MiniCPM-OCR читает папку сканов локально. Какие страницы всё ещё должен проверить человек?
SDK MiniCPM-OCR 1.0.5 обрабатывает несколько входных файлов за один запуск. Сохраняйте результат на документ, проверяйте важные поля и решайте, какие сканы можно отправить в поисковый архив.
Три старых счёта человек читает без труда, а поиск по ним затруднён. Первый — PDF без текстового слоя. Второй — фотография с загнутым углом. Третий — чистый скан с таблицей на двух страницах. Локальное распознавание превращает изображения в текст, но сотруднику, который утверждает архив, нужно знать, к какому файлу относится результат и сохранили ли столбцы смысл.
9 ноября 2026 года OpenBMB выпустила версию 1.0.5 SDK MiniCPM-OCR. Обновление принимает несколько входных файлов за запуск и выдаёт результат для каждого. Отдельный параметр позволяет считать самостоятельные изображения отдельными документами. Модель MiniCPM-OCR 1.0 с 1,3 млрд параметров предназначена для документов и PDF на китайском и английском. OpenBMB опубликовала модель и SDK ранее и описывает локальный запуск распознавания. Версия в PyPI · Проект OpenBMB и история изменений
Полезный первый эксперимент — небольшая партия с результатом, который можно проверить. Дайте каждому входному файлу устойчивый идентификатор, держите извлечённый результат рядом с оригиналом и сверяйте поля, ошибки в которых могут привести к последствиям. Так можно отличить черновик для поиска от записи, на основании которой можно действовать.
Официальная иллюстрация выпуска MiniCPM-OCR от OpenBMB показывает преобразование документов в структурированный текст. Apache 2.0. Telli.sh преобразовала изображение в растр и изменила размер. Исходная иллюстрация

Обновление упрощает сохранение границ документов
В примечаниях OpenBMB от 9 ноября сказано, что версия 1.0.5 при нескольких входах возвращает один результат на файл. Параметр --split-images считает отдельные изображения самостоятельными документами. Это важно там, где есть и многостраничные PDF, и фотографии. Счёт, уже собранный в один PDF, обычно следует оставить целым. Две не связанные фотографии должны остаться двумя записями. Пакет MiniCPM-OCR 1.0.5 и примечания
Для небольшой оценки подготовьте по документу каждого вида. Чистый PDF поможет установить ожидаемый порядок чтения. Снимок страницы покажет, мешают ли сгиб, поворот или блик. Плотная таблица покажет, что происходит с похожими значениями в двух столбцах. Если в архиве есть снимки двух страниц одной записи, определите группировку до передачи в анализатор. Группировка относится к документу, а команда принимает файлы.
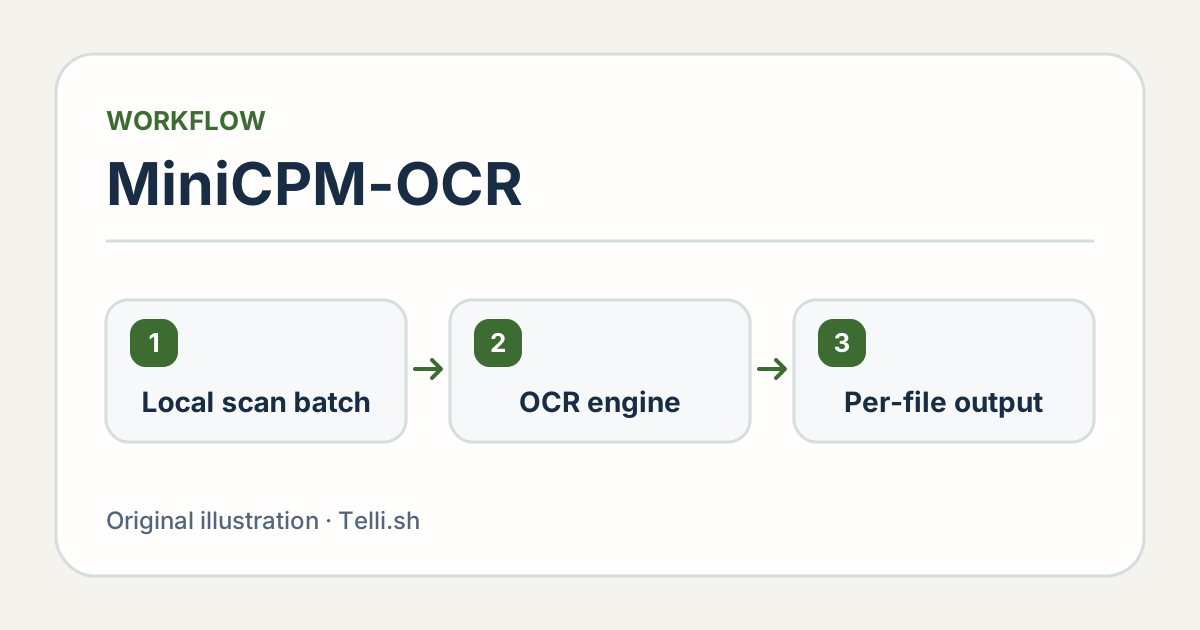
В примере каждому входу соответствует устойчивый идентификатор, а оригинал сохраняется для проверки. Иллюстрация Telli.sh.
Подготовьте список входов с оригиналом, количеством страниц и ожидаемым выходом. Если используете контрольную сумму для обнаружения случайных изменений, вычислите её по оригиналу до запуска. Сохраняйте результаты отдельно, чтобы повторная попытка не перезаписала единственный источник. Если в двух папках есть файл invoice.pdf, устойчивый идентификатор сохраняет соответствие даже при одинаковых именах.
Выберите формат, который сможет прочитать следующий процесс. В зависимости от настроек SDK OpenBMB собирает результаты в Markdown или JSON. Markdown удобно читать человеку. Структурированный формат может помочь следующему процессу обработать возвращённые области. Любой формат требует сверки с изображением, если число или поле будет влиять на решение. Процесс распознавания OpenBMB
Локальная установка разделяет анализ разметки и распознавание
OpenBMB описывает две части полноформатного анализа на компьютере. SDK запускает модель разметки, которая находит и упорядочивает текст, таблицы, формулы и другие области. Затем отправляет вырезанные фрагменты по HTTP сервису распознавания и собирает ответы в порядке чтения. Обе части можно запустить на своём оборудовании. Сервис распознавания — отдельная среда, и SDK может обращаться к сервису в другом месте. Руководство OpenBMB по анализу страниц и локальному развёртыванию
Эта граница важна для конфиденциальных документов. Вопрос в том, куда модуль разметки отправляет фрагменты. Локальный SDK, настроенный на внешний сервис, всё равно может передавать содержимое по сети. Для локальной обработки укажите нужный сервис и используйте утверждённые в организации правила хранения и журналирования. Публичную демонстрацию можно изучить на синтетическом примере без настоящего клиентского документа.
5 ноября OpenBMB опубликовала Docker-образ с SDK, vLLM и моделью. Описанная установка требует Linux x86-64, GPU NVIDIA, драйвер с поддержкой CUDA 12.9 и Docker с NVIDIA Container Toolkit. OpenBMB также описывает среды распознавания, в том числе llama.cpp и Ollama. По одному размеру модели нельзя определить, насколько удобно на конкретной машине будет выполнять весь процесс. Проверьте модуль разметки, формат модели, память и скорость обработки на целевой машине. Требования к развёртыванию OpenBMB
Отдельные документы можно обработать и на телефоне. 2 ноября OpenBMB объявила об автономном распознавании на iOS. Обновление проекта от 12 ноября расширило локальную демонстрацию на Android и HarmonyOS. Мобильная демонстрация и пакетный SDK на компьютере — разные способы пользоваться моделью. Выберите подходящий для расположения файлов и порядка проверки результатов. История мобильных выпусков OpenBMB
Проверяйте поля, ошибка в которых незаметна на первый взгляд
Допустим, в счёте 10 единиц по цене 38,50. В извлечённой таблице 38,50 оказалось в количестве, а 10 — в цене за единицу. Проверка, которая ищет только присутствие чисел, может принять результат. Для пользователя важна связь значения со столбцом. Сравнивайте вместе строку, заголовки и итоговые суммы.
В поисковом архиве риск устроен иначе. Опечатка в описании может быть допустима, если сотрудник всё равно найдёт оригинал. Ошибка в номере заказа может привести к другому документу. Определите поля, где нужно точное совпадение, и сверьте их с источником. Если на странице есть код, сохраняйте начальные нули при проверке. Числовой формат или импорт в таблицу может удалить их даже при правильном распознавании.
| Пример документа | Что сверить с оригиналом | Что решить до дальнейшего использования |
|---|---|---|
| Счета | Идентификатор поставщика, номер счёта, валюта, суммы и заголовки столбцов | Какие поля требуют точного совпадения |
| Отчёт в нескольких колонках | Заголовок, порядок колонок и подписи у иллюстраций | Читается ли результат в правильном порядке |
| Повёрнутая или сфотографированная форма | Имена, отметки, печати и записи рядом со сгибом | Какие страницы нужно проверить вручную или переснять |
| Многоязычный скан | Идентификаторы и текст полей на каждом языке | Какие языки отвечают критериям приёмки архива |
OpenBMB позиционирует MiniCPM-OCR 1.0 для китайского и английского. Командам с корейскими или смешанными страницами стоит измерить точность на своих материалах. Включите плотный документ, чистую форму и фотографию на каждом важном языке. Записывайте типы ошибок вместо одной средней оценки по нескольким непохожим документам. Описание модели OpenBMB
Оценка области помогает выбрать, что проверить первым
OpenBMB также публикует MiniCPM-OCR Jev, отдельную модель для сверки извлечённого текста, формул и таблиц с областью изображения. Проект описывает оценку как способ найти области, которые могут требовать проверки. В пакетной обработке её можно использовать для очередности, продолжая сверять важные поля с оригиналом. Прежде чем выстраивать очередь по оценкам, выясните, насколько хорошо они выделяют нужные вам ошибки. Описание MiniCPM-OCR Jev от OpenBMB
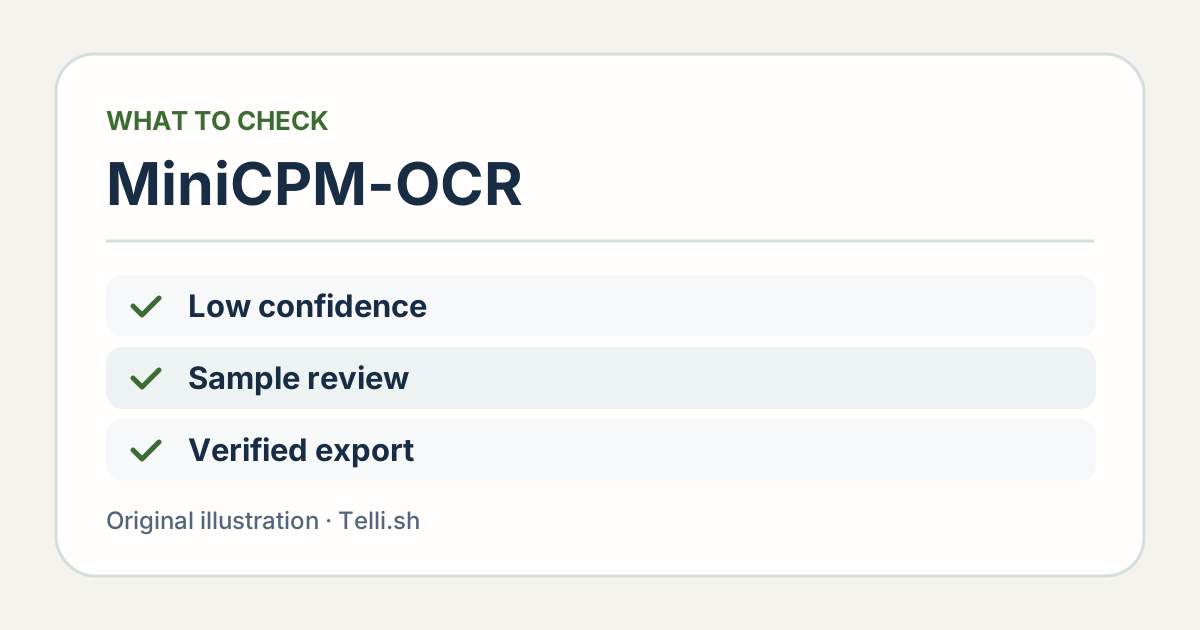
Дополнительная оценка областей помогает выбирать очерёдность проверки. Поля, связанные с платежами, идентификаторами и другими решениями, могут требовать прямой сверки. Иллюстрация Telli.sh.
Чтобы понять пользу оценки, подготовьте небольшой эталонный набор с несколькими знакомыми ошибками. Пропущенный знак в номере детали, смещённая строка и предложение с чистой страницы представляют разные варианты. Добавьте правильные области. Изучите случаи, где модель высоко оценила ошибку или низко — верный результат. Их стоит обсудить до введения порога.
Сохраняйте расхождения видимыми. Если проверяющий исправил итоговую сумму, оставьте исходный результат OCR и запишите изменение со ссылкой на документ. Это позволит понять, связаны ли ошибки с типом документа или способом съёмки. Следующий сотрудник также сможет отличить человеческую правку от первого ответа модели.
Время проверки может определить, подходит ли подход для больших объёмов. Записывайте, сколько занимает устранение проблемы и какие страницы приходится пересматривать. Локальный инструмент может экономить время на чистых документах и удлинять очередь для плохих сканов. Если одна и та же бумажная форма постоянно даёт сбой, улучшение сканирования может быть полезнее ещё одной модели.
Возьмите небольшую партию, в которой возможны разные сбои
- Соберите разрешённые образцы. Возьмите чистый скан, повёрнутую фотографию и многостраничную таблицу с характерными языками и разметкой. Сохраните оригиналы под устойчивыми идентификаторами.
- Выберите утверждённый локальный путь. Для обработки на компьютере следуйте руководству OpenBMB и проверьте конечную точку сервиса распознавания. До загрузки файлов проверьте требования к оборудованию и среде. Официальное руководство по локальному развёртыванию
- Запустите SDK и сохраните результат для каждого файла. Запишите версию SDK, модель или квантование, среду выполнения и формат. Осознанно выберите группировку изображений и сохраните источник для каждого выхода. Инструкции SDK 1.0.5
- Проверяйте с учётом назначения архива. Для поиска смотрите порядок чтения, для последующей обработки — важные поля извлечения. Запишите, какие документы приняты, исправлены или отклонены и почему.
- Повторите с новой небольшой партией. Используйте те же критерии. Сравните время проверки и прослеживаемость. До роста объёма решите, что делать с типами документов, которые всё ещё обрабатываются вручную.
Выберите выполнимое применение. Ассистент для поиска в отсканированных протоколах встреч не требует тех же гарантий по полям, что заполнение формы оплаты счёта. Начните с поиска или другого обратимого процесса, если это текущая потребность. Пилот покажет, какие виды извлечения позже потребуют более строгих проверок.
Дайте архиву простой способ показать, что он проиндексировал. Если выдача показывает только машинный текст, пользователь может счесть правдоподобный результат окончательным. Покажите имя исходного файла или ID рядом с результатом и облегчите переход к нужной странице. При наличии статуса проверки показывайте и его. Тогда пользователи поймут, когда нужно открыть оригинал.
Для общей папки вывода есть полезный тест восстановления. Представьте, что один файл не обработался и вы запустили только его с другими настройками. Убедитесь, что результаты остальных на месте и что список входов указывает на выход второго прогона. Автоматическая переобработка для этого не нужна. Проверка показывает, можно ли улучшить один результат, сохранив историю остальных.
Партия полезна, когда от каждого результата можно вернуться к странице
Обновление SDK MiniCPM-OCR убирает часть работы по отправке файлов по одному. Остальное относится к устройству архива. Сохраняйте границы документов, выбирайте место обработки изображений и определяйте глубину проверки полей по требованиям следующего процесса. Если через месяц человек найдёт в результате число, он должен суметь открыть исходную страницу и увидеть то, что видел анализатор.
Источники
- MiniCPM-OCR SDK 1.0.5 в PyPI, 9 ноября 2026 года
- Репозиторий OpenBMB MiniCPM-OCR, карточки моделей, даты и руководства
- Публичная демонстрация OpenBMB
- Иллюстрация выпуска OpenBMB и лицензия
Чтобы находить решения, принятые при проверке архива документов, создайте аккаунт Telli.sh.