Cùng tỷ lệ lỗi 10,0% nhưng quyết định trái ngược: cách đo độ chính xác của bản ghi cuộc họp
Tỷ lệ lỗi từ chấm điểm chữ “không” và chữ “cái” y hệt nhau, và đó là lý do hai bản ghi cùng đạt 10,0% nhưng chỉ một bản dùng được. Đây là toàn bộ quy trình đo: một đoạn thử 12 phút dựng theo đúng đặc tả cuộc họp, một bản ghi tham chiếu với quy tắc chuẩn hóa được đóng băng trước, các lệnh cpWER và DER chính xác, cùng một bảng điểm năm chiều chỉ dành cho WER thô 10 điểm trên 100.
Đây là hai bản ghi do máy tạo ra cho cùng một câu hai mươi từ trong một buổi họp sản phẩm.
A — “Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review” (Priya nói việc chuyển đổi Helios lùi sang Q3 và chúng ta không nên ký hợp đồng với nhà cung cấp trước khi rà soát bảo mật).
B — “Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review” (…lùi sang Q2 và chúng ta nên ký hợp đồng với nhà cung cấp trước khi rà soát bảo mật).
Mỗi bản chứa đúng hai lỗi so với những gì thực sự được nói ra. Mỗi bản đạt tỷ lệ lỗi từ 10,0%. Bản A làm rơi chữ “the” hai lần. Bản B đẩy một mốc thời hạn sớm lên một quý và xóa mất chữ “not” khỏi một cam kết.
Nếu quy trình đánh giá của bạn xếp hai hệ thống đó ngang nhau, thì vấn đề nằm ở quy trình — không phải ở mô hình.
Bài này là quy trình đo mà chúng tôi sẽ đưa cho một người được giao nhiệm vụ chọn công cụ ghi chép trước thứ Sáu. Nó nói chính xác tỷ lệ lỗi từ đếm cái gì; vì sao con số ấy đánh lừa riêng với âm thanh cuộc họp; và một giao thức năm bước bạn có thể chạy trong một buổi chiều với hai gói mã nguồn mở và một bản ghi âm 12 phút. Ở một bài riêng, chúng tôi đã lập luận rằng chỉ riêng độ chính xác ghi chép chưa bao giờ là sản phẩm cuối. Đây là bài đi kèm — không phải lập luận, mà là phương pháp.
Tóm tắt nhanh:
- WER là
(substitutions + deletions + insertions) ÷ reference words, và mọi từ đều mang trọng số như nhau. Từ phủ định “not” và mạo từ “the” tốn giá y hệt nhau.- Các bảng xếp hạng công bố đã nén lại. Trên bảng độc lập của Artificial Analysis, truy xuất ngày 31 tháng 8 năm 2026, năm mô hình dẫn đầu nằm giữa 1,7% và 2,6% AA-WER — một khoảng cách quá hẹp để chọn ra người thắng.
- Thay vào đó hãy chấm năm chiều, có trọng số: thuật ngữ chịu lực (30), quy gán người nói (25), số liệu và số tiền (20), phân đoạn (15), WER thô (10). Công cụ cho những phần khó đã có sẵn —
cpWERvàDERnằm trong MeetEval, bộ công cụ dựng cho các thử thách CHiME.
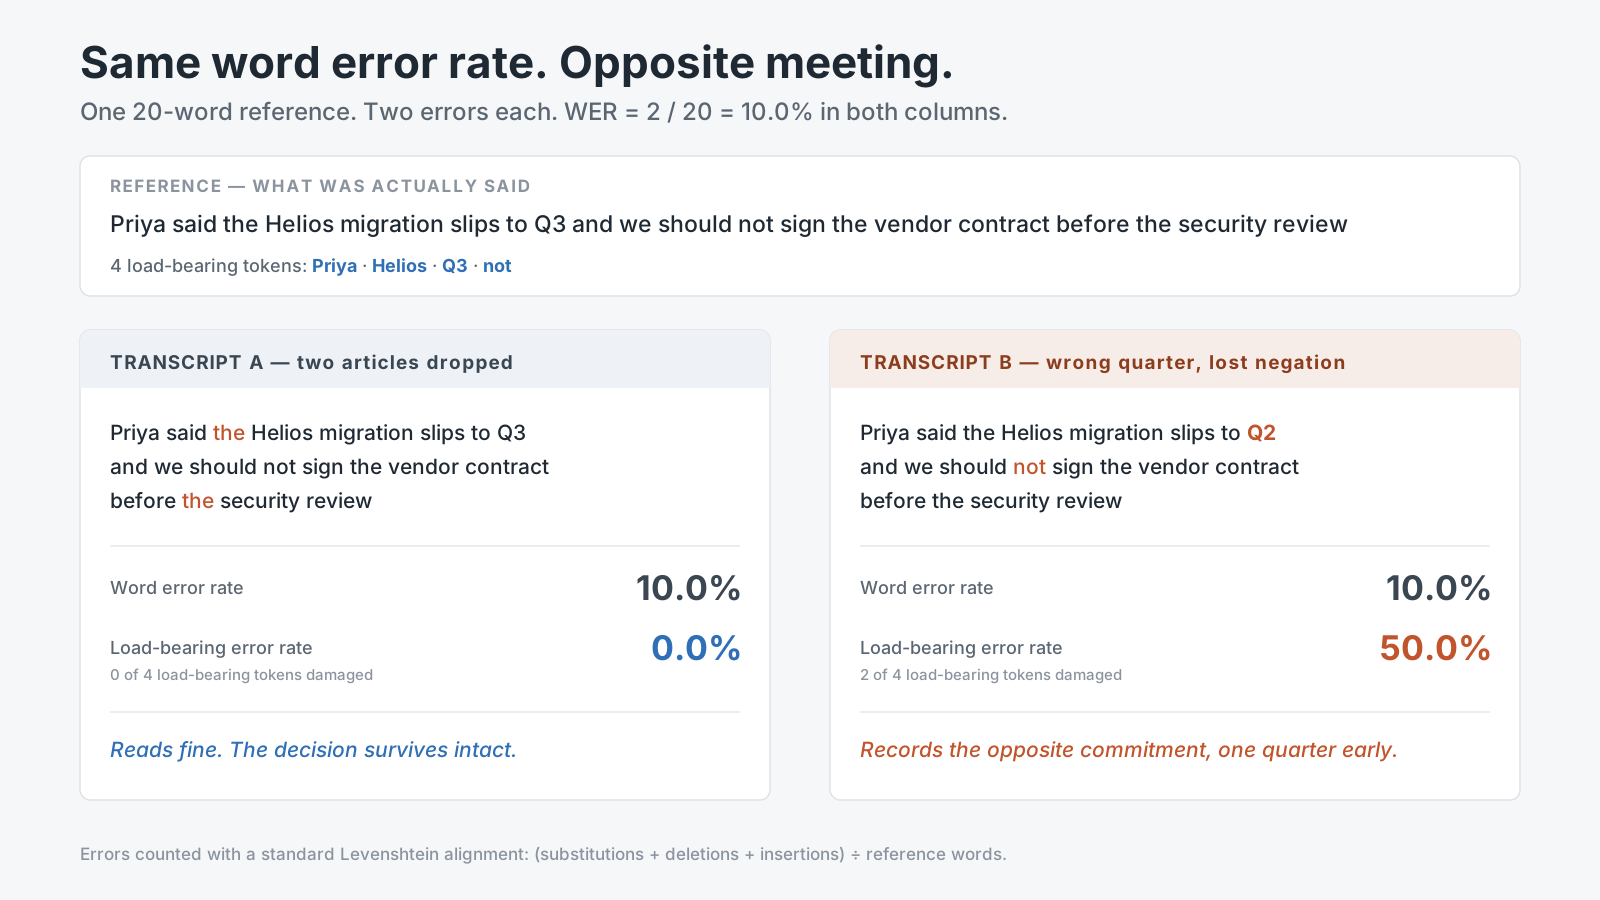
Cả hai cột đều có hai lỗi so với bản tham chiếu 20 từ. Chỉ một trong hai còn ghi lại đúng quyết định mà căn phòng thực sự đưa ra.
Tỷ lệ lỗi từ đếm chính xác những gì
WER sinh ra từ một phép căn chỉnh duy nhất. Lấy bản ghi tham chiếu — thứ mà con người thống nhất là đã được nói. Lấy đầu ra của máy. Tìm chuỗi chỉnh sửa rẻ nhất biến bản này thành bản kia, dùng phép căn chỉnh Levenshtein kinh điển, rồi gán nhãn cho từng chỉnh sửa:
- một phép thay thế khi mô hình viết ra một từ khác (“deploy” nghe thành “delay”),
- một phép xóa khi một từ trong tham chiếu không có đối ứng ở đầu ra,
- một phép chèn khi mô hình sinh ra một từ không ai nói.
Sau đó:
WER = (substitutions + deletions + insertions) ÷ reference words
Mẫu số là độ dài bản tham chiếu, không phải độ dài giả thuyết, và đó là lý do WER hoàn toàn có thể vượt quá 100% — một mô hình bịa thoải mái có thể gom được nhiều phép chèn hơn cả số từ vốn có ban đầu.
Một ví dụ tính tay, lấy từ chính tài liệu của MeetEval để phép tính đối chiếu được với một kết quả đã công bố. Tham chiếu: “The quick brown fox jumps over the lazy dog” — chín từ. Giả thuyết: “The kwick brown fox jump over lazy” — bảy từ. Phép căn chỉnh tìm ra hai phép thay thế (quick→kwick, jumps→jump) và hai phép xóa (the, dog), không có phép chèn nào. Vậy (2 + 2 + 0) ÷ 9 = 0,4444, tức WER bằng 44,4%, và MeetEval in ra đúng như thế: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
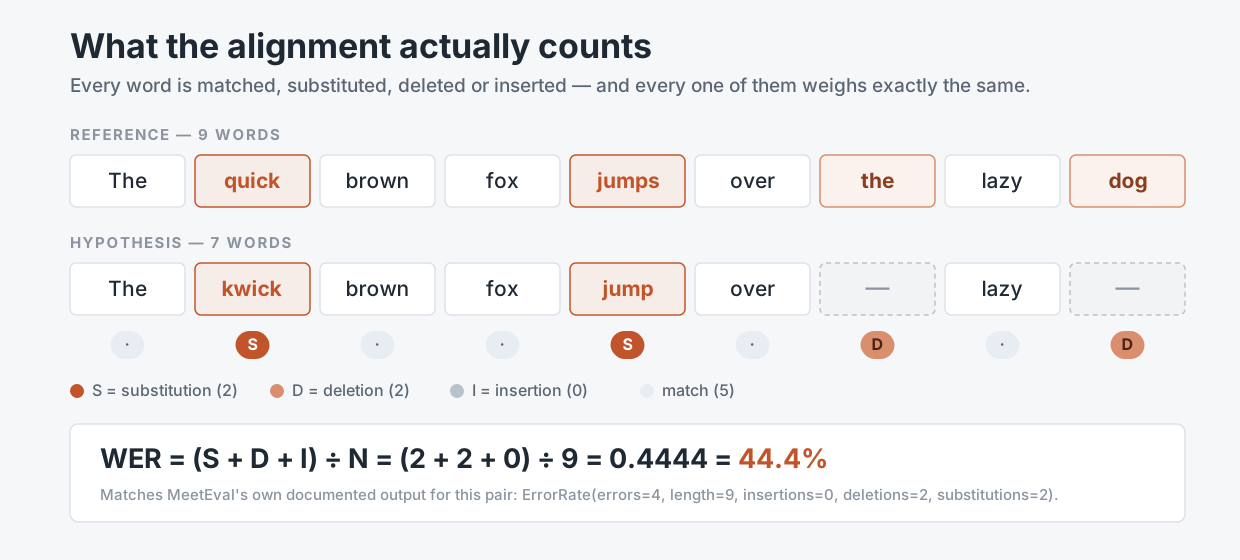
Phép căn chỉnh mang tính máy móc và tái lập được. Cái nó không có là trọng số. Nguồn: tài liệu MeetEval, truy xuất ngày 31 tháng 8 năm 2026.
Hai tính chất của công thức đó quan trọng hơn bất cứ dòng nào trên trang giới thiệu của nhà cung cấp. Thứ nhất, nó phẳng: chỉ số này không hề biết rằng một số từ gánh cả cuộc họp còn một số từ chỉ gánh ngữ pháp. Thứ hai, nó mù người nói: WER tiêu chuẩn gộp mọi thứ thành một dòng duy nhất, nên một hệ thống chép đúng từng từ nhưng gán một nửa số đó cho nhầm người vẫn có thể đạt điểm đẹp không tì vết.
Vì sao các con số đã công bố không còn tách được các ứng viên của bạn
Kéo bảng xếp hạng ra thì vấn đề trở thành một phép tính. Artificial Analysis, đơn vị tự chạy đánh giá riêng thay vì in lại tuyên bố của nhà cung cấp, liệt kê năm mô hình dẫn đầu theo AA-WER vào ngày 31 tháng 8 năm 2026 như sau: Fun-Realtime-ASR-preview 1,7%, ElevenLabs Scribe v2 2,2%, MAI-Transcribe-1.5 của Microsoft 2,4%, Smallest AI Pulse Pro 2,4% và Gemini 3.5 Transcribe 2,6%. Mô hình trọng số mở tốt nhất, Voxtral Small của Mistral, ở mức 2,8%.
Toàn bộ nhóm dẫn đầu thị trường nằm gọn trong một dải rộng 1,1 điểm. Với một cuộc họp 45 phút chứa khoảng 6.300 từ được nói ra, khoảng cách giữa hạng nhất và hạng năm là chừng 57 từ — chưa tới một từ trên mỗi màn hình bản ghi.
Còn một vấn đề thứ hai: âm thanh dùng làm benchmark không phải là âm thanh của bạn. AA-WER v2 là trung bình có trọng số theo thời lượng âm thanh trên khoảng tám giờ lấy từ ba nguồn: AA-AgentTalk 50%, VoxPopuli-Cleaned-AA 25% và Earnings22-Cleaned-AA 25%. Các bài phát biểu nghị viện và các buổi công bố kết quả kinh doanh được thu tốt, nói lần lượt theo lượt, và gần như không có thứ định nghĩa nên một cuộc họp nội bộ — bốn người cắt lời nhau về một dự án mà chỉ họ từng nghe tới.
Nghiên cứu về âm thanh hội thoại thật sự đã coi đây là một lĩnh vực riêng suốt nhiều năm. Thử thách CHiME-6, công bố ngày 20 tháng 4 năm 2020 bởi Watanabe, Mandel, Barker và mười tám đồng tác giả, xây dựng phần đánh giá trên các bản thu bữa tối chính vì hội thoại tự nhiên có chồng tiếng và micro đặt xa làm sụp đổ những hệ thống chấm điểm cao trên giọng đọc. Kho ngữ liệu AMI Meeting Corpus, 100 giờ ghi âm thu bằng cả tai nghe cận miệng lẫn micro trường xa, tồn tại vì đúng lý do đó.
Đây là điểm mấu chốt, và chúng tôi nói thẳng không rào đón: một con số WER đã công bố cho bạn biết mô hình của nhà cung cấp không hỏng. Nó không thể cho bạn biết nên mua của ai.
Những gì WER bắt được và những gì nó không thể bắt về mặt cấu trúc
| Kiểu hỏng | WER thô có bắt được? | Cái giá bạn phải trả | Thứ thật sự đo được nó |
|---|---|---|---|
| Nghe nhầm từ thông dụng (“their”/“there”) | Có, với trọng số đầy đủ | Gần như không gì cả | WER |
| Từ đệm và câu nói dở bị bỏ | Có, tính là phép xóa | Không gì cả — thường còn tốt hơn | WER, một cách gây hiểu lầm |
| Danh từ riêng bị bóp méo (“Xochitl” → “Societal”) | Có, nhưng chỉ nặng bằng 1 từ | Tên của người chịu trách nhiệm | Tỷ lệ lỗi trên thuật ngữ chịu lực |
| Sai số hoặc sai ngày (“Q3” → “Q2”) | Có, nặng bằng 1 từ | Một hạn chót bị lỡ | Độ chính xác số liệu, chấm riêng |
| Từ phủ định bị xóa (“should not” → “should”) | Có, nặng bằng 1 từ | Quyết định bị đảo ngược | Tỷ lệ lỗi trên thuật ngữ chịu lực |
| Từ đúng, sai người nói | Không — WER mù người nói | Không ai biết ai đã cam kết | cpWER, DER |
| Các lượt nói bị gộp thành một khối | Không | Một bức tường chữ không đọc nổi | tcpWER kèm collar, người đọc lại |
| Thiếu ranh giới câu | Không — dấu câu bị chuẩn hóa mất | Bản tóm tắt phải đoán cấu trúc | Điểm phân đoạn, người đọc lại |
| Cả đoạn bị bịa ra trong lúc im lặng | Một phần — dưới dạng phép chèn | Nội dung bịa được trình bày như biên bản | WER cộng số phép chèn đọc riêng |
Nửa dưới của bảng đó mới là nửa quyết định một bản ghi có trở thành ghi chú dùng được hay không, và WER tiêu chuẩn không thấy gì trong đó cả. Đó không phải khuyết điểm của chỉ số — WER trả lời đúng câu hỏi mà nó được thiết kế cho, trong nghiên cứu đọc chính tả những năm 1990. Khuyết điểm nằm ở việc dùng một mình nó vào năm 2026.
Bước 1: dựng một đoạn 12 phút hành xử như một cuộc họp thật
Đừng đánh giá trên file demo của nhà cung cấp, và cũng đừng đánh giá trên tám giờ kho lưu trữ của chính bạn. Bạn cần một đoạn đủ ngắn để chép tay và đủ dày đặc để làm mọi thứ gãy.
Nhắm tới 12 phút. Với nhịp nói hội thoại bình thường khoảng 140 từ mỗi phút và mật độ nói chừng 75%, con số đó cho ra khoảng 1.260 từ tham chiếu — đủ để chênh lệch 2 điểm phần trăm tỷ lệ lỗi tương đương 25 từ chứ không phải nhiễu thống kê, và đủ ít để hai người chép cẩn thận xong trong một buổi chiều.
Hãy dựng đoạn thử theo đặc tả, không theo cảm tính. Đặc tả của chúng tôi:
- Từ bốn người nói trở lên, trong đó ít nhất một người tham gia từ xa qua kênh âm thanh bị nén, và ít nhất một giọng không phải bản ngữ trong ngôn ngữ làm việc.
- Chín mươi giây trở lên chồng tiếng thật sự — hai người nói cùng lúc, ai đó nói nốt câu của người khác, một tiếng ho đè lên một quyết định. Chồng tiếng chính là chỗ phân tách người nói lặng lẽ sụp đổ, và một đoạn thử không có nó thì chẳng đo được gì.
- Hai mươi lăm thuật ngữ chuyên ngành trở lên: tên mã sản phẩm, từ viết tắt nội bộ, tên khách hàng, tên người tham dự. Đây là những từ có mật độ nghĩa trên mỗi ký tự cao nhất trong phòng họp và tần suất thấp nhất trong mọi kho huấn luyện.
- Mười lăm số liệu trở lên: ngày tháng, quý, số tiền, số phiên bản, phần trăm. Hãy cố tình nói một vài số theo cách dễ nhầm (“fifteen” và “fifty” trong cùng một phút).
- Ba quyết định phủ định trở lên, nói ra tự nhiên: “bản phát hành này chúng ta không ship cái đó”, “khoan hẵng ký hợp đồng”.
- Hai bản thu song song nếu bạn thu xếp được — micro của chính chiếc laptop và một track tai nghe riêng cho từng người. Đó là thiết kế của kho ngữ liệu AMI, và nó cho phép bạn tách “mô hình yếu” khỏi “phòng họp ồn”.
Thu một lần duy nhất. Lưu file WAV không nén ở 16 kHz trở lên. Mọi công cụ bạn đánh giá từ đây trở đi đều nhận đúng file này, mãi mãi.
Bước 2: viết bản tham chiếu — rồi đóng băng quy tắc chuẩn hóa trước khi chấm bất cứ điểm nào
Bản ghi tham chiếu là một dụng cụ đo, và nó có sai số. Artificial Analysis duy trì các phiên bản “đã làm sạch” cho các tập đánh giá công khai của họ chính vì bản ghi tham chiếu gốc chứa lỗi chép của riêng nó; ghi chú của họ nói thẳng — bản đã làm sạch “loại bỏ các lỗi ghi chép khỏi văn bản tham chiếu, cung cấp một chuẩn đối chiếu chính xác hơn để đánh giá mô hình”. Nếu một đơn vị vận hành benchmark còn phải sửa chuẩn đối chiếu đã công bố, thì bản chép lượt đầu của bạn cũng chẳng phải kinh thánh.
Vậy nên: hai người chép độc lập, rồi đối chiếu từng khác biệt. Hãy dự trù năm đến tám lần thời gian thực cho cặp đôi ấy, tức một đoạn 12 phút tốn khoảng một ngày công gộp lại. Đó là khoản chi lớn nhất trong toàn bộ quy trình này và không có cách nào né được.
Sau đó hãy viết ra chính sách chuẩn hóa của bạn trước khi tính lấy một điểm nào, bởi tự thân những lựa chọn này đã dịch chuyển con số cuối cùng vài điểm:
- Số: “Q3” có phải cùng một token với “Q three” không? “bốn mươi nghìn” có bằng “40.000” không?
- Dạng rút gọn: “we're” có khớp với “we are” không?
- Từ đệm: “um”, “uh” và các câu nói dở có nằm trong bản tham chiếu không, và có được chấm không?
- Chữ hoa và dấu câu: thường bị lược bỏ trước khi chấm — nghĩa là một công cụ chấm câu đẹp không được cộng điểm ở đây, và bạn phải chấm phần đó riêng ở bước 3.
Lưu kết quả theo SegLST, định dạng JSON mà các thử thách CHiME dùng và cũng là mặc định của MeetEval: mỗi phân đoạn một đối tượng với session_id, words, speaker, start_time và end_time. Chính các trường người nói và thời gian mới làm cho các chỉ số nhận biết người nói khả thi, và bổ sung chúng về sau là một cực hình.
Bước 3: chấm năm chiều, và chỉ cho WER thô mười điểm trên một trăm
Cài công cụ — pip install jiwer meeteval — rồi chấm từng chiều trên cùng một đoạn. JiWER tính WER cùng với match error rate, word information lost, word information preserved và character error rate, dùng bản cài đặt khoảng cách chỉnh sửa tối thiểu của RapidFuzz. MeetEval tính các chỉ số riêng cho cuộc họp.
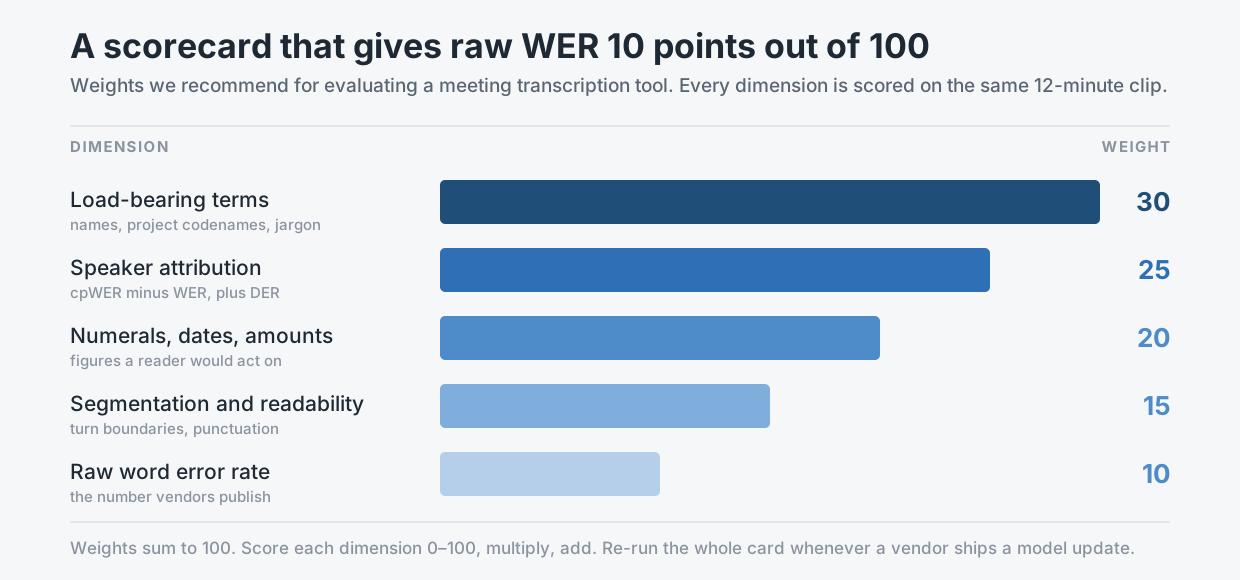
Trọng số chúng tôi khuyến nghị. Chiều mà mọi nhà cung cấp đem ra quảng cáo lại là chiều đáng ít điểm nhất.
Thuật ngữ chịu lực — 30 điểm. Đánh dấu mọi danh từ riêng, tên mã và mảnh thuật ngữ chuyên ngành trong bản tham chiếu. Rồi tính đúng công thức WER đó nhưng chỉ trên những token ấy. Chúng tôi gọi kết quả là tỷ lệ lỗi trên thuật ngữ chịu lực, và đây là con số có sức dự báo mạnh nhất trong cả bài tập. Trong cặp bản ghi ở đầu bài này, bốn token chịu lực là Priya, Helios, Q3 và not. Bản A không làm hỏng token nào: 0,0%. Bản B làm hỏng hai: 50,0%. Cùng một WER tổng thể 10,0%, mà chênh nhau năm mươi điểm trên chỉ số thực sự quan trọng.
Quy gán người nói — 25 điểm. Chạy meeteval-wer cpwer -r ref.stm -h hyp.stm. Concatenated minimum-permutation WER tìm ánh xạ tốt nhất giữa người nói trong tham chiếu và trong giả thuyết, nối các từ của từng người nói lại rồi chấm kết quả — nên những từ bị gán cho nhầm người sẽ thành lỗi. Rồi lấy hiệu: cpWER trừ WER thường chính là khoảng cách quy gán, phần thiệt hại đến thuần túy từ việc không biết ai đã nói. Bổ sung diarization error rate để có góc nhìn thời gian; DER là tổng của lỗi người nói, tiếng nói báo động giả và tiếng nói bị bỏ sót, tính theo phần trăm thời gian được chấm, được định nghĩa ở mục 6.1 của kế hoạch đánh giá NIST RT-09 và được cài đặt trong dscore, thứ mà MeetEval bọc lại và vốn đọc file RTTM. Nếu ứng viên của bạn hỗ trợ dấu thời gian, hãy dùng tcpwer --collar 5 thay cho cpwer để một từ đúng nhưng gắn sai thời điểm không được tha thứ trong im lặng.
Số liệu, ngày tháng và số tiền — 20 điểm. Trích mọi token số từ bản tham chiếu và chấm độ chính xác khớp tuyệt đối với giả thuyết, sau khi áp dụng chính sách chuẩn hóa bạn đã viết ra. Hãy báo cáo dưới dạng phân số trần — “13 trên 15 đúng” — chứ không phải phần trăm, vì số lượng nhỏ và phần trăm ngụ ý một độ chính xác bạn không có.
Phân đoạn và độ dễ đọc — 15 điểm. Chiều này do con người chấm. Hãy nhờ hai người đọc không dự cuộc họp đọc đầu ra thô và đánh dấu, tính theo từng phút: ranh giới câu đặt sai chỗ, các lượt nói bị gộp thành một khối, và những đoạn phải đọc lại mới hiểu. Dấu câu đã bị chuẩn hóa khỏi phép tính WER, nên đây là nơi duy nhất nó được chấm.
Tỷ lệ lỗi từ thô — 10 điểm. Chạy jiwer và ghi lại con số. Đây là một phép kiểm tra sàn thật sự: bất cứ giá trị nào trên khoảng 12% với âm thanh sạch thu gần miệng đều báo hiệu một vấn đề âm học có thật, đáng điều tra. Vượt qua cái sàn đó, nó gần như không phân biệt được gì nữa, và đó chính xác là lý do nó đáng mười điểm chứ không phải tám mươi.
Chấm mỗi chiều theo thang 0–100, nhân với trọng số, cộng lại. Kết quả so sánh được giữa các công cụ và theo thời gian, đó mới là toàn bộ mục đích.
Bước 4: chạy mọi ứng viên trên đúng cùng một file, và ghi lại “cùng một” nghĩa là gì
Đây là bước các đội hay bỏ qua, và chính nó vô hiệu hóa mọi thứ phía trên.
Cùng file WAV, cùng tần số lấy mẫu, không mã hóa lại giữa các ứng viên. Cùng bản tham chiếu, cùng chính sách chuẩn hóa được áp bởi cùng một script. Phân tách người nói phải được bật rõ ràng hoặc tắt rõ ràng trên mọi công cụ, và ghi lại theo cả hai chiều — một công cụ đánh giá khi tắt phân tách người nói không so sánh được với công cụ đánh giá khi bật. Việc thiên lệch theo từ khóa hoặc thực thể phải tắt ở lượt chạy đầu và bật ở lượt thứ hai, cả hai đều được ghi lại; Microsoft báo cáo mức giảm WER lên tới 30% khi cung cấp danh sách từ khóa cho MAI-Transcribe-1.5, đủ lớn để một phép so sánh trộn lẫn lượt chạy có và không thiên lệch trở nên vô nghĩa.
Đặc biệt hãy để mắt tới cách xử lý âm thanh dài. Artificial Analysis phải cắt âm thanh Earnings22 của họ thành các khúc khoảng chín phút cho những mô hình không xử lý ổn định đầu vào dài trọn vẹn, và khoảng 30 giây cho những mô hình có giới hạn chặt hơn — ghi chú công bố của chính họ nêu tên GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B và Qwen3 ASR Flash của Alibaba trong số các hệ thống bị ảnh hưởng. Việc cắt khúc làm thay đổi kết quả, vì lỗi dồn về các đường biên. Nếu một nhà cung cấp cắt file của bạn, đó là một thuộc tính của sản phẩm và nó thuộc về bảng điểm, chứ không phải một hiện tượng cần chỉnh cho mất đi.
Cuối cùng, hãy ghi lại chuỗi phiên bản mô hình chính xác và ngày của từng lượt chạy. “Whisper large-v3” không phải một phiên bản; whisper-large-v3, run 2026-08-31 mới là.
Bước 5: chạy lại bảng điểm khi nhà cung cấp ra bản mới, chứ không phải khi bạn sực nhớ
Các mô hình giọng nói chạy trên đám mây thay đổi ngay dưới chân bạn. Tên endpoint giữ nguyên còn trọng số phía sau thì không, và chẳng ai gửi email cho bạn khi ghi chú cuộc họp bắt đầu xử lý danh từ riêng tệ đi một chút.
Ba tín hiệu sau nên kích hoạt một lượt chạy lại toàn bộ bảng điểm, trên đúng đoạn thử bạn đã dựng ở bước 1:
- Nhà cung cấp đăng một mục changelog động tới mô hình, bộ phân tách người nói, hoặc lớp dấu câu và định dạng.
- Một mốc thời gian trôi qua — hằng quý là đủ với hầu hết các đội, hằng tháng nếu đầu ra ghi chép nuôi bất cứ thứ gì tự động hóa ở phía sau.
- Tỷ lệ lỗi trên thuật ngữ chịu lực của bạn dịch chuyển hơn 5 điểm giữa hai lượt chạy bất kỳ — điều đó nên kích hoạt một cuộc điều tra trước khi kích hoạt một cuộc chuyển đổi nhà cung cấp.
Giữ mọi lượt chạy trong một bảng duy nhất: ngày, chuỗi phiên bản mô hình, năm điểm số theo chiều, tổng có trọng số. Sau ba bốn lượt, bạn sở hữu thứ mà không bảng xếp hạng nào cho bạn được — một chuỗi thời gian về cách một sản phẩm cụ thể vận hành trên thứ âm thanh nghe giống hệt các cuộc họp thật của bạn.
Điểm mấu chốt: độ chính xác là phép đo căn phòng của bạn, không phải một thuộc tính của mô hình
Tỷ lệ lỗi từ là thuộc tính của một mô hình trên một kho ngữ liệu. Thứ bạn thực sự cần là thuộc tính của một mô hình trên âm thanh của bạn, với từ vựng của bạn, giữa những người của bạn đang nói chồng lên nhau — và đại lượng đó không tồn tại cho tới khi bạn đo nó. Không ai công bố nó thay bạn được, vì không ai khác có tên mã của bạn trong bản ghi tham chiếu của họ.
Tin tốt là phép đo này rẻ. Một bản thu 12 phút, một ngày công chép tay cẩn thận, hai lệnh cài bằng pip, và một bảng điểm gọn trong một trang. Lựa chọn đắt đỏ là lựa chọn mà đa số các đội mặc định chọn: quyết định dựa trên một con số phần trăm đã công bố, rồi phát hiện ra khác biệt sáu tháng sau, trong một bản ghi chú nói rằng cả nhóm đã đồng ý với điều mà họ đã dứt khoát từ chối.
Bạn thà sai ở đâu hơn — ở một chữ số thập phân, hay ở một quyết định?
Telli.sh đứng ở đâu trong chuyện này: chúng tôi xây đúng những lớp mà bảng điểm này đặt trọng số cao nhất. Telli.sh chạy tách người nói, phân đoạn, tinh chỉnh và tóm tắt trên nền nhận dạng giọng nói, với bản dịch sang 44 ngôn ngữ đích và giao diện bằng 15 ngôn ngữ, bởi 90 điểm của bảng điểm ấy — phần không phải WER thô — mới là chỗ một bản ghi biến thành ghi chú mà ai đó hành động được. Nếu bạn muốn một điểm dữ liệu thật thay vì một benchmark, hãy đưa đoạn 12 phút của chính bạn chạy qua nó và chấm kết quả bằng quy trình phía trên.
Nguồn
- MeetEval — bộ công cụ đánh giá ghi chép cuộc họp — các lệnh cpWER, tcpWER, ORC-WER, MIMO-WER và DI-cpWER, định dạng SegLST, cùng ví dụ tính tay
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), truy xuất ngày 31 tháng 8 năm 2026 - JiWER — gói đánh giá nhận dạng giọng nói — WER, MER, WIL, WIP và CER qua khoảng cách chỉnh sửa tối thiểu của RapidFuzz
- dscore — công cụ chấm điểm phân tách người nói — DER bằng lỗi người nói cộng tiếng nói báo động giả cộng tiếng nói bị bỏ sót, theo mục 6.1 của kế hoạch đánh giá NIST RT-09
- Bảng xếp hạng speech-to-text của Artificial Analysis — phương pháp luận AA-WER v2 (~8 giờ gồm AA-AgentTalk 50%, VoxPopuli-Cleaned-AA 25%, Earnings22-Cleaned-AA 25%), số liệu năm mô hình dẫn đầu, ghi chú về bản tham chiếu đã làm sạch và ghi chú về việc cắt khúc Earnings22, tất cả truy xuất ngày 31 tháng 8 năm 2026
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), ngày 20 tháng 4 năm 2020 — các nhánh đa người nói có phân đoạn và không phân đoạn, cùng thiết kế thu âm bữa tối
- The AMI Meeting Corpus — 100 giờ ghi âm cuộc họp thu bằng micro cận miệng và micro trường xa đồng bộ
- MAI-Transcribe trong Azure Speech — Microsoft Learn — thiên lệch theo từ khóa và các giới hạn được ghi nhận
- Bài viết trước của chúng tôi về việc vì sao độ chính xác ghi chép chưa bao giờ là sản phẩm cuối