อัตราความผิดพลาด 10.0% เท่ากัน แต่ตัดสินใจตรงข้ามกัน: วิธีวัดความแม่นยำของการถอดเสียงการประชุม
อัตราความผิดพลาดของคำให้น้ำหนักกับคำว่า “ไม่” เท่ากับคำว่า “ที่” เป๊ะ ๆ นั่นคือเหตุผลที่ผลถอดเสียงการประชุมสองฉบับได้ 10.0% เท่ากันได้ แต่ใช้เป็นบันทึกการประชุมได้จริงเพียงฉบับเดียว นี่คือขั้นตอนการวัดแบบเต็ม: คลิปทดสอบ 12 นาทีที่สร้างตามสเปกของการประชุมจริง บันทึกอ้างอิงที่ตรึงกฎการนอร์มัลไลซ์ไว้ก่อน คำสั่ง cpWER และ DER ที่ใช้จริง และตารางคะแนนห้ามิติที่ให้ WER ดิบเพียง 10 คะแนนจาก 100
นี่คือบันทึกถอดเสียงจากเครื่องสองฉบับของประโยคยี่สิบคำเดียวกัน จากการประชุมทีมผลิตภัณฑ์
A — “Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review” (พรียาบอกว่าการย้ายระบบ Helios เลื่อนไป Q3 และเราไม่ควรเซ็นสัญญากับผู้ขายก่อนการตรวจสอบด้านความปลอดภัย)
B — “Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review” (…เลื่อนไป Q2 และเราควรเซ็นสัญญากับผู้ขายก่อนการตรวจสอบด้านความปลอดภัย)
แต่ละฉบับมีความผิดพลาดสองจุดพอดีเมื่อเทียบกับสิ่งที่พูดจริง แต่ละฉบับได้อัตราความผิดพลาดของคำที่ 10.0% ฉบับ A ทำคำว่า “the” หายไปสองครั้ง ส่วนฉบับ B เลื่อนกำหนดส่งให้เร็วขึ้นหนึ่งไตรมาส และลบคำว่า “not” ออกจากข้อผูกพัน
ถ้ากระบวนการประเมินของคุณจัดให้สองระบบนี้เท่ากัน ปัญหาอยู่ที่กระบวนการ ไม่ใช่ที่โมเดล
บทความนี้คือขั้นตอนการวัดที่เราจะยื่นให้คนที่ถูกสั่งให้เลือกเครื่องมือถอดเสียงให้ได้ภายในวันศุกร์ มันครอบคลุมว่าอัตราความผิดพลาดของคำนับอะไรบ้างอย่างแม่นยำ ทำไมตัวเลขนี้ถึงหลอกเราเป็นพิเศษกับเสียงจากการประชุม และโปรโตคอลห้าขั้นที่คุณรันได้ในบ่ายเดียวด้วยแพ็กเกจโอเพนซอร์สสองตัวกับไฟล์บันทึกเสียง 12 นาที เราเคยเขียนแยกไว้แล้วว่า ความแม่นยำของการถอดเสียงเพียงอย่างเดียวไม่เคยเป็นสิ่งที่ต้องส่งมอบ บทความนี้คือชิ้นคู่กัน — ไม่ใช่ข้อโต้แย้ง แต่เป็นวิธีการ
สรุปสั้น:
- WER คือ
(substitutions + deletions + insertions) ÷ reference wordsและทุกคำมีน้ำหนักเท่ากันหมด คำปฏิเสธ “not” กับคำนำหน้านาม “the” มีราคาเท่ากัน- ตารางจัดอันดับที่เผยแพร่กันบีบตัวเข้าหากันแล้ว บนกระดานอิสระของ Artificial Analysis ซึ่งดึงข้อมูลวันที่ 31 สิงหาคม 2026 โมเดลห้าอันดับแรกอยู่ระหว่าง 1.7% ถึง 2.6% AA-WER ซึ่งเป็นช่วงที่แคบเกินกว่าจะเลือกผู้ชนะออกมาได้
- ให้วัดห้ามิติแทน พร้อมถ่วงน้ำหนัก: คำที่แบกความหมาย (30) การระบุตัวผู้พูด (25) ตัวเลขและจำนวนเงิน (20) การแบ่งช่วง (15) และ WER ดิบ (10) เครื่องมือสำหรับส่วนที่ยากมีอยู่แล้ว —
cpWERและDERมาพร้อมกับ MeetEval ชุดเครื่องมือที่สร้างขึ้นเพื่อการแข่งขัน CHiME
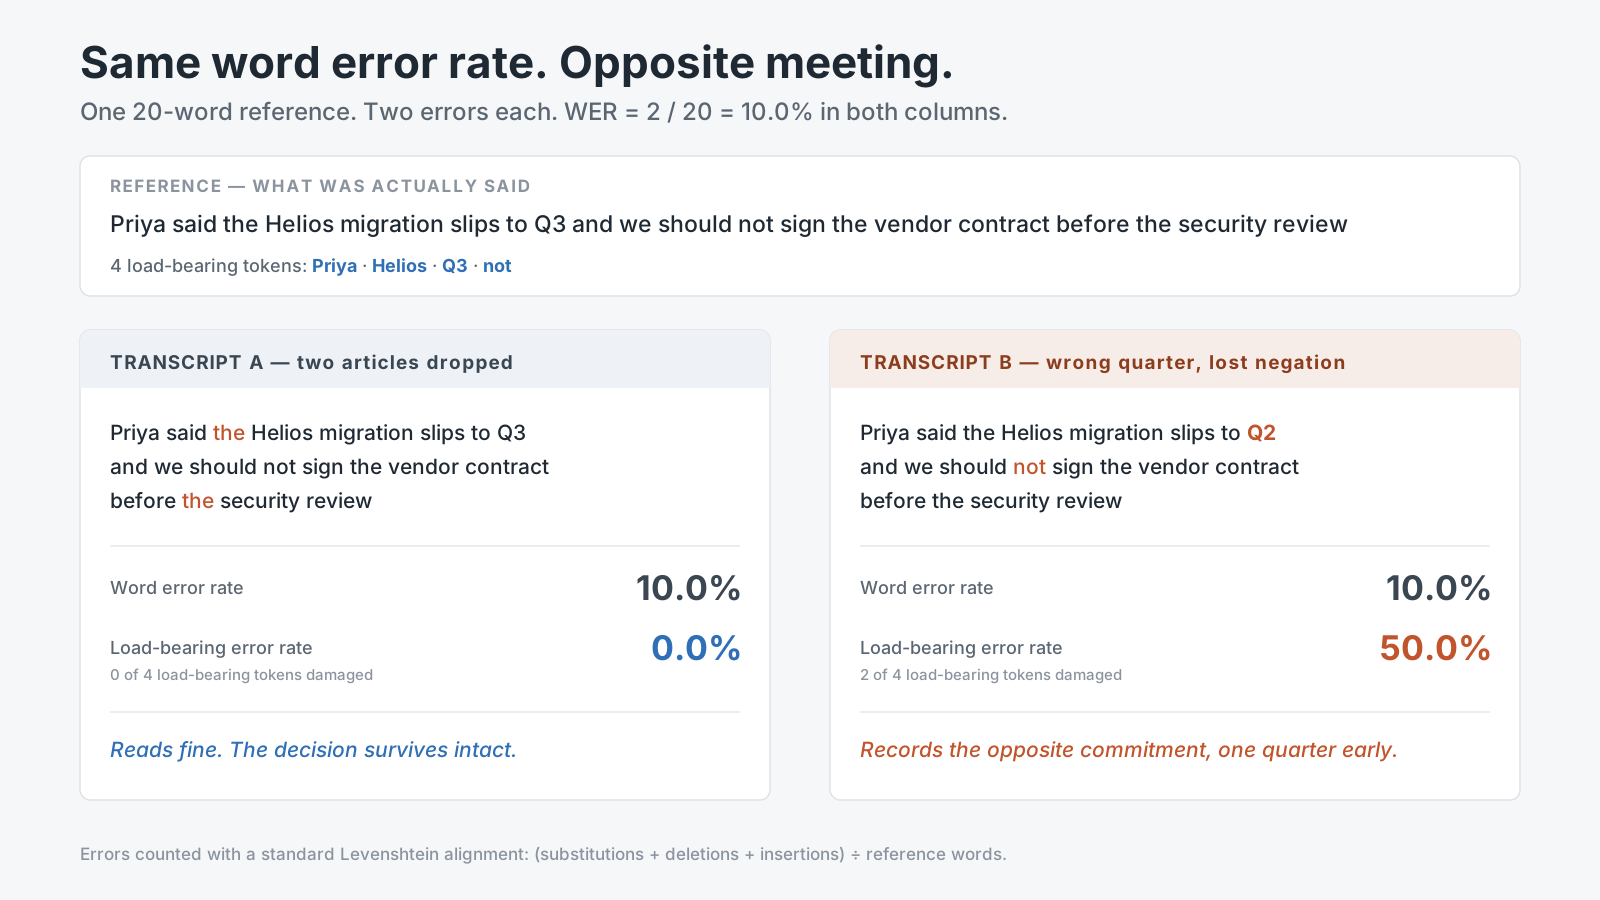
ทั้งสองคอลัมน์มีความผิดพลาดสองจุดเมื่อเทียบกับบันทึกอ้างอิง 20 คำ แต่มีเพียงฉบับเดียวที่ยังบันทึกการตัดสินใจซึ่งเกิดขึ้นจริงในห้องประชุมไว้ได้
อัตราความผิดพลาดของคำนับอะไรบ้าง เขียนออกมาให้ครบ
WER มาจากการจับคู่เพียงครั้งเดียว หยิบบันทึกอ้างอิงขึ้นมา — สิ่งที่มนุษย์ตกลงกันว่าถูกพูดออกมาจริง หยิบผลลัพธ์ของเครื่องขึ้นมา แล้วหาลำดับการแก้ไขที่ถูกที่สุดซึ่งเปลี่ยนฝั่งหนึ่งไปเป็นอีกฝั่ง โดยใช้การจับคู่แบบเลเวนชไตน์คลาสสิก จากนั้นติดป้ายให้การแก้ไขแต่ละจุด:
- การแทนที่ (substitution) เมื่อโมเดลเขียนคำอื่นออกมา (“deploy” ถูกได้ยินเป็น “delay”)
- การลบ (deletion) เมื่อคำในบันทึกอ้างอิงไม่มีคู่ในผลลัพธ์
- การแทรก (insertion) เมื่อโมเดลผลิตคำที่ไม่มีใครพูดออกมา
จากนั้น:
WER = (substitutions + deletions + insertions) ÷ reference words
ตัวส่วนคือความยาวของบันทึกอ้างอิง ไม่ใช่ความยาวของสมมติฐาน ซึ่งเป็นเหตุผลที่ WER เกิน 100% ได้อย่างชอบธรรม โมเดลที่หลอนอย่างอิสระสามารถสะสมการแทรกได้มากกว่าจำนวนคำที่มีอยู่ตั้งแต่แรก
ตัวอย่างที่คำนวณให้ดู ยกมาจากเอกสารของ MeetEval เองเพื่อให้ตรวจเลขย้อนกับผลลัพธ์ที่เผยแพร่ไว้ได้ บันทึกอ้างอิง: “The quick brown fox jumps over the lazy dog” — เก้าคำ สมมติฐาน: “The kwick brown fox jump over lazy” — เจ็ดคำ การจับคู่พบการแทนที่สองจุด (quick→kwick, jumps→jump) และการลบสองจุด (the, dog) ไม่มีการแทรกเลย นั่นคือ (2 + 2 + 0) ÷ 9 = 0.4444 หรือ WER เท่ากับ 44.4% และ MeetEval พิมพ์ออกมาตรงตามนั้น: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2)
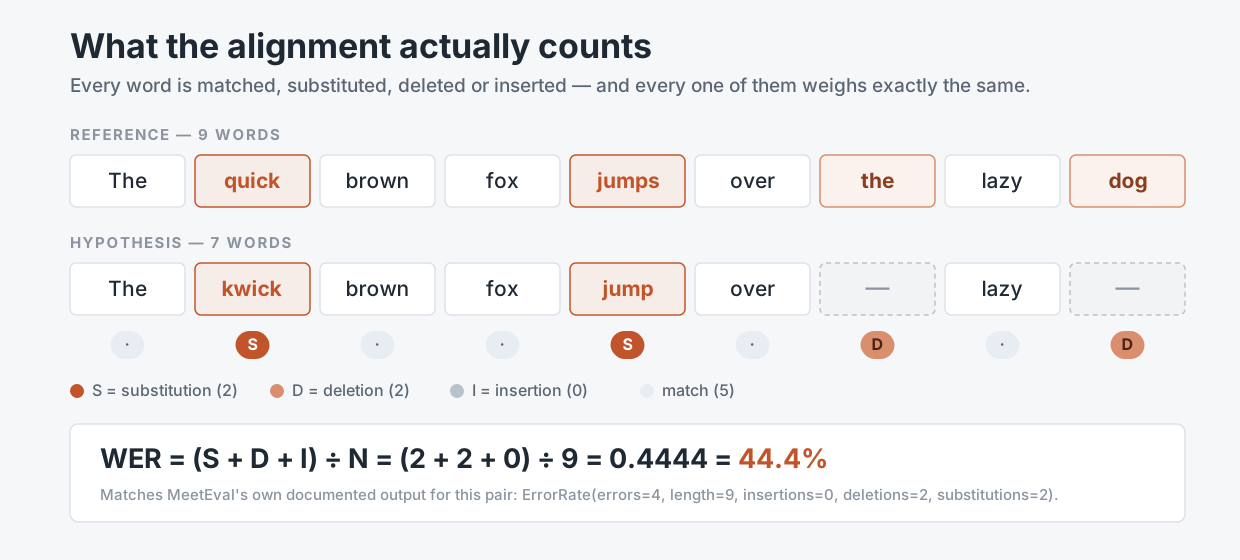
การจับคู่เป็นกลไกล้วน ๆ และทำซ้ำได้ สิ่งที่มันไม่ใช่คือการถ่วงน้ำหนัก ที่มา: เอกสารของ MeetEval ดึงข้อมูลวันที่ 31 สิงหาคม 2026
คุณสมบัติสองข้อของสูตรนี้สำคัญกว่าอะไรก็ตามบนหน้าเว็บขายของผู้ให้บริการ ข้อแรก มันเป็นตัววัดที่ แบนราบ ตัวชี้วัดนี้ไม่มีแนวคิดเลยว่าคำบางคำแบกทั้งการประชุมไว้ ขณะที่อีกหลายคำแบกแค่ไวยากรณ์ ข้อสอง มันเป็นตัววัดที่ มองไม่เห็นผู้พูด WER มาตรฐานเชื่อมทุกอย่างเป็นสายเดียว ระบบที่ถอดเสียงถูกทุกคำแต่ยกครึ่งหนึ่งไปให้ผิดคนจึงยังทำคะแนนสวยไร้ที่ติได้
ทำไมตัวเลขที่เผยแพร่จึงแยกผู้เข้าชิงของคุณออกจากกันไม่ได้อีกแล้ว
ดึงตารางจัดอันดับออกมา แล้วปัญหาจะกลายเป็นเรื่องเลขคณิตล้วน ๆ Artificial Analysis ซึ่งรันการประเมินของตัวเองแทนที่จะพิมพ์ซ้ำคำกล่าวอ้างของผู้ขาย ระบุโมเดลห้าอันดับแรกตาม AA-WER ณ วันที่ 31 สิงหาคม 2026 ไว้ว่า Fun-Realtime-ASR-preview ที่ 1.7% ตามด้วย ElevenLabs Scribe v2 ที่ 2.2% MAI-Transcribe-1.5 ของไมโครซอฟท์ที่ 2.4% Smallest AI Pulse Pro ที่ 2.4% และ Gemini 3.5 Transcribe ที่ 2.6% ส่วนโมเดลน้ำหนักเปิดที่ดีที่สุดอย่าง Voxtral Small ของ Mistral อยู่ที่ 2.8%
ยอดตลาดทั้งหมดอัดกันอยู่ในแถบกว้างเพียง 1.1 จุด สำหรับการประชุม 45 นาทีที่มีคำพูดราว 6,300 คำ ช่องว่างระหว่างอันดับหนึ่งกับอันดับห้าคิดเป็นราว 57 คำ หรือน้อยกว่าหนึ่งคำต่อหนึ่งหน้าจอของบันทึก
ยังมีปัญหาข้อที่สอง นั่นคือเสียงที่ใช้ทำเบนช์มาร์กไม่ใช่เสียงของคุณ AA-WER v2 เป็นค่าเฉลี่ยถ่วงน้ำหนักตามความยาวเสียง จากข้อมูลราวแปดชั่วโมงที่ดึงมาจากสามแหล่ง: AA-AgentTalk 50% VoxPopuli-Cleaned-AA 25% และ Earnings22-Cleaned-AA 25% สุนทรพจน์ในรัฐสภาและการแถลงผลประกอบการถูกบันทึกมาอย่างดี พูดทีละคนเป็นลำดับ และแทบไม่มีสิ่งที่นิยามการประชุมภายในองค์กรเลย นั่นคือคนสี่คนพูดแทรกกันเรื่องโครงการที่มีแต่พวกเขาเท่านั้นที่เคยได้ยิน
งานวิจัยเกี่ยวกับเสียงสนทนาจริง ๆ ปฏิบัติกับเรื่องนี้เป็นศาสตร์แยกต่างหากมาหลายปีแล้ว การแข่งขัน CHiME-6 ซึ่งเผยแพร่วันที่ 20 เมษายน 2020 โดย Watanabe, Mandel, Barker และผู้ร่วมเขียนอีกสิบแปดคน สร้างการประเมินขึ้นบนเสียงบันทึกงานเลี้ยงอาหารค่ำ ก็เพราะบทสนทนาตามธรรมชาติที่มีเสียงทับซ้อนและไมโครโฟนอยู่ไกล ทำให้ระบบที่ทำคะแนนดีกับเสียงอ่านพังลง ส่วนคลังข้อมูล AMI Meeting Corpus ที่มีเสียงบันทึก 100 ชั่วโมงจากทั้งหูฟังแบบติดปากและไมโครโฟนกลางห้อง ก็มีอยู่ด้วยเหตุผลเดียวกัน
ประเด็นอยู่ตรงนี้ และเราจะพูดโดยไม่อ้อมค้อม: ค่า WER ที่เผยแพร่บอกคุณได้ว่าโมเดลของผู้ขายรายนั้นไม่ได้พัง แต่มันบอกไม่ได้ว่าคุณควรซื้อจากใคร
สิ่งที่ WER จับได้ และสิ่งที่มันจับไม่ได้ในเชิงโครงสร้าง
| รูปแบบความล้มเหลว | WER ดิบจับได้ไหม | มันทำให้คุณเสียอะไร | อะไรที่วัดมันได้จริง |
|---|---|---|---|
| ฟังคำสามัญผิด (“their”/“there”) | ได้ เต็มน้ำหนัก | แทบไม่เสียอะไรเลย | WER |
| คำเติมและการพูดสะดุดหายไป | ได้ นับเป็นการลบ | ไม่เสียอะไร มักดีขึ้นด้วยซ้ำ | WER แบบชวนเข้าใจผิด |
| ชื่อเฉพาะเพี้ยน (“Xochitl” → “Societal”) | ได้ แต่หนักแค่ 1 คำ | ชื่อของคนที่ต้องรับผิดชอบ | อัตราความผิดพลาดของคำที่แบกความหมาย |
| ตัวเลขหรือวันที่ผิด (“Q3” → “Q2”) | ได้ หนักแค่ 1 คำ | กำหนดส่งที่พลาดไป | ความแม่นยำของตัวเลข วัดแยกต่างหาก |
| คำปฏิเสธถูกลบ (“should not” → “should”) | ได้ หนักแค่ 1 คำ | การตัดสินใจที่กลับหัวกลับหาง | อัตราความผิดพลาดของคำที่แบกความหมาย |
| คำถูกหมด แต่ผิดตัวผู้พูด | จับไม่ได้ เพราะ WER มองไม่เห็นผู้พูด | ไม่มีใครรู้ว่าใครรับปาก | cpWER, DER |
| ช่วงพูดของแต่ละคนถูกยุบเป็นก้อนเดียว | จับไม่ได้ | กำแพงตัวอักษรที่อ่านไม่ไหว | tcpWER พร้อม collar และการอ่านทวนโดยมนุษย์ |
| ไม่มีขอบเขตประโยค | จับไม่ได้ เพราะเครื่องหมายวรรคตอนถูกนอร์มัลไลซ์ทิ้ง | บทสรุปที่ต้องเดาโครงสร้างเอง | คะแนนการแบ่งช่วง และการอ่านทวนโดยมนุษย์ |
| ทั้งย่อหน้าถูกหลอนขึ้นมาระหว่างช่วงเงียบ | ได้บางส่วน ในรูปของการแทรก | เนื้อหาที่กุขึ้นถูกนำเสนอเป็นบันทึกทางการ | WER บวกกับจำนวนการแทรกที่อ่านแยก |
ครึ่งล่างของตารางนั้นคือครึ่งที่ตัดสินว่าบันทึกถอดเสียงจะกลายเป็นโน้ตที่ใช้งานได้หรือไม่ และ WER มาตรฐานมองไม่เห็นมันเลยสักข้อ นี่ไม่ใช่ข้อบกพร่องของตัวชี้วัด เพราะ WER ตอบคำถามที่มันถูกออกแบบมาให้ตอบในงานวิจัยการบอกจดของยุค 1990 ข้อบกพร่องอยู่ที่การใช้มันตัวเดียวโดด ๆ ในปี 2026
ขั้นที่ 1: สร้างคลิป 12 นาทีที่ประพฤติตัวเหมือนการประชุมจริง
อย่าประเมินด้วยไฟล์เดโมของผู้ขาย และอย่าประเมินด้วยคลังเสียงของคุณเองแปดชั่วโมง คุณต้องการคลิปเดียวที่สั้นพอจะถอดด้วยมือ และแน่นพอจะทำให้อะไร ๆ พังให้เห็น
ตั้งเป้าไว้ที่ 12 นาที ด้วยจังหวะการสนทนาปกติราว 140 คำต่อนาทีและความหนาแน่นของการพูดราว 75% คุณจะได้ คำอ้างอิงราว 1,260 คำ ซึ่งมากพอที่ความต่างของอัตราความผิดพลาด 2 จุดจะเท่ากับ 25 คำ ไม่ใช่สัญญาณรบกวนทางสถิติ และน้อยพอที่คนสองคนจะถอดอย่างพิถีพิถันได้ภายในบ่ายเดียว
จงสร้างคลิปตามสเปก ไม่ใช่ตามความรู้สึก สเปกของเราเป็นแบบนี้:
- ผู้พูดตั้งแต่สี่คนขึ้นไป โดยอย่างน้อยหนึ่งคนเข้าร่วมจากระยะไกลผ่านช่องสัญญาณเสียงที่ถูกบีบอัด และอย่างน้อยหนึ่งสำเนียงที่ไม่ใช่เจ้าของภาษาในภาษาที่ใช้ทำงาน
- เสียงทับซ้อนของจริงตั้งแต่เก้าสิบวินาทีขึ้นไป — คนสองคนพูดพร้อมกัน ใครสักคนพูดจบประโยคแทนอีกคน เสียงไอทับตอนที่กำลังตัดสินใจ เสียงพูดทับกันคือจุดที่การแยกผู้พูดพังเงียบ ๆ และคลิปที่ไม่มีมันก็ไม่ได้วัดอะไรเลย
- ศัพท์เฉพาะทางตั้งแต่ยี่สิบห้าคำขึ้นไป: ชื่อรหัสผลิตภัณฑ์ ตัวย่อภายในองค์กร ชื่อลูกค้า ชื่อผู้เข้าร่วม คำเหล่านี้คือคำที่มีความหมายต่อตัวอักษรสูงที่สุดในห้องประชุม และมีความถี่ต่ำที่สุดในคลังฝึกใด ๆ
- ตัวเลขตั้งแต่สิบห้าจำนวนขึ้นไป: วันที่ ไตรมาส จำนวนเงิน หมายเลขเวอร์ชัน เปอร์เซ็นต์ และจงตั้งใจพูดบางตัวให้กำกวม (“fifteen” กับ “fifty” ในนาทีเดียวกัน)
- การตัดสินใจเชิงปฏิเสธตั้งแต่สามครั้งขึ้นไป พูดออกมาอย่างเป็นธรรมชาติ เช่น “รอบนี้เราไม่ปล่อยตัวนั้น” หรือ “พักเรื่องสัญญาไว้ก่อน”
- การบันทึกสองชุดพร้อมกัน เท่าที่คุณจัดการได้ — ไมโครโฟนของตัวแล็ปท็อปเอง และแทร็กหูฟังแยกรายคน นั่นคือการออกแบบของคลังข้อมูล AMI และมันช่วยให้คุณแยก “โมเดลอ่อน” ออกจาก “ห้องประชุมเสียงดัง” ได้
บันทึกมันครั้งเดียว เก็บไฟล์ WAV แบบไม่บีบอัดที่ 16 kHz ขึ้นไป เครื่องมือทุกตัวที่คุณประเมินนับจากนี้จะได้รับไฟล์เดียวกันเป๊ะนี้ตลอดไป
ขั้นที่ 2: เขียนบันทึกอ้างอิง แล้วตรึงกฎการนอร์มัลไลซ์ก่อนจะคิดคะแนนใด ๆ
บันทึกอ้างอิงคือเครื่องมือวัด และมันมีแถบความคลาดเคลื่อนของมันเอง Artificial Analysis ดูแลชุดประเมินสาธารณะเวอร์ชัน “ทำความสะอาดแล้ว” ไว้ด้วยเหตุผลเฉพาะเจาะจงว่าบันทึกอ้างอิงต้นฉบับมีความผิดพลาดในการถอดเสียงของตัวเอง หมายเหตุของพวกเขาพูดตรง ๆ ว่าเวอร์ชันที่ทำความสะอาดแล้วนั้น “ลบความผิดพลาดในการถอดเสียงออกจากข้อความอ้างอิง เพื่อให้ได้ความจริงพื้นฐานที่แม่นยำขึ้นสำหรับการประเมินโมเดล” ถ้าผู้ดำเนินการเบนช์มาร์กยังต้องแก้ความจริงพื้นฐานที่ตัวเองเผยแพร่ไปแล้ว บันทึกรอบแรกของคุณก็ไม่ใช่พระคัมภีร์เหมือนกัน
ดังนั้น: ให้คนสองคนถอดแยกกัน แล้วมานั่งปรับทุกจุดที่ต่างกัน ตั้งงบเวลาไว้ห้าถึงแปดเท่าของเวลาจริงสำหรับคนคู่นั้น ซึ่งทำให้คลิป 12 นาทีกินเวลาราวหนึ่งวันทำงานเมื่อรวมแรงทั้งสองคน นี่คือต้นทุนก้อนใหญ่ที่สุดในกระบวนการทั้งหมดนี้ และไม่มีทางเลี่ยง
จากนั้นให้เขียนนโยบายการนอร์มัลไลซ์ของคุณลงไป ก่อน ที่จะคำนวณคะแนนสักตัว เพราะลำพังตัวเลือกเหล่านี้ก็ขยับตัวเลขสุดท้ายได้หลายจุดแล้ว:
- ตัวเลข: “Q3” เป็นโทเคนเดียวกับ “Q three” หรือไม่ “สี่หมื่น” เท่ากับ “40,000” หรือไม่
- รูปย่อ: “we're” นับว่าตรงกับ “we are” หรือไม่
- คำเติม: “um” “uh” และการพูดสะดุด อยู่ในบันทึกอ้างอิงหรือเปล่า และให้คะแนนด้วยหรือไม่
- ตัวพิมพ์ใหญ่เล็กและเครื่องหมายวรรคตอน: ปกติจะถูกตัดทิ้งก่อนคิดคะแนน ซึ่งแปลว่าเครื่องมือที่ใส่เครื่องหมายวรรคตอนได้สวยงามจะไม่ได้เครดิตตรงนี้เลย คุณจึงต้องไปให้คะแนนมันแยกในขั้นที่ 3
เก็บผลลัพธ์ไว้ในรูปแบบ SegLST ซึ่งเป็นรูปแบบ JSON ที่การแข่งขัน CHiME ใช้และเป็นค่าเริ่มต้นของ MeetEval: หนึ่งอ็อบเจ็กต์ต่อหนึ่งช่วง พร้อมฟิลด์ session_id, words, speaker, start_time และ end_time ฟิลด์ผู้พูดกับเวลานี่เองที่ทำให้ตัวชี้วัดซึ่งรับรู้ผู้พูดเป็นไปได้ และการย้อนกลับมาใส่ทีหลังนั้นทรมานมาก
ขั้นที่ 3: ให้คะแนนห้ามิติ และให้ WER ดิบสิบคะแนนจากร้อย
ติดตั้งเครื่องมือ — pip install jiwer meeteval — แล้วให้คะแนนแต่ละมิติบนคลิปเดียวกัน JiWER คำนวณ WER พร้อมกับ match error rate, word information lost, word information preserved และ character error rate โดยใช้การหาระยะการแก้ไขต่ำสุดที่ตั้งอยู่บน RapidFuzz ส่วน MeetEval คำนวณตัวชี้วัดที่เจาะจงกับการประชุม
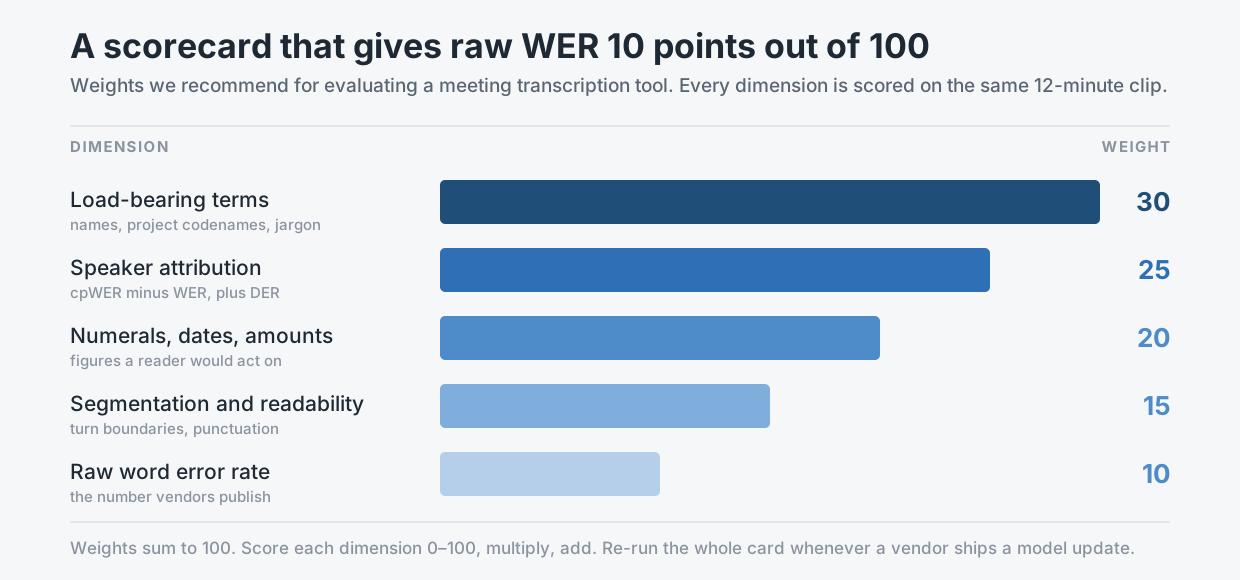
น้ำหนักที่เราแนะนำ มิติที่ผู้ขายทุกรายเอามาโฆษณา กลับเป็นมิติที่มีค่าน้อยที่สุด
คำที่แบกความหมาย — 30 คะแนน ทำเครื่องหมายทุกชื่อเฉพาะ ทุกชื่อรหัส และทุกชิ้นของศัพท์เฉพาะทางในบันทึกอ้างอิง จากนั้นคำนวณสูตร WER เดิมโดยนับเฉพาะโทเคนเหล่านั้น เราเรียกผลลัพธ์นี้ว่า อัตราความผิดพลาดของคำที่แบกความหมาย และมันคือตัวเลขเดียวที่ทำนายผลได้ดีที่สุดในแบบฝึกหัดทั้งหมดนี้ ในคู่บันทึกที่หัวบทความนี้ โทเคนที่แบกความหมายสี่ตัวคือ Priya, Helios, Q3 และ not ฉบับ A ไม่ทำเสียหายสักตัว อยู่ที่ 0.0% ส่วนฉบับ B ทำเสียหายสองตัว อยู่ที่ 50.0% WER โดยรวมเท่ากันที่ 10.0% แต่ห่างกันห้าสิบจุดบนตัวชี้วัดที่สำคัญจริง
การระบุตัวผู้พูด — 25 คะแนน รันคำสั่ง meeteval-wer cpwer -r ref.stm -h hyp.stm วิธี concatenated minimum-permutation WER จะหาการจับคู่ที่ดีที่สุดระหว่างผู้พูดในบันทึกอ้างอิงกับผู้พูดในสมมติฐาน เชื่อมคำของผู้พูดแต่ละคนเข้าด้วยกัน แล้วให้คะแนนผลลัพธ์ คำที่ถูกยกไปให้ผิดคนจึงกลายเป็นความผิดพลาด จากนั้นให้ลบกัน: cpWER ลบด้วย WER ธรรมดาคือช่องว่างของการระบุตัวผู้พูด ซึ่งเป็นสัดส่วนความเสียหายที่มาจากการไม่รู้ว่าใครพูดล้วน ๆ แล้วเติม diarization error rate เข้าไปเพื่อดูมุมของเวลา DER คือผลรวมของความผิดพลาดด้านผู้พูด เสียงพูดที่แจ้งเตือนผิด และเสียงพูดที่หลุดไป คิดเป็นเปอร์เซ็นต์ของเวลาที่นำมาให้คะแนน นิยามไว้ในหัวข้อ 6.1 ของแผนการประเมิน NIST RT-09 และถูกนำไปใช้จริงใน dscore ซึ่ง MeetEval ห่อไว้อีกชั้นและอ่านไฟล์ RTTM ได้ ถ้าผู้เข้าชิงของคุณรองรับไทม์สแตมป์ ให้ใช้ tcpwer --collar 5 แทน cpwer เพื่อไม่ให้คำที่ถูกต้องแต่ไปติดอยู่ผิดจังหวะเวลาถูกยกโทษให้เงียบ ๆ
ตัวเลข วันที่ และจำนวนเงิน — 20 คะแนน ดึงโทเคนที่เป็นตัวเลขทุกตัวออกจากบันทึกอ้างอิง แล้วให้คะแนนความแม่นยำแบบตรงตัวเทียบกับสมมติฐาน หลังจากใช้นโยบายการนอร์มัลไลซ์ที่คุณเขียนไว้แล้ว รายงานมันเป็นเศษส่วนตรง ๆ เช่น “ถูก 13 จาก 15” ไม่ใช่เป็นเปอร์เซ็นต์ เพราะจำนวนนับน้อยมาก และเปอร์เซ็นต์จะสื่อถึงความละเอียดที่คุณไม่มีจริง
การแบ่งช่วงและความอ่านง่าย — 15 คะแนน มิตินี้ต้องใช้คน ให้ผู้อ่านสองคนที่ไม่ได้เข้าประชุมอ่านผลลัพธ์ดิบ แล้วทำเครื่องหมายเป็นรายนาทีว่า ขอบเขตประโยคอยู่ผิดที่ตรงไหน ช่วงพูดของแต่ละคนถูกยุบเป็นก้อนเดียวตรงไหน และย่อหน้าไหนที่ต้องอ่านซ้ำถึงจะเข้าใจ เครื่องหมายวรรคตอนถูกนอร์มัลไลซ์ออกไปจากการคำนวณ WER แล้ว ที่นี่จึงเป็นที่เดียวที่มันถูกให้คะแนนเลย
อัตราความผิดพลาดของคำแบบดิบ — 10 คะแนน รัน jiwer แล้วจดตัวเลขไว้ มันเป็นการตรวจพื้นที่แท้จริง อะไรก็ตามที่สูงกว่าราว 12% บนเสียงสะอาดจากไมโครโฟนใกล้ปาก บ่งบอกถึงปัญหาทางเสียงของจริงที่ควรไปสืบต่อ แต่เหนือพื้นนั้นขึ้นไป มันแทบไม่แยกแยะอะไรได้เลย ซึ่งเป็นเหตุผลตรง ๆ ว่าทำไมมันถึงมีค่าสิบคะแนน ไม่ใช่แปดสิบ
ให้คะแนนแต่ละมิติในสเกล 0–100 คูณด้วยน้ำหนักของมัน แล้วบวกกัน ผลลัพธ์เทียบกันได้ข้ามเครื่องมือและข้ามเวลา ซึ่งคือประเด็นทั้งหมดของเรื่องนี้
ขั้นที่ 4: รันผู้เข้าชิงทุกรายบนไฟล์เดียวกันเป๊ะ แล้วจดไว้ว่า “เดียวกันเป๊ะ” หมายถึงอะไร
นี่คือขั้นที่ทีมส่วนใหญ่ข้าม และการข้ามมันทำให้ทุกอย่างก่อนหน้านี้เป็นโมฆะ
ไฟล์ WAV เดียวกัน อัตราสุ่มตัวอย่างเดียวกัน ไม่มีการเข้ารหัสใหม่ระหว่างผู้เข้าชิงแต่ละราย บันทึกอ้างอิงเดียวกัน นโยบายการนอร์มัลไลซ์เดียวกันที่รันด้วยสคริปต์ตัวเดียวกัน การแยกผู้พูดต้องถูกเปิดอย่างชัดเจนหรือปิดอย่างชัดเจนในทุกเครื่องมือ และต้องจดไว้ทั้งสองแบบ เพราะเครื่องมือที่ประเมินโดยปิดการแยกผู้พูดเทียบกับเครื่องมือที่เปิดไว้ไม่ได้ การถ่วงน้ำหนักด้วยคำสำคัญหรือชื่อเอนทิตีให้ปิดในรอบแรกและเปิดในรอบสอง จดไว้ทั้งสองรอบ ไมโครซอฟท์รายงานว่า WER ลดลงได้ถึง 30% จากการป้อนรายการคำสำคัญให้ MAI-Transcribe-1.5 ซึ่งมากพอที่การเปรียบเทียบซึ่งปนรอบที่ถ่วงน้ำหนักกับรอบที่ไม่ถ่วงจะหมดความหมายไปเลย
จับตาการจัดการเสียงยาวเป็นพิเศษ Artificial Analysis ต้องหั่นเสียง Earnings22 ของตัวเองเป็นท่อนราวเก้านาทีสำหรับโมเดลที่รับอินพุตเต็มความยาวได้ไม่น่าเชื่อถือ และเป็นท่อนราว 30 วินาทีสำหรับโมเดลที่มีข้อจำกัดแคบกว่า หมายเหตุที่พวกเขาเผยแพร่เองระบุชื่อ GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B และ Qwen3 ASR Flash ของอาลีบาบา ว่าอยู่ในกลุ่มระบบที่ได้รับผลกระทบ การหั่นท่อนเปลี่ยนผลลัพธ์ เพราะความผิดพลาดกระจุกตัวอยู่ตามรอยต่อ ถ้าผู้ขายหั่นไฟล์ของคุณ นั่นคือคุณสมบัติของผลิตภัณฑ์และควรอยู่ในตารางคะแนน ไม่ใช่สิ่งแปลกปลอมที่ต้องแก้ให้หายไป
สุดท้าย จดสตริงเวอร์ชันของโมเดลให้แม่นยำ พร้อมวันที่ของทุกรอบการรัน คำว่า “Whisper large-v3” ไม่ใช่เวอร์ชัน แต่ whisper-large-v3, run 2026-08-31 ต่างหากที่ใช่
ขั้นที่ 5: รันตารางคะแนนใหม่ตอนที่ผู้ขายปล่อยของ ไม่ใช่ตอนที่คุณนึกขึ้นได้
โมเดลเสียงพูดที่โฮสต์บนคลาวด์เปลี่ยนอยู่ใต้เท้าคุณ ชื่อเอนด์พอยต์คงเดิม แต่น้ำหนักที่อยู่เบื้องหลังมันไม่คงเดิม และไม่มีใครส่งอีเมลมาบอกคุณตอนที่โน้ตประชุมของคุณเริ่มจัดการชื่อเฉพาะได้แย่ลงนิดหน่อย
สัญญาณสามข้อนี้ควรกระตุ้นให้รันตารางคะแนนใหม่ทั้งใบ บนคลิปเดียวกับที่คุณสร้างไว้ในขั้นที่ 1:
- ผู้ขายเผยแพร่บันทึกการเปลี่ยนแปลง ที่แตะต้องตัวโมเดล ตัวแยกผู้พูด หรือชั้นเครื่องหมายวรรคตอนและการจัดรูปแบบ
- ครบรอบตามปฏิทิน — รายไตรมาสก็เพียงพอสำหรับทีมส่วนใหญ่ หรือรายเดือนถ้าผลลัพธ์การถอดเสียงถูกป้อนต่อเข้าสู่ระบบอัตโนมัติปลายทาง
- อัตราความผิดพลาดของคำที่แบกความหมายขยับเกิน 5 จุด ระหว่างสองรอบใด ๆ ซึ่งควรกระตุ้นให้เกิดการสืบสวนก่อนที่จะกระตุ้นให้ย้ายผู้ให้บริการ
เก็บทุกรอบไว้ในตารางเดียว: วันที่ สตริงเวอร์ชันโมเดล คะแนนทั้งห้ามิติ และผลรวมถ่วงน้ำหนัก หลังจากสามหรือสี่รอบ คุณจะเป็นเจ้าของสิ่งที่ไม่มีตารางจัดอันดับไหนให้คุณได้ นั่นคืออนุกรมเวลาว่าผลิตภัณฑ์หนึ่ง ๆ ทำงานอย่างไรกับเสียงที่ฟังแล้วเหมือนการประชุมจริงของคุณ
บรรทัดสุดท้าย: ความแม่นยำในการถอดเสียงการประชุมคือการวัดห้องประชุมของคุณ ไม่ใช่คุณสมบัติของโมเดล
อัตราความผิดพลาดของคำเป็นคุณสมบัติของโมเดลบนคลังข้อมูลหนึ่ง สิ่งที่คุณต้องการจริง ๆ คือคุณสมบัติของโมเดล บนเสียงของคุณ ด้วยคำศัพท์ของคุณ กับคนของคุณที่พูดทับกัน และปริมาณนั้นไม่มีอยู่จนกว่าคุณจะวัดมันเอง ไม่มีใครเผยแพร่มันแทนคุณได้ เพราะไม่มีใครมีชื่อรหัสของคุณอยู่ในบันทึกอ้างอิงของพวกเขา
ข่าวดีคือการวัดนี้ราคาถูก บันทึกเสียง 12 นาทีหนึ่งไฟล์ การถอดเสียงอย่างพิถีพิถันหนึ่งวันทำงาน การติดตั้งผ่าน pip สองครั้ง และตารางคะแนนที่ยาวไม่เกินหนึ่งหน้า ทางเลือกที่แพงคือทางที่ทีมส่วนใหญ่เลือกโดยอัตโนมัติ นั่นคือเลือกจากตัวเลขเปอร์เซ็นต์ที่เผยแพร่ แล้วมาค้นพบความต่างในอีกหกเดือนถัดมา ในโน้ตที่บอกว่าทีมตกลงกับสิ่งที่ทีมปฏิเสธไปอย่างชัดเจน
คุณอยากผิดพลาดกับเรื่องไหนมากกว่ากัน — ทศนิยมหนึ่งตำแหน่ง หรือการตัดสินใจหนึ่งครั้ง
Telli.sh อยู่ตรงไหนในเรื่องนี้: เราสร้างชั้นงานที่ตารางคะแนนนี้ให้น้ำหนักจริง ๆ Telli.sh รันการแยกผู้พูด การแบ่งช่วง การขัดเกลา และการสรุปความ ทับอยู่บนการรู้จำเสียงพูด พร้อมการแปลเป็น 44 ภาษาปลายทาง และอินเทอร์เฟซ 15 ภาษา เพราะ 90 คะแนนของตารางนั้นซึ่งไม่ใช่ WER ดิบ คือจุดที่บันทึกถอดเสียงกลายเป็นโน้ตที่ใครสักคนลงมือทำต่อได้ ถ้าคุณอยากได้จุดข้อมูลจริงแทนที่จะเป็นเบนช์มาร์ก ลองส่งคลิป 12 นาทีของคุณเองเข้าไป แล้วให้คะแนนผลลัพธ์ด้วยขั้นตอนข้างต้น
แหล่งข้อมูล
- MeetEval — ชุดเครื่องมือประเมินการถอดเสียงประชุม — คำสั่ง cpWER, tcpWER, ORC-WER, MIMO-WER และ DI-cpWER, รูปแบบ SegLST และตัวอย่างที่คำนวณให้ดู
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2)ดึงข้อมูลวันที่ 31 สิงหาคม 2026 - JiWER — แพ็กเกจประเมินการรู้จำเสียงพูด — WER, MER, WIL, WIP และ CER ผ่านระยะการแก้ไขต่ำสุดของ RapidFuzz
- dscore — เครื่องมือให้คะแนนการแยกผู้พูด — DER คือความผิดพลาดด้านผู้พูด บวกเสียงพูดที่แจ้งเตือนผิด บวกเสียงพูดที่หลุดไป ตามหัวข้อ 6.1 ของแผนการประเมิน NIST RT-09
- ตารางจัดอันดับ speech-to-text ของ Artificial Analysis — ระเบียบวิธี AA-WER v2 (~8 ชั่วโมง ประกอบด้วย AA-AgentTalk 50%, VoxPopuli-Cleaned-AA 25%, Earnings22-Cleaned-AA 25%) ตัวเลขห้าอันดับแรก หมายเหตุเรื่องบันทึกอ้างอิงที่ทำความสะอาดแล้ว และหมายเหตุเรื่องการหั่นท่อน Earnings22 ทั้งหมดดึงข้อมูลวันที่ 31 สิงหาคม 2026
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20 เมษายน 2020 — สายการแข่งขันแบบแบ่งช่วงและไม่แบ่งช่วงสำหรับหลายผู้พูด และการออกแบบการบันทึกเสียงงานเลี้ยงอาหารค่ำ
- The AMI Meeting Corpus — เสียงบันทึกการประชุม 100 ชั่วโมง เก็บด้วยไมโครโฟนติดปากและไมโครโฟนระยะไกลที่ซิงก์กัน
- MAI-Transcribe ใน Azure Speech — Microsoft Learn — การถ่วงน้ำหนักด้วยคำสำคัญ และข้อจำกัดที่บันทึกไว้
- บทความก่อนหน้าของเราว่าทำไมความแม่นยำของการถอดเสียงไม่เคยเป็นสิ่งที่ต้องส่งมอบ