Kadar ralat sama 10,0%, keputusan bertentangan: cara mengukur ketepatan transkripsi mesyuarat
Kadar ralat perkataan memberi wajaran serupa kepada perkataan «bukan» dan kata sandang biasa, lalu dua transkrip boleh sama-sama mendarat pada 10,0% sedangkan hanya satu yang benar-benar boleh dipakai. Inilah tatacara pengukurannya secara penuh: klip ujian 12 minit yang dibina mengikut spesifikasi mesyuarat, transkrip rujukan dengan peraturan penormalan yang dibekukan, arahan cpWER dan DER yang tepat, serta kad markah lima dimensi yang memberi WER mentah 10 mata daripada 100.
Inilah dua transkrip mesin bagi ayat dua puluh perkataan yang sama, dipetik daripada sebuah mesyuarat produk.
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review"
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review"
Setiap satu mengandungi tepat dua ralat berbanding apa yang sebenarnya diucapkan. Setiap satu mencatat kadar ralat perkataan sebanyak 10,0%. Transkrip A menggugurkan kata sandang "the" sebanyak dua kali. Transkrip B mengalihkan satu tarikh akhir ke hadapan sebanyak satu suku tahun dan memadamkan perkataan "not" daripada sebuah komitmen.
Sekiranya proses penilaian anda meletakkan dua sistem itu sebagai setara, yang bermasalah ialah prosesnya — bukan modelnya.
Tulisan ini ialah tatacara pengukuran yang bakal kami serahkan kepada sesiapa yang disuruh memilih alat transkripsi menjelang hari Jumaat. Kandungannya: apa sebenarnya yang dikira oleh kadar ralat perkataan; mengapa angka itu mengelirukan khususnya pada audio mesyuarat; dan sebuah protokol lima langkah yang boleh anda jalankan dalam satu petang menggunakan dua pakej sumber terbuka serta sebuah rakaman 12 minit. Secara berasingan kami pernah berhujah bahawa ketepatan transkripsi memang tidak pernah menjadi hasil akhirnya. Ini tulisan pasangannya — bukan hujahnya, tetapi kaedahnya.
Ringkasan:
- WER ialah
(substitutions + deletions + insertions) ÷ reference words, dan setiap perkataan membawa wajaran yang serupa. Penafian «bukan» dan kata sandang biasa berkos sama.- Papan pendahulu yang diterbitkan sudah memampat. Pada papan bebas Artificial Analysis, dicapai 31 Ogos 2026, lima model teratas berada antara 1,7% dan 2,6% AA-WER — julat yang terlalu sempit untuk memilih pemenang.
- Nilaikan lima dimensi sebaliknya, dengan wajaran: istilah penanggung makna (30), pengatributan penutur (25), angka dan jumlah wang (20), segmentasi (15), WER mentah (10). Alat bagi bahagian yang sukar sudah pun wujud —
cpWERdanDERterkandung dalam MeetEval, kit yang dibina untuk siri cabaran CHiME.
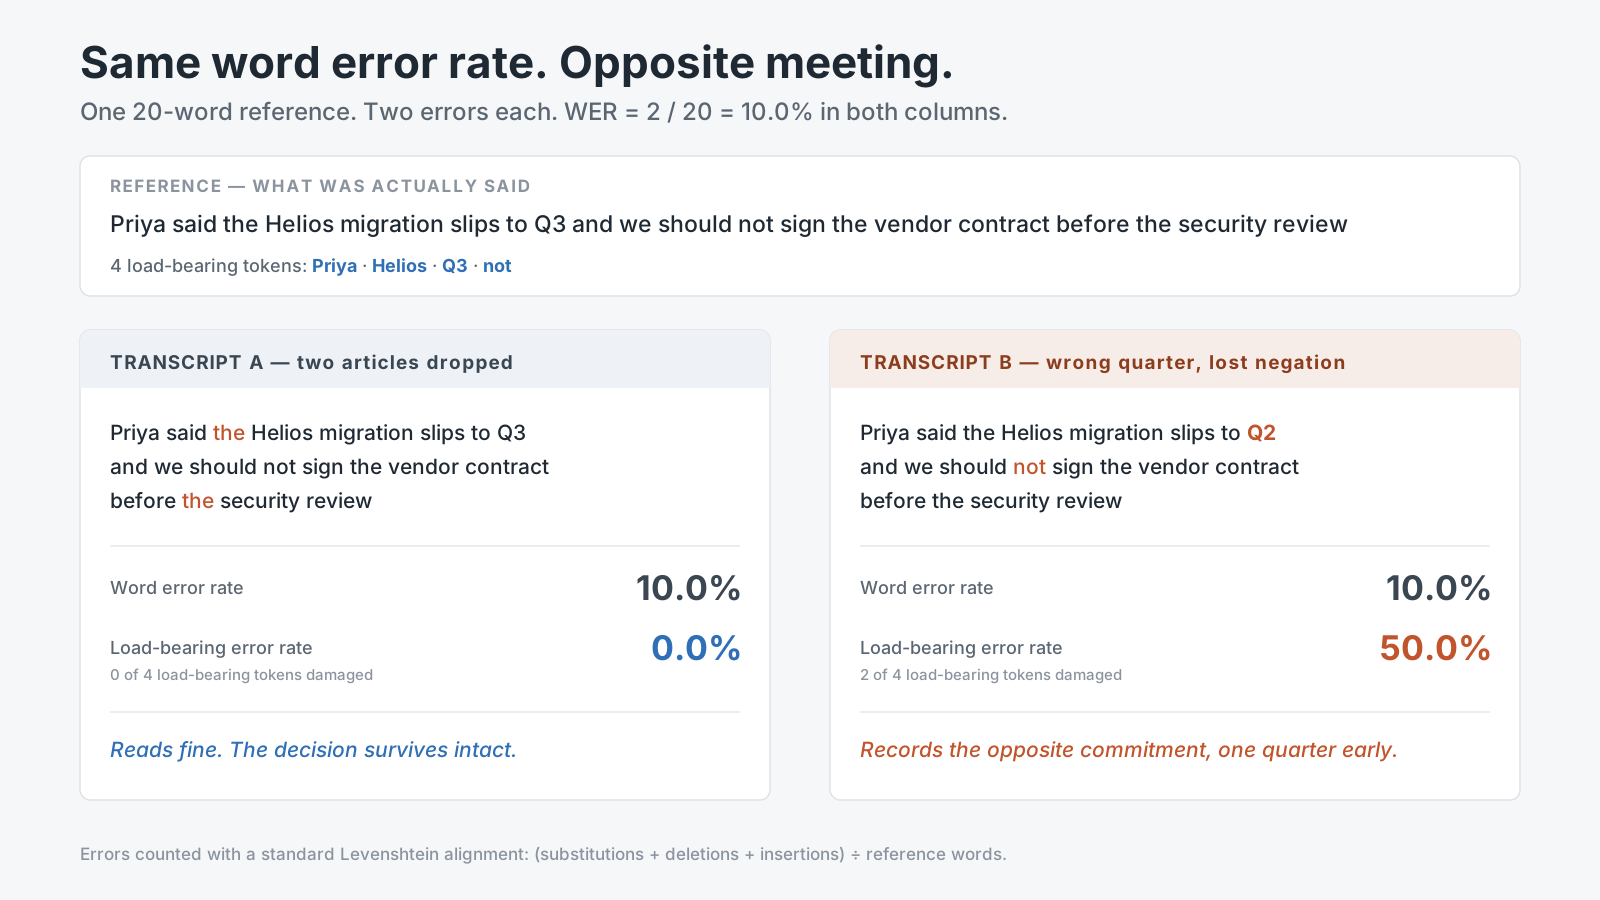
Kedua-dua lajur mengandungi dua ralat berbanding rujukan sepanjang 20 perkataan. Hanya satu daripadanya masih merakam keputusan yang benar-benar dibuat di dalam bilik itu.
Apa yang sebenarnya dikira oleh kadar ralat perkataan, ditulis sepenuhnya
WER terhasil daripada satu penjajaran tunggal. Ambil transkrip rujukan — apa yang manusia bersetuju telah diucapkan. Ambil keluaran mesin. Cari urutan suntingan termurah yang menukar satu menjadi satu lagi, menggunakan penjajaran Levenshtein klasik, kemudian labelkan setiap suntingan:
- penggantian apabila model menulis perkataan yang berlainan ("deploy" terdengar sebagai "delay"),
- pengguguran apabila sesuatu perkataan rujukan tiada pasangannya dalam keluaran,
- penyisipan apabila model menghasilkan perkataan yang tidak diucapkan sesiapa pun.
Kemudian:
WER = (substitutions + deletions + insertions) ÷ reference words
Penyebutnya ialah panjang rujukan, bukan panjang hipotesis, dan itulah sebabnya WER boleh melebihi 100% secara sah — model yang berhalusinasi tanpa kekangan mampu mengumpul lebih banyak penyisipan daripada bilangan perkataan yang ada pada mulanya.
Satu contoh terkira, dipetik daripada dokumentasi MeetEval sendiri supaya aritmetiknya boleh disemak berbanding keluaran yang telah diterbitkan. Rujukan: "The quick brown fox jumps over the lazy dog" — sembilan perkataan. Hipotesis: "The kwick brown fox jump over lazy" — tujuh perkataan. Penjajaran itu menemui dua penggantian (quick→kwick, jumps→jump) serta dua pengguguran (the, dog), tanpa penyisipan. Itu bersamaan (2 + 2 + 0) ÷ 9 = 0,4444, iaitu WER sebanyak 44,4%, dan MeetEval mencetak tepat begitu: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
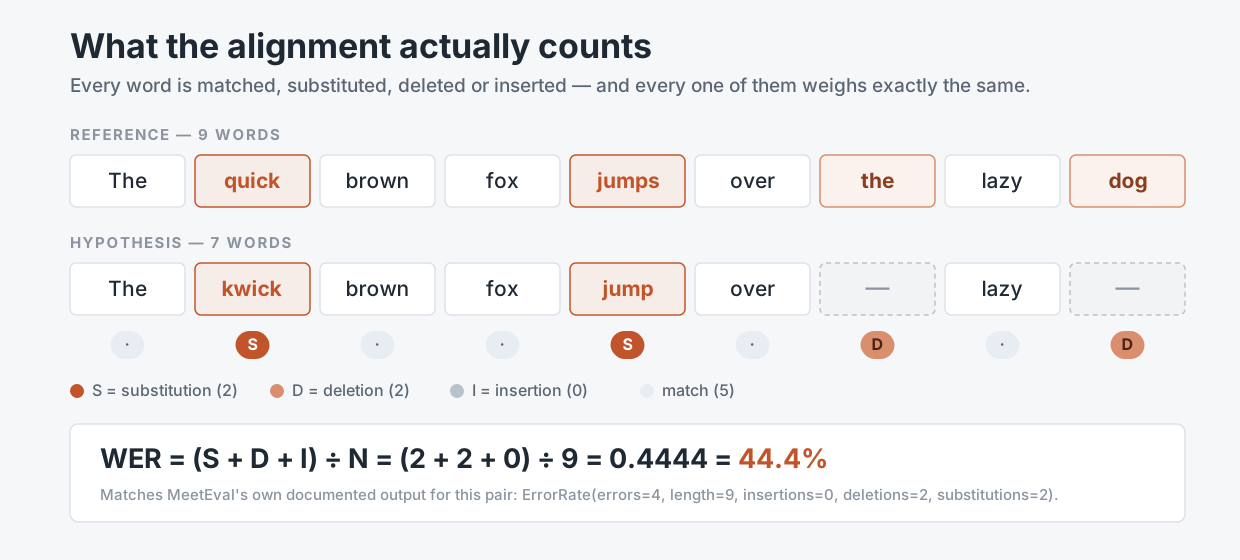
Penjajarannya bersifat mekanikal dan boleh diulang. Apa yang tiada padanya ialah wajaran. Sumber: dokumentasi MeetEval, dicapai 31 Ogos 2026.
Dua sifat rumus itu lebih penting daripada apa-apa jua yang tertera pada laman promosi vendor. Pertama, ia rata: metrik ini langsung tidak tahu bahawa sesetengah perkataan menanggung isi mesyuarat manakala yang lain hanya menanggung tatabahasa. Kedua, ia buta penutur: WER piawai mencantumkan segalanya menjadi satu aliran, jadi sistem yang mentranskripsi setiap perkataan dengan sempurna tetapi mengatributkan separuhnya kepada orang yang salah masih boleh memaparkan markah yang bersih.
Mengapa angka terbitan sudah tidak mampu membezakan calon anda
Tarik papan pendahulunya dan masalahnya bertukar menjadi aritmetik. Artificial Analysis, yang menjalankan penilaiannya sendiri dan bukan mencetak semula dakwaan vendor, menyenaraikan lima model teratasnya mengikut AA-WER pada 31 Ogos 2026 sebagai Fun-Realtime-ASR-preview pada 1,7%, ElevenLabs Scribe v2 pada 2,2%, MAI-Transcribe-1.5 milik Microsoft pada 2,4%, Smallest AI Pulse Pro pada 2,4%, dan Gemini 3.5 Transcribe pada 2,6%. Model pemberat terbuka terbaik, Voxtral Small daripada Mistral, berada pada 2,8%.
Keseluruhan puncak pasaran itu muat dalam jalur selebar 1,1 mata. Bagi mesyuarat 45 minit yang mengandungi lebih kurang 6.300 patah perkataan terucap, jurang antara kedudukan pertama dengan kedudukan kelima menyamai kira-kira 57 patah perkataan — kurang daripada satu patah bagi setiap skrin transkrip.
Ada masalah kedua, iaitu audio penanda aras itu bukan audio anda. AA-WER v2 ialah purata berwajaran tempoh audio merentas kira-kira lapan jam rakaman yang diambil daripada tiga sumber: AA-AgentTalk sebanyak 50%, VoxPopuli-Cleaned-AA sebanyak 25%, dan Earnings22-Cleaned-AA sebanyak 25%. Ucapan parlimen dan panggilan laporan pendapatan dirakam dengan baik, dituturkan bergilir-gilir, dan sebahagian besarnya bebas daripada perkara yang justru mentakrifkan mesyuarat dalaman — empat orang mencelah antara satu sama lain tentang projek yang hanya mereka sahaja pernah dengar.
Penyelidikan terhadap audio yang benar-benar bersifat perbualan telah lama memperlakukan hal ini sebagai bidang tersendiri. Cabaran CHiME-6, diterbitkan pada 20 April 2020 oleh Watanabe, Mandel, Barker bersama lapan belas penulis bersama, membina penilaiannya di atas rakaman jamuan makan malam justeru kerana perbualan semula jadi yang bertindih dan mikrofon berjauhan meranapkan sistem yang bermarkah tinggi pada ucapan bacaan. AMI Meeting Corpus, 100 jam rakaman yang dirakam serentak menggunakan set kepala dekat mulut dan mikrofon bilik jarak jauh, wujud atas sebab yang sama.
Inilah intinya, dan kami menyatakannya tanpa berselindung: WER yang diterbitkan hanya memberitahu anda bahawa model sesuatu vendor itu tidak rosak. Ia tidak mampu memberitahu anda vendor mana yang patut dibeli.
Apa yang tertangkap oleh WER dan apa yang secara struktur tidak mungkin ditangkapnya
| Mod kegagalan | Ditangkap WER mentah? | Apa kosnya kepada anda | Apa yang benar-benar mengukurnya |
|---|---|---|---|
| Perkataan biasa tersalah dengar («their»/«there») | Ya, dengan wajaran penuh | Hampir tiada | WER |
| Bunyi sisipan dan permulaan tergendala digugurkan | Ya, dikira sebagai pengguguran | Tiada — selalunya malah penambahbaikan | WER, secara mengelirukan |
| Kata nama khas rosak («Xochitl» → «Societal») | Ya, tetapi berwajaran 1 perkataan | Nama orang yang bertanggungjawab | Kadar ralat istilah penanggung |
| Angka atau tarikh tersalah («Q3» → «Q2») | Ya, berwajaran 1 perkataan | Tarikh akhir yang terlepas | Ketepatan angka, dinilai berasingan |
| Penafian terpadam («should not» → «should») | Ya, berwajaran 1 perkataan | Keputusan yang terbalik | Kadar ralat istilah penanggung |
| Perkataan betul, penutur salah | Tidak — WER buta penutur | Tiada sesiapa tahu siapa yang berjanji | cpWER, DER |
| Giliran penutur bercantum menjadi satu blok | Tidak | Dinding teks yang tidak terbaca | tcpWER berserta collar, bacaan oleh manusia |
| Sempadan ayat hilang | Tidak — tanda baca dinormalkan keluar | Ringkasan yang meneka-neka strukturnya | Markah segmentasi, bacaan oleh manusia |
| Seluruh petikan dihalusinasi ketika senyap | Sebahagian — sebagai penyisipan | Kandungan rekaan disajikan sebagai rekod | WER berserta kiraan penyisipan yang dibaca berasingan |
Separuh bawah jadual itulah yang menentukan sama ada sesebuah transkrip menjelma menjadi minit yang berguna, dan WER piawai langsung tidak melihatnya. Itu bukan kecacatan pada metriknya — WER menjawab soalan yang memang direka untuknya dalam penyelidikan pengimlakan tahun 1990-an. Yang cacat ialah penggunaannya secara bersendirian pada tahun 2026.
Langkah 1: bina klip 12 minit yang berkelakuan seperti mesyuarat sebenar
Jangan menilai menggunakan fail demonstrasi vendor dan jangan pula menilai menggunakan lapan jam arkib anda sendiri. Anda memerlukan satu klip yang cukup pendek untuk ditranskripsi dengan tangan dan cukup padat untuk meranapkan pelbagai perkara.
Sasarkan 12 minit. Pada kelajuan perbualan biasa kira-kira 140 patah perkataan seminit dan ketumpatan pertuturan lebih kurang 75%, itu menghasilkan sekitar 1.260 patah perkataan rujukan — cukup banyak sehingga perbezaan 2% pada kadar ralat bermakna 25 patah perkataan dan bukan hingar statistik, dan cukup sedikit sehingga dua orang boleh mentranskripsikannya dengan teliti dalam satu petang.
Bina klip itu mengikut spesifikasi, bukan mengikut rasa hati. Spesifikasi kami:
- Empat penutur atau lebih, termasuk sekurang-kurangnya seorang yang menyertai dari jauh melalui saluran audio termampat, dan sekurang-kurangnya satu loghat bukan penutur jati dalam bahasa kerja.
- Sembilan puluh saat atau lebih pertindihan yang tulen — dua orang bercakap serentak, seseorang menghabiskan ayat orang lain, batuk yang menutupi sesuatu keputusan. Pertuturan bersilang ialah tempat diarisasi runtuh secara senyap, dan klip yang tiada padanya tidak mengukur apa-apa.
- Dua puluh lima istilah domain atau lebih: nama kod produk, akronim dalaman, nama pelanggan, nama hadirin. Inilah perkataan yang paling tinggi makna bagi setiap aksara di dalam bilik dan paling rendah kekerapannya dalam mana-mana korpus latihan.
- Lima belas angka atau lebih: tarikh, suku tahun, jumlah mata wang, nombor versi, peratusan. Sebut sebahagiannya secara taksa dengan sengaja («lima belas» dan «lima puluh» dalam minit yang sama).
- Tiga keputusan bernafi atau lebih, dinyatakan secara semula jadi: «kita takkan hantar itu dalam keluaran ini», «kita tangguh dulu kontrak tersebut».
- Dua rakaman serentak jika anda mampu menguruskannya — mikrofon komputer riba itu sendiri dan trek set kepala bagi setiap penutur. Itulah reka bentuk korpus AMI, dan ia membolehkan anda mengasingkan «modelnya lemah» daripada «biliknya bising».
Rakam sekali sahaja. Simpan failnya dalam WAV tanpa mampatan pada 16 kHz atau lebih baik. Setiap alat yang anda nilai mulai saat ini menerima fail yang serupa ini, selama-lamanya.
Langkah 2: tulis rujukannya — kemudian bekukan peraturan penormalan sebelum menilai apa-apa
Transkrip rujukan ialah alat pengukur, dan ia mempunyai palang ralatnya sendiri. Artificial Analysis menyelenggara versi «dibersihkan» bagi set penilaian awamnya justeru kerana transkrip rujukan asalnya sendiri mengandungi ralat transkripsi; nota mereka berterus terang mengenainya — versi yang dibersihkan itu «membuang ralat transkripsi daripada teks rujukan, lalu menyediakan kebenaran asas yang lebih tepat untuk penilaian model». Jika pengendali penanda aras pun terpaksa membetulkan kebenaran asas yang telah diterbitkan, transkrip pusingan pertama anda juga bukanlah kitab suci.
Jadi: dua orang mentranskripsi secara berasingan, kemudian menyelaraskan setiap perbezaan. Peruntukkan lima hingga lapan kali masa sebenar bagi pasangan itu, yang meletakkan klip 12 minit pada lebih kurang satu hari bekerja usaha gabungan. Itulah kos tunggal terbesar dalam keseluruhan tatacara ini dan tiada jalan untuk mengelakkannya.
Kemudian catatkan dasar penormalan anda sebelum anda mengira walau satu markah, kerana pilihan-pilihan berikut dengan sendirinya menganjak angka akhir sebanyak beberapa mata:
- Nombor: adakah «Q3» token yang sama dengan «Q tiga»? Adakah «empat puluh ribu» bersamaan «40.000»?
- Bentuk singkatan: adakah «we're» sepadan dengan «we are»?
- Bunyi sisipan: adakah «um», «uh» dan permulaan tergendala hadir di dalam rujukan langsung, dan adakah ia dinilai?
- Huruf besar dan tanda baca: lazimnya dilucutkan sebelum penilaian — bermakna alat yang meletakkan tanda baca dengan cantik langsung tidak mendapat kredit di sini, dan anda mesti menilainya berasingan dalam langkah 3.
Simpan hasilnya dalam SegLST, format JSON yang digunakan siri cabaran CHiME dan menjadi lalai MeetEval: satu objek bagi setiap segmen dengan session_id, words, speaker, start_time dan end_time. Medan penutur dan pemasaan itulah yang membolehkan metrik peka penutur, dan memasangnya semula kemudian hari amat menyeksakan.
Langkah 3: nilai lima dimensi, dan beri WER mentah sepuluh mata daripada seratus
Pasang alatnya — pip install jiwer meeteval — kemudian nilai setiap dimensi pada klip yang sama. JiWER mengira WER bersama match error rate, word information lost, word information preserved dan character error rate, menggunakan pelaksanaan jarak suntingan minimum RapidFuzz. MeetEval pula mengira metrik yang khusus untuk mesyuarat.
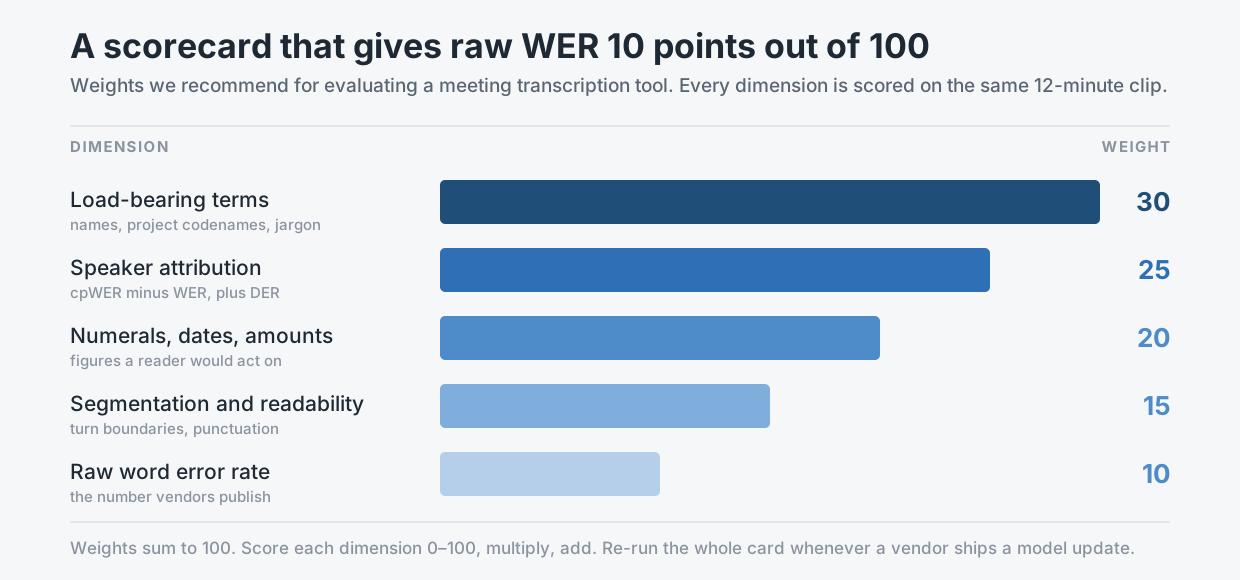
Wajaran yang kami syorkan. Dimensi yang diiklankan setiap vendor ialah dimensi yang bernilai paling sedikit mata.
Istilah penanggung makna — 30 mata. Tandakan setiap kata nama khas, nama kod dan serpihan jargon domain di dalam rujukan. Kemudian kira rumus WER yang sama hanya ke atas token-token itu. Hasilnya kami panggil kadar ralat istilah penanggung, dan itulah angka paling meramal dalam keseluruhan latihan ini. Pada pasangan transkrip di bahagian awal tulisan ini, empat token penanggungnya ialah Priya, Helios, Q3 dan not. Transkrip A tidak merosakkan satu pun: 0,0%. Transkrip B merosakkan dua: 50,0%. WER keseluruhan sama-sama 10,0%, dengan jurang lima puluh mata pada metrik yang benar-benar bermakna.
Pengatributan penutur — 25 mata. Jalankan meeteval-wer cpwer -r ref.stm -h hyp.stm. Concatenated minimum-permutation WER mencari pemetaan terbaik antara penutur rujukan dengan penutur hipotesis, mencantumkan perkataan setiap penutur, lalu menilai hasilnya — sehingga perkataan yang diatributkan kepada orang yang salah menjadi ralat. Kemudian tolak: cpWER ditolak WER biasa ialah jurang pengatributan, iaitu bahagian kerosakan yang berpunca semata-mata daripada tidak diketahuinya siapa yang bercakap. Tambahkan diarization error rate untuk pandangan pemasaan; DER ialah hasil tambah ralat penutur, pertuturan penggera palsu dan pertuturan tercicir sebagai peratusan daripada masa yang dinilai, ditakrifkan dalam seksyen 6.1 pelan penilaian NIST RT-09 dan dilaksanakan dalam dscore, yang dibalut oleh MeetEval dan yang membaca fail RTTM. Sekiranya calon anda menyokong cap masa, gunakan tcpwer --collar 5 menggantikan cpwer supaya perkataan yang betul tetapi terlekat pada saat yang salah tidak diampunkan secara senyap.
Angka, tarikh dan jumlah wang — 20 mata. Cungkil setiap token berangka daripada rujukan lalu nilai ketepatan padanan tepatnya berbanding hipotesis, selepas menerapkan dasar penormalan bertulis anda. Laporkannya sebagai pecahan biasa — «13 daripada 15 betul» — dan bukan sebagai peratusan, kerana bilangannya kecil dan peratusan menyiratkan kejituan yang anda sebenarnya tidak miliki.
Segmentasi dan kebolehbacaan — 15 mata. Yang satu ini bergantung pada manusia. Minta dua pembaca yang tidak menghadiri mesyuarat itu membaca keluaran mentahnya lalu menandakan, bagi setiap minit: sempadan ayat yang tersalah letak, giliran penutur yang bercantum menjadi satu blok, dan perenggan yang menuntut bacaan berulang. Tanda baca sudah dinormalkan keluar daripada pengiraan WER anda, jadi di sinilah satu-satunya tempat ia dinilai langsung.
Kadar ralat perkataan mentah — 10 mata. Jalankan jiwer lalu catat angkanya. Ia benar-benar berguna sebagai semakan lantai: apa-apa yang melebihi kira-kira 12% pada audio dekat mulut yang bersih menandakan masalah akustik sebenar yang berbaloi disiasat. Melepasi lantai itu, ia hampir tidak membezakan apa-apa, dan itulah tepatnya sebab ia bernilai sepuluh mata dan bukan lapan puluh.
Nilai setiap dimensi pada julat 0–100, darabkan dengan wajarannya, kemudian jumlahkan. Hasilnya boleh dibandingkan merentas alat dan merentas masa, dan itulah keseluruhan tujuannya.
Langkah 4: jalankan setiap calon pada fail yang serupa, dan catatkan apa maksud «serupa» itu
Inilah langkah yang dilangkau pasukan, dan ia membatalkan segala-galanya di hulunya.
WAV yang sama, kadar pensampelan yang sama, tanpa pengekodan semula antara calon. Rujukan yang sama, dasar penormalan yang sama dikenakan oleh skrip yang sama. Diarisasi dihidupkan secara jelas atau dimatikan secara jelas pada setiap alat, dan dicatatkan yang mana pun pilihannya — alat yang dinilai dengan diarisasi dimatikan tidak setanding dengan alat yang dinilai dengan diarisasi dihidupkan. Pemberatan kata kunci atau entiti dimatikan pada pusingan pertama dan dihidupkan pada pusingan kedua, kedua-duanya dicatatkan; Microsoft melaporkan pengurangan WER sehingga 30% daripada pemberian senarai kata kunci kepada MAI-Transcribe-1.5, iaitu jumlah yang cukup besar sehingga perbandingan yang mencampurkan pusingan berpemberatan dengan pusingan tanpa pemberatan menjadi tidak bermakna.
Perhatikan pengendalian audio panjang secara khusus. Artificial Analysis terpaksa mencantas audio Earnings22 miliknya kepada kira-kira sembilan minit bagi model yang tidak mampu mengendalikan input panjang penuh secara boleh harap, dan kepada kira-kira 30 saat bagi model yang batasnya lebih ketat — nota terbitan mereka sendiri menamakan GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B dan Qwen3 ASR Flash daripada Alibaba antara sistem yang terjejas. Pencantasan mengubah keputusan, kerana ralat berkelompok pada sempadan potongan. Jika sesuatu vendor mencantas fail anda, itu ialah sifat produknya dan tempatnya di dalam kad markah, bukan artifak yang perlu dibetulkan sehingga hilang.
Akhir sekali, rekodkan rentetan versi model yang tepat berserta tarikh bagi setiap larian. «Whisper large-v3» bukan versi; whisper-large-v3, run 2026-08-31 barulah versi.
Langkah 5: jalankan semula kadnya apabila vendor mengeluarkan sesuatu, bukan apabila anda terkenang
Model pertuturan yang dihoskan berubah di bawah kaki anda. Nama titik akhirnya kekal sama sedangkan pemberat di sebaliknya tidak, dan tiada sesiapa menghantar e-mel kepada anda apabila minit mesyuarat anda menjadi sedikit lebih lemah pada kata nama khas.
Tiga pencetus sepatutnya menyalakan larian semula kad penuh, pada klip yang sama yang anda bina dalam langkah 1:
- Vendor menerbitkan catatan changelog yang menyentuh modelnya, pendiarinya, atau lapisan tanda baca dan pemformatannya.
- Satu selang kalendar berlalu — suku tahunan sudah memadai bagi kebanyakan pasukan, bulanan jika keluaran transkripsi menyuap apa-apa yang automatik di hilirnya.
- Kadar ralat istilah penanggung anda beranjak lebih daripada 5 mata antara mana-mana dua larian, yang sepatutnya mencetuskan siasatan sebelum mencetuskan penghijrahan.
Simpan setiap larian dalam satu jadual: tarikh, rentetan versi model, kelima-lima markah dimensi, jumlah berwajaran. Selepas tiga atau empat larian anda memiliki sesuatu yang tidak mampu diberikan mana-mana papan pendahulu — satu siri masa tentang bagaimana sesebuah produk tertentu berprestasi pada audio yang bunyinya seperti mesyuarat anda yang sebenar.
Kesimpulannya: ketepatan ialah ukuran tentang bilik anda, bukan sifat semula jadi model
Kadar ralat perkataan ialah sifat sesebuah model pada sesebuah korpus. Apa yang sebenarnya anda perlukan ialah sifat sesebuah model pada audio anda, bagi perbendaharaan kata anda, dengan orang anda bercakap bertindih-tindih — dan kuantiti itu tidak wujud sehingga anda mengukurnya. Tiada sesiapa boleh menerbitkannya untuk anda, kerana tiada sesiapa lain memiliki nama kod anda di dalam transkrip rujukan mereka.
Berita baiknya, pengukuran itu murah. Satu rakaman 12 minit, satu hari bekerja transkripsi yang teliti, dua pemasangan pip, dan sebuah kad markah yang muat pada satu muka surat. Pilihan mahalnya ialah pilihan yang diambil kebanyakan pasukan secara lalai: memilih berdasarkan peratusan terbitan, lalu menemui perbezaannya enam bulan kemudian, di dalam minit yang menyatakan bahawa pasukan itu bersetuju dengan sesuatu yang sebenarnya mereka tolak secara terang-terangan.
Angka yang mana lebih sanggup anda salah — satu tempat perpuluhan, atau satu keputusan?
Di mana Telli.sh berdiri: kami membina lapisan-lapisan yang justru diberi wajaran oleh kad markah ini. Telli.sh menjalankan pemisahan penutur, segmentasi, penghalusan dan peringkasan di atas pengecaman pertuturan, dengan terjemahan ke 44 bahasa sasaran dan antara muka dalam 15 bahasa, kerana 90 mata pada kad itu yang bukan WER mentah ialah tempat sesebuah transkrip bertukar menjadi minit yang boleh ditindaki seseorang. Jika anda mahukan titik data sebenar dan bukan sekadar penanda aras, jalankan klip 12 minit anda sendiri melaluinya lalu nilai hasilnya dengan tatacara di atas.
Mulakan nota AI secara langsung
Sumber
- MeetEval — kit penilaian transkripsi mesyuarat — arahan cpWER, tcpWER, ORC-WER, MIMO-WER dan DI-cpWER, format SegLST, serta contoh terkira
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), dicapai 31 Ogos 2026 - JiWER — pakej penilaian pengecaman pertuturan — WER, MER, WIL, WIP dan CER melalui jarak suntingan minimum RapidFuzz
- dscore — alat pemarkahan diarisasi — DER sebagai ralat penutur campur pertuturan penggera palsu campur pertuturan tercicir, mengikut seksyen 6.1 pelan penilaian NIST RT-09
- Papan pendahulu speech-to-text Artificial Analysis — metodologi AA-WER v2 (~8 jam merentas AA-AgentTalk 50%, VoxPopuli-Cleaned-AA 25%, Earnings22-Cleaned-AA 25%), angka lima model teratas, nota rujukan dibersihkan dan nota pencantasan Earnings22, kesemuanya dicapai 31 Ogos 2026
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20 April 2020 — trek berbilang penutur bersegmen dan tidak bersegmen, serta reka bentuk rakaman jamuan makan malam
- The AMI Meeting Corpus — 100 jam rakaman mesyuarat yang dirakam dengan mikrofon dekat mulut dan mikrofon jarak jauh secara segerak
- MAI-Transcribe dalam Azure Speech — Microsoft Learn — pemberatan kata kunci dan batasan yang didokumentasikan
- Tulisan kami sebelum ini tentang mengapa ketepatan transkripsi tidak pernah menjadi hasil akhirnya