Stesso tasso di errore del 10,0 %, decisione opposta: come si misura davvero l'accuratezza delle trascrizioni di riunione
Il word error rate pesa la parola «non» esattamente come la parola «il», ed è il motivo per cui due trascrizioni possono fermarsi entrambe al 10,0 % e una sola essere utilizzabile. Ecco la procedura di misurazione completa: un clip di prova da 12 minuti costruito a specifica, una trascrizione di riferimento con regole di normalizzazione congelate, i comandi esatti per cpWER e DER, e una pagella a cinque dimensioni che assegna al WER grezzo 10 punti su 100.
Ecco due trascrizioni automatiche della stessa frase di venti parole, pronunciata in una riunione di prodotto.
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review"
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review"
(Nella prima: «Priya ha detto che la migrazione Helios slitta al Q3 e non dovremmo firmare il contratto con il fornitore prima della revisione di sicurezza».)
Ognuna contiene esattamente due errori rispetto a ciò che è stato realmente detto. Ognuna ottiene un word error rate del 10,0 %. La trascrizione A ha perso due volte l'articolo «the». La trascrizione B ha spostato una scadenza avanti di un trimestre e ha cancellato il «not» da un impegno.
Se il vostro processo di valutazione classifica quei due sistemi come equivalenti, il problema è il processo — non i modelli.
Questo articolo è la procedura di misurazione che consegneremmo a qualcuno a cui è stato chiesto di scegliere uno strumento di trascrizione entro venerdì. Copre che cosa conta esattamente il word error rate, perché quel numero inganna proprio sull'audio delle riunioni, e un protocollo in cinque passi che potete eseguire in un pomeriggio con due pacchetti open source e una registrazione da 12 minuti. Altrove abbiamo sostenuto che l'accuratezza della trascrizione non è mai stata il risultato da consegnare. Questo è il pezzo gemello — non la tesi, il metodo.
In breve:
- Il WER è
(sostituzioni + cancellazioni + inserimenti) ÷ parole di riferimento, e ogni parola pesa allo stesso modo. La negazione «non» e l'articolo «il» costano identico.- Le classifiche pubblicate si sono compresse. Sulla graduatoria indipendente di Artificial Analysis, consultata il 31 agosto 2026, i primi cinque modelli stanno tra l'1,7 % e il 2,6 % di AA-WER: una forbice troppo stretta per farne uscire un vincitore.
- Valutate invece cinque dimensioni, pesate: termini portanti (30), attribuzione dei parlanti (25), numeri e importi (20), segmentazione (15), WER grezzo (10). Gli strumenti per le parti difficili esistono già —
cpWEReDERsono inclusi in MeetEval, il toolkit nato per le sfide CHiME.
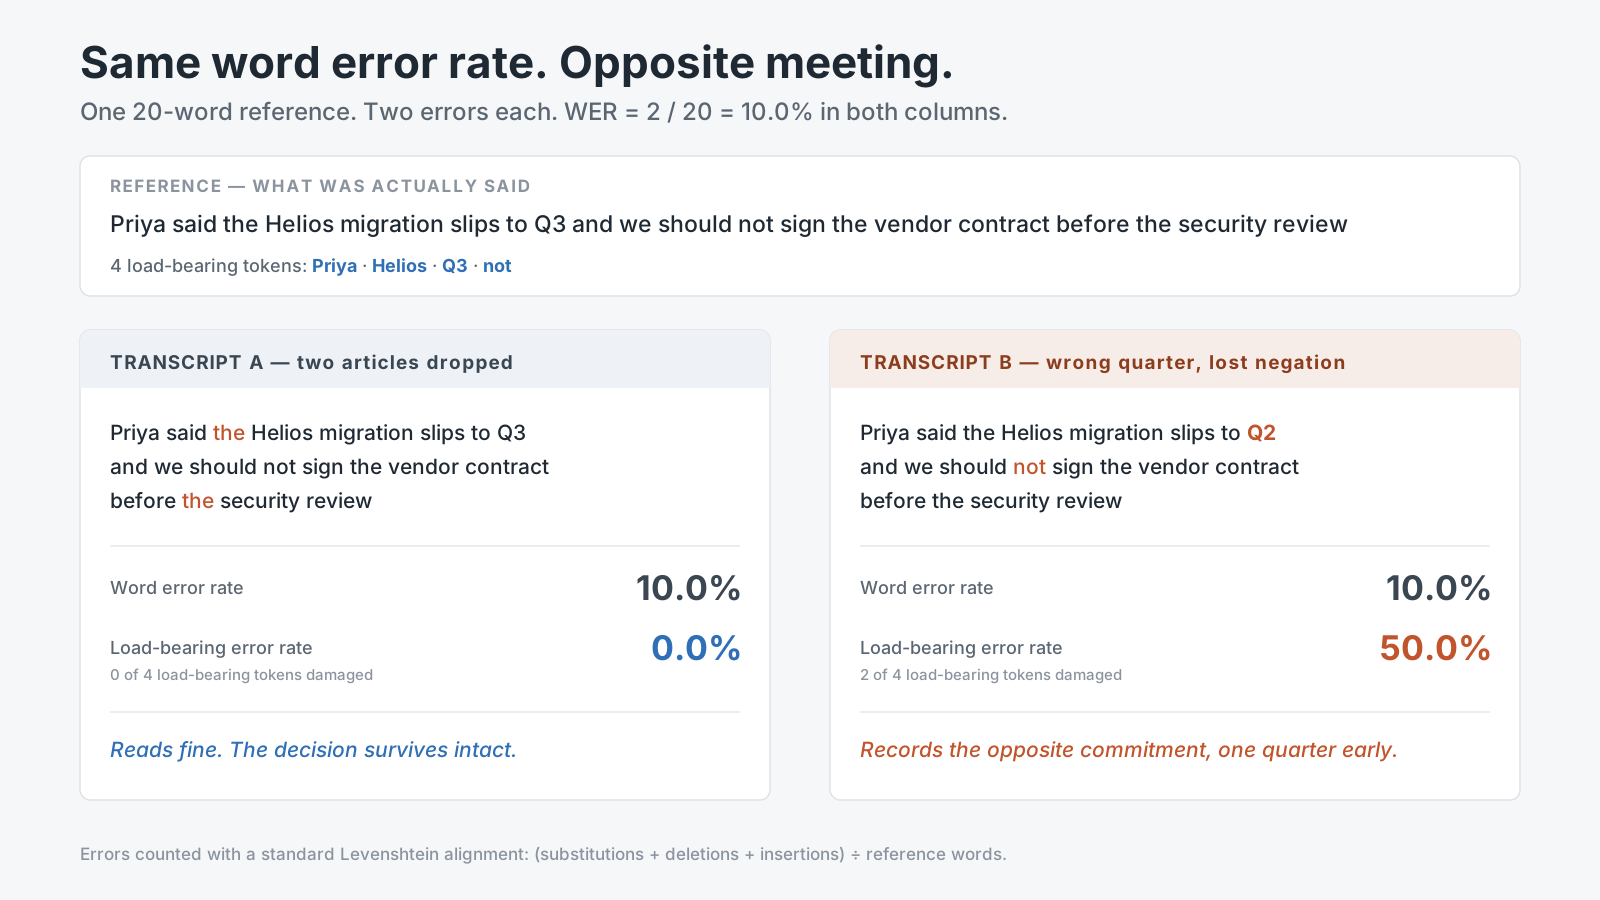
Entrambe le colonne contengono due errori rispetto a un riferimento di 20 parole. Una sola registra ancora la decisione che la stanza ha davvero preso.
Che cosa conta il word error rate, scritto per esteso
Il WER nasce da un unico allineamento. Prendete la trascrizione di riferimento — ciò che gli esseri umani concordano sia stato detto. Prendete l'output della macchina. Trovate la sequenza di modifiche più economica che trasforma l'una nell'altro, con il classico allineamento di Levenshtein, ed etichettate ogni modifica:
- una sostituzione quando il modello ha scritto una parola diversa («deploy» sentito come «delay»),
- una cancellazione quando una parola del riferimento non ha alcun corrispondente nell'output,
- un inserimento quando il modello ha prodotto una parola che nessuno ha pronunciato.
Poi:
WER = (substitutions + deletions + insertions) ÷ reference words
Il denominatore è la lunghezza del riferimento, non quella dell'ipotesi, ed è per questo che il WER può legittimamente superare il 100 %: un modello che allucina liberamente può accumulare più inserimenti di quante fossero le parole di partenza.
Un esempio svolto, preso dalla documentazione di MeetEval così che l'aritmetica sia verificabile contro un output pubblicato. Riferimento: "The quick brown fox jumps over the lazy dog" — nove parole. Ipotesi: "The kwick brown fox jump over lazy" — sette parole. L'allineamento trova due sostituzioni (quick→kwick, jumps→jump) e due cancellazioni (the, dog), nessun inserimento. Fa (2 + 2 + 0) ÷ 9 = 0,4444, cioè un WER del 44,4 %, ed è esattamente ciò che MeetEval stampa: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
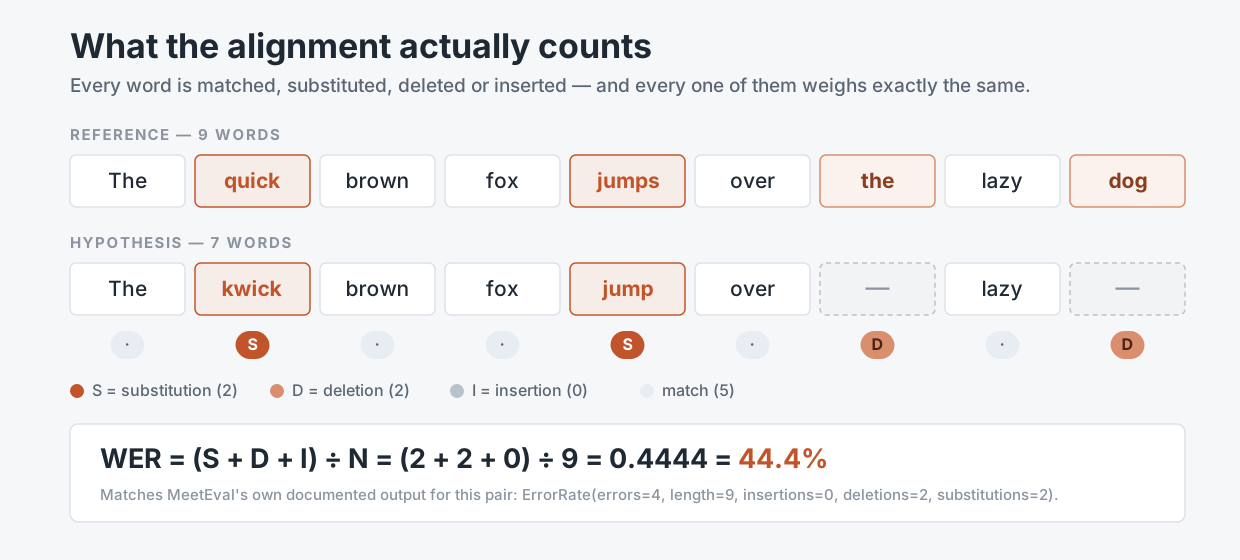
L'allineamento è meccanico e riproducibile. Quello che non è, è pesato. Fonte: documentazione di MeetEval, consultata il 31 agosto 2026.
Due proprietà di quella formula contano più di qualsiasi cosa scritta sulla landing page di un fornitore. Primo, è piatta: la metrica non ha alcuna nozione del fatto che certe parole reggono la riunione e altre reggono la grammatica. Secondo, è cieca ai parlanti: il WER standard concatena tutto in un unico flusso, quindi un sistema che trascrive ogni parola alla perfezione e ne attribuisce metà alla persona sbagliata può esibire un punteggio immacolato.
Perché i numeri pubblicati non riescono più a separare i vostri candidati
Aprite le classifiche e il problema diventa aritmetica. Artificial Analysis, che esegue valutazioni proprie invece di ristampare le dichiarazioni dei fornitori, al 31 agosto 2026 elencava i suoi primi cinque modelli per AA-WER così: Fun-Realtime-ASR-preview all'1,7 %, ElevenLabs Scribe v2 al 2,2 %, MAI-Transcribe-1.5 di Microsoft al 2,4 %, Smallest AI Pulse Pro al 2,4 % e Gemini 3.5 Transcribe al 2,6 %. Il miglior modello a pesi aperti, Voxtral Small di Mistral, si ferma al 2,8 %.
L'intera fascia alta del mercato sta dentro una banda di 1,1 punti. Su una riunione di 45 minuti con circa 6.300 parole pronunciate, il divario tra il primo e il quinto classificato è di circa 57 parole: meno di una parola per schermata di trascrizione.
C'è un secondo problema, ed è che l'audio del benchmark non è il vostro audio. AA-WER v2 è una media ponderata sulla durata dell'audio su circa otto ore prese da tre fonti: AA-AgentTalk al 50 %, VoxPopuli-Cleaned-AA al 25 % ed Earnings22-Cleaned-AA al 25 %. I discorsi parlamentari e le call sugli utili sono registrati bene, pronunciati a turno e in gran parte privi della cosa che definisce una riunione interna: quattro persone che si interrompono a vicenda parlando di un progetto di cui hanno sentito parlare solo loro.
La ricerca sull'audio genuinamente conversazionale tratta questo come una disciplina a sé da anni. La sfida CHiME-6, pubblicata il 20 aprile 2020 da Watanabe, Mandel, Barker e diciotto coautori, ha costruito la propria valutazione su registrazioni di cene tra amici proprio perché la conversazione naturale, con sovrapposizioni e microfoni distanti, manda in crisi sistemi che vanno benissimo sul parlato letto. Il corpus AMI Meeting, 100 ore di registrazioni catturate sia con archetti ravvicinati sia con microfoni d'ambiente, esiste per la stessa ragione.
Ecco il punto, e lo diciamo senza mezzi termini: un WER pubblicato vi dice che il modello di un fornitore non è rotto. Non può dirvi da quale fornitore comprare.
Che cosa il WER intercetta e che cosa strutturalmente non può vedere
| Modalità di guasto | Intercettata dal WER grezzo? | Che cosa vi costa | Che cosa la misura davvero |
|---|---|---|---|
| Parola comune fraintesa («their»/«there») | Sì, a peso pieno | Quasi nulla | WER |
| Intercalari e false partenze eliminati | Sì, contati come cancellazioni | Nulla — spesso è un miglioramento | WER, in modo fuorviante |
| Nome proprio storpiato («Xochitl» → «Societal») | Sì, ma con il peso di 1 parola | Il nome della persona responsabile | Tasso di errore sui termini portanti |
| Numero o data sbagliati («Q3» → «Q2») | Sì, peso di 1 parola | Una scadenza mancata | Accuratezza sui numeri, valutata a parte |
| Negazione cancellata («should not» → «should») | Sì, peso di 1 parola | La decisione ribaltata | Tasso di errore sui termini portanti |
| Parole giuste, parlante sbagliato | No — il WER è cieco ai parlanti | Nessuno sa chi si è impegnato | cpWER, DER |
| Turni di parola fusi in un unico blocco | No | Un muro di testo illeggibile | tcpWER con collar, rilettura umana |
| Confini di frase assenti | No — la punteggiatura viene normalizzata via | Un riassunto che tira a indovinare la struttura | Punteggio di segmentazione, rilettura umana |
| Intero passaggio allucinato nel silenzio | In parte — come inserimenti | Contenuto inventato presentato come verbale | WER più conteggio degli inserimenti letto a parte |
La metà inferiore di quella tabella è la metà che decide se una trascrizione diventa un appunto utilizzabile, e il WER standard non ne vede nulla. Non è un difetto della metrica — il WER risponde alla domanda per cui è stato progettato nella ricerca sulla dettatura degli anni Novanta. È un difetto dell'usarlo da solo nel 2026.
Passo 1: costruite un clip da 12 minuti che si comporti come una riunione vera
Non valutate su un file dimostrativo del fornitore e non valutate su otto ore del vostro archivio. Vi serve un clip abbastanza corto da poter essere trascritto a mano e abbastanza denso da rompere qualcosa.
Puntate a 12 minuti. A un ritmo conversazionale normale di circa 140 parole al minuto e con una densità di parlato attorno al 75 %, ne escono all'incirca 1.260 parole di riferimento: abbastanza perché una differenza del 2 % nel tasso di errore siano 25 parole e non rumore statistico, e abbastanza poche perché due persone possano trascriverle con cura in un pomeriggio.
Costruite il clip su una specifica, non a sensazione. La nostra:
- Quattro o più parlanti, di cui almeno uno collegato da remoto su un canale audio compresso e almeno uno con accento non nativo nella lingua di lavoro.
- Novanta secondi o più di sovrapposizione reale — due persone che parlano insieme, qualcuno che finisce la frase di un altro, un colpo di tosse sopra una decisione. Il parlato incrociato è il punto in cui la diarizzazione si sfalda in silenzio, e un clip che non ne contiene non misura nulla.
- Venticinque o più termini di dominio: nomi in codice di prodotto, acronimi interni, nomi di clienti, nomi dei partecipanti. Sono le parole con il più alto significato per carattere nella stanza e la frequenza più bassa in qualunque corpus di addestramento.
- Quindici o più numeri: date, trimestri, importi in valuta, numeri di versione, percentuali. Pronunciatene qualcuno in modo ambiguo di proposito («quindici» e «cinquanta» nello stesso minuto).
- Tre o più decisioni negate, espresse in modo naturale: «quella cosa non la rilasciamo in questa release», «sul contratto aspettiamo».
- Due registrazioni simultanee dove riuscite a organizzarle — il microfono del portatile e una traccia con archetto per parlante. È il disegno del corpus AMI, e vi permette di distinguere «il modello è debole» da «la stanza è rumorosa».
Registratelo una volta sola. Conservate il WAV non compresso a 16 kHz o meglio. Ogni strumento che valuterete da qui in avanti riceve questo identico file, per sempre.
Passo 2: scrivete il riferimento — poi congelate le regole di normalizzazione prima di calcolare qualsiasi punteggio
La trascrizione di riferimento è uno strumento di misura, e ha le sue barre d'errore. Artificial Analysis mantiene versioni «pulite» dei propri set di valutazione pubblici proprio perché le trascrizioni di riferimento originali contenevano a loro volta errori di trascrizione; la loro nota è esplicita: le versioni pulite «rimuovono gli errori di trascrizione dal testo di riferimento, fornendo una ground truth più accurata per la valutazione dei modelli». Se chi gestisce un benchmark deve correggere la ground truth pubblicata, nemmeno la vostra trascrizione di primo passaggio è vangelo.
Quindi: due persone trascrivono in modo indipendente, poi riconciliano ogni differenza. Mettete in preventivo da cinque a otto volte il tempo reale per la coppia, il che porta un clip da 12 minuti a circa una giornata di lavoro di sforzo combinato. È il costo singolo più alto dell'intera procedura e non esiste modo di aggirarlo.
Poi mettete per iscritto la vostra politica di normalizzazione prima di calcolare un solo punteggio, perché queste scelte da sole spostano il numero finale di diversi punti:
- Numeri: «Q3» è lo stesso token di «Q tre»? «quarantamila» equivale a «40.000»?
- Contrazioni: «we're» corrisponde a «we are»?
- Intercalari: «ehm», «uh» e le false partenze compaiono nel riferimento, e vengono valutate?
- Maiuscole e punteggiatura: normalmente rimosse prima del calcolo — il che significa che uno strumento che punteggia magnificamente qui non riceve alcun credito, e dovete valutarlo a parte nel passo 3.
Salvate il risultato in SegLST, il formato JSON usato dalle sfide CHiME e predefinito in MeetEval: un oggetto per segmento con session_id, words, speaker, start_time ed end_time. I campi del parlante e dei tempi sono ciò che rende possibili le metriche consapevoli dei parlanti, e aggiungerli a posteriori è una sofferenza.
Passo 3: valutate cinque dimensioni, e date al WER grezzo dieci punti su cento
Installate gli strumenti — pip install jiwer meeteval — e valutate ogni dimensione sullo stesso clip. JiWER calcola il WER insieme a match error rate, word information lost, word information preserved e character error rate, con un'implementazione della distanza di edit minima basata su RapidFuzz. MeetEval calcola le metriche specifiche delle riunioni.
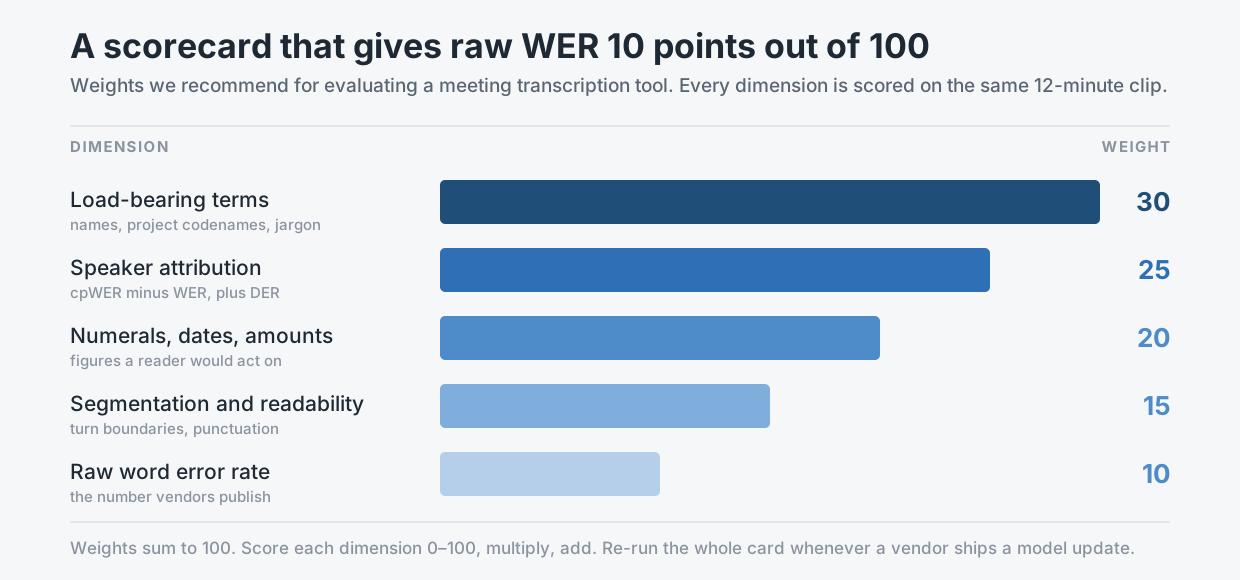
I pesi che raccomandiamo. La dimensione che ogni fornitore pubblicizza è quella che vale meno punti.
Termini portanti — 30 punti. Marcate nel riferimento ogni nome proprio, nome in codice e pezzo di gergo di dominio. Poi calcolate la stessa formula del WER solo su quei token. Chiamiamo il risultato tasso di errore sui termini portanti, ed è il numero singolo più predittivo dell'intero esercizio. Nella coppia di trascrizioni in cima a questo articolo, i quattro token portanti sono Priya, Helios, Q3 e not. La trascrizione A non ne danneggia nessuno: 0,0 %. La trascrizione B ne danneggia due: 50,0 %. Stesso WER complessivo del 10,0 %, cinquanta punti di distanza sulla metrica che conta.
Attribuzione dei parlanti — 25 punti. Eseguite meeteval-wer cpwer -r ref.stm -h hyp.stm. Il concatenated minimum-permutation WER trova la migliore corrispondenza tra i parlanti del riferimento e quelli dell'ipotesi, concatena le parole di ciascun parlante e valuta il risultato — così le parole attribuite alla persona sbagliata diventano errori. Poi sottraete: il cpWER meno il WER semplice è il divario di attribuzione, la porzione del danno che deriva puramente dal non sapere chi ha parlato. Aggiungete il diarization error rate per la vista sui tempi; il DER è la somma di errore di parlante, parlato in falso allarme e parlato mancato, espressi come percentuali del tempo valutato, definito nella sezione 6.1 del piano di valutazione NIST RT-09 e implementato in dscore, che MeetEval incapsula e che legge file RTTM. Se il vostro candidato supporta i timestamp, usate tcpwer --collar 5 al posto di cpwer, così una parola corretta agganciata al momento sbagliato non viene perdonata in silenzio.
Numeri, date e importi — 20 punti. Estraete dal riferimento ogni token numerico e valutate l'accuratezza a corrispondenza esatta contro l'ipotesi, dopo aver applicato la politica di normalizzazione che avete messo per iscritto. Riportatelo come frazione semplice — «13 su 15 corretti» — e non come percentuale, perché i conteggi sono piccoli e una percentuale suggerisce una precisione che non avete.
Segmentazione e leggibilità — 15 punti. Questa è umana. Fate leggere l'output grezzo a due persone che non hanno partecipato alla riunione e chiedete loro di segnare, minuto per minuto: confini di frase nel posto sbagliato, turni di parola fusi in un unico blocco e paragrafi che costringono a rileggere. La punteggiatura è stata normalizzata via dal calcolo del WER, quindi questo è l'unico posto in cui viene valutata.
Word error rate grezzo — 10 punti. Eseguite jiwer e annotate il numero. È un vero controllo di soglia minima: qualsiasi valore sopra il 12 % circa su audio pulito e ravvicinato indica un problema acustico reale che vale la pena investigare. Oltre quella soglia non discrimina quasi nulla, ed è esattamente il motivo per cui vale dieci punti e non ottanta.
Valutate ogni dimensione da 0 a 100, moltiplicate per il suo peso, sommate. Il risultato è confrontabile tra strumenti e nel tempo, che è tutto il senso dell'operazione.
Passo 4: eseguite ogni candidato sul file identico, e mettete per iscritto che cosa significava «identico»
È il passo che i team saltano, ed è quello che invalida tutto ciò che sta a monte.
Stesso WAV, stessa frequenza di campionamento, nessuna ricodifica tra un candidato e l'altro. Stesso riferimento, stessa politica di normalizzazione applicata dallo stesso script. Diarizzazione esplicitamente attiva o esplicitamente disattiva su ogni strumento, e annotata in entrambi i casi — uno strumento valutato con la diarizzazione spenta non è confrontabile con uno valutato con la diarizzazione accesa. Bias su parole chiave o entità disattivato per il primo passaggio e attivato per un secondo passaggio, entrambi registrati; Microsoft dichiara fino a una riduzione del 30 % del WER fornendo una lista di parole chiave a MAI-Transcribe-1.5, un valore abbastanza grande da rendere privo di senso un confronto che mescoli esecuzioni con e senza bias.
Sorvegliate in particolare la gestione dell'audio lungo. Artificial Analysis deve spezzare l'audio di Earnings22 in blocchi di circa nove minuti per i modelli che non reggono in modo affidabile un input a lunghezza piena, e di circa 30 secondi per i modelli con limiti più stretti — la loro nota pubblicata cita GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B e Qwen3 ASR Flash di Alibaba tra i sistemi interessati. Lo spezzettamento cambia i risultati, perché gli errori si addensano ai confini. Se un fornitore spezza il vostro file, quella è una proprietà del prodotto e va nella pagella, non un artefatto da correggere.
Infine, annotate la stringa esatta della versione del modello e la data di ogni esecuzione. «Whisper large-v3» non è una versione; whisper-large-v3, run 2026-08-31 lo è.
Passo 5: rieseguite la pagella quando il fornitore rilascia, non quando ve ne ricordate
I modelli vocali ospitati cambiano sotto i vostri piedi. Il nome dell'endpoint resta costante mentre i pesi dietro di esso no, e nessuno vi manda un'email quando i vostri appunti di riunione peggiorano leggermente sui nomi propri.
Tre condizioni devono far scattare una riesecuzione dell'intera pagella, sullo stesso clip costruito al passo 1:
- Il fornitore pubblica una voce di changelog che tocca il modello, il diarizzatore o lo strato di punteggiatura e formattazione.
- Passa un intervallo di calendario — trimestrale basta per la maggior parte dei team, mensile se l'output della trascrizione alimenta qualcosa di automatizzato a valle.
- Il vostro tasso di errore sui termini portanti si muove di più di 5 punti tra due esecuzioni qualsiasi: deve innescare un'indagine prima di innescare una migrazione.
Tenete ogni esecuzione in un'unica tabella: data, stringa di versione del modello, i cinque punteggi dimensionali, il totale pesato. Dopo tre o quattro esecuzioni possedete qualcosa che nessuna classifica può darvi — una serie storica di come uno specifico prodotto si comporta su audio che suona come le vostre riunioni vere.
Il punto: l'accuratezza è una misura della vostra stanza, non una proprietà del modello
Il word error rate è una proprietà di un modello su un corpus. Ciò che vi serve davvero è una proprietà di un modello sul vostro audio, per il vostro vocabolario, con le vostre persone che si parlano sopra — e quella grandezza non esiste finché non la misurate. Nessuno può pubblicarla al posto vostro, perché nessun altro ha i vostri nomi in codice nella propria trascrizione di riferimento.
La buona notizia è che la misurazione costa poco. Una registrazione da 12 minuti, una giornata di lavoro di trascrizione accurata, due installazioni pip e una pagella che sta in una pagina. L'alternativa cara è quella che la maggior parte dei team sceglie per inerzia: decidere su una percentuale pubblicata e scoprire la differenza sei mesi dopo, in un appunto che dice che il team ha accettato una cosa che aveva esplicitamente rifiutato.
Su quale numero preferireste sbagliarvi: un decimale o una decisione?
Dove si colloca Telli.sh: costruiamo esattamente gli strati che questa pagella pesa. Telli.sh esegue separazione dei parlanti, segmentazione, rifinitura e sintesi sopra il riconoscimento vocale, con traduzione verso 44 lingue di destinazione e un'interfaccia in 15, perché i 90 punti di quella pagella che non sono WER grezzo sono il punto in cui una trascrizione diventa un appunto su cui qualcuno può agire. Se volete un dato reale invece di un benchmark, fate passare il vostro clip da 12 minuti e valutate il risultato con la procedura qui sopra.
Fonti
- MeetEval — un toolkit per la valutazione delle trascrizioni di riunione — comandi cpWER, tcpWER, ORC-WER, MIMO-WER e DI-cpWER, il formato SegLST e l'esempio svolto
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), consultato il 31 agosto 2026 - JiWER — pacchetto per la valutazione del riconoscimento vocale — WER, MER, WIL, WIP e CER tramite la distanza di edit minima di RapidFuzz
- dscore — strumenti di scoring per la diarizzazione — il DER come errore di parlante più parlato in falso allarme più parlato mancato, secondo la sezione 6.1 del piano di valutazione NIST RT-09
- Classifica speech-to-text di Artificial Analysis — metodologia AA-WER v2 (~8 ore tra AA-AgentTalk 50 %, VoxPopuli-Cleaned-AA 25 %, Earnings22-Cleaned-AA 25 %), le cifre dei primi cinque modelli, la nota sui riferimenti puliti e quella sullo spezzettamento di Earnings22, tutte consultate il 31 agosto 2026
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20 aprile 2020 — le tracce multiparlante segmentata e non segmentata, e il disegno delle registrazioni di cena
- The AMI Meeting Corpus — 100 ore di registrazioni di riunione catturate con microfoni ravvicinati e d'ambiente sincronizzati
- MAI-Transcribe in Azure Speech — Microsoft Learn — il bias su parole chiave e le limitazioni documentate
- Il nostro articolo precedente sul perché l'accuratezza della trascrizione non è mai stata il risultato da consegnare