Tingkat kesalahan sama-sama 10,0%, keputusan berlawanan: cara mengukur akurasi transkripsi rapat
Tingkat kesalahan kata memberi bobot identik pada kata «tidak» dan kata sandang biasa, dan itulah sebabnya dua transkrip bisa sama-sama mendarat di 10,0% sementara hanya satu yang layak pakai. Inilah prosedur pengukurannya secara utuh: klip uji 12 menit yang dibangun sesuai spesifikasi rapat, transkrip acuan dengan aturan normalisasi yang dibekukan, perintah cpWER dan DER yang persis, serta kartu skor lima dimensi yang memberi WER mentah 10 poin dari 100.
Berikut dua transkrip mesin dari kalimat dua puluh kata yang sama, diambil dari sebuah rapat produk.
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review"
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review"
Masing-masing mengandung tepat dua kesalahan terhadap apa yang sesungguhnya diucapkan. Masing-masing mencetak tingkat kesalahan kata sebesar 10,0%. Transkrip A menghilangkan kata sandang "the" dua kali. Transkrip B memajukan sebuah tenggat satu kuartal dan menghapus kata "not" dari sebuah komitmen.
Kalau proses evaluasi Anda menempatkan kedua sistem itu setara, yang bermasalah adalah prosesnya — bukan modelnya.
Tulisan ini adalah prosedur pengukuran yang akan kami serahkan kepada orang yang disuruh memilih perkakas transkripsi sebelum hari Jumat. Isinya: apa persisnya yang dihitung oleh tingkat kesalahan kata; mengapa angka itu menyesatkan khusus pada audio rapat; dan protokol lima langkah yang bisa Anda jalankan dalam satu sore dengan dua paket sumber terbuka dan sebuah rekaman 12 menit. Secara terpisah kami sudah berargumen bahwa akurasi transkripsi tidak pernah menjadi hasil akhirnya. Ini tulisan pendampingnya — bukan argumennya, melainkan metodenya.
Ringkasan:
- WER adalah
(substitutions + deletions + insertions) ÷ reference words, dan setiap kata memikul bobot yang sama. Negasi «tidak» dan kata sandang biasa berongkos identik.- Papan peringkat yang dipublikasikan sudah memampat. Di papan independen Artificial Analysis, diambil 31 Agustus 2026, lima model teratas duduk di antara 1,7% dan 2,6% AA-WER — rentang yang terlalu sempit untuk menentukan pemenang.
- Nilailah lima dimensi sebagai gantinya, dengan bobot: istilah penyangga makna (30), atribusi pembicara (25), angka dan nominal (20), segmentasi (15), WER mentah (10). Perkakas untuk bagian yang sulit sudah tersedia —
cpWERdanDERada di dalam MeetEval, kakas yang dibangun untuk rangkaian tantangan CHiME.
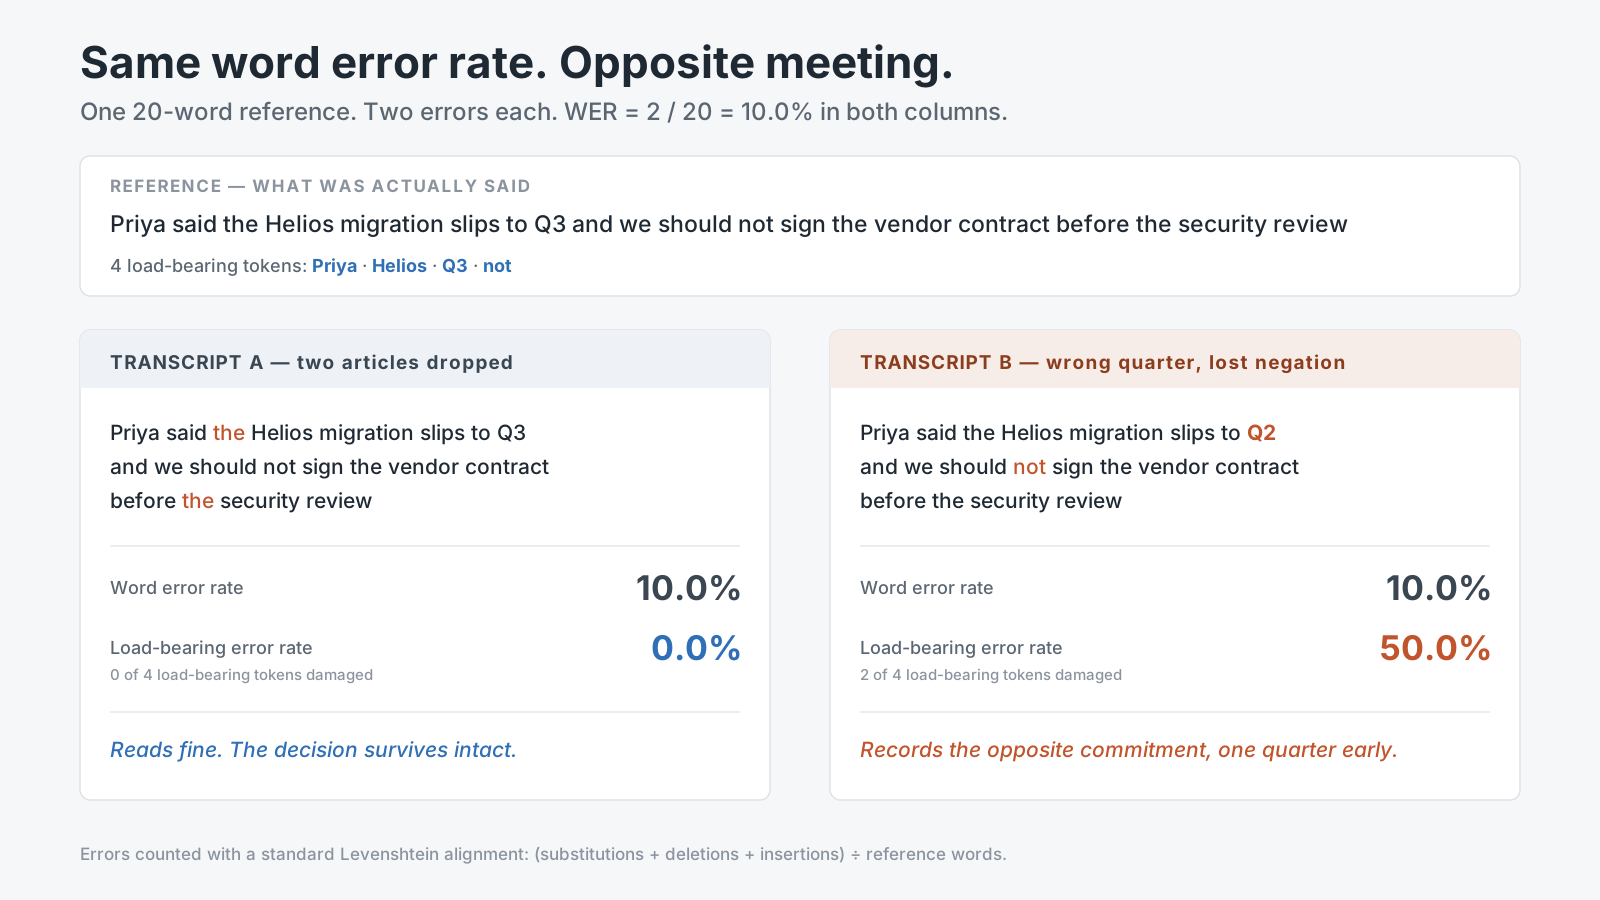
Kedua kolom berisi dua kesalahan terhadap acuan sepanjang 20 kata. Hanya satu di antaranya yang masih merekam keputusan yang benar-benar diambil di ruangan itu.
Apa yang sebenarnya dihitung tingkat kesalahan kata, ditulis lengkap
WER lahir dari satu proses penyelarasan. Ambil transkrip acuan — apa yang disepakati manusia telah diucapkan. Ambil keluaran mesin. Cari rangkaian suntingan termurah yang mengubah yang satu menjadi yang lain, memakai penyelarasan Levenshtein klasik, lalu beri label tiap suntingan:
- substitusi ketika model menulis kata yang berbeda ("deploy" terdengar sebagai "delay"),
- penghapusan ketika sebuah kata acuan tidak punya padanan di keluaran,
- penyisipan ketika model memproduksi kata yang tak seorang pun ucapkan.
Lalu:
WER = (substitutions + deletions + insertions) ÷ reference words
Penyebutnya adalah panjang acuan, bukan panjang hipotesis, dan itulah sebabnya WER secara sah bisa melampaui 100% — model yang berhalusinasi bebas bisa menumpuk lebih banyak penyisipan daripada jumlah kata yang tersedia sejak awal.
Sebuah contoh terkerjakan, diambil dari dokumentasi MeetEval sendiri supaya aritmetikanya bisa dicocokkan dengan keluaran yang sudah dipublikasikan. Acuan: "The quick brown fox jumps over the lazy dog" — sembilan kata. Hipotesis: "The kwick brown fox jump over lazy" — tujuh kata. Penyelarasan menemukan dua substitusi (quick→kwick, jumps→jump) dan dua penghapusan (the, dog), tanpa penyisipan. Hasilnya (2 + 2 + 0) ÷ 9 = 0,4444, yakni WER sebesar 44,4%, dan MeetEval mencetak persis itu: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
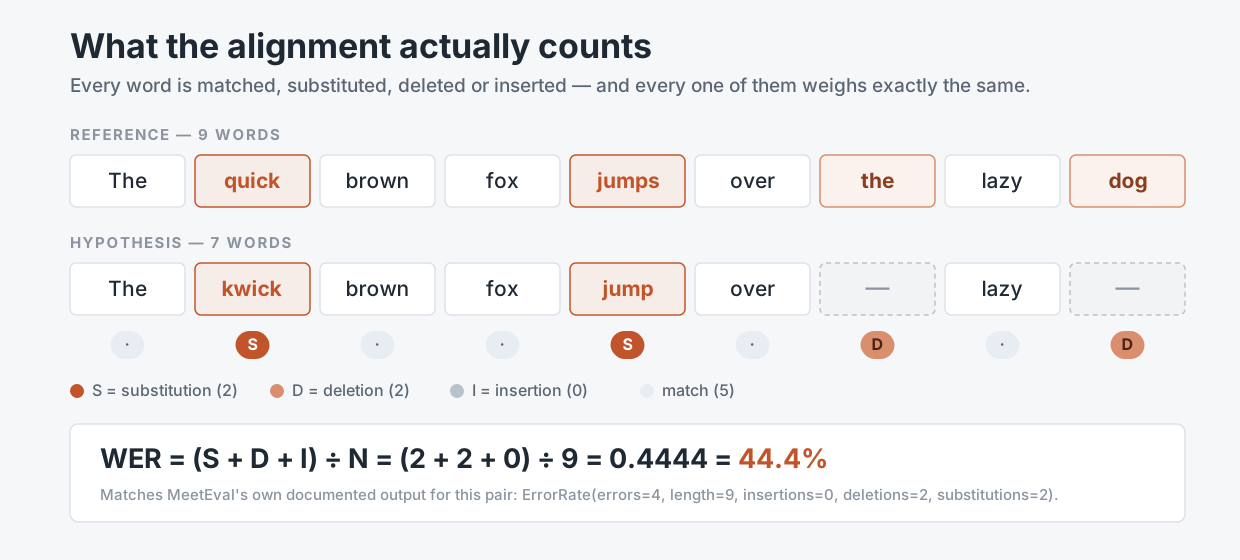
Penyelarasannya mekanis dan bisa diulang. Yang tidak dimilikinya adalah pembobotan. Sumber: dokumentasi MeetEval, diambil 31 Agustus 2026.
Dua sifat dari rumus itu lebih penting daripada apa pun yang tertera di halaman promosi vendor. Pertama, ia rata: metrik ini sama sekali tidak tahu bahwa sebagian kata memikul isi rapat sementara sebagian lain hanya memikul tata bahasa. Kedua, ia buta pembicara: WER standar melebur semuanya menjadi satu arus, sehingga sistem yang mentranskripsikan setiap kata dengan sempurna namun mengatribusikan separuhnya kepada orang yang salah tetap bisa memasang skor tanpa cela.
Mengapa angka yang dipublikasikan tak lagi mampu memisahkan kandidat Anda
Tarik papan peringkatnya dan masalahnya berubah menjadi aritmetika. Artificial Analysis, yang menjalankan evaluasinya sendiri alih-alih mencetak ulang klaim vendor, mendaftar lima model teratasnya berdasarkan AA-WER pada 31 Agustus 2026 sebagai Fun-Realtime-ASR-preview di 1,7%, ElevenLabs Scribe v2 di 2,2%, MAI-Transcribe-1.5 milik Microsoft di 2,4%, Smallest AI Pulse Pro di 2,4%, dan Gemini 3.5 Transcribe di 2,6%. Model bobot terbuka terbaik, Voxtral Small dari Mistral, duduk di 2,8%.
Seluruh puncak pasar muat di dalam pita selebar 1,1 poin. Pada rapat 45 menit dengan kira-kira 6.300 kata terucap, jarak antara peringkat satu dan peringkat lima setara sekitar 57 kata — kurang dari satu kata per layar transkrip.
Ada masalah kedua, yaitu bahwa audio tolok ukur itu bukan audio Anda. AA-WER v2 adalah rata-rata terbobot durasi audio dari kira-kira delapan jam rekaman yang ditarik dari tiga sumber: AA-AgentTalk sebesar 50%, VoxPopuli-Cleaned-AA sebesar 25%, dan Earnings22-Cleaned-AA sebesar 25%. Pidato parlemen dan panggilan laporan keuangan direkam dengan baik, diucapkan bergiliran, dan sebagian besar bebas dari hal yang justru mendefinisikan rapat internal — empat orang saling memotong bicara tentang proyek yang hanya mereka sendiri pernah dengar.
Riset pada audio yang benar-benar percakapan sudah memperlakukan ini sebagai disiplin tersendiri selama bertahun-tahun. Tantangan CHiME-6, dipublikasikan 20 April 2020 oleh Watanabe, Mandel, Barker dan delapan belas rekan penulis, membangun evaluasinya di atas rekaman jamuan makan malam justru karena percakapan alami dengan tumpang tindih dan mikrofon berjarak menghancurkan sistem yang bernilai bagus pada ujaran bacaan. AMI Meeting Corpus, 100 jam rekaman yang diambil dengan headset dekat mulut sekaligus mikrofon ruangan jarak jauh, hadir dengan alasan yang sama.
Inilah intinya, dan kami menyatakannya tanpa berkelit: WER yang dipublikasikan memberi tahu Anda bahwa model sebuah vendor tidak rusak. Ia tidak bisa memberi tahu Anda vendor mana yang harus dibeli.
Apa yang tertangkap WER dan apa yang secara struktural tak mungkin tertangkap
| Mode kegagalan | Tertangkap WER mentah? | Apa ongkosnya bagi Anda | Apa yang benar-benar mengukurnya |
|---|---|---|---|
| Kata umum salah dengar («their»/«there») | Ya, dengan bobot penuh | Nyaris tidak ada | WER |
| Gumaman dan awalan gagal terbuang | Ya, terhitung sebagai penghapusan | Tidak ada — sering justru perbaikan | WER, secara menyesatkan |
| Nama diri rusak («Xochitl» → «Societal») | Ya, tetapi berbobot 1 kata | Nama orang yang bertanggung jawab | Tingkat kesalahan istilah penyangga |
| Angka atau tanggal keliru («Q3» → «Q2») | Ya, berbobot 1 kata | Tenggat yang terlewat | Akurasi angka, dinilai terpisah |
| Negasi terhapus («should not» → «should») | Ya, berbobot 1 kata | Keputusan yang terbalik | Tingkat kesalahan istilah penyangga |
| Kata benar, pembicara salah | Tidak — WER buta pembicara | Tidak ada yang tahu siapa yang berjanji | cpWER, DER |
| Giliran bicara melebur jadi satu blok | Tidak | Dinding teks yang tak terbaca | tcpWER dengan collar, pembacaan oleh manusia |
| Batas kalimat hilang | Tidak — tanda baca dinormalisasi habis | Ringkasan yang menebak-nebak strukturnya | Skor segmentasi, pembacaan oleh manusia |
| Satu paragraf penuh dihalusinasikan saat hening | Sebagian — sebagai penyisipan | Isi karangan disajikan sebagai rekaman resmi | WER ditambah jumlah penyisipan yang dibaca terpisah |
Separuh bawah tabel itulah yang menentukan apakah sebuah transkrip menjelma menjadi catatan yang berguna, dan WER standar tidak melihat satu pun darinya. Itu bukan cacat metriknya — WER menjawab pertanyaan yang memang dirancang untuknya dalam riset dikte tahun 1990-an. Yang cacat adalah memakainya sendirian di tahun 2026.
Langkah 1: bangun klip 12 menit yang berperilaku seperti rapat sungguhan
Jangan mengevaluasi pada berkas demo vendor dan jangan pula mengevaluasi pada delapan jam arsip Anda sendiri. Anda butuh satu klip yang cukup pendek untuk ditranskripsikan dengan tangan dan cukup padat untuk merusakkan banyak hal.
Bidik 12 menit. Pada laju percakapan normal sekitar 140 kata per menit dan kepadatan bicara kira-kira 75%, itu menghasilkan sekitar 1.260 kata acuan — cukup banyak sehingga selisih 2% pada tingkat kesalahan berarti 25 kata alih-alih derau statistik, dan cukup sedikit sehingga dua orang bisa mentranskripsikannya dengan cermat dalam satu sore.
Bangun klipnya menurut spesifikasi, bukan menurut firasat. Spesifikasi kami:
- Empat pembicara atau lebih, termasuk setidaknya satu yang bergabung dari jauh lewat kanal audio terkompresi, dan setidaknya satu aksen bukan penutur asli dalam bahasa kerja.
- Sembilan puluh detik atau lebih tumpang tindih yang sungguhan — dua orang bicara bersamaan, seseorang menyelesaikan kalimat orang lain, batuk yang menimpa sebuah keputusan. Suara yang saling menimpa adalah tempat diarisasi runtuh diam-diam, dan klip tanpa itu tidak mengukur apa pun.
- Dua puluh lima istilah domain atau lebih: nama sandi produk, akronim internal, nama pelanggan, nama peserta. Inilah kata-kata dengan makna per karakter tertinggi di ruangan dan frekuensi terendah di korpus pelatihan mana pun.
- Lima belas angka atau lebih: tanggal, kuartal, nominal mata uang, nomor versi, persentase. Ucapkan sebagian di antaranya secara ambigu dengan sengaja («lima belas» dan «lima puluh» dalam menit yang sama).
- Tiga keputusan bernegasi atau lebih, dinyatakan secara alami: «kita tidak akan merilis itu pada versi ini», «kita tahan dulu kontraknya».
- Dua rekaman serentak kalau Anda sanggup mengaturnya — mikrofon bawaan laptop dan jalur headset per pembicara. Itulah rancangan korpus AMI, dan itu memungkinkan Anda memisahkan «modelnya lemah» dari «ruangannya berisik».
Rekam sekali saja. Simpan WAV-nya tanpa kompresi pada 16 kHz atau lebih baik. Setiap perkakas yang Anda evaluasi mulai dari sini mendapat berkas yang identik ini, selamanya.
Langkah 2: tulis acuannya — lalu bekukan aturan normalisasi sebelum menilai apa pun
Transkrip acuan adalah instrumen pengukur, dan ia punya batang galat. Artificial Analysis memelihara versi «bersih» dari set evaluasi publiknya justru karena transkrip acuan aslinya sendiri mengandung kesalahan transkripsi; catatan mereka blak-blakan soal itu — versi bersih tersebut «menghapus kesalahan transkripsi dari teks acuan, sehingga memberikan kebenaran dasar yang lebih akurat untuk evaluasi model». Kalau operator tolok ukur saja harus mengoreksi kebenaran dasar yang sudah dipublikasikan, transkrip lintasan pertama Anda pun bukan kitab suci.
Jadi: dua orang mentranskripsikan secara terpisah, lalu merekonsiliasi setiap perbedaan. Anggarkan lima sampai delapan kali durasi nyata untuk pasangan itu, yang menempatkan klip 12 menit pada kira-kira satu hari kerja usaha gabungan. Itulah biaya tunggal terbesar dalam seluruh prosedur ini dan tidak ada jalan memutarinya.
Lalu tuliskan kebijakan normalisasi Anda sebelum Anda menghitung satu skor pun, karena pilihan-pilihan berikut sendirian sudah menggeser angka akhir sebesar beberapa poin:
- Angka: apakah «Q3» token yang sama dengan «Q tiga»? Apakah «empat puluh ribu» setara dengan «40.000»?
- Kontraksi: apakah «we're» cocok dengan «we are»?
- Gumaman: apakah «um», «uh» dan awalan gagal ada di dalam acuan sama sekali, dan apakah keduanya dinilai?
- Kapitalisasi dan tanda baca: biasanya dipangkas sebelum penilaian — yang berarti perkakas yang memberi tanda baca dengan indah tidak mendapat kredit apa pun di sini, dan Anda harus menilainya terpisah di langkah 3.
Simpan hasilnya dalam SegLST, format JSON yang dipakai rangkaian tantangan CHiME dan menjadi bawaan MeetEval: satu objek per segmen dengan session_id, words, speaker, start_time dan end_time. Kolom pembicara dan pewaktuan itulah yang memungkinkan metrik sadar-pembicara, dan memasangnya belakangan adalah pekerjaan yang menyiksa.
Langkah 3: nilai lima dimensi, dan beri WER mentah sepuluh poin dari seratus
Pasang perkakasnya — pip install jiwer meeteval — lalu nilai tiap dimensi pada klip yang sama. JiWER menghitung WER berikut match error rate, word information lost, word information preserved dan character error rate, memakai implementasi jarak sunting minimum dari RapidFuzz. MeetEval menghitung metrik yang khusus rapat.
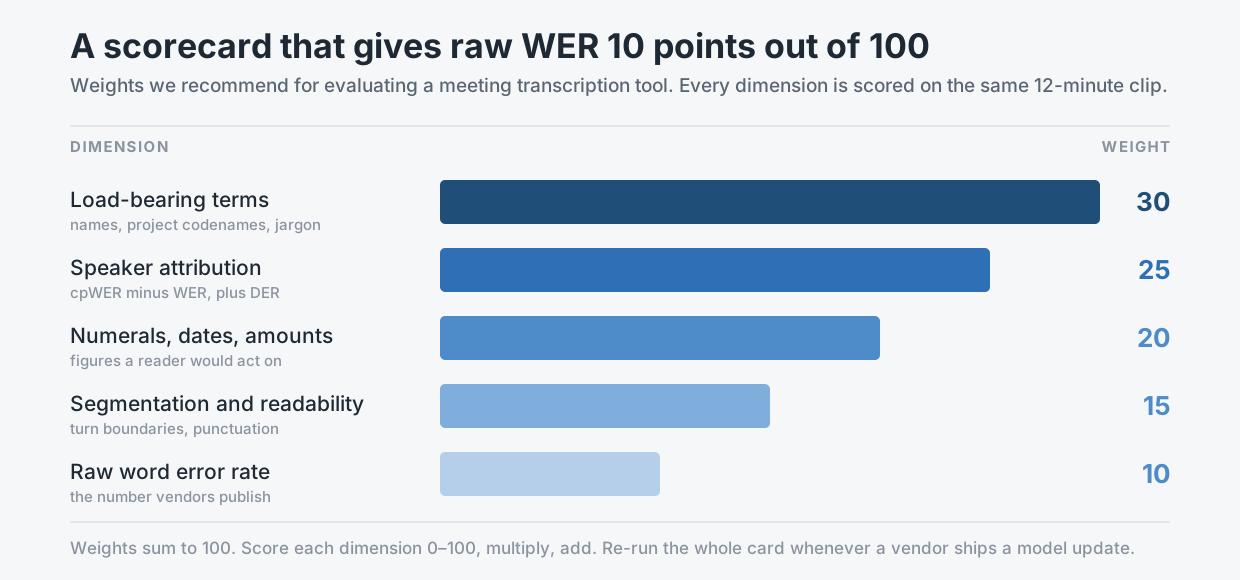
Bobot yang kami sarankan. Dimensi yang diiklankan setiap vendor justru yang bernilai paling sedikit poin.
Istilah penyangga makna — 30 poin. Tandai setiap nama diri, nama sandi dan potongan jargon domain di dalam acuan. Lalu hitung rumus WER yang sama hanya atas token-token itu. Hasilnya kami sebut tingkat kesalahan istilah penyangga, dan itulah angka paling prediktif dalam seluruh latihan ini. Pada sepasang transkrip di awal tulisan ini, keempat token penyangganya adalah Priya, Helios, Q3 dan not. Transkrip A tidak merusak satu pun: 0,0%. Transkrip B merusak dua: 50,0%. WER keseluruhan sama-sama 10,0%, dengan rentang lima puluh poin pada metrik yang benar-benar penting.
Atribusi pembicara — 25 poin. Jalankan meeteval-wer cpwer -r ref.stm -h hyp.stm. Concatenated minimum-permutation WER mencari pemetaan terbaik antara pembicara acuan dan pembicara hipotesis, merangkai kata-kata tiap pembicara, lalu menilai hasilnya — sehingga kata yang diatribusikan kepada orang yang salah menjadi kesalahan. Lalu kurangkan: cpWER dikurangi WER biasa adalah selisih atribusi, yakni bagian kerusakan yang murni berasal dari tidak diketahuinya siapa yang bicara. Tambahkan diarization error rate untuk sudut pandang pewaktuan; DER adalah jumlah kesalahan pembicara, ujaran alarm palsu dan ujaran yang terlewat sebagai persentase dari waktu yang dinilai, didefinisikan pada bagian 6.1 rencana evaluasi NIST RT-09 dan diimplementasikan di dscore, yang dibungkus MeetEval dan yang membaca berkas RTTM. Kalau kandidat Anda mendukung penanda waktu, pakai tcpwer --collar 5 alih-alih cpwer supaya kata yang benar tetapi melekat pada momen yang salah tidak diampuni diam-diam.
Angka, tanggal dan nominal — 20 poin. Ekstrak setiap token numerik dari acuan lalu nilai akurasi kecocokan persisnya terhadap hipotesis, setelah menerapkan kebijakan normalisasi tertulis Anda. Laporkan sebagai pecahan biasa — «13 dari 15 benar» — bukan sebagai persentase, karena cacahnya kecil dan persentase menyiratkan presisi yang tidak Anda miliki.
Segmentasi dan keterbacaan — 15 poin. Yang satu ini manusiawi. Mintalah dua pembaca yang tidak menghadiri rapat itu membaca keluaran mentahnya dan menandai, per menit: batas kalimat yang salah tempat, giliran bicara yang melebur jadi satu blok, dan paragraf yang menuntut pembacaan ulang. Tanda baca sudah dinormalisasi keluar dari perhitungan WER Anda, jadi di sinilah satu-satunya tempat ia dinilai sama sekali.
Tingkat kesalahan kata mentah — 10 poin. Jalankan jiwer dan catat angkanya. Ia adalah pemeriksaan lantai yang sungguhan: apa pun di atas kira-kira 12% pada audio dekat mulut yang bersih menandakan masalah akustik nyata yang layak ditelusuri. Di luar lantai itu, ia nyaris tidak membedakan apa-apa, dan justru itulah alasan ia bernilai sepuluh poin, bukan delapan puluh.
Nilai tiap dimensi pada rentang 0–100, kalikan dengan bobotnya, lalu jumlahkan. Hasilnya sebanding antarperkakas dan antarwaktu, dan itulah seluruh intinya.
Langkah 4: jalankan setiap kandidat pada berkas yang identik, dan catat apa arti «identik» itu
Inilah langkah yang dilewati tim-tim, dan ia membatalkan segala sesuatu di hulunya.
WAV yang sama, laju cuplik yang sama, tanpa penyandian ulang di antara kandidat. Acuan yang sama, kebijakan normalisasi yang sama diterapkan oleh skrip yang sama. Diarisasi dinyalakan secara eksplisit atau dimatikan secara eksplisit pada setiap perkakas, dan dicatat apa pun pilihannya — perkakas yang dievaluasi dengan diarisasi mati tidak sebanding dengan yang dievaluasi dengan diarisasi hidup. Pembobotan kata kunci atau entitas dimatikan pada lintasan pertama dan dinyalakan pada lintasan kedua, keduanya dicatat; Microsoft melaporkan pengurangan WER hingga 30% dari pemberian daftar kata kunci kepada MAI-Transcribe-1.5, yang cukup besar sehingga perbandingan yang mencampur lintasan berbobot dan tak berbobot menjadi tak bermakna.
Perhatikan penanganan audio panjang secara khusus. Artificial Analysis terpaksa memotong audio Earnings22 miliknya menjadi kira-kira sembilan menit untuk model yang tidak mampu menangani masukan panjang penuh secara andal, dan menjadi kira-kira 30 detik untuk model dengan batas yang lebih ketat — catatan terbitan mereka sendiri menyebut GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B dan Qwen3 ASR Flash dari Alibaba di antara sistem yang terdampak. Pemotongan mengubah hasil, karena kesalahan menggerombol di batas potongan. Kalau sebuah vendor memotong berkas Anda, itu properti produknya dan tempatnya di kartu skor, bukan artefak yang harus dikoreksi hilang.
Terakhir, catat string versi model yang persis dan tanggal setiap kali dijalankan. «Whisper large-v3» bukan versi; whisper-large-v3, run 2026-08-31 baru versi.
Langkah 5: jalankan ulang kartunya saat vendor merilis, bukan saat Anda kebetulan teringat
Model ucapan yang dihosting berubah di bawah kaki Anda. Nama endpoint-nya tetap konstan sementara bobot di baliknya tidak, dan tak seorang pun mengirimi Anda surel ketika catatan rapat Anda menjadi sedikit lebih buruk pada nama diri.
Tiga pemicu semestinya menyalakan penjalanan ulang kartu penuh, pada klip yang sama yang Anda bangun di langkah 1:
- Vendor menerbitkan entri changelog yang menyentuh modelnya, diarizer-nya, atau lapisan tanda baca dan pemformatannya.
- Sebuah interval kalender berlalu — triwulanan sudah cukup untuk kebanyakan tim, bulanan bila keluaran transkripsi memasok apa pun yang otomatis di hilirnya.
- Tingkat kesalahan istilah penyangga Anda bergerak lebih dari 5 poin antara dua penjalanan mana pun, yang semestinya memicu investigasi sebelum memicu migrasi.
Simpan setiap penjalanan dalam satu tabel: tanggal, string versi model, kelima skor dimensi, total terbobot. Setelah tiga atau empat kali, Anda memiliki sesuatu yang tak bisa diberikan papan peringkat mana pun — deret waktu tentang bagaimana sebuah produk tertentu bekerja pada audio yang terdengar seperti rapat Anda yang sebenarnya.
Intinya: akurasi adalah pengukuran atas ruangan Anda, bukan sifat bawaan model
Tingkat kesalahan kata adalah sifat sebuah model pada sebuah korpus. Yang sesungguhnya Anda butuhkan adalah sifat sebuah model pada audio Anda, untuk kosakata Anda, dengan orang-orang Anda yang saling menimpa bicara — dan besaran itu tidak ada sampai Anda mengukurnya. Tak seorang pun bisa menerbitkannya untuk Anda, karena tak seorang pun punya nama sandi Anda di dalam transkrip acuannya.
Kabar baiknya, pengukurannya murah. Satu rekaman 12 menit, satu hari kerja transkripsi yang cermat, dua pemasangan pip, dan sebuah kartu skor yang muat dalam satu halaman. Alternatif yang mahal adalah yang dipilih kebanyakan tim secara bawaan: memilih berdasarkan persentase yang dipublikasikan, lalu menemukan selisihnya enam bulan kemudian, di dalam catatan yang menyebutkan bahwa tim menyetujui sesuatu yang justru mereka tolak.
Angka mana yang lebih Anda relakan untuk salah — satu angka di belakang koma, atau sebuah keputusan?
Di mana Telli.sh berdiri: kami membangun lapisan-lapisan yang justru diberi bobot oleh kartu skor ini. Telli.sh menjalankan pemisahan pembicara, segmentasi, penghalusan dan peringkasan di atas pengenalan ucapan, dengan terjemahan ke 44 bahasa tujuan dan antarmuka dalam 15 bahasa, karena 90 poin dari kartu itu yang bukan WER mentah adalah tempat sebuah transkrip berubah menjadi catatan yang bisa ditindaklanjuti seseorang. Kalau Anda menginginkan titik data nyata alih-alih sebuah tolok ukur, jalankan klip 12 menit Anda sendiri melewatinya dan nilai hasilnya dengan prosedur di atas.
Sumber
- MeetEval — kakas evaluasi transkripsi rapat — perintah cpWER, tcpWER, ORC-WER, MIMO-WER dan DI-cpWER, format SegLST, serta contoh terkerjakan
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), diambil 31 Agustus 2026 - JiWER — paket evaluasi pengenalan ucapan — WER, MER, WIL, WIP dan CER lewat jarak sunting minimum RapidFuzz
- dscore — perkakas penilaian diarisasi — DER sebagai kesalahan pembicara ditambah ujaran alarm palsu ditambah ujaran terlewat, sesuai bagian 6.1 rencana evaluasi NIST RT-09
- Papan peringkat speech-to-text Artificial Analysis — metodologi AA-WER v2 (~8 jam dari AA-AgentTalk 50%, VoxPopuli-Cleaned-AA 25%, Earnings22-Cleaned-AA 25%), angka lima model teratas, catatan acuan bersih dan catatan pemotongan Earnings22, semuanya diambil 31 Agustus 2026
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20 April 2020 — jalur multipembicara tersegmentasi dan tak tersegmentasi, serta rancangan rekaman jamuan makan malam
- The AMI Meeting Corpus — 100 jam rekaman rapat yang diambil dengan mikrofon dekat mulut dan mikrofon jarak jauh secara tersinkron
- MAI-Transcribe di Azure Speech — Microsoft Learn — pembobotan kata kunci dan keterbatasan yang terdokumentasi
- Tulisan kami sebelumnya tentang mengapa akurasi transkripsi tak pernah menjadi hasil akhirnya