Anthropic đang đóng dấu chìm vào văn bản của Claude — và 1.922 vụ án cho thấy dấu đó không thể khắc phục điều gì
Dấu chìm văn bản của Claude nhận diện khả năng có sự tham gia của mô hình nhưng không xác minh tính chính xác: giới hạn phát hiện, những vụ cáo buộc nhầm và 1.922 trường hợp ảo giác được ghi nhận cho thấy nguồn gốc khác với sự thật ra sao.
Ngày 14 tháng 8 năm 2026, Anthropic giải thích cách đóng dấu chìm văn bản sẽ hoạt động trong các mô hình Claude tương lai. FAQ liên hệ đợt triển khai với các yêu cầu minh bạch của Đạo luật AI EU, bắt đầu áp dụng ngày 2 tháng 8. Các mô hình phát hành trước mốc đó sẽ được cập nhật trong giai đoạn chuyển tiếp; thông báo không có nghĩa mọi phản hồi Claude hiện đều mang dấu chìm.
Ý tưởng hữu ích là một tín hiệu nằm trong lựa chọn từ ngữ của mô hình. Trong điều kiện phù hợp, tín hiệu đó có thể giúp nhận diện sự tham gia của mô hình mà không làm thay đổi cách văn bản hiển thị với người đọc.
Sự khác biệt này quan trọng khi văn bản do AI tạo ra chứa bằng chứng bịa đặt. Bản chụp cơ sở dữ liệu công khai được nhắc đến bên dưới ghi nhận 1.922 vụ án liên quan đến nội dung AI bị ảo giác. Đây không phải các bài kiểm tra phát hiện dấu chìm, và chúng không cho biết một công cụ cụ thể có nhận diện được văn bản đó hay không. Chúng cho thấy một vấn đề khác: tín hiệu nguồn gốc không thể xác nhận vụ án, nghiên cứu hay sự kiện được trích dẫn có tồn tại. Hiểu khoảng cách này giúp kết quả dấu chìm hữu ích hơn và khó bị sử dụng sai hơn.
Tóm tắt:
- Không có gì được thêm vào văn bản. Khóa bí mật thay đổi tính ngẫu nhiên phía sau việc chọn từ, không thay đổi định dạng hiển thị. Anthropic dự kiến triển khai toàn cầu, bổ sung các mô hình cũ theo thời gian.
- Kết quả dương tính là bằng chứng yếu, kết quả âm tính gần như không phải bằng chứng. Chính Anthropic nói dấu này không phân biệt được "Claude viết cái này" với "Claude sửa rất nhiều cái này", yếu với văn bản ngắn, mã nguồn và các đoạn thuần sự kiện, và sẽ bị xóa nếu viết lại. Năm 2024, các nhà nghiên cứu cho thấy dưới 50 đô la là đủ để vừa xóa những dấu này vừa giả mạo chúng lên văn bản do người viết.
- Nguồn gốc không phải là kiểm chứng. Kết quả phát hiện có thể cho thấy khả năng mô hình đã tham gia, nhưng không xác thực vụ án, trích dẫn hay cuốn sách được nêu trong văn bản.
Ảnh: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Một trang đầy dấu xác thực. Mỗi con dấu chứng minh một đường biên giới đã được vượt qua. Không con dấu nào nói một lời về việc người mang hộ chiếu có nói thật hay không.
Anthropic thật sự đã thay đổi điều gì, và không thay đổi điều gì
Hãy bắt đầu từ cơ chế, vì gần như mọi hiểu lầm về sau đều bắt nguồn từ chỗ này.
Khi một mô hình ngôn ngữ viết, nó tạo ra từng từ một, và ở phần lớn vị trí không có một lựa chọn đúng duy nhất. "Cuộc họp rất hiệu quả" và "Cuộc họp rất hữu ích" đều ổn. Mô hình giữ một danh sách các từ kế tiếp chấp nhận được rồi chọn một bằng cách rút ngẫu nhiên. Đó là lý do cùng một câu lệnh cho bạn hai câu trả lời hơi khác nhau.
Dấu chìm văn bản thay lần rút ngẫu nhiên ấy bằng một lần rút giả ngẫu nhiên do khóa bí mật điều khiển. Mô hình vẫn chỉ chọn trong số những từ mà chính nó đã đánh giá là tốt ngang nhau, nên chất lượng không đổi. Nhưng qua vài trăm từ, khuôn mẫu về việc từ chấp nhận được nào thắng ở mỗi lượt sẽ không còn giống ngẫu nhiên nữa, và ai nắm khóa đều có thể đo được nó.
Không có ký tự ẩn hay siêu dữ liệu văn bản có thể loại bỏ. Tín hiệu đến từ lựa chọn từ ngữ; Anthropic cho biết cách này không thêm token và chỉ ảnh hưởng không đáng kể đến tốc độ. Chính sách triển khai áp dụng toàn cầu thay vì theo khu vực, nhưng mức độ bao phủ tùy thuộc tiến độ cập nhật mô hình; chính sách đó không chứng minh một phản hồi cụ thể đã được đóng dấu chìm.
Không có gì mới về mặt khoa học ở đây. Scott Aaronson đề xuất cách tiếp cận này năm 2022, Kirchenbauer và cộng sự công bố một phương án hoạt động được tại ICML năm 2023, và Google DeepMind công bố SynthID-Text trên Nature vào tháng 10 năm 2024 — bản triển khai của Anthropic là một phiên bản của nó. Google đã chạy nó trong Gemini từ năm 2024, báo cáo khoảng 20 triệu phản hồi thực tế mà không phát hiện khác biệt chất lượng, và từ đó tuyên bố đã đánh dấu hơn 10 tỷ nội dung.
Cập nhật ngày 12 tháng 10 năm 2026: bản FAQ của Anthropic cập nhật ngày 1 tháng 9 mô tả API phát hiện đang ở giai đoạn xem trước riêng tư dành cho các tổ chức đủ điều kiện, với kế hoạch mở rộng quyền truy cập. Thông tin này thay cho trạng thái "sắp ra mắt" trong ảnh chụp tình hình tháng 8 ban đầu. Dấu chìm ước tính mức độ Claude tham gia; nó không kiểm tra văn bản có đúng sự thật hay không.
Dấu sống sót qua sao chép dán. Nó không sống sót qua việc viết lại.
Tín hiệu nằm ở những từ nào đã được chọn, nên bất cứ thao tác nào giữ nguyên lựa chọn từ ngữ đều giữ nguyên dấu, còn thao tác nào thay thế chúng thì phá hủy dấu. Anthropic nêu giới hạn rất thẳng: "việc viết lại hoàn toàn, trong đó mọi từ đều bị thay thế, sẽ" loại bỏ nó. Có hai trường hợp phá vỡ khuôn mẫu này theo cách khiến nhiều người bất ngờ.
Văn bản ngắn và văn bản thuần sự kiện hầu như không mang được gì. Dấu chìm cần có lựa chọn để ẩn vào. Một hai câu không đủ số quyết định để tạo thành khuôn mẫu, còn nội dung nặng tính sự kiện có thể chẳng có lựa chọn thật nào — ví dụ của Anthropic rất rõ: sau "Principia của Newton", từ tiếp theo chắc chắn là "Mathematica", và không khóa nào có quyền chen vào. Cùng logic ấy làm yếu mã nguồn, nơi cú pháp quyết định phần lớn token, và việc soát lỗi, khi mô hình đổi quá ít từ để để lại tín hiệu.
Bản dịch mang dấu chìm đầy đủ. Điều này đi ngược trực giác. Nhờ Claude dịch một tài liệu sang tiếng Nhật, thì phần tiếng Nhật đó là do Claude tạo mới, từng từ một, với quyền tự do lựa chọn như thường lệ — nên nó ra đời với dấu đầy đủ, dù ý tưởng đến từ một bản gốc do người viết và không có dấu. Điều này ngược với những gì các nhà nghiên cứu DeepMind mô tả trên Nature, rằng dịch văn bản đã có dấu sang ngôn ngữ khác sẽ làm giảm mạnh độ tin cậy phát hiện. Cả hai đều đúng, vì chúng là hai kịch bản khác nhau: dịch văn bản đã có dấu ở nơi khác sẽ rửa trôi dấu, còn để chính mô hình đứng ra dịch thì đóng lên một dấu mới.
| Bạn làm gì với văn bản | Dấu có sống sót không |
|---|---|
| Sao chép và dán đi bất cứ đâu | Có — không có gì nhúng vào để việc dán có thể bóc ra |
| Sửa nhẹ: lỗi chính tả, tiêu đề, cắt bớt | Có — phần lớn lựa chọn từ ngữ vẫn nguyên vẹn |
| Nhờ mô hình dịch | Có — bản dịch được tạo mới nên mang dấu đầy đủ |
| Diễn đạt lại nhiều bằng lời của bạn | Không — bạn thay chính những lựa chọn mang tín hiệu |
| Viết lại hoàn toàn, thay mọi từ | Không — Anthropic nói rõ điều này loại bỏ dấu |
| Một đoạn trích ngắn, một hai câu | Yếu đến không có — quá ít lựa chọn để tạo khuôn mẫu |
| Mã nguồn, hoặc các đoạn thuần sự kiện | Yếu — cú pháp và sự kiện không chừa tự do cho mô hình |
| Để mô hình soát bản nháp của bạn | Yếu đến không có — quá ít từ bị đổi |
Hành vi theo đúng công bố của Anthropic trong trang hỏi đáp ngày 14/8/2026 và của nhóm tác giả SynthID-Text trên Nature, tháng 10/2024.
Dương tính là bằng chứng yếu. Âm tính gần như không phải bằng chứng.
Nếu công cụ phát hiện trả về kết quả, bạn có thể kết luận hợp lý điều gì?
Nếu dương tính: rằng một phần văn bản này đã đi qua mô hình của nhà cung cấp đó. Chỉ vậy thôi. Anthropic nói rõ rằng dấu này không phân biệt được "Claude viết cái này" với "Claude sửa rất nhiều cái này", nó không nói gì về việc bất kỳ khẳng định nào bên trong có đúng hay không, và nó không nhận ra văn bản của một AI khác, vì nó chỉ biết khóa của chính mình.
Nếu âm tính, người đó gần như không biết được gì. Một kết quả sạch chính là thứ bạn cũng nhận được từ một bản diễn đạt lại, một đoạn trích ngắn, một khối mã, mô hình của đối thủ, hoặc một mô hình trọng số mở chạy trên máy tính xách tay của ai đó mà chẳng đánh dấu gì cả.
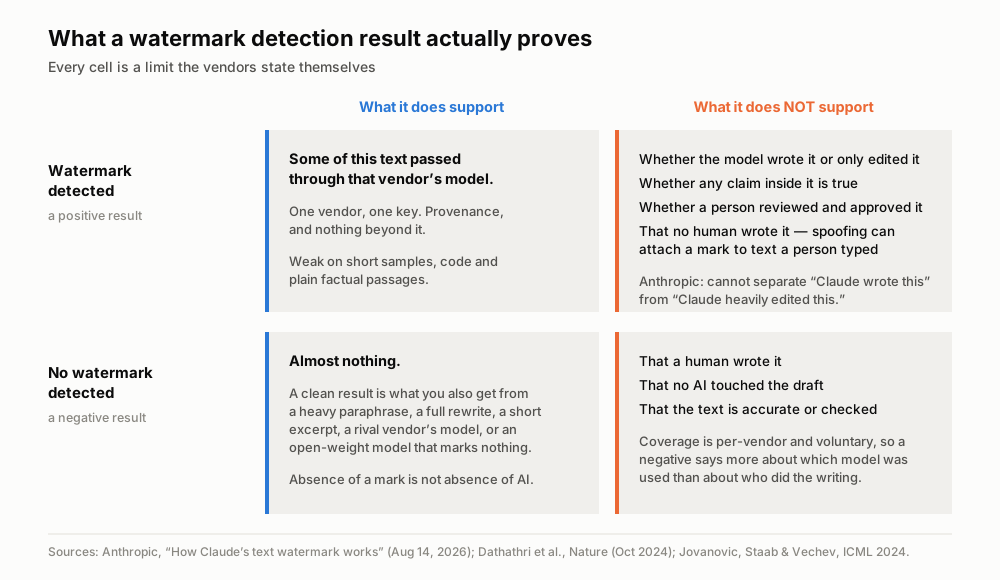
Mỗi ô ở đây là một giới hạn do chính các nhà cung cấp công bố. Nguồn: trang hỏi đáp về dấu chìm của Anthropic (14/8/2026, cập nhật 1/9); Dathathri và cộng sự, Nature (10/2024); Jovanović, Staab và Vechev, ICML 2024.
Đòn tấn công không ai dự trù lại chạy theo chiều ngược lại
Xóa dấu là rủi ro ai cũng hình dung ra: có người tẩy văn bản AI để giấu nguồn gốc. Được thôi. Nhưng có một đòn tấn công thứ hai với mũi tên chỉ theo chiều ngược, và đó mới là thứ đáng lo.
Giả mạo nghĩa là làm cho văn bản do con người viết mang dấu chìm của người khác. Không ai giấu gì cả; họ đang gài. Mục tiêu là một người sau đó bị buộc tội dùng AI, hoặc một nhà cung cấp bị quy trách nhiệm cho nội dung họ chưa từng tạo ra.
Tại ICML 2024, Jovanović, Staab và Vechev đã trình diễn cả hai đòn tấn công nhắm vào các phương án tiên tiến nhất với tỷ lệ thành công trên 80% và chi phí tính toán dưới 50 đô la. Chính nhóm tác giả DeepMind cũng thừa nhận điều tương tự trong bài báo Nature của họ: dấu chìm "không mang lại một giải pháp trọn vẹn", chúng cần sự hợp tác của nhà cung cấp mô hình mới tồn tại được, không thể áp đặt lên các mô hình trọng số mở mà ai cũng chạy được nguyên trạng, và chúng "dễ tổn thương trước các đòn đánh cắp, giả mạo và tẩy xóa". Mệnh đề cuối cùng ấy chính là toàn bộ luận điểm, do chính nhóm xây dựng công nghệ này viết ra.
Các công cụ phát hiện AI đời đầu đã cáo buộc nhầm sinh viên
Công cụ phát hiện đã tồn tại từ lâu, và đó là một công nghệ khác với lịch sử gây hại đã được ghi lại. Dấu chìm do chủ sở hữu mô hình cài vào lúc sinh văn bản, bằng một khóa. Bộ phân loại thì đoán sau khi sự việc đã rồi, dựa trên đặc điểm của chính văn bản: lựa chọn từ ngữ dễ đoán đến đâu, vốn từ đa dạng đến đâu. Cái thứ nhất biết điều gì đó. Cái thứ hai chỉ đối chiếu khuôn mẫu văn phong. Đó là khác biệt giữa đo lường và lập hồ sơ.
OpenAI ra mắt AI Text Classifier ngày 31/1/2023 và đóng nó ngày 20/7 cùng năm "do tỷ lệ chính xác thấp". Theo chính số liệu của họ: bắt được 26% văn bản AI và gắn cờ sai 9% văn bản do người viết.
Rồi tháng 7/2023, Liang và cộng sự công bố trên Patterns phát hiện lẽ ra đã chấm dứt cả nhóm công cụ này. Chạy bảy công cụ phát hiện trên các bài luận TOEFL do người không nói tiếng Anh bản ngữ viết, tỷ lệ dương tính giả trung bình là 61,3%; một công cụ gắn cờ 97,8% số bài. Khi yêu cầu viết lại chính những bài luận đó với vốn từ phong phú hơn, tỷ lệ tụt xuống 11,6%. Các công cụ này chưa bao giờ đo quyền tác giả: chúng đo độ trôi chảy, và trừng phạt bất cứ ai có tiếng Anh giản dị hơn.
Đại học Vanderbilt đã tắt công cụ phát hiện AI của Turnitin vào ngày 16/8/2023. Lời giải thích của trường dùng một phép tính giả định: áp dụng tỷ lệ dương tính giả 1% như công bố cho khoảng 75.000 bài nộp có thể khiến xấp xỉ 750 bài bị gắn cờ nhầm. Đây là ước tính rủi ro, không phải số sinh viên thực sự bị buộc tội. Thông báo của Vanderbilt.
Phát hiện dấu chìm kiểm tra một kiểu tạo sinh xác định thay vì suy luận quyền tác giả từ văn phong. Kết quả vẫn mang tính xác suất, và những đoạn ngắn hoặc bị chỉnh sửa nhiều có thể không đưa ra kết luận rõ ràng. Không nên biến kết quả về khả năng mô hình tham gia thành lời buộc tội một cá nhân; nghiên cứu về giả mạo cũng cho thấy vì sao chỉ phát hiện thôi không thể xác lập quyền tác giả.
Quy định đến trước công cụ
Sở dĩ mọi thứ dồn vào trong hai tuần là vì giới lập pháp đã đi trước.
Đạo luật AI của EU chia nghĩa vụ làm hai. Điều 50(2) ràng buộc nhà cung cấp: ai xây dựng hệ thống sinh nội dung phải đánh dấu đầu ra ở dạng máy đọc được, bao gồm cả văn bản. Điều 50(4) ràng buộc bạn: bên triển khai khi đăng tải văn bản do AI tạo ra nhằm "thông tin cho công chúng về các vấn đề lợi ích công" phải công bố điều đó.
Và điều khoản thứ hai đi kèm một ngoại lệ mà với phần lớn người đọc chính là trái tim thực tế của cả cơ chế. Nghĩa vụ không áp dụng khi nội dung đã qua rà soát của con người hoặc kiểm soát biên tập và có một người chịu trách nhiệm biên tập về nó. Hãy đọc lại hai lần. Câu trả lời của châu Âu cho văn bản do AI tạo ra không phải một công cụ phát hiện. Đó là một con người có tên tuổi đã rà soát nó và chịu trách nhiệm về nó.
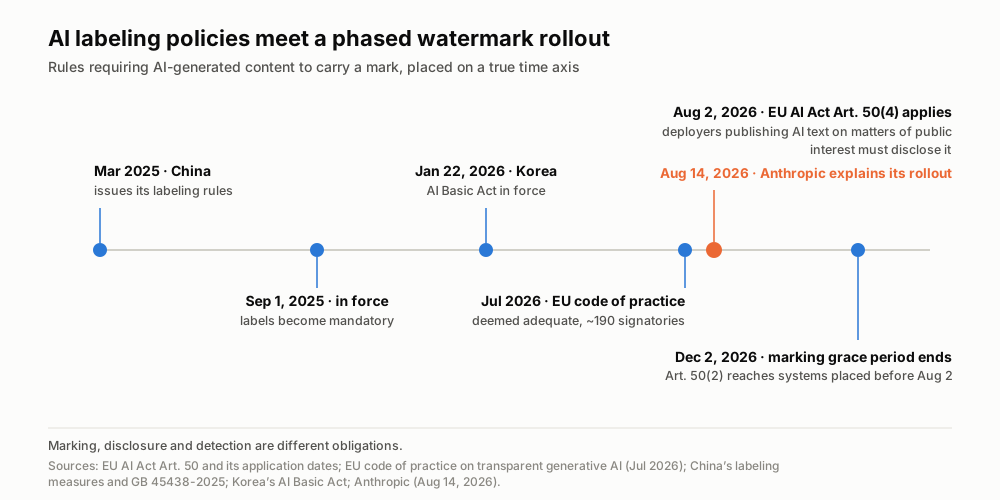
Nghĩa vụ gắn nhãn đến đúng lịch; công cụ phát hiện dùng được thì không. Nguồn: Đạo luật AI của EU và các mốc áp dụng, bộ quy tắc ứng xử về minh bạch của EU (tháng 7/2026), các biện pháp gắn nhãn của Trung Quốc và tiêu chuẩn GB 45438-2025, Luật Cơ bản về AI của Hàn Quốc, và thông báo của Anthropic.
Ủy ban châu Âu mô tả bộ quy tắc minh bạch là khuôn khổ tuân thủ tự nguyện, không thay thế luật; đến cuối tháng 7/2026, khoảng 190 tổ chức đã ký. FAQ của Ủy ban cho các hệ thống được đưa ra thị trường trước ngày 2/8 thời gian chuyển tiếp đến ngày 2/12/2026. Cần phân biệt lịch triển khai của bên ký kết với nghĩa vụ pháp lý; hai điều này không thể thay thế cho nhau. Tổng quan của Ủy ban, FAQ của Ủy ban.
Các khu vực pháp lý khác áp dụng quy tắc khác nhau. Biện pháp gắn nhãn của Trung Quốc có hiệu lực từ ngày 1/9/2025, yêu cầu nhãn hiển thị và nhãn nhúng theo tiêu chuẩn GB 45438-2025. Luật Cơ bản về AI của Hàn Quốc có hiệu lực ngày 22/1/2026. Khi đánh giá việc tuân thủ, cần xem xét khu vực pháp lý và loại nội dung áp dụng, thay vì giả định có một quy tắc gắn nhãn chung cho toàn cầu.
Còn một khoảng trống nữa thuộc về đây. Wall Street Journal đưa tin năm 2024 rằng OpenAI đã xây dựng một phương pháp dấu chìm văn bản được mô tả nội bộ là chính xác khoảng 99,9%. Hãy coi đó là một bản tin, không phải một sự thật: con số này chưa từng được kiểm chứng độc lập và OpenAI chưa bao giờ triển khai đánh dấu văn bản. Chính bài đăng ngày 11/6/2026 của họ về tuân thủ ở EU chỉ nói về nguồn gốc hình ảnh, và thừa nhận giới hạn chung bằng lời của chính họ: "siêu dữ liệu có thể bị gỡ bỏ, dấu chìm có thể suy giảm."
Dấu chìm không thể xác minh trích dẫn bị ảo giác
Damien Charlotin duy trì một cơ sở dữ liệu công khai về các bản án trên khắp thế giới trong đó tòa phải xử lý nội dung do AI tạo ra có chứa ảo giác. Truy xuất ngày 16/8/2026, con số là 1.922 bản án. Diễn biến: khoảng 200 vào giữa năm 2025, 719 vào tháng 1/2026, 1.227 vào tháng 4, 1.598 vào ngày 9/6, và 1.922 hôm nay — riêng mười tuần gần nhất đã thêm 324 vụ.
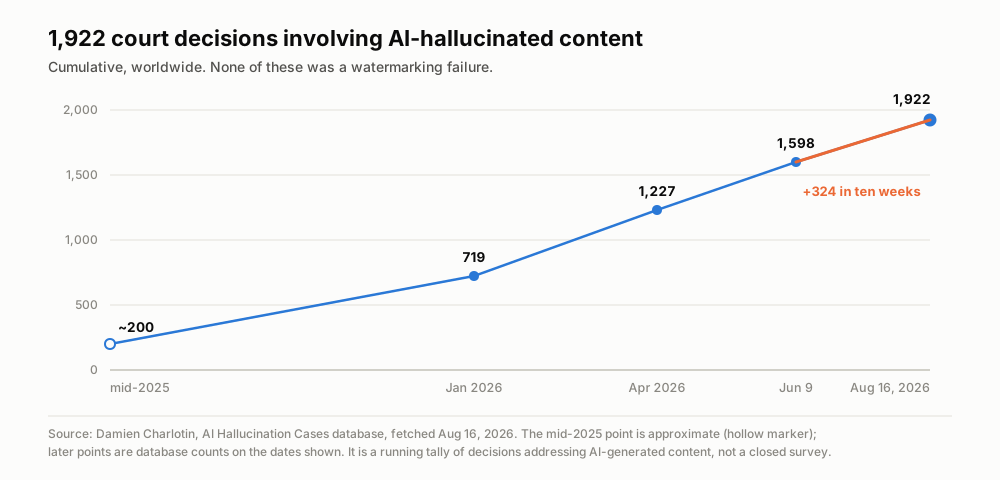
Các vụ này ghi nhận hiện tượng ảo giác, không phải kết quả thử nghiệm dấu chìm. Dấu xác minh nguồn gốc không thể xác nhận các khẳng định thực tế trong đó. Nguồn: cơ sở dữ liệu vụ việc ảo giác AI của Damien Charlotin, truy xuất ngày 16/8/2026.
Nguyên mẫu là vụ Mata v. Avianca, được xử tại Quận Nam New York ngày 22/6/2023: một bản trình bày viện dẫn sáu bản án không hề tồn tại, và mức phạt 5.000 đô la.
Nhưng ví dụ đáng nặng ký nhất lại thuộc về Anthropic. Tháng 5/2025, trong vụ Concord Music v. Anthropic, chính các luật sư của công ty đã nộp một bản khai của chuyên gia trích dẫn một nghiên cứu do Claude bịa ra. Việc kiểm tra thủ công đã bỏ sót; luật sư phải xin lỗi tòa. Chính công ty hôm nay ra mắt dấu chìm văn bản từng vấp phải việc trích dẫn thiếu phê phán — đầu ra của mô hình của chính họ, trong vụ kiện của chính họ, qua sự rà soát của luật sư của chính họ. Ngay cả kết quả dấu chìm dương tính cũng không thể chứng minh nghiên cứu được trích dẫn đó có tồn tại hay không.
Chuyện này vượt ra ngoài tòa án. Tháng 10/2025, Deloitte Australia đồng ý hoàn lại một phần cho bản báo cáo chính phủ trị giá 440.000 đô la Úc chứa các tài liệu tham khảo không tồn tại và một câu trích dẫn bịa đặt từ bản án. Ngày 18/5/2025, Chicago Sun-Times và Philadelphia Inquirer đăng một danh sách sách đọc mùa hè phát hành theo hệ thống, trong đó chỉ năm trên mười lăm cuốn là có thật. Liang và cộng sự, phân tích 950.965 bài báo trong arXiv:2404.01268, thấy nội dung do LLM chỉnh sửa lên tới 17,5% trong phần tóm tắt của ngành khoa học máy tính, so với 6,3% hoặc thấp hơn ở toán học và nhóm tạp chí Nature.
Câu hỏi về khối lượng cũng xứng đáng có một con số trung thực thay vì một con số gây hoảng. Phân tích Common Crawl của Graphite công bố tháng 10/2025 cho thấy khoảng 51,7% bài báo mới trong mẫu là do AI viết vào tháng 5/2025 — và Axios, khi đưa tin, đã thêm lưu ý quan trọng: tỷ lệ này đã chững lại quanh mức một nửa thay vì tiếp tục leo thang. Đây không phải một trận lụt. Đây là một trạng thái bình thường mới.
Và đây là điểm mấu chốt. Không có mục nào trong danh sách đó là thất bại của dấu chìm. Trong mọi trường hợp, nguồn gốc chưa bao giờ là điều gây tranh cãi: ai cũng biết có mô hình tham gia, hoặc sẽ chấp nhận điều đó ngay lập tức. Thứ đã thất bại là không ai mở trích dẫn ra để kiểm tra xem vụ án đó, nghiên cứu đó, cuốn sách đó có tồn tại hay không.
Kết luận: nguồn gốc không phải là kiểm chứng
Hãy gọi đó là ngụy biện dấu bưu điện. Dấu bưu điện chứng minh bưu cục nào đã xử lý lá thư. Nó chưa bao giờ có ý kiến gì về việc lá thư có nói thật hay không. Chúng ta vừa dồn rất nhiều công sức kỹ thuật để tạo ra một con dấu bưu điện rất tốt, và một phần cuộc thảo luận công cộng sắp nhầm nó với một người kiểm chứng sự thật.
Hãy giữ cùng lúc ba điều. Kết quả dương tính là bằng chứng về khả năng mô hình đã tham gia, không phải quyền tác giả hay sự thật. Kết quả âm tính không thể chứng minh con người đã viết văn bản. Phạm vi bao phủ tùy thuộc vào nhà cung cấp, khóa của họ và các mô hình dùng dấu chìm đó; không có tính phổ quát. API xem trước riêng tư đã cập nhật của Anthropic cũng có điều kiện về đối tượng đủ tư cách, chứ không mở công khai không hạn chế.
Điều đứng vững sau khi bị xem xét không phải là dấu trên đầu ra, mà là hồ sơ có thể đối chiếu lại với nguồn: bản ghi âm vẫn còn đó, bản chép lời có dấu thời gian để mở lại, câu nói gắn với đúng người đã nói, hay khẳng định dẫn đến tài liệu gốc bạn có thể mở ra. Chúng tôi từng lập luận như vậy về dịch trực tiếp, nơi ghi chú kiểm tra lại được quan trọng hơn đầu ra trôi chảy, và về việc gỡ băng lấy lời khai của cảnh sát, nơi hồ sơ phải trụ được khi có người phản bác. Kỷ nguyên dấu chìm làm lập luận đó sắc bén hơn: khi việc đánh dấu trở nên phổ quát, câu "có AI tham gia" sẽ không còn phân biệt được điều gì.
Dấu chìm trả lời văn bản đến từ đâu. Chưa ai xây được công cụ trả lời nó có đúng hay không, bởi câu trả lời không nằm ở một bộ phát hiện mà ở nguồn bạn có thể quay lại.
Telli.sh đứng ở đâu: chúng tôi xây đúng cái nguồn để bạn quay lại. Telli.sh ghi âm cuộc họp, tạo bản gỡ băng có mốc thời gian và phân định người nói, và neo bản tóm tắt vào chính đoạn âm thanh sinh ra nó — nên bất kỳ dòng nào trong ghi chú của bạn, nhiều tháng sau vẫn truy về được đúng giây ai đó nói ra câu ấy. Đây không phải lời tuyên bố về việc phát hiện AI. Đây là nửa còn lại của bài toán: khi bản tóm tắt khẳng định điều gì, bạn có thể đối chiếu với bản ghi âm thay vì tin vào câu chữ.
Nguồn
- Anthropic, "How Claude's text watermark works" (tháng 8/2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (tháng 10/2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (tháng 7/2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, cơ sở dữ liệu vụ việc ảo giác AI
- Ủy ban châu Âu, Điều 50 của Đạo luật AI: nghĩa vụ minh bạch
- Trang ảnh trên Wikimedia Commons
