Anthropic กำลังฝังลายน้ำในข้อความของ Claude — และคดีในศาล 1,922 คดีชี้ให้เห็นว่าลายน้ำแก้ปัญหาอะไรไม่ได้
ลายน้ำข้อความของ Claude ชี้ถึงความเป็นไปได้ที่โมเดลมีส่วนร่วม แต่ไม่ได้ตรวจสอบความถูกต้อง: ข้อจำกัดของการตรวจจับ การกล่าวหาผิด และคดีหลอนข้อมูลที่บันทึกไว้ 1,922 คดีเผยให้เห็นความต่างระหว่างที่มากับความจริงอย่างไร
วันที่ 14 สิงหาคม 2026 Anthropic อธิบายว่าลายน้ำข้อความจะทำงานอย่างไรในโมเดล Claude รุ่นต่อ ๆ ไป FAQ เชื่อมโยงการทยอยเปิดใช้กับข้อกำหนดด้านความโปร่งใสของกฎหมาย AI สหภาพยุโรป ซึ่งเริ่มมีผลวันที่ 2 สิงหาคม โมเดลที่ออกก่อนวันดังกล่าวจะได้รับการอัปเดตในช่วงเปลี่ยนผ่าน; ประกาศนี้ไม่ได้หมายความว่าคำตอบ Claude ทุกคำตอบมีลายน้ำอยู่แล้ว
แนวคิดที่เป็นประโยชน์คือสัญญาณที่ซ่อนอยู่ในตัวเลือกคำของโมเดล ภายใต้เงื่อนไขที่เหมาะสม สัญญาณนี้ช่วยระบุการมีส่วนร่วมของโมเดลได้โดยไม่เปลี่ยนหน้าตาข้อความที่ผู้อ่านเห็น
ความแตกต่างนี้สำคัญเมื่อข้อความที่สร้างขึ้นมีหลักฐานปลอมปนอยู่ ภาพข้อมูลจากฐานข้อมูลสาธารณะที่กล่าวถึงด้านล่างบันทึก 1,922 คดีในศาล ที่เกี่ยวข้องกับเนื้อหาซึ่ง AI หลอนขึ้นมา ข้อมูลเหล่านี้ไม่ใช่การทดสอบตรวจจับลายน้ำ และไม่ได้บอกว่าเครื่องตรวจจับใดจะระบุข้อความเหล่านั้นได้หรือไม่ แต่แสดงปัญหาอีกอย่างหนึ่ง: สัญญาณระบุที่มาไม่สามารถยืนยันได้ว่าคดี งานวิจัย หรือข้อเท็จจริงที่อ้างถึงมีอยู่จริง การเข้าใจช่องว่างนี้ทำให้ผลลายน้ำมีประโยชน์ขึ้นและถูกนำไปใช้ผิดได้ยากขึ้น
สรุปสั้น
- ไม่มีอะไรถูกเพิ่มเข้าไปในข้อความ กุญแจลับเปลี่ยนความสุ่มเบื้องหลังการเลือกคำ ไม่ใช่รูปแบบที่มองเห็นได้ Anthropic วางแผนทยอยเปิดใช้ทั่วโลก และเพิ่มโมเดลเก่าตามลำดับ
- ผลบวกคือหลักฐานอ่อน ส่วนผลลบแทบไม่ใช่หลักฐานเลย Anthropic เขียนเองว่าเครื่องหมายนี้แยกไม่ออกระหว่าง "Claude เขียนสิ่งนี้" กับ "Claude แก้สิ่งนี้อย่างหนัก" อ่อนมากกับข้อความสั้น โค้ด และย่อหน้าที่เป็นข้อเท็จจริงล้วน และถูกลบทิ้งเมื่อเขียนใหม่ ปี 2024 นักวิจัยแสดงให้เห็นว่าใช้เงินไม่ถึง 50 ดอลลาร์ก็ทั้งลบเครื่องหมายเหล่านี้ได้ และ ปลอมมันลงบนข้อความที่มนุษย์เขียนได้ด้วย
- ที่มาไม่ใช่การตรวจสอบ ผลตรวจจับอาจบ่งชี้ว่าโมเดลมีส่วนร่วม แต่ไม่ได้ยืนยันว่าคดี แหล่งอ้างอิง หรือหนังสือที่กล่าวถึงในข้อความมีอยู่จริง
ภาพ: Jon Rawlinson, Wikimedia Commons, CC BY 2.0 หน้ากระดาษที่เต็มไปด้วยเครื่องหมายรับรองความแท้ ทุกดวงพิสูจน์ว่ามีการข้ามพรมแดนเกิดขึ้น ไม่มีดวงไหนพูดสักคำว่าผู้เดินทางพูดความจริงหรือเปล่า
Anthropic เปลี่ยนอะไรจริง ๆ และไม่ได้เปลี่ยนอะไร
เริ่มจากกลไกก่อน เพราะความเข้าใจผิดเกือบทั้งหมดที่ตามมาเกิดจากการเข้าใจตรงนี้พลาด
เวลาโมเดลภาษาเขียน มันผลิตทีละคำ และในตำแหน่งส่วนใหญ่ไม่มีคำตอบที่ถูกต้องเพียงคำเดียว "การประชุมครั้งนี้ ได้ผล" กับ "การประชุมครั้งนี้ มีประโยชน์" ใช้ได้ทั้งคู่ โมเดลถือรายการคำถัดไปที่ยอมรับได้อยู่ในมือ แล้วสุ่มหยิบมาหนึ่งคำ นี่คือเหตุผลที่คำสั่งเดียวกันให้คำตอบต่างกันเล็กน้อยเมื่อถามสองครั้ง
ลายน้ำในข้อความเปลี่ยนการสุ่มนั้นให้เป็นการสุ่ม เทียม ที่ขับเคลื่อนด้วยกุญแจลับ โมเดลยังคงเลือกเฉพาะจากคำที่มันตัดสินว่าดีพอกันอยู่แล้ว คุณภาพจึงไม่ถูกแตะต้อง แต่เมื่อผ่านไปไม่กี่ร้อยคำ รูปแบบว่าคำที่ยอมรับได้คำใดชนะในแต่ละครั้งจะเลิกดูเหมือนความบังเอิญ และใครที่ถือกุญแจก็วัดมันได้
ไม่มีอักขระซ่อนหรือเมทาดาทาข้อความที่ลบออกได้ สัญญาณมาจากตัวเลือกคำ และ Anthropic ระบุว่าไม่เพิ่ม token และส่งผลต่อความเร็วเพียงเล็กน้อย นโยบายการเปิดใช้ครอบคลุมทั่วโลก ไม่ได้แบ่งตามภูมิภาค แต่ความครอบคลุมของโมเดลขึ้นอยู่กับการทยอยอัปเดต; นโยบายเพียงอย่างเดียวไม่ได้ยืนยันว่าคำตอบใดคำตอบหนึ่งมีลายน้ำ
ทั้งหมดนี้ไม่ใช่วิทยาศาสตร์ใหม่ สก็อตต์ แอรอนสัน เสนอแนวทางนี้ในปี 2022 เคียร์เชนบาวเออร์และคณะตีพิมพ์วิธีที่ใช้งานได้จริงในงาน ICML ปี 2023 และ Google DeepMind ตีพิมพ์ SynthID-Text ใน Nature เดือนตุลาคม 2024 การนำไปใช้ของ Anthropic ก็เป็นรุ่นหนึ่งของสิ่งนั้น Google รันมันใน Gemini มาตั้งแต่ปี 2024 โดยรายงานว่าคำตอบจริงราว 20 ล้านครั้งไม่พบความต่างด้านคุณภาพ และนับจากนั้นก็อ้างว่าได้ฝังลายน้ำในเนื้อหามากกว่า 1 หมื่นล้านชิ้น
อัปเดต 12 ตุลาคม 2026: FAQ ของ Anthropic ฉบับปรับปรุงเมื่อวันที่ 1 กันยายนระบุว่า API ตรวจจับอยู่ในช่วงทดสอบแบบส่วนตัวสำหรับองค์กรที่มีคุณสมบัติตามเกณฑ์ และมีแผนขยายการเข้าถึง ข้อมูลนี้แทนสถานะ "เร็ว ๆ นี้" ในภาพสถานการณ์เดิมเมื่อเดือนสิงหาคม ลายน้ำประเมินความเป็นไปได้ที่ Claude มีส่วนร่วม แต่ไม่ได้ตรวจว่าข้อความนั้นเป็นความจริงหรือไม่
เครื่องหมายรอดจากการคัดลอกวาง แต่ไม่รอดจากการเขียนใหม่
สัญญาณอยู่ที่ คำใดถูกเลือก ดังนั้นอะไรก็ตามที่รักษาการเลือกคำไว้ก็รักษาเครื่องหมายไว้ และอะไรก็ตามที่แทนที่การเลือกคำก็ทำลายมัน Anthropic ระบุเพดานไว้ตรงไปตรงมาว่า "การเขียนใหม่ทั้งหมดโดยเปลี่ยนทุกคำจะ" ลบมันออก แต่มีสองกรณีที่หักล้างรูปแบบนี้ในแบบที่หลายคนคาดไม่ถึง
ข้อความสั้นและข้อความเชิงข้อเท็จจริงแทบไม่บรรจุอะไรเลย ลายน้ำต้องการทางเลือกไว้ซ่อนตัว ประโยคหนึ่งหรือสองประโยคไม่ให้การตัดสินใจมากพอจะก่อรูปแบบ ส่วนเนื้อหาที่หนักไปทางข้อเท็จจริงอาจไม่มีทางเลือกจริงเลย ตัวอย่างของ Anthropic ชัดมาก หลังคำว่า "Principia ของนิวตัน" คำถัดไปย่อมเป็น "Mathematica" และไม่มีกุญแจใดมีสิทธิ์ออกเสียง ตรรกะเดียวกันทำให้โค้ดอ่อนแอ เพราะไวยากรณ์กำหนดโทเคนส่วนใหญ่ไว้แล้ว และการตรวจพิสูจน์อักษรก็เช่นกัน เพราะโมเดลเปลี่ยนคำน้อยเกินกว่าจะทิ้งสัญญาณไว้
การแปลพกลายน้ำเต็มรูปแบบ ข้อนี้สวนสัญชาตญาณ ถ้าคุณให้ Claude แปลเอกสารเป็นภาษาญี่ปุ่น ข้อความภาษาญี่ปุ่นนั้นคือสิ่งที่ Claude สร้างขึ้นใหม่ ทีละคำ พร้อมอิสระในการเลือกตามปกติ มันจึงออกมาโดยมีเครื่องหมายเต็ม แม้ความคิดจะมาจากต้นฉบับของมนุษย์ที่ไม่มีเครื่องหมายก็ตาม นี่ตรงข้ามกับสิ่งที่นักวิจัย DeepMind อธิบายไว้ใน Nature ซึ่งระบุว่าการแปลข้อความที่มีลายน้ำไปเป็นอีกภาษาหนึ่งจะลดความมั่นใจในการตรวจจับลงมาก ทั้งสองอย่างจริง เพราะเป็นคนละสถานการณ์ การแปลข้อความที่มีเครื่องหมายด้วย เครื่องมืออื่น จะชะล้างเครื่องหมายออก ส่วนการให้โมเดล เป็นผู้แปลเอง จะประทับเครื่องหมายใหม่ลงไป
| สิ่งที่คุณทำกับข้อความ | เครื่องหมายรอดหรือไม่ |
|---|---|
| คัดลอกไปวางที่ไหนก็ได้ | รอด — ไม่มีอะไรฝังอยู่ที่การวางจะดึงออกได้ |
| แก้ไขเบา ๆ เช่น คำผิด หัวข้อ ตัดทอน | รอด — การเลือกคำส่วนใหญ่ยังคงเดิม |
| ให้โมเดลแปลให้ | รอด — คำแปลถูกสร้างใหม่ จึงมีเครื่องหมายเต็ม |
| ถอดความใหม่หนัก ๆ ด้วยคำของคุณเอง | ไม่รอด — คุณแทนที่การเลือกคำที่แบกสัญญาณไว้ |
| เขียนใหม่ทั้งหมด เปลี่ยนทุกคำ | ไม่รอด — Anthropic ระบุว่าวิธีนี้ลบมันออก |
| ข้อความสั้นเพียงหนึ่งถึงสองประโยค | อ่อนถึงไม่มีเลย — ทางเลือกน้อยเกินจะก่อรูปแบบ |
| โค้ด หรือย่อหน้าที่เป็นข้อเท็จจริงล้วน | อ่อน — ไวยากรณ์และข้อเท็จจริงไม่เหลืออิสระให้โมเดล |
| ให้โมเดลตรวจแก้ร่างของคุณ | อ่อนถึงไม่มีเลย — คำที่เปลี่ยนมีน้อยเกินไป |
พฤติกรรมตามที่ Anthropic ระบุในคำถามที่พบบ่อยวันที่ 14 สิงหาคม 2026 และตามที่คณะผู้เขียน SynthID-Text ระบุใน Nature เดือนตุลาคม 2024
ผลบวกคือหลักฐานอ่อน ผลลบแทบไม่ใช่หลักฐานเลย
หากตัวตรวจจับให้ผลลัพธ์ คุณสรุปอะไรได้อย่างสมเหตุสมผล?
ถ้าผลเป็นบวก เขารู้ว่าข้อความส่วนหนึ่งผ่านโมเดลของผู้ให้บริการรายนั้นมา แค่นั้น Anthropic ระบุชัดว่าเครื่องหมายนี้ แยกไม่ออกระหว่าง "Claude เขียนสิ่งนี้" กับ "Claude แก้สิ่งนี้อย่างหนัก" มันไม่บอกอะไรเลยว่าข้ออ้างใดในนั้นเป็นจริงหรือไม่ และมันจำข้อความจาก AI เจ้าอื่น ไม่ได้ เพราะมันรู้จักแค่กุญแจของตัวเอง
ถ้าผลเป็นลบ เขาแทบไม่รู้อะไรเลย ผลที่สะอาดคือสิ่งเดียวกับที่คุณได้จากการถอดความหนัก ๆ ข้อความสั้น บล็อกโค้ด โมเดลของคู่แข่ง หรือโมเดลน้ำหนักเปิดที่รันอยู่บนแล็ปท็อปของใครสักคนโดยไม่ทำเครื่องหมายอะไรเลย
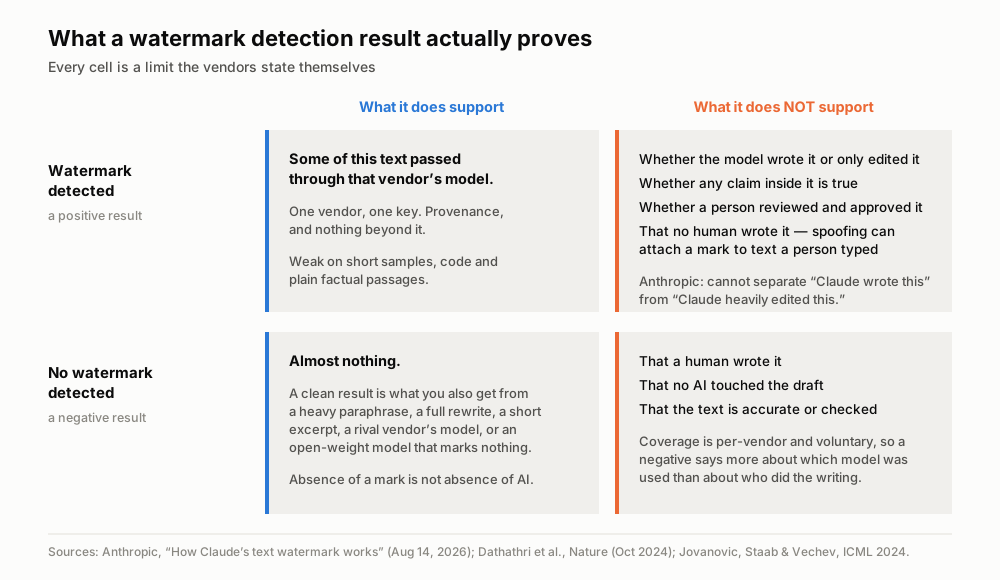
ทุกช่องในนี้คือข้อจำกัดที่ผู้ให้บริการเผยแพร่ด้วยตัวเอง ที่มา: คำถามที่พบบ่อยเรื่องลายน้ำของ Anthropic (14 สิงหาคม 2026, อัปเดต 1 กันยายน); Dathathri และคณะ, Nature (ตุลาคม 2024); Jovanović, Staab และ Vechev, ICML 2024
การโจมตีที่ไม่มีใครตั้งงบรับมือนั้นวิ่งย้อนทิศ
การลบเครื่องหมายคือความเสี่ยงที่ทุกคนนึกออก มีคนฟอกข้อความ AI เพื่อกลบต้นทาง เอาล่ะ แต่ยังมีการโจมตีแบบที่สองที่ลูกศรชี้กลับทาง และนั่นคือสิ่งที่ควรทำให้คุณกังวล
การปลอมแปลง คือการทำให้ข้อความที่ มนุษย์ เขียนพกลายน้ำของคนอื่น ไม่มีใครซ่อนอะไร แต่กำลังยัดของ เป้าหมายคือคนที่จะถูกกล่าวหาว่าใช้ AI หรือผู้ให้บริการที่จะถูกโทษสำหรับผลลัพธ์ที่ตัวเองไม่เคยผลิต
ในงาน ICML ปี 2024 Jovanović, Staab และ Vechev สาธิตการโจมตีทั้งสองแบบกับวิธีการที่ล้ำสมัยที่สุด ด้วย อัตราสำเร็จเกิน 80% และใช้เงินคำนวณไม่ถึง 50 ดอลลาร์ คณะผู้เขียนจาก DeepMind ก็ยอมรับจุดเดียวกันในบทความ Nature ของตัวเองว่า ลายน้ำ "ไม่ได้ให้ทางออกที่ครบถ้วน" ต้องอาศัยความร่วมมือของผู้ให้บริการโมเดลจึงจะมีอยู่ได้ บังคับใช้กับโมเดลน้ำหนักเปิดที่ใครก็รันได้ตามเดิมไม่ได้ และ "เปราะบางต่อการโจมตีแบบขโมย ปลอมแปลง และลบทิ้ง" อนุประโยคสุดท้ายนั่นคือข้อโต้แย้งทั้งหมด เขียนโดยทีมที่สร้างเทคโนโลยีนี้ขึ้นมาเอง
เครื่องมือตรวจจับ AI ยุคแรกกล่าวหานักศึกษาผิดคน
เครื่องมือตรวจจับมีอยู่แล้ว และมันเป็นคนละเทคโนโลยีที่มีประวัติสร้างความเสียหายบันทึกไว้ชัดเจน ลายน้ำ ถูกฝังตอนสร้างข้อความโดยเจ้าของโมเดลด้วยกุญแจ ส่วน ตัวจำแนก เป็นการเดาย้อนหลังจากลักษณะของตัวข้อความเอง เช่น การเลือกคำคาดเดาได้แค่ไหน คลังคำหลากหลายเพียงใด อย่างแรกรู้บางอย่าง อย่างหลังแค่จับคู่รูปแบบสำนวน นั่นคือความต่างระหว่างการวัดกับการจัดโปรไฟล์
OpenAI เปิดตัว AI Text Classifier เมื่อวันที่ 31 มกราคม 2023 และปิดมันในวันที่ 20 กรกฎาคมปีเดียวกัน "เนื่องจากอัตราความแม่นยำต่ำ" ตัวเลขของเขาเอง จับข้อความ AI ได้ 26% และติดธงข้อความมนุษย์ผิดพลาด 9%
จากนั้นเดือนกรกฎาคม 2023 Liang และคณะตีพิมพ์ใน Patterns ผลที่ควรจะปิดฉากเครื่องมือประเภทนี้ไปเลย เมื่อทดสอบตัวตรวจจับเจ็ดตัวกับเรียงความ TOEFL ที่เขียนโดยผู้ที่ไม่ได้ใช้ภาษาอังกฤษเป็นภาษาแม่ อัตราผลบวกลวงเฉลี่ยอยู่ที่ 61.3% ตัวหนึ่งติดธงเรียงความเหล่านั้นถึง 97.8% แต่เมื่อให้เขียนเรียงความชุดเดิมใหม่ด้วยคลังคำที่หลากหลายขึ้น อัตราดังกล่าวลดลงเหลือ 11.6% ตัวตรวจจับไม่เคยวัดความเป็นผู้เขียนเลย มันวัดความคล่องแคล่ว และลงโทษใครก็ตามที่ภาษาอังกฤษเรียบง่ายกว่า
มหาวิทยาลัยแวนเดอร์บิลต์ปิดตัวตรวจจับ AI ของ Turnitin เมื่อวันที่ 16 สิงหาคม 2023 คำอธิบายของมหาวิทยาลัยใช้การคำนวณสมมติ: หากใช้อัตราผลบวกลวง 1% ตามที่อ้างกับงานที่ส่งประมาณ 75,000 ชิ้น ก็อาจติดธงผิดราว 750 ชิ้น นั่นคือการประเมินความเสี่ยง ไม่ใช่จำนวนคนที่ถูกกล่าวหาจริง ประกาศของแวนเดอร์บิลต์
การตรวจจับลายน้ำทดสอบรูปแบบการสร้างข้อความที่กำหนดไว้ แทนที่จะอนุมานผู้เขียนจากสำนวน ผลลัพธ์ยังเป็นเพียงความน่าจะเป็น และข้อความสั้นหรือผ่านการแก้ไขอย่างหนักอาจสรุปไม่ได้ ไม่ควรเปลี่ยนผลที่บอกว่าโมเดลอาจมีส่วนร่วมให้กลายเป็นข้อกล่าวหาต่อบุคคลใดบุคคลหนึ่ง งานวิจัยเรื่องการปลอมแปลงยังแสดงให้เห็นด้วยว่าเหตุใดการตรวจจับเพียงอย่างเดียวจึงยืนยันผู้เขียนไม่ได้
กฎระเบียบมาถึงก่อนเครื่องมือ
ที่ทุกอย่างมากระจุกกันในสองสัปดาห์เดียว เป็นเพราะฝ่ายนิติบัญญัติขยับก่อน
กฎหมาย AI ของสหภาพยุโรปแบ่งหน้าที่ออกเป็นสองส่วน มาตรา 50(2) ผูกมัดผู้ให้บริการ ใครสร้างระบบสร้างเนื้อหาต้องทำเครื่องหมายผลลัพธ์ในรูปแบบที่เครื่องอ่านได้ รวมถึงข้อความด้วย ส่วน มาตรา 50(4) ผูกมัดคุณ ผู้นำไปใช้ที่เผยแพร่ข้อความซึ่ง AI สร้างขึ้นและ "ให้ข้อมูลแก่สาธารณะในเรื่องที่เป็นประโยชน์สาธารณะ" ต้องเปิดเผยเรื่องนี้
และข้อหลังมีข้อยกเว้นที่สำหรับผู้อ่านส่วนใหญ่ถือเป็นหัวใจในทางปฏิบัติของทั้งระบบ หน้าที่นี้ไม่ใช้บังคับเมื่อเนื้อหา ผ่านการตรวจทานของมนุษย์หรือการควบคุมด้านบรรณาธิการ และมีบุคคลรับผิดชอบทางบรรณาธิการต่อเนื้อหานั้น อ่านซ้ำอีกรอบ คำตอบของยุโรปต่อข้อความที่ AI สร้างขึ้นไม่ใช่ตัวตรวจจับ แต่คือมนุษย์ที่มีชื่อระบุชัด ผู้ตรวจทานสิ่งนั้นและรับผิดชอบต่อมัน
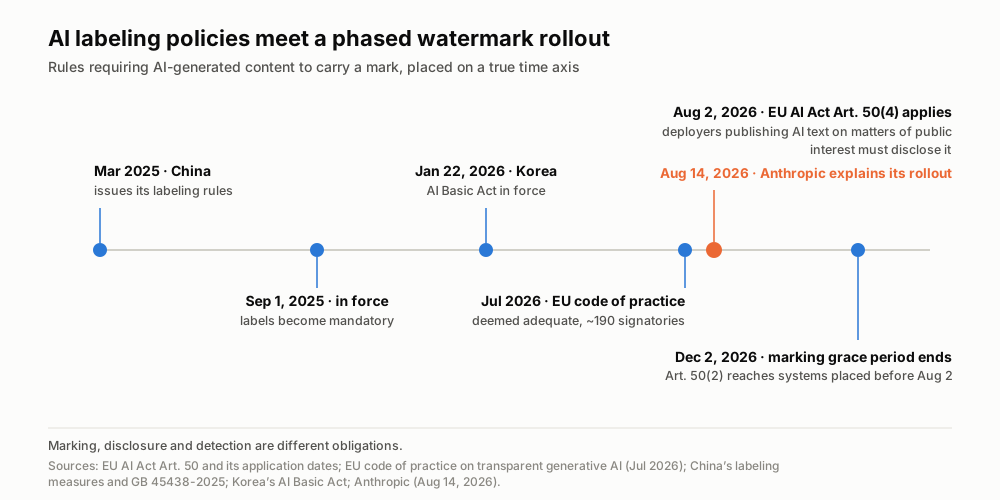
ภาระหน้าที่ด้านการติดฉลากมาตามกำหนด แต่เครื่องมือตรวจจับที่ใช้ได้จริงไม่มา ที่มา: กฎหมาย AI ของสหภาพยุโรปและกำหนดการบังคับใช้, แนวปฏิบัติด้านความโปร่งใสของสหภาพยุโรป (กรกฎาคม 2026), มาตรการติดฉลากของจีนและมาตรฐาน GB 45438-2025, กฎหมายพื้นฐานด้าน AI ของเกาหลี และประกาศของ Anthropic
คณะกรรมาธิการยุโรปอธิบายแนวปฏิบัติด้านความโปร่งใสว่าเป็นกรอบการปฏิบัติตามโดยสมัครใจ ไม่ใช่สิ่งทดแทนกฎหมาย และมีองค์กรลงนามราว 190 แห่งเมื่อสิ้นเดือนกรกฎาคม 2026 คำถามที่พบบ่อยของคณะกรรมาธิการระบุว่าระบบที่วางตลาดก่อนวันที่ 2 สิงหาคมมีช่วงเปลี่ยนผ่านจนถึงวันที่ 2 ธันวาคม 2026 จุดนี้สำคัญ: กำหนดการดำเนินการของผู้ลงนามกับข้อผูกพันทางกฎหมายใช้แทนกันไม่ได้ ภาพรวมของคณะกรรมาธิการ, คำถามที่พบบ่อยของคณะกรรมาธิการ
เขตอำนาจศาลอื่นมีกฎต่างกัน มาตรการติดฉลากของจีนมีผลตั้งแต่วันที่ 1 กันยายน 2025 โดยกำหนดฉลากที่มองเห็นและฉลากฝังในตามมาตรฐาน GB 45438-2025 กฎหมายพื้นฐานด้าน AI ของเกาหลีมีผลวันที่ 22 มกราคม 2026 ผู้อ่านที่ประเมินการปฏิบัติตามกฎควรพิจารณาเขตอำนาจศาลและประเภทเนื้อหาที่เกี่ยวข้อง ไม่ใช่กฎติดฉลากเดียวที่อ้างว่าใช้ทั่วโลก
ยังมีความว่างเปล่าอีกจุดที่ควรอยู่ตรงนี้ วอลล์สตรีทเจอร์นัล รายงานในปี 2024 ว่า OpenAI ได้สร้างวิธีทำลายน้ำในข้อความที่ภายในบริษัทระบุว่าแม่นยำราว 99.9% ให้ถือว่านั่นคือรายงานข่าว ไม่ใช่ข้อเท็จจริง ตัวเลขนี้ไม่เคยถูกตรวจสอบโดยอิสระ และ OpenAI ไม่เคยปล่อยการทำเครื่องหมายข้อความออกมาเลย โพสต์ของบริษัทเองเมื่อวันที่ 11 มิถุนายน 2026 เรื่องการปฏิบัติตามกฎของสหภาพยุโรปก็พูดถึงเฉพาะที่มาของภาพ และยอมรับข้อจำกัดทั่วไปด้วยถ้อยคำของตัวเองว่า "เมทาดาทาถูกลบได้ ลายน้ำเสื่อมสภาพได้"
ลายน้ำตรวจสอบการอ้างอิงที่หลอนขึ้นมาไม่ได้
Damien Charlotin ดูแลฐานข้อมูลสาธารณะของคำพิพากษาทั่วโลกที่ผู้พิพากษาต้องจัดการกับเนื้อหาที่ AI สร้างขึ้นและมีการหลอนข้อมูล เมื่อดึงข้อมูลวันที่ 16 สิงหาคม 2026 ตัวเลขอยู่ที่ 1,922 คำพิพากษา เส้นทางเป็นแบบนี้ ราว 200 คดีกลางปี 2025, 719 คดีเมื่อมกราคม 2026, 1,227 คดีเมื่อเมษายน, 1,598 คดีเมื่อวันที่ 9 มิถุนายน และ 1,922 คดีในวันนี้ โดยเพิ่มขึ้น 324 คดีในสิบสัปดาห์หลังสุดเพียงช่วงเดียว
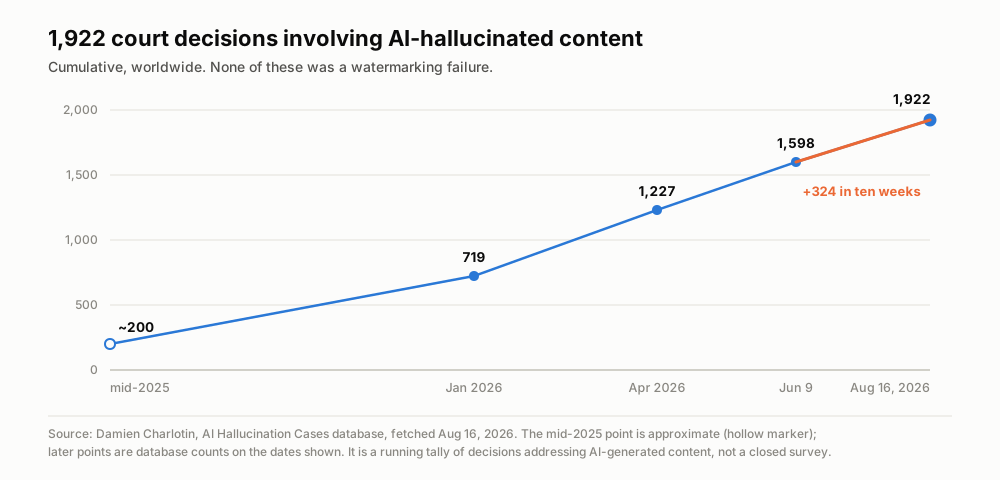
คดีเหล่านี้บันทึกกรณีหลอนข้อมูล ไม่ใช่ผลทดสอบลายน้ำ เครื่องหมายระบุแหล่งที่มาไม่สามารถยืนยันข้อกล่าวอ้างตามข้อเท็จจริงได้ ที่มา: ฐานข้อมูลคดีการหลอนข้อมูลของ AI โดย Damien Charlotin ดึงข้อมูลวันที่ 16 สิงหาคม 2026
ต้นแบบคือคดี Mata v. Avianca ซึ่งศาลเขตใต้แห่งนิวยอร์กตัดสินเมื่อวันที่ 22 มิถุนายน 2023 คำร้องที่อ้างคำพิพากษาหกฉบับซึ่งไม่มีอยู่จริง และค่าปรับ 5,000 ดอลลาร์
แต่ตัวอย่างที่ควรมีน้ำหนักมากที่สุดเป็นของ Anthropic เอง เดือนพฤษภาคม 2025 ในคดี Concord Music v. Anthropic ทนายความของบริษัทเองยื่นคำให้การของผู้เชี่ยวชาญที่อ้างงานวิจัยซึ่ง Claude แต่งขึ้นมา การตรวจด้วยมือมองข้ามไป และทนายต้องขอโทษต่อศาล บริษัทที่วันนี้กำลังปล่อยลายน้ำในข้อความเคยพลาดจากการอ้างอิงอย่างไม่วิพากษ์ — ใช้ผลลัพธ์จากโมเดลของตัวเอง ในคดีของตัวเอง ผ่านการตรวจทานของทนายตัวเอง แม้ผลลายน้ำจะเป็นบวก ก็พิสูจน์ไม่ได้ว่างานวิจัยที่อ้างถึงนั้นมีอยู่จริงหรือไม่
เรื่องนี้ขยายออกไปนอกศาลด้วย เดือนตุลาคม 2025 Deloitte Australia ตกลงคืนเงินบางส่วนสำหรับรายงานของรัฐบาลมูลค่า 440,000 ดอลลาร์ออสเตรเลีย ซึ่งมีรายการอ้างอิงที่ไม่มีอยู่จริงและคำพูดที่แต่งขึ้นจากคำพิพากษา วันที่ 18 พฤษภาคม 2025 ชิคาโกซันไทมส์ และ ฟิลาเดลเฟียอินไควเรอร์ ตีพิมพ์รายชื่อหนังสืออ่านช่วงฤดูร้อนที่เผยแพร่ผ่านระบบร่วม โดยในสิบห้าเล่มมีเพียงห้าเล่มที่มีอยู่จริง Liang และคณะ วิเคราะห์บทความ 950,965 ชิ้นใน arXiv:2404.01268 พบว่าเนื้อหาที่ LLM ปรับแก้สูงถึง 17.5% ในบทคัดย่อสาขาวิทยาการคอมพิวเตอร์ เทียบกับ 6.3% หรือต่ำกว่าในสาขาคณิตศาสตร์และกลุ่มวารสาร Nature
คำถามเรื่องปริมาณก็สมควรได้ตัวเลขที่ซื่อตรงมากกว่าตัวเลขที่น่าตกใจ การวิเคราะห์ Common Crawl โดย Graphite ที่เผยแพร่เมื่อตุลาคม 2025 พบว่าราว 51.7% ของบทความใหม่ในกลุ่มตัวอย่างเขียนโดย AI ในเดือนพฤษภาคม 2025 และ Axios ซึ่งรายงานเรื่องนี้ได้เพิ่มข้อสังเกตที่สำคัญไว้ว่า สัดส่วนดังกล่าว ทรงตัวอยู่ราวครึ่งหนึ่งแทนที่จะไต่สูงขึ้นต่อ นี่ไม่ใช่น้ำท่วม แต่เป็นความปกติแบบใหม่
และนี่คือประเด็น ไม่มีรายการใดในนั้นเลยที่เป็นความล้มเหลวของลายน้ำ ในทุกกรณี ที่มาไม่เคยเป็นข้อสงสัย ทุกคนรู้ว่ามีโมเดลเข้ามาเกี่ยวข้อง หรือจะยอมรับทันทีถ้ามีคนบอก สิ่งที่ล้มเหลวคือไม่มีใครเปิดรายการอ้างอิงนั้นขึ้นมาตรวจว่าคดีนั้น งานวิจัยนั้น หรือหนังสือเล่มนั้นมีอยู่จริงหรือไม่
บทสรุป: ที่มาไม่ใช่การตรวจสอบ
เรียกมันว่า มายาคติตราไปรษณีย์ ก็แล้วกัน ตราไปรษณีย์พิสูจน์ว่าที่ทำการใดจัดการจดหมายฉบับนั้น มันไม่เคยมีความเห็นว่าจดหมายพูดความจริงหรือไม่ เราเพิ่งทุ่มแรงวิศวกรรมมหาศาลไปกับการสร้างตราไปรษณีย์ที่ดีมาก และบทสนทนาสาธารณะส่วนหนึ่งกำลังจะเข้าใจผิดว่ามันคือผู้ตรวจสอบข้อเท็จจริง
ให้ถือสามเรื่องไว้พร้อมกัน ผลตรวจเป็นบวกเป็นหลักฐานว่าโมเดลอาจมีส่วนร่วม ไม่ใช่หลักฐานความเป็นผู้เขียนหรือความจริง ผลเป็นลบพิสูจน์ไม่ได้ว่ามนุษย์เป็นผู้เขียน ขอบเขตการตรวจขึ้นอยู่กับผู้ให้บริการ กุญแจของผู้ให้บริการ และโมเดลที่ใช้ลายน้ำนั้น จึงไม่ครอบคลุมทั้งหมด API แบบทดสอบส่วนตัวฉบับปรับปรุงของ Anthropic ยังมีเกณฑ์คุณสมบัติผู้ใช้ ไม่ได้เปิดให้สาธารณะโดยไม่มีข้อจำกัด
สิ่งที่ผ่านการตรวจสอบได้ไม่ใช่เครื่องหมายบนผลลัพธ์ แต่เป็นบันทึกที่สาวกลับไปหาต้นทางได้: ไฟล์เสียงที่ยังอยู่ ข้อความถอดเสียงที่มีเวลาให้ย้อนกลับไปฟัง ประโยคที่ระบุผู้พูดถูกคน และข้อกล่าวอ้างที่ตามไปถึงเอกสารต้นทางซึ่งเปิดดูได้ เราเคยเสนอแนวคิดเดียวกันในบทความเรื่อง การแปลสด ที่บันทึกซึ่งตรวจทานได้สำคัญกว่าผลลัพธ์ที่ลื่นไหล และ การถอดเสียงการสอบปากคำของตำรวจ ที่บันทึกต้องยืนหยัดได้เมื่อมีคนโต้แย้ง ยุคลายน้ำทำให้ข้อโต้แย้งนั้นคมขึ้น: เมื่อการทำเครื่องหมายกลายเป็นเรื่องทั่วไป ประโยคว่า "มี AI เข้ามาเกี่ยวข้อง" ก็ไม่ช่วยแยกแยะอะไรอีกต่อไป
ลายน้ำตอบว่าข้อความมาจากไหน ยังไม่มีใครสร้างสิ่งที่ตอบว่าข้อความนั้นจริงหรือไม่ เพราะคำตอบไม่ใช่ตัวตรวจจับ แต่เป็นแหล่งข้อมูลที่คุณย้อนกลับไปตรวจได้
Telli.sh อยู่ตรงไหน: เราสร้างแหล่งที่คุณย้อนกลับไปดูได้นั่นเอง Telli.sh บันทึกการประชุม สร้างข้อความถอดเสียงที่มีมาร์กเวลาและระบุผู้พูด และยึดบทสรุปไว้กับไฟล์เสียงที่มันมาจาก ทำให้บรรทัดใดก็ตามในบันทึกของคุณสาวกลับไปยังวินาทีที่มีคนพูดประโยคนั้นได้ แม้ผ่านไปหลายเดือน นี่ไม่ใช่คำกล่าวอ้างเรื่องการตรวจจับ AI แต่เป็นอีกครึ่งหนึ่งของโจทย์ เมื่อบทสรุปกล่าวอ้างอะไรสักอย่าง คุณตรวจสอบกับไฟล์เสียงได้ แทนที่จะต้องเชื่อประโยคนั้น
แหล่งอ้างอิง
- Anthropic, "How Claude's text watermark works" (สิงหาคม 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (ตุลาคม 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (กรกฎาคม 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, ฐานข้อมูลคดีการหลอนข้อมูลของ AI
- คณะกรรมาธิการยุโรป, มาตรา 50 ของกฎหมาย AI: หน้าที่ด้านความโปร่งใส
- หน้าภาพบน Wikimedia Commons
