Anthropic marca il testo di Claude: cosa dimostrano davvero 1.922 casi giudiziari
La filigrana testuale di Claude può indicare un possibile coinvolgimento del modello, ma non verifica l'accuratezza dei fatti. Cosa consente di concludere un rilevamento, quali sono i suoi limiti e cosa insegnano 1.922 casi documentati di allucinazioni sulla differenza tra provenienza e verità.
Il 14 agosto 2026 Anthropic ha spiegato come funzionerà la filigrana testuale nei futuri modelli Claude. Le FAQ collegano il rilascio ai requisiti di trasparenza del regolamento europeo sull'IA, applicabili dal 2 agosto. I modelli pubblicati prima di quella data vengono aggiornati durante un periodo di transizione; l'annuncio non significa che ogni risposta di Claude abbia già una filigrana.
L'idea utile è un segnale nelle parole scelte dal modello. Nelle condizioni giuste, può aiutare a individuare il coinvolgimento di un modello senza cambiare l'aspetto del testo per chi lo legge.
La distinzione conta quando un testo generato contiene prove inventate. Un'istantanea di un database pubblico, citata più avanti, registrava 1.922 casi giudiziari riguardanti contenuti allucinati dall'IA. Non sono test di rilevamento delle filigrane e non dimostrano se un particolare rilevatore avrebbe individuato quei testi. Mostrano un problema diverso: un segnale di provenienza non può confermare che esistano il caso, lo studio o il fatto citati. Capire questa differenza rende il risultato di una filigrana molto più utile e molto più difficile da usare impropriamente.
In breve:
- Al testo non viene aggiunto nulla. Una chiave segreta modifica la casualità nella scelta delle parole, non il formato visibile. Anthropic prevede un rilascio globale, con l'aggiunta graduale dei modelli meno recenti.
- Un esito positivo è una prova debole, uno negativo quasi non è una prova. Anthropic scrive che il marchio non distingue "Claude ha scritto questo" da "Claude ha rielaborato molto questo", che è debole su testi brevi, codice e passaggi puramente fattuali, e che una riscrittura lo cancella. Nel 2024 alcuni ricercatori hanno dimostrato che con meno di 50 dollari si possono sia rimuovere questi marchi sia falsificarli su testo scritto da una persona.
- La provenienza non è verifica. Un risultato può indicare un probabile coinvolgimento del modello, ma non convalidare un caso, una citazione o un libro menzionato nel testo.
Immagine: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Una pagina piena di marchi di autenticità. Ognuno dimostra che una frontiera è stata attraversata. Nessuno dice una parola sulla sincerità del viaggiatore.
Cosa ha cambiato davvero Anthropic, e cosa no
Partiamo dal meccanismo, perché quasi tutti i fraintendimenti successivi nascono da un errore qui.
Quando un modello linguistico scrive, produce una parola alla volta, e nella maggior parte delle posizioni non esiste un'unica scelta corretta. "La riunione è stata produttiva" e "La riunione è stata utile" vanno bene entrambe. Il modello tiene un elenco di parole successive accettabili e ne sceglie una con un'estrazione casuale. È per questo che lo stesso prompt dà due risposte leggermente diverse.
Una filigrana testuale sostituisce quell'estrazione casuale con una pseudocasuale guidata da una chiave segreta. Il modello continua a scegliere solo fra parole che già considerava equivalenti, quindi la qualità resta intatta. Ma nell'arco di qualche centinaio di parole lo schema di quale parola accettabile ha vinto ogni volta smette di sembrare una coincidenza, e chi possiede la chiave può misurarlo.
Non ci sono caratteri nascosti né metadati testuali rimovibili. Il segnale deriva dalle parole scelte e, secondo Anthropic, non aggiunge token e ha un impatto trascurabile sulla velocità. La politica di lancio è globale, non regionale, ma la copertura dipende dal rilascio: la sola politica non dimostra che una specifica risposta abbia una filigrana.
Non c'è nulla di scientificamente nuovo. Scott Aaronson propose l'approccio nel 2022, Kirchenbauer e colleghi pubblicarono uno schema funzionante a ICML nel 2023, e Google DeepMind pubblicò SynthID-Text su Nature nell'ottobre 2024: l'implementazione di Anthropic ne è una versione. Google lo esegue in Gemini dal 2024, riportando circa 20 milioni di risposte in produzione senza differenze di qualità rilevabili, e da allora dichiara oltre 10 miliardi di contenuti marcati.
Aggiornamento, 12 ottobre 2026: l'aggiornamento del 1° settembre alle FAQ di Anthropic descrive un'API di rilevamento in anteprima privata per le organizzazioni idonee, con un accesso più ampio previsto. Questo sostituisce lo stato di API in arrivo nella fotografia originale di agosto. La filigrana stima il coinvolgimento di Claude; non verifica se il testo sia vero.
Il marchio sopravvive a un copia-incolla. Non sopravvive a una riscrittura.
Il segnale vive in quali parole sono state scelte: tutto ciò che conserva quelle scelte conserva il marchio, tutto ciò che le sostituisce lo distrugge. Anthropic enuncia il limite senza giri di parole: "una riscrittura completa in cui ogni parola viene sostituita" lo rimuoverà. Due casi rompono lo schema in un modo che spiazza molti.
I testi brevi e quelli fattuali non portano quasi nulla. La filigrana ha bisogno di scelte in cui nascondersi. Una o due frasi non offrono abbastanza decisioni per formare uno schema, e un contenuto molto fattuale può non offrire alcuna scelta reale: l'esempio di Anthropic è che dopo "i Principia di Newton" la parola successiva sarà "Mathematica", e nessuna chiave ha voce in capitolo. La stessa logica indebolisce il codice, dove la sintassi detta la maggior parte dei token, e la revisione di bozze, dove il modello cambia troppe poche parole per lasciare un segnale.
La traduzione porta una filigrana completa. Questo va contro l'intuito. Se chiedi a Claude di tradurre un documento in giapponese, quel testo giapponese è generato ex novo da Claude, parola per parola, con la consueta libertà di scelta: esce quindi pienamente marcato, anche se le idee venivano da un originale umano non marcato. È l'opposto di ciò che descrivono i ricercatori di DeepMind su Nature, dove tradurre in un'altra lingua un testo già marcato riduce fortemente la confidenza del rilevamento. Entrambe le cose sono vere, perché sono scenari diversi: tradurre altrove un testo marcato dilava il marchio, mentre far tradurre il modello stesso ne imprime uno nuovo.
| Cosa fai al testo | Il marchio sopravvive? |
|---|---|
| Copiarlo e incollarlo ovunque | Sì — non c'è nulla di incorporato che l'incollaggio possa togliere |
| Modifiche leggere: refusi, titoli, tagli | Sì — la gran parte delle scelte di parola resta intatta |
| Chiedere al modello di tradurlo | Sì — la traduzione è generata ex novo, quindi è pienamente marcata |
| Parafrasi profonda con parole tue | No — sostituisci proprio le scelte che portavano il segnale |
| Riscrittura completa, ogni parola sostituita | No — Anthropic dichiara che questo lo rimuove |
| Un estratto breve, una o due frasi | Debole o nullo — troppe poche scelte per formare uno schema |
| Codice, o passaggi puramente fattuali | Debole — sintassi e fatti non lasciano libertà al modello |
| Far correggere al modello la tua bozza | Debole o nullo — cambiano troppe poche parole |
Comportamento come dichiarato da Anthropic nelle domande frequenti del 14 agosto 2026 e dagli autori di SynthID-Text su Nature, ottobre 2024.
Un esito positivo è una prova debole. Uno negativo quasi non è una prova.
Se un rilevatore restituisce un risultato, che cosa si può ragionevolmente concludere?
Se è positivo: che parte di quel testo è passata dal modello di quel fornitore. Tutto qui. Anthropic afferma chiaramente che il marchio non distingue "Claude ha scritto questo" da "Claude ha rielaborato molto questo", non dice nulla sulla veridicità di alcuna affermazione contenuta, e non riconosce testo di un'altra IA, perché conosce soltanto la propria chiave.
Se è negativo, non ha imparato quasi nulla. Un esito pulito è esattamente ciò che ottieni anche da una parafrasi, da un estratto breve, da un blocco di codice, dal modello di un concorrente o da un modello a pesi aperti che gira sul portatile di qualcuno senza alcuna marcatura.
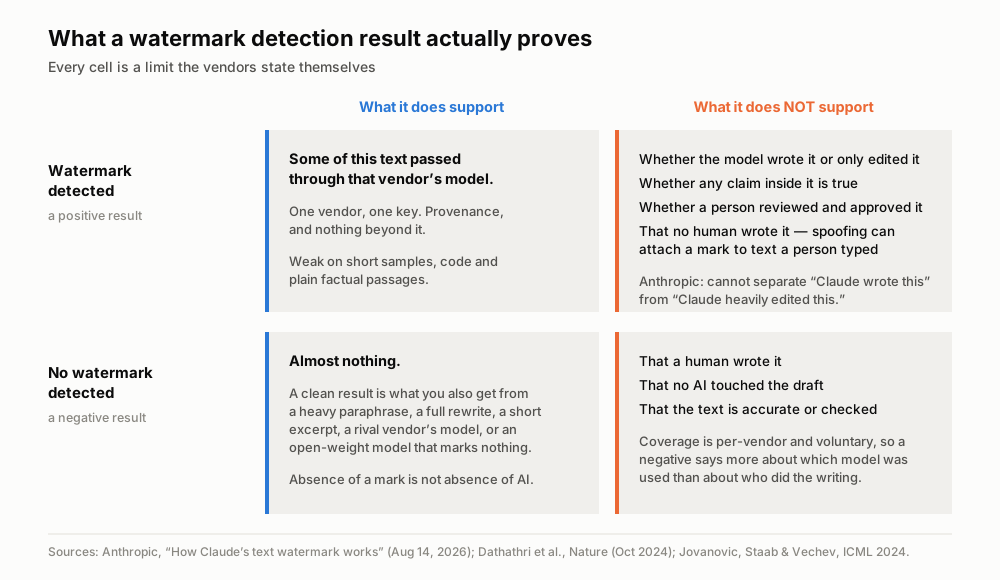
Ogni cella qui è un limite pubblicato dai fornitori stessi. Fonti: domande frequenti di Anthropic sulla filigrana (14 agosto 2026, aggiornate il 1° settembre); Dathathri et al., Nature (ottobre 2024); Jovanović, Staab e Vechev, ICML 2024.
L'attacco per cui nessuno stanzia un budget va nella direzione opposta
La rimozione è il rischio che tutti immaginano: qualcuno ripulisce un testo di IA per nasconderne l'origine. D'accordo. Ma esiste un secondo attacco con la freccia rivolta dall'altra parte, ed è quello che dovrebbe preoccuparti.
Lo spoofing consiste nel far portare a un testo scritto da una persona la filigrana di qualcun altro. Nessuno sta nascondendo qualcosa: si sta piantando qualcosa. Il bersaglio è chi verrà poi accusato di aver usato l'IA, o un fornitore a cui verranno addebitati output che non ha mai prodotto.
A ICML 2024, Jovanović, Staab e Vechev hanno dimostrato entrambi gli attacchi contro schemi allo stato dell'arte con oltre l'80% di successo e meno di 50 dollari di calcolo. Gli autori di DeepMind concedono lo stesso terreno nel loro articolo su Nature: le filigrane "non offrono una soluzione completa", per esistere richiedono la collaborazione del fornitore del modello, non sono imponibili ai modelli a pesi aperti che chiunque può eseguire tali e quali, e sono "vulnerabili ad attacchi di furto, spoofing e rimozione". Quest'ultima frase è l'intera tesi, scritta dal gruppo che ha costruito la tecnologia.
I primi rilevatori di IA accusarono gli studenti sbagliati
Gli strumenti di rilevamento esistono già, e sono una tecnologia diversa con una storia documentata di danni. Una filigrana viene impressa al momento della generazione dal proprietario del modello, con una chiave. Un classificatore tira a indovinare a posteriori, dalle caratteristiche del testo stesso: quanto sono prevedibili le scelte di parola, quanto è vario il lessico. Il primo sa qualcosa. Il secondo fa riconoscimento di pattern stilistici. È la differenza fra misurare e profilare.
OpenAI lanciò un AI Text Classifier il 31 gennaio 2023 e lo ritirò il 20 luglio dello stesso anno "a causa del suo basso tasso di accuratezza". I suoi numeri: individuato il 26% del testo di IA, segnalato erroneamente il 9% del testo umano.
Poi Liang e colleghi pubblicarono su Patterns nel luglio 2023 il risultato che avrebbe dovuto chiudere la categoria. Con sette rilevatori applicati a temi TOEFL scritti da non madrelingua inglesi, il tasso medio di falsi positivi era del 61,3%; un rilevatore ne segnalò il 97,8%. Chiedendo di riformulare gli stessi temi con un lessico più ricco, il tasso scendeva all'11,6%. I rilevatori non stavano misurando la paternità del testo: misuravano la scioltezza, e penalizzavano chi aveva un inglese più semplice.
La Vanderbilt University disattivò il rilevatore di IA di Turnitin il 16 agosto 2023. La sua spiegazione si basava su un calcolo ipotetico: applicando un tasso dichiarato di falsi positivi dell'1% a circa 75.000 elaborati presentati si potrebbero segnalare erroneamente circa 750 elaborati. Era una stima del rischio, non il conteggio di studenti effettivamente accusati. Annuncio della Vanderbilt.
Il rilevamento delle filigrane verifica uno schema di generazione definito, anziché dedurre la paternità dallo stile di scrittura. Il risultato resta probabilistico e i passaggi brevi o pesantemente modificati possono non essere conclusivi. Un risultato sul coinvolgimento del modello non dovrebbe trasformarsi in un'accusa contro una persona specifica; le ricerche sullo spoofing mostrano anche perché il solo rilevamento non può stabilire la paternità.
La regolamentazione è arrivata prima degli strumenti
Che tutto questo si concentri in due settimane dipende dal fatto che il legislatore si è mosso per primo.
Il regolamento europeo sull'IA divide l'obbligo in due. L'articolo 50, paragrafo 2 vincola i fornitori: chi costruisce un sistema generativo deve marcarne gli output in forma leggibile dalle macchine, testo compreso. L'articolo 50, paragrafo 4 vincola te: chi pubblica testo generato da IA che "informa il pubblico su questioni di interesse pubblico" deve dichiararlo.
E questo secondo comma porta con sé un'esenzione che è, per la maggior parte dei lettori, il cuore pratico dell'intero impianto. L'obbligo non si applica quando il contenuto è stato sottoposto a revisione umana o controllo editoriale e una persona ne assume la responsabilità editoriale. Rileggilo. La risposta europea al testo generato da IA non è un rilevatore. È una persona con un nome che lo ha rivisto e che ne risponde.
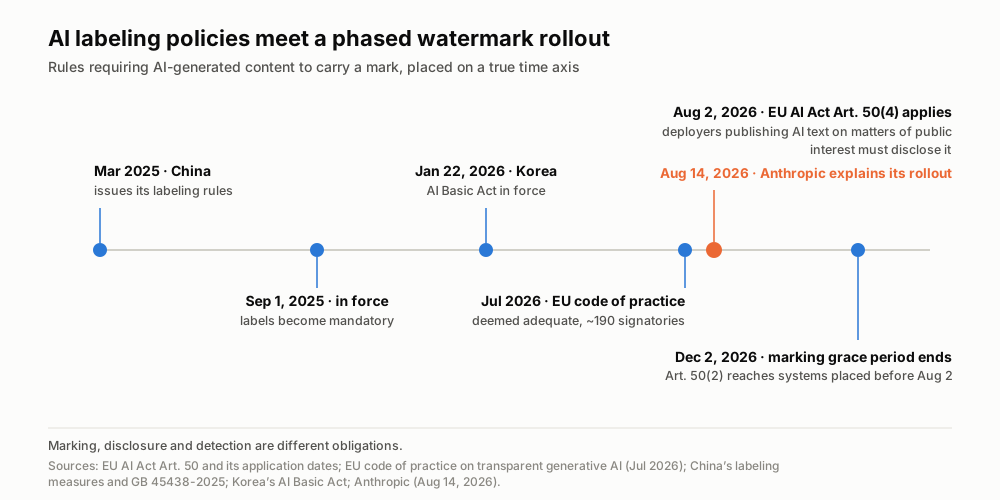
Gli obblighi di etichettatura sono arrivati secondo calendario; un rilevamento utilizzabile no. Fonti: il regolamento europeo sull'IA e le sue date di applicazione, il codice di condotta europeo sulla trasparenza (luglio 2026), le misure cinesi di etichettatura e la norma GB 45438-2025, la legge quadro coreana sull'IA e l'annuncio di Anthropic.
La Commissione descrive il proprio codice sulla trasparenza come un quadro volontario per la conformità, non come un sostituto della legge; alla fine di luglio 2026 lo avevano sottoscritto circa 190 organizzazioni. Le FAQ prevedono un periodo transitorio fino al 2 dicembre 2026 per i sistemi immessi sul mercato prima del 2 agosto. La distinzione conta: il calendario di attuazione di un firmatario e un obbligo di legge non sono intercambiabili. Panoramica della Commissione, FAQ della Commissione.
Altre giurisdizioni applicano regole diverse. Le misure cinesi sull'etichettatura sono entrate in vigore il 1° settembre 2025 e prevedono etichette visibili e incorporate secondo la norma GB 45438-2025. La legge quadro coreana sull'IA è entrata in vigore il 22 gennaio 2026. Per valutare la conformità servono la giurisdizione applicabile e il tipo di contenuto, non un'unica presunta regola globale.
Anche un'altra assenza va segnalata qui. Il Wall Street Journal riportò nel 2024 che OpenAI aveva costruito un metodo di filigrana testuale descritto internamente come accurato attorno al 99,9%. Va trattato come una notizia di stampa, non come un fatto: quel numero non è mai stato verificato in modo indipendente e OpenAI non ha mai rilasciato una marcatura del testo. Il suo stesso post dell'11 giugno 2026 sulla conformità europea documenta solo la provenienza delle immagini, e ammette il limite generale con parole proprie: "i metadati possono essere rimossi, le filigrane possono degradarsi".
Una filigrana non può convalidare una citazione allucinata
Damien Charlotin cura un database pubblico di decisioni giudiziarie di tutto il mondo in cui un giudice ha dovuto occuparsi di contenuti generati da IA contenenti allucinazioni. Consultato il 16 agosto 2026, segnava 1.922 decisioni. La traiettoria: circa 200 a metà 2025, 719 a gennaio 2026, 1.227 ad aprile, 1.598 il 9 giugno e 1.922 oggi, con 324 aggiunte solo nelle ultime dieci settimane.
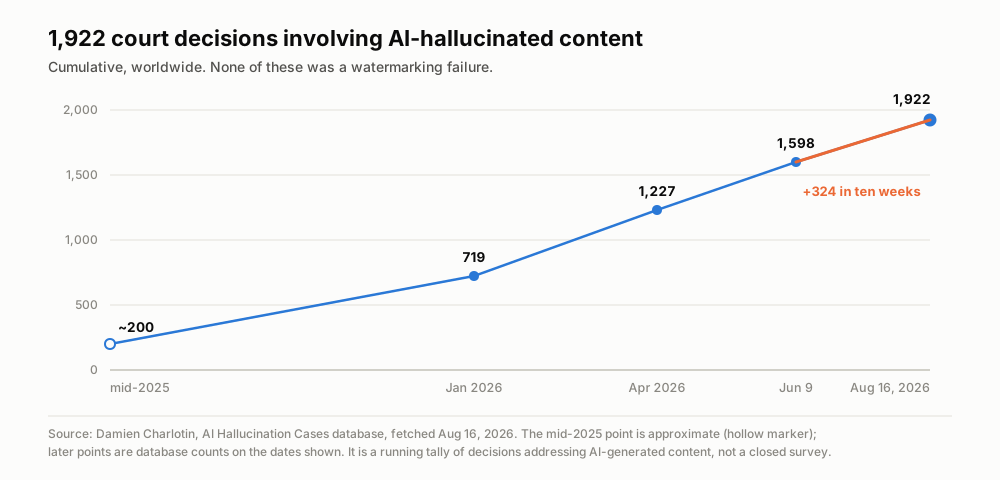
Questi casi documentano allucinazioni, non risultati verificati di rilevamento della filigrana. Un segno di provenienza non può convalidarne le affermazioni fattuali. Fonte: database dei casi di allucinazione da IA di Damien Charlotin, consultato il 16 agosto 2026.
L'archetipo è Mata v. Avianca, deciso nel Distretto Meridionale di New York il 22 giugno 2023: un atto che citava sei decisioni giudiziarie inesistenti e una sanzione da 5.000 dollari.
Ma l'esempio che dovrebbe pesare di più appartiene ad Anthropic. Nel maggio 2025, in Concord Music v. Anthropic, gli avvocati dell'azienda depositarono una dichiarazione peritale che citava uno studio allucinato da Claude. Un controllo manuale non se ne accorse; il legale si scusò con la corte. L'azienda che oggi rilascia una filigrana testuale si è scottata proprio citando senza spirito critico l'output del proprio modello, nel proprio contenzioso, con i propri avvocati a rivedere. Una filigrana su quella dichiarazione non avrebbe potuto stabilire se lo studio citato esistesse.
Il fenomeno esce dalle aule di tribunale. Deloitte Australia ha accettato nell'ottobre 2025 di rimborsare parzialmente un rapporto governativo da 440.000 dollari australiani contenente riferimenti inesistenti e una citazione inventata tratta da una sentenza. Il 18 maggio 2025 il Chicago Sun-Times e il Philadelphia Inquirer hanno pubblicato una lista di letture estive distribuita in syndication in cui solo cinque dei quindici libri esistevano. Liang e colleghi, analizzando 950.965 articoli in arXiv:2404.01268, hanno trovato contenuti modificati da LLM fino al 17,5% negli abstract di informatica, contro il 6,3% o meno in matematica e nel portafoglio Nature.
Anche la questione dei volumi merita un numero onesto invece che allarmante. Un'analisi di Common Crawl condotta da Graphite e pubblicata nell'ottobre 2025 ha rilevato che circa il 51,7% dei nuovi articoli campionati era scritto da IA a maggio 2025 — e Axios, riportandolo, ha aggiunto la precisazione che conta: quella quota si è stabilizzata attorno alla parità invece di continuare a salire. Non è un'inondazione. È una nuova normalità.
Ecco il punto. Nulla in quell'elenco è un fallimento della filigrana. In ogni caso la provenienza non è mai stata in discussione: tutti sapevano che c'era di mezzo un modello, o l'avrebbero accettato subito. È fallito il fatto che nessuno abbia aperto la citazione per controllare se quel caso, quello studio, quel libro esistesse.
In conclusione: la provenienza non è verifica
Chiamiamola la fallacia del timbro postale. Un timbro dimostra quale ufficio ha trattato la lettera. Non ha mai avuto un'opinione sulla veridicità di ciò che vi è scritto. Abbiamo appena investito parecchia ingegneria per costruire un ottimo timbro postale, e una parte del dibattito pubblico sta per scambiarlo per un verificatore di fatti.
Tieni presenti tre cose. Un rilevamento positivo è un indizio sul possibile coinvolgimento del modello, non prova la paternità né la verità. Un risultato negativo non prova che il testo sia stato scritto da una persona. La copertura dipende dal fornitore, dalla sua chiave e dai modelli che usano la sua filigrana; non è universale. Anche l'API di Anthropic in anteprima privata richiede determinati requisiti di idoneità e non è accessibile senza restrizioni al pubblico.
Ciò che regge davvero all'esame non è un marchio sull'output. È un documento che puoi ricostruire dalla sua fonte: una registrazione che esiste ancora, una trascrizione con marcatura temporale in cui puoi tornare all'istante in questione, una frase attribuita alla persona che l'ha detta, un'affermazione che risale a un documento primario che puoi aprire. Lo abbiamo già sostenuto parlando di traduzione in diretta, dove la nota riesaminabile conta più dell'output scorrevole, e di trascrizione degli interrogatori di polizia, dove il verbale deve reggere quando qualcuno lo contesta. L'era della filigrana non cambia quell'argomento, lo affila: quando la marcatura diventa universale, "c'era di mezzo l'IA" smette di distinguere qualsiasi cosa.
Le filigrane rispondono alla domanda su da dove venga un testo. Ciò che risponde alla domanda se sia vero non l'ha ancora costruito nessuno, perché quella cosa non è un rilevatore. È una fonte a cui puoi tornare.
Dove si colloca Telli.sh: noi costruiamo proprio quella fonte a cui tornare. Telli.sh registra la riunione, produce una trascrizione con marcature temporali e interlocutori identificati, e tiene il riassunto ancorato all'audio da cui proviene: qualsiasi riga dei tuoi appunti può essere ricondotta, mesi dopo, al secondo esatto in cui qualcuno l'ha detta. Non è una promessa sul rilevamento dell'IA. È l'altra metà del problema: quando un riassunto afferma qualcosa, puoi confrontarlo con la registrazione invece di fidarti della frase.
Fonti
- Anthropic, "How Claude's text watermark works" (agosto 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (ottobre 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (luglio 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, database dei casi di allucinazione da IA
- Commissione europea, articolo 50 della legge sull'IA: obblighi di trasparenza
- Pagina dell'immagine su Wikimedia Commons
