Llama Windows: первый локальный ИИ-чат без настройки терминала
Безопасно установите Llama Windows, выберите подходящую для компьютера модель GGUF, попробуйте три практических запроса и подключитесь к локальному API, не выставляя сервер в сеть.
Первая задача для локального ИИ должна быть простой: превратить шесть вымышленных заметок со встречи в три пункта действий. Чтобы выяснить, сможет ли компьютер ответить, вам не должно требоваться компилировать движок инференса, подбирать десяток флагов запуска или загружать приватный документ.
Hugging Face представила Llama Windows 13 октября 2026 года — приложение в системном трее Windows, использующее среду выполнения llama.cpp. Оно находит и скачивает модели, а затем предоставляет локальный чат и API для других приложений. Название относится к приложению и не означает, что оно работает только с моделями Meta Llama. Анонс запуска
В этом руководстве мы безопасно установим приложение, выберем подходящую первую модель и проверим первую беседу. Затем разберём три полезные задачи и необязательный запрос к локальному API. Начните с общедоступного или вымышленного текста; используйте чувствительные материалы только после того, как поймёте весь рабочий процесс.
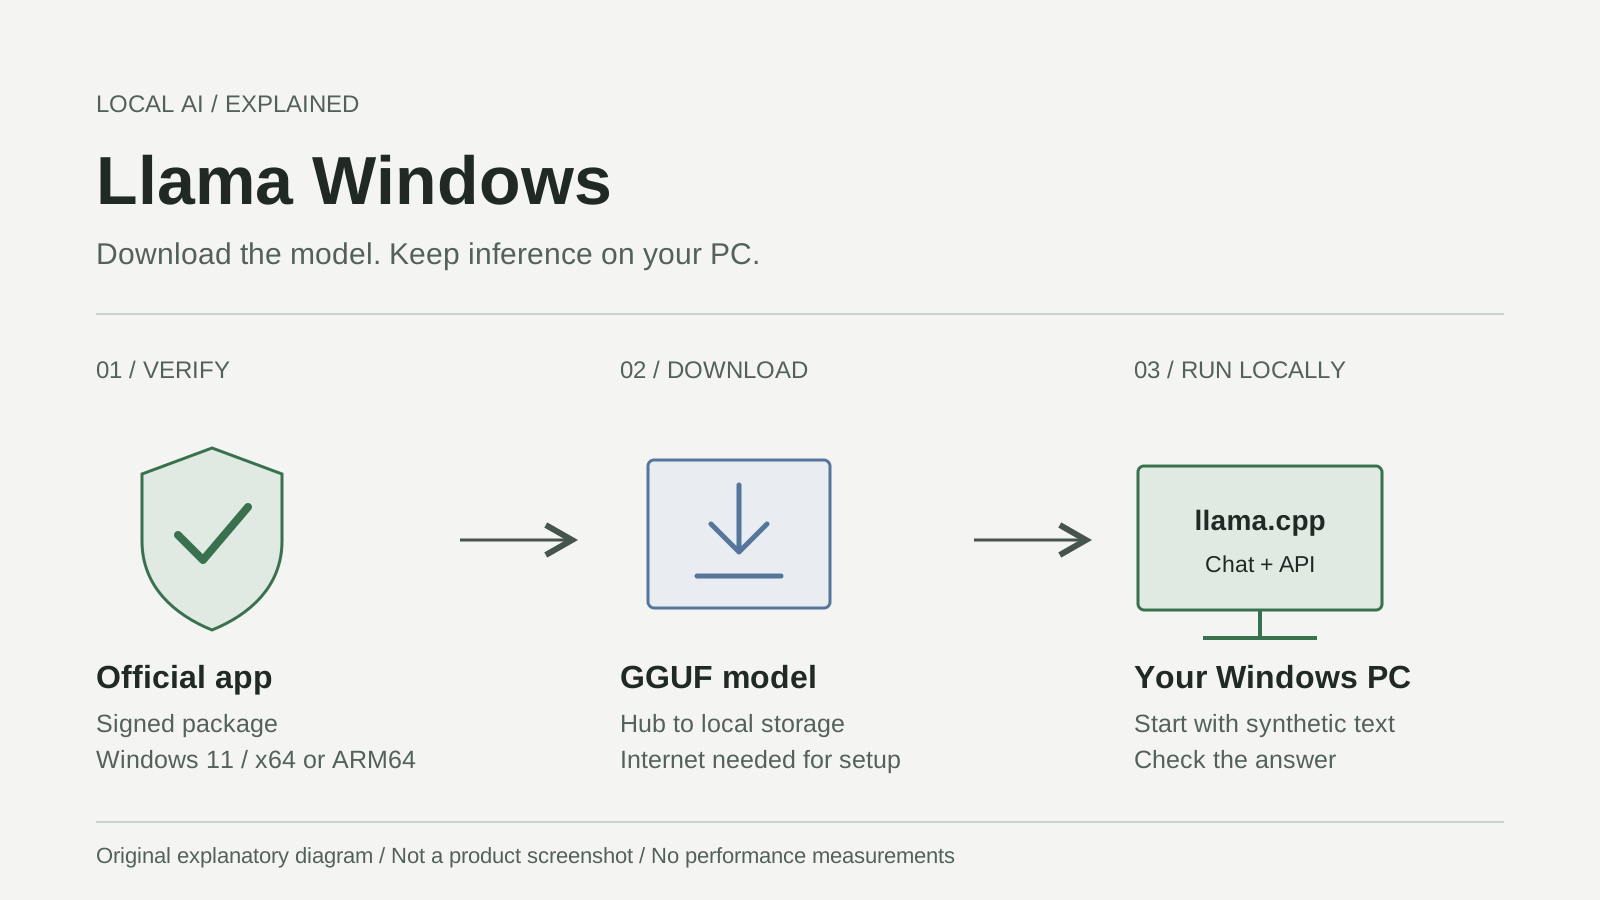
Оригинальная пояснительная иллюстрация, не снимок продукта. Скачивание модели при настройке и локальный инференс — разные этапы. По данным официального руководства по установке для Windows.
Проверьте сборку Windows, прежде чем выбирать модель
По состоянию на 20 октября последняя опубликованная версия для Windows — v0.12.0. В манифесте пакета требуется Windows.Desktop 10.0.26100.0 или более поздняя версия. Сборка 26100 соответствует Windows 11 версии 24H2; используйте актуальную обслуживаемую версию Windows, а не просто самую старую, проходящую установку. Релиз, манифест релиза, сведения о выпусках Microsoft
Найдите в Windows winver, чтобы проверить номер сборки. В параметрах Windows откройте Система > О системе, чтобы проверить тип системы и установленную оперативную память. Официальный .msixbundle содержит сборки x64 и ARM64: x64 обычно подходит для компьютеров Windows с процессорами Intel/AMD, а ARM64 — для Windows на Arm. Пакет сам выбирает архитектуру. Среди текущих файлов релиза нет 32-разрядного пакета x86. Репозиторий Windows, сборка пакета
В документации по установке для Windows не указаны единые минимальные требования к RAM, VRAM или дискретному графическому процессору. Потребности зависят от модели и контекста. llama.cpp поддерживает инференс на CPU и несколько графических бэкендов, но это не гарантирует одинакового ускорения на каждом компьютере. Специально покупать RTX Spark не нужно. Возможности llama.cpp
На Mac перейдите по отдельной ссылке Download for Mac на сайте llama.app. Не устанавливайте пакет для Windows и не следуйте инструкциям по драйверам Windows. Указанный на сайте размер приложения для Mac также не является требованием к установщику Windows.
Установите подписанное приложение, не ослабляя защиту Windows
Обычная установка готового пакета не требует компиляции или установки .NET SDK. Предварительные условия сборки из исходников предназначены разработчикам и не нужны для первой беседы. Официальная документация по установке
- Откройте llama.app и выберите Download for Windows 11 либо перейдите по ссылке Releases в репозитории. Убедитесь, что релиз принадлежит
ggml-org/Llama-Windows, а не похожему сайту загрузок. - Выберите актуальный
.msixbundle, а не архив исходного кода GitHub. Для проверенного релиза файл называетсяLlamaApp-v0.12.0.msixbundle. Во время установки держите страницу релиза под рукой. - Откройте пакет в Windows App Installer. До выбора Install проверьте сведения об издателе и подписи. В манифесте v0.12.0 идентификатор подписи — Hugging Face, а отображаемое имя издателя — Morgan Funtowicz. Одного знакомого имени недостаточно для проверки подписи: Windows должна доверять подписи пакета. Идентификатор пакета
- Если Windows сообщает о неизвестном издателе, недействительной подписи или ограничении организации, остановитесь. Повторно проверьте официальный файл, обновите Windows/App Installer через каналы Microsoft или обратитесь к администратору. Не отключайте Defender или SmartScreen, не обходите политику выполнения и не импортируйте неизвестный сертификат ради принудительной установки. Устранение неполадок Microsoft App Installer
- Запустите Llama и найдите значок приложения в области уведомлений рядом с часами; при необходимости проверьте стрелку скрытых значков. Если управляемая среда выполнения llama.cpp отсутствует, приложение может установить её самостоятельно, поэтому при первом запуске может понадобиться интернет. Пошаговая загрузка для Windows, настройка среды выполнения
Не меняйте параметры сетевого доступа. В v0.12.0 адрес сервера задаётся параметром Settings > Llama > Listen On; по умолчанию используется localhost. Для первого чата не нужно создавать правило входящих подключений или указывать адрес, доступный с другого компьютера. Примечания к безопасности релиза
Модель, помещающаяся на диске, может не поместиться в память
GGUF — формат файла модели с весами и метаданными для сред инференса, таких как llama.cpp. Это не бренд чат-бота и не оценка качества. Для диалога следует начать с модели, настроенной на инструкции или чат; базовая модель предназначена для других целей. Прочитайте карточку модели, а не выбирайте только по числу загрузок. Документация Hugging Face по GGUF, рекомендации по карточкам моделей
Количество параметров описывает выученные моделью числовые значения: 3B означает примерно три миллиарда параметров, а не загрузку объёмом 3 ГБ. Квантование хранит эти значения компактнее. Названия вроде Q4_K_M и Q8_0 обозначают разные схемы квантования, а не версии приложения. Более низкая точность может сократить объём хранилища и памяти, но компромисс между качеством и скоростью зависит от модели и оборудования. Это не означает, что такой вариант автоматически самый быстрый или лучший. Руководство по квантованию llama.cpp
Разделяйте четыре вида ресурсов:
| Ресурс | На что закладывается бюджет | Решение для новичка |
|---|---|---|
| Место на диске | Скачанные файлы модели, среда выполнения и временное место для загрузки | Перед скачиванием проверьте целевой диск |
| Системная RAM | Windows, другие приложения, данные модели и работа среды выполнения | Оставьте запас для обычного использования компьютера |
| VRAM графического процессора | Задачи, назначенные дискретному GPU | Не путайте её с системной RAM |
| Контекст | Токены для инструкций, беседы и генерируемого ответа | Начните с короткого, не выбирайте сразу максимум |
Контекст — это рабочий стол беседы. Большой стол вмещает больше материалов, но занимает больше памяти. Токены — это фрагменты текста, а не фиксированное количество слов; в разных языках и коде они разбиваются по-разному. Веса модели — лишь часть потребления: важны также кеш ключей и значений и буферы среды выполнения. Параметры сервера llama.cpp
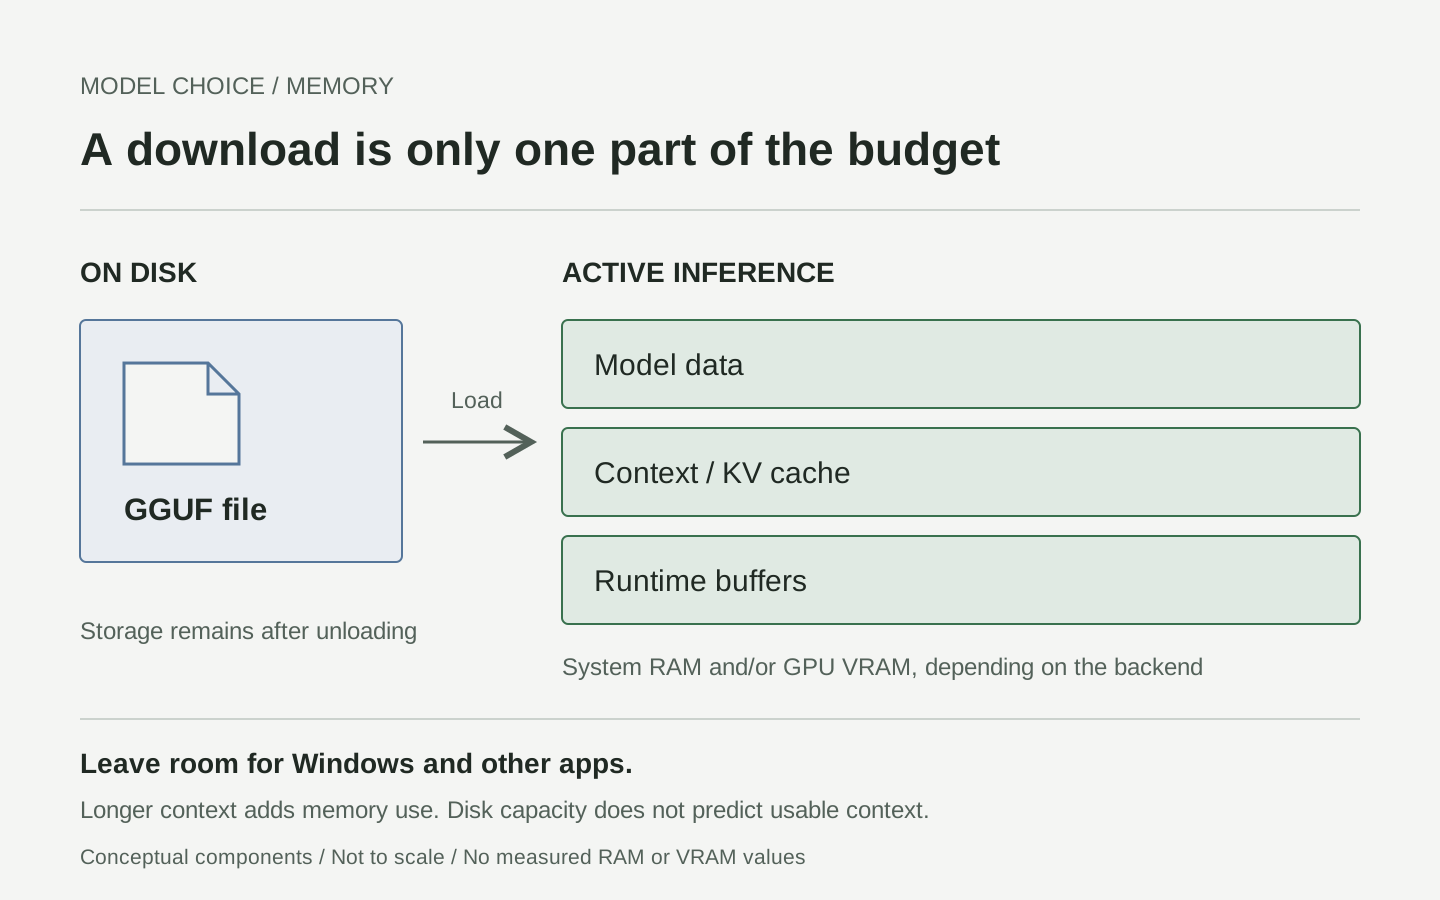
Оригинальная концептуальная схема, не измерение распределения памяти. Источник сведений о модели показывает оценку памяти модели и контекста; общее потребление компьютера включает и другие расходы.
Откройте сведения о модели и изучите оценку памяти для выбранной длины контекста. Выберите небольшую рекомендуемую чат-модель и короткий контекст, оставляющий запас. Гипотетический файл объёмом 4 ГБ на компьютере с 16 ГБ RAM не доказывает, что длинная беседа поместится в память. Если позже будете сравнивать варианты квантования, оставьте модель, запрос и контекст неизменными — так будет понятно, что именно изменилось. Перед коммерческим использованием проверьте лицензию самой модели: лицензия MIT приложения не распространяется на каждую скачиваемую модель.
Сделайте первую беседу намеренно простой для проверки
В статье о запуске панели называются Recommended Models и Available. В проверенном исходном коде v0.12.0 вместо этого используются Models, разделитель Browse more и подсказки к значкам: Download model, Load model, Open WebUI и Stop model. Ориентируйтесь на элементы своей версии, а не ищите устаревшие названия панелей. Исходный код интерфейса Windows для конкретной версии
- Откройте меню из трея и посмотрите размер и сведения о рекомендуемой модели. Для первого запуска выберите общедоступную модель, не требующую особого разрешения.
- Нажмите кнопку загрузки и дождитесь её завершения. Завершённая загрузка означает, что файл получен, а не то, что инференс уже запущен.
- Выберите короткий контекст в сведениях о модели и нажмите Load model. После загрузки выберите Open WebUI, чтобы открыть локальный чат. В официальном кратком руководстве также рекомендуется выбрать контекст до начала беседы. Краткое руководство
- Вставьте приведённый ниже синтетический запрос и отправьте его. Сравните ответ с исходными фактами; не считайте успехом одно лишь появление текста.
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
Хороший ответ сохранит обе даты и укажет, что срок для задачи Sam не задан. Выдуманный срок — ошибка точности, даже если установка прошла идеально. Сохраните запрос и ID модели для сравнения, а по завершении нажмите Stop model. В приложении также описано наложение чата Alt+Space; это необязательная функция, а не условие начала работы. README для Windows
Три небольшие задачи покажут, для чего подходит локальная модель
Это учебные примеры с вымышленными входными данными, а не зафиксированные результаты работы модели. Для каждой задачи приведены запрос, уточнение и конкретный критерий приёмки.
Превратите черновые заметки в передачу дел, не выдумывая решений
Предположим, волонтёрская группа готовит мероприятие на выходные. Вставьте такой запрос:
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
Важно различить обязательство и предложение. Задайте уточнение: «Какие действия явно поручены, а какие пока только предложены?» Принимайте результат, только если задание June закреплено, предложение Omar остаётся предварительным и время начала не выдумано. Сохраните исходные заметки вместе с передачей дел, чтобы другой человек мог проверить основания.
Изучите отрывок, не выходя за пределы источника
Возьмите короткий текст из общественного достояния или написанное вами синтетическое объяснение. Вот самостоятельное упражнение:
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
Проверяйте каждую цитату, а не только правдоподобие ответа. Хороший вопрос без ответа может касаться температурных порогов, но модель не должна их придумывать. Во втором запросе попросите упростить формулировки, сохранив все факты. Тогда переписывание можно проверить по предложениям, а не превращать в повод добавить общий учебник по теплицам.
Составьте ответ клиенту, не раздавая обещаний
Прежде чем использовать настоящий текст клиента, потренируйтесь на вымышленном обращении:
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
Отклоните черновик, в котором сказано, что возврат уже оформлен, или гарантирован результат в тот же день. Попросите модель подчеркнуть каждое обещание, которое она дала, а затем проверьте их сами. Подтвердить действие в аккаунте может только человек с доступом к реальной системе поддержки. Локальный запуск меняет место составления ответа, но не даёт модели полномочий оформлять возвраты.
Ту же модель можно использовать через локальный API
Можно ограничиться чатом. Для редактора, скрипта или прототипа в документации указан управляемый сервер по адресу http://localhost:9931 с совместимыми с OpenAI запросами по путям /v1. Это локальная совместимость, а не обращение к облаку OpenAI. Если порт менялся в настройках, проверьте его там. Документация API Llama
Запустите приложение, загрузите модель и откройте PowerShell. Сначала выведите список доступных моделей маршрутизатора: /models содержит статус загрузки, а /v1/models — конечная точка метаданных, совместимая с OpenAI. Скопируйте точный ID намеренно загруженной модели. Не выбирайте наугад первую запись: это может запустить загрузку другой модели.
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
Перед запуском второго блока замените заполнитель ниже на точный ID модели. Запрос отправляет только синтетический текст и не требует дополнительных SDK:
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
Формат запроса и поле ответа соответствуют официальной документации сервера llama.cpp. Оставьте Listen On на localhost и никогда не вставляйте облачный API-ключ в этот пример. Ошибка 401 означает, что нужно проверить локальную аутентификацию, а не снимать защиту. В v0.12.0 выбор адреса не для loopback приводит к созданию ключа приложением и запросу подтверждения. Поведение безопасности Windows
Локальный инференс не отменяет все сетевые операции
В README для Windows сказано, что запросы и инференс остаются локальными и приложение не отправляет телеметрию. Там же описаны сетевые запросы для скачивания моделей и проверки обновлений релиза; User-Agent содержит версию приложения, сборку Windows и архитектуру. Это разные действия, а не противоречивые значения слова «офлайн». Заявление о конфиденциальности
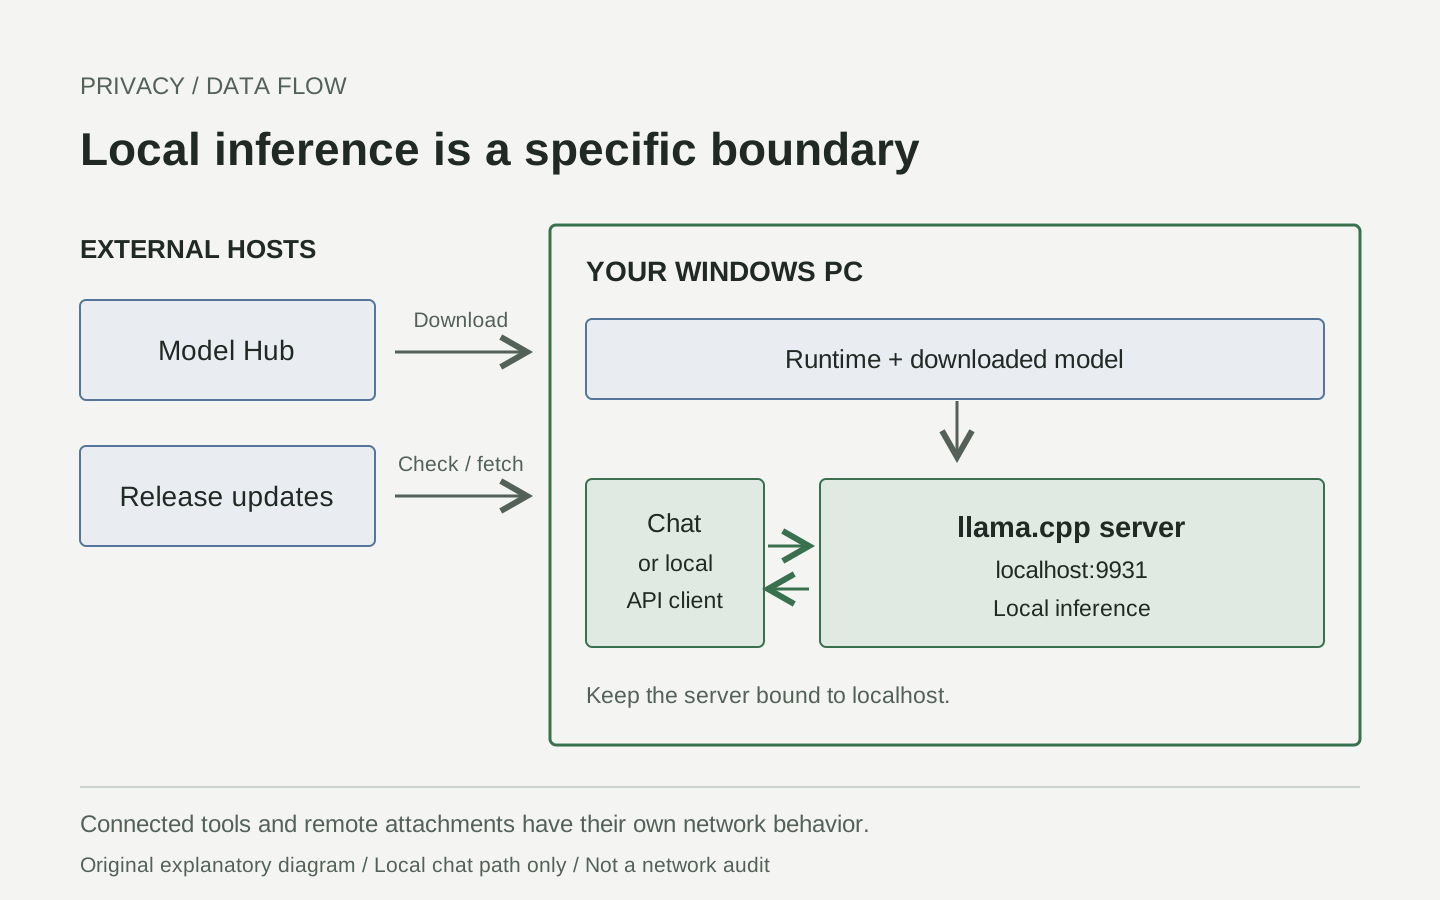
Оригинальное пояснение потока данных. Хосты загрузки внешние, а показанный путь чата локальный. Источники: документация Windows о конфиденциальности и справочник API.
Скачанная поддерживаемая модель может выполнять инференс без подключения к интернету, но для новой модели всё равно потребуется загрузка. Подключённый редактор, расширение браузера, удалённый URL вложения или включённый внешний инструмент имеют собственное сетевое поведение. Не предполагайте, что они наследуют локальную границу сервера.
Перед работой с конфиденциальными данными проверьте хранение бесед, расширения браузера, расположение резервных копий и синхронизацию, а также правила организации. Офлайн-беседа с синтетическими данными после настройки полезна для проверки функций, но не доказывает, что проведён аудит каждого компонента. Не включайте токены или приватные запросы в общедоступные диагностические журналы.
Устраняйте неполадку на конкретном этапе, а не переустанавливайте всё
| Симптом | Что проверить сначала | Полезное следующее действие |
|---|---|---|
| Пакет не устанавливается | Минимальную сборку 26100, архитектуру, подпись, политику устройства | Сохраните точный текст ошибки App Installer; используйте официальные обновления или обратитесь к администратору |
| Окно приложения не видно | Область уведомлений и скрытые значки | Откройте значок в трее; постоянное окно на панели задач не ожидается |
| Не скачивается модель | Свободное место, подключение, ограниченный доступ и отображаемая ошибка | Сначала устраните причину; начните с общедоступной модели |
| Загрузка завершилась, но модель не запускается | Оценку контекста, свободную память, ошибку среды выполнения | Остановите другие загруженные модели и уменьшите контекст или размер модели |
| Ответы медленные | Размер модели, длину контекста, реально используемый CPU/GPU-бэкенд | Сравните на одном коротком запросе; рекомендация каталога не гарантирует скорость |
| API не подключается | Работу приложения, настроенный порт, локальный адрес | Проверьте состояние сервера, прежде чем запускать второй сервер |
| Беглый ответ содержит ложные детали | Исходный текст и пригодность модели | Упростите задачу и попросите подтверждающие цитаты |
В текущем README настройки и журналы расположены в %LOCALAPPDATA%\Llama; в публикации о запуске был указан другой путь к журналам. Используйте кнопку приложения для открытия папки журналов, а не угадывайте. Документированная конечная точка /health помогает понять, готов ли сервер модели или ещё загружается, хотя работающий маршрутизатор не подтверждает, что загрузилась нужная модель. Текущая документация по хранению данных, поведение проверки работоспособности сервера
Считайте первую настройку успешной только после этих проверок
- Официальный подписанный пакет устанавливается без отключения средств безопасности.
- Выбранная вами модель полностью скачалась и загрузилась.
- Чат открывается по локальному адресу и выполняет синтетическое задание.
- Даты, имена и отсутствующие сведения соответствуют исходному тексту.
- Вы можете остановить модель и загрузить её снова.
- Если вы используете API, отвечает нужная модель, а сервер остаётся доступен только через localhost.
Итог: локальный ИИ — это рабочий процесс, который можно проверить
По нашему мнению, главное улучшение — не в том, что можно обойтись без одной команды терминала. Оно в том, что выбор модели, расход памяти, исходный материал и полученный ответ становятся достаточно понятными для повторения. Начните с небольшой задачи, ответ на которую вы можете проверить. Расширяйте сценарий только тогда, когда понимаете, как выглядит успех.
Источники и иллюстрации
Проверено 20 октября 2026 года. Руководство описывает документированные рабочие процессы; не заявляется об испытании установки, запуске модели, платном запросе или бенчмарке. Все три SVG — оригинальные пояснительные иллюстрации, а не копии интерфейса. Фактический интерфейс показан на официальном снимке приложения в трее и в демонстрации наложения, опубликованных разработчиком. Эти материалы доступны по ссылкам и не перепубликуются.
- Анонс Hugging Face, 13 октября
- Релиз Windows, пакет и изменения безопасности
- Официальная установка и краткое руководство
- Формат GGUF и метаданные
- Локальный API и документация конечных точек
- Среда выполнения llama.cpp и справочник сервера
Сделайте эксперименты пригодными для повторного использования
Храните ссылки на источники, запросы, ID моделей и заметки проверки вместе, а не сохраняйте только итоговый ответ. Telli.sh поможет организовать такие исследовательские заметки; это не интеграция с Llama Windows и не утверждение, что заметки остаются офлайн. Создать аккаунт Telli.sh