Как перейти на llama.cpp 1.0 и сохранить рабочий сценарий локального ИИ-приложения?
Версия llama.cpp 1.0 делает несовместимые изменения публичного интерфейса C заметными по номеру версии. Разбираемся, как проверить библиотеку, локальный сервер и установочный пакет перед обновлением.
Небольшая инженерная команда привозит автономного помощника по документам на объект с плохой связью. Помощник получает абзац из руководства по обслуживанию и возвращает короткий ответ с номером страницы. На ноутбуке разработчика новая сборка llama.cpp запускается и генерирует текст. На рабочем ноутбуке на объекте сохранённая конфигурация запуска всё ещё передаёт устаревший параметр. Дальше по цепочке приложение ожидает поле ответа, которое никто не проверил вручную. Во всех трёх случаях команда говорит об обновлении llama.cpp, хотя каждый компонент опирается на свой интерфейс.
13 ноября 2026 года ggml-org выпустила llama.cpp и ggml 1.0.0. Первый проект запускает языковые модели, а его библиотека инференса называется libllama. Второй предоставляет тензорные операции и бэкенды для разных устройств через библиотеку libggml. Разработчики объявили, что будущая несовместимость публичных интерфейсов C будет отражаться в номере основной версии. В самом выпуске llama.cpp 1.0.0 удалили устаревшие функции и параметр командной строки, поддержка которого прекращена. Объявление о правилах версионирования от 13 ноября · Выпуск llama.cpp 1.0.0 · Выпуск ggml 1.0.0
Перед сменой среды выполнения определите, к какой группе относится ваша интеграция. Одни приложения собираются и связываются с библиотекой C. Другие запускают локальный HTTP-сервер и отправляют ему запросы. Третьи включают среду выполнения в готовый установочный пакет. Приложение может относиться сразу к нескольким группам. Для каждой есть небольшой набор проверок, который даст более надёжное основание для решения об обновлении, чем успешная демонстрация на компьютере разработчика.
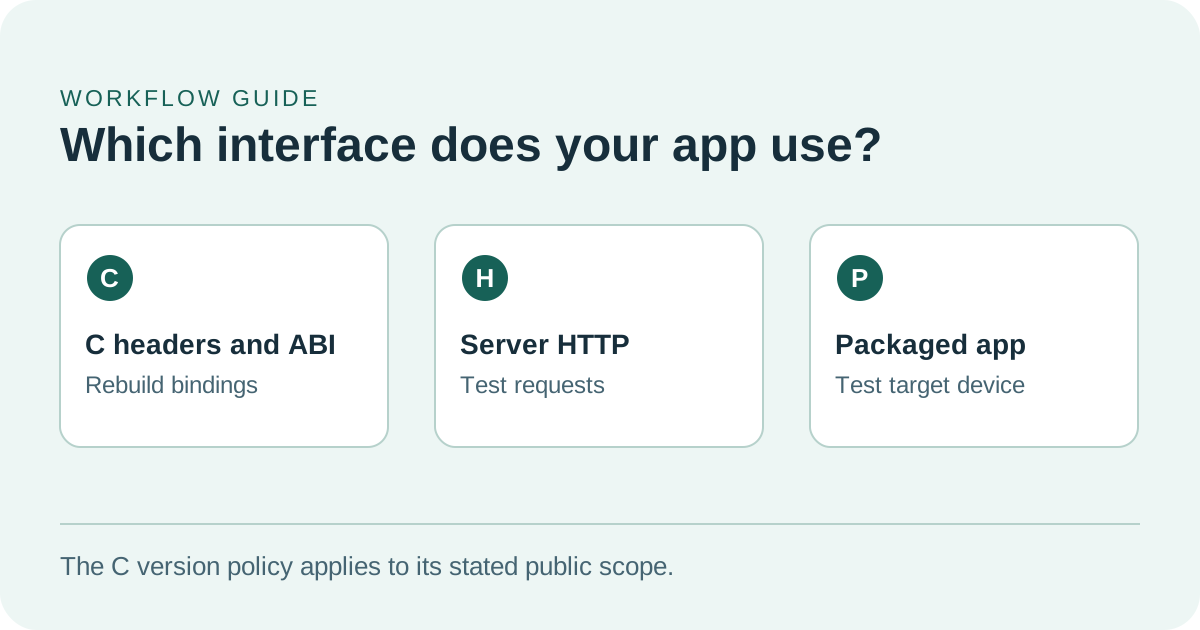
Совместимость C, ответы HTTP и готовые пакеты требуют разных проверок.
Версия 1.0 даёт разработчикам нативных интеграций более ясный сигнал
Заголовки C определяют, как исходный код вызывает библиотеку. Они сообщают компилятору, какие функции и типы данных доступны. Бинарный интерфейс, или ABI, определяет, как скомпилированный код взаимодействует с готовой библиотекой. Чистая сборка позволяет рано обнаружить исчезнувшее объявление. Запуск связанного приложения показывает, что произойдёт с библиотекой, установленной на целевом устройстве. Если приложение загружает свои нативные зависимости самостоятельно, стоит провести обе проверки.
По политике от 13 ноября несовместимые изменения публичного API языка C в каталогах заголовков проекта повышают номер основной версии. Совместимые дополнения, обновления бэкендов и поддержку моделей выпускают как минорные версии. Исправления без изменения API выходят как патчи. Для разработчика нативной обвязки это полезный сигнал. Тем, кто распространяет средство запуска из командной строки или HTTP-клиент, всё равно нужно проверить параметры и запросы, которыми уже пользуются люди. Объявление разработчиков о правилах версионирования
Список изменений конкретного выпуска даёт пример. В примечаниях к llama.cpp 1.0.0 указано удаление 35 устаревших функций из llama.h. Отдельно названы llama_set_warmup и снятые с поддержки параметры дефрагментации. Там же говорится, что API NextN для спекулятивного декодирования перенесён в llama.h, и описано переименование функции для работы с состоянием. Начните с вызовов, которые уже есть в вашем коде. Если компилятор сообщает об отсутствующей функции, сверьтесь с примечаниями к выпуску и действующим публичным заголовком, прежде чем менять зависящий от неё участок. Изменения API в версии 1.0.0 · Публичные заголовки версии 1.0.0
Для автономного помощника первичная проверка нативной интеграции может загрузить знакомый файл модели, отправить вопрос и короткий отрывок, прочитать ответ и корректно освободить модель. Повторите цикл загрузки и завершения в том процессе приложения, который запускают пользователи. Если языковая обвязка собирается отдельно, убедитесь, что при сборке берутся нужные заголовки, а установленное приложение загружает нужную библиотеку. Прежде чем оценивать результат, запишите, какой артефакт использовался. Успех сборки с одной локальной копией мало говорит о другой копии, лежащей рядом с приложением на рабочем ноутбуке.
Проверять нужно те компоненты, от которых зависит рабочий сценарий
Проект также выпускает llama-server, HTTP-процесс со своими аргументами командной строки и документированными эндпоинтами. Версия 1.0.0 добавляет эндпоинт /v1/audio/speech, совместимый с API OpenAI. Это пример серверной возможности, которая может развиваться параллельно с библиотекой C. В том же выпуске убрали --defrag-thold. Если поставляемая служба передаёт этот параметр, её запуск придётся адаптировать, даже если она напрямую не обращается к функциям C. Примечания к выпуску 1.0.0 · Документация сервера для версии 1.0.0
Документация сервера предлагает простую проверку, которую можно выполнять рядом с тестом приложения. Запрос к /health может вернуть HTTP 503 во время загрузки модели и возвращает 200, когда модель загружена. Если приложение работает через HTTP-клиент, затем проверьте привычный запрос на генерацию ответа, построение эмбеддингов или другую операцию. Убедитесь, что клиент правильно разбирает ответ. Для потоковой выдачи проверьте короткий ответ, который завершится штатно, и длинный, который пользователь отменит в приложении. Успешный вызов простейшего эндпоинта ничего не говорит о кнопке отмены или разборе текста. Состояние готовности и эндпоинты сервера версии 1.0.0
| Что использует приложение | Первая проверка после обновления | Что добавляет реальный сценарий |
|---|---|---|
| Публичные заголовки C и нативную библиотеку | Собрать с нуля и запустить с нужной библиотекой | Несколько раз загрузить модель, выполнить короткий запрос и освободить ресурсы |
| Локальный HTTP-сервер | Запустить с сохранёнными настройками и дождаться готовности модели | Проверить реальные запросы, потоковый ответ, отмену и ошибки, которые обрабатывает клиент |
| Установщик настольного или автономного приложения | Установить на типичное устройство и записать, какие артефакты вошли в сборку | Открыть установленное приложение с прежними настройками и запустить знакомую локальную модель |
| Конкретный аппаратный бэкенд | Убедиться, какой бэкенд выбран и помещается ли модель в памяти | Сравнить память и время на самой медленной конфигурации, которую вы обещаете поддерживать |
В третьем случае важны вещи, которые не видны по перечню серверных функций. В пакете для Windows может понадобиться библиотека бэкенда рядом с исполняемым файлом, надёжный поиск существующего файла модели и понятное сообщение, если файл пропал. На машине разработчика рабочий бэкенд мог быть установлен отдельно. Проверка нового пакета в типичной пользовательской среде обнаруживает отсутствующие зависимости, которые уже были в среде разработки. В объявлении от 13 ноября перечислены несколько каналов распространения и платформ с предварительными сборками. Используйте именно тот тег или пакет, который команда собирается поставить, и зафиксируйте его происхождение. Рекомендации разработчиков по распространению
Номер версии не показывает, сколько ждать ответа по руководству
Пользователь ощущает несколько этапов работы автономного помощника как одну задержку. Сначала загружается модель. Приложение разбивает вопрос и отрывок на токены. Затем среда выполнения обрабатывает запрос, начинает генерировать текст и передаёт его интерфейсу. При большом отрывке основное время может уйти на обработку входных данных. При намеренно длинном ответе больше времени может занять генерация. Если это важно для пользователей, измеряйте отдельно старт приложения, время до появления первого текста и время до полного ответа.
Документация для версии 1.0.0 описывает три режима llama-bench: обработку входного запроса, генерацию текста и комбинированный режим. Из замеров исключены токенизация и выбор очередного токена. Инструмент полезен для сравнения двух сборок с одинаковыми настройками, но его результат отличается от задержки, которую регистрирует пользовательский интерфейс. Чтобы понять, какой этап ускорился, запишите оба показателя. Документация теста производительности для версии 1.0.0
В обеих сборках начните с одного и того же файла GGUF. Используйте одинаковые аппаратный бэкенд, настройки контекста и параметры выгрузки на ускоритель там, где обе сборки их поддерживают. Сохраните фактические настройки и хеш модели. Затем попробуйте короткий ввод и ввод размером с документ. При замере памяти фиксируйте как пик на самом длинном типичном запросе, так и потребление после загрузки. Модель может запуститься на свободном ноутбуке и упереться в другой предел с уже открытым браузером и просмотрщиком документов.
В выпуске 1.0.0 перечислены режимы FP8 для кеша ключей и значений при инференсе, в том числе f8_e4m3, и настраиваемый кеш экспертов в памяти хоста для моделей со смесью экспертов. Эти возможности добавляют варианты для сравнения. Если бэкенд и модель поддерживают параметр, измерьте эффект отдельно от перехода на 1.0. Включите его на одном типичном устройстве, повторите те же запросы и проверьте, что качество ответов соответствует требованиям приложения. Тогда задержку или пропавшую ссылку можно расследовать без догадок о том, что именно изменилось. Основные изменения выпуска 1.0.0
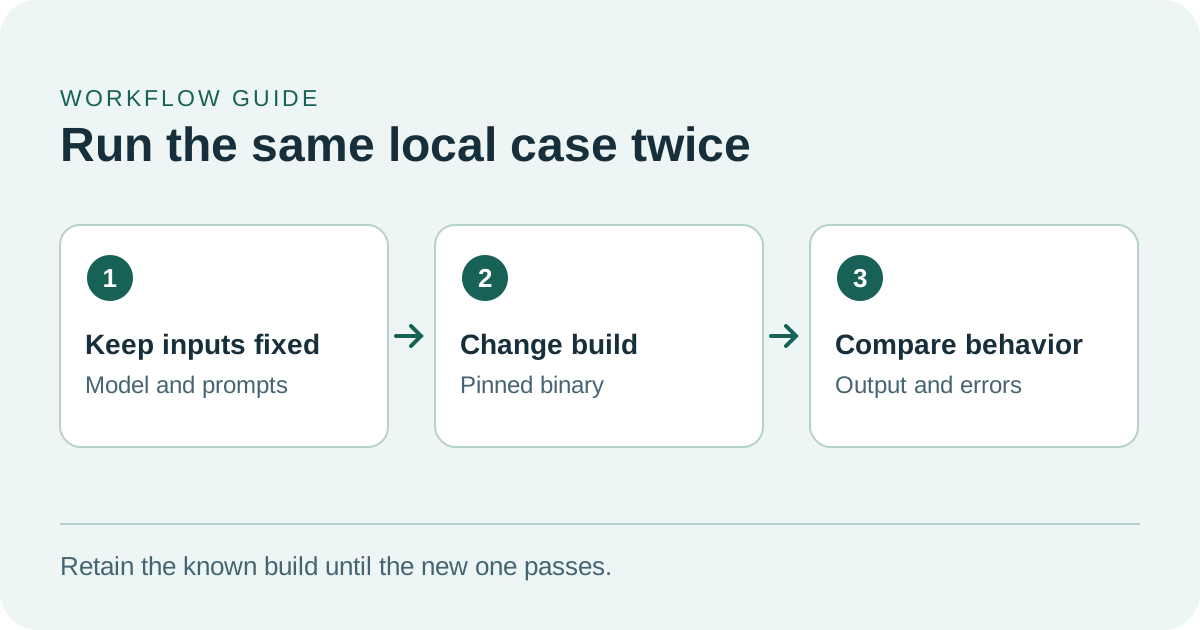
Зафиксируйте модель и входные данные, чтобы связать разницу с обновлением.
Пробная миграция даёт основание для решения о выпуске
- Выберите две конкретные сборки. Храните текущую версию и кандидата 1.0.0 в разных местах. Запишите версии приложения, среды выполнения и модели, один и тот же хеш GGUF для каждой проверки и аппаратный бэкенд. При смене версии сохраняйте пользовательские файлы и настройки.
- Используйте обычный сценарий запуска. Для проверки сервера с доступом только через интерфейс обратной петли подойдёт команда
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931, если заменить путь на свой одобренный файл модели. Запустите и обычную команду из текущей поставки, чтобы рано обнаружить снятые с поддержки параметры. Дождитесь готовности и выполните проверку тем клиентом, который открывают пользователи. Настройка и параметры сервера в выбранной версии - Подберите несколько сложных вопросов. Возьмите короткий отрывок с одним ясным ответом, более длинный текст с похожими терминами и вопрос, на который в тексте ответа нет. Укажите, какой ответ считать полезным. Помощник должен назвать правильную страницу, когда ответ есть в тексте, и сообщить, если сведений не хватает. Записывайте ошибки разбора и непригодные ответы отдельно от оценки качества модели.
- Меняйте по одному параметру производительности. На типичном устройстве начните с
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5, выполняя команду в обеих сборках с одинаковым бэкендом. Количество токенов и пять повторов приведены для примера. Чтобы оценить пользовательский опыт, добавьте замеры запуска, памяти и задержки в приложении и более длинный реальный запрос. Параметры теста производительности в выбранной версии - Запустите установленную сборку и отрепетируйте возврат. Проверьте кандидата в чистой типичной среде, перезапустите приложение и повторите самый тяжёлый поддерживаемый сценарий. Убедитесь, что после неудачного старта прежние настройки и файлы остаются доступны и что можно вернуться к предыдущей версии. Оставьте данные, по которым коллега поймёт, когда стоит приостановить широкое обновление.
Нескольких хорошо подобранных случаев обычно хватает, чтобы найти следующую неисправность. Если длинный отрывок стал обрабатываться медленнее, выясните, где появляется разница: до первого текста, во время генерации или при отображении. Если после изменения начал падать запрос, сохраните его форму и сведения о клиенте до правки запроса или модели. Если проблема возникает только в пакете, сравните установщик и запущенный процесс с рабочей копией разработчика. У владельца каждого компонента появится конкретный случай, который можно воспроизвести.
Удачное обновление воспроизводится на устройстве, где оно нужно
Ценность llama.cpp 1.0 в том, что изменения среды выполнения, от которой зависят многие локальные инструменты, стали заметнее. Команда приложения может сохранить короткую запись о совместимости: сборка, модель, устройство, фактический пользовательский запрос и результат. Тогда работа над следующим выпуском начнётся с проверки привычного сценария, даже если за приложение и среду выполнения уже отвечают другие люди.
Источники
- Объявление ggml-org о правилах версионирования и распространении, 13 ноября 2026 года
- Выпуск llama.cpp 1.0.0, 13 ноября 2026 года
- Выпуск ggml 1.0.0
- Публичные заголовки C в llama.cpp 1.0.0
- Документация llama-server для версии 1.0.0
- Документация llama-bench для версии 1.0.0
Чтобы хранить решения по обновлениям, записи о тестах и настройки моделей с возможностью поиска, создайте аккаунт Telli.sh.