Справится ли ваш компьютер и с субтитрами, и с озвучкой?
В llama.cpp 0.9.0 появились три возможности для работы с речью. Проверьте офлайн-расшифровку, метки говорящих и озвучку готовым голосом на своём компьютере.
У вас есть черновой монтаж демонстрации продукта, запись разговора двух коллег поверх видео и три фразы для повторной озвучки. Отправить запись в сервис расшифровки, а сценарий — в сервис синтеза речи привычно. Если выполнить обе задачи на монтажной машине, повторные правки могут стать проще, особенно когда исходники должны оставаться на ней. При этом очередь, файлы моделей и проверку качества берёт на себя монтажёр.
4 ноября 2026 года проект llama.cpp с открытым исходным кодом выпустил версию 0.9.0. Она добавляет офлайн-расшифровку с NVIDIA Nemotron 3.5 Transcribe, синтез речи с Chatterbox и предустановленные голоса Pocket TTS, которым не нужна запись-образец. В примечаниях указаны расшифровка на 40 языках, контекст в промпте и определение говорящих. У каждого изменения своё место в одном процессе монтажа и свои требования к компьютеру и человеку, проверяющему результат. Примечания к выпуску llama.cpp v0.9.0
Если вы познакомились с llama.cpp, когда запускали локальный чат-бот, по названию обновление может показаться более узким, чем оно есть. Это среда вывода для поддерживаемых архитектур, с инструментами загрузки совместимых моделей и обработки запросов. Обновление расширяет набор задач для этих инструментов. Приложение вокруг них по-прежнему определяет, где хранить звук, как показывать исправления и когда файл готов к публикации. Проект llama.cpp
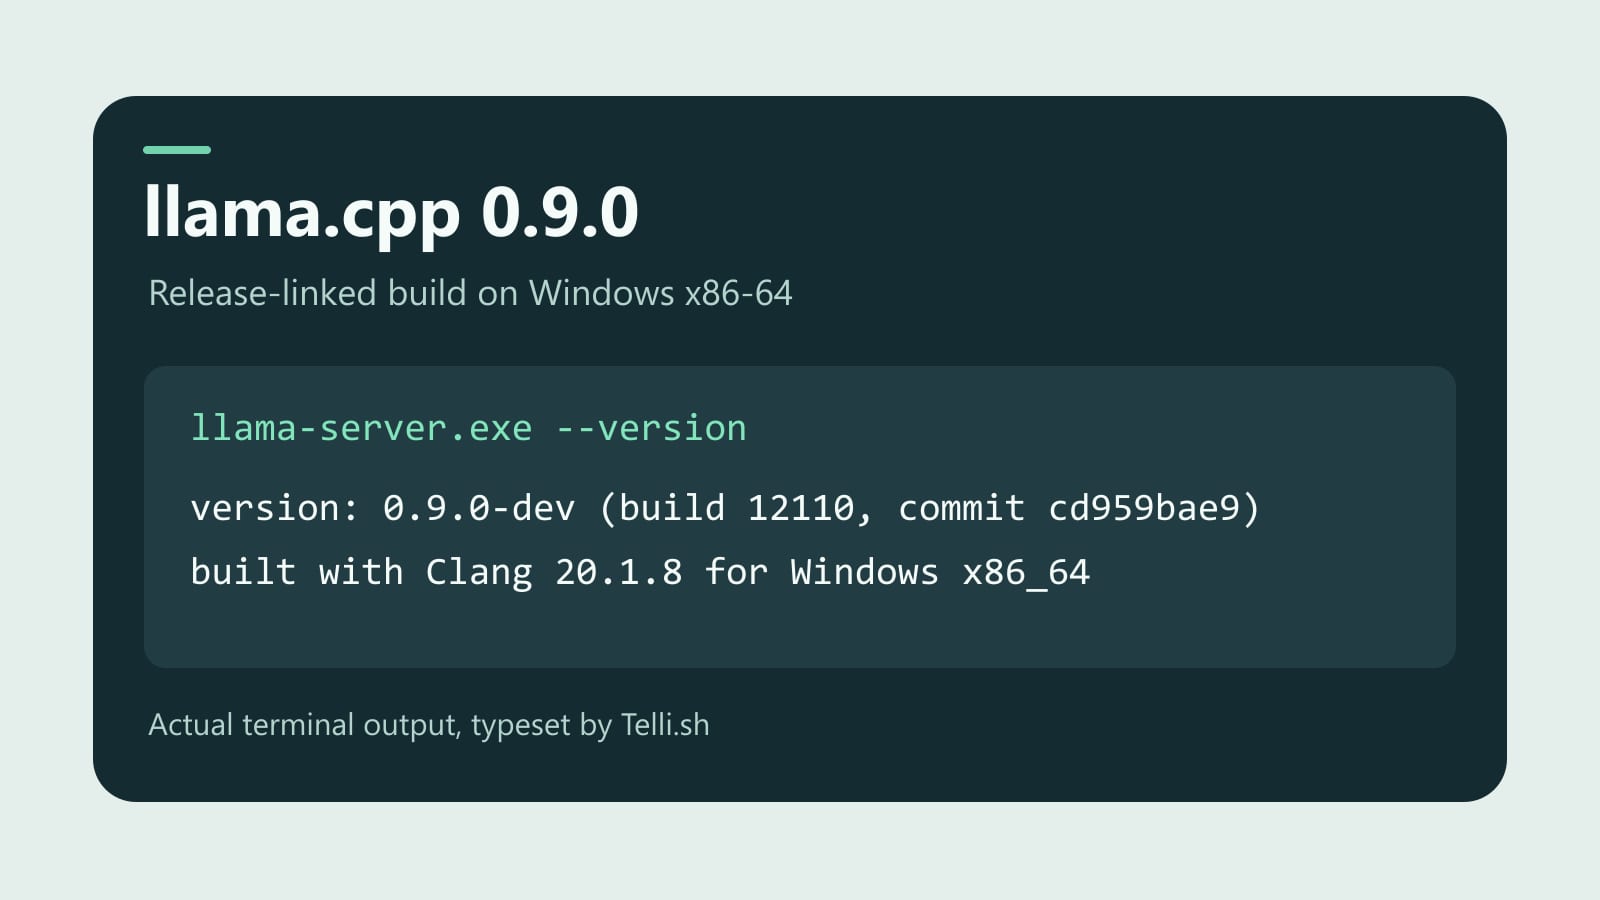
Telli.sh запустил официальную сборку для Windows по ссылке из выпуска и оформил её фактический вывод версии. Он подтверждает, какая сборка использована. Сборка b12110 из выпуска
Субтитры начинаются с расшифровки, которую можно исправить
Допустим, коллега записывает десятиминутный обзор ещё не выпущенного продукта. Другой коллега перебивает его, чтобы поправить название функции. Нужна расшифровка с поиском, предварительное определение говорящих и в итоге субтитры, появляющиеся в правильный момент. Это три разных результата. Первый — текст, второй — редакторская разметка, третий требует синхронизации.
Интеграция Nemotron позволяет начать с первых двух. Принятая реализация поддерживает офлайн-расшифровку с необязательным контекстом и определением говорящих. Она может передавать сведения о говорящих между окнами обработки одной записи. В заметках разработчиков уточняется, что временные метки для отдельных слов и потоковая обработка не вошли в интеграцию. На практике расшифруйте готовую запись, исправьте текст и синхронизируйте его на отдельном этапе монтажа или создания субтитров, когда этого требует итоговый файл. Интеграция Nemotron 3.5 Transcribe
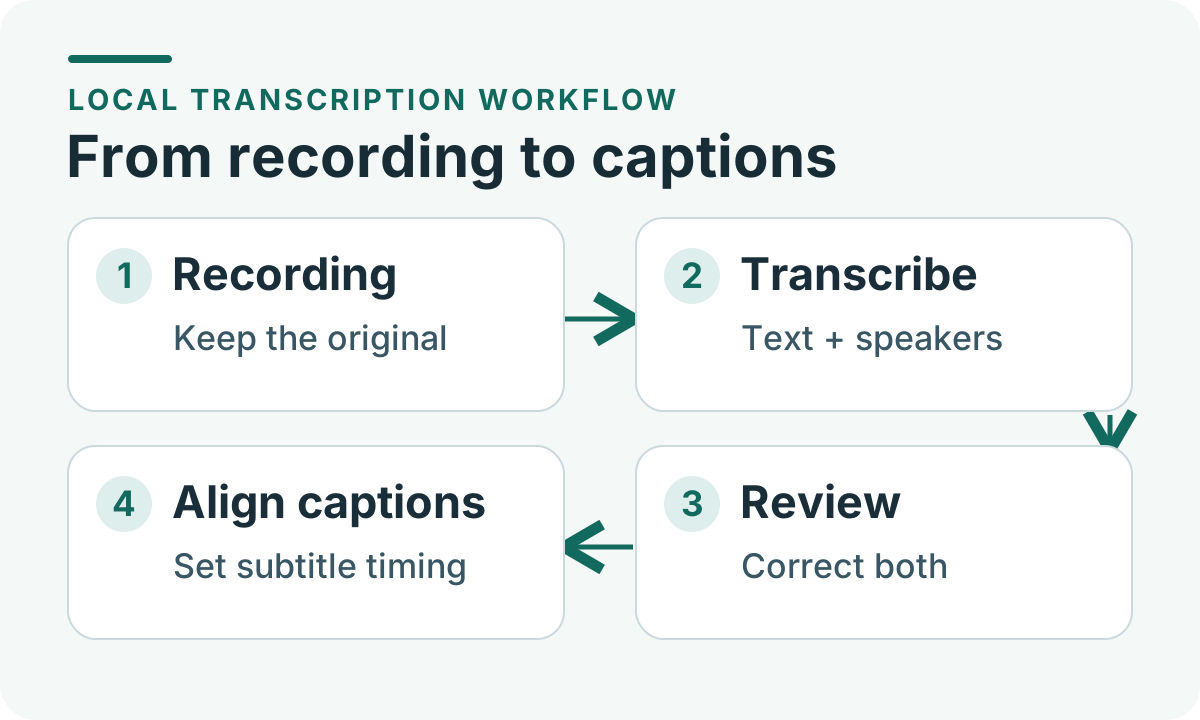
Иллюстрация Telli.sh. Локальную расшифровку можно редактировать. Субтитры синхронизируют после сверки текста и говорящих.
Контекст в промпте особенно полезно проверить командам, у которых встречаются редкие слова. Для записи о вымышленной функции Pine Relay попробуйте короткий список ожидаемых имён и сокращений. Затем обработайте тот же фрагмент без списка. Посчитайте, исправляет ли контекст название, вставляет ли его там, где никто его не произнёс, и меняет ли числа или посторонние слова. Сократите список настолько, чтобы можно было понять влияние каждой записи. Ассистент расшифровки должен упрощать проверку редких слов, сохраняя то, что люди действительно сказали.
Определение говорящих проверьте отдельно. В чистой записи интервью двух человек можно легко различить. Если добавить третьего по громкой связи и несколько наложившихся фраз, объём исправлений может измениться. Прослушайте переходы и самую длинную реплику каждого. Расшифровка может верно распознать все слова, но приписать важное решение другому человеку. Храните метки модели отдельно от имён, поставленных человеком, пока их не подтвердит тот, кто знает запись.
Субтитры проверяйте вместе с видео. Предложение, которое хорошо выглядит в документе, может выйти за границу экрана, появиться до важного момента или остаться, когда уже говорит другой человек. Заранее проверьте резкую склейку и короткое перебивание. Если нужен файл субтитров с точными метками времени, включите синхронизацию и правки в оценку времени. Чистая первая расшифровка полезна, даже если финальный монтаж нужно собрать в другом месте.
Готовый голос подходит для первой проверки
Теперь возьмём вторую часть чернового монтажа. Название функции изменилось, и нужно заменить одну фразу озвучки в шести записях экрана. Когда модель и компьютер настроены, локальная генерация нового дубля обходится недорого. Сложнее выдержать единообразие и произношение. Новый звук должен естественно звучать между соседними фрагментами, правильно произносить название продукта и укладываться в план.
Версия 0.9.0 добавляет Chatterbox в список моделей синтеза речи, поддерживаемых llama.cpp. В обсуждении проверки проекта описаны запуски Chatterbox Turbo и Multilingual V3 на CUDA. Проверяющий испробовал стандартные голоса и генерацию по записи-образцу, затем приложил примеры. Это результат проверки интеграции на конкретной конфигурации. Для рабочего процесса важно отдельно проверить, насколько стабильно выбранный голос звучит на нужном языке с вашим текстом и оборудованием. Поддержка Chatterbox и примеры звука от разработчиков
Pocket TTS даёт другой вариант. Совместимая модель может перечислить встроенные голоса в поле voices ответа сервера на GET /props. Клиент может передать одно из имён в конечную точку синтеза речи. Скрипт или небольшое приложение может заполнить список голосов по загруженной модели. Для первого пилота можно взять готовый голос без поиска и хранения записи человека для имитации. Сохраните модель и имя голоса в записи об экспорте, чтобы следующую правку можно было начать с тех же настроек. Предустановленные голоса Pocket TTS
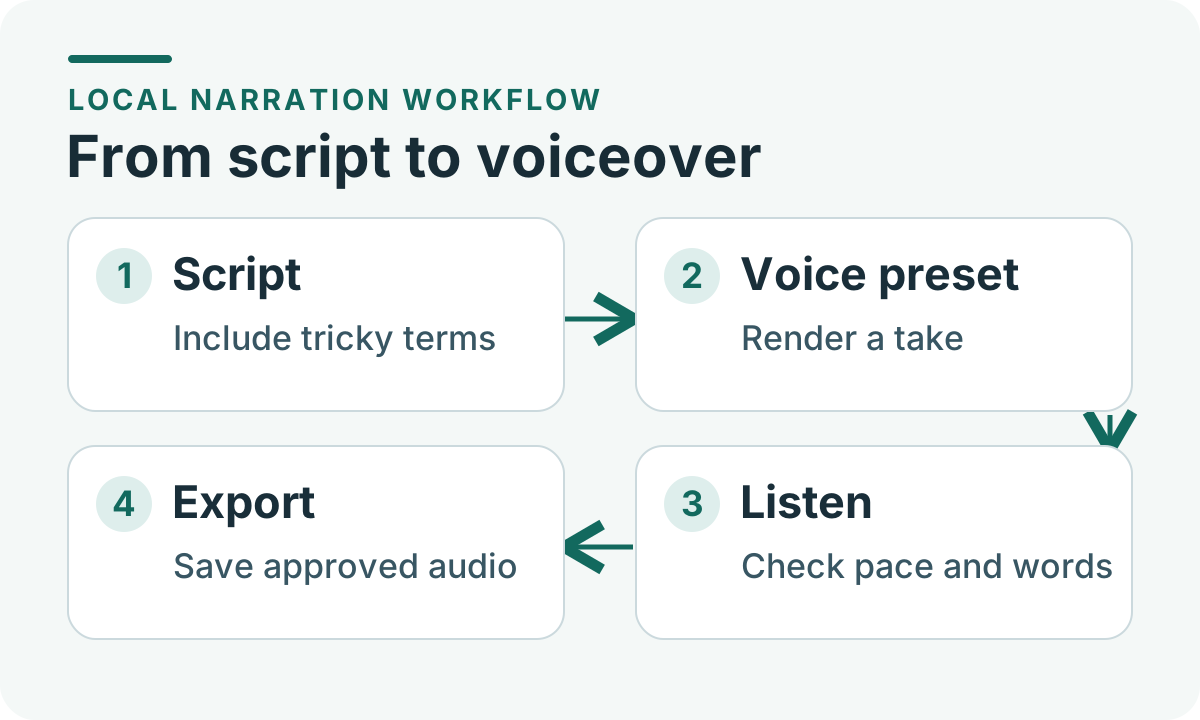
Иллюстрация Telli.sh. Прослушайте сам звук перед экспортом. Предустановка показывает, что запросили, а проверка на слух — что получилось.
Начните с короткого текста, содержащего слова, которые обычно пропускают в показательных примерах. Добавьте код продукта, формат адреса или число с единицей измерения, а также фразу, в которой важен тон. Проверьте три отдельные фразы и затем синтезируйте целый абзац. Голос может звучать последовательно в отдельных фразах и торопливо произнести важное слово в длинном дубле. Попросите человека, знающего язык аудитории, сначала послушать без текста и затем сравните услышанное с оригиналом.
Сохраняйте итоговый звук отдельно от текста и исходных записей. Если позже обнаружится неверное число, можно будет заменить конкретный дубль и сохранить оригинальный монтаж. Если для озвучки уже есть диктор, чьи записи разрешено использовать, помечайте их отдельно от сгенерированных вариантов, чтобы один источник не заменял другой без следа. Готовый голос подходит, когда нужна просто понятная и последовательная речь.
Версия среды вывода — одна часть настройки
Обновление может избавить от необходимости менять среду вывода, если команда уже использует llama.cpp. Всё равно понадобятся совместимая сборка, правильные файлы модели и дополнения, требуемые конкретной моделью. Например, в реализации Nemotron указан мультимодальный проектор. Веса скачиваются отдельно и распространяются на своих условиях. Перед упаковкой любой части для другой команды или клиента прочитайте документацию среды и модели. Файлы выпуска и примечания по настройке Nemotron
Память стоит измерять во время работы, после загрузки модели. Размер файла показывает, сколько места он занимает на диске. Для исполнения нужны также память для вычислений, буферы вычислительной части и промежуточные данные. Компьютер может начать расшифровку и одновременно замедлить монтаж, если оба процесса используют GPU. Ноутбук может справиться один раз и замедлиться на четвёртом запуске из-за охлаждения и фоновых задач. Замерьте пиковую оперативную память и, если применимо, память GPU с открытым редактором в рабочей конфигурации.
Разработчики опубликовали в запросе на включение Nemotron результаты проверки на наборах чистой речи и совещаний, указали настройки квантования и использование RTX PRO 6000 Blackwell. Это объясняет, как проверяли интеграцию. Для решения о покупке или внедрении измеряйте обработку своих записей на целевой машине. Даже на одном оборудовании смена точности, языка или количества наложившихся голосов может изменить соотношение между временем работы и ручной проверкой. Проверка и настройка Nemotron
Сравнивайте версии отдельно. b12144 от 6 ноября — отдельный предварительный выпуск с изменением организации моделей со смесью экспертов в CUDA. Для проверки новых звуковых функций начните с нумерованного выпуска от 4 ноября и сохраните те же файлы и настройки. Если позже проверите предварительный выпуск, зарегистрируйте его отдельно. Тогда можно будет различить изменения из-за звуковой модели, вычислительной части или приложения. Примечания к предварительному выпуску от 6 ноября
Для локальной обработки полезно точно определить, что остаётся на компьютере. Монтажный процесс может вызывать локальный сервер, а соседнее приложение — отправлять журналы, синхронизировать выходную папку или скачивать зависимость. Прежде чем работать с чувствительными записями, скачайте программы и веса на тестовом компьютере или на выделенном этапе настройки. Затем возьмите безобидный фрагмент, отключите сеть и проверьте, какие части процесса завершаются. Уточните, куда записываются исходник, временные файлы и экспорт. Локальная среда отвечает за границы вывода модели, а приложение определяет весь путь данных.
Проверьте один проект на своём рабочем компьютере
- Выберите два коротких материала, которыми можно делиться. Запишите от 30 до 60 секунд речи двух человек, добавьте небольшое наложение голосов и вымышленное название функции. Подготовьте короткую озвучку с тем же названием и одним сложным числом. Оставляйте входные материалы одинаковыми, чтобы видеть влияние настроек.
- Зафиксируйте версии среды и моделей. Выберите исходный код v0.9.0 или связанную сборку b12110 для своей системы. Запишите источник модели, имена файлов и квантование. Для Nemotron через
llama-serverв принятой интеграции указан--reasoning off, потому что шаблон по умолчанию иначе может вернуть рассуждение без расшифровки. В примечаниях говорится, что мультимодальной CLI этот параметр не нужен. Проверяйте именно тот путь, который собираетесь использовать. Примечания к интеграции Nemotron - Замерьте первый и повторный запуски. Запишите время от старта до результата при первом запуске и после загрузки модели. Для расшифровки поделите время обработки на длину записи, чтобы понять, приемлемо ли ожидание для длинного материала. Отметьте пиковую память и отзывчивость редактора. В озвучке может быть важнее время от правки строки до прослушивания нового дубля.
- Сравнивайте ошибки по затратам на исправление. Отметьте пропущенный термин, неверное число, перепутанных говорящих и фразу, которую нужно синхронизировать заново. Включите исправление в общее время. В озвучке проверьте имена, числа, паузы и совпадение звука с монтажом. В сравнение должен входить исправленный результат вместе с первым сгенерированным файлом.
- Определите передачу работы до автоматизации. Решите, кто проверяет расшифровку, где синхронизируют субтитры и как отмечают одобренную озвучку. После первого успешного фрагмента попробуйте второй. Если обработка файла не удалась, сохраните исходник и покажите ошибку в очереди, чтобы человек мог продолжить работу без повтора всего пакета.
Эти проверки можно вести в четырёх столбцах таблицы: настройка, время обработки, время исправлений и принятие результата. Записывайте причины отклонения. После нескольких испытаний может оказаться, что локальная схема отлично подходит для повторной озвучки, а шумные групповые интервью всё ещё требуют другого процесса. Это полезный результат. Используйте каждый компонент там, где он экономит время, и отмечайте, где запасной вариант работает лучше.
Если у вас уже есть хороший процесс расшифровки, сравните его на той же записи по тем же критериям. Можно перенести лишь более простую часть, например генерацию черновой озвучки с небольшим риском на рабочей станции. Надёжный процесс создания субтитров сможет воспользоваться общей локальной интеграцией позже, если будет повод объединить обслуживание моделей и новая реализация уже подтвердит соответствие прежним редакторским требованиям.
Для каких задач выпуск особенно полезен
Первая задача должна быть той, которую вы уже повторяете. Команда обучающих видео может расшифровать черновой дубль, пока он на монтажной машине, и сделать временную озвучку для проверки темпа. Исследователь может получить редактируемый текст собственной записи, поправить говорящих и оставить звук в качестве источника. Небольшая команда разработчиков может проверить оба пути во внутреннем интерфейсе, если он показывает выбранную модель, итоговый файл и ошибки.
Выпуск особенно полезен, если нужно сократить переходы между специализированными инструментами и сохранить отдельные проверки качества. Модель расшифровки по-прежнему должна распознавать слова и различать людей. Модель синтеза должна произносить сценарий. Редактор решает, когда результат готов. Теперь эти задачи могут использовать один набор инструментов вывода и, возможно, тот же компьютер, на котором вы уже работаете.
Чтобы вернуться к готовой записи вместе с расшифровкой и заметками, загрузите её в Telli.sh.