Liquid LFM3 задаёт лучший вопрос о локальном ИИ: какая малая модель справится с задачей?
LFM3 развивает общую основу в текстовые, зрительные, звуковые, универсальные модели и модели решений. Как выбрать специалиста, рассчитать память и оценить локальное применение.
Локальному ассистенту, читающему чек, не обязательно нужна та же модель, что отвечает на устный вопрос. У программы, выбирающей одно из трёх разрешённых действий, снова другая задача. Если считать их одной задачей, небольшое приложение может стать неоправданно сложным.
Liquid AI анонсировала LFM3 27 октября 2026 года: шесть моделей примерно класса 2B, ответвляющихся от общей основы 1.7B и охватывающих текст, зрение, звук, универсальную мультимодальность и два варианта решений. Компания предоставляет открытые веса, Playground и доступ через API. Анонс LFM3.
Интересное решение — какая роль нужна вашему приложению. Это руководство объясняет семейство через практический выбор, отделяет компактный файл весов от рабочего бюджета памяти и предлагает первую оценку, способную показать, полезна ли специализированная модель на вашем оборудовании.
 Raspberry Pi 5 как иллюстрация периферийных вычислений, а не нашего испытания LFM3. Изображение: RetroEditor, CC BY 4.0; размер изменён с добавлением полей. Источник изображения · Лицензия и сведения об изображении. Официальная информация о продукте.

Выбор семейства специалистов начинается с нужного результата
Самый быстрый способ ошибиться — начать с самого длинного списка поддерживаемых входных данных. Начинайте с результата, который должно выдавать приложение. Абзац, расшифровка, структурированное поле и выбор разрешённого действия — разные контракты, даже если одни исходные материалы могли бы помочь получить все четыре результата.
Анонс Liquid от 27 октября выделяет четыре модальные ветви и две ветви решений: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B и d1-Omni-2B. Следующая таблица переводит эти роли в вопросы выбора для приложения. Это руководство по соответствию задаче, а не независимый рейтинг качества. Описание семейства.
| Роль модели | Кандидат семейства LFM3 | Вопрос для приложения |
|---|---|---|
| Текстовое взаимодействие | LFM3-1.7B | Нужен ли задаче языковой ответ на основе текста? |
| Понимание изображений и текста | LFM3-VL-2B | Зависит ли ответ от чего-то видимого? |
| Речевое и звуковое взаимодействие | LFM3-Audio-2B | Нужно ли приложению слышать или говорить? |
| Совместное аудиовизуальное взаимодействие | LFM3-Omni-2B | Нужно ли вместе интерпретировать изображение и звук? |
| Структурированные решения по тексту и изображениям | d1-2B | Можно ли выразить результат типизированными решениями? |
| Структурированные решения с учётом звука | d1-Omni-2B | Должно ли ограниченное решение также использовать звук? |
Наша оценка: полезная единица локального ИИ — наименьшая полная задача. У модели должно быть достаточно возможностей для выполнения ясного контракта приложения вместе со способом обработки неопределённости. Всё сверх этого требует затрат на исполнение, испытания и интеграцию, которые должны оправдать своё место.
Представьте семейство как свёрток инструментов. Для некоторых работ разумно брать все инструменты; для повторяющейся регулировки проще выбрать подходящий. Аналогия касается проектирования приложения, а не утверждения, что одна модель всегда превосходит другую.
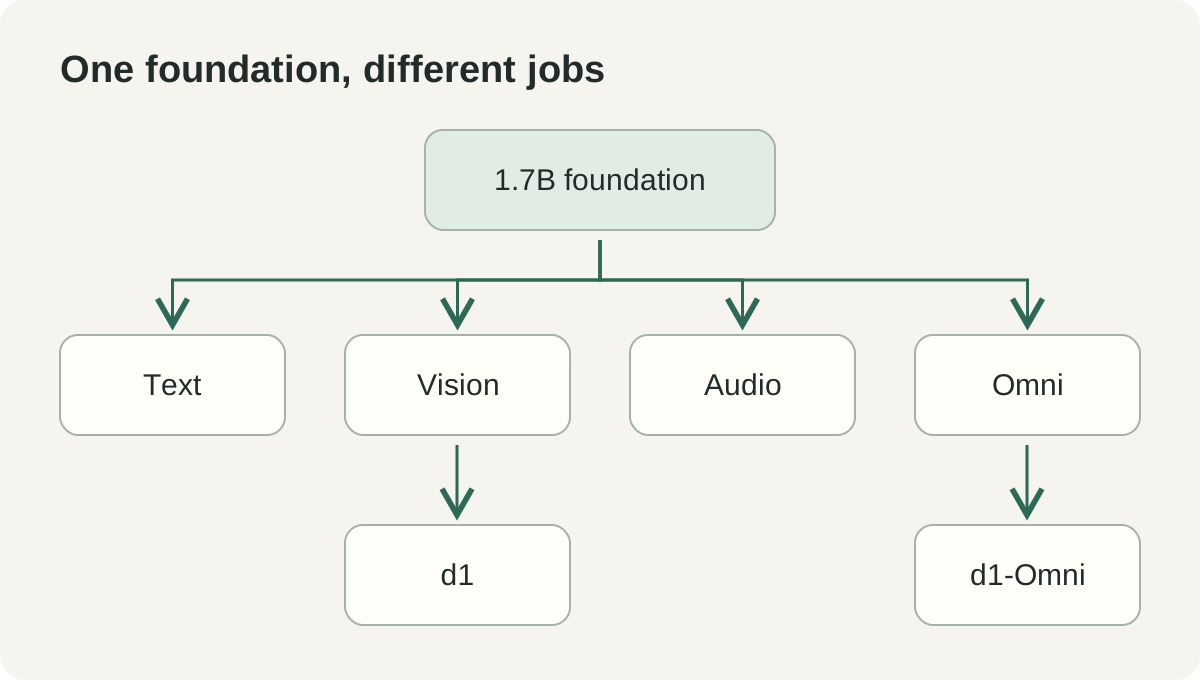 Авторская поясняющая схема ролей, названных в анонсе LFM3 от Liquid AI. Она группирует варианты применения и опускает детали внутренней реализации.
Открытые веса дают выбор развёртывания, но лицензию нужно прочитать
Загрузка весов даёт разработчику конкретный объект для упаковки, оценки и адаптации. Она может поддержать локальное развёртывание, при котором путь данных приложения остаётся под контролем разработчика. Это полезно, но наличие загружаемого файла не определяет его коммерческие условия.
Каталог моделей Liquid, проверенный 2 ноября, описывает бесплатное коммерческое использование, пока компания не превысит 10 миллионов долларов годовой выручки. Карточка LFM3-1.7B указывает LFM Open License v1.0. Прочитайте лицензию конкретного чекпойнта и текущую страницу лицензирования применительно к планируемому развёртыванию, распространению и выручке.
Это практический шаг закупки. Небольшой внутренний прототип, загружаемое потребительское приложение и услуга для других компаний могут вызывать разные вопросы о распространении и обязательствах. Запишите идентификатор модели, ревизию и лицензию рядом с приложением, чтобы решение оставалось прослеживаемым по мере роста проекта.
У среды исполнения и весов модели также разные версии. Модель может быть доступна, пока среда на вашем устройстве ещё не поддерживает её совместимым образом. Проверяйте документированное сочетание, не предполагая, что каждое приложение, способное загрузить предыдущее семейство, правильно загрузит новое.
Для команды эта запись должна включать промпт или шаблон, ожидаемый чекпойнтом. Совместимый загрузчик всё равно может работать плохо, если входные данные оформлены неправильно. Воспроизводимость начинается с понимания того, что именно загрузили и как приложение к нему обращалось.
Примерно 1 ГБ весов — лишь начало бюджета памяти
В материалах запуска от 27 октября Liquid описывает размер текстовой модели в 4-битном представлении как примерно 1 ГБ. Карточка текстовой модели указывает 1,73 миллиарда параметров и контекст ввода и вывода в 256K токенов. Это характеристики модели; пиковая память приложения зависит также от нагрузки и среды исполнения.
Файл весов — только часть работающего процесса. Среде исполнения нужна рабочая память; обработке контекста — состояние; мультимедийным входам могут понадобиться дополнительные буферы и кодировщики. За те же ресурсы конкурируют другие программы устройства. Заголовок о размере весов не показывает, будет ли всему приложению комфортно под нагрузкой.
Поэтому иллюстративный бюджет следует начинать с измеренного потребления памяти процессом. Запишите состояние приложения в простое, пик во время обработки репрезентативного запроса и состояние после повторных запросов. Проверяйте длину контекста и размеры входов, которые действительно будут давать пользователи, а не крошечный промпт, выбранный потому, что он легко помещается.
Та же дисциплина относится ко времени. Запуск, обработка промпта и генерация ответа — отдельные ожидания. Модель, быстро выдающая токены после долгой задержки, может казаться медленной в интерактивном приложении; пакетной задаче может быть важнее число завершённых элементов в час. Выбирайте меру, соответствующую взаимодействию.
Для звуковой функции включайте весь путь от входа до полезного результата. Для функции изображения — обработку изображений. Для функции решений — валидацию и передачу действия. Это требования оценки, которые задаёте вы, а не показатели производительности из анонса.
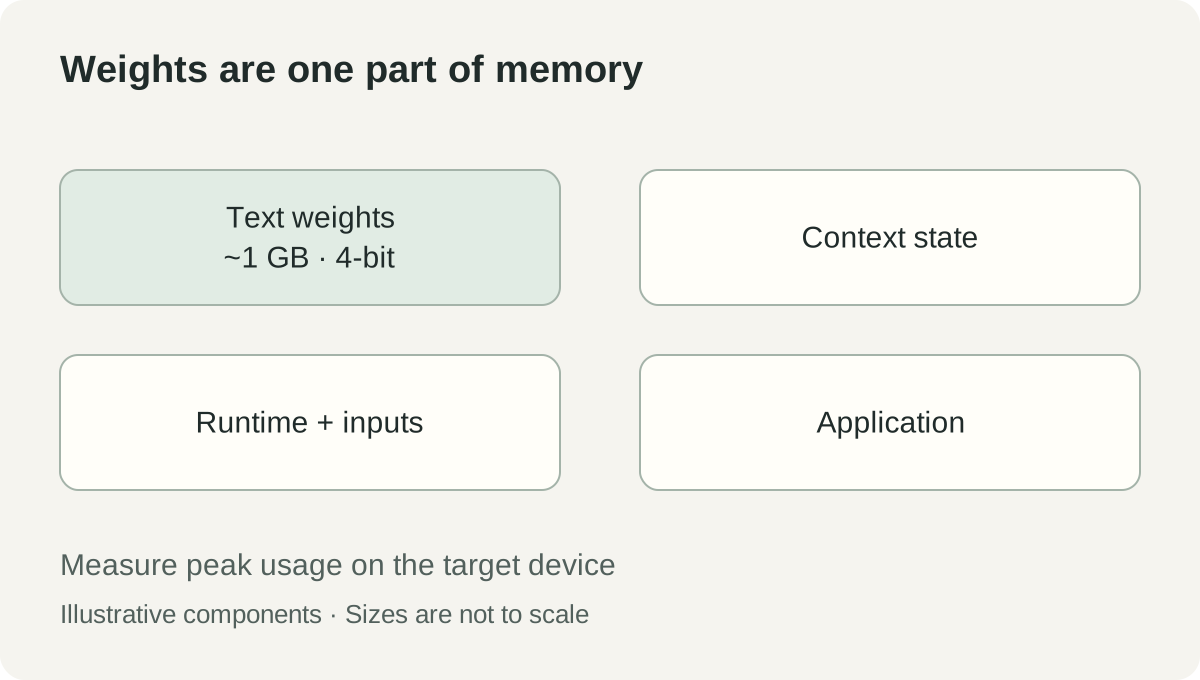 Авторская схема бюджета памяти. Ширина сегментов иллюстративна и не выражает измеренные пропорции; примерно 1 ГБ относится к опубликованному Liquid размеру 4-битной текстовой модели, а не ко всей памяти приложения. Источник.
Три иллюстративных приложения показывают разные компромиссы
Помощник по документам может отделять чтение от решения
Представьте небольшое бизнес-приложение, которое получает сфотографированные чеки. Одна задача — прочитать видимые название продавца, дату и сумму. Другая — решить, достаточно ли полон документ для проверки человеком. Эти результаты заслуживают отдельной валидации, даже если одна модель помогает получить оба.
Зрительно-языковой путь мог бы поддержать вопросы об изображении; путь решений можно оценить для ограниченной проверки полноты. Приложение должно сохранять исходное изображение и отличать извлечённые поля от принятых бухгалтерских данных. Отсутствующая дата должна оставаться отсутствующей, пока кто-то не разрешит проблему.
Составьте иллюстративную оценочную выборку с чёткими и размытыми изображениями, необычной компоновкой и чеками на реальных рабочих языках. Измеряйте ошибки отдельных полей и нагрузку на проверку. Высокая общая доля успеха может скрывать повторяющуюся ошибку в самом важном для бизнеса поле.
Полезный продуктовый результат — более короткая и понятная очередь проверки. Изящное объяснение модели менее важно, чем возможность проверяющего изучить источник и исправить поля. Этот приоритет помогает выбрать между свободным языковым ответом и более ограниченным интерфейсом решений.
Речевой интерфейс может начинаться с узкого набора разрешённых действий
Рассмотрим иллюстративного голосового ассистента для локального приложения. Пользователь может попросить найти элемент, прочитать его состояние или подготовить черновик действия. Звуковые возможности полезны, когда говорить проще, чем печатать, но приложению всё ещё нужно знать, что запросу разрешено менять.
Начните с небольшого словаря действий и видимого пути подтверждения. Например, поиск записи может сразу выполняться в разрешённых данных, тогда как запрос на изменение записи может показывать предложенное действие для проверки. Политика принадлежит приложению, а не случайной формулировке, которую выдаст модель.
Проверяйте реальные акустические условия. Фоновый разговор, короткие фразы и похожие имена могут создавать иные ошибки, чем чистая записанная фраза. Включите случаи, когда правильный результат — переспросить пользователя. Беглый устный ответ менее полезен, чем правильное взаимодействие с возможностью восстановления.
Универсальный мультимодальный кандидат становится актуальным, когда запрос зависит от видимого и произнесённого одновременно. Если все задачи используют только речь, для добавления визуальной обработки нужна причина. Здесь семейный подход может помочь сохранить соразмерность функции задаче.
Локальный инструмент поддержки может распределять работу, сохраняя путь выхода
Иллюстративное приложение поддержки могло бы выбирать одну из трёх очередей по обращению и приложенному снимку экрана. Ограниченный результат решения может соответствовать задаче точнее, чем длинный ответ, который приложению придётся интерпретировать. Полезный вопрос — достаточно ли надёжен выбранный маршрут при приемлемой доле проверки.
Сохраните явный исход «нужна проверка». Испытайте обращения, не подходящие ни одной разрешённой очереди, противоречащие тексту снимки экрана и случаи недостаточного контекста. Приложение не должно заставлять модель выдумывать допустимый маршрут только потому, что схема требует его наличия.
Сравните модель с простой исходной системой, например существующими правилами и ручным распределением. Если исходная система уже надёжно обрабатывает категорию, модель должна улучшать другую часть процесса. Новизна не является критерием приёмки.
Для каждой ошибки сохраняйте достаточно разрешённого контекста, чтобы понять её причину. Отделяйте проблемы входа, неоднозначные категории и ошибки модели. Это различие показывает, нужно ли улучшать модель, менять определения очередей или запрашивать более качественные исходные материалы.
Таблицы бенчмарков — отправная точка для вашей нагрузки
Официальная карточка LFM3-1.7B, проверенная 2 ноября, рекомендует извлечение или поиск для задач с большим объёмом знаний и предостерегает от агентного программирования и сложных многошаговых рассуждений при таком размере. Это полезная рекомендация по размещению модели внутри более крупной системы, даже если таблицы производителя показывают прогресс.
Бенчмарк отвечает на определённый вопрос в конкретных условиях. Ваше приложение добавляет собственные данные, инструменты, распределение языков и цену ошибок. Модель может улучшить общий публичный показатель и всё ещё требовать тщательной работы над несколькими категориями, с которыми пользователи сталкиваются каждый день.
Разделите в пилоте три сравнения. Во-первых, сравните качество задачи с текущим процессом. Во-вторых, сравните полную стоимость ресурсов на целевом устройстве. В-третьих, сравните работу, необходимую для восстановления после сбоя. Победители этих сравнений могут различаться.
Например, облачная универсальная модель может быть полезна как путь эскалации, когда локальный специалист отказывается отвечать. Такой подход требует явной политики данных и пользовательского сценария. Локальная работа — вариант развёртывания, который проверяют во всём приложении, включая журналирование и резервные запросы.
Дообучение должно следовать за доказанным пробелом. Если сбои вызваны отсутствием исходных материалов или неясными определениями результата, дополнительное обучение может закрепить неверную задачу. Определите контракт и изучите ошибки, прежде чем решать, что следующим полезным шагом будет настройка модели.
Решения первого пилота должны помещаться на одной странице
Официальная карточка текстовой модели ссылается на форматы чекпойнтов и инструкции среды исполнения. Начинайте с неё для точного сочетания модели и среды; используйте официальный Playground для первой проверки взаимодействия, если это соответствует вашей политике данных. Ни один путь не заменяет испытаний развёртывания, которое вы собираетесь выпускать.
- Запишите контракт входа и выхода. Укажите разрешённый материал, ожидаемый результат и явный исход передачи на проверку. Выберите одну задачу вместо образа универсального ассистента.
- Выберите кандидата и ревизию. Сопоставьте модальность и роль результата, затем запишите чекпойнт, лицензию и совместимую среду исполнения. Прочитайте ограничения конкретной модели.
- Создайте репрезентативную оценочную выборку. Включите обычные и сложные случаи, неподдерживаемые запросы и примеры на реальных языках пользователей. Отделяйте отложенные материалы от данных для настройки.
- Запустите документированный быстрый старт в изолированной среде. Следуйте текущим инструкциям карточки по зависимостям и формату. Перед сравнением результатов подтвердите возвращаемую идентичность модели.
- Измерьте полный путь приложения. Фиксируйте правильность, долю проверки, задержку и пик памяти для реалистичных размеров входа. Записывайте оборудование и параметры среды рядом с числами.
- Испытайте путь неопределённости. Убедитесь, что недостающая информация, неверный результат и сбой исполнения приводят к понятному состоянию проверки или повторной попытки.
- Решите, что специализировать дальше. По повторяющимся категориям ошибок выбирайте между лучшим входом, более ясными правилами, извлечением, дообучением и другой моделью.
Для первого прохода письменное решение может быть простым: этот кандидат полезен для этой задачи на этом устройстве при таких условиях проверки. Узкий воспроизводимый вывод ценнее общего заявления, что локальный ИИ готов ко всему.
Малая модель заслуживает место выполнением определённой задачи
LFM3 расширяет выбор для разработчиков, которым нужны текст, зрение, звук или ограниченные решения рядом с приложением. Практическое значение — в возможности выбирать эти роли и оценивать их как части продукта.
Следующий шаг — определить одну задачу достаточно точно, чтобы измерять качество, память и восстановление. Специалист становится полезным, когда всё приложение может полагаться на его контракт и знает, что делать, если он не может ответить.
Источники
- Liquid AI: представляем LFM3, 27 октября 2026 года; проверено 2 ноября 2026 года.
- Каталог моделей Liquid AI и цены и лицензирование, проверено 2 ноября 2026 года.
- Официальная карточка LFM3-1.7B, проверено 2 ноября 2026 года.
- Официальная карточка d1-2B, проверено 2 ноября 2026 года.
Сохраняйте материалы, на которых основано решение
Telli.sh — один из вариантов хранения разрешённых исходных материалов рядом с проверенными вами заметками. Создать пространство заметок.