Jev เลือกแทนการสนทนา: เดโมจริงบอกอะไรเกี่ยวกับการตัดสินใจของโมเดล
จากเดโมเบราว์เซอร์และการจัดประเภทอีเมล 1,500 ฉบับ ไปจนถึง Doom และ Wikiracing: ตัวอย่าง Jev พิสูจน์อะไรจริง และจะประเมินการตัดสินใจแบบมีโครงสร้างอย่างปลอดภัยได้อย่างไร
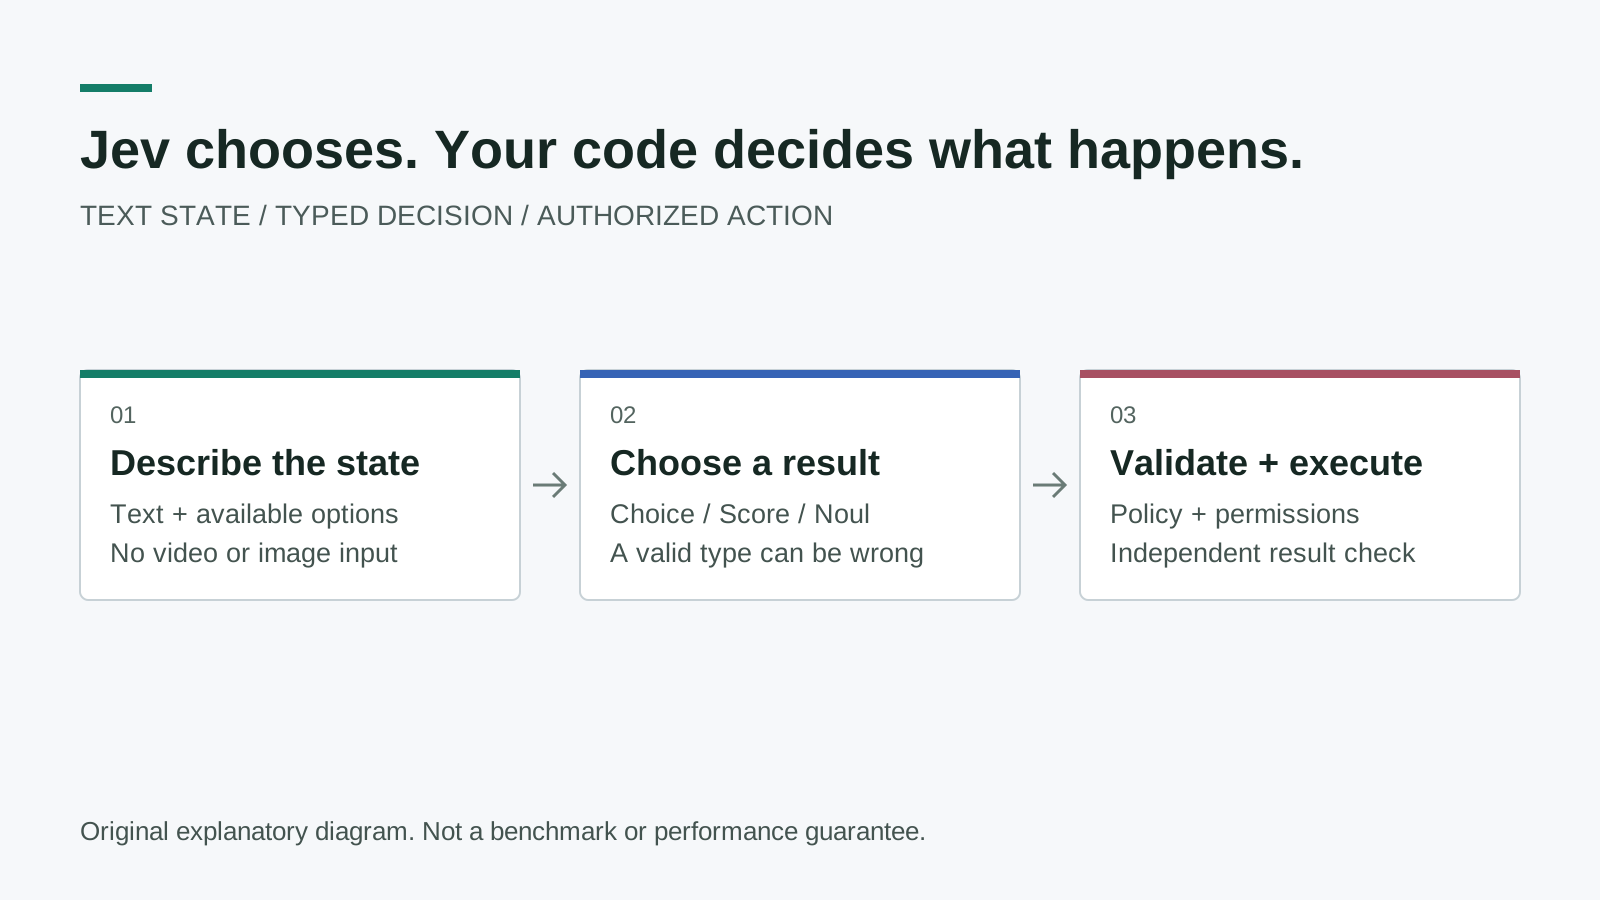
แผนภาพต้นฉบับแสดงขอบเขตการตัดสินใจ คำตอบที่มีชนิดข้อมูลชัดเจนจำกัดรูปแบบ ไม่ได้รับประกันความถูกต้องหรือการอนุญาตให้ดำเนินการ
ตัวจัดประเภทกล่องจดหมายไม่จำเป็นต้องเขียนเรียงความก่อนเลือกโฟลเดอร์ ตัวควบคุมเบราว์เซอร์มักต้องเลือกปุ่มที่มีอยู่ ไม่ใช่สร้างคำสั่งใหม่ การตัดสินใจเล็ก ๆ เหล่านี้คือจุดที่ Jev ซึ่งเป็นโมเดล System One รุ่นแรกของ TypeSafe AI แสดงจุดเด่นได้น่าสนใจที่สุด
TypeSafe เปิดตัว Jev เมื่อ 15 กันยายน 2026 ความแตกต่างที่เป็นประโยชน์ไม่ใช่แค่เป็นโมเดลเร็วอีกรุ่น แต่คือการคืนผลเป็นการตัดสินใจที่มีข้อจำกัด แทนร้อยแก้วปลายเปิด ซึ่งเปลี่ยนวิธีสร้างโปรแกรมรอบโมเดล แต่ไม่ได้ตัดความเป็นไปได้ที่จะเลือกผิด ดู การเปิดตัวอย่างเป็นทางการ สำหรับกรอบอธิบายของผู้ให้บริการ
คู่มือนี้ติดตามเดโมสาธิตสามรายการ: งานเบราว์เซอร์ที่มีหลักฐาน GIF และวิดีโอให้ดาวน์โหลดได้ รายงานของผู้เขียนเกี่ยวกับการจัดประเภทอีเมล 1,500 ฉบับ และเดโมเกมของ TypeSafe จากนั้นจะแปลงตัวอย่างเหล่านั้นเป็นแผนประเมินที่ทำได้จริง บทความกรณีใช้งานบน Tistory ซึ่งเผยแพร่วันที่ 18 กันยายน เป็นจุดเริ่มต้นการค้นคว้า แอปพลิเคชันที่เสนอไว้ในบทความนั้นไม่ได้ถูกถือว่าเป็นการติดตั้งใช้งานของลูกค้าที่ตรวจสอบโดยอิสระ
สรุปสั้น ๆ:
- Jev เลือก ให้คะแนน หรือประเมินข้อความจากข้อมูลได้ ไม่ใช่สิ่งแทนโมเดลที่เขียนข้อความทั่วไป
- ผลลัพธ์ที่ถูกชนิดข้อมูลยังผิดความหมายได้ เก็บการตรวจสอบและการอนุญาตขั้นสุดท้ายไว้ในโค้ด
- วิดีโอบันทึกเบราว์เซอร์เป็นของจริง แต่หนึ่งงานไม่ใช่เบนช์มาร์กทั่วไป ตัวอย่างอีเมลเป็นรายงานของผู้เขียน ไม่ใช่งานศึกษาความแม่นยำที่เผยแพร่
- เริ่มจากการจัดประเภทที่ย้อนกลับได้ วัดข้อผิดพลาดกับข้อมูลของตน และรองรับการงดตัดสินใจ
คำตอบสั้น ๆ ต้องเริ่มจากคำถามที่ชัดเจน
องค์ประกอบหลักสามอย่างของ API คือ Choice, Score และ Noul Choice เลือกจากตัวเลือกที่ตั้งชื่อไว้ Score ประเมินตามระดับที่เรียงลำดับและมีคำอธิบาย Noul คืนค่าความน่าจะเป็นของข้อความจริง/เท็จ โดยค่าใกล้กึ่งกลางหมายถึงไม่แน่ใจในข้อความนั้น ไม่ใช่ระดับความรุนแรงปานกลาง เอกสารองค์ประกอบพื้นฐาน กำหนดสัญญาเหล่านี้
แนวทางที่เปลี่ยนไปคือกำหนดผลลัพธ์ที่เป็นไปได้ก่อนถามโมเดล แทนที่จะขอให้เขียนย่อหน้าเกี่ยวกับข้อความสนับสนุนที่เข้ามา คุณถามได้ว่าเกี่ยวกับการเรียกเก็บเงิน การเข้าถึงบัญชี ข้อบกพร่องของผลิตภัณฑ์ หรือหมวดที่ยังระบุไม่ได้ จากนั้นแอปพลิเคชันตัดสินใจว่าจะส่งไปคิวไหน ผลลัพธ์เหมือนสับรางรถไฟ ไม่ใช่รถไฟทั้งขบวน: ช่วยกำหนดทิศทางงานแต่ไม่ได้ทำทุกอย่างที่จำเป็นให้เสร็จ
| องค์ประกอบ | คำถามที่มีประโยชน์ | ความรับผิดชอบของแอป |
|---|---|---|
| Choice | คิวใดเหมาะกับข้อความนี้มากที่สุด | กำหนดชุดตัวเลือกให้ครบ รวมทางส่งตรวจทาน |
| Score | ข้อความตรงกับระดับความเร่งด่วนที่อธิบายไว้มากแค่ไหน | กำหนดระดับและทดสอบว่าผู้ตรวจเห็นตรงกันหรือไม่ |
| Noul | ข้อความร้องขอการยกเลิกอย่างชัดเจนหรือไม่ | กำหนดความน่าจะเป็นที่ควรส่งตรวจหรือใช้การกระทำที่ย้อนกลับได้ |
การเขียนตัวเลือกที่ดีเป็นงานวิศวกรรม หากป้ายกำกับสองอันซ้อนทับกัน ตัวเลือกที่ดูมั่นใจอาจซ่อนปัญหาในอนุกรมวิธาน หากไม่มีป้ายใดตรงแต่บังคับให้เลือก ก็เท่ากับปกปิดช่องว่างเป็นความแน่นอน ตัวเลือกให้ตรวจทานมักมีค่ากว่าการเพิ่มหมวดแคบ ๆ เพราะเผยให้เห็นจุดที่ต้องปรับสัญญาการตัดสินใจ
ตามข้อมูลที่ตรวจเมื่อ 30 กันยายน 2026 รายการอ้างอิงโมเดล ระบุ jev-1.13.0 รองรับอินพุตข้อความเท่านั้น และราคา $0.042 ต่อหนึ่งล้านโทเค็นอินพุต ส่วนโทเค็นเอาต์พุตฟรี นี่คือราคาโทเค็นของโมเดล ไม่ใช่ค่าใช้จ่ายรวมของการรันเอเจนต์ เบราว์เซอร์ การดึงข้อมูล โมเดลช่วย การลองซ้ำ และการตรวจทานโดยมนุษย์ต้องอยู่ในงบปฏิบัติการด้วย
GIF เบราว์เซอร์แสดงการค้นหาจริง ไม่ใช่การจองเที่ยวบิน
คลังสาธารณะ jev-ultrafast ของ Browser Use มีบันทึกงานค้นหา Google Flights จาก Zurich ไป London Jev เลือกการกระทำและเป้าหมายจากการแสดงหน้าเว็บปัจจุบัน ตัวช่วยสร้างข้อความอีกตัวจะป้อนข้อความเมื่อการกระทำที่เลือกต้องพิมพ์ นี่คือระบบที่ประกอบจากหลายส่วน ไม่ใช่หลักฐานว่า Jev สร้างข้อความทุกชนิดหรือตีความเฟรมวิดีโอได้เอง
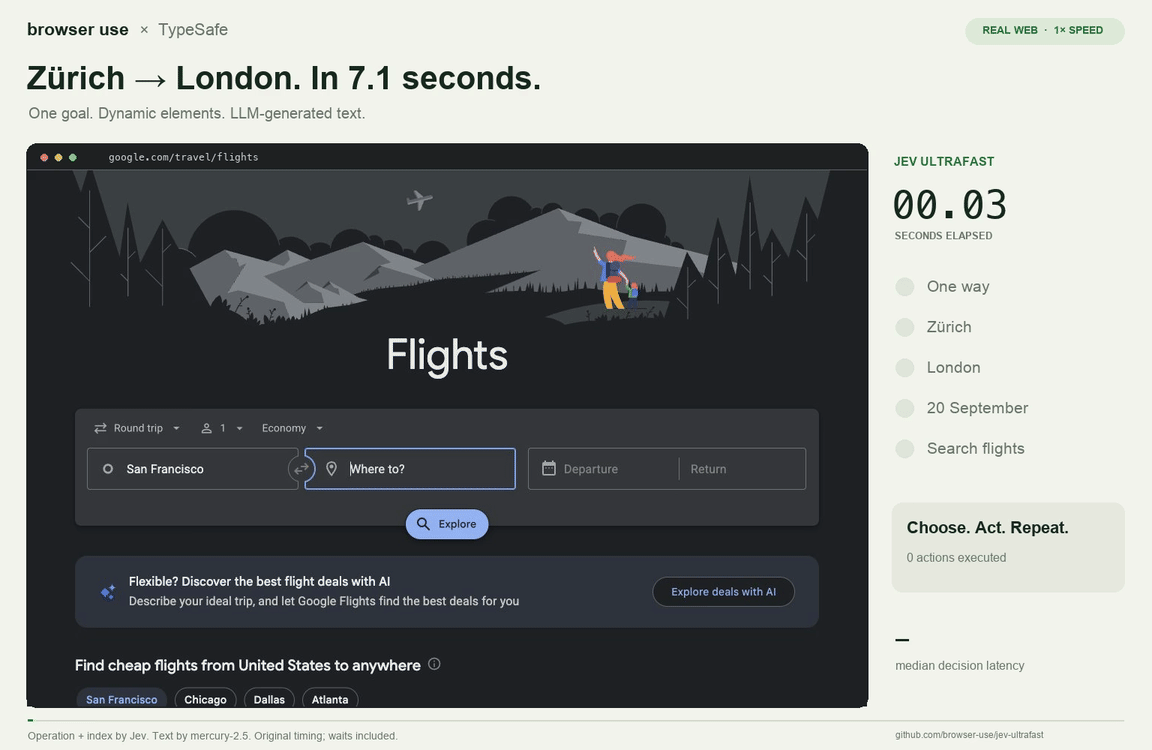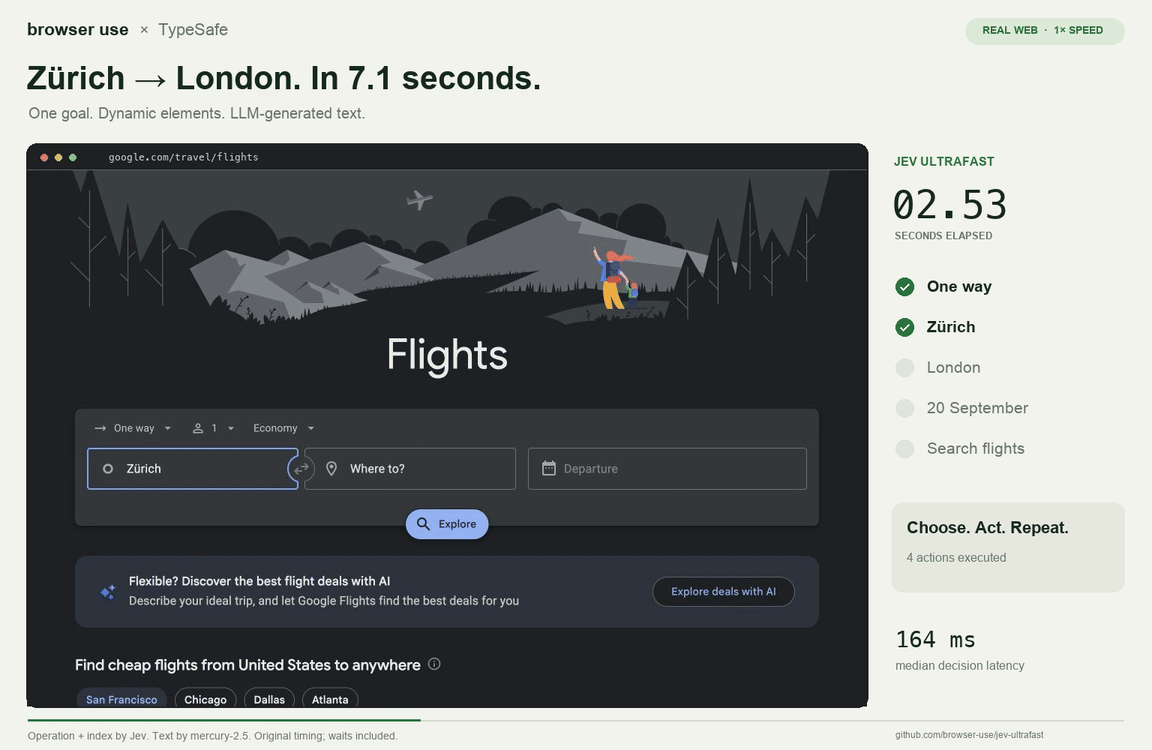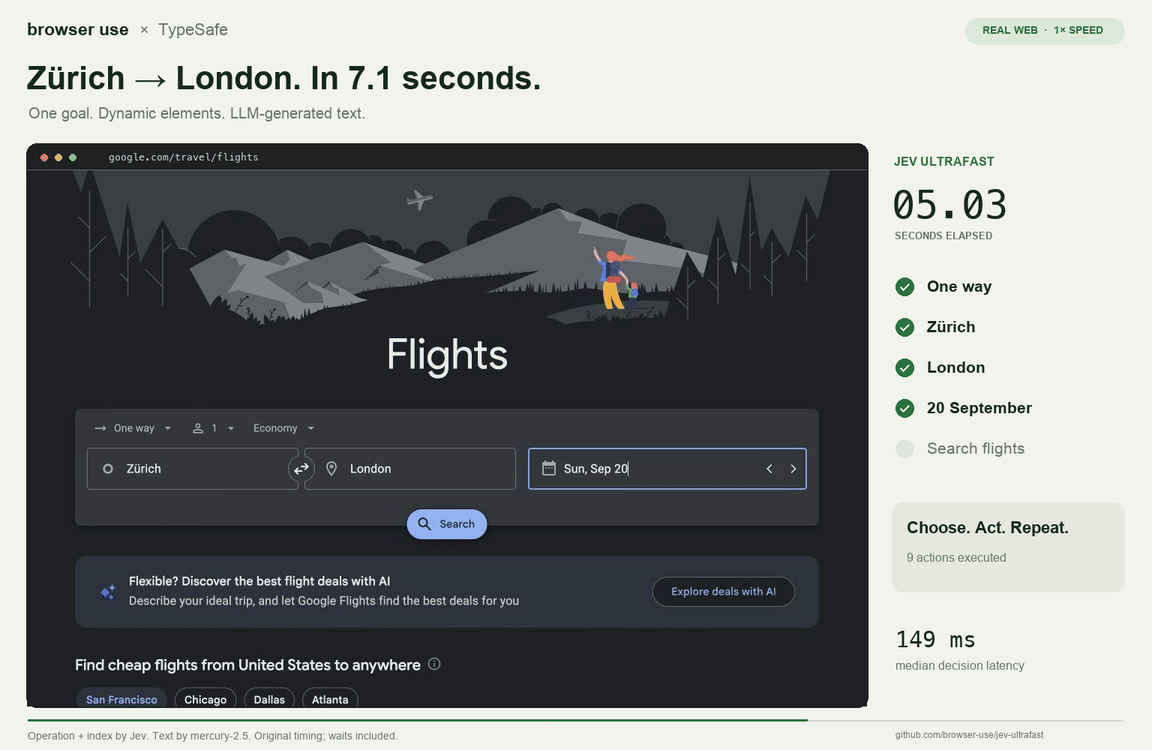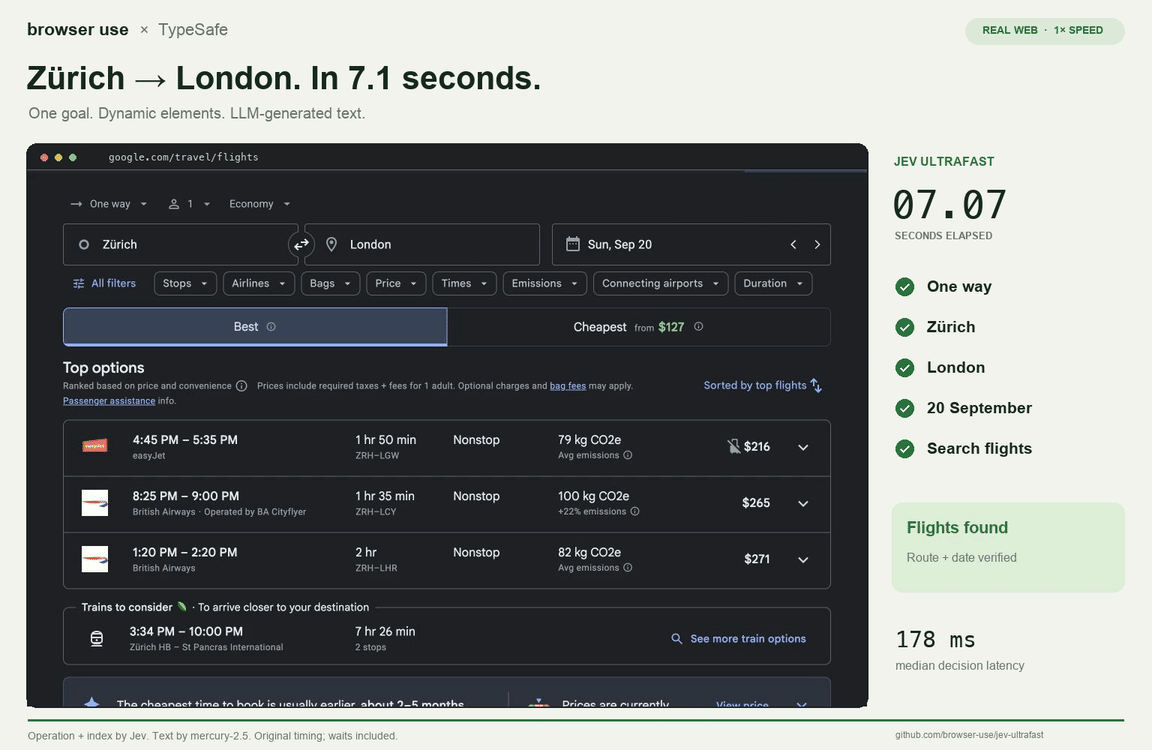
GIF จริงที่ผู้เขียน Browser Use บันทึกและตรึงไว้ที่ commit 1231850a0bf1a0c0341fe408ef1668dbbfdfac46 ลิขสิทธิ์ 2026 Browser Use ใบอนุญาต MIT แสดงขั้นตอนค้นหา ไม่ใช่ซื้อ สามารถเล่นบันทึกเดียวกันด้านล่างได้
MP4 ของผู้เขียน แสดงด้วยความเร็วที่บันทึกพร้อมตัวควบคุมเบราว์เซอร์ บันทึกต้นฉบับและหมายเหตุการวัด; ใบอนุญาต MIT ที่เก็บไว้ เราตรวจดูไฟล์สาธารณะ แต่ไม่ได้รันเบนช์มาร์กซ้ำ
เวลาทำงานที่ผู้เขียนวัดได้คือ 7.073 วินาที นาฬิกาเริ่มที่การทำนายครั้งแรกหลังสังเกตหน้าแรก ไม่ใช่ตอนเปิดเบราว์เซอร์ใหม่ การตั้งค่า การนำทางเริ่มต้น และการตรวจสอบอิสระครั้งใหม่หลังจบรอบไม่รวมอยู่ในช่วงเวลานี้ มีการตรวจผลการค้นหา แต่ไม่ได้เลือกหรือซื้อตั๋ว ขอบเขตเหล่านี้จำเป็นต่อการตีความตัวเลข
รายงานเดียวกันเปรียบเทียบการรันสลับกันหกรอบ รอบละสามครั้งต่อ runtime ค่ามัธยฐานเวลางานลดจาก 9.450 วินาทีเป็น 7.092 วินาที ส่วนค่ามัธยฐานการเรียก Browser Protocol ลดจาก 1,092 เหลือ 101 ครั้ง ทั้งสองชุดใช้ Jev และตัวช่วยข้อความตัวเดียวกัน จึงเป็นการเปรียบเทียบ runtime เป็นหลัก ไม่ใช่การแข่งขันระหว่างตระกูลโมเดลสองแบบ ผู้เขียนระบุชัดถึงตัวอย่างจำนวนน้อยและความแปรปรวนของเว็บจริงใน รายงานประสิทธิภาพ
มุมมองของเราคือวงจรการทำงานรอบเบราว์เซอร์สำคัญไม่น้อยไปกว่าโมเดล การรวบรวมหน้าเว็บซ้ำ ๆ การหาเป้าหมาย และการทำให้การตัดสินใจก่อนหน้าใช้ไม่ได้ อาจมีต้นทุนมากกว่าความเรียบง่ายที่เห็นจากการคลิก โมเดลตัดสินใจที่เร็วกว่าแก้คำอธิบายปุ่มที่ไม่น่าเชื่อถือไม่ได้ คลังโค้ดยังคงตรวจผลแยกต่างหาก เพราะโมเดลบอกว่าเสร็จไม่ใช่หลักฐานว่างานเสร็จจริง
ข้อจำกัดของเดโมก็มีประโยชน์เช่นกัน การติดตั้งใช้งานที่บันทึกไว้ไม่ครอบคลุมทุกเฟรม canvas ขั้นตอนอัปโหลด หรือวิดเจ็ตคีย์บอร์ดทั่วไป ทีมประเมินควรทำงานตัวแทนและเส้นทางความล้มเหลวของตนซ้ำ ไม่อนุมานว่าค้นเที่ยวบินสำเร็จครั้งเดียวพิสูจน์ความสามารถเบราว์เซอร์ทั่วไป มองบันทึกนี้เป็นหลักฐานที่ตรวจสอบได้ของระบบผสมหนึ่งแบบที่ทำงานจริง
โพสต์เรื่องอีเมล 1,500 ฉบับน่าสนใจแต่ไม่มีตัวหาร
เมื่อ 16 กันยายน 2026 vogel (@ryanvogel) โพสต์บน X ว่าลอง Jev กับอีเมลของตน 1,500 ฉบับ และประทับใจกับผลการจัดประเภท โพสต์ต้นฉบับมีวิดีโอ เป็นกรณีผู้ใช้จริงที่มีประโยชน์เพราะปริมาณงานชัดเจนและแหล่งข้อมูลคือผู้รายงานการทดลองเอง ไม่ใช่รายการสมมติที่ไม่ระบุผู้เขียน
อย่างไรก็ดี นี่ไม่ใช่รายงานความแม่นยำ โพสต์ไม่ได้ระบุชุดทดสอบติดป้ายกำกับสาธารณะ อัตราความผิดพลาดที่วัดได้ ความสอดคล้องระหว่างผู้ตรวจ หรือค่าเสียหายจากข้อผิดพลาด จำนวนข้อความที่ประมวลผลบอกขนาดการทดลอง ไม่ได้บอกความถูกต้อง ดู เดโม X ต้นฉบับ โดยคำนึงถึงความแตกต่างนี้ วิดีโอถูกลิงก์ไว้แทนการคัดลอกโดยไม่มีใบอนุญาตเผยแพร่ต่อ
ถึงอย่างนั้น การจัดประเภทอีเมลเป็นจุดเริ่มประเมินที่สมเหตุสมผล เพราะออกแบบให้ย้อนกลับได้ แสดงป้ายแนะนำข้างกล่องจดหมายเดิม ไม่แตะข้อความต้นฉบับ และบันทึกการแก้ไข เปรียบเทียบคู่ที่สับสนง่าย เช่น ใบแจ้งหนี้กับการเตือนชำระเงิน หรือคำขอยกเลิกกับคำร้องเรียนที่เพียงเอ่ยถึงการยกเลิก กรณีเหล่านี้ชี้ว่าหมวดหมู่ตรงกับขั้นตอนทำงานจริงหรือไม่
การเริ่มใช้งานไม่ควรลบจดหมาย ส่งคำตอบ หรืออนุมัติธุรกรรมโดยอัตโนมัติเพียงเพราะผลจัดประเภทดูมั่นใจ การกระทำเหล่านั้นมีสิทธิ์และผลลัพธ์อีกแบบ เริ่มจากข้อเสนอแนะหรือคิวตรวจทาน แล้วค่อยเพิ่มการกระทำขอบเขตแคบเมื่อวัดรูปแบบข้อผิดพลาดแล้ว นี่เป็นขั้นตอนประเมินที่เราเสนอ ไม่ใช่คำกล่าวอ้างเกี่ยวกับการติดตั้งใช้งานของผู้โพสต์ X
Doom และ Wikiracing ทำให้วงจรตัดสินใจมองเห็นได้
งานเปิดตัวของ TypeSafe มี เดโม Doom และ เดโม Wikiracing ซึ่งลิงก์จากบทความเปิดตัวทางการ ทั้งคู่ช่วยอธิบายการตัดสินใจซ้ำ ๆ ด้วยภาพ แต่ไม่ได้พิสูจน์ว่า Jev เป็นโมเดลภาพทั่วไปหรือแก้ปัญหาวางแผนใด ๆ ได้
ในตัวอย่าง Doom โมเดลได้รับคำอธิบายสถานะเป็นข้อความแบบมีโครงสร้าง ไม่ใช่ภาพหน้าจอ ส่วน Wikiracing โมเดลเลือกจากลิงก์ที่มี แทนการสร้าง URL ปลายทางขึ้นเอง กลไกที่น่าสนใจคือวงจรสังเกต เลือกภายในขอบเขต แล้วลงมือทำซ้ำ เดโมเกมทำให้เห็นวงจรนี้ง่าย แต่ยังไม่ตอบว่าถ่ายโอนไปสภาพแวดล้อมอื่นได้ดีแค่ไหน
การแยกส่วนแบบเดียวกันปรากฏในเอกสารเดโมบ้านอัจฉริยะ ของ TypeSafe คำถามหลายข้ออาจจัดประเภทด้านต่าง ๆ ของคำขอ ขณะที่อีกส่วนหนึ่งจัดการบทสนทนาอิสระหรือแบ่งคำขอซับซ้อน อย่าอธิบายสถาปัตยกรรมนี้ว่าเป็นโมเดลเดียวที่ทั้งสร้างภาษาและดำเนินการตัดสินใจทุกอย่าง ชื่ออย่าง assistant หรือ agent มักซ่อนขอบเขตดังกล่าว หากการติดตั้งใช้งานไม่แสดงให้ชัด
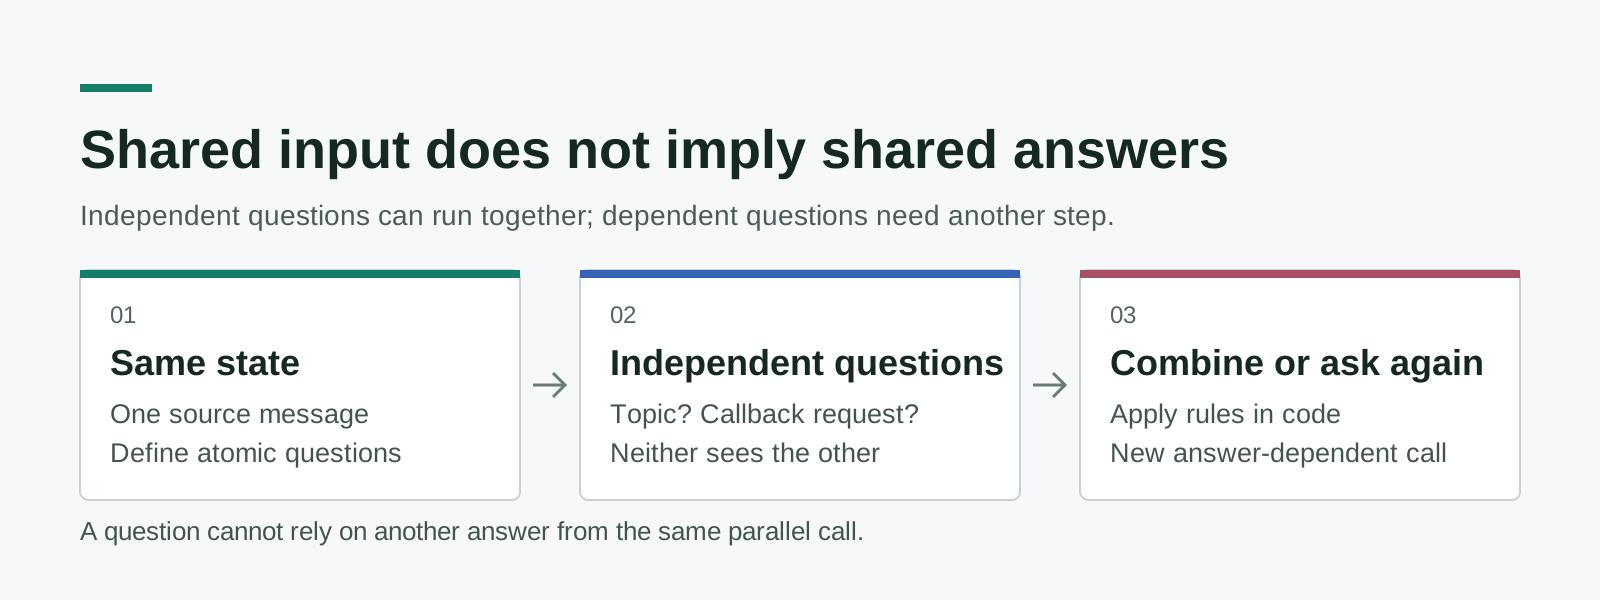
แผนภาพต้นฉบับอิงสัญญา fan-out ที่บันทึกไว้ คำถามพร้อมกันใช้สถานะร่วมกัน แต่ไม่ได้แอบอ่านคำตอบของกันและกัน
รูปแบบ fan-out ลดเวลารอแบบต่อเนื่องได้เมื่อหลายคำถามขึ้นกับแหล่งเดียวกัน ตัวอย่างเช่น ประเมินหัวข้อของข้อความกับว่ามีการขอให้โทรกลับอย่างชัดเจนหรือไม่แยกกันได้ คำถามที่ขึ้นกับหัวข้อซึ่งเพิ่งเลือกไม่อาจสมมติว่ามีคำตอบนั้นอยู่แล้วในการเรียกเดียวกัน แยกส่วนพึ่งพาไปขั้นตอนถัดไป หรือรวมผลอิสระอย่างกำหนดแน่นอนในโค้ด
คำตอบที่มีชนิดข้อมูลไม่เท่ากับคำตอบที่ถูกต้อง
การตีความโมเดลแบบมีข้อจำกัดที่อันตรายที่สุดคือคิดว่าคำตอบที่มีรูปแบบถูกต้องย่อมไม่ผิด ซึ่งไม่จริง ตัวจัดประเภทอาจเลือกป้ายที่อนุญาตแต่ไม่เหมาะสม ตัวเลือกการกระทำอาจเลือกปุ่มที่ใช้ได้แต่เป็นของฟอร์มผิด การกำจัดร้อยแก้วผิดรูปแบบจากอินเทอร์เฟซมีประโยชน์ แต่แก้ปัญหาคนละกลุ่มกับการเข้าใจงานผิด
บันทึกความไม่สม่ำเสมอของ Jev 1.13 ของ TypeSafe ซึ่งตรวจทานครั้งล่าสุดวันที่ 17 กันยายน กล่าวถึงจุดอ่อนด้านเลขคณิต การนับ การเปรียบเทียบวันที่ บริบทชวนไขว้เขว และอินพุตเชิงโจมตี หากต้องเปรียบเทียบอย่างแม่นยำ ให้แยกวิเคราะห์วันที่และคำนวณปริมาณด้วยโค้ดทั่วไป อย่าเปลี่ยนกฎที่กำหนดแน่นอนให้เป็นการตัดสินเชิงความหมายเพียงเพราะโมเดลรับคำถามได้
เอกสารความเชื่อมั่น ก็สำคัญ: Choice และ Score เปิดเผยการแจกแจงความน่าจะเป็นกับค่าความเชื่อมั่นที่อนุมานได้ ส่วน Noul ไม่มีฟิลด์ความเชื่อมั่นแยกต่างหาก ตัวเลขนั้นไม่ใช่ความน่าจะเป็นสากลว่าคำตอบถูก ต้องตรวจสอบ threshold กับงานของตน โดยเฉพาะเมื่อผลของผลบวกลวงต่างจากผลของผลลบลวง
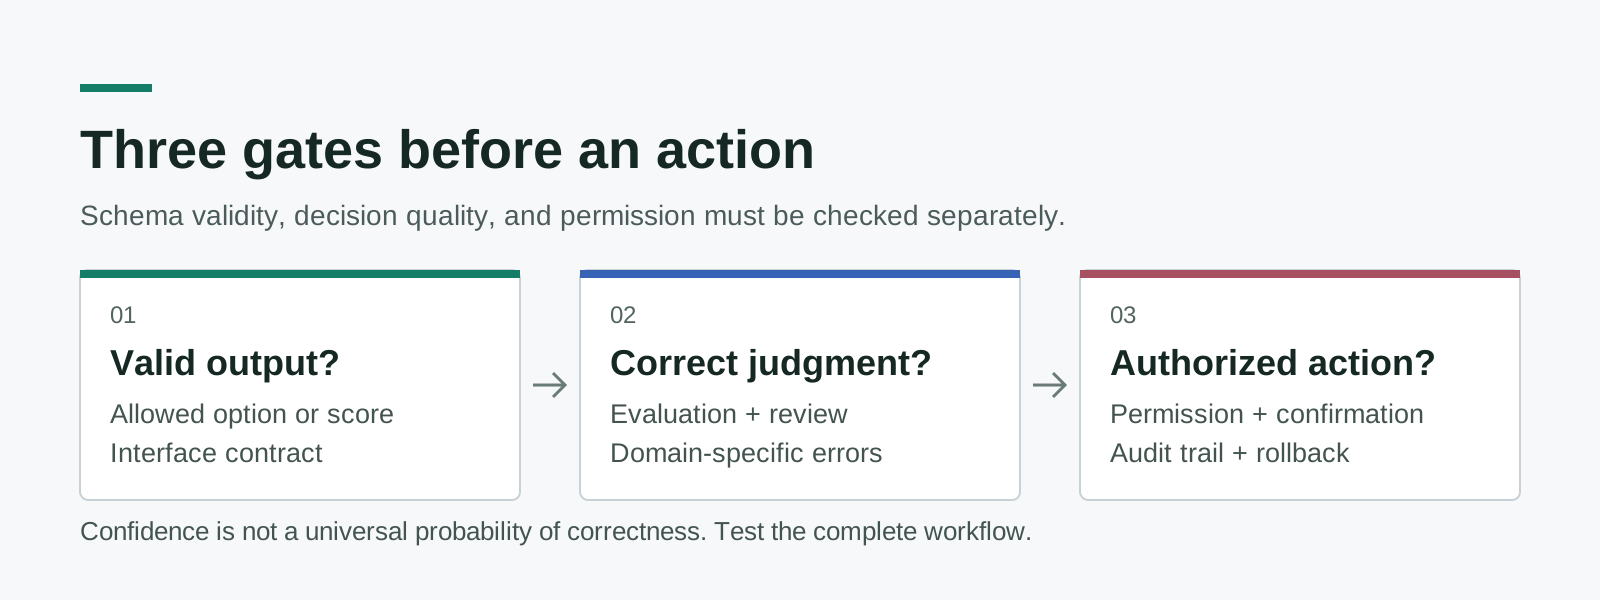
แผนภาพประเมินต้นฉบับ การผ่านด่านหนึ่งไม่ได้หมายถึงผ่านด่านถัดไป เอาต์พุตที่อนุญาตยังต้องตีความถูกและมีการอนุมัติการกระทำ
งานหลายภาษาควรทดสอบทุกภาษาที่ให้บริการ เอกสารโมเดลระบุว่าภาษาอังกฤษเป็นภาษาหลักในการฝึก และคุณภาพภาษาอื่นไม่สม่ำเสมอ รวมถึงอักษร CJK คิวสนับสนุนภาษาเกาหลีหรือคลังจดหมายข่าวหลายภาษาจึงควรเป็นส่วนประเมินของตัวเอง ไม่ใช่การต่อขยายคะแนนอังกฤษโดยอัตโนมัติ การแปลอาจเปลี่ยนหลักฐานได้ด้วย หากประเมินข้อมูลที่ผ่านการแปลให้เก็บต้นฉบับไว้
สร้างการทดลองที่ยอมรับความล้มเหลวได้อย่างตรงไปตรงมา
โครงการนำร่องที่มีประโยชน์เริ่มจากการตัดสินใจที่ทีมติดป้ายได้สม่ำเสมอ เลือกงานที่ย้อนกลับได้ เช่น เสนอคิวสนับสนุน ทำเครื่องหมายรายการที่อาจซ้ำ หรือจัดป้ายเอกสารเพื่อตรวจภายหลัง อย่านิยามความสำเร็จจากความลื่นไหลของเดโม กำหนดผลลัพธ์ผิดที่คุณจะสังเกตได้ ผลที่อาจหลุดรอด และต้นทุนที่ผู้ใช้ต้องรับจากแต่ละอย่าง
- เขียนสัญญาการตัดสินใจ ระบุผลลัพธ์ทั้งหมด ฟิลด์ต้นทางที่ต้องใช้ และตัวเลือกตรวจทาน แยกการตีความเชิงความหมายออกจากการคำนวณและสิทธิ์อนุญาต
- สร้างชุดประเมิน ใช้ข้อมูลที่ได้รับอนุญาตให้ประมวลผล ใส่รายการทั่วไป ขอบเขตกำกวม ภาษาปะปน ฟิลด์ว่าง และคำสั่งมุ่งร้ายในข้อความต้นทาง
- กันชุดข้อมูลไว้ทดสอบ ปรับเกณฑ์ด้วยชุดหนึ่ง แล้ววัดกับข้อมูลที่ไม่ได้ใช้กำหนดถ้อยคำ บันทึกความเห็นต่างแทนการแอบเปลี่ยนคำตอบที่คาดหวัง
- วัดเวิร์กโฟลว์ ติดตามข้อผิดพลาดรายหมวด อัตราการตรวจทาน เวลาแฝงตั้งแต่ต้นจนจบ การลองซ้ำ และต้นทุนรวม คำเรียกโมเดลที่เร็วภายในวงจรดึงข้อมูลที่ช้าก็ยังเป็นผลิตภัณฑ์ที่ช้า
- ทำงานในโหมดข้อเสนอแนะ บันทึกตัวเลือก ความน่าจะเป็นที่เกี่ยวข้อง รุ่นโมเดล และการแก้ไขโดยมนุษย์ โดยไม่ดำเนินการสำคัญโดยอัตโนมัติ
- เพิ่มการกระทำที่มีขอบเขตหนึ่งอย่าง ขออนุมัติชัดเจนเมื่อจำเป็น เก็บบันทึกตรวจสอบ และมีทางย้อนกลับเมื่อแหล่งข้อมูลหรือรุ่นโมเดลเปลี่ยน
ขั้นตอนนี้ตั้งใจให้เข้มงวดกว่าการดูวิดีโอ เพราะถามว่าโมเดลช่วยกับการกระจายกรณีจริงของคุณ รวมถึงกรณียุ่งยากหรือไม่ อัตราตรวจทานที่ดูสูงอาจดีกว่าความผิดพลาดราคาแพงเพียงไม่กี่ครั้งที่ไม่ถูกสังเกต ตัดสินใจเรื่องความสมดุลก่อนเลือก threshold ไม่ใช่หลังเกิดเหตุ
ตรึงรุ่นเพื่อให้ประเมินซ้ำได้ และบันทึกรุ่นที่ส่งกลับมากับแต่ละผลลัพธ์ alias ที่เปลี่ยนตามเวลาเหมาะกับการสำรวจ แต่พฤติกรรมอาจเปลี่ยนโดยไม่ต้องแก้โค้ดแอป เอกสารประเมินควรช่วยให้ผู้อื่นสร้างเกณฑ์ อินพุต ผลลัพธ์ที่คาดหวัง และขอบเขตการทำงานขึ้นใหม่ได้ นั่นทำให้การทดลองที่น่าสนใจกลายเป็นฟีเจอร์ที่ดูแลต่อได้ ไม่ใช่แค่คลิปน่าประทับใจ
สรุป: ย้ายการตัดสินใจเข้าสู่สัญญาที่มีขอบเขต
Jev น่าสนใจที่สุดเมื่อช่วยตัดสินใจเรื่องเล็ก ๆ ที่ตรวจสอบได้ ภายในโปรแกรมที่รู้กฎอยู่แล้ว วิดีโอเบราว์เซอร์แสดงระบบประกอบที่ทำงานได้ โพสต์อีเมลให้ตัวอย่างการทดลองที่ควรทดสอบ และเดโมทางการเผยให้เห็นวงจร คำถามต่อไปไม่ใช่โมเดลเลือกคำตอบได้หรือไม่ แต่ระบบของคุณรู้จักการเลือกที่ผิดก่อนเกิดผลกระทบหรือไม่
แหล่งข้อมูลและเครดิตสื่อ
- TypeSafe: Introducing System One Models and Jev, 15 กันยายน 2026; บริบทเปิดตัวทางการและวิดีโอเกม
- Browser Use: jev-ultrafast, ตรวจซอร์สที่ตรึงไว้เมื่อ 30 กันยายน 2026 GIF และ MP4 ลิขสิทธิ์ 2026 Browser Use, ใบอนุญาต MIT; ไม่ได้สื่อถึงความสัมพันธ์เป็นพันธมิตร
- Browser Use: บันทึกและการวัดรอบทดสอบที่จับคู่กัน, ตรวจเมื่อ 30 กันยายน 2026; เป็นการวัดของผู้เขียน ไม่ใช่การทำซ้ำของเรา
- vogel บน X: การทดลองจัดประเภทอีเมล 1,500 ฉบับ, 16 กันยายน 2026; กรณีใช้งานที่รายงานเองพร้อมวิดีโอต้นฉบับ
- องค์ประกอบพื้นฐาน, โมเดล, ความเชื่อมั่น, fan-out และ เดโมบ้านอัจฉริยะ ของ TypeSafe ตรวจเมื่อ 30 กันยายน 2026
- ความไม่สม่ำเสมอของ Jev 1.13, ตรวจทานครั้งล่าสุด 17 กันยายน 2026; ตรวจเมื่อ 30 กันยายน
- บทความกรณีใช้งาน Jev บน Tistory, 18 กันยายน 2026; จุดเริ่มต้นการค้นคว้า ไม่ใช่การยืนยันการติดตั้งใช้งาน
เก็บหลักฐานไว้ข้างโน้ต
เมื่อค้นคว้าโมเดลใหม่ ให้เก็บแหล่งที่มา วันที่ และสิ่งที่เดโมพิสูจน์ได้จริงไว้ด้วย สร้างบัญชี Telli.sh เพื่อจัดระเบียบข้อมูลค้นคว้าและโน้ตที่สร้างต่อยอด โดยไม่สับสนระหว่างบทสรุปกับหลักฐานต้นฉบับ