Jev memilih, bukan berbual: tiga demo dan batasan di baliknya
Apa yang sebenarnya dilakukan Jev dari TypeSafe, dengan GIF Browser Use dan demo yang boleh dimainkan, kes X tentang 1,500 e-mel, serta demo permainan rasmi. Ketahui bila keputusan bertip membantu, bila ia gagal dan cara menilai aliran kerja sebenar.
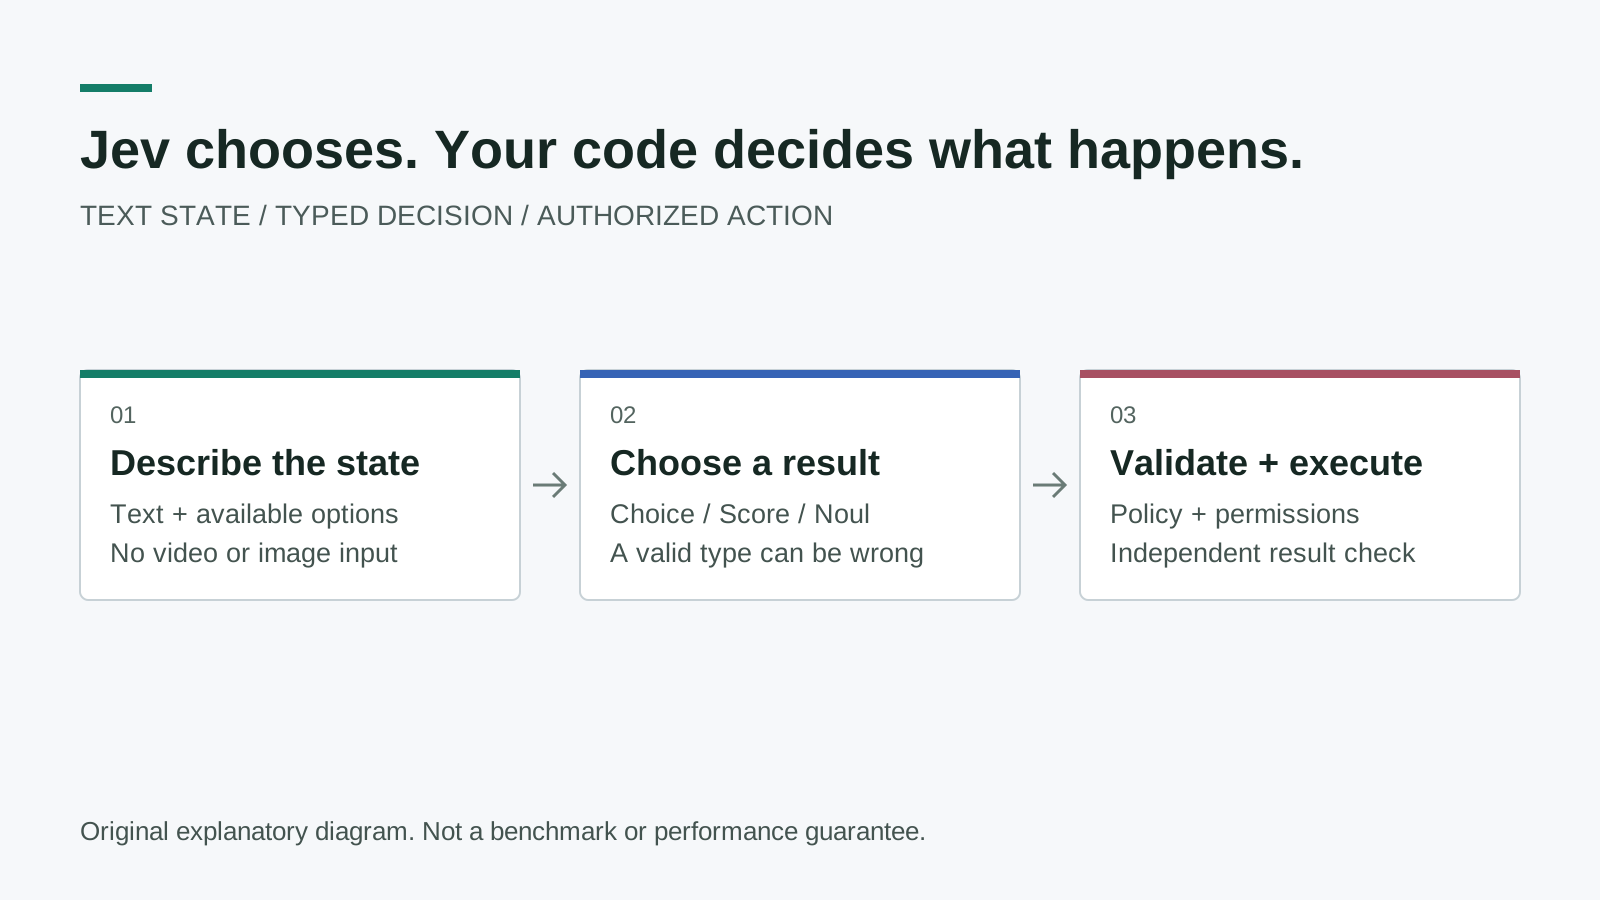
Diagram penjelasan orisinal, bukan penanda aras vendor. Model memilih dalam ruang yang ditentukan; kode aplikasi tetap bertanggungjawab atas izin, validasi, dan pelaksanaan.
Pengelas kotak masuk tidak perlu menulis esai sebelum memilih folder. Pengendali browser sering kali hanya perlu memilih satu tombol yang tersedia, bukan mencipta perintah baru. Keputusan kecil seperti inilah yang membuat Jev, model System One pertama dari TypeSafe AI, mengemukakan hujah paling menarik untuk dirinya.
TypeSafe memperkenalkan Jev pada 15 September 2026. Perbezaan yang berguna bukan sekadar bahawa ia model lain yang pantas: model ini mengembalikan keputusan terkekang, bukannya prosa terbuka. Hal itu mengubah cara anda dapat membina program di sekelilingnya, tetapi tidak menghilangkan kemungkinan jawapan yang dipilih salah. Lihat pelancaran rasmi untuk pembingkaian daripada vendornya.
Panduan ini menelusuri tiga demonstrasi awam: tugas browser dengan bukti GIF dan video yang boleh dimuat turun, laporan seorang penulis tentang pengelasan 1,500 e-mel, dan demo permainan TypeSafe. Kami juga mengolah contoh tersebut menjadi rancangan penilaian yang konkrit. Artikel kes penggunaan di Tistory, diterbitkan pada 18 September, menjadi titik mula penyelidikan; aplikasi yang dicadangkan di sana tidak dianggap sebagai penggunaan pelanggan yang disahkan secara bebas.
Ringkasnya:
- Jev boleh memilih, memberikan skor atau menilai proposisi daripada teks; ia bukan pengganti model yang menulis teks sewenang-wenangnya.
- Hasil bertip yang sah masih boleh salah dari segi makna. Kekalkan pengesahan dan kebenaran akhir dalam kod.
- Rakaman browser itu benar, tetapi satu tugas bukan penanda aras umum. Contoh e-mel ialah laporan penulis, bukan kajian ketepatan yang diterbitkan.
- Mulakan dengan pengelasan yang boleh dibalikkan, ukur ralat pada data anda sendiri dan sokong pilihan untuk tidak membuat keputusan.
Jawapan ringkas memerlukan soalan yang sangat jelas
Tiga primitif teras API ialah Choice, Score dan Noul. Choice memilih daripada alternatif yang dinamakan. Score menilai aras berurutan yang diterangkan. Noul mengembalikan kebarangkalian bagi proposisi ya-atau-tidak; nilai yang hampir di tengah menunjukkan ketidakpastian tentang proposisi itu, bukannya aras keterukan sederhana. Dokumentasi primitif mentakrifkan kontrak ini.
Perubahan praktikalnya ialah menentukan hasil yang mungkin sebelum meminta model membuat keputusan. Daripada meminta perenggan tentang mesej sokongan yang masuk, anda boleh bertanya sama ada ia berkaitan pengebilan, akses akaun, kecacatan produk atau kategori yang belum dapat dipastikan. Aplikasi anda kemudian menentukan baris gilir yang patut dipaparkan. Hasilnya ibarat suis pada landasan kereta api, bukannya seluruh kereta api: ia membantu mengarahkan kerja tetapi tidak menyediakan setiap keupayaan yang diperlukan untuk menyiapkannya.
| Primitif | Soalan yang berguna | Tanggungjawab aplikasi |
|---|---|---|
| Choice | Baris gilir yang manakah antara ini paling sepadan dengan mesej tersebut? | Tentukan set pilihan yang lengkap, termasuk laluan semakan |
| Score | Sejauh manakah mesej ini sepadan dengan aras keterdesakan yang diterangkan? | Tentukan aras dan uji sama ada penilai bersetuju |
| Noul | Adakah mesej ini secara jelas meminta pembatalan? | Tentukan kebarangkalian yang mewajarkan semakan atau tindakan boleh balik |
Menulis alternatif yang baik ialah sebahagian daripada kerja kejuruteraan. Jika dua label bertindih, pilihan yang kelihatan yakin boleh menyembunyikan masalah dalam taksonomi anda. Jika tiada label yang sesuai, memaksa pilihan menyamarkan kekurangan liputan sebagai kepastian. Pilihan untuk semakan selalunya lebih bernilai daripada satu lagi kategori sempit kerana ia menunjukkan bahagian kontrak keputusan yang perlu diperbaik.
Setakat semakan pada 30 September 2026, rujukan model menyenaraikan jev-1.13.0, input teks sahaja dan harga $0.042 bagi setiap sejuta token input, manakala token output percuma. Itulah harga token model, bukannya jumlah kos menjalankan agen. Browser, pengekstrakan, model pembantu, percubaan semula dan semakan manusia juga perlu dimasukkan dalam belanjawan operasi.
GIF browser menunjukkan carian sebenar, bukan tempahan penerbangan
Repositori awam jev-ultrafast oleh Browser Use menyertakan tugas Google Flights yang dirakam dari Zurich ke London. Jev memilih operasi dan sasaran daripada perwakilan halaman semasa. Pembantu generatif yang berasingan membekalkan teks apabila operasi terpilih memerlukan input. Ini sistem gabungan, bukannya bukti bahawa Jev sendiri menjana setiap rentetan atau mentafsir bingkai video.
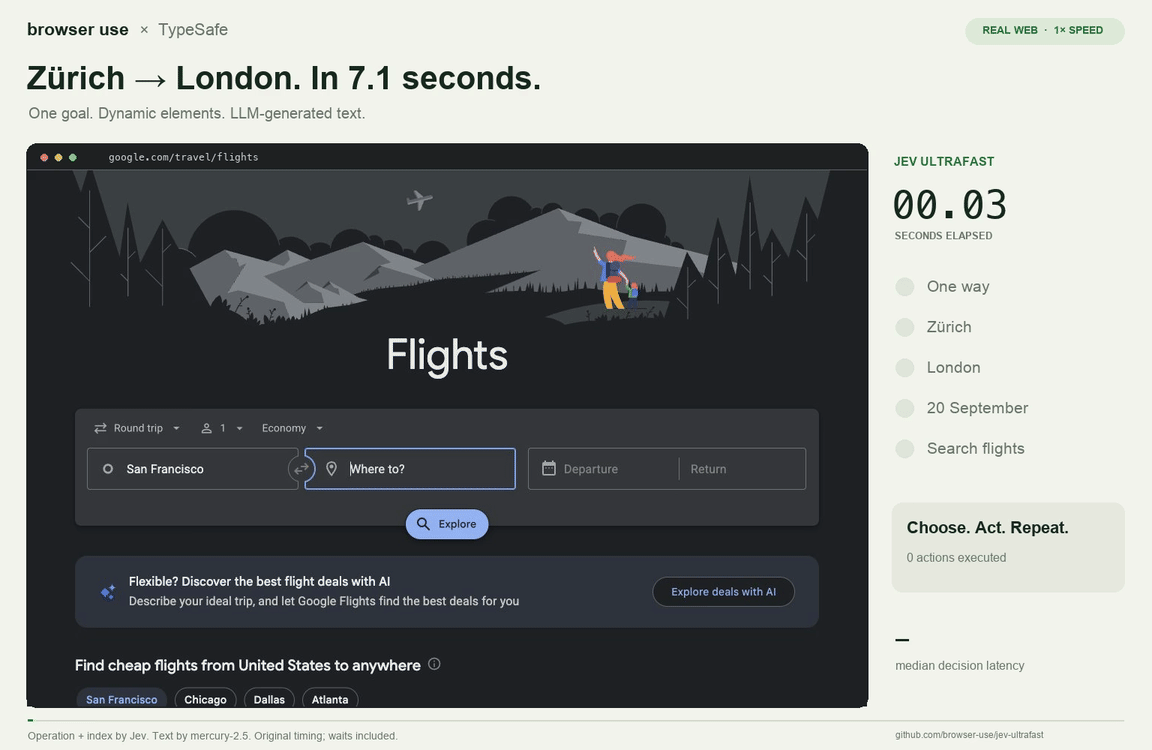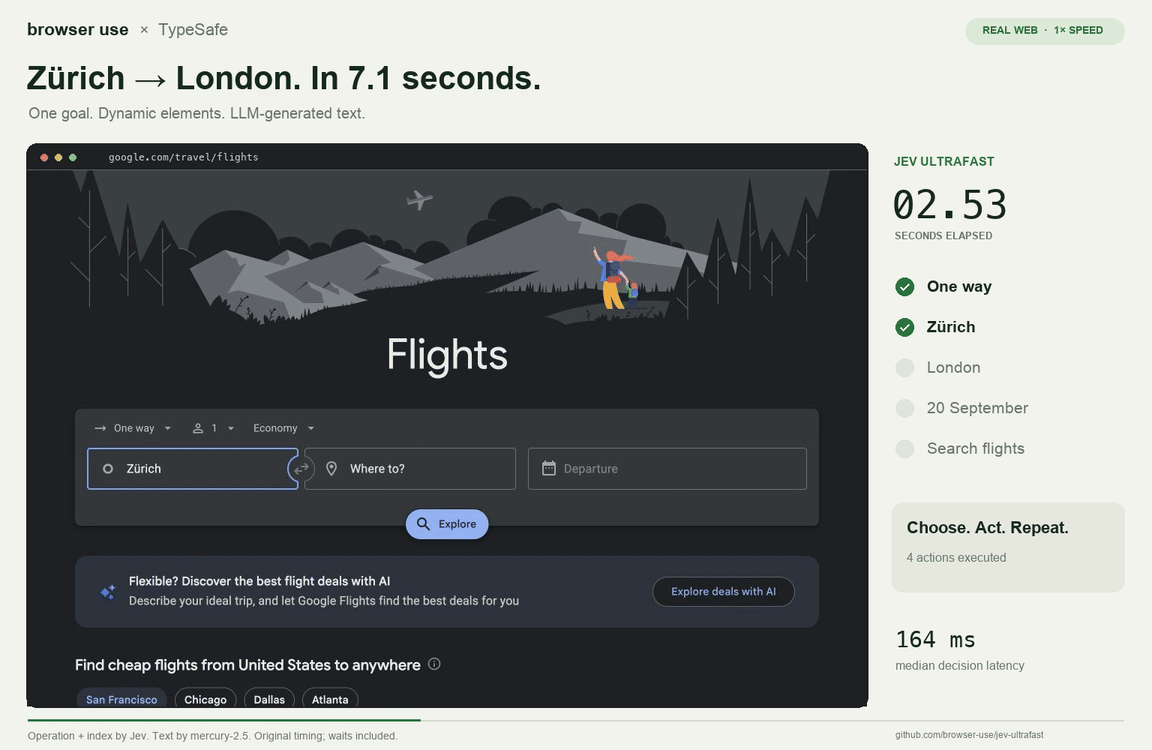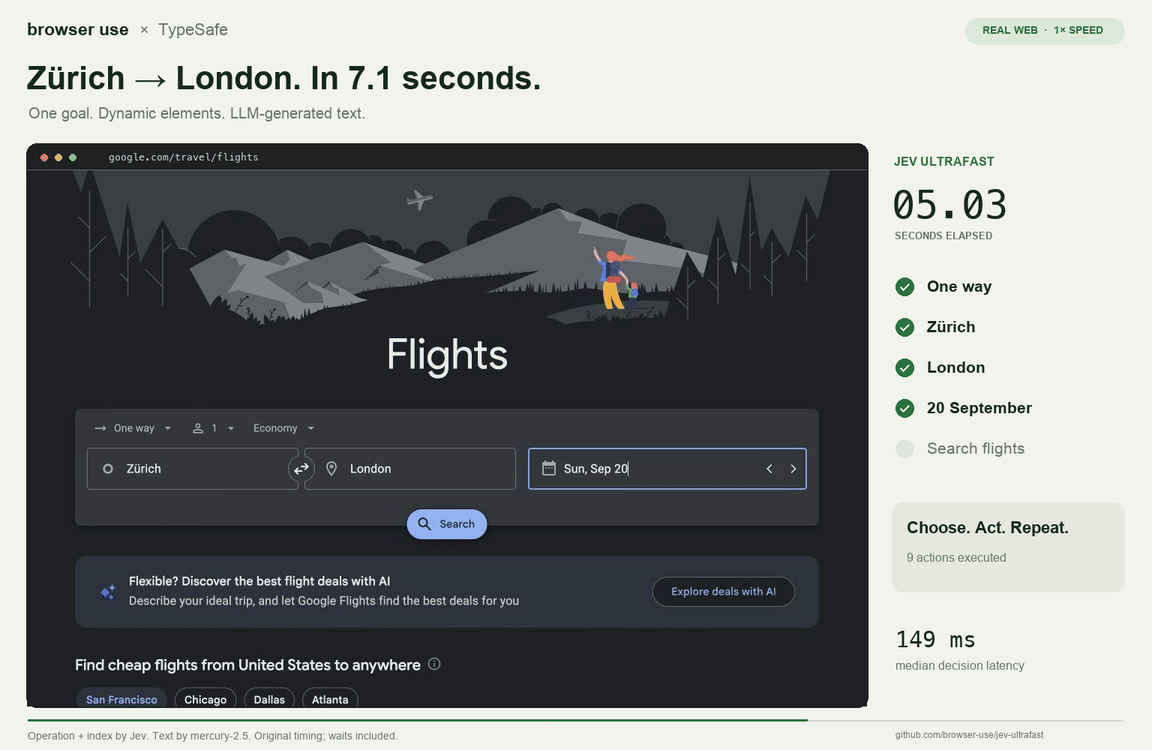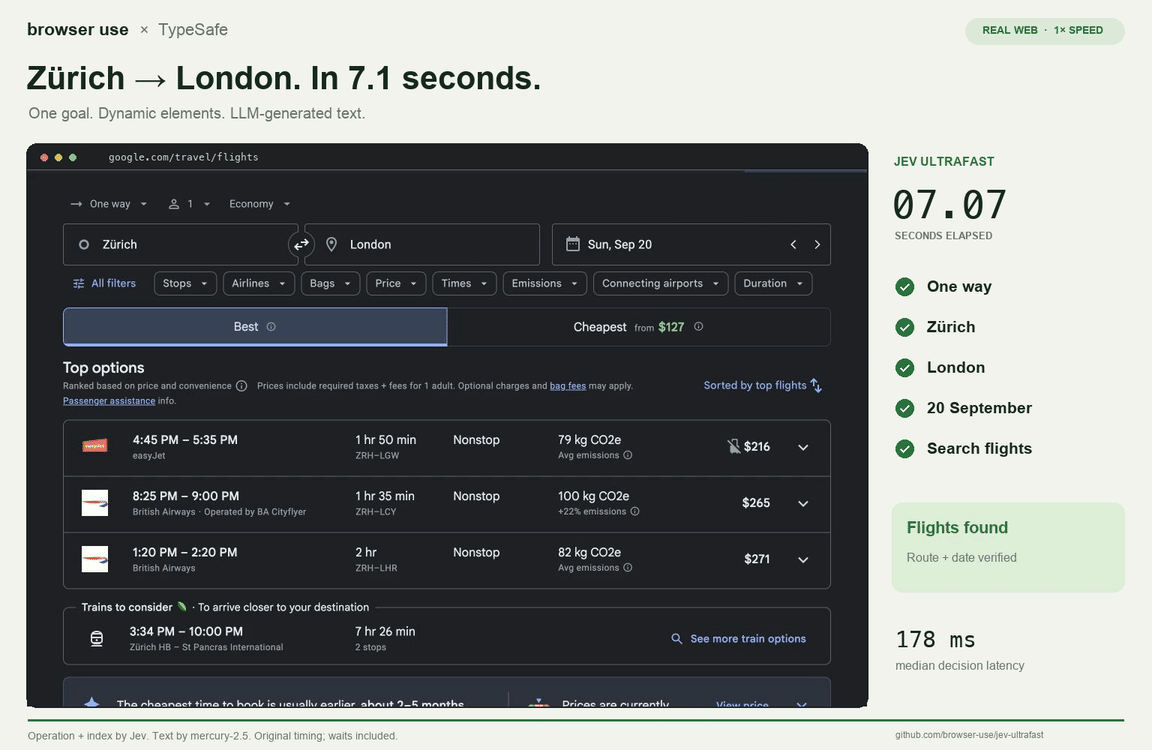
GIF sebenar yang dirakam pengarang Browser Use, dipatok pada komit 1231850a0bf1a0c0341fe408ef1668dbbfdfac46. Hak cipta 2026 Browser Use, lesen MIT. Ia menunjukkan aliran carian, bukan pembelian. Rakaman yang sama boleh dimainkan di bawah.
MP4 pengarang, dipaparkan pada kelajuan rakaman dengan kawalan browser. Rakaman asal dan nota pengukuran; lesen MIT yang dikekalkan. Kami memeriksa artifak awam; kami tidak menjalankan semula penanda aras ini.
Masa penyelesaian yang diukur pengarang untuk rakaman itu ialah 7.073 saat. Jam bermula pada ramalan pertama selepas pemerhatian halaman utama awal, bukannya ketika browser baharu dilancarkan. Persediaan, navigasi awal dan pengesahan bebas baharu selepas tugas tidak termasuk dalam sela masa yang diukur. Hasil carian disemak; tiada tiket dipilih atau dibeli. Batasan ini penting untuk memahami maksud angka tersebut.
Laporan yang sama membandingkan enam larian berselang-seli, tiga bagi setiap runtime. Median masa tugas berubah daripada 9.450 saat kepada 7.092 saat, manakala median panggilan protokol browser menurun daripada 1,092 kepada 101. Kedua-dua kumpulan menggunakan Jev dan pembantu teks yang sama, jadi ini terutamanya perbandingan runtime, bukannya pertandingan antara dua keluarga model. Pengarang menyatakan dengan jelas sampel kecil dan variasi web langsung dalam laporan prestasi.
Pada pandangan kami, gelung browser di sekelilingnya wajar diberi perhatian setara dengan model. Mengumpulkan halaman berulang kali, menyelesaikan sasaran dan membatalkan keputusan boleh menelan kos lebih besar daripada yang disangka berdasarkan mudahnya satu klik. Enjin keputusan yang lebih pantas tidak dapat mengimbangi penerangan butang yang tidak boleh dipercayai. Repositori itu mengekalkan pengesahan hasil yang berasingan kerana model yang mengatakan tugasnya selesai bukan bukti bahawa ia benar-benar selesai.
Di sinilah batasan demo menjadi berguna. Pelaksanaan yang didokumenkan tidak meliputi setiap bingkai, kanvas, aliran muat naik atau widget papan kekunci arbitrari. Pasukan yang menilainya patut menghasilkan semula tugas dan laluan kegagalannya sendiri yang mewakili, bukannya membuat kesimpulan bahawa carian penerbangan yang berjaya membuktikan kecekapan browser umum. Anggap rakaman itu sebagai bukti yang boleh diperiksa bagi satu gubahan yang berfungsi.
Catatan tentang 1,500 e-mel menjanjikan, tetapi penyebutnya tiada
Pada 16 September 2026, vogel (@ryanvogel) menyiarkan di X bahawa beliau telah mencuba Jev pada 1,500 e-melnya sendiri dan kagum dengan hasil pengelasan. Catatan asal itu menyertakan video. Ini contoh pengguna sebenar yang berguna kerana bebannya konkrit dan sumbernya ialah orang yang melaporkan eksperimen tersebut, bukannya senarai aplikasi hipotetikal tanpa atribusi.
Namun, ini bukan laporan ketepatan. Catatan itu tidak membuktikan adanya set ujian berlabel awam, kadar ralat yang diukur, persetujuan antara penilai atau kos kesilapan. Bilangan mesej yang diproses memberitahu skala eksperimen, bukan ketepatannya. Pembaca patut menonton demonstrasi X asal dengan memahami perbezaan ini; videonya dipautkan dan tidak disalin tanpa lesen pengedaran semula.
Walau bagaimanapun, pengelasan e-mel ialah tempat yang munasabah untuk memulakan penilaian kerana prosesnya boleh dibuat berbalik. Paparkan label yang dicadangkan di sebelah peti masuk sedia ada, biarkan mesej asal tidak disentuh dan rekodkan pembetulan. Bandingkan pasangan yang mengelirukan seperti invois dengan peringatan pembayaran, atau permintaan pembatalan dengan aduan yang sekadar menyebut pembatalan. Kes-kes ini menunjukkan sama ada kategori tersebut sepadan dengan aliran kerja sebenar anda.
Penggunaan awal tidak sepatutnya memadam e-mel secara automatik, menghantar balasan atau meluluskan transaksi hanya kerana pengelasan kelihatan yakin. Tindakan itu membawa kebenaran dan akibat yang berbeza. Mulakan dengan cadangan atau baris gilir semakan; hanya naik taraf kepada tindakan sempit selepas corak ralatnya diukur. Ini prosedur penilaian yang kami cadangkan, bukannya dakwaan tentang pelaksanaan pengarang X.
Doom dan Wikiracing memperlihatkan gelung keputusan
Pelancaran TypeSafe merangkumi demonstrasi Doom dan demonstrasi Wikiracing, kedua-duanya dipautkan daripada artikel pelancaran rasmi. Kedua-duanya menerangkan keputusan berulang secara visual. Namun, ia bukan bukti bahawa Jev ialah model visual serba guna atau boleh menyelesaikan masalah perancangan sewenang-wenangnya.
Dalam contoh Doom, model menerima penerangan keadaan berstruktur dalam bentuk teks, bukannya tangkap layar. Dalam Wikiracing, model memilih daripada pautan yang tersedia dan bukannya mencipta URL destinasi. Mekanisme menariknya ialah kitaran pemerhatian, pilihan terbatas dan tindakan yang berulang. Demo permainan menjadikan kitaran itu mudah dilihat, tetapi persoalan tentang sejauh mana ia berpindah ke persekitaran lain masih terbuka.
Pemisahan yang sama kelihatan dalam dokumentasi demo rumah pintar TypeSafe. Soalan berbeza boleh mengelaskan aspek permintaan, manakala komponen lain mengendalikan perbualan bebas atau memecahkan permintaan majmuk. Jangan gambarkan seni bina itu sebagai satu model yang menjana bahasa dan melaksanakan setiap keputusan. Nama seperti pembantu atau agen sering menyembunyikan batasan tersebut melainkan pelaksanaannya menjelaskannya.
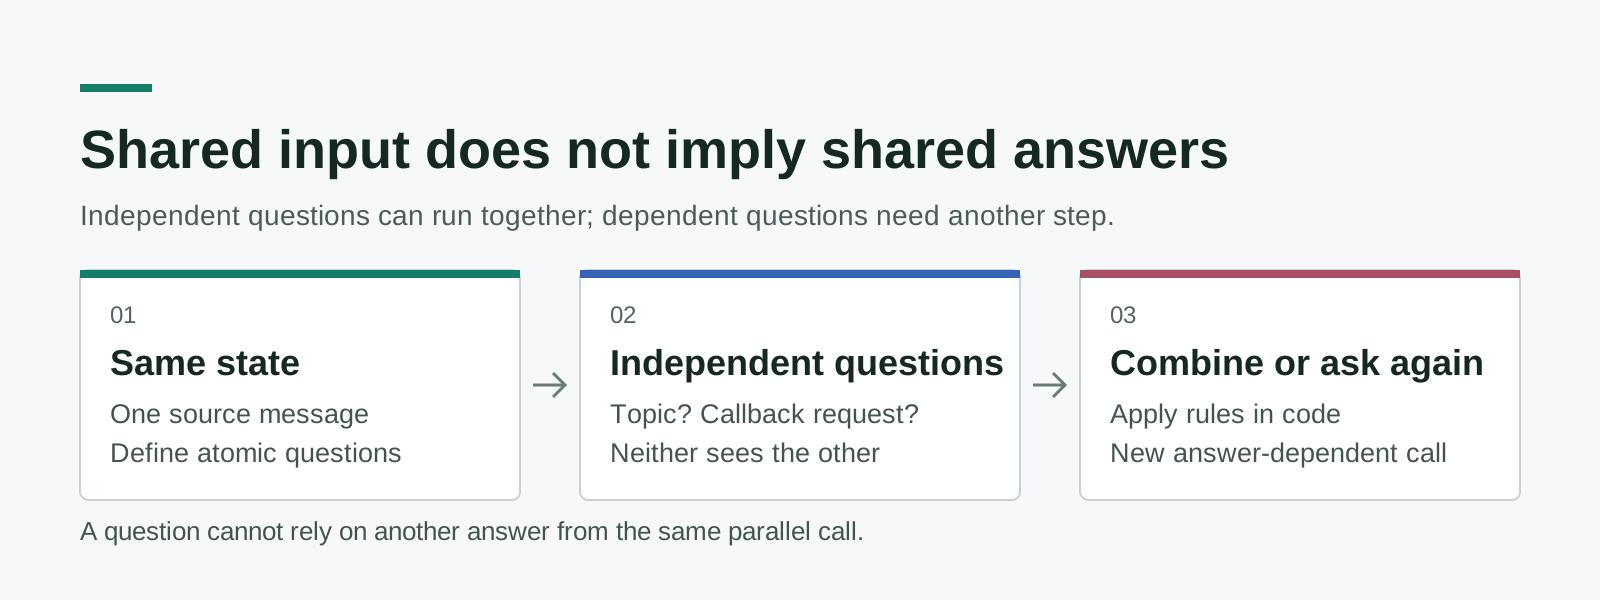
Rajah asal berdasarkan kontrak fan-out yang didokumenkan. Soalan serentak berkongsi keadaan; setiap soalan tidak membaca jawapan soalan lain secara rahsia.
Corak fan-out boleh mengurangkan masa menunggu bersiri apabila beberapa soalan bergantung pada sumber yang sama. Contohnya, topik mesej dan sama ada mesej itu secara jelas meminta panggilan balik boleh dinilai secara bebas. Soalan yang bergantung pada topik yang baru dipilih tidak boleh mengandaikan jawapan itu sudah wujud dalam panggilan yang sama. Pisahkan kebergantungan itu menjadi langkah kemudian atau gabungkan hasil bebas secara deterministik dalam kod.
Jawapan bertip tidak sama dengan jawapan yang betul
Tafsiran paling berbahaya tentang model terkekang ialah jawapan yang berformat baik tidak mungkin salah. Ia masih boleh salah. Pengelas boleh memilih label yang dibenarkan tetapi tidak sesuai, dan pemilih tindakan boleh memilih butang sah pada borang yang salah. Menghapuskan prosa cacat daripada antara muka memang berguna, tetapi itu menangani kelas kegagalan yang berbeza daripada salah memahami tugas.
Nota ketidakteraturan Jev 1.13 TypeSafe, kali terakhir disemak pada 17 September, menghuraikan kelemahan berkaitan aritmetik, pengiraan, perbandingan tarikh, konteks yang mengganggu dan input adversarial. Untuk perbandingan tepat, huraikan tarikh dan kira kuantiti dengan kod biasa. Jangan jadikan peraturan deterministik sebagai pertimbangan semantik semata-mata kerana model boleh menerima soalannya.
Dokumentasi keyakinan juga penting: Choice dan Score mendedahkan taburan kebarangkalian serta nilai keyakinan terbitan; Noul tidak mempunyai medan keyakinan berasingan. Angka itu bukan kebarangkalian universal bahawa jawapannya betul. Ambang perlu disahkan terhadap tugas anda sendiri, khususnya apabila akibat positif palsu berbeza daripada negatif palsu.
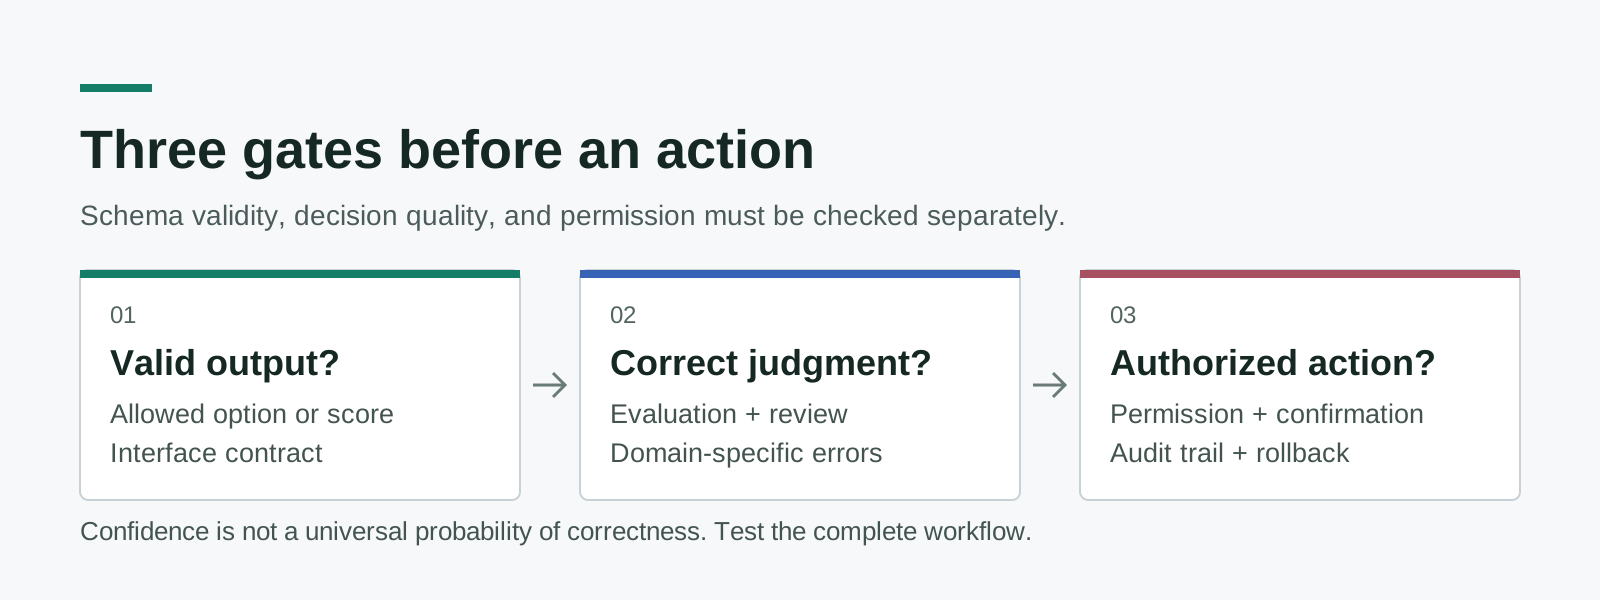
Rajah penilaian asal. Melepasi satu pintu tidak bermakna pintu seterusnya turut dilepasi; output yang dibenarkan masih memerlukan tafsiran yang betul dan tindakan yang dibenarkan.
Bagi kerja berbilang bahasa, uji setiap bahasa yang benar-benar anda kendalikan. Dokumentasi model menyatakan bahasa Inggeris ialah bahasa latihan utama dan kualitinya tidak seragam dalam bahasa lain, termasuk aksara CJK. Oleh itu, baris gilir sokongan Korea atau arkib surat berita pelbagai bahasa patut menjadi segmen penilaian tersendiri, bukan sambungan yang dianggap setara dengan skor Inggeris. Terjemahan juga boleh mengubah bukti, maka kekalkan teks asal jika menilai perwakilan yang diterjemahkan.
Bina percubaan yang boleh gagal dengan jujur
Rintis yang berguna bermula dengan keputusan yang boleh dilabel secara konsisten oleh pasukan anda. Pilih tugas boleh balik seperti mencadangkan baris gilir sokongan, menandakan kemungkinan pendua atau melabel dokumen untuk semakan kemudian. Jangan takrifkan kejayaan berdasarkan kelancaran demo. Takrifkan hasil salah yang akan anda kesan, yang mungkin terlepas dan kos setiap satunya kepada pengguna.
- Tulis kontrak keputusan. Senaraikan hasil yang mungkin, medan sumber yang diperlukan dan pilihan semakan. Asingkan tafsiran semantik daripada pengiraan dan kebenaran.
- Bina set penilaian. Gunakan bahan yang anda diberi kuasa untuk proses. Sertakan item biasa, sempadan samar, bahasa bercampur, medan kosong dan arahan berniat jahat dalam teks sumber.
- Simpan sebahagian data sebagai set pegangan. Laraskan kriteria pada satu set, kemudian ukur menggunakan bahan yang tidak mempengaruhi penetapan kriteria. Rekodkan perselisihan dan bukannya mentakrif semula jawapan jangkaan secara senyap.
- Ukur aliran kerja. Jejaki ralat mengikut kategori, kadar semakan, kependaman hujung ke hujung, percubaan semula dan jumlah kos. Panggilan model yang pantas dalam gelung pengambilan data yang perlahan tetap menghasilkan produk perlahan.
- Jalankan dalam mod cadangan. Log pilihan, kebarangkalian berkaitan, versi model dan pembetulan manusia tanpa melaksanakan tindakan berakibat secara automatik.
- Naik taraf satu tindakan terbatas. Minta kebenaran jelas apabila sesuai, kekalkan jejak audit dan sediakan laluan undur apabila sumber atau versi model berubah.
Prosedur ini sengaja lebih ketat daripada menonton rakaman. Ia bertanya sama ada model membantu dengan taburan kes anda, termasuk kes yang janggal. Kadar semakan yang kelihatan tinggi mungkin lebih baik daripada sebilangan kecil kesilapan senyap yang mahal. Tentukan imbangan itu sebelum memilih ambang, bukannya selepas insiden berlaku.
Patok versi untuk penilaian yang boleh diulang dan rekodkan versi yang dikembalikan bersama setiap hasil. Alias bergerak memudahkan penerokaan tetapi boleh mengubah tingkah laku tanpa perubahan kod sumber dalam aplikasi. Artifak penilaian sepatutnya membolehkan orang lain membina semula kriteria, input, hasil jangkaan dan sempadan pelaksanaan. Begitulah eksperimen yang menjanjikan menjadi ciri yang boleh diselenggara, bukannya himpunan klip yang mengagumkan.
Kesimpulannya: letakkan pertimbangan dalam kontrak yang terbatas
Jev paling menarik apabila membuat keputusan kecil yang boleh diperiksa dalam program yang sudah mengetahui peraturannya. Video browser menunjukkan gubahan yang berfungsi, catatan e-mel memberikan eksperimen konkrit yang wajar diuji, dan demo rasmi mendedahkan gelungnya. Soalan seterusnya bukan sama ada model boleh memilih jawapan, tetapi sama ada sistem anda dapat mengenali pilihan yang buruk sebelum pilihan itu membawa akibat.
Sumber dan kredit media
- TypeSafe: Memperkenalkan Model System One dan Jev, 15 September 2026; konteks pelancaran rasmi dan video permainan.
- Browser Use: jev-ultrafast, sumber berpaksikan komit yang diperiksa pada 30 September 2026. GIF dan MP4 hak cipta 2026 Browser Use, lesen MIT; tiada perkaitan yang tersirat.
- Browser Use: ukuran rakaman dan larian sepadan, diperiksa 30 September 2026; ukuran pengarang, bukan penghasilan semula oleh kami.
- vogel di X: eksperimen pengelasan 1,500 e-mel, 16 September 2026; kes penggunaan laporan sendiri dengan video asal.
- Primitif TypeSafe, model, keyakinan, fan-out dan demo rumah pintar, disemak 30 September 2026.
- Ketidakteraturan Jev 1.13, kali terakhir disemak 17 September 2026; disemak 30 September.
- Artikel kes penggunaan Jev di Tistory, 18 September 2026; titik mula penyelidikan, bukan pengesahan penggunaan.
Simpan bukti bersama nota anda
Apabila menyelidik model baharu, kekalkan sumber, tarikhnya dan perkara sebenar yang dibuktikan oleh demonstrasi. Cipta akaun Telli.sh untuk mengatur bahan penyelidikan dan nota terbitan anda tanpa mengelirukan ringkasan dengan bukti asal.