Можно ли поставить ноутбук с GPU на паузу и продолжить тот же эксперимент?
GKE Workspaces разворачивается в собственном кластере и сочетает постоянные файлы, возобновляемые сеансы с ускорителями и IDE в браузере. У каждого уровня свои затраты.
Шесть вечера. Ноутбук наконец загрузил модель и выдал результаты, которые стоит изучить. Если остановить сеанс, завтра можно потратить часть дня на восстановление окружения и повторную загрузку модели. Если оставить его включённым, дефицитный ускоритель может простаивать всю ночь.
4 ноября Google объявила о GKE Workspaces. Открытая среда разработки работает в кластере Google Kubernetes Engine команды. Из браузерной панели можно запустить JupyterLab или VS Code с настроенными ресурсами. Проект построен на Kubeflow Workspaces и описывает приостановку и возобновление поддерживаемых сеансов. Команде нужно определить, какое состояние понадобится завтра и какие ресурсы должны оставаться выделенными для его сохранения.
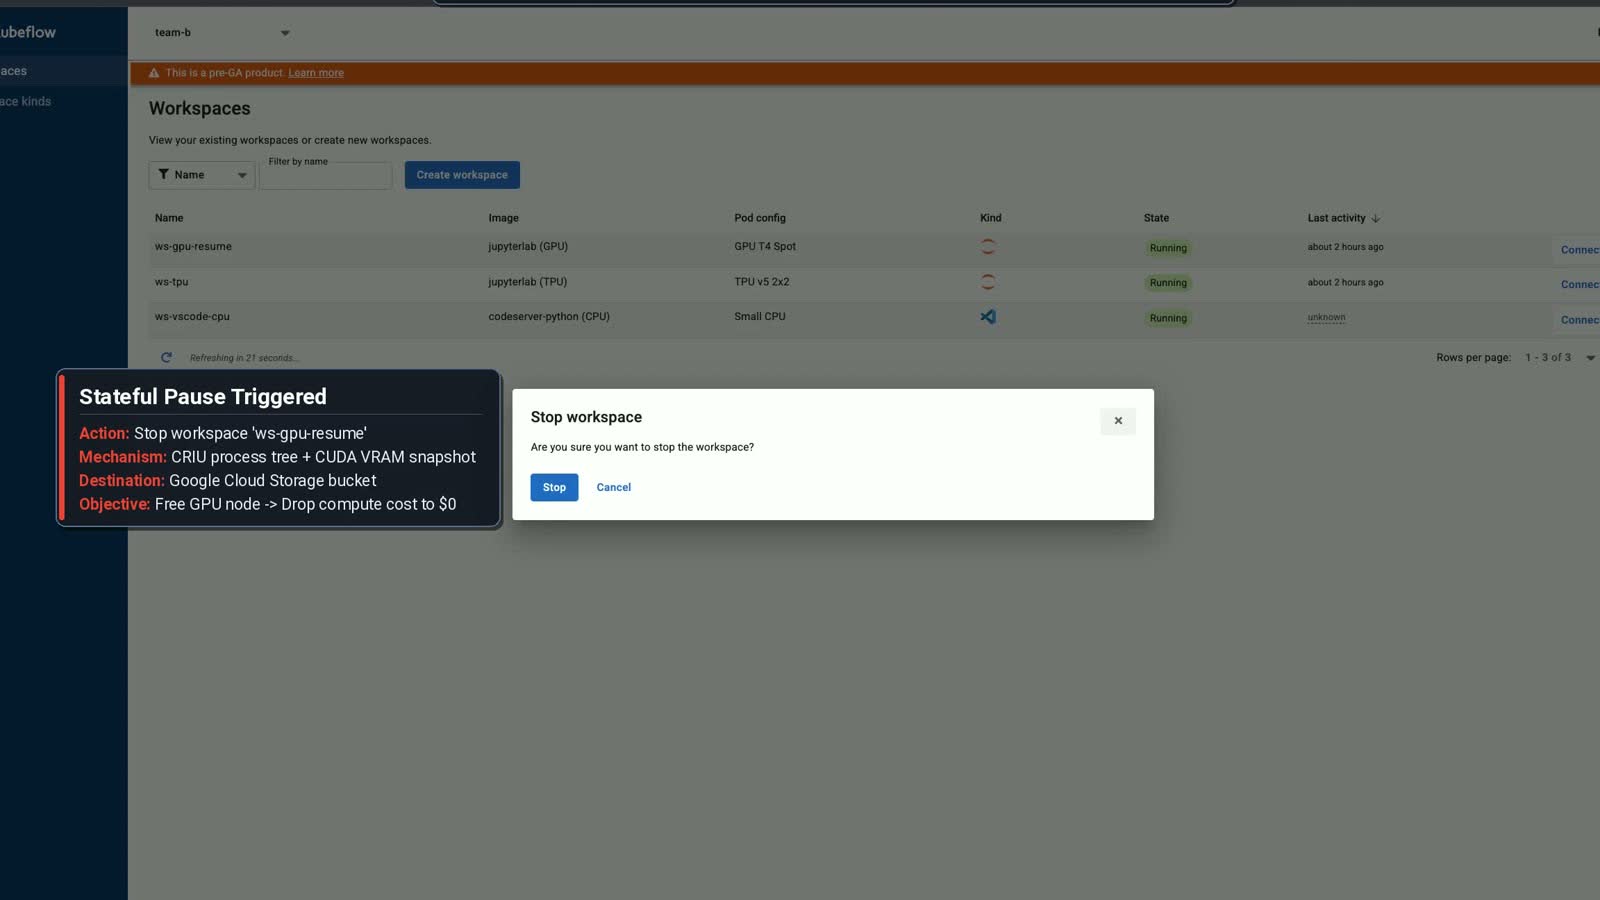
Кадр из демонстрации возобновляемых ноутбуков GKE Workspaces, обрезан, Apache 2.0. Источник изображения · Лицензия.
Файл ноутбука и активный сеанс сохраняют разные вещи
Пауза ноутбука с GPU. Оригинальная иллюстрация Telli.sh.
При сохранении ноутбука остаются написанные ячейки и сохранённые результаты. Диск может сохранить наборы данных и контрольные точки для нового процесса. Ни то ни другое автоматически не захватывает всё содержимое активного сеанса. В эксперименте могут быть инициализированные переменные, загруженная на ускоритель модель и промежуточное состояние, которое пришлось бы восстанавливать вручную.
Google описывает, как с помощью GKE Pod Snapshots сохранять поддерживаемое состояние работающей среды и освобождать вычислительные ресурсы. Файлы рабочей среды остаются на постоянном хранилище. Для возобновления нужны и снимок, и совместимые ресурсы. Поэтому пауза ближе к продолжению эксперимента, чем к открытию сохранённого файла, с практическими ограничениями со стороны окружения.
| Уровень | Пример | Вопрос при планировании |
|---|---|---|
| Постоянные файлы | Ноутбук, кэшированные веса, результаты и зависимости | Сохранятся ли они после запуска с нуля? |
| Контрольная точка приложения | Снимок обучения или сохранённое состояние запуска | Можно ли продолжить задачу без старого процесса? |
| Снимок рабочей среды | Активный процесс или поддерживаемое состояние ускорителя | Поддерживают ли оборудование и окружение восстановление? |
| Ресурсы кластера | Узел, квота ускорителя или резервирование | Высвободятся ли ресурсы и будут ли они доступны позднее? |
Воспроизводимость и удобство улучшают разные части процесса. Снимок помогает быстро вернуться к сеансу. Воспроизводимый ноутбук и контрольная точка приложения помогают другому человеку повторить работу или перенести её в новую среду. Для важного эксперимента сохраняйте и то и другое.
Исследовательская группа может поставить сеанс с GPU на паузу между встречами, при этом зафиксировать код коммитом и сохранить артефакты модели в долговечном хранилище. Если снимок не восстановится, будет понятная альтернатива. Длительное обучение также может записывать контрольные точки по расписанию, даже когда среда, из которой оно запущено, поддерживает паузу.
Приостановленная рабочая среда всё равно имеет стоимость
Учёт реальных затрат. Оригинальная иллюстрация Telli.sh.
Непосредственная выгода — не тратить вычислительные ресурсы, пока никто не работает. Сумма счёта зависит от того, что кластер делает после остановки сеанса. Узел может продолжать работать, потому что его используют другие поды. Резервирование по-прежнему может стоить денег или накладывать обязательства. Постоянные диски и сохранённые снимки остаются частью системы.
Возьмём условный пример. Если исследователь оставляет неиспользуемый ускоритель выделенным на 12 часов после работы, пауза даёт платформе возможность высвободить эти 12 часов. Это возможность вернуть ресурс в пул. Финансовый результат зависит от того, как узел и ускоритель выделяются и тарифицируются. Если узел должен работать для другой задачи, изменение может помочь планированию сильнее, чем уменьшить текущий счёт.
Корректное сравнение учитывает и время. Запись снимка расходует ресурсы, восстановление большого состояния занимает время, а нужный ускоритель не всегда доступен сразу. В загруженном кластере возможность передать устройство другому человеку важна, даже если команда уже обязалась оплачивать весь пул.
Запишите время окончания активной работы, остановки среды и освобождения узла. Затем измерьте, когда вернувшийся пользователь сможет запустить следующую ячейку. По этим отметкам команда платформы поймёт, возвращает ли пауза полезные ресурсы без очереди в начале следующего рабочего дня.
Команда платформы по-прежнему отвечает за рабочую среду
Самообслуживание меняет того, кто нажимает кнопку. Администраторы всё ещё определяют доступные образы, ускорители, квоты и правила изоляции. В репозитории GKE Workspaces указано, что код распространяется по Apache 2.0 и проект не является официально поддерживаемым продуктом Google. При оценке считайте установку и эксплуатацию инженерной ответственностью команды.
Инженеру машинного обучения могут понадобиться знакомая IDE, достаточно памяти и доступ к данным эксперимента. Владелец платформы также думает о системных учётных записях по умолчанию, разрешениях хранилища, остановке нагрузки и обновлении образов. Эти потребности совместимы, если типы среды показывают соответствующие компромиссы. Небольшой ноутбук на CPU и сеанс экспериментов на GPU могут начинаться с разных настроек.
Анонс описывает варианты ускорителей и подключение локальных инструментов или агентов. Посмотрите инструкции для своего кластера и сценария, прежде чем считать эти возможности взаимозаменяемыми. Для восстановления на конкретном оборудовании, доступа между кластерами и связи с локальной разработкой есть отдельные требования. Начните с простого случая, где сотрудник может посмотреть среду и убедиться, в каком кластере она работает.
Проведите одну проверку паузы и восстановления
- Прочитайте руководство по развёртыванию и актуальные требования среды GKE к снимкам и ускорителям. Создайте тестовую среду с разрешениями и лимитами, соответствующими предполагаемому процессу.
- Запустите воспроизводимый ноутбук. Сохраните входные данные, промежуточную контрольную точку приложения и небольшой файл с результатом. Зафиксируйте время и выделенные ресурсы до паузы.
- Поставьте среду на паузу и проверьте ресурсы кластера. Посмотрите, остановился ли под, можно ли снова выделить ускоритель и какое хранилище осталось.
- Возобновите работу. Проверьте ожидаемые файлы и состояние активного процесса. Выполните ячейку, которая использует уже загруженную модель. Измерьте время от запроса на возобновление до готовности ноутбука к работе.
- Попробуйте такое же восстановление из сохранённых файлов и контрольной точки приложения. Это даст альтернативу и ориентир, если восстановление снимка медленное или недоступно.
- Обсудите настройки простоя с командой. Решите, что считать бездействием и нужны ли длительным задачам отдельный тип среды или явные правила обработки.
Проверьте восстановление при исчерпанной квоте или в занятом кластере. Удачная демонстрация в пустом кластере может скрыть сложности с получением ресурсов, когда несколько пользователей возвращаются одновременно. Цель — понять поведение системы при дефиците ресурсов.
Посчитайте, куда уходят часы GPU
Представьте рабочую станцию разработчика, которую используют 40 часов в неделю. Если станция выделена на всю неделю, это 168 часов. Если платформа может освобождать узел GPU после остановки работы и возвращать его только на эти 40 часов, время выделения узла сокращается на 128 часов до учёта накладных расходов на снимок и восстановление. Это пример без предположений о тарифах облака и профиле загрузки. Он показывает верхнюю границу для такой схемы выделения ресурсов, поскольку общий узел может выполнять другую работу в те же часы.
Команда может уточнить сравнение на своём пуле GPU. Для каждого интервала запишите часы работы узла, наличие другой задачи на нём и объём сохранённых данных. Отметьте и время от запроса на возобновление до запуска следующей ячейки. Если узел остаётся из-за второй нагрузки, приостановка ноутбука может дать место для неё, не снижая счёт. Это другой и тоже полезный результат.
Время снимка входит в расчёт. Если пауза длится долго и старый под остаётся выделенным, короткий порог бездействия может давать больше прерываний при небольшой экономии. Если возобновление занимает несколько минут, пока автомасштабирование подбирает совместимый GPU, после короткого перерыва человек может ждать дольше, чем позволяет сэкономить политика. Измеряйте разные периоды простоя, прежде чем считать выгодной каждую паузу.
Выберите, что сохранять, до включения паузы
В репозитории GKE Workspaces описан процесс VS Code без состояния и отдельный пример JupyterLab с состоянием. Второй показывает восстановление ноутбука с GPU, в том числе с моделью Qwen2.5 на 3 млрд параметров на одном T4. Снимки подов Kubernetes и пример имеют конкретные ограничения совместимости. В документации GKE описана роль GKE Sandbox и совместимой конфигурации узла и образа. Прежде чем полагаться на восстановление в примере с GPU, убедитесь, что на новом узле та же поддерживаемая модель GPU и совместимое окружение.
Решите, чего пользователи ждут от кнопки паузы. Одним нужны файлы, результаты и состояние редактора. Другие рассчитывают, что следующая ячейка Python увидит объект в RAM или модель в VRAM. Общий набор данных может находиться во внешнем объектном хранилище и остаться за пределами снимка. Зафиксируйте, какие состояния восстанавливает выбранная среда, где сохраняются обычные файлы и что делать при сбое восстановления.
Полезна и проба с отказом перед возобновлением. В тестовом пространстве имён сделайте совместимые ресурсы временно недоступными и проверьте, что среда показывает понятный статус и не запускает несколько конкурирующих восстановлений. Убедитесь, что владелец может восстановить работу из файлов или сохранённых результатов, если процесс в памяти не возобновляется. Затем удалите тестовый снимок и проверьте, как отработали хранилище и правила хранения.
Покажите команде полную картину затрат
Исследователь хочет продолжить работу. Команда платформы хочет вернуть дефицитный GPU в пул. Ответственному за расходы важно, исчезает ли выделение ресурса на самом деле. Одна проба может ответить на все три вопроса, если отдельно фиксировать простой, размещение по узлам, размер снимков, успешные возобновления и время восстановления. Добавьте инструкцию на случай сбоя и покажите пользователям, находится ли среда на паузе, ждёт ресурсы или готова.
На основе этих данных выберите правила простоя для разных нагрузок. Долгому сеансу, модель в котором загружается медленно, полезно сохранить память между рабочими сменами. Короткому эксперименту из сохранённого скрипта может хватить постоянных файлов и чистого перезапуска. Оба могут пользоваться одним пулом без обещания одинакового времени восстановления.
Включите проверку возобновления в план обновления
Обновление платформы может изменить образ, из которого запускается среда, или пул узлов с GPU. До включения обновления для команды создайте тестовый ноутбук на старой конфигурации и посмотрите, что произойдёт на новой. Проверка должна отличать успешное восстановление от нового сеанса с открытым прежним файлом. Прочитайте значение, существующее только в активном тестовом процессе, затем убедитесь, что его файлы остались на месте.
Если обновление делает старые снимки непригодными, дайте пользователям время сохранить критичные результаты и опишите запасной вариант. Отдельно проверьте очистку просроченных снимков. Проверка восстановления показывает лишь, что конкретная среда может вернуться. Проверка очистки покажет, сколько устаревшего состояния осталось после завершения работы.
Сохраняйте то, что труднее всего воссоздать
Рабочая среда полезнее, когда люди могут не думать о жизненном цикле машины и при этом возвращаться к работе. Для этого нужно отдельно рассматривать файлы, контрольные точки, снимки и доступные ресурсы. Выберите минимальное состояние, нужное для удобного продолжения, и убедитесь, что проект можно воспроизвести без исходного сеанса.
Если команда понимает, что остаётся на диске, что нужно восстановить и когда вычислительные ресурсы возвращаются в пул, она может установить правила простоя, которыми действительно будут пользоваться.
Источники
-
Анонс Google от 4 ноября и демонстрация в блоге открытого ПО
-
Код GKE Workspaces, статус поддержки и документация по установке
Чтобы сохранять рабочие разговоры и решения и быстро находить их, создайте аккаунт Telli.sh.