Более трудное обещание Gemini 4 Carbon: полезная работа после первого дня
Новая передовая модель Google делает акцент на длительной инженерной работе и киберзащите. Поэтапный доступ, бенчмарки и практические границы многодневной задачи агента.
Сложная программная ошибка редко появляется как аккуратное упражнение по коду. Она приходит в виде отчёта, непостоянного сбоя или симптома в нескольких слоях от причины. Полезная работа может включать чтение истории, проверку конкурирующих объяснений и отказ от патча, ещё час назад казавшегося перспективным.
Google анонсировала Gemini 4 Carbon 28 октября 2026 года, делая акцент на длительных инженерных задачах и киберзащите. Google DeepMind говорит, что внутренние команды наблюдали, как модель днями продолжала сложную работу, включая тонкие ошибки крупных кодовых баз. Это внутреннее наблюдение, а не обещание успешной многодневной работы над каждой клиентской задачей. Анонс Google также ясно определяет доступ: сначала отдельные специалисты киберзащиты, затем дополнительные доверенные партнёры через Fairwind; более широкий доступ запланирован.
Практический вопрос — что должна оставлять после себя дольше работающая модель. Это руководство объясняет положение новой модели, чтение опубликованных сравнений и подготовку инженерной задачи, которая остаётся проверяемой после многих часов работы.
 Пример доски задач Scrumban 2013 года иллюстрирует видимые состояния работы продолжающегося проекта. Это не интерфейс Gemini и не результат модели. Изображение: Dr ian mitchell, CC BY-SA 3.0; размер изменён с добавлением полей. Источник изображения · Лицензия и сведения об изображении. Официальная информация о продукте.

Длительность полезна только при сохранении смысла задачи
Программирующий агент может оставаться занятым, не проясняя проблему. Он может искать больше файлов, пробовать больше патчей и запускать больше команд, уходя от исходного сбоя. Более долгое выполнение увеличивает и возможность прогресса, и возможность накопить ошибочные предположения. Продуктовая задача — сохранить цель через всю эту активность.
Наша оценка: длительной задаче нужен устойчивый контракт. Он фиксирует проблему, доказательства исправления, разрешённый объём и действия, всё ещё требующие человека. Он должен переживать смену гипотез и реализации. Иначе модель может прийти к убедительному концу, решив более простую проблему, чем поручил пользователь.
Рассмотрим иллюстративную ошибку синхронизации. Отчёт говорит, что элемент будто сохраняется, но исчезает после обновления страницы. Полезная задача агента — воспроизвести поведение, найти сбой ответственности или сохранения, предложить ограниченное исправление и проверить тот же пользовательский путь. Менее полезный результат — большой рефакторинг с прошедшим тестом, никогда не проверявшим обновление.
Со временем различие становится важнее. После нескольких часов проверяющим нужна запись сильнейших доказательств и оставшихся неопределённостей, а не расшифровка каждой команды. Она должна показывать коллеге, где продолжать после остановки и что оправдает принятие результата.
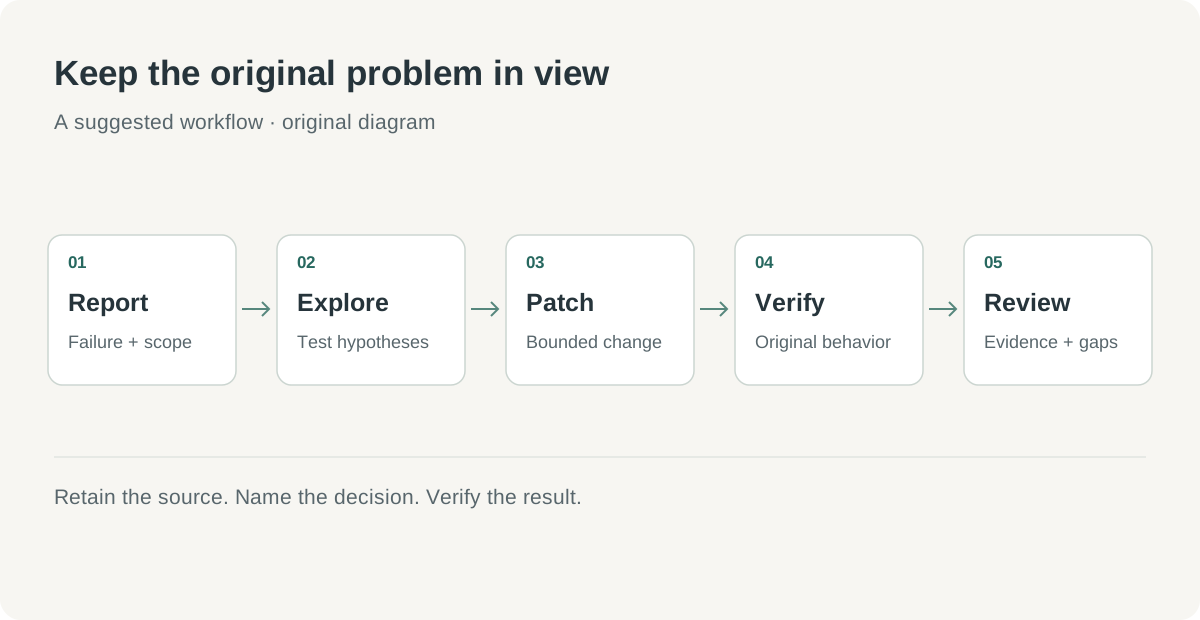 Авторская схема задачи: длительная работа должна создавать прослеживаемое исправление, сохраняя исходный критерий приёмки на всём протяжении исследования.
Сравнения Carbon описывают несколько разных видов работы
Страница сравнения моделей Google DeepMind, проверенная 2 ноября, приводит Carbon и Argon по нескольким оценкам. Например, она сообщает 65,2 % против 57,1 % на Terminal-Bench 4.0 и 61,2 % против 55,0 % на FrontierSWE 2. Это опубликованные результаты с отдельными названиями и условиями бенчмарков; складывать их в единую успешность продукта нельзя.
Команде разработки следует начинать с задачи, похожей на её процесс. Терминал, исправление репозитория и работа через браузер предъявляют агенту разные требования. Даже сильной в одной оценке модели может понадобиться другая настройка инструментов или больше человеческого контекста в производственном репозитории. Бенчмарк помогает выбрать эксперимент; поведение самого репозитория определяет успех.
| Вопрос оценки | Какие доказательства искать в пилоте команды | Что один бенчмарк оставляет открытым |
|---|---|---|
| Может ли агент найти причину? | Воспроизведение и подкреплённое причинное объяснение | Представлен ли сбой команды в бенчмарке |
| Может ли исправить поведение? | Узкое изменение и регрессионная проверка | Сохранены ли скрытые интеграционные контракты |
| Может ли ответственно пользоваться инструментами? | Ясные разрешения и проверяемые действия | Соответствует ли производственная конфигурация оценке |
| Может ли другой инженер проверить работу? | Краткий набор изменений, результаты и нерешённые пробелы | Сколько проверки требуют стандарты команды |
| Можно ли остановить и продолжить работу? | Сохранённое состояние и пригодная для продолжения передача | Сохраняет ли агентная система нужные материалы |
Эта таблица — рамка оценки, а не повторение методики Google. Она превращает широкое заявление о возможностях в вопросы, на которые команда может ответить. Сильный локальный результат должен включать неудачи и заблокированные шаги, чтобы команда понимала, где помогает модель и где ещё требует работы окружающий процесс.
Сравнению также нужна стабильная основа. Сохраняйте одинаковыми ревизию репозитория, разрешения инструментов, формулировку задачи и тестовую среду при сравнении конфигураций. Если одному запуску дают воспроизведение, а другой должен найти его с нуля, разница времени не изолирует вклад модели. Записывайте условия до интерпретации результата.
Киберзащите нужна цепочка от находки к проверенному исправлению
Анонс Google от 28 октября сообщает для Carbon 88,2 % на SEC-bench Pro, 54,8 % на ExploitGym и 71,0 % на CWE-bench и отмечает выполнение этих внешних оценок без защитных ограничений. Цифры относятся к разным задачам поиска, подтверждения и исправления уязвимостей. Анонс Google — источник этих опубликованных поставщиком результатов.
Для защитника полезная последовательность начинается с разрешённой цели и проверяемой находки. Валидация должна установить соответствующий риск в согласованной среде. Затем исправление должно устранить причину и сохранить допустимое поведение. У этапов разные требования к доказательствам, даже если один агент помогает во всех.
Иллюстративная внутренняя проверка библиотеки показывает различие. Команда даёт агенту изолированную копию библиотеки и определённую проблему обработки входа. Желаемый результат — конкретная находка, ограниченное воспроизведение в тестовой среде и патч с регрессионным покрытием. Агент не должен расширять задание на посторонние системы только из-за найденных в проектных материалах ссылок или доступов.
Второй иллюстративный сценарий — разбор существующего отчёта. Агент может связать его с путями кода и определить тесты, отличающие реальную проблему от ошибочного предположения. Полезному выводу «исправление не нужно» тоже нужны доказательства. Закрыть отчёт уверенным объяснением слабее, чем показать, почему заявленный путь неприменим к проверяемой ревизии.
Конечная ответственность остаётся у инженерной команды или команды безопасности системы. Предложенный патч требует проверки относительно реальных границ сервиса, процесса развёртывания и требований совместимости. Успешные изолированные тесты — часть решения, тогда как производственное внедрение и мониторинг остаются отдельными шагами.
Результат безопасности модели не определяет разрешения развёртывания
Google описывает улучшения согласования с намерениями, устойчивости к внедрению инструкций и сокращение неподтверждённых утверждений. Это важные направления для модели, продолжающей работу в неоднозначности. Практический вывод — оценить их в целевом процессе, а не считать громкий результат безопасности разрешением подключить все инструменты.
Длительная работа выигрывает от поэтапных полномочий. Чтение репозитория, изменение изолированной копии и развёртывание сервиса — разные действия. Команда может позволить сбор доказательств и подготовку проверяемого изменения, сохранив отдельное утверждение публикации или воздействия на производство. Граница должна обеспечиваться средой, а не только описываться задачей.
Недоверенные материалы создают ещё одну практическую проблему. Исходный файл, описание issue или загруженная страница могут содержать инструкции, противоречащие порученной работе. Хорошо спроектированная агентная система должна отделять полномочия задачи от читаемого содержимого. Доказательства проверки должны делать неожиданные смены объёма видимыми, особенно после столь долгого запуска, что никто не смотрит на каждое действие.
То же относится к доступам. Давайте задаче только нужный доступ и предпочитайте среду, где случайное действие имеет ограниченный эффект. Полезный пилот может установить, запрашивает ли модель недостающий контекст и оставляет ли честное состояние блокировки. Это столь же важно, как число файлов, которые она меняет до остановки.
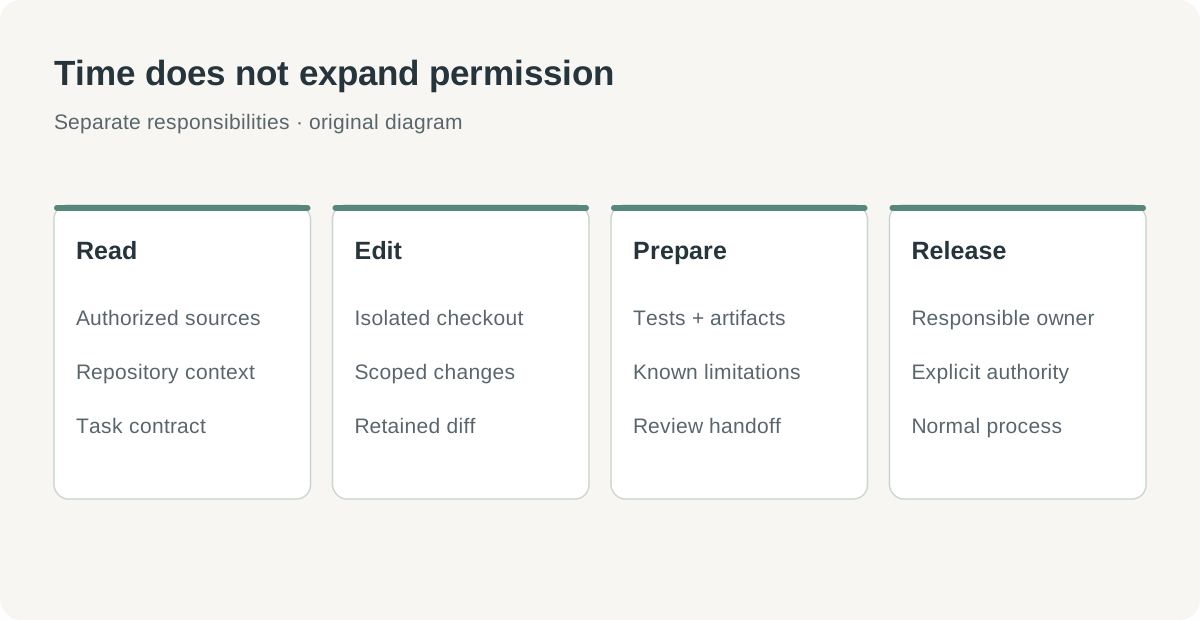 Авторская схема полномочий: более долгое выполнение не расширяет разрешения автоматически. У каждого этапа другой ответственный и отдельное условие завершения.
Поэтапный доступ сначала оставляет большинству команд подготовку
Публичный запуск описывает доступ отдельных специалистов киберзащиты, затем дополнительных доверенных партнёров Fairwind, тогда как общие интерфейсы для разработчиков, бизнеса и потребителей ещё впереди. Анонс модели и широкая доступность продукта — разные события. Проверяйте текущий путь доступа по официальным каналам Google, прежде чем строить сроки вокруг Carbon. Анонс от 28 октября, проверено 2 ноября 2026 года.
Команды без доступа всё равно могут подготовить полезную работу. Выберите сложную, но ограниченную задачу, сохраните нужную ревизию репозитория и соберите доказательства её нынешней сложности. Определите тесты и ожидания проверяющего. Подготовку можно использовать при появлении доступа, а сегодня она сделает сравнение с доступными инструментами содержательнее.
Не считайте подготовку обещанием завершения без наблюдения. Хорошая задача может выявить недостающую тестовую инфраструктуру, неясную ответственность или ненадёжное воспроизведение ещё до запуска новой модели. Исправление этих условий улучшает инженерный процесс независимо от того, какая модель в итоге будет исследовать проблему.
Третье иллюстративное применение — межслойный дефект приложения. Состояние интерфейса выглядит правильным, но сервер хранит другое значение. Задача может требовать сквозной трассировки запроса, сохранения и обновлённого интерфейса с последующим узким исправлением. Ценность длительного рассуждения — сохранять связь слоёв при исследовании, а не просто генерировать больше кода в каждом.
Стоимость долгой задачи включает проверку и восстановление
Опубликованные цены токенов — только часть длительной работы. Выполнение инструментов, повторный контекст, тестовая инфраструктура и инженерная проверка влияют на реальные расходы. Задача, заканчивающаяся читаемым, хорошо подкреплённым патчем, может быть ценнее дешёвого запуска, оставляющего проверяющему часы неопределённости.
Для первого пилота задайте по возможности границы расходов и времени в агентной системе. Решите, какие доказательства нужны до продления запуска. Застрявшая задача должна оставлять полезную контрольную точку: последний подтверждённый факт, сильнейшую оставшуюся гипотезу и следующий тест. Тогда продолжение основывается на прогрессе, а не надежде, что поможет больше времени.
Нагрузка проверки тоже измерима. Отслеживайте, может ли коллега понять причину, изучить изменения и повторить нужные проверки без воспроизведения всего сеанса. Если нет, улучшите формат результата до расширения полномочий агента. Долгая задача должна сокращать неопределённость команды, а не переносить её в более длинный документ проверки.
Начните с исправления с ясной финишной чертой
- Подтвердите доступный путь и точную предлагаемую модель. Отделяйте объявленное внедрение Carbon от доступа к другой Gemini.
- Выберите разрешённую изолированную задачу со стабильной ревизией и воспроизводимым сбоем. Не ставьте первую оценку в зависимость от неконтролируемого производственного состояния.
- Запишите критерий приёмки через пользовательское или системное поведение. Включите контракты, которые должны сохраниться, и назовите внешние действия, требующие утверждения.
- Предоставьте нужные инструменты и минимальные разрешения. Сохраняйте изменения, журналы и тестовые материалы там, где другой инженер сможет их проверить.
- Требуйте контрольных точек, различающих подтверждённые доказательства, текущие гипотезы и заблокированную работу. Проверяйте их до расширения объёма или бюджета.
- Оцените исправление относительно исходного сбоя и затронутого регрессионного набора. Изучите изменения на посторонние правки и скрытые миграции контрактов.
- Пусть ответственный проверяющий решит, готов ли патч к обычному выпуску. Явно запишите незавершённые проверки и нужную внешнюю верификацию.
Пилот должен включать одно намеренно неудобное условие, например падающий посторонний тест или недоступный необязательный сервис. Наблюдайте, отделяет ли итог этот предел от реальных доказательств исправления. Модель, честно сообщающую пробел проверки, легче интегрировать, чем превращающую каждое неопределённое состояние в заявление о завершении.
Многодневный агент должен оставлять более короткий путь к решению
Анонс Carbon указывает на другое ожидание от ИИ-разработки: работу, проходящую через тупики и создающую достойное проверки исправление. Окружающая инженерная система должна сделать такую настойчивость полезной. Ясный объём, сохранённые доказательства и ограниченные полномочия дают модели задачу, которую можно содержательно закончить.
Мы ожидаем, что сильнейшие оценки сосредоточатся на качестве передачи. Сохранила ли модель исходный вопрос? Определила ли, что действительно сломалось? Может ли инженер проверить результат и решить, что дальше? Эти вопросы связывают долгий запуск с практическим инженерным итогом.
Обещание более долго работающего ИИ — более короткий путь от сложного отчёта к обоснованному решению. Время работы становится ценным, когда следующий человек доверяет оставшемуся результату.
Источники
- Google: представляем Gemini 4 Carbon, 28 октября 2026 года; проверено 2 ноября 2026 года. Внутренние наблюдения и бенчмарки приписываются Google.
- Google DeepMind: сравнение моделей Gemini, проверено 2 ноября 2026 года. Версии и условия бенчмарков должны оставаться связанными с оценками.
Сохраняйте связь инженерного решения с источником
Telli.sh — один из вариантов хранения разрешённых исходных материалов и заметок, стоящих за инженерным решением. Создать пространство заметок.