120 นาทีฟรีที่ใส่บทสัมภาษณ์เดียวยังไม่พอ: การถอดเสียงด้วย AI แบบฟรีให้อะไรคุณจริง ๆ ในภาษาอินโดนีเซีย
แพ็กเกจฟรีของ Notta ให้เวลาถอดเสียง 120 นาทีต่อเดือน แต่จำกัดหนึ่งไฟล์บันทึกไว้ที่ 3 นาที TurboScribe ให้ 3 ไฟล์ต่อวันโดยมีเพดาน 30 นาที ส่วน API ของ Google ให้ 60 นาทีฟรีแต่ไม่มีหน้าจอใช้งานให้ วันที่ 7 สิงหาคม 2026 Deepgram ปล่อยโมเดลภาษาอินโดนีเซียที่ดีขึ้น เฉพาะบนเส้นทาง batch เท่านั้น นี่คือการเปรียบเทียบที่ทดสอบจริงของแพ็กเกจฟรีที่นักข่าว นักวิจัย และผู้สัมภาษณ์ฝ่ายบุคคลในอินโดนีเซียเจอเข้าจริง ๆ พร้อมข้อจำกัดที่ไม่มีเจ้าไหนโฆษณา
คุณมีไฟล์สัมภาษณ์ความยาว 47 นาทีนอนอยู่ในโทรศัพท์ แหล่งข่าวอยู่ที่สุราบายา บันทึกไว้เมื่อเช้านี้ ส่วนใหญ่เป็นภาษาอินโดนีเซียโดยมีคำอังกฤษโปรยอยู่ตามปกติ — deadline, stakeholder, follow up คุณต้องได้บทถอดเสียงภายในวันนี้ และถ้าเลือกได้ก็ไม่อยากจ่ายเงินเลย
คุณจึงค้นหา แล้วไปเจอเครื่องมือที่โฆษณาว่าให้เวลาถอดเสียงฟรี 120 นาทีต่อเดือน คุณสมัครทันที ไฟล์ 47 นาทีของคุณอยู่ต่ำกว่า 120 อย่างสบาย จากนั้นการอัปโหลดล้มเหลว และในตารางเปรียบเทียบแพ็กเกจก็มีตัวเลขที่สองซ่อนอยู่ ตัวเลขที่ไม่มีใครเอาขึ้นพาดหัว นั่นคือ การถอดเสียงสูงสุดต่อหนึ่งไฟล์บันทึก 3 นาที
นี่คือรูปร่างของสินค้าทั้งหมวดนี้ แพ็กเกจฟรีถูกโฆษณาด้วยตัวเลขที่ฟังดูใจกว้างที่สุด แล้วถูกล็อกด้วยตัวเลขอีกตัวที่อยู่ต่ำลงไปสามบรรทัด บทความนี้คือการเปรียบเทียบที่เราอยากให้มีมานานแล้ว ว่าแพ็กเกจฟรีแต่ละเจ้าให้อะไรกับบทสัมภาษณ์ภาษาอินโดนีเซียได้จริง ปฏิเสธอะไรอย่างเงียบ ๆ และคุณจะทดสอบเจ้าไหนก็ได้ภายในห้านาทีอย่างไรก่อนจะผูกมัดตัวเอง
สรุปสั้น
- แพ็กเกจฟรีมีเพดานสามชั้นที่ไม่ขึ้นต่อกัน ได้แก่ นาทีต่อเดือน นาทีต่อไฟล์ และจำนวนไฟล์ต่อวัน และตัวที่ทำให้บทสัมภาษณ์พังเกือบทุกครั้งคือเพดานต่อไฟล์ ไม่ใช่ยอดรวมรายเดือน
- การรู้จำเสียงพูดภาษาอินโดนีเซียดีขึ้นจริงในเดือนนี้ Deepgram ปล่อยโมเดล Nova-3 ภาษาอินโดนีเซียรุ่นปรับปรุงเมื่อวันที่ 7 สิงหาคม 2026 แต่เฉพาะบนเส้นทาง batch เท่านั้น ไม่ใช่ streaming การอัปโหลดไฟล์บันทึกจึงได้ประโยชน์ ส่วนคำบรรยายสดไม่ได้
- ไม่มีกระดานจัดอันดับสาธารณะที่วัดความแม่นยำของภาษาอินโดนีเซีย Open ASR Leaderboard เพิ่งเพิ่มภาษาจากกลุ่มประเทศซีกโลกใต้ภาษาแรกเมื่อวันที่ 28 สิงหาคม 2026 และภาษานั้นคือฮินดี ตราบใดที่ยังไม่เปลี่ยน คลิปทดสอบ 5 นาทีของคุณเองคือเกณฑ์วัดเดียวที่อธิบายไฟล์เสียงของคุณได้
แพ็กเกจฟรีทั้งหมด วางเรียงข้างกัน
ตัวเลขทุกตัวด้านล่างมาจากหน้าราคาหรือเอกสารที่ผู้ให้บริการเผยแพร่เอง เข้าดูเมื่อวันที่ 31 สิงหาคม 2026 งานอ้างอิงคือบทสัมภาษณ์สองคนความยาว 47 นาที เพราะนั่นคือไฟล์ที่คนมีอยู่จริง
| เครื่องมือ | แพ็กเกจฟรี | ไฟล์เดี่ยวที่ยาวที่สุดแบบฟรี | ภาษาอินโดนีเซีย | จุดเริ่มต้นแบบเสียเงิน |
|---|---|---|---|---|
| Notta | 120 นาที/เดือน, อัปโหลด 50 ครั้ง/เดือน, สรุปด้วย AI 10 ครั้ง/เดือน, 1 ที่นั่ง | 3 นาที | ยังไม่ยืนยัน | Pro $8.17/เดือน เมื่อจ่ายรายปี — 1,800 นาที/เดือน ไฟล์ยาวได้ 5 ชั่วโมง |
| TurboScribe | 3 บทถอดเสียงต่อวัน ลำดับคิวต่ำกว่า | 30 นาที | รองรับ | Unlimited $10/เดือน หรือ $120 เมื่อจ่ายรายปี — ไฟล์ยาวได้ 10 ชั่วโมง |
| Transkriptor | ไม่มีการประกาศนาทีฟรีรายเดือน | — | รองรับ | Lite $9.99/เดือน — 300 นาที/เดือน |
| Maestra | ไม่มีการประกาศนาทีฟรีรายเดือน | — | รองรับ | จ่ายตามใช้ $12 ต่อ 60 นาที; Lite $23/เดือน — 180 นาที/เดือน |
| Google Cloud Speech-to-Text | 60 นาที/เดือน หลังจากนั้น $0.016/นาที | แทบไม่มีเพดาน | รองรับ, id-ID | $0.016/นาที เมื่อเปิดบันทึกข้อมูล, $0.024/นาที เมื่อปิด |
| API ถอดเสียงของ OpenAI | ไม่มี | แทบไม่มีเพดาน | รองรับ | $0.006/นาที (gpt-4o-transcribe), $0.003/นาที (mini) |
| Whisper แบบติดตั้งเอง | ไม่จำกัด สัญญาอนุญาต MIT | เท่าที่ฮาร์ดแวร์ของคุณไหว | รองรับ | ซอฟต์แวร์ฟรี ค่า GPU เป็นของคุณเอง |
| Telli.sh | 60 นาที/เดือน | เท่าที่โควตายังเหลือ | รองรับ | แพ็กเกจเสียเงินเริ่มที่ 300 นาที/เดือน |
แหล่งข้อมูล: หน้าราคาของผู้ให้บริการแต่ละราย เข้าดูเมื่อวันที่ 31 สิงหาคม 2026; เอกสารภาษาที่รองรับของ Google สำหรับ id-ID; ราคา API ที่ OpenAI ประกาศไว้ หน้าราคาที่ใช้งานจริงของ TurboScribe บล็อกการดึงข้อมูลอัตโนมัติ ตัวเลขของเจ้านี้จึงมาจากสำเนาหน้าเดียวกันใน Internet Archive และตรงกับคำอธิบายแพ็กเกจที่ปรากฏในที่อื่น โปรดตรวจสอบก่อนนำไปใช้ตัดสินใจ เราดึงรายชื่อภาษาแยกรายภาษาจาก Notta ไม่ได้ในวันที่ 31 สิงหาคม 2026 การรองรับภาษาอินโดนีเซียของเจ้านี้จึงถูกทำเครื่องหมายว่ายังไม่ยืนยัน แทนที่จะเหมาเอาว่ารองรับ
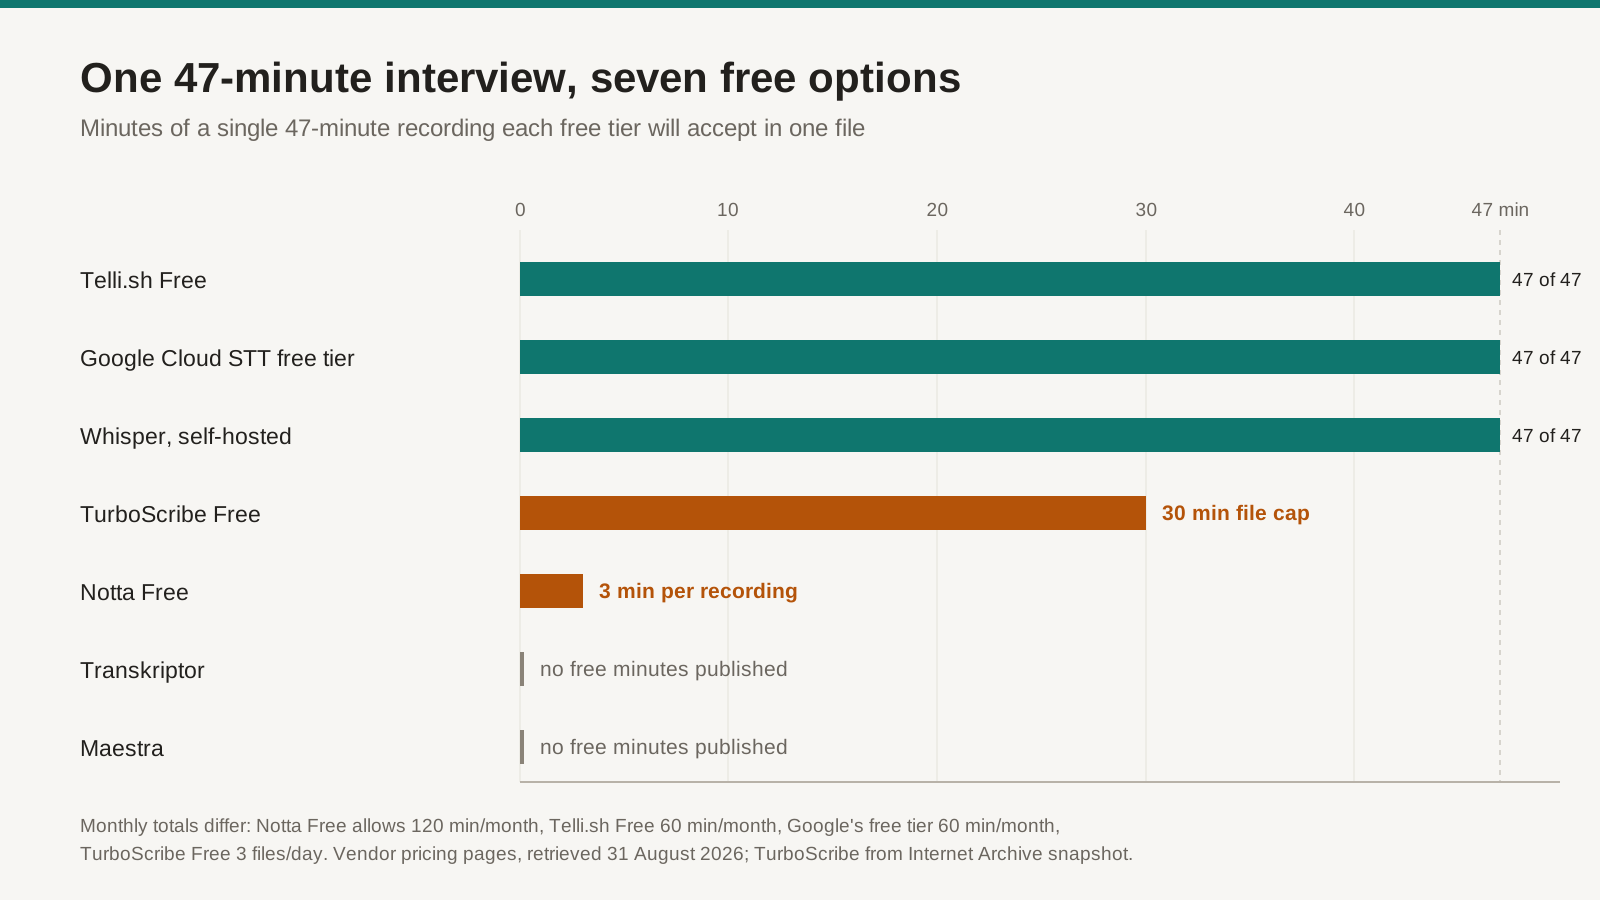
หน่วยเดียวกันบนแกนเดียว: จำนวนนาทีของบทสัมภาษณ์ 47 นาทีที่รับได้ในไฟล์เดียว โควตารายเดือนต่างกันไปและระบุไว้ใต้แผนภูมิ
120 นาทีของ Notta มีอยู่จริง แต่เพดานสามนาทีต่างหากที่ทำให้บทสัมภาษณ์พัง
ถ้าอ่านแพ็กเกจฟรีของ Notta อย่างละเอียด จะพบว่ามันไม่ได้ขี้เหนียวเลย — ถอดเสียง 120 นาทีต่อเดือน อัปโหลดไฟล์ได้ 50 ครั้ง สรุปด้วย AI 10 ครั้ง เครดิต AI 1,000 หน่วย และไม่ต้องใช้บัตรเครดิต สำหรับบันทึกเสียงสั้น ๆ กับสายที่ไม่ยาว นี่คือโควตาที่ใช้ได้จริง และเป็นนาทีรายเดือนที่มากกว่าคู่แข่งส่วนใหญ่แจกเสียอีก
จากนั้นเลื่อนลงอีกแค่บรรทัดเดียวในตารางเปรียบเทียบชุดเดิม: การถอดเสียงสูงสุดต่อหนึ่งไฟล์บันทึก 3 นาที ในแพ็กเกจ Free เทียบกับ 5 ชั่วโมงในแพ็กเกจ Pro แปลว่า 120 นาทีของคุณคือเศษไฟล์สามนาทีที่แยกกัน 40 ชิ้น บทสัมภาษณ์ 47 นาทีเข้าระบบไม่ได้เลยแม้แต่ครั้งเดียว
ประเด็นอยู่ตรงนี้ และมันใช้ได้เกินกว่าผู้ให้บริการรายใดรายหนึ่ง: แพ็กเกจฟรีไม่ใช่ตัวเลขตัวเดียว แต่คือเพดานสามชั้น และการตลาดจะหยิบตัวที่สูงที่สุดมาพูดเสมอ นาทีต่อเดือนคือพาดหัว นาทีต่อไฟล์คือตัวที่ตัดสินว่าบทสัมภาษณ์ของคุณถอดเสียงได้หรือไม่ ส่วนจำนวนไฟล์ต่อวันคือตัวที่ตัดสินว่าคุณจะเคลียร์งานภาคสนามทั้งสัปดาห์ให้จบในวันอาทิตย์เดียวได้หรือเปล่า
TurboScribe พลิกการแลกเปลี่ยนชุดเดียวกันกลับด้าน แพ็กเกจฟรีของเจ้านี้ไม่โฆษณาแอ่งนาทีรายเดือนเลย — สามบทถอดเสียงต่อวัน แต่ละบทยาวได้ถึง 30 นาที อัปโหลดได้ทีละไฟล์ และอยู่ในคิวลำดับต่ำกว่า สามไฟล์ไฟล์ละ 30 นาทีต่อวันเท่ากับเสียง 90 นาที ซึ่งแซงโควตารายเดือน 120 นาทีของ Notta ภายในสองวัน แต่บทสัมภาษณ์ 47 นาทีก็ยังใส่ไม่ลงอยู่ดี เพราะข้อจำกัดที่ผูกมัดจริงคือเพดานต่อไฟล์อีกเช่นเคย คุณจะต้องหั่นไฟล์บันทึกออกเป็นท่อน และทุกรอยตัดคือการสูญเสียความต่อเนื่องของผู้พูดตรงรอยนั้น
Transkriptor กับ Maestra คลายความตึงนี้ด้วยวิธีอื่น คือแทบไม่มีแพ็กเกจฟรีเลย แพ็กเกจที่ Transkriptor ประกาศไว้เริ่มที่ Lite $9.99 ต่อเดือนสำหรับการถอดเสียง 300 นาที ไล่ขึ้นไปถึง Pro $19.99 สำหรับ 2,400 นาที (เฉลี่ย $8.33 ต่อเดือนถ้าจ่าย $99.99 ต่อปี) ส่วน Maestra ขายเครดิตแบบจ่ายตามใช้ที่ $12 ต่อ 60 นาที และ Lite ที่ $23 ต่อเดือนสำหรับ 180 นาที ทั้งสองเจ้าระบุภาษาอินโดนีเซียไว้ ตารางภาษาของ Maestra ทำเครื่องหมายว่าภาษาอินโดนีเซียรองรับทั้งการถอดเสียง การแปล การพากย์ และงานเรียลไทม์ ไม่มีเจ้าไหนประกาศโควตาฟรีแบบต่อเนื่อง ซึ่งก็นับเป็นความตรงไปตรงมาอีกแบบหนึ่ง
ภาษาอินโดนีเซียดีขึ้นแบบวัดได้เมื่อวันที่ 7 สิงหาคม บนเส้นทางเดียวเป๊ะ ๆ
มีบางอย่างเกิดขึ้นจริงกับการรู้จำเสียงพูดภาษาอินโดนีเซียในเดือนนี้ และแทบไม่มีบทความเรื่อง «เครื่องมือถอดเสียงด้วย AI» ชิ้นไหนพูดถึงเลย
วันที่ 7 สิงหาคม 2026 Deepgram ปล่อยโมเดลภาษาเดี่ยว Nova-3 รุ่นปรับปรุงและเพิ่มภาษาอาร์เมเนียเข้ามา บันทึกการเปลี่ยนแปลงของเจ้านี้เจาะจงในแบบที่ประกาศจากผู้ขายไม่ค่อยทำกัน ภายใต้หัวข้อ Batch models: ทมิฬและอินโดนีเซีย ภายใต้หัวข้อ Streaming models: ทมิฬและเบลารุส
ภาษาอินโดนีเซียปรากฏในรายการหนึ่ง แต่ไม่ปรากฏในอีกรายการ
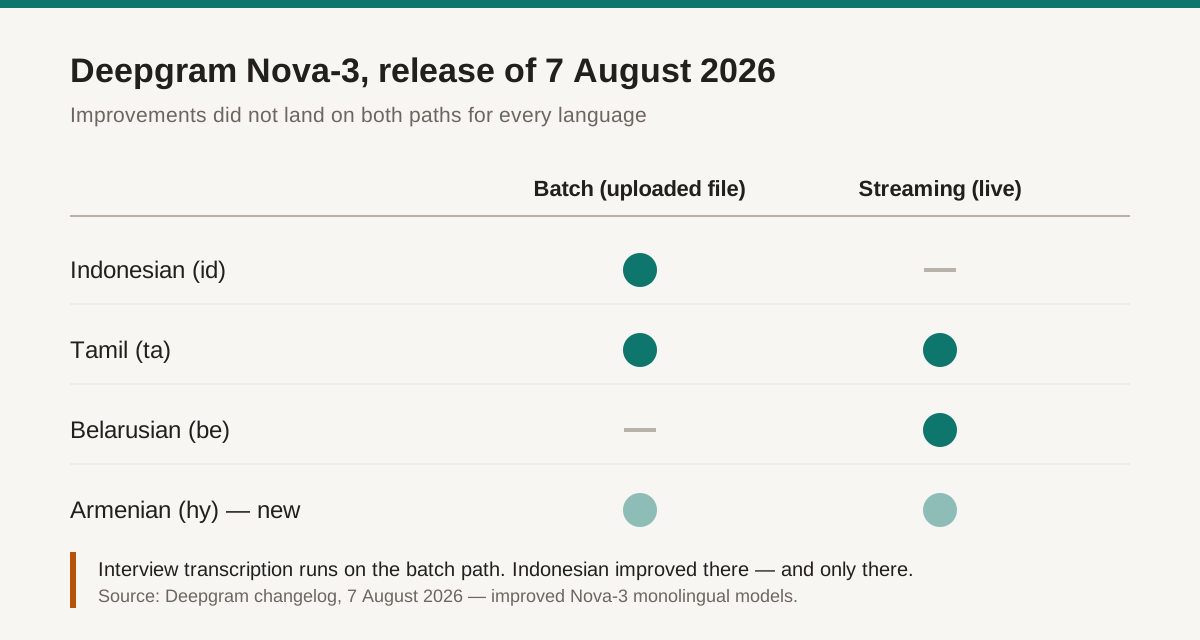
การปล่อยรุ่นครั้งเดียวกันปรับภาษาอินโดนีเซียให้ดีขึ้นในฝั่ง batch และปรับภาษาเบลารุสในฝั่ง streaming คำว่า «รองรับภาษาอินโดนีเซียดีขึ้น» จึงไม่ใช่ข้อเท็จจริงเดียว ที่มา: บันทึกการเปลี่ยนแปลงของ Deepgram วันที่ 7 สิงหาคม 2026
ความแตกต่างข้อนี้ตกลงมาตรงงานสัมภาษณ์พอดี batch คือเส้นทางที่ไฟล์ซึ่งอัปโหลดขึ้นไปเดินผ่าน เครื่องยนต์เห็นไฟล์บันทึกทั้งไฟล์ ใช้บริบทได้จากทั้งสองทิศทาง และไม่ต้องวิ่งไล่บัฟเฟอร์เสียงสด ส่วน streaming คือเส้นทางของคำบรรยายสด ถ้าคุณอัดสัมภาษณ์แล้วค่อยอัปโหลดทีหลัง คุณอยู่บนเส้นทาง batch ซึ่งเป็นเส้นทางที่ภาษาอินโดนีเซียดีขึ้นในเดือนนี้พอดี แต่ถ้าสิ่งที่คุณหวังคือคำบรรยายภาษาอินโดนีเซียแบบสดที่แม่นยำระหว่างสัมภาษณ์ โมเดลตัวนั้นไม่ได้เปลี่ยนแปลงเลยในวันที่ 7 สิงหาคม
เราเขียนข้อโต้แย้งนี้ฉบับยาวไว้ในบทความ คำว่า «รองรับ» ซ่อนอะไรไว้จริง ๆ ในความครอบคลุมภาษาของการรู้จำเสียงพูด เพราะรูปแบบนี้เกิดซ้ำทั้งอุตสาหกรรม ภาษาหนึ่งไม่ได้มีสถานะแค่รองรับหรือไม่รองรับ แต่รองรับบนเส้นทางหนึ่ง ในโหมดหนึ่ง ที่ระดับคุณภาพหนึ่ง ณ วันที่หนึ่ง สำหรับงานถอดเสียงบทสัมภาษณ์โดยเฉพาะ ข่าวดีคือเส้นทางที่คุณต้องใช้เป็นเส้นทางเดียวกับที่เพิ่งดีขึ้น
ไม่มีใครเผยแพร่เกณฑ์วัดความแม่นยำของภาษาอินโดนีเซีย คุณจึงต้องเป็นเกณฑ์วัดเสียเอง
นี่คือส่วนที่อึดอัดของการเขียนเปรียบเทียบอย่างซื่อตรง เราให้ตาราง WER ของภาษาอินโดนีเซียกับคุณไม่ได้ เพราะตารางสาธารณะที่น่าเชื่อถือยังไม่มีอยู่จริง
Open ASR Leaderboard ซึ่งใกล้เคียงกับกระดานคะแนนกลางที่สุดเท่าที่วงการนี้มี เปิดแท็บหลายภาษาที่ครอบคลุมเฉพาะภาษายุโรปเรื่อยมาจนถึงวันที่ 28 สิงหาคม 2026 เมื่อ Hugging Face และ Voice Arena เพิ่มภาษาฮินดีเข้าไปเป็นภาษาจากกลุ่มประเทศซีกโลกใต้ภาษาแรก ส่วนภาษาอินโดนีเซียซึ่งมีคนราว 280 ล้านคนในตลาดบ้านเกิดยังไม่อยู่ในนั้น ผู้ขายเผยแพร่คำกล่าวอ้างเรื่องความแม่นยำสำหรับภาษาอังกฤษ แล้วเงียบสำหรับภาษาอื่น
โครงสร้างของ Whisper เองก็ใบ้ถึงความไม่สมมาตรแบบเดียวกัน ตัวตัดคำของ OpenAI ประกาศโทเคนภาษาไว้ 100 ภาษา และภาษาอินโดนีเซียอยู่ในลำดับที่ 17 ของตารางนั้น ถือว่าน่านับถือ นำหน้ารายชื่อส่วนใหญ่อยู่พอสมควร แต่ยังห่างไกลจากปริมาณข้อมูลที่หนุนภาษาอังกฤษ จีน หรือสเปนอยู่มาก โทเคนที่ประกาศไว้ไม่ใช่การรับประกันคุณภาพ มันเป็นเพียงคำแถลงว่าโมเดลจะลองทำภาษานั้นให้
ข้อสรุปเชิงปฏิบัติที่ซื่อตรงจึงเป็นแบบนี้: สำหรับภาษาอินโดนีเซีย เกณฑ์วัดคือไฟล์เสียงของคุณเอง ไม่ใช่ไฟล์เดโมของผู้ขาย ไม่ใช่กระดานจัดอันดับ ไม่ใช่คะแนนดาวจากเว็บรีวิว แต่คือเครื่องอัดของคุณ ห้องของคุณ สำเนียงถิ่นของผู้ให้สัมภาษณ์ของคุณ และศัพท์เฉพาะในวงการของคุณ ฟังดูเหมือนคำตอบแบบเลี่ยงบาลี จนกว่าคุณจะสังเกตว่าการทำให้ครบถ้วนใช้เวลาราวยี่สิบนาทีเท่านั้น
การทดสอบ 5 นาที: ทำสิ่งนี้ก่อนจ่ายเงินให้ใคร
หยิบบทสัมภาษณ์จริงมาหนึ่งท่อนยาวห้านาที ถ้าเลือกได้ควรเป็นท่อนที่มีผู้พูดสองคน มีเสียงรบกวนพื้นหลัง และมีคำนามเฉพาะอย่างน้อยสามคำ แล้วส่งเข้าเครื่องมือทุกตัวที่คุณกำลังพิจารณา จากนั้นตรวจห้าอย่างตามลำดับนี้
- นับข้อผิดพลาดของคำนามเฉพาะ ชื่อคน ชื่อบริษัท ชื่อสถานที่ และศัพท์ผลิตภัณฑ์ นี่คือจุดที่การรู้จำเสียงภาษาอินโดนีเซียพลาดอย่างสม่ำเสมอ และเป็นจุดที่ความผิดพลาดสร้างความเสียหายปลายทางมากที่สุด เพราะชื่อที่ผิดจะไหลเข้าไปในทุกบทสรุปและทุกคำพูดที่คุณสร้างต่อจากนั้นอย่างเงียบเชียบ ห้าข้อผิดพลาดในห้านาทีเท่ากับราว 47 ข้อผิดพลาดในบทสัมภาษณ์ทั้งไฟล์
- ตรวจบรรทัดที่ปนสองภาษาเป็นพิเศษ หาประโยคที่มีคำอังกฤษแทรกอยู่กลางอนุประโยคภาษาอินโดนีเซีย แล้วอ่านว่าเครื่องมือให้ผลออกมาอย่างไร นี่คือการทดสอบเดี่ยวที่ทำนายผลได้ดีที่สุดสำหรับเสียงภาษาอินโดนีเซียในงานอาชีพ และเป็นข้อที่ไม่มีหน้าเว็บของผู้ขายรายใดพูดถึง
- ตรวจป้ายกำกับผู้พูดที่นาทีที่ห้า ไม่ใช่ที่นาทีแรก การแยกผู้พูดมักดูสมบูรณ์แบบในไม่กี่วินาทีแรกเสมอ สิ่งที่สำคัญคือผู้พูด A ยังเป็นผู้พูด A อยู่หรือไม่ หลังการพูดแทรกครั้งแรก การพูดทับกัน หรือการเงียบยาว
- มองหาแสตมป์เวลาที่คุณใช้งานต่อได้ ถ้าวันหนึ่งคุณต้องตรวจสอบคำพูดกลับไปยังไฟล์เสียง คุณต้องมีแสตมป์เวลาระดับบรรทัดในไฟล์ที่ส่งออก ไม่ใช่มีแค่ในเครื่องเล่นบนหน้าเว็บ นักข่าวและนักวิจัยเชิงคุณภาพควรถือว่าข้อนี้เป็นข้อบังคับ
- ส่งออกไฟล์แล้วเปิดในที่อื่น TXT, DOCX, SRT, VTT แล้วแต่ว่ากระบวนการทำงานของคุณต้องใช้อะไร จุดนี้คือจุดที่แพ็กเกจฟรีมักหยุดให้บริการ และบทถอดเสียงที่คุณเอาออกจากเครื่องมือไม่ได้ก็เป็นแค่เดโม ไม่ใช่บันทึก
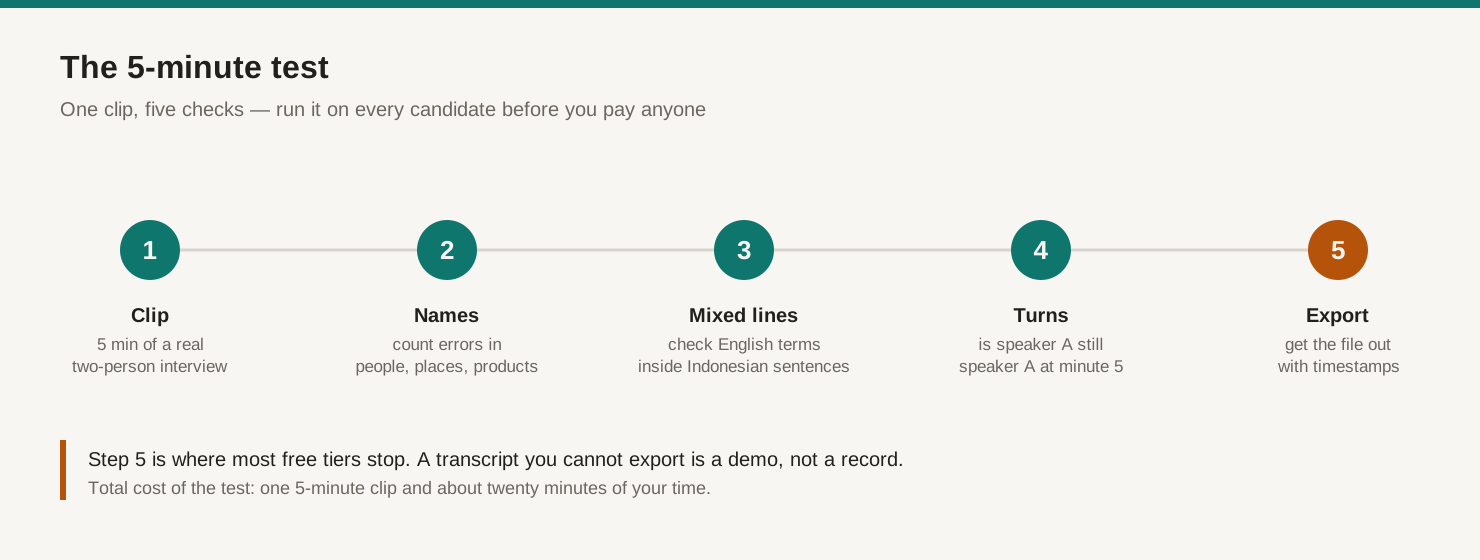
การตรวจทั้งห้าข้อ เรียงตามลำดับที่การประเมินจริงจะเจอ
ถ้าสิ่งที่คุณอยากได้คือกระบวนการทำงานหลังเลือกเครื่องมือเสร็จแล้ว เช่น การไล่ตรวจบทถอดเสียงก่อนจะเชื่อบทสรุป หรือการผูกคำพูดไว้กับไฟล์เสียงต้นทาง เราเขียนแยกไว้แล้วในบทความ เปลี่ยนไฟล์เสียงสัมภาษณ์ให้เป็นบทถอดเสียงและบทสรุปที่ตรวจทานได้
จุดที่บทสัมภาษณ์ภาษาอินโดนีเซียพังจริง ๆ คือคำอังกฤษกลางประโยค
ภาษาอินโดนีเซียในงานอาชีพไม่ได้เป็นภาษาเดี่ยว ประโยคอย่าง «Nanti kita follow up setelah meeting dengan tim product» ไม่ใช่ภาษาอินโดนีเซียที่พัง แต่คือวิธีที่ผู้จัดการผลิตภัณฑ์ในจาการ์ตาพูดจริง และก็ใกล้เคียงกับวิธีพูดของนักสรรหาบุคลากร ที่ปรึกษา และผู้ก่อตั้งสตาร์ตอัปด้วย บทถอดเสียงใดที่ทำเศษคำอังกฤษเละ ก็เท่ากับทำศัพท์ที่บันทึกของคุณพึ่งพาอยู่เละไปพร้อมกัน
นี่คือเรื่องยากที่สุดในหมวดนี้ และควรเข้าใจว่าทำไม เครื่องยนต์เสียงพูดส่วนใหญ่รันโมเดลภาษาเดี่ยวหนึ่งตัวต่อหนึ่งคำขอ คุณตั้งภาษาเป็นอินโดนีเซีย โมเดลก็จะแข็งแรงที่สุดกับสัทศาสตร์และคลังคำภาษาอินโดนีเซีย ซึ่งแปลว่าคำอังกฤษที่โผล่มากลางประโยคจะถูกถอดเสียงให้กลายเป็นคำหน้าตาอินโดนีเซีย หรือไม่ก็หายไปเลย ส่วนการตั้งภาษาเป็นอังกฤษก็แค่สลับทิศทางของความเสียหาย โหมดหลายภาษาหรือโหมดสลับภาษามีอยู่จริง แต่แคบกว่ารายชื่อภาษาเดี่ยวมาก ณ เดือนสิงหาคม 2026 Nova-3 ของ Deepgram มีเอกสารระบุ 58 ภาษาแบบทีละภาษา แต่รองรับการสลับภาษาเพียง 10 ภาษาเท่านั้น
มีทางบรรเทาที่ใช้ได้จริงสองทาง และถูกทั้งคู่ ทางแรก ตั้งภาษาต้นทางเป็นอินโดนีเซียอย่างชัดเจน แทนที่จะปล่อยให้ระบบตรวจจับภาษาอัตโนมัติทำงาน เพราะการตรวจจับอัตโนมัติต้องเดาจากช่วงวินาทีที่มีบริบทน้อยที่สุดของทั้งไฟล์ และการเดาผิดหนึ่งครั้งทำให้ทุกขั้นตอนถัดไปแย่ลงพร้อมกันหมด ทางที่สอง ถ้าเครื่องมือมีคลังคำแบบกำหนดเองหรือรายการคำสำคัญ ให้ใส่ศัพท์อังกฤษที่โผล่ซ้ำ ๆ และคำนามเฉพาะลงไปก่อนเริ่มประมวลผล ไม่ใช่ใส่ทีหลัง
ขอเรียกสิ่งนี้ว่า ปัญหากาโด-กาโด ตามชื่อสลัดคลุกของอินโดนีเซีย เสียงนั้นถูกคลุกรวมมาตั้งแต่ต้น แต่เครื่องยนต์ทุกตัวอยากเสิร์ฟมันเป็นอาหารจานเดียว
ถ้าคุณเขียนโค้ดได้ การถอดเสียงถูกกว่ากาแฟหนึ่งแก้ว
การเปรียบเทียบแพ็กเกจฟรีเปลี่ยนรูปไปทั้งหมดถ้าคุณยอมแตะ API และตัวเลขชุดนี้ก็ควรรู้ไว้ ต่อให้สุดท้ายคุณเลือกไม่ใช้ก็ตาม
OpenAI คิดค่าบริการ $0.006 ต่อนาทีสำหรับ gpt-4o-transcribe และ $0.003 ต่อนาทีสำหรับรุ่น mini บทสัมภาษณ์ 47 นาทีของคุณจึงมีค่าใช้จ่าย 28 เซนต์ หรือ 14 เซนต์บนรุ่น mini ส่วน Google Cloud Speech-to-Text ให้ 60 นาทีแรกของแต่ละเดือนฟรี หลังจากนั้นคิด $0.016 ต่อนาทีเมื่อเปิดการบันทึกข้อมูล และ $0.024 เมื่อปิด อีกทั้งยังระบุ id-ID ไว้ทั้งบนโมเดล chirp และ chirp_2 ในภูมิภาค asia-southeast1 ขณะที่ Whisper ใช้สัญญาอนุญาต MIT และไม่มีค่าใช้จ่ายใดนอกจากฮาร์ดแวร์ของคุณเอง
ที่ราคาระดับนั้น ตัวการรู้จำเสียงเองแทบจะฟรี สิ่งที่คุณจ่ายเงินซื้อจากผลิตภัณฑ์สำหรับผู้ใช้ทั่วไปคือทุกอย่างที่ห้อมล้อมมันอยู่ ได้แก่ หน้าจออัปโหลด ป้ายกำกับผู้พูด แสตมป์เวลา ตัวแก้ไข การค้นข้ามบทสัมภาษณ์เก่า บทสรุป การส่งออก และที่ทางซึ่งบันทึกนั้นยังอยู่ในอีกหกเดือนข้างหน้า
นั่นคือการตั้งกรอบคำถามสร้างเองหรือซื้อเอาอย่างซื่อตรง ถ้าคุณมีบทสัมภาษณ์สามชิ้นต่อปีและรันสคริปต์ Python ได้ ก็รันสคริปต์ไปเลย แต่ถ้าคุณมีสามชิ้นต่อสัปดาห์และต้องหาคำพูดหนึ่งประโยคจากเดือนมีนาคม สิ่งที่คุณกำลังเลือกซื้อไม่ใช่การรู้จำเสียง แต่คือระบบจัดเก็บเอกสารที่มีการรู้จำเสียงติดมาด้วย
สิ่งที่ไม่มีแพ็กเกจฟรีเจ้าไหนทำให้คุณได้
ยุติธรรมก็ต้องยุติธรรม นี่คือข้อจำกัดที่ใช้กับทุกตัวเลือกบนโต๊ะ รวมถึงของเราเองด้วย
แพ็กเกจฟรีไม่ให้การแยกผู้พูดที่เชื่อถือได้ มันเป็นหนึ่งในส่วนที่แพงที่สุดของสายการประมวลผล และทั้งหมวดนี้มักกันมันไว้ให้แพ็กเกจเสียเงินเป็นปกติ ถ้าการแยกผู้พูดสองคนเป็นเรื่องจำเป็นต่องานของคุณ ให้ตั้งงบไว้เลย ดีกว่าไปลุ้นเอา
แพ็กเกจฟรีไม่รับประกันการเก็บรักษาไฟล์ พื้นที่จัดเก็บมีต้นทุน พื้นที่ฟรีจึงเป็นน้ำใจที่ถูกถอนคืนได้ด้วยการแก้นโยบายครั้งเดียว ให้ส่งออกทุกอย่างที่สำคัญและเก็บสำเนาของคุณเอง ซึ่งก็เป็นคำตอบของคำถามเรื่องการติดหนึบกับผู้ขายที่ไม่มีใครถามจนกว่าจะถึงวันที่ต้องย้ายออก
แพ็กเกจฟรีไม่ได้ยกพื้นความแม่นยำสำหรับผู้พูดเฉพาะกลุ่มของคุณ สำเนียงถิ่น ผู้ให้สัมภาษณ์สูงอายุ เสียงคุณภาพระดับโทรศัพท์ และการสลับภาษาที่หนาแน่น ล้วนทำให้ผลลัพธ์แย่ลง และระดับแพ็กเกจไม่ได้เปลี่ยนว่าโมเดลเคยเจอเสียงแบบของคุณมามากแค่ไหน การจ่ายเพิ่มซื้อได้แค่จำนวนนาทีกับฟีเจอร์ ไม่ได้ซื้อตัวรู้จำเสียงคนละตัว
และไม่มีเครื่องมือใด ไม่ว่าฟรีหรือเสียเงิน ที่ลบขั้นตอนตรวจทานออกไปได้ บทสรุปจาก AI ที่สร้างบนบทถอดเสียงซึ่งยังไม่ถูกตรวจ ย่อมรับทอดข้อผิดพลาดทุกจุดในนั้นมาเต็ม ๆ อย่างมั่นใจและอย่างมองไม่เห็น
บรรทัดสุดท้าย: สิ่งที่ควรเทียบไม่ใช่จำนวนนาที แต่คือจำนวนบทสัมภาษณ์
แพ็กเกจฟรีทุกเจ้าในหมวดนี้โฆษณาปริมาณเวลา นั่นคือหน่วยที่ผิดสำหรับงานสัมภาษณ์ เพราะเวลาจะมีความหมายก็ต่อเมื่อมันมาเป็นก้อนเดียวที่ต่อเนื่อง หนึ่งร้อยยี่สิบนาทีที่ถูกสับเป็นแผ่นละสามนาที มีค่าน้อยกว่าสามสิบนาทีที่ไม่ขาดตอนสำหรับนักข่าว และทั้งสองอย่างก็มีค่าน้อยกว่าหกสิบนาทีที่บรรจุบทสนทนาทั้งบทเอาไว้ได้โดยป้ายกำกับผู้พูดยังครบถ้วน
ฉะนั้นเวลาเทียบเครื่องมือ ให้แปลงทุกแพ็กเกจฟรีเป็นสกุลเงินเดียวที่มีความหมายกับคุณ นั่นคือ บริการนี้ถอดบทสัมภาษณ์จริงของฉันได้กี่ชิ้น แบบครบทั้งไฟล์ตั้งแต่ต้นจนจบ โดยไม่ต้องตัดแบ่ง สำหรับแพ็กเกจฟรีที่มีชื่อเสียงหลายเจ้า คำตอบที่ซื่อตรงคือศูนย์ และพวกเขาจะไม่บอกคุณแบบนั้นบนหน้าราคา
ชั้นการรู้จำเสียงกำลังกลายเป็นของสามัญที่มุ่งไปสู่ราคาหนึ่งในสามเซนต์ต่อนาที สิ่งที่ยังหายากสำหรับภาษาอินโดนีเซียคือบันทึกที่คุณค้นได้ แก้ได้ ยกมาอ้างได้ และยังหาเจอในไตรมาสหน้า
Telli.sh อยู่ตรงไหนในภาพนี้: เราเป็นหนึ่งในตัวเลือกที่ว่ามาข้างต้น และเราจะพูดให้เจาะจง แพ็กเกจ Free ของ Telli.sh คือ 60 นาทีต่อเดือน ซึ่งเป็นตัวเลขพาดหัวที่น้อยกว่า 120 นาทีของ Notta และตั้งใจไม่ให้ถูกสับด้วยเพดานสามนาทีต่อไฟล์บันทึก บทสัมภาษณ์เต็มความยาวจึงเข้าไปได้ในไฟล์เดียว คุณจะได้บทถอดเสียงภาษาอินโดนีเซีย การแปลไปยังภาษาปลายทางได้ 44 ภาษา บทสรุปจาก AI ที่สร้างจากบทถอดเสียงนั้น และหน้าจอใช้งานที่มีให้เลือก 15 ภาษา รวมถึงภาษาอินโดนีเซีย เมื่อเกิน 60 นาทีต่อเดือน นี่คือผลิตภัณฑ์แบบเสียเงิน และถ้าปริมาณงานของคุณน้อยและคุณรันสคริปต์เองได้ เส้นทาง API ก็ถูกกว่าจริง ๆ เชิญทดสอบ 5 นาทีกับเราด้วยวิธีเดียวกับที่คุณจะทดสอบเจ้าอื่น
แหล่งอ้างอิง
- Deepgram, "Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian", บันทึกการเปลี่ยนแปลงลงวันที่ 7 สิงหาคม 2026 — โมเดล batch ที่ปรับปรุงแล้วสำหรับภาษาทมิฬและอินโดนีเซีย โมเดล streaming ที่ปรับปรุงแล้วสำหรับภาษาทมิฬและเบลารุส และเพิ่มภาษาอาร์เมเนีย (
hy) ให้ทั้งสองเส้นทาง - Hugging Face และ Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 สิงหาคม 2026 — ภาษาฮินดีเป็นภาษาจากกลุ่มประเทศซีกโลกใต้ภาษาแรกของกระดานจัดอันดับนี้
- หน้าราคาของ Notta, เข้าดูเมื่อ 31 สิงหาคม 2026 — แพ็กเกจ Free 120 นาที/เดือน สูงสุด 3 นาทีต่อไฟล์บันทึก อัปโหลดไฟล์ 50 ครั้ง/เดือน สรุปด้วย AI 10 ครั้ง/เดือน; Pro $8.17/เดือนเมื่อจ่ายรายปี พร้อม 1,800 นาที/เดือน
- หน้าราคาของ Transkriptor, เข้าดูเมื่อ 31 สิงหาคม 2026 — Lite $9.99/เดือน (300 นาที), Pro $19.99/เดือน (2,400 นาที หรือ $99.99/ปีเมื่อจ่ายรายปี), Team $30/ที่นั่ง/เดือน (3,000 นาทีต่อที่นั่ง)
- หน้าราคาของ Maestra และ รายชื่อภาษาที่ Maestra รองรับ, เข้าดูเมื่อ 31 สิงหาคม 2026 — จ่ายตามใช้ $12 ต่อ 60 เครดิต, Lite $23/เดือนสำหรับ 180 นาที; ภาษาอินโดนีเซียถูกระบุไว้สำหรับการถอดเสียง การแปล การพากย์ และงานเรียลไทม์
- หน้าราคาของ TurboScribe ตามที่ Internet Archive บันทึกไว้ — แพ็กเกจ Free 3 บทถอดเสียงต่อวัน โดยจำกัดไฟล์ละ 30 นาทีและอัปโหลดได้ทีละไฟล์; Unlimited $10/เดือน หรือ $120 เมื่อจ่ายรายปี ไฟล์ยาวได้ 10 ชั่วโมง หน้าเว็บที่ใช้งานจริงตอบกลับ HTTP 403 ต่อการดึงข้อมูลอัตโนมัติ จึงควรถือตัวเลขชุดนี้เป็นแนวทางคร่าว ๆ และยืนยันอีกครั้งบนเว็บไซต์
- หน้าราคาของ Google Cloud Speech-to-Text และ รายชื่อภาษาที่รองรับ, เข้าดูเมื่อ 31 สิงหาคม 2026 — 60 นาทีแรกของแต่ละเดือนฟรี จากนั้น $0.016/นาที เมื่อเปิดการบันทึกข้อมูล และ $0.024/นาที เมื่อปิด;
id-IDอยู่บนchirpและchirp_2ในภูมิภาคasia-southeast1 - หน้าราคา API ของ OpenAI, เข้าดูเมื่อ 31 สิงหาคม 2026 —
gpt-4o-transcribeที่ $0.006/นาที และgpt-4o-mini-transcribeที่ $0.003/นาที - OpenAI Whisper, สัญญาอนุญาต MIT; ตาราง
LANGUAGESในตัวตัดคำประกาศไว้ 100 ภาษา โดยภาษาอินโดนีเซีย (id) อยู่ในลำดับที่ 17, เข้าดูเมื่อ 31 สิงหาคม 2026