AI transkrip wawancara gratis: 120 menit yang tidak cukup untuk satu wawancara
Paket gratis Notta memberi 120 menit transkripsi per bulan, tapi membatasi satu rekaman hanya 3 menit. TurboScribe memberi 3 berkas per hari dengan batas 30 menit. API Google memberi 60 menit gratis tanpa antarmuka. Pada 7 Agustus 2026 Deepgram merilis model bahasa Indonesia yang lebih baik — hanya di jalur batch. Perbandingan jujur aplikasi transkrip wawancara yang benar-benar dipakai jurnalis, peneliti, dan tim HR di Indonesia, beserta batas yang tidak pernah mereka iklankan.
Ada rekaman wawancara 47 menit di ponsel Anda. Narasumber di Surabaya, direkam pagi tadi, mayoritas bahasa Indonesia dengan taburan kata Inggris seperti biasa — deadline, stakeholder, follow up. Transkripnya dibutuhkan hari ini, dan Anda jelas lebih suka tidak membayar.
Anda pun mencari, menemukan aplikasi yang mengiklankan 120 menit transkripsi gratis per bulan, lalu mendaftar. Berkas 47 menit Anda jelas masih di bawah 120. Unggahan gagal. Dan di tabel perbandingan paket, tiga baris di bawah angka utama tadi, ada angka kedua yang tidak pernah dipasang di judul: maksimum transkripsi per rekaman, 3 menit.
Begitulah bentuk seluruh kategori ini. Paket gratis diiklankan lewat angka yang paling terdengar murah hati, lalu dibatasi oleh angka lain yang letaknya jauh di bawah. Tulisan ini adalah perbandingan yang seharusnya sudah ada sejak dulu: apa yang benar-benar diberikan tiap paket gratis untuk wawancara berbahasa Indonesia, apa yang diam-diam ditolaknya, dan bagaimana menguji semuanya dalam lima menit sebelum Anda terlanjur berkomitmen.
Ringkasnya
- Paket gratis punya tiga plafon yang berdiri sendiri — menit per bulan, menit per berkas, dan jumlah berkas per hari — dan yang mematikan wawancara hampir selalu batas per berkas, bukan total bulanan.
- Pengenalan suara bahasa Indonesia benar-benar membaik bulan ini: Deepgram merilis model Nova-3 bahasa Indonesia yang ditingkatkan pada 7 Agustus 2026, tetapi hanya di jalur batch, bukan streaming. Mengunggah rekaman diuntungkan; teks langsung saat wawancara tidak.
- Tidak ada papan peringkat publik yang mengukur akurasi bahasa Indonesia. Open ASR Leaderboard baru menambahkan bahasa Global South pertamanya pada 28 Agustus 2026, dan yang masuk adalah bahasa Hindi. Selama itu belum berubah, klip uji 5 menit milik Anda sendiri adalah satu-satunya tolok ukur yang mewakili audio Anda.
Aplikasi transkrip wawancara dan paket gratisnya, berdampingan
Semua angka di bawah diambil dari halaman harga atau dokumentasi resmi masing-masing vendor, diakses 31 Agustus 2026. Pekerjaan acuannya satu: wawancara dua orang berdurasi 47 menit, karena itulah berkas yang benar-benar dimiliki orang.
| Layanan | Paket gratis | Berkas tunggal terpanjang, gratis | Bahasa Indonesia | Harga berbayar terendah |
|---|---|---|---|---|
| Notta | 120 menit/bulan, 50 unggahan/bulan, 10 ringkasan AI/bulan, 1 kursi | 3 menit | Belum terkonfirmasi | Pro $8,17/bulan tagihan tahunan — 1.800 menit/bulan, berkas hingga 5 jam |
| TurboScribe | 3 transkrip per hari, prioritas antrean lebih rendah | 30 menit | Ya | Unlimited $10/bulan, $120 per tahun — berkas hingga 10 jam |
| Transkriptor | Tidak ada menit gratis bulanan yang dipublikasikan | — | Ya | Lite $9,99/bulan — 300 menit/bulan |
| Maestra | Tidak ada menit gratis bulanan yang dipublikasikan | — | Ya | Bayar sesuai pakai $12 per 60 menit; Lite $23/bulan — 180 menit/bulan |
| Google Cloud Speech-to-Text | 60 menit/bulan, lalu $0,016/menit | Praktis tanpa batas | Ya, id-ID | $0,016/menit dengan data logging, $0,024/menit tanpa |
| API transkripsi OpenAI | Tidak ada | Praktis tanpa batas | Ya | $0,006/menit (gpt-4o-transcribe), $0,003/menit (mini) |
| Whisper, pasang sendiri | Tanpa batas, lisensi MIT | Sebatas perangkat keras Anda | Ya | Perangkat lunak gratis, biaya GPU Anda sendiri |
| Telli.sh | 60 menit/bulan | Sepanjang kuota masih ada | Ya | Paket berbayar mulai 300 menit/bulan |
Sumber: halaman harga masing-masing vendor, diakses 31 Agustus 2026; dokumentasi bahasa Google untuk id-ID; harga API resmi OpenAI. Halaman harga TurboScribe memblokir pengambilan otomatis, jadi angkanya berasal dari arsip Internet Archive atas halaman yang sama dan sesuai dengan cara paket itu dijelaskan di tempat lain — periksa ulang sebelum Anda mengandalkannya. Kami tidak berhasil mengambil daftar bahasa per-bahasa dari Notta pada 31 Agustus 2026, jadi dukungan bahasa Indonesianya kami tandai belum terkonfirmasi, bukan kami anggap ada.
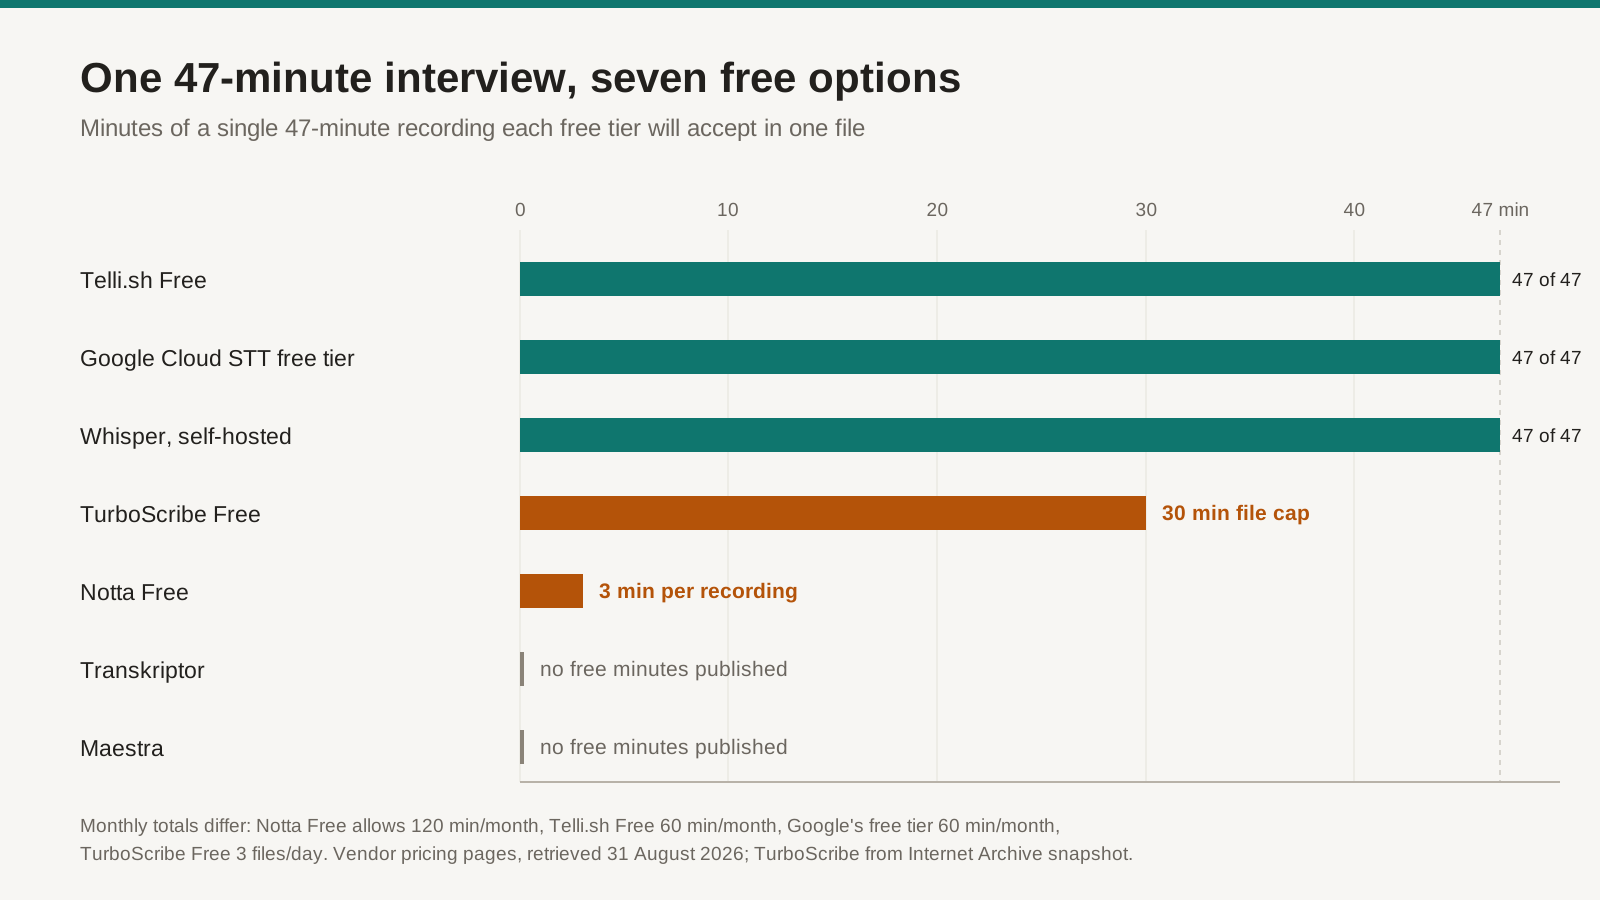
Satu satuan pada satu sumbu: menit dari satu wawancara 47 menit yang diterima dalam satu berkas. Kuota bulanan berbeda-beda dan dicatat di bawah grafik.
120 menit Notta itu nyata. Batas tiga menit per rekaman yang mematikannya.
Baca paket gratis Notta baik-baik dan sebenarnya ia tidak pelit — 120 menit transkripsi per bulan, 50 unggahan berkas, 10 ringkasan AI, 1.000 kredit AI, tanpa kartu kredit. Untuk memo suara dan panggilan pendek, itu kuota yang sungguh berguna, dan lebih banyak dari yang diberikan hampir semua pesaingnya.
Lalu turun satu baris di tabel perbandingan yang sama: maksimum transkripsi per rekaman, 3 menit di paket Free, melawan 5 jam di paket Pro. Jadi 120 menit Anda sebetulnya 40 potongan tiga menit yang terpisah. Wawancara 47 menit tidak bisa masuk sama sekali.
Inilah intinya, dan ini berlaku jauh melampaui satu vendor: paket gratis bukan satu angka, melainkan tiga plafon, dan iklan selalu mengutip yang paling tinggi. Menit per bulan adalah judulnya. Menit per berkas adalah yang menentukan wawancara Anda bisa ditranskrip atau tidak. Jumlah berkas per hari adalah yang menentukan Anda bisa memproses hasil liputan seminggu dalam satu hari Minggu atau tidak.
TurboScribe membalik pertukaran yang sama. Paket gratisnya sama sekali tidak mengiklankan kolam menit bulanan — tiga transkrip per hari, masing-masing hingga 30 menit, satu berkas dalam satu waktu, dengan prioritas antrean lebih rendah. Tiga berkas 30 menit per hari berarti 90 menit audio, melewati kuota bulanan Notta hanya dalam dua hari. Tetapi wawancara 47 menit tetap tidak muat, karena yang mengikat lagi-lagi batas per berkas. Anda harus memotong rekaman, dan setiap potongan itu memakan kesinambungan pembicara di titik potongnya.
Transkriptor dan Maestra menyelesaikan ketegangan ini dengan cara lain: keduanya pada dasarnya tidak punya paket gratis. Paket Transkriptor dimulai dari Lite, $9,99 per bulan untuk 300 menit transkripsi, naik ke Pro $19,99 untuk 2.400 menit ($8,33 per bulan jika Anda membayar $99,99 setahun di muka). Maestra menjual kredit bayar-sesuai-pakai seharga $12 per 60 menit, dengan Lite $23 per bulan untuk 180 menit. Keduanya mencantumkan bahasa Indonesia; tabel bahasa Maestra menandai bahasa Indonesia sebagai didukung untuk transkripsi, terjemahan, sulih suara, maupun real-time. Tidak ada yang mempublikasikan kuota gratis berulang — dan itu bentuk kejujurannya sendiri.
Transkrip otomatis bahasa Indonesia membaik pada 7 Agustus — tepatnya hanya di satu jalur
Ada yang benar-benar berubah untuk pengenalan suara bahasa Indonesia bulan ini, dan hampir tidak ada artikel "aplikasi transkrip AI" yang menyebutnya.
Pada 7 Agustus 2026, Deepgram merilis model monolingual Nova-3 yang ditingkatkan dan menambahkan bahasa Armenia. Changelog-nya spesifik dengan cara yang jarang dilakukan pengumuman vendor. Di bawah Batch models: Tamil dan Indonesia. Di bawah Streaming models: Tamil dan Belarusia.
Bahasa Indonesia muncul di satu daftar dan tidak di daftar lainnya.
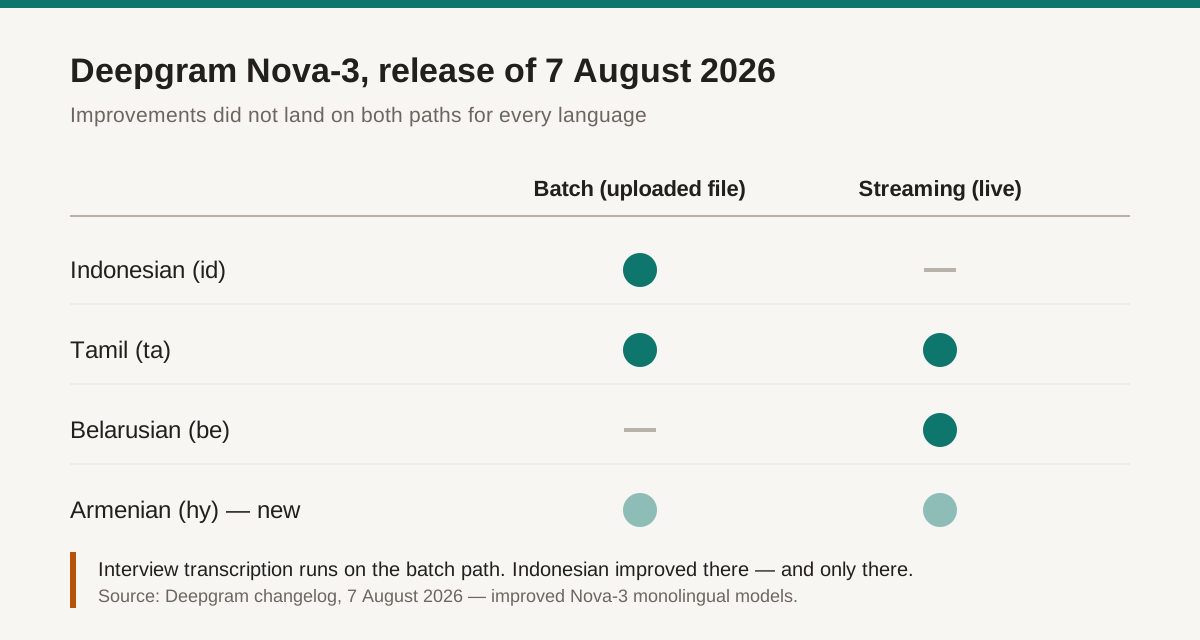
Rilis yang sama meningkatkan bahasa Indonesia di batch dan Belarusia di streaming. "Dukungan bahasa Indonesia membaik" bukan satu fakta tunggal. Sumber: changelog Deepgram, 7 Agustus 2026.
Perbedaan itu mendarat tepat di pekerjaan wawancara. Batch adalah jalur yang dilewati berkas yang diunggah — mesinnya melihat seluruh rekaman, bisa memakai konteks dari dua arah, dan tidak sedang berkejaran dengan buffer audio langsung. Streaming adalah jalur teks langsung. Kalau Anda merekam wawancara lalu mengunggahnya setelah selesai, Anda berada di jalur batch, yaitu jalur yang bahasa Indonesianya membaik bulan ini. Kalau yang Anda harapkan adalah teks langsung berbahasa Indonesia yang akurat selama wawancara berlangsung, model itu tidak berubah pada 7 Agustus.
Versi panjang argumen ini sudah kami tulis di apa yang sebenarnya disembunyikan kata "didukung" dalam cakupan bahasa speech-to-text, karena polanya berulang di seluruh industri: sebuah bahasa bukan didukung atau tidak didukung, melainkan didukung di jalur tertentu, dalam mode tertentu, pada tingkat kualitas tertentu, per tanggal tertentu. Khusus untuk transkrip wawancara, kabar baiknya: jalur yang Anda butuhkan justru jalur yang membaik.
Tidak ada tolok ukur akurasi bahasa Indonesia, jadi Anda harus menjadi tolok ukurnya
Ini bagian yang tidak enak dari menulis perbandingan yang jujur: kami tidak bisa memberi Anda tabel WER untuk bahasa Indonesia, karena tabel publik yang kredibel memang belum ada.
Open ASR Leaderboard — yang paling mendekati papan skor netral di bidang ini — menjalankan tab multibahasa yang hanya mencakup bahasa-bahasa Eropa sampai 28 Agustus 2026, ketika Hugging Face dan Voice Arena menambahkan bahasa Hindi sebagai bahasa Global South pertamanya. Bahasa Indonesia, dengan sekitar 280 juta penutur di pasar asalnya, masih belum ada di sana. Vendor mempublikasikan klaim akurasi untuk bahasa Inggris dan memilih diam untuk yang lain.
Struktur Whisper sendiri memberi petunjuk ke ketimpangan yang sama. Tokenizer OpenAI mendeklarasikan 100 token bahasa, dan bahasa Indonesia menempati posisi ke-17 dalam tabel itu — terhormat, jauh di depan sebagian besar daftar, dan sama sekali tidak sebanding dengan volume data di belakang bahasa Inggris, Mandarin, atau Spanyol. Token yang dideklarasikan bukan jaminan kualitas; itu hanya pernyataan bahwa modelnya akan mencoba.
Maka kesimpulan operasional yang jujur adalah ini: untuk bahasa Indonesia, tolok ukurnya adalah audio Anda sendiri. Bukan berkas demo vendor, bukan papan peringkat, bukan rating bintang situs ulasan. Perekam Anda, ruangan Anda, logat daerah narasumber Anda, kosakata industri Anda. Kedengarannya seperti jawaban yang menghindar — sampai Anda sadar prosesnya hanya butuh sekitar dua puluh menit.
Uji 5 menit: jalankan ini sebelum membayar siapa pun
Ambil satu potongan lima menit dari wawancara sungguhan — idealnya yang berisi dua pembicara, suara latar, dan setidaknya tiga nama diri. Jalankan lewat semua kandidat. Lalu periksa lima hal, dengan urutan ini.
- Hitung kesalahan nama diri. Nama orang, perusahaan, tempat, dan istilah produk. Di sinilah pengenalan suara bahasa Indonesia paling sering gagal, dan di sini pula kesalahannya paling merusak, karena nama yang salah menyebar diam-diam ke setiap ringkasan dan kutipan yang Anda buat sesudahnya. Lima kesalahan dalam lima menit berarti sekitar 47 kesalahan di wawancara Anda.
- Periksa khusus baris-baris campur bahasa. Cari kalimat yang menyelipkan kata Inggris di dalam klausa Indonesia, lalu baca hasil mesinnya. Ini uji paling prediktif untuk audio profesional Indonesia, dan justru satu-satunya yang tidak dibahas halaman vendor mana pun.
- Verifikasi label pembicara di menit kelima, bukan menit pertama. Pemisahan pembicara hampir selalu terlihat sempurna di detik-detik awal. Yang menentukan adalah apakah Pembicara A masih Pembicara A setelah interupsi pertama, suara yang bertabrakan, atau jeda panjang.
- Cari stempel waktu yang bisa Anda pakai. Kalau suatu saat Anda perlu memverifikasi kutipan ke audionya, Anda butuh stempel waktu per baris di berkas ekspor, bukan hanya di pemutar web. Jurnalis dan peneliti kualitatif sebaiknya menganggap ini wajib.
- Ekspor berkasnya dan buka di tempat lain. TXT, DOCX, SRT, VTT — apa pun yang dibutuhkan alur kerja Anda. Di sinilah paket gratis paling sering berhenti, dan transkrip yang tidak bisa Anda keluarkan dari aplikasinya adalah demo, bukan arsip.
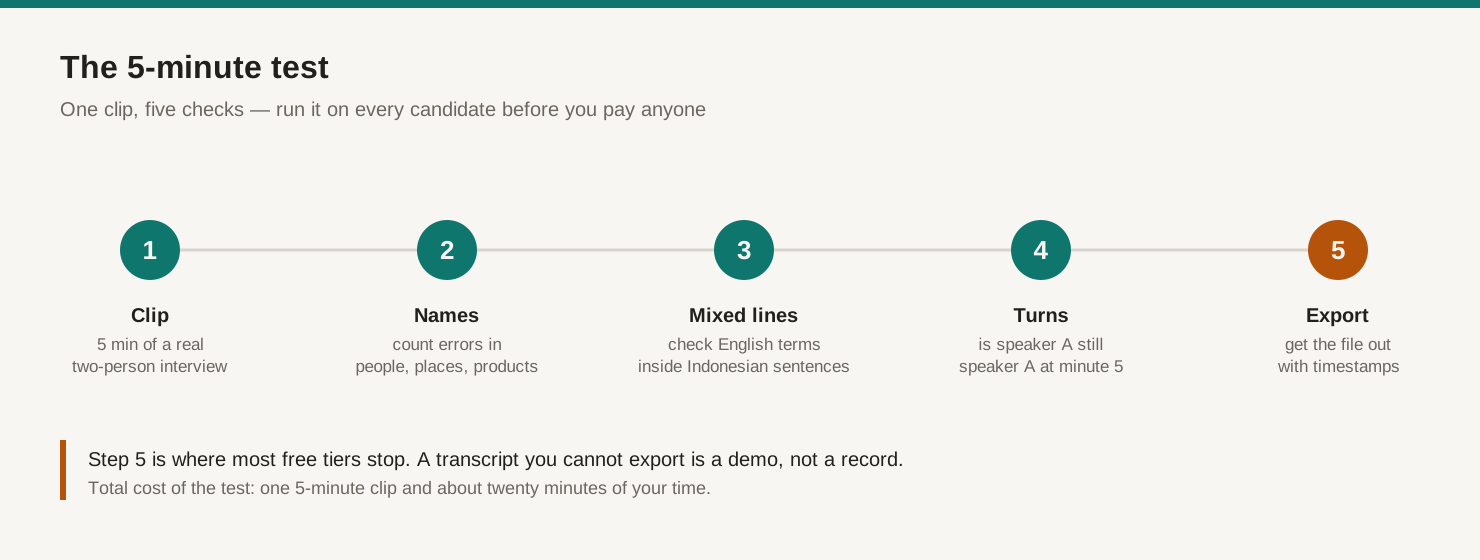
Lima pemeriksaan, dalam urutan yang benar-benar Anda temui saat mengevaluasi.
Kalau yang Anda cari adalah alur kerja setelah aplikasinya dipilih — meninjau transkrip sebelum memercayai ringkasan, menjaga kutipan tetap terikat ke audio sumber — itu sudah kami bahas terpisah di cara mengubah audio wawancara menjadi transkrip dan ringkasan yang bisa ditinjau.
Titik rawan wawancara Indonesia: kata Inggris di tengah kalimat
Bahasa Indonesia profesional itu tidak monolingual. "Nanti kita follow up setelah meeting dengan tim product" bukan bahasa Indonesia yang rusak; begitulah seorang product manager di Jakarta berbicara, dan kurang lebih begitu pula cara bicara rekruter, konsultan, dan pendiri startup. Transkrip yang mengacak potongan Inggrisnya berarti mengacak persis istilah yang paling dibutuhkan catatan Anda.
Ini hal tersulit di kategori ini, dan alasannya layak dipahami. Sebagian besar mesin menjalankan satu model monolingual per permintaan. Anda menyetel bahasa ke Indonesia, dan modelnya paling kuat pada fonetik Indonesia serta kosakata Indonesia — artinya kata Inggris yang datang di tengah kalimat akan ditransliterasikan menjadi sesuatu yang berbentuk Indonesia, atau hilang. Menyetel bahasa ke Inggris hanya membalik arah kerusakannya. Mode multibahasa atau code-switching memang ada, tetapi cakupannya jauh lebih sempit dari daftar monolingual: per Agustus 2026, Nova-3 milik Deepgram mendokumentasikan 58 bahasa satu per satu dan code-switching di tepat 10 bahasa.
Dua penawar praktis, keduanya murah. Pertama, setel bahasa sumber secara eksplisit ke Indonesia alih-alih membiarkan deteksi otomatis menyala — deteksi otomatis harus menebak dari detik-detik paling minim konteks di seluruh berkas, dan tebakan yang salah menurunkan kualitas seluruh tahap berikutnya sekaligus. Kedua, kalau aplikasinya menyediakan kosakata khusus atau daftar kata kunci, masukkan istilah Inggris dan nama diri yang sering muncul sebelum proses dijalankan, bukan sesudahnya.
Sebut saja ini masalah gado-gado: audionya memang campur sejak awal, dan setiap mesin ingin menyajikannya sebagai satu masakan.
Kalau Anda bisa menulis kode, transkripsi lebih murah dari secangkir kopi
Perbandingan paket gratis berubah bentuk sepenuhnya kalau Anda bersedia menyentuh API, dan angkanya layak diketahui bahkan jika akhirnya Anda memilih tidak.
OpenAI menagih $0,006 per menit untuk gpt-4o-transcribe dan $0,003 per menit untuk varian mini. Wawancara 47 menit Anda berbiaya 28 sen, atau 14 sen di mini. Google Cloud Speech-to-Text memberi 60 menit pertama per bulan gratis, lalu $0,016 per menit dengan data logging aktif dan $0,024 tanpa, dan mencantumkan id-ID pada model chirp maupun chirp_2 di region asia-southeast1. Whisper berlisensi MIT dan tidak berbiaya apa pun selain perangkat keras Anda sendiri.
Pada harga segitu, pengenalan suaranya sendiri nyaris gratis. Yang sebenarnya Anda beli dari produk konsumen mana pun adalah semua yang mengelilinginya: antarmuka unggah, label pembicara, stempel waktu, editor, pencarian lintas wawancara lama, ringkasan, ekspor, dan satu tempat di mana arsipnya masih ada enam bulan lagi.
Itulah pembingkaian jujur untuk pertanyaan bikin-sendiri versus beli. Kalau Anda punya tiga wawancara setahun dan bisa menjalankan skrip Python, jalankan skripnya. Kalau Anda punya tiga wawancara seminggu dan perlu menemukan satu kutipan dari bulan Maret, yang Anda cari bukan pengenalan suara — yang Anda cari adalah sistem pengarsipan yang kebetulan punya pengenalan suara.
Yang tidak bisa dilakukan paket gratis mana pun
Adil harus adil, jadi inilah batas yang berlaku untuk semua opsi di tabel tadi, termasuk kami.
Paket gratis tidak memberi pemisahan pembicara yang andal. Itu salah satu bagian termahal dari pipeline dan lazimnya disimpan untuk paket berbayar di seluruh kategori. Kalau pemisahan dua pembicara krusial bagi pekerjaan Anda, anggarkan biayanya alih-alih berharap.
Paket gratis tidak menjanjikan penyimpanan permanen. Penyimpanan itu berbiaya; penyimpanan gratis adalah kemurahan hati yang bisa dicabut lewat satu perubahan kebijakan. Ekspor apa pun yang penting dan simpan salinan Anda sendiri — yang sekaligus jadi jawaban atas pertanyaan ketergantungan vendor yang tidak pernah ditanyakan orang sampai mereka perlu pindah.
Paket gratis tidak memperbaiki lantai akurasi untuk pembicara spesifik Anda. Logat daerah, narasumber lanjut usia, audio kualitas telepon, dan campur bahasa yang padat semuanya menurunkan hasil, dan tingkat paket tidak mengubah seberapa banyak model itu pernah terpapar audio seperti milik Anda. Membayar lebih membeli menit dan fitur, bukan mesin pengenal yang berbeda.
Dan tidak ada alat, gratis maupun berbayar, yang menghapus keharusan meninjau. Ringkasan AI yang dibangun di atas transkrip yang belum ditinjau mewarisi setiap kesalahan di dalamnya — dengan percaya diri, dan tanpa terlihat.
Intinya: yang perlu dibandingkan bukan menit, tapi jumlah wawancara
Setiap paket gratis di kategori ini mengiklankan sejumlah waktu. Itu satuan yang keliru untuk pekerjaan wawancara, karena waktu hanya berarti kalau datang dalam satu potongan utuh. Seratus dua puluh menit yang dicacah jadi irisan tiga menit bernilai lebih kecil bagi jurnalis dibanding tiga puluh menit yang tidak terputus, dan keduanya bernilai lebih kecil dibanding enam puluh menit yang sanggup memuat satu percakapan penuh dengan label pembicaranya tetap utuh.
Jadi saat membandingkan aplikasi transkrip wawancara, konversikan setiap paket gratis ke satu-satunya mata uang yang berarti bagi Anda: berapa banyak wawancara saya yang sungguhan bisa ditranskrip layanan ini, dari awal sampai akhir, tanpa memotong berkasnya? Untuk beberapa paket gratis yang terkenal, jawaban jujurnya nol, dan itu tidak akan mereka tulis di halaman harga.
Lapisan pengenalan suara sudah jadi komoditas yang menuju sepertiga sen per menit. Yang masih langka untuk bahasa Indonesia adalah arsip yang bisa Anda cari, koreksi, kutip, dan tetap Anda temukan kuartal depan.
Posisi Telli.sh: kami satu opsi di antara beberapa opsi di atas, dan kami akan spesifik soal itu. Paket Free Telli.sh adalah 60 menit per bulan — lebih sedikit dari 120 menit Notta di angka judul, dan sengaja tidak dicacah oleh batas tiga menit per rekaman, sehingga satu wawancara penuh masuk sebagai satu berkas. Anda mendapat transkrip bahasa Indonesia, terjemahan ke 44 bahasa target, ringkasan AI yang dibuat dari transkripnya, dan antarmuka dalam 15 bahasa termasuk bahasa Indonesia. Di atas 60 menit per bulan, ini produk berbayar, dan kalau volume Anda kecil serta Anda bisa menjalankan skrip, jalur API memang lebih murah. Jalankan uji 5 menit ke kami dengan cara yang persis sama seperti Anda menjalankannya ke siapa pun.
Sumber
- Deepgram, "Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian", changelog tertanggal 7 Agustus 2026 — model batch yang ditingkatkan untuk Tamil dan Indonesia, model streaming yang ditingkatkan untuk Tamil dan Belarusia, Armenia (
hy) ditambahkan untuk keduanya. - Hugging Face dan Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 Agustus 2026 — Hindi sebagai bahasa Global South pertama di papan peringkat itu.
- Harga Notta, diakses 31 Agustus 2026 — paket Free 120 menit/bulan, maksimum 3 menit per rekaman, 50 unggahan berkas/bulan, 10 ringkasan AI/bulan; Pro $8,17/bulan tagihan tahunan dengan 1.800 menit/bulan.
- Harga Transkriptor, diakses 31 Agustus 2026 — Lite $9,99/bulan (300 menit), Pro $19,99/bulan (2.400 menit, $99,99/tahun untuk tagihan tahunan), Team $30/kursi/bulan (3.000 menit/kursi).
- Harga Maestra dan daftar bahasa Maestra, diakses 31 Agustus 2026 — bayar-sesuai-pakai $12 per 60 kredit, Lite $23/bulan untuk 180 menit; bahasa Indonesia tercantum untuk transkripsi, terjemahan, sulih suara, dan real-time.
- Harga TurboScribe sebagaimana diarsipkan Internet Archive — paket Free 3 transkrip per hari dengan batas berkas 30 menit dan unggahan satu berkas sekaligus; Unlimited $10/bulan, $120 per tahun, berkas hingga 10 jam. Halaman aslinya mengembalikan HTTP 403 untuk pengambilan otomatis; perlakukan angka ini sebagai indikatif dan konfirmasikan di situsnya.
- Harga Google Cloud Speech-to-Text dan daftar bahasa yang didukung, diakses 31 Agustus 2026 — 60 menit pertama per bulan gratis, $0,016/menit dengan data logging dan $0,024/menit tanpa;
id-IDpadachirpdanchirp_2diasia-southeast1. - Harga API OpenAI, diakses 31 Agustus 2026 —
gpt-4o-transcribe$0,006/menit,gpt-4o-mini-transcribe$0,003/menit. - OpenAI Whisper, berlisensi MIT; tabel
LANGUAGESpada tokenizer-nya mendeklarasikan 100 bahasa dengan bahasa Indonesia (id) di posisi ke-17, diakses 31 Agustus 2026.