Eleven Realtime переносит конкуренцию голосового ИИ за пределы голоса
ElevenLabs представила модели реального времени Mini и Max. Главное изменение — более простая организация диалога и более чёткая граница между естественной речью и выполненной задачей.
Официальное превью компонента голосового чата ElevenLabs UI для поддержки клиентов. Источник: elevenlabs/ui; copyright 2025 Eleven Labs Inc., лицензия MIT. Это пример голосового интерфейса, а не испытание модели Realtime.

Неловкий момент голосового разговора часто возникает ещё до ответа. Вы делаете паузу, вспоминая дату, а ассистент начинает говорить. Исправляете имя, а он заканчивает заранее подготовленную фразу. Голос может звучать прекрасно, хотя само общение кажется странно несогласованным. Для разработчика телефонного помощника, репетитора или интерактивного персонажа такие мелкие сбои могут значить не меньше качества синтезированной речи.
20 октября ElevenLabs представила Eleven Realtime v1 Mini и v1 Max, позиционируя их как законченные модели голосовых агентов, а не очередной компонент для самостоятельной сборки. Mini рассчитана на повседневное общение с меньшими затратами; Max — на сложные инструкции и многошаговую работу. Релиз важен тем, что объединяет больше элементов разговора в одном продуктовом решении. И заставляет серьёзнее отнестись к старому вопросу: если голос звучит компетентно, как понять, что задача действительно выполнена? Официальный анонс.
На наш взгляд, перспектива здесь — меньше времени на настройку стыков между компонентами. Проверкой станет диалог, который выдерживает исправления и даёт правильный результат. Отполированная демонстрация показывает первое впечатление. Обычный запутанный запрос клиента показывает, заслуживает ли продукт места в работе.
ElevenLabs расширяет знакомую сильную сторону до более крупной задачи
Тем, кто знает ElevenLabs прежде всего по синтетическим голосам, стоит учесть: теперь компания описывает три платформы — ElevenCreative для создания контента, ElevenAgents для работающих разговорных агентов и ElevenAPI для разработчиков. Realtime входит в более широкий замысел: сделать аудио полезным внутри приложения, а не только в виде готового файла. Это объясняет сочетание качества голоса с механизмами взаимодействия. Справка ElevenLabs для прессы.
У аудиоклипа есть чёткая граница. Текст написан, речь сгенерирована, слушатель слышит результат. Живой агент работает в меняющейся ситуации. Собеседник может перебить, изменить вопрос, добавить недостающую информацию или обнаружить, что исходный запрос был неверен. Программа должна понять, означает пауза «ваша очередь» или «я ещё думаю». Ей необходимо согласовывать своё понимание с человеком и одновременно взаимодействовать с системами за пределами диалога.
Это иная продуктовая задача, чем убедительно произнести отдельную фразу. Возьмём помощника по бронированию. Он может безупречно произнести имя клиента и всё же забронировать неправильный день, пропустив исправление. Успешному голосовому продукту нужны и уместный ритм общения, и правильная запись операции. Улучшить одно, игнорируя другое, — значит создать приятный способ сделать не то.
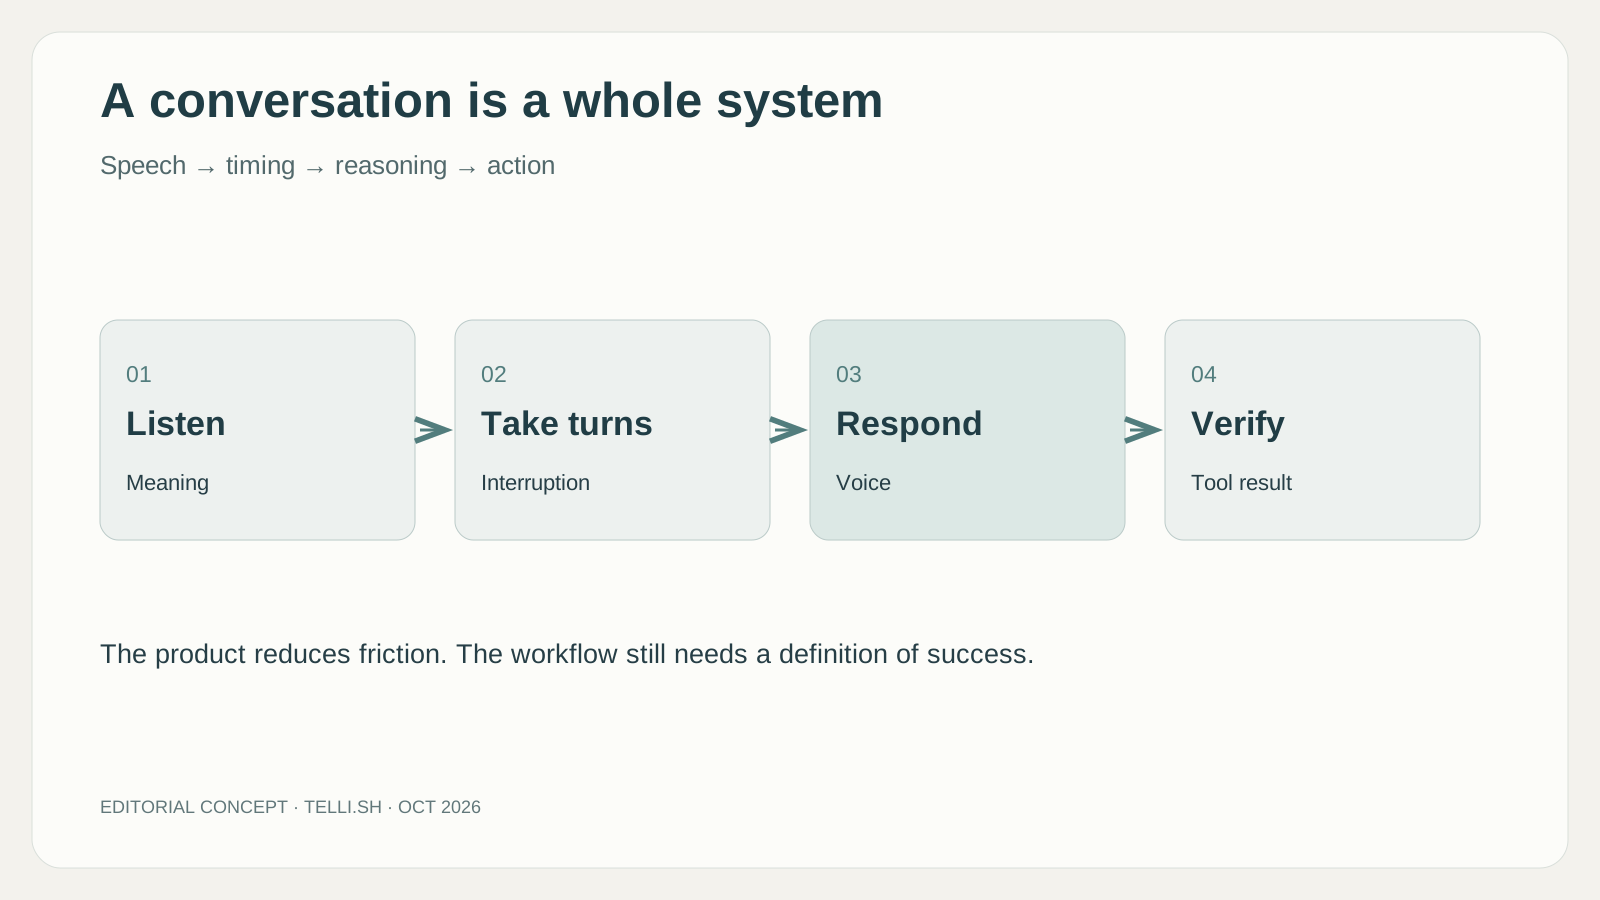
Оригинальная редакционная инфографика. Описывает пользовательский опыт, а не внутреннюю архитектуру модели.
Управляемый стек сокращает настройки и меняет область вашего контроля
Различие в документации вполне практическое. В режиме Custom разработчик выбирает языковую модель, модель речи и параметры распознавания. Режим Realtime передаёт этот выбор ElevenLabs, сохраняя инструкции агента, голос, инструменты и другие поддерживаемые настройки разговора. Доступ открывается постепенно, поэтому переключатель может ещё не появиться во всех рабочих пространствах. У Realtime также есть ограничения совместимости и региональные условия, которым должен соответствовать существующий агент. Документация моделей Realtime.
Такой обмен может быть полезен. Небольшой команде способность ассистента справляться с перебиванием может быть гораздо важнее выбора каждого компонента. Управляемая конфигурация даёт согласованную отправную точку и меньше сочетаний для поиска неисправностей. Время можно направить на вопросы клиентов, информацию, которой действительно располагает бизнес, и момент передачи разговора человеку.
Но меньше настроек означает и меньше независимых замен. Если часть поведения не подходит, команде нужно понимать, можно ли её изменить, сменить модели или вернуться к собственной конфигурации. Сравнивать следует общий труд по поддержанию пригодного к работе агента. Настраиваемый стек бывает обременительным, интегрированный — ограничивающим. Что важнее, зависит от задачи и от того, кто будет обслуживать систему после демонстрации.
Особенно это заметно, когда прототип становится общим сервисом. Его создатель может знать все особенности. Сотрудники поддержки, клиент и следующий разработчик столкнутся с поведением без этого знания. Продукт, последовательно принимающий распространённые решения, может быть ценен и при меньшем числе вариантов. Последовательность полезна, когда её можно увидеть, проверить и согласовать с обязанностями сервиса.
Другие голосовые стеки размещают контроль в иных точках
Подход ElevenLabs яснее виден рядом с альтернативами. Руководство OpenAI по голосовым агентам отличает речевое взаимодействие в реальном времени от цепочки, которая расшифровывает речь, запускает текстового агента и затем синтезирует ответ. В описании цепочек подчёркиваются проверяемый промежуточный текст и независимая замена компонентов. Это сравнение архитектур, а не свидетельство о нераскрытом устройстве Eleven Realtime. Один и тот же клиентский диалог можно построить вокруг разных точек наблюдения и изменения поведения.
Текстовая стадия полезна, если организации нужна определённая контрольная точка. Обучающий сервис может проверять, как агент понял ответ ученика; специализированная поддержка — обрабатывать терминологию до произнесения ответа. Промежуточная запись даёт конкретный объект для проверки. Вместе с тем появляется ещё одна граница компонентов, которую нужно поддерживать. Для живого персонажа или свободной беседы разработчик может предпочесть более цельное взаимодействие с другим набором средств контроля.
| Подход | Что привлекает разработчика | Что ещё нужно решить |
|---|---|---|
| Управляемый режим реального времени | Меньше решений о компонентах и единая поддерживаемая конфигурация диалога | Подходят ли поддерживаемые настройки сервису |
| Цепочка речи и текста | Проверяемый промежуточный текст и независимая замена компонентов | Как собранные стадии сохраняют ритм и исправления |
| Оркестрация на основе фреймворка | Явное поведение приложения для реплик, инструментов и передач | Кто поддерживает это поведение при смене поставщиков |
Решающий фактор — где команде нужна надёжная контрольная точка: в промежуточной расшифровке, событии разговора или выполненном действии. Поэтому команда вполне может обоснованно сохранить собственную систему и после перспективного интегрированного релиза. Коммерческая возможность ElevenLabs — сделать управляемый вариант достаточно хорошим для большего числа задач, чтобы подробная сборка стала выбором, а не входным билетом в разработку голосового сервиса.
Заминка и перебивание требуют разных реакций
Подход фреймворков добавляет ещё одно измерение. Документация LiveKit по обработке реплик явно рассматривает ложные прерывания: голосовая активность может остановить агента, даже если пользовательская расшифровка не появилась, а после заданного тайм-аута речь может продолжиться. Это не означает, что ElevenLabs использует такой же механизм. Это показывает, почему кажущаяся вежливость голосового продукта зависит от поведения приложения, а не только от модели, подбирающей слова.
Представьте разницу между «подождите, другой адрес» и кашлем слушателя. Оба события создают звук во время реплики ассистента. Только одно обязательно меняет запрос. Сервис, начинающий объяснение заново после каждого фонового звука, утомляет; игнорирующий настоящее исправление — подрывает доверие. Полезно сравнивать восстановление разговора с правильным контекстом, а не только скорость обнаружения активности в аудиоканале.
Это расширяет и состав участников пилота. Людям, подбирающим незнакомое слово, говорящим на втором языке или в более медленном темпе, может требоваться разная длительность тишины. Это предлагаемые группы оценки, а не заявления об измеренной доступности или поддержке языков. Команде стоит слушать, дают ли пользователям закончить мысль и приходится ли после сбоя повторять весь запрос. Средняя скорость ответа способна скрыть такую нагрузку.
Обнадёживает возможность улучшить этот опыт управляемой разговорной моделью, не заставляя каждого клиента создавать собственную логику времени. Остаётся вопрос, насколько конкретное приложение позволяет изменить неподходящий стандартный ритм. Для демонстрации это вполне предметная задача: дать человеку замешкаться, исправить деталь и продолжить, затем проверить понимание агента и данные, реально переданные инструменту. Так удобство разговора связывается с проверяемым результатом.
Mini и Max разделяют беседу и сложное выполнение
Два названия должны подталкивать к выбору по нагрузке, а не к автоматической покупке большей модели. Персонаж для языковой практики и сервисный агент, выполняющий возврат средств, решают разные задачи. Первому нужно поддерживать разговор и правильно реагировать на ошибки. Второму, возможно, придётся найти правила, определить заказ, проверить условия и сообщить результат внешнего действия.
Большая модель может быть излишней для лёгкой беседы, а дешёвая — оказаться дорогой, если постоянно передаёт неразрешённые обращения сотрудникам. Стоимость минуты полезна для оценки счёта. Стоимость правильно завершённого взаимодействия полезнее для решения, нужен ли системе такой рабочий процесс. Второй показатель включает восстановление, повторные звонки и труд людей, исправляющих правдоподобные ошибки.
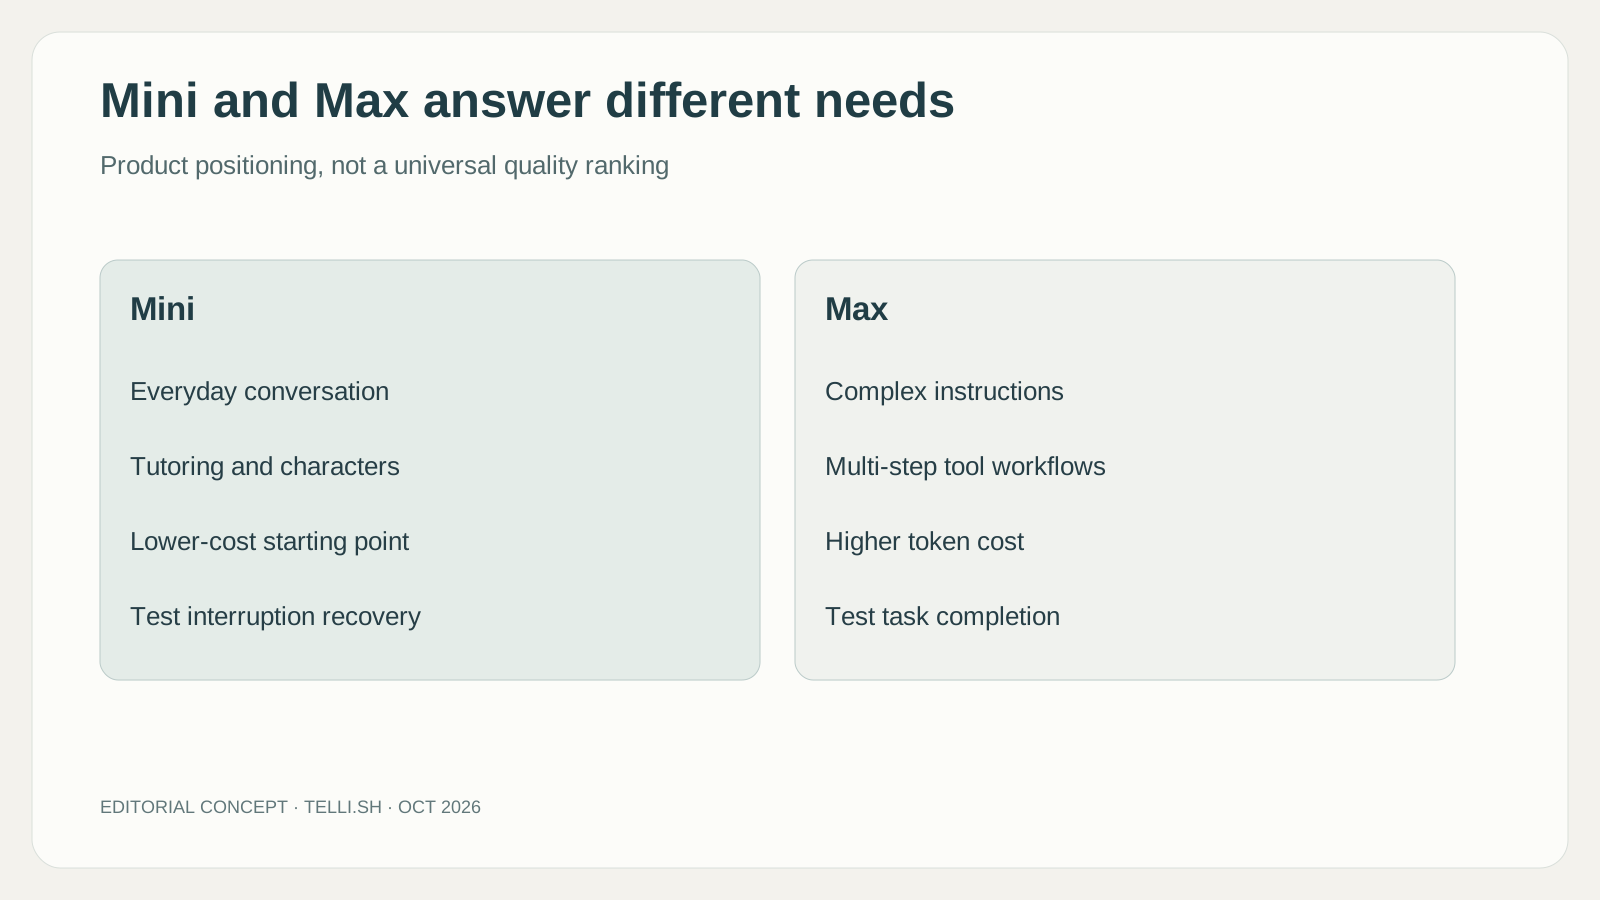
Оригинальная инфографика на основе позиционирования поставщика. Это не измеренный рейтинг для всех языков и задач.
Анонс приводит результаты тестов со ссылкой на Artificial Analysis. В использовании инструментов указано 87.1% завершения для Max и 60.3% для Mini, а опубликованные оценки динамики разговора немного выше у Mini. Это результаты бенчмарков, опубликованные поставщиком, а не наши измерения в эксплуатации. Они полезно показывают, что разговорная беглость и завершение работы с инструментами могут расходиться, но не устанавливают успешность звонков конкретной компании. Анонс и контекст бенчмарков.
Поэтому команде не стоит сводить всё качество к одному месту в рейтинге. Если агент в основном рассказывает о музейной экспозиции, ритм общения может быть главным. Если он изменяет бронирование, важнее точное конечное состояние. Релиз даёт две отправные точки, но определение качества по-прежнему задаёт задача.
Три обычные ситуации показывают разные сильные стороны
Представьте ученика, разыгрывающего заказ в ресторане на другом языке. Он останавливается посреди заказа, ищет слово и начинает снова. Полезный репетитор оставляет место заминке и помогает, не перехватывая инициативу. Выигрыш — уверенность продолжать практику. Неудача — ассистент, принимающий каждую паузу за разрешение прочитать лекцию. Этот пример прежде всего о сотрудничестве в разговоре; качество преподавания требует отдельной проверки.
Теперь возьмём запись на приём. Звонящий сначала просит пятницу, а затем говорит: «Вообще-то следующий понедельник, после обеда». Ассистент должен перенести исправление в предлагаемую запись и подтвердить важные детали до значимого шага. Когда система бронирования ответит, устное подтверждение должно отражать её ответ. Дружелюбное «всё готово» до принятия изменения системой было бы ошибкой, даже если каждая фраза звучала естественно.
Интерактивный персонаж создаёт третий баланс. В вымышленном мире допустим творческий ответ, но игрок всё равно ожидает, что персонаж помнит текущую сцену и останавливается при перебивании. Бизнес-результатом здесь может быть увлекательная беседа, а не завершённая операция. Поведение, оживляющее персонажа, в поддержке может выглядеть уклончивостью. Вот почему нужно оценивать разные задачи, а не считать голосовых агентов однородной категорией.
Совместимость удешевляет пробу, но ограничения стоит прочесть
ElevenLabs предлагает доступ через ElevenAgents и Realtime API, совместимый с OpenAI. Пример в анонсе меняет адрес назначения и модель существующего клиента, но отдельно указывает подключение только по WebSocket и отличает API от управляемой платформы. Поэтому интеграция WebRTC требует большего, чем замена имени модели; нельзя считать, что управляемые каналы или база знаний автоматически появляются вместе с API. Доступ к API и замечания о миграции.
Совместимость ценна облегчением сравнения. Разработчик сохраняет больше существующего приложения, пробуя другого поставщика. Так реальнее сопоставить одинаковую задачу, инструкции и инструменты, а не разрозненные демонстрации. Это не отменяет проверки событий, переподключений, ответов инструментов и того, как приложение показывает сбой.
Эти менее эффектные детали формируют клиентский опыт. Если связь пропала после запроса бронирования, приложению нужно знать, состоялось ли оно, прежде чем просить повторить запрос. Если инструмент превысил время ожидания, повтор его вызова может иметь иные последствия, чем повтор устного вопроса. Миграция модели успешна, когда всё приложение правильно ведёт себя в таких ситуациях, а не только воспроизводит первый аудиоответ.
Естественный голос способен представить незавершённое действие завершённым
При выборе моделей сохраняйте условия сравнения. Если большой модели дать более чистую базу знаний, лучший промпт и надёжные инструменты, испытание не покажет, какое изменение помогло. Начните с одинаковых представительных запросов и изучите сбои, прежде чем менять окружение. Нарушение ритма может потребовать настройки разговора; неверное объяснение правил — лучших источников; незавершённая запись — исправления интеграции инструмента. Более способная модель может помочь с частью проблем, но не должна скрывать сломанную связь, которая останется сломанной при любом выборе.
Сильнейшее достоинство продукта может одновременно затруднить обнаружение ошибок. Люди воспринимают тон, темп и уверенность как сигналы. Беглый ассистент способен звучать так, будто всё проверил, хотя лишь сформировал правдоподобный ответ. В текстовом интерфейсе у пользователя может быть больше возможности изучить ответ. Во время звонка разговор движется дальше, и спорная деталь растворяется в потоке.
Ответ в дизайне должен быть предметным, без театральности. Разделяйте объяснение, предлагаемое действие и подтверждённый результат. Позвольте агенту сказать, что он проверяет данные, что запрос ожидает выполнения или нужна помощь человека. Эти состояния должны соответствовать приложению, а не служить успокоительными словами в инструкции. Честная пауза часто лучше мгновенного ответа, создающего последующую работу по исправлению.
Передаче человеку тоже нужна непрерывность. Звонящий, попавший к сотруднику через несколько минут, не должен восстанавливать детали по памяти. Полезная передача содержит актуальный запрос, важные исправления и незавершённый шаг. Там, где агент сомневался, должна сохраниться неопределённость. Иначе автоматизация экономит время в начале звонка, перекладывая тот же труд на человека, которому предстоит разобраться.
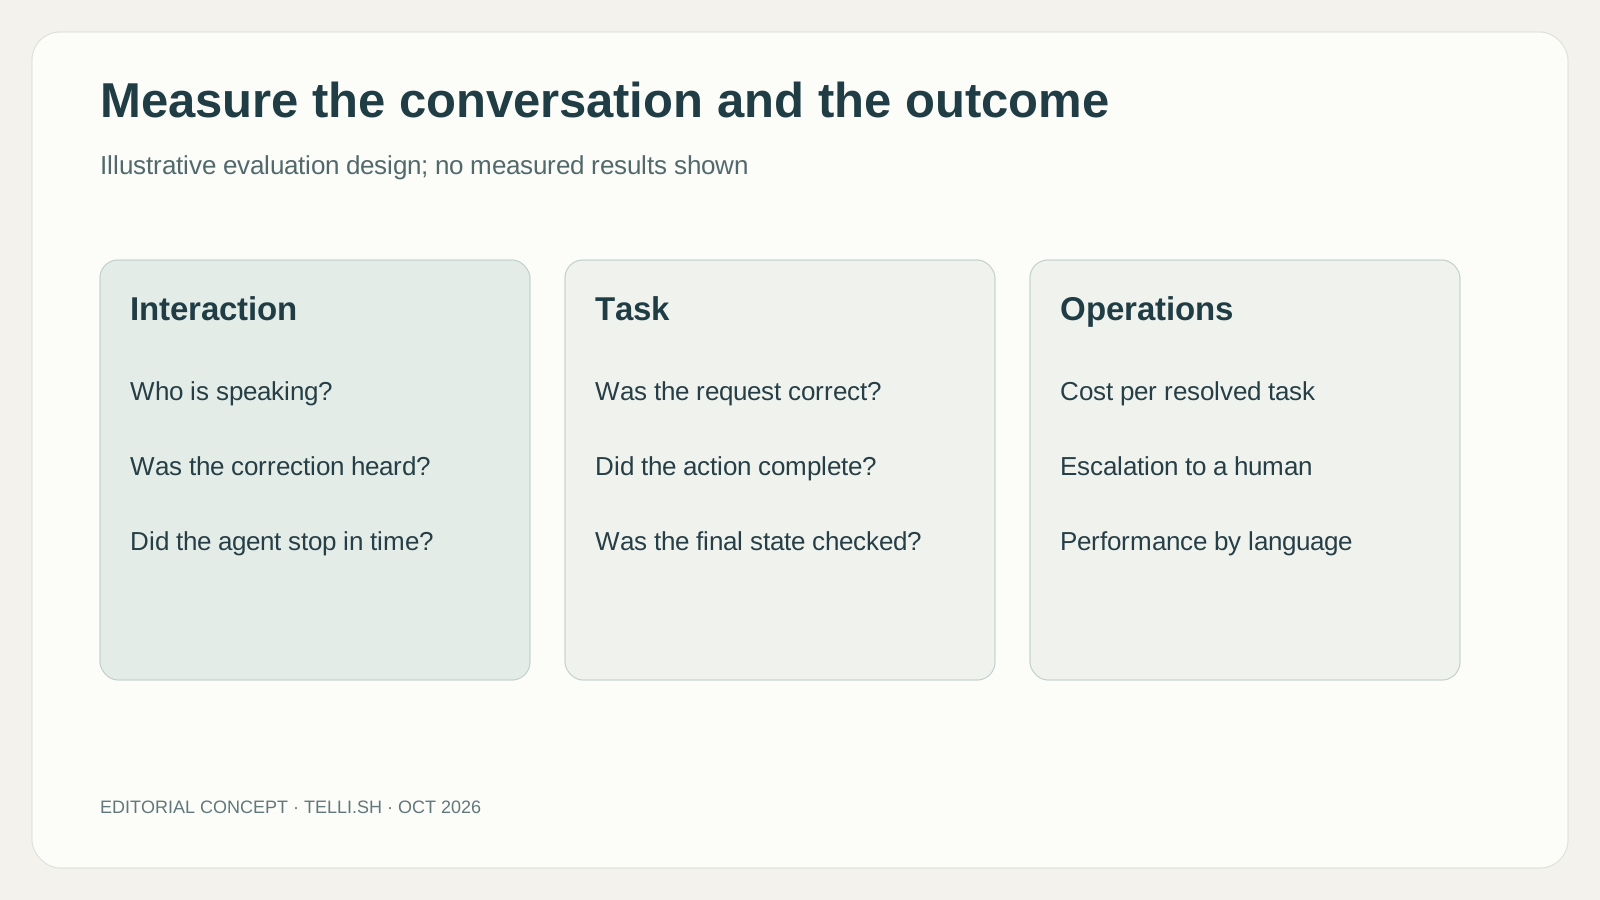
Оригинальная редакционная схема оценки. Результаты испытаний не представлены.
Следующий бенчмарк — разрешённый разговор
Разумный пилот использовал бы представительные разговоры с разрешения участников: короткие и длинные запросы, перебивания, исправления, разные языки и случаи передачи специалисту. Проверяйте, состоялось ли нужное действие, как часто вмешивались люди и сколько стоило завершённое взаимодействие. Сохраняйте скорость первого аудио как один показатель, но учитывайте и быстрые ответы, потребовавшие исправления. Это предложение методики, а не проведённые нами испытания Realtime.
Самый перспективный результат — агент, задающий меньше ненужных вопросов и всё же готовый задать необходимый. Репетитор должен дать ученику закончить мысль. Помощник по бронированию — проверить исправленную дату. Агент поддержки — сохранить контекст при передаче. Эти улучшения скромны в описании и существенны в опыте: они убирают мелкие помехи, делающие автоматизированные беседы утомительными.
Eleven Realtime придаёт этому направлению конкретную продуктовую форму. Он может позволить большему числу команд создавать полезные голосовые взаимодействия без освоения каждого элемента аудиостека. Долгосрочное значение будет зависеть от того, приводит ли интегрированное разговорное поведение к надёжно выполненной работе. Голос вовлекает пользователя в беседу. Результат определяет, захочет ли он следующей.
Источники
-
Анонс Eleven Realtime и контекст бенчмарков, 20 октября 2026 года.
-
Режимы моделей Realtime, доступность и ограничения, проверено 21 октября 2026 года.
-
Сведения о платформах ElevenLabs, проверено 21 октября 2026 года.
-
Архитектуры голосовых агентов OpenAI, проверено 21 октября 2026 года.
-
Обработка реплик LiveKit, проверено 21 октября 2026 года.
Сохраните разговор доступным для проверки
Если вам нужно отдельное место для разрешённых записей и проверенных заметок, один из вариантов — Telli.sh. Начните с аудиозаметки.