Может ли старая DDR4 дать серверу для ИИ больше запаса?
Netlist и Marvell готовят к SC26 решения CXL на базе DDR4. Разбираемся, где поможет дополнительная память хоста и что измерить перед покупкой.
Внутренний поиск работает быстро до утреннего наплыва запросов. Сервису нужно извлечь фрагменты из тысяч документов, прежде чем отправить запрос на ответ ускорителю. Часто используемые отрывки помещаются в памяти, но при повторном поиске по остальной коллекции приходится снова обращаться к накопителю. Люди ждут дольше, хотя у GPU ещё есть свободные ресурсы. Команде, поддерживающей сервис, увеличение кеша на сервере может помочь больше, чем ещё один GPU.
Два анонса перед SC26 показывают дополнительный способ увеличить такой кеш. 10 ноября консорциум CXL сообщил, что специалист по памяти Netlist планирует показать прототип NVvault-D4. Он позволяет использовать имеющуюся DDR4 как расширение памяти хоста по Compute Express Link (CXL). 13 ноября производитель микросхем Marvell объявил о стендах партнёров с контроллерами расширения памяти Structera X и памятью DDR4 или DDR5. В анонсах речь идёт об оборудовании, которое планировали показать. Цены, сроки поставки и результаты запланированных демонстраций остаются открытыми. SC26 проходит 15–20 ноября в Чикаго, основные стенды работают 17–19 ноября по местному времени. Анонс Netlist от консорциума CXL · Анонс Marvell к SC26 · Официальные даты SC26
Покупателю важно выяснить, удержит ли дополнительная ёмкость в памяти достаточно данных для полезной нагрузки без неприемлемого замедления самых долгих запросов. Если у команды уже есть запас DDR4, повторное использование может быть выгодно при условии, что модули пройдут квалификацию и система сможет размещать там нужные данные. Польза зависит от того, какие операции ждут сейчас и где возникает это ожидание.
Куда добавляется память
CPU обращается к локальной DRAM напрямую через свой контроллер памяти. Если сервер и устройство расширения памяти совместимы, CPU также может обращаться к памяти за этим устройством по каналу CXL. Расширение даёт дополнительное место для данных на стороне хоста. Путь доступа, пропускная способность и задержка отличаются от локальных каналов DRAM. Прошивка и операционная система должны сделать дополнительную ёмкость доступной, а приложению или ОС нужна политика размещения страниц под конкретную нагрузку.
Это важно, если кто-то хочет использовать запас DDR4 в новом сервере. Сервер может сохранить локальную DDR5 и обращаться к DDR4 через поддерживаемое устройство расширения. По-прежнему важны контроллер устройства, квалификация модулей и совместимость с хостом. Прототип на имеющейся DDR4 даёт повод изучить повторное использование. Какие модули примет поддерживаемая конфигурация и в каких системах они смогут надёжно работать, ещё предстоит уточнить.
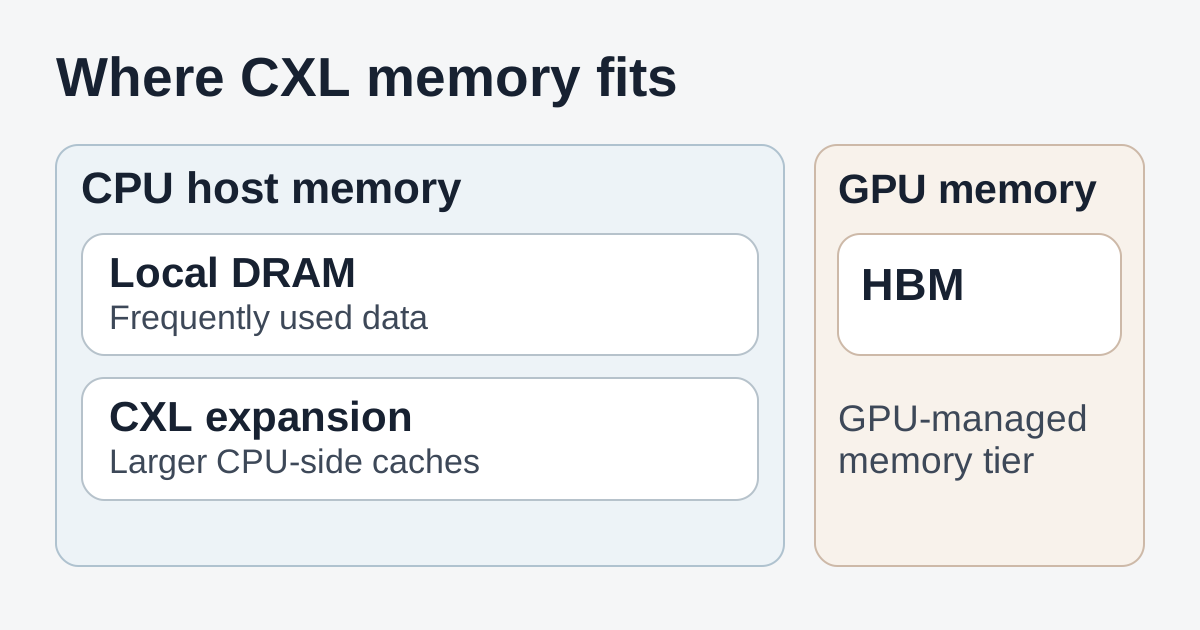
Локальная DRAM может хранить часто используемые страницы, а уровень расширения — более крупные кеши на стороне CPU. Высокоскоростная память ускорителя имеет свои пределы ёмкости и пропускной способности.
В примере с поиском часто читаемые данные индекса можно оставить в локальной DDR5, а более крупный и реже используемый кеш фрагментов или результатов переместить на уровень CXL. Когда сервис найдёт нужные фрагменты, его серверная часть для инференса передаст их модели на GPU. Веса модели и данные, необходимые вычислительным ядрам ускорителя, должны помещаться там, откуда их читает движок инференса. Расширение CXL в этих анонсах касается ёмкости памяти хоста. Высокоскоростная память GPU, обычно называемая HBM, остаётся отдельным ресурсом.
Начните с трассировки времени обработки запросов. Если CPU постоянно ждёт данных, вытесненных из кеша, дополнительная память хоста может сократить обращения к накопителю. Если модель большую часть времени читает веса из памяти GPU, а хост редко простаивает, та же покупка может почти не повлиять на время ответа. Ускорение извлечения данных может быть заметно, даже если сама модель работает с прежней скоростью. Измерьте оба этапа, прежде чем объяснять изменения всего сервиса одним из них.
Три прототипа Netlist рассчитаны на разные задачи
Для повторного использования DDR4 интересен NVvault-D4. Консорциум называет среди целевых применений виртуальные машины, базы данных в памяти, высокопроизводительные вычисления и корпоративные нагрузки. Возьмём сервер виртуализации. Самые активные виртуальные машины можно оставить в локальной памяти и проверить, удастся ли переместить менее активные страницы гостевых систем на уровень расширения. Команда базы данных могла бы проверить то же с частью кеша чтения. Для неё нужна политика распределения, сохраняющая страницы чувствительных к задержке запросов близко к CPU. Это возможные пилоты для решения по увеличению ёмкости. Результатов на рабочих нагрузках в анонсе нет. Анонс Netlist от консорциума CXL
Два других проекта Netlist показывают, почему важно смотреть на обозначение модели. NVvault-HM использует DRAM как кеш перед памятью на базе NAND. В анонсе обсуждаются перемещение данных и телеметрия, а среди применений упомянуты кеши «ключ — значение» для ИИ и аналитика. NVvault-PM — отдельная разработка CXL Type 3 с DRAM, резервированием на NAND и встроенным источником энергии для работы при потере питания. В анонсе PM позиционируется для сохранения кеша «ключ — значение», контрольных точек и восстановления. Чтобы оценить резервирование или сохранность данных, нужно узнать, как конкретная разработка ведёт себя в нужных сценариях отказа. Анонс D4 не даёт оснований приписывать ему свойства хранения или восстановления двух других проектов. Анонс Netlist от консорциума CXL
Кеш «ключ — значение» языковой модели даёт отдельный наглядный пример теста ИИ. Он хранит данные механизма внимания для предыдущих токенов, чтобы модель могла использовать их снова. Движок инференса с выгрузкой в память хоста может перемещать страницы кеша неактивных сессий из памяти GPU и загружать их обратно при возобновлении сессий. Можно проверить, сколько дополнительных сессий удастся сохранить и сколько времени добавляет перенос данных при возобновлении запроса. Размещение и копирование зависят от движка и сервера. Это возможный эксперимент для многоуровневой памяти хоста. В самом анонсе Netlist кейсы KV-кеша прямо относятся к HM и PM.
Анонс Marvell даёт покупателям второй вариант реализации, за которым стоит следить. Партнёры компании планируют показать системы на семействе контроллеров Structera X с DDR4 и DDR5. Программа и комплект материалов для прессы дают контекст по выставке и линейке. Покупателям ещё нужно выяснить, какие конфигурации серверов квалифицирует поставщик, какую память они принимают и как будет обслуживаться система целиком. Изображения микросхем в комплекте относятся к семейству продуктов и даны для справки. Программа павильона консорциума CXL на SC26 · Анонс Marvell к SC26 · Пресс-кит Marvell Structera
Сначала измерьте самые медленные запросы
Среднее значение может скрыть запросы, из-за которых приложение кажется медленным. В поисковом сервисе популярные документы могут давать быстрые попадания в кеш весь день, а менее востребованные заставляют те же процессы снова обращаться к уровню расширения. Увеличение времени самых долгих запросов может быть приемлемо в ночном пакетном индексировании. Пользователь, ждущий результата поиска, может заметить его сразу. Конфигурацию памяти нужно оценивать по реальным целевым показателям сервиса на пике нагрузки.
В 2025 году независимые авторы исследования MELODY показали, почему это важно. Они изучили 265 нагрузок на четырёх реальных устройствах памяти CXL, пяти платформах CPU и семи уровнях задержки. Они анализировали чувствительность в субмикросекундном диапазоне 140–410 нс и выяснили, что при работе с памятью CXL важны характер нагрузки, задержки самых медленных запросов и поведение CPU. В статье испытанные расширители названы CXL-A — CXL-D. Результаты не дают оценки производительности систем, анонсированных к SC26. Покупателю исследование показывает, почему средняя задержка или один удачный тест не позволяют судить о поведении конкретного сервера. Исследование MELODY на ASPLOS 2025 · Полный текст статьи
Если платформа позволяет, запланируйте три сравнения. Сначала воспроизведите работу сервиса на имеющейся локальной DRAM. Затем испытайте большую ёмкость на хосте с несколькими уровнями памяти. Наконец, возьмите полностью локальную конфигурацию той же суммарной ёмкости как базу для содержательного сравнения. Учебный пример подбора ёмкости — 256 ГиБ локальной DRAM плюс 256 ГиБ доступного расширения против 512 ГиБ локальной DRAM. Используйте сопоставимые приложение, набор данных, настройки ПО и подаваемую нагрузку. Зафиксируйте вынужденные различия в платформах или локальных каналах памяти. Если рабочая альтернатива — вытеснение данных на накопитель или распределение по нескольким хостам, измерьте время и стоимость этого варианта.
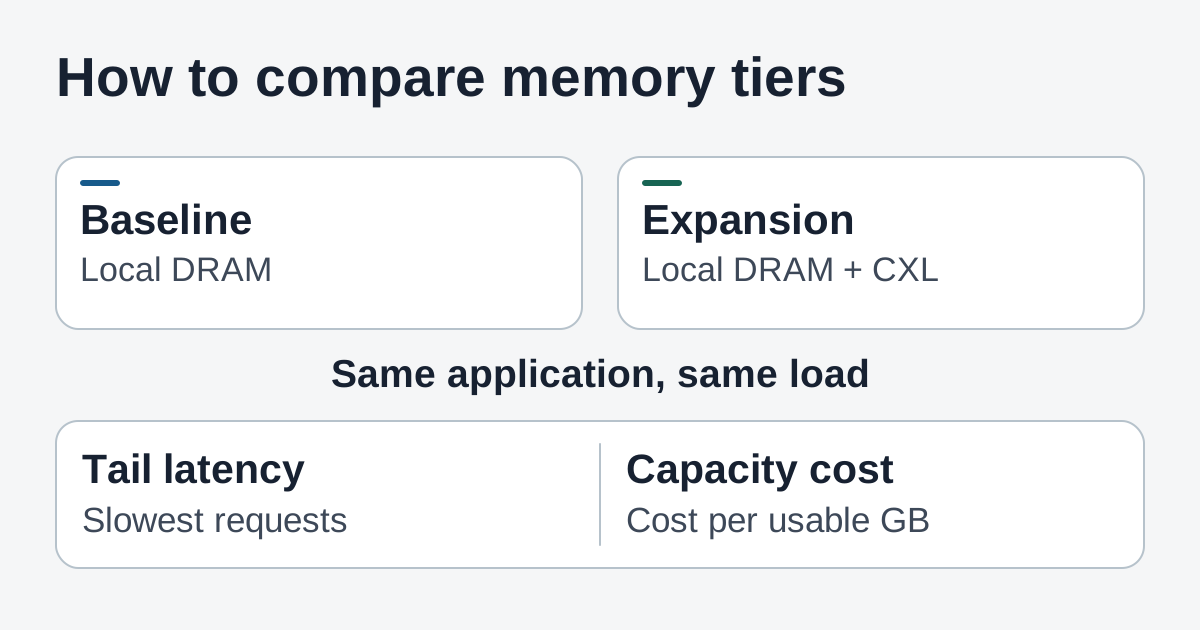
Сравнивайте одну и ту же нагрузку и трафик на обеих конфигурациях. Проверьте самые долгие запросы и посчитайте стоимость единицы доступной ёмкости.
- Воспроизведите трафик, заполняющий кеш. Используйте реалистичную смесь запросов с частыми и редкими обращениями к документам. Проведите тест с холодного состояния и после прогрева кеша. Следите за медианой, p95 и p99 задержки запросов, частотой ошибок и пропускной способностью при одинаковой параллельности. В поиске с ИИ измеряйте извлечение данных и инференс отдельно, чтобы ускорение одного этапа не скрывало замедление другого.
- Проверьте, какие данные действительно переместились. Изучите выделение памяти по уровням и узлам NUMA CPU, миграцию и освобождение страниц, если эти сведения доступны, а также счётчики канала или устройства, которые предоставляет платформа. Удачный тест мог оставить почти все запросы в локальной DRAM. Неудачный тест мог по умолчанию разместить часто читаемые страницы индекса на удалённом уровне. Записывайте политику размещения вместе с каждым набором замеров.
- Воспроизведите тяжёлый рабочий день. Запустите вторую задачу на фоне активной интерактивной нагрузки, прогрейте кеш после перезапуска и посмотрите, что происходит при достижении пределов памяти. Уточните, как ОС сообщает об ошибках устройства или памяти, как эксплуатация определяет затронутый хост и как сервис возвращается к прежней политике выделения памяти. Восстановление нужно проверить для любой конфигурации, которую команда будет поддерживать.
- Определите критерии приёмки до просмотра графиков. Возьмите текущие цели по p99 и частоте ошибок за исходные. Запишите, сколько дополнительной памяти должно быть доступно при соблюдении этих целей и в каких случаях допустимо более медленное восстановление. Если система укладывается в цели только при высокой доле попаданий в кеш, используйте трассы особенно загруженных дней, чтобы проверить, сохраняется ли эта доля при рабочем трафике.
Посчитайте полную стоимость повторного использования
Имеющиеся DIMM могут сделать строку о памяти в смете привлекательнее. Потребуются также устройство расширения, поддерживаемый хост или обновление и квалифицированные модули, плюс время специалистов на внедрение и поддержку. Устройству нужен подходящий слот или способ подключения к платформе. Сверьте распределение линий PCIe с потребностями накопителей, сети и ускорителей. Расширение памяти теряет смысл, если отнимает ресурсы, которые той же нагрузке нужны для перемещения данных.
Рассчитайте цену доступного ГиБ при нужном уровне обслуживания. Учтите ёмкость, зарезервированную платформой или недоступную из-за необходимости оставить достаточно страниц в локальной памяти, а также питание и охлаждение, квалификацию для парка серверов, запчасти и поддержку за весь плановый срок службы. Узнайте, кто выпускает обновления прошивки и как система показывает состояние оборудования и ошибки памяти. Если новый уровень позволяет выполнять на том же хосте работу, для которой иначе нужен накопитель или ещё один сервер, измерьте экономию и учтите накладные расходы обеих схем. Для прямого сравнения запустите сервис на пике частоты запросов на обеих архитектурах и сопоставьте стоимость удержания времени ответа в заданных пределах.
После SC26 следите за квалифицированными конфигурациями, документированной поддержкой модулей, совместимостью ПО и трассировками реальных нагрузок. После выпуска системы у команд с большим вторичным рабочим набором может появиться ещё один способ расширить имеющийся сервер. Показательным был бы сервис, который удерживает больше данных документов в памяти хоста, реже обращается к накопителю и дешевле соблюдает прежний лимит p99. С таким результатом проще обосновать следующую закупку.
Источники
- Анонс Netlist для SC26 от консорциума CXL, 10 ноября 2026 года
- Анонс Marvell о партнёрах и подключениях на SC26, 13 ноября 2026 года
- Программа павильона консорциума CXL на SC26 и материалы мероприятия
- Пресс-кит линейки Marvell Structera
- Официальная программа и даты выставки SC26
- Статья MELODY и данные публикации, ASPLOS 2025 · Полный текст статьи
Чтобы хранить записи пилота, трассировки нагрузки и решения о закупках в одном месте, создайте аккаунт Telli.sh.