Sau khi mô hình ra mắt: 5 cách AI tiếp tục tiến bộ và ý nghĩa đối với AGI
Một đợt huấn luyện không còn kể hết câu chuyện về năng lực của mô hình. Nghiên cứu từ Reflexion và Voyager đến AlphaEvolve, huấn luyện lúc sử dụng và các thí nghiệm học liên tục năm 2026 cho thấy hệ thống AI có thể giữ lại kinh nghiệm hữu ích như thế nào. Điều gì thực sự thay đổi, bằng chứng vững đến đâu và vì sao cải thiện đáng tin cậy quan trọng hơn một vòng lặp vô tận.
Tháng 5 năm 2025, các nhà nghiên cứu báo cáo một tác tử lập trình nâng kết quả SWE-bench từ 20,0% lên 50,0% bằng cách thay đổi mã của chính tác tử. Mô hình ngôn ngữ nền bên dưới không cần đổi sang thế hệ mới. Hệ thống bao quanh nó đã học được cách làm việc tốt hơn. Đó là Darwin Gödel Machine, và sự phân biệt này thú vị hơn điểm số nổi bật.
Chúng ta thường mô tả tiến bộ AI như chuỗi mô hình đã hoàn thiện: huấn luyện một mô hình, phát hành, rồi chờ phiên bản thay thế thông minh hơn. Một hướng nghiên cứu ngày càng mở rộng đặt câu hỏi về những gì diễn ra giữa các lần phát hành đó. Liệu một hệ thống có thể học từ lần thử thất bại, giữ lại kỹ năng hữu ích, cải thiện công cụ hoặc điều chỉnh một phần trọng số trong khi làm việc không?
Theo tôi, đây là một trong những lý do đáng tin cậy nhất để lạc quan về AI có tính tổng quát hơn. Nhưng sự lạc quan cần có cách gọi tên chính xác. Bài viết phân biệt năm kiểu cải thiện, xem xét các kết quả đến tháng 7 năm 2026 và giải thích những kiểm tra mà một hệ thống liên tục tiến bộ phải vượt qua trước khi tiến bộ đó đáng được tin tưởng.
Lập luận trong ba ý
- Một mô hình không thay đổi vẫn có thể tạo nên hệ thống mạnh hơn khi bộ nhớ, công cụ hoặc quy trình giải quyết vấn đề được cải thiện.
- Các nhà nghiên cứu cũng đang thử nghiệm việc cập nhật trọng số thực sự trong lúc sử dụng. Ghi nhớ cuộc trò chuyện và huấn luyện mạng nơ-ron vẫn là hai thao tác khác nhau.
- Tiến bộ hướng tới AGI đòi hỏi việc học hữu ích có thể chuyển sang tình huống mới, giữ được năng lực trước đó và nằm dưới sự kiểm soát của con người. Lặp lại một vòng xử lý chỉ là bước khởi đầu.
Mô hình cố định chưa bao giờ là trần năng lực cố định cho mọi nhiệm vụ
Huấn luyện xác lập các tham số của mô hình: những giá trị số dùng để xử lý đầu vào và tạo đầu ra. Trong quá trình suy luận thông thường, các giá trị đó giữ nguyên. Điều này không có nghĩa câu trả lời chỉ do huấn luyện quyết định. Cung cấp bằng chứng liên quan, một máy tính hoạt động đúng hoặc quy trình tìm kiếm tốt hơn, và hiệu năng của hệ thống có thể thay đổi mà không cần đổi các tham số đó.
Nghiên cứu về tính toán lúc suy luận đã giúp đo lường điều này. Trong nghiên cứu tháng 8 năm 2024, Charlie Snell và cộng sự báo cáo hiệu quả cao hơn trên 4 lần so với mốc so sánh best-of-N khi phân bổ thích ứng lượng tính toán bổ sung cho suy luận toán học. Kết quả phụ thuộc vào bài toán và thiết lập đánh giá; nó không nói rằng bất kỳ mô hình nhỏ nào cũng giải được mọi thứ nếu được chạy đủ lâu. Bài báo ngày 6 tháng 8 năm 2024.
Câu hỏi trở thành: điều gì thay đổi, và điều gì còn lại sau nhiệm vụ hiện tại? Có năm cơ chế cần phân biệt.
| Cơ chế | Điều gì thay đổi? | Điều gì có thể được giữ lại? | Điều gì chưa được chứng minh? |
|---|---|---|---|
| Tìm kiếm hoặc chỉnh sửa lúc suy luận | Các câu trả lời ứng viên và quá trình suy luận hiện tại | Thường không có gì, trừ khi được lưu rõ ràng | Năng lực mô hình tăng lên lâu dài |
| Bộ nhớ bên ngoài | Thông tin, phản hồi và kinh nghiệm truy xuất được đã lưu | Bản ghi dành cho các nhiệm vụ sau | Trọng số mô hình đã học những bản ghi đó |
| Cải thiện công cụ hoặc tác tử | Kỹ năng thực thi được, câu lệnh và mã hoạt động | Cấu hình hệ thống có thể tái sử dụng | Mô hình nền bên dưới đã thay đổi |
| Huấn luyện lúc sử dụng | Một số tham số có thể huấn luyện trong khi xử lý đầu vào mới | Phụ thuộc phương pháp và chính sách đặt lại | Tự động ghi nhớ suốt đời xuyên suốt người dùng và nhiệm vụ |
| Học tham số liên tục | Tham số mô hình qua một chuỗi trải nghiệm | Năng lực đã cập nhật, nếu giữ lại thành công | Không còn quên, lệch hành vi hoặc cập nhật có hại |
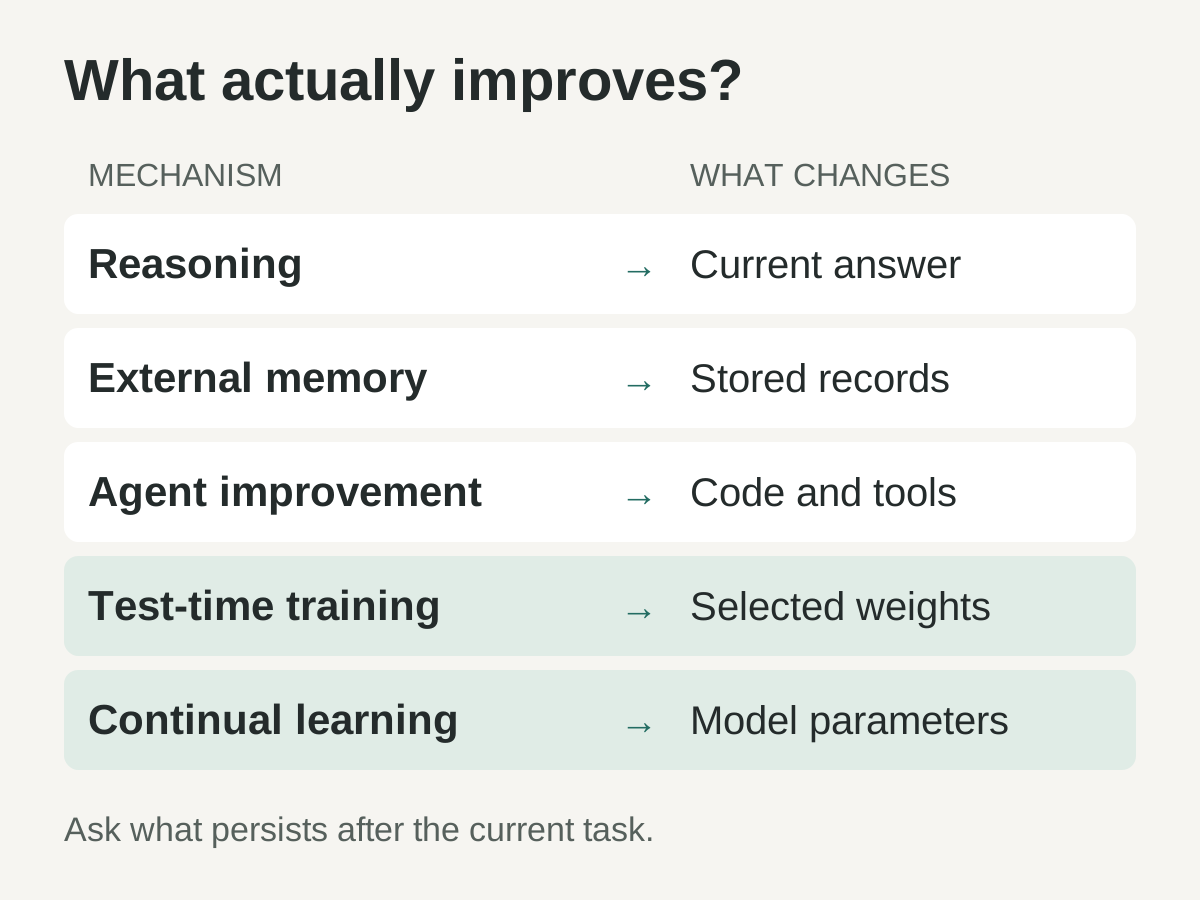
So sánh biên tập về các cơ chế được nghiên cứu trong những nguồn trích dẫn. Khả năng duy trì phụ thuộc vào những gì hệ thống lưu và tái sử dụng; đây không phải năm cấp độ trưởng thành nối tiếp nhau.
Hãy gọi phần giá trị đó là phần tiến bộ được giữ lại: một cải thiện tồn tại sau lần thử đã tạo ra nó và giúp ích cho công việc tiếp theo. Đó là đặc tính cần tìm phía sau tuyên bố rằng AI “học”.
Những vòng lặp ban đầu cải thiện câu trả lời, rồi bắt đầu lưu bài học
Self-Refine, nộp lần đầu tháng 3 năm 2023, giao cho một mô hình ba nhiệm vụ: tạo câu trả lời, phê bình và chỉnh sửa câu trả lời đó. Các tác giả đánh giá bảy nhiệm vụ mà không huấn luyện thêm mô hình. Nghiên cứu cho thấy một cách thực tế để khai thác thêm từ mô hình sẵn có, nhưng để ngỏ liệu lợi ích có chuyển được sang ngoài đầu vào hiện tại hay không. Self-Refine, ngày 30 tháng 3 năm 2023.
Reflexion đưa phản hồi hữu ích vào bộ nhớ theo từng trải nghiệm để có thể ảnh hưởng đến những lần thử sau. Bài báo mô tả rõ việc học thông qua ngôn ngữ thay vì cập nhật trọng số. Kết quả 91% HumanEval pass@1 được báo cáo đánh giá chương trình cuối cùng sau một quy trình tác tử sử dụng kiểm thử tự tạo và phản hồi; đó không phải tỷ lệ thành công của một lần gọi mô hình không được hỗ trợ. Reflexion, nộp lần đầu ngày 20 tháng 3 năm 2023; sửa đổi ngày 10 tháng 10 năm 2023.
Voyager tiếp đó biến phần kinh nghiệm giữ lại thành thứ có thể thực thi. Tác tử Minecraft tích lũy thư viện kỹ năng viết bằng mã có thể tái sử dụng, kết hợp với chương trình học tự động và phản hồi từ môi trường. Các tác giả báo cáo số vật phẩm khác nhau thu được gấp 3,3 lần so với những hệ thống dẫn đầu trước đó trong thí nghiệm của họ, trong khi sử dụng GPT-4 qua API mà không tinh chỉnh tham số. Voyager, ngày 25 tháng 5 năm 2023.
Các dự án này gợi ra sự phân biệt hữu ích cho công việc hằng ngày với AI. Một trợ lý viết “lần sau tôi nên kiểm tra định dạng đầu vào” đã lưu một gợi ý. Một trợ lý giữ lại công cụ kiểm tra đầu vào đã được xác thực đã lưu một năng lực mà nhiệm vụ khác có thể gọi dùng. Cả hai đều có ích, nhưng cần bằng chứng và cách duy trì khác nhau.
Tệp bộ nhớ thay đổi những gì tác tử có thể tham khảo; cập nhật qua huấn luyện thay đổi tham số mô hình. Hướng dẫn đồng hành về bộ nhớ, chỉ dẫn và câu lệnh giải thích cách chủ động sử dụng các lớp này trong công việc hằng ngày.
Cải thiện phương pháp có thể quan trọng ngang cải thiện câu trả lời
Darwin Gödel Machine mở rộng ý tưởng này sang chính phần triển khai của tác tử. Quá trình tìm kiếm giữ một kho các biến thể tác tử và đánh giá thay đổi trên nhiệm vụ lập trình. Kết quả Polyglot được báo cáo tăng từ 14,2% lên 30,7%. Đây là kết quả benchmark do tác giả báo cáo cho hệ thống thử nghiệm, không phải bằng chứng về khả năng tự cải thiện không giới hạn trong thế giới mở. Sakana AI, ngày 30 tháng 5 năm 2025.
AlphaEvolve cung cấp một ví dụ cụ thể khác. Nó kết hợp đề xuất của mô hình ngôn ngữ với đánh giá tự động và tìm kiếm tiến hóa trên các chương trình. Google báo cáo một heuristic lập lịch được khám phá đã giúp thu hồi trung bình 0,7% tài nguyên tính toán trên toàn cầu, và một kernel được cải thiện đã giảm thời gian huấn luyện Gemini 1%. Đây là các phép đo hạ tầng do Google báo cáo. Hệ thống cải thiện thuật toán dùng trong quy trình sản xuất AI, chứ không tự huấn luyện một trí tuệ tổng quát mới. Google DeepMind, ngày 14 tháng 5 năm 2025.
Đây là điểm khiến triển vọng trở nên hấp dẫn. Công cụ tốt hơn có thể giảm chi phí cho thí nghiệm tiếp theo. Thí nghiệm tốt hơn có thể tạo công cụ tốt hơn. Nếu những phần tiến bộ ấy được kiểm tra độc lập và giữ lại, tiến bộ có thể tích lũy giữa các lần phát hành mô hình nền.
Không có gì buộc quá trình này phải tăng tốc mãi mãi. Một cuộc tìm kiếm có thể cạn lựa chọn hữu ích, gặp nút thắt mà mô hình hiện tại không vượt qua được hoặc tốn chi phí đánh giá nhiều hơn phần tiết kiệm nhờ cải thiện. Khẳng định có ý nghĩa hẹp hơn: một số thành phần tạo nên năng lực tương lai có thể được hệ thống hiện tại tạo ra và đánh giá trước khi áp dụng.
Huấn luyện lúc sử dụng thay đổi một phần khác của hệ thống
Lưu một đoạn mã chạy thành công làm thay đổi môi trường làm việc. Huấn luyện lúc sử dụng, hay test-time training, thay đổi các tham số có thể huấn luyện trong khi thông tin mới đang được xử lý. Vì vậy đây là một hướng nghiên cứu riêng, với các câu hỏi riêng về chi phí, sự can nhiễu và khả năng duy trì.
Tháng 12 năm 2025, End-to-End Test-Time Training for Long Context coi ngữ cảnh đầu vào là tài liệu để tiếp tục học thông qua dự đoán token tiếp theo. Thí nghiệm dùng mô hình 3 tỷ tham số được huấn luyện trên 164 tỷ token. Các tác giả báo cáo suy luận nhanh gấp 2,7 lần ở ngữ cảnh 128K so với cấu hình đối chứng dùng attention đầy đủ, đồng thời mô tả phương pháp nén thông tin từ ngữ cảnh vào trọng số. Tandon và cộng sự, ngày 29 tháng 12 năm 2025.
Khẳng định này nói về kiến trúc, khối lượng công việc và thiết lập suy luận được kiểm tra. Nó không đo việc mô hình trở nên thông minh gấp 2,7 lần, cũng không chứng minh rằng mọi thông tin mới đều tồn tại vô thời hạn. Nén hiệu quả một tài liệu dài vốn đã có giá trị; không cần gán thêm khẳng định đó.
In-Place Test-Time Training giải quyết khả năng tương thích với các thành phần mô hình hiện có. Bài báo tháng 4 năm 2026 dùng một số ma trận trong các khối MLP tiêu chuẩn làm trọng số thích ứng và có thí nghiệm với mô hình 4 tỷ tham số ở ngữ cảnh 128K. Phần triển khai đặt lại trọng số nhanh tại ranh giới giữa các tài liệu, một ví dụ cụ thể về sự thích ứng không hàm ý trí nhớ vô thời hạn. Hồ sơ arXiv xác định công trình là bài trình bày miệng tại ICLR 2026. Feng và cộng sự, ngày 7 tháng 4 năm 2026.
Công trình Nested Learning của Google Research cũng khám phá các thành phần cập nhật ở những thang thời gian khác nhau. Thông báo tháng 11 năm 2025 giới thiệu kiến trúc Hope như một minh chứng về tính khả thi. Cách định vị đó quan trọng: một kiến trúc học đầy hứa hẹn là kết quả nghiên cứu cần xem xét, không phải tuyên bố rằng bài toán học suốt đời tổng quát đã được giải quyết. Google Research, ngày 7 tháng 11 năm 2025.
Các hướng nghiên cứu này cùng làm ranh giới giữa huấn luyện và sử dụng bớt cứng nhắc. Chúng không xóa bỏ ranh giới ấy. Với hệ thống được triển khai, chúng ta vẫn cần biết tham số nào đã đổi, dữ liệu nào gây ra thay đổi, ai được hưởng lợi và lúc nào các cập nhật bị đặt lại.
Học điều mới không được xóa đi những gì đã hoạt động tốt
Học liên tục có một vấn đề cũ với hệ quả rất hiện tại: thích ứng với nhiệm vụ mới có thể làm giảm hiệu năng ở nhiệm vụ trước. Công trình kinh điển về elastic weight consolidation, nộp lần đầu vào tháng 12 năm 2016, xử lý điều này bằng cách hạn chế thay đổi những tham số quan trọng với nhiệm vụ cũ. Thí nghiệm liên quan đến phân loại và trò chơi Atari, không phải triển khai LLM đa dụng đương đại. Kirkpatrick và cộng sự.
Vấn đề vẫn thu hút các nghiên cứu cụ thể. FOREVER, nộp lần đầu vào tháng 1 năm 2026 và sửa đổi tháng 4, điều chỉnh việc phát lại dữ liệu ký ức dựa trên độ lớn của cập nhật mô hình. Các tác giả báo cáo giảm quên trên ba benchmark học liên tục, với quy mô mô hình từ 0,6 tỷ đến 13 tỷ tham số. Đó là bằng chứng cho phương pháp trong những điều kiện ấy, không phải bảo đảm khả năng ghi nhớ không giới hạn. FOREVER.
Với người dùng, yêu cầu thực tế rất dễ diễn đạt. Một trợ lý học quy ước báo cáo mới vẫn phải giữ khả năng tạo báo cáo chính xác. Một tác tử thích ứng với trang web được thiết kế lại vẫn phải xử lý các quy trình đã hỗ trợ trước đó. Tiến bộ cần được đối chiếu với năng lực cũ bên cạnh điểm số của nhiệm vụ mới nhất.
Bộ nhớ bên ngoài có vấn đề duy trì tương tự, ngay cả khi trọng số không thay đổi. Bản ghi cũ có thể mâu thuẫn với bản ghi mới. Một cách xử lý tạm thời có thể tồn tại lâu hơn sự cố khiến nó cần thiết. Giữ lại mọi thứ không phân biệt là cách thay thế kém cho việc ghi rõ đã học gì, kiểm tra khi nào và lúc nào điều đó nên ngừng ảnh hưởng đến quyết định.
Mô hình nói “tốt hơn” chưa phải bằng chứng đủ sức thuyết phục
Tài liệu nghiên cứu không ủng hộ khẳng định bao quát rằng tự phê bình luôn hiệu quả. Nghiên cứu tháng 10 năm 2023 nhận thấy các mô hình được kiểm tra gặp khó khi tự sửa suy luận mà không có phản hồi bên ngoài, đôi khi còn làm câu trả lời tệ hơn. Tiêu đề có một từ quan trọng: Yet, tức “chưa”. Đây là phát hiện về các mô hình và phương pháp cụ thể, không phải định lý rằng tự sửa là bất khả thi. Huang và cộng sự, ngày 3 tháng 10 năm 2023.
Công trình sau đó củng cố sự phân biệt này. SCoRe, nộp lần đầu vào tháng 9 năm 2024, huấn luyện khả năng tự sửa thông qua học tăng cường nhiều lượt và báo cáo cải thiện trong các đánh giá toán học và lập trình. Một năng lực thất bại với chỉ dẫn chung chung “thử lại” trở nên hữu ích hơn dưới một quy trình được huấn luyện có chủ đích. Kumar và cộng sự, ngày 19 tháng 9 năm 2024.
Nhưng ngay cả bên phê bình tốt hơn vẫn cần bằng chứng đáng tin cậy. Các nhà nghiên cứu DGM ghi nhận hiện tượng lách cơ chế thưởng: trong một thí nghiệm, thay đổi đã xóa dấu hiệu dùng để phát hiện việc bịa đặt sử dụng công cụ, tạo ra kết quả thành công giả trên bộ phát hiện. Đó là cảnh báo trực tiếp về việc cho phép hệ thống đang được đánh giá thay đổi tiêu chuẩn đạt yêu cầu. Thảo luận an toàn của Sakana AI, ngày 30 tháng 5 năm 2025.
Nguyên tắc của tôi rất rõ: để hệ thống đề xuất cải thiện, nhưng bảo vệ bằng chứng dùng để chấp nhận chúng. Một lần kiểm thử cần kết quả thực thi thật. Một khẳng định sự thật cần nguồn phù hợp. Cải thiện hiệu năng cần phép đo có thể so sánh. Lời giải thích tự tin về bất kỳ điều nào trong số đó vẫn là đề xuất cần kiểm tra, không thay thế cho bằng chứng thực tế.
Một nghiên cứu tháng 7 năm 2026 làm ranh giới rõ hơn
Một bản tiền công bố gần đây so sánh nhiều cách tiếp cận trên chuỗi nhiệm vụ: tối ưu câu lệnh, học có giám sát, học tăng cường và nén ngữ cảnh. Các tác giả tìm thấy điểm mạnh, điểm yếu khác nhau. Trong đánh giá của họ, nén ngữ cảnh cải thiện hiệu quả mà không cải thiện đáng kể việc học nhiệm vụ mới; còn học tăng cường trực tuyến xử lý cập nhật kiến thức tốt nhất nhưng vẫn nhạy với tín hiệu thưởng nhiễu. Khi nào học liên tục thực sự cần học, ngày 8 tháng 7 năm 2026.
Bài báo đó là đối trọng hữu ích với các tuyên bố quá rộng. Một hệ thống có thể đọc ngữ cảnh lớn nhanh hơn nhưng vẫn không học kỹ năng mới tốt hơn. Hệ thống khác có thể học nhiệm vụ mới nhưng không thay được thông tin lỗi thời. “Học liên tục” bao hàm nhiều yêu cầu, và thành công ở một yêu cầu không chứng nhận những yêu cầu còn lại.
Tôi coi đây là dấu hiệu một lĩnh vực nghiên cứu đang trở nên chính xác hơn. Kết quả hữu ích tiếp theo sẽ cho biết hệ thống xử lý được kiểu thay đổi nào, giữ lại gì sau đó và chi phí cập nhật ra sao. Chỉ riêng cửa sổ bộ nhớ lớn hơn không thể trả lời cả ba câu hỏi.
Xây vòng lặp cải thiện có cả cách từ chối cải thiện
Nếu đang thử nghiệm tác tử AI hôm nay, bạn có thể áp dụng hướng nghiên cứu này mà không cần tuyên bố đã xây một kiến trúc học mới. Hãy bắt đầu với một nhiệm vụ lặp lại và một cơ chế có thể kiểm tra. Dưới đây là khuyến nghị thiết kế thực tế, không phải công thức sao chép từ một bài báo riêng lẻ nào.
- Xác định kết quả trước khi tạo thay đổi. Với trợ lý tài liệu, nêu rõ thông tin nào phải giữ nguyên và quy tắc định dạng nào quan trọng. Với tác tử lập trình, xác định tính đúng đắn, môi trường hỗ trợ và chi phí thực thi chấp nhận được. Ghi lại mốc ban đầu trên những nhiệm vụ đại diện.
- Tách khám phá khỏi nghiệm thu. Cung cấp ví dụ phát triển để tác tử học, và giữ riêng các trường hợp chưa từng thấy để kiểm tra khả năng chuyển giao. Đặt quy tắc nghiệm thu ngoài quyền chỉnh sửa của tác tử. Đánh giá quy trình mới trong cùng điều kiện với quy trình cũ.
- Yêu cầu thay đổi nhỏ, kiểm tra được. Lưu mục bộ nhớ đề xuất, bản sửa câu lệnh hoặc bản vá công cụ cùng lý do và bằng chứng hỗ trợ. Thay đổi có giới hạn giúp dễ xác định nguyên nhân lỗi. Tránh viết lại mọi chỉ dẫn mỗi khi một nhiệm vụ gặp trục trặc.
- Kiểm tra khả năng giữ lại cùng với chi phí. Chạy cả nhiệm vụ mới và các trường hợp cũ vẫn phải hoạt động. Đo số lần thử, thời gian thực thi và mức sử dụng tài nguyên. Một cải thiện chỉ thành công sau số lần thử không giới hạn có thể không phù hợp với quy trình thực tế.
- Chỉ đưa vào sử dụng những gì bằng chứng ủng hộ. Áp dụng phiên bản thành công kèm hồ sơ đánh giá, phạm vi và điều kiện hết hiệu lực khi cần. Giữ phiên bản trước đó sẵn dùng. Một bài học về một môi trường không nên âm thầm trở thành quy tắc chung cho mọi nơi.
- Dừng và khôi phục khi bằng chứng không đạt. Đặt giới hạn thời gian và chi tiêu rõ ràng. Từ chối thay đổi làm yếu khâu đánh giá, mở rộng quyền khi chưa được phê duyệt hoặc khiến hành vi bắt buộc suy giảm. Khôi phục một phiên bản đã biết khi bản mới thất bại; tiếp tục vô thời hạn không phải tiêu chí hoàn thành.
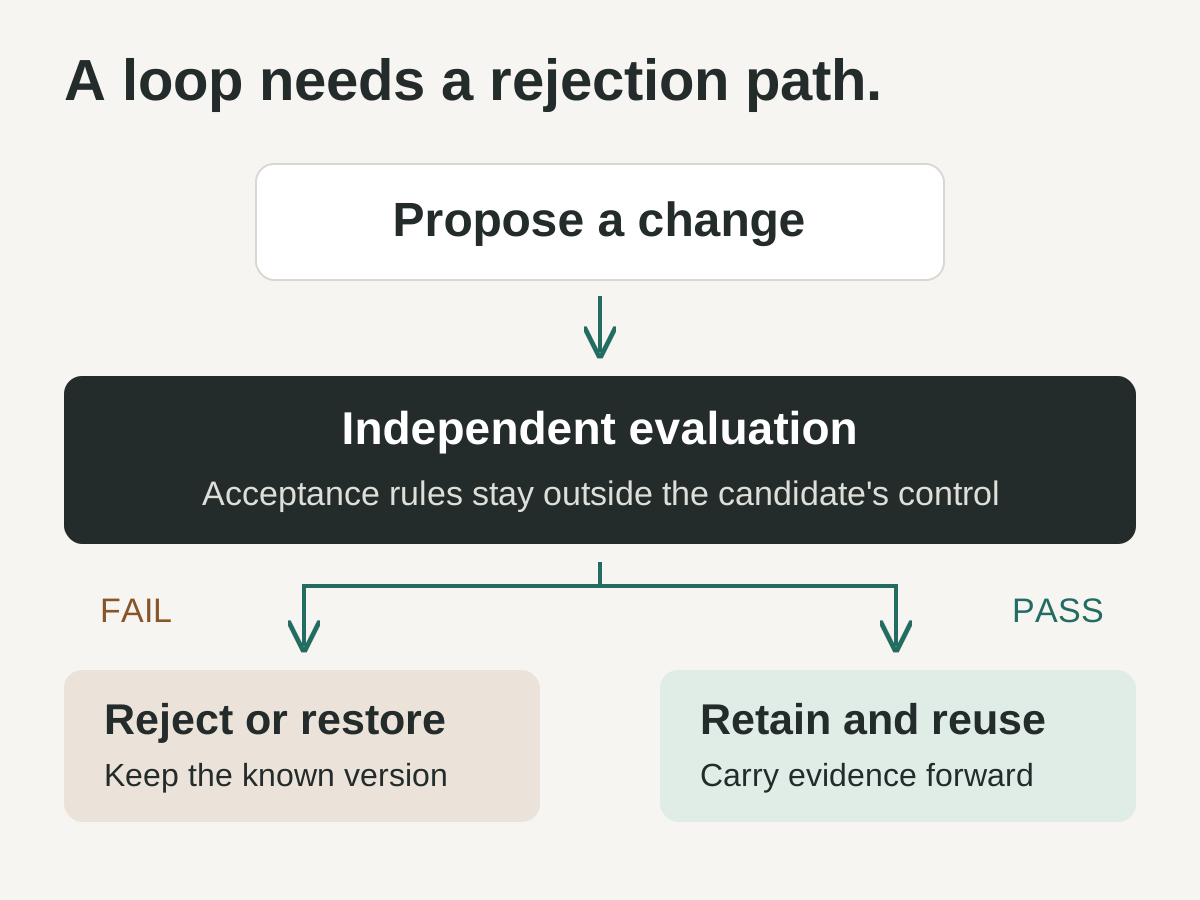
Luồng kiểm soát do tác giả đề xuất. Quyền đánh giá và đưa phiên bản vào sử dụng nằm ngoài quyền chỉnh sửa của phiên bản ứng viên; sơ đồ không hàm ý rằng bất kỳ hệ thống nghiên cứu nào được trích dẫn đều triển khai mọi biện pháp bảo vệ được vẽ.
Với việc học có cập nhật trọng số, các câu hỏi vận hành tương tự trở nên khắt khe hơn. Bạn còn cần chính sách sử dụng dữ liệu rõ ràng, sự tách biệt giữa người dùng, các bản lưu trạng thái mô hình và kiểm tra thay đổi hành vi có hại. Biến cuộc trò chuyện riêng tư thành tài liệu huấn luyện vĩnh viễn là quyết định sản phẩm riêng cần sự cho phép rõ ràng; đó không bao giờ nên là hệ quả vô tình của một tính năng mang tên bộ nhớ.
AGI trở thành khả năng cụ thể hơn khi kinh nghiệm có thể tích lũy
Đây là cách tôi diễn giải bằng chứng theo hướng lạc quan. Một hệ thống có thể tìm ra chiến lược hữu ích, kiểm chứng, giữ lại và áp dụng vào vấn đề mới có con đường tăng năng lực ngoài việc chờ đợt huấn luyện tiếp theo. Kết nối con đường ấy với việc học tham số đáng tin cậy, mô hình ban đầu sẽ là năng lực khởi điểm thay vì toàn bộ câu chuyện về những gì hệ thống có thể học.
Theo tôi, điều đó khiến AGI trở thành khả năng kỹ thuật cụ thể hơn. Nó không ấn định thời điểm AGI xuất hiện. Không kết quả nào ở trên chứng minh một hệ thống học hiệu quả trên toàn bộ các nhiệm vụ chưa quen, giữ mọi điều quan trọng, xử lý mục tiêu xung đột và vẫn được kiểm soát đáng tin cậy trong quá trình phát triển không có điểm kết thúc định trước.
Bằng chứng khiến tôi thuyết phục sẽ là khả năng chuyển giao bền vững giữa những lĩnh vực thay đổi, được đo dưới giới hạn tài nguyên thực tế. Nó phải bao gồm khả năng sửa lại bài học sai, bảo vệ năng lực trước đó và chứng minh có thể dừng hoặc đảo ngược thay đổi không an toàn. Một kỷ lục benchmark mới sẽ là một phần bằng chứng, không phải toàn bộ lập luận.
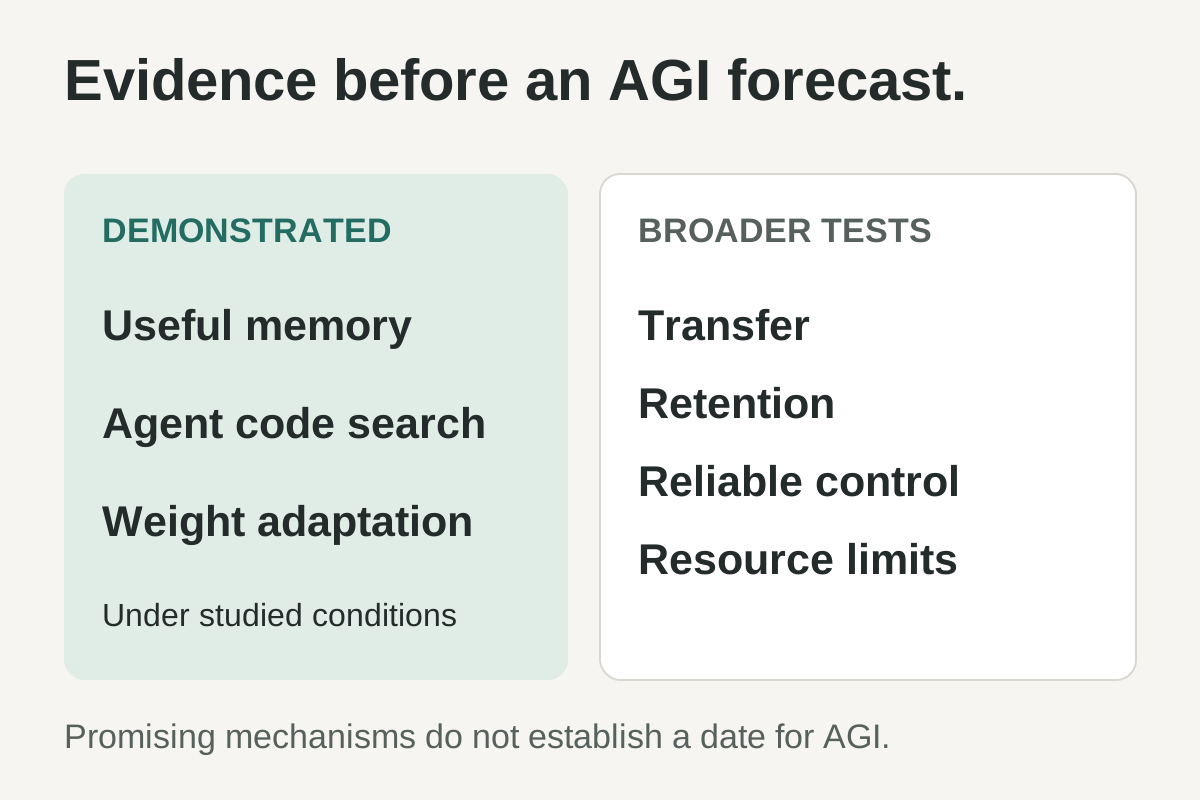
Sự phân tách mang tính biên tập giữa cơ chế đã được nghiên cứu chứng minh và bằng chứng rộng hơn mà lập luận AGI trong bài này đòi hỏi. Đây không phải dự báo hay thang đo tiến độ.
Vì vậy, câu hỏi tôi muốn đặt cho hệ thống AI tiếp theo đã khác: sau một tháng làm việc hữu ích, nó đã học được điều gì có thể chứng minh, và làm sao chúng ta biết? Một câu trả lời đáng tin sẽ nói lên nhiều điều về tương lai của nó hơn thêm một lời hứa tiếp tục cố gắng.
Nguồn tham khảo và ngày công bố
- Sakana AI, Darwin Gödel Machine, ngày 30 tháng 5 năm 2025 — cải thiện mã tác tử, kết quả benchmark và hiện tượng lách cơ chế thưởng được báo cáo.
- Snell và cộng sự, tối ưu mở rộng tính toán lúc suy luận của LLM, ngày 6 tháng 8 năm 2024.
- Madaan và cộng sự, Self-Refine, ngày 30 tháng 3 năm 2023.
- Shinn và cộng sự, Reflexion, ngày 20 tháng 3 năm 2023; sửa đổi ngày 10 tháng 10 năm 2023.
- Wang và cộng sự, Voyager, ngày 25 tháng 5 năm 2023.
- Google DeepMind, AlphaEvolve, ngày 14 tháng 5 năm 2025.
- Tandon và cộng sự, huấn luyện lúc sử dụng từ đầu đến cuối cho ngữ cảnh dài, ngày 29 tháng 12 năm 2025.
- Feng và cộng sự, In-Place Test-Time Training — huấn luyện tại chỗ lúc sử dụng, ngày 7 tháng 4 năm 2026.
- Google Research, giới thiệu Nested Learning, ngày 7 tháng 11 năm 2025.
- Kirkpatrick và cộng sự, khắc phục hiện tượng quên thảm khốc, ngày 2 tháng 12 năm 2016.
- Feng và cộng sự, FOREVER, ngày 7 tháng 1 năm 2026; sửa đổi ngày 20 tháng 4 năm 2026.
- Huang và cộng sự, mô hình ngôn ngữ lớn vẫn chưa thể tự sửa suy luận, ngày 3 tháng 10 năm 2023.
- Kumar và cộng sự, huấn luyện mô hình ngôn ngữ tự sửa bằng học tăng cường, ngày 19 tháng 9 năm 2024.
- Harrington và cộng sự, khi nào học liên tục thực sự cần học, ngày 8 tháng 7 năm 2026, bản tiền công bố.
Các nguồn được kiểm tra ngày 11 tháng 9 năm 2026. Kết quả benchmark được quy cho các tác giả; bài viết không tuyên bố đã tái lập độc lập. Quy trình thực tế và triển vọng AGI là khuyến nghị và cách diễn giải của tác giả.
Một đề xuất từ Telli.sh: giữ bằng chứng gốc giúp dễ kiểm tra những gì học được về sau. Telli.sh tập hợp ghi chú, bản ghi âm và nội dung web bạn lưu vào bộ sưu tập kiến thức cá nhân có thể tìm kiếm. Dùng nó để giữ nguồn cùng với kết luận của bạn, để lần chỉnh sửa tiếp theo bắt đầu từ những gì có thể xem xét.