หลังโมเดลเปิดตัว: 5 วิธีที่ AI พัฒนาต่อได้ และความหมายต่อ AGI
การฝึกโมเดลหนึ่งรอบไม่ได้อธิบายความสามารถทั้งหมดอีกต่อไป งานวิจัยตั้งแต่ Reflexion และ Voyager ไปจนถึง AlphaEvolve การฝึกขณะใช้งาน และการทดลองเรียนรู้ต่อเนื่องในปี 2026 แสดงให้เห็นว่าระบบ AI เก็บประสบการณ์ที่มีประโยชน์ไว้ได้อย่างไร อะไรเปลี่ยนจริง หลักฐานหนักแน่นตรงไหน และเหตุใดการพัฒนาที่เชื่อถือได้จึงสำคัญกว่าวงจรที่ทำซ้ำไม่รู้จบ
ในเดือนพฤษภาคม 2025 นักวิจัยรายงานว่าเอเจนต์เขียนโค้ดตัวหนึ่งเพิ่มผลการทดสอบ SWE-bench จาก 20.0% เป็น 50.0% ด้วยการเปลี่ยนโค้ดของตัวเอเจนต์เอง โมเดลภาษาที่อยู่ข้างใต้ไม่ต้องเปลี่ยนหมายเลขรุ่น ระบบที่อยู่รอบโมเดลได้เรียนรู้วิธีทำงานที่ดีขึ้น นั่นคือ Darwin Gödel Machine และความแตกต่างนี้น่าสนใจกว่าคะแนนพาดหัว
เรามักอธิบายความก้าวหน้าของ AI เป็นลำดับของโมเดลที่สร้างเสร็จแล้ว: ฝึกหนึ่งรุ่น เปิดตัว แล้วรอรุ่นที่ฉลาดกว่ามาแทน แต่แนวทางวิจัยที่กำลังเติบโตถามว่าเกิดอะไรขึ้นระหว่างการเปิดตัวเหล่านั้น ระบบเรียนรู้จากความพยายามที่ล้มเหลว เก็บทักษะที่มีประโยชน์ ปรับเครื่องมือให้ดีขึ้น หรือปรับค่าน้ำหนักบางส่วนระหว่างทำงานได้หรือไม่
ผมมองว่านี่เป็นหนึ่งในเหตุผลที่น่าเชื่อถือที่สุดที่จะมองอนาคตของ AI ที่มีความสามารถทั่วไปมากขึ้นอย่างมีความหวัง แต่ความหวังต้องมีคำอธิบายที่แม่นยำ บทความนี้แยกการพัฒนาห้าแบบ พิจารณาผลงานถึงเดือนกรกฎาคม 2026 และอธิบายการทดสอบที่ระบบซึ่งพัฒนาอย่างต่อเนื่องต้องผ่าน ก่อนที่ความก้าวหน้าของมันจะสมควรได้รับความเชื่อใจ
ข้อเสนอหลักสามประการ
- โมเดลที่ไม่เปลี่ยนแปลงสร้างระบบที่เก่งขึ้นได้ เมื่อความจำ เครื่องมือ หรือกระบวนการแก้ปัญหาดีขึ้น
- นักวิจัยกำลังทดสอบการปรับค่าน้ำหนักจริงระหว่างใช้งานด้วย การจดจำบทสนทนากับการฝึกโครงข่ายประสาทยังเป็นคนละกระบวนการ
- ความก้าวหน้าสู่ AGI ต้องอาศัยการเรียนรู้ที่มีประโยชน์และถ่ายโอนไปใช้ได้ รักษาความสามารถเดิม และอยู่ภายใต้การควบคุมของมนุษย์ การวนซ้ำเป็นเพียงจุดเริ่มต้น
โมเดลที่คงเดิมไม่เคยหมายถึงเพดานเดิมสำหรับทุกงาน
การฝึกกำหนดพารามิเตอร์ของโมเดล ซึ่งก็คือค่าตัวเลขที่ใช้ประมวลผลอินพุตและสร้างเอาต์พุต ในการอนุมานตามปกติ ค่าเหล่านี้ไม่เปลี่ยน แต่นั่นไม่ได้หมายความว่าคำตอบถูกกำหนดด้วยการฝึกเพียงอย่างเดียว หากให้หลักฐานที่เกี่ยวข้อง เครื่องคิดเลขที่ทำงานได้ หรือขั้นตอนค้นหาที่ดีกว่า ผลงานของระบบก็เปลี่ยนได้โดยไม่ต้องเปลี่ยนพารามิเตอร์เหล่านั้น
งานวิจัยเรื่องการคำนวณขณะอนุมานทำให้ประเด็นนี้วัดได้ ในงานศึกษาของเดือนสิงหาคม 2024 Charlie Snell และคณะรายงานประสิทธิภาพที่สูงกว่า 4 เท่า เมื่อเทียบกับแนวทางฐาน best-of-N โดยจัดสรรการคำนวณเพิ่มเติมสำหรับการให้เหตุผลทางคณิตศาสตร์แบบปรับตามโจทย์ ผลขึ้นอยู่กับปัญหาและรูปแบบการประเมิน ไม่ได้บอกว่าโมเดลขนาดเล็กทุกตัวแก้ได้ทุกเรื่องหากปล่อยให้ทำงานนานพอ บทความวิจัย วันที่ 6 สิงหาคม 2024
คำถามจึงกลายเป็นว่า อะไรเปลี่ยน และอะไรยังคงอยู่หลังงานปัจจุบันจบลง? มีกลไกห้าแบบที่ควรแยกจากกัน
| กลไก | อะไรเปลี่ยน? | อะไรอาจคงอยู่? | ยังไม่ได้พิสูจน์เรื่องใด? |
|---|---|---|---|
| การค้นหาหรือแก้คำตอบขณะอนุมาน | คำตอบที่เป็นตัวเลือกและกระบวนการให้เหตุผลปัจจุบัน | โดยทั่วไปไม่มี เว้นแต่จะบันทึกไว้โดยชัดเจน | ความสามารถของโมเดลเพิ่มขึ้นอย่างถาวร |
| ความจำภายนอก | ข้อเท็จจริง ข้อเสนอแนะ และประสบการณ์ที่บันทึกและเรียกคืนได้ | บันทึกที่งานถัดไปเข้าถึงได้ | ค่าน้ำหนักของโมเดลได้เรียนรู้บันทึกเหล่านั้นแล้ว |
| การปรับปรุงเครื่องมือหรือเอเจนต์ | ทักษะที่รันได้ พรอมป์ต์ และโค้ดทำงาน | การจัดองค์ประกอบระบบที่นำกลับมาใช้ได้ | โมเดลพื้นฐานที่อยู่ข้างใต้เปลี่ยนไป |
| การฝึกขณะใช้งาน | พารามิเตอร์ที่เลือกให้ฝึกได้ระหว่างประมวลผลอินพุตใหม่ | ขึ้นอยู่กับวิธีและนโยบายรีเซ็ต | การจดจำตลอดชีวิตโดยอัตโนมัติข้ามผู้ใช้และงาน |
| การเรียนรู้พารามิเตอร์อย่างต่อเนื่อง | พารามิเตอร์ของโมเดลตลอดลำดับประสบการณ์ | ความสามารถที่ปรับแล้ว หากรักษาไว้สำเร็จ | ปลอดจากการลืม การเบี่ยงเบน หรือการอัปเดตที่เป็นอันตราย |
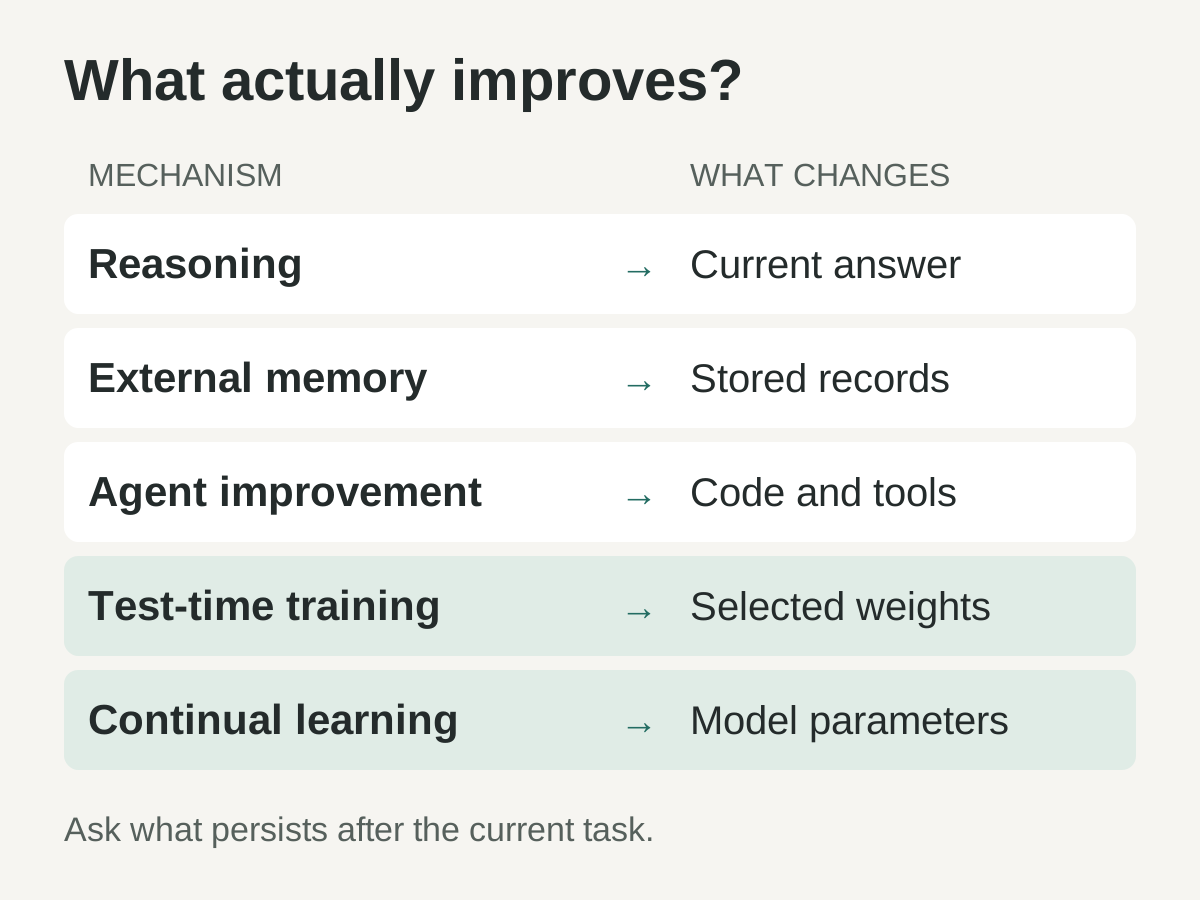
การเปรียบเทียบเชิงบรรณาธิการของกลไกในงานวิจัยที่อ้างถึง ความคงอยู่ขึ้นกับสิ่งที่ระบบบันทึกและนำกลับมาใช้ ไม่ใช่ห้าระดับความก้าวหน้าที่ต้องผ่านตามลำดับ
เรียกส่วนที่มีคุณค่านี้ว่า ผลพัฒนาที่เก็บไว้ได้ นั่นคือการปรับปรุงที่ยังคงอยู่หลังความพยายามที่สร้างมันขึ้นมา และช่วยงานถัดไป นี่คือคุณสมบัติที่ควรมองหาภายใต้คำกล่าวว่า AI “เรียนรู้”
วงจรแรก ๆ ปรับคำตอบให้ดีขึ้น แล้วจึงเริ่มเก็บบทเรียน
Self-Refine ซึ่งส่งครั้งแรกในเดือนมีนาคม 2023 ให้โมเดลหนึ่งตัวทำสามหน้าที่ ได้แก่ สร้างคำตอบ วิจารณ์ และแก้คำตอบ ผู้เขียนประเมิน เจ็ดงาน โดยไม่ฝึกโมเดลเพิ่มเติม ผลแสดงวิธีที่ใช้ได้จริงในการดึงความสามารถจากโมเดลเดิมให้มากขึ้น แต่ยังเปิดคำถามว่าประโยชน์นั้นจะถ่ายโอนไปนอกอินพุตปัจจุบันได้หรือไม่ Self-Refine วันที่ 30 มีนาคม 2023
Reflexion นำข้อเสนอแนะที่มีประโยชน์เข้าไปในความจำรายประสบการณ์ ซึ่งส่งผลต่อความพยายามครั้งต่อไปได้ บทความระบุชัดว่าเป็นการเรียนรู้ผ่านภาษา ไม่ใช่การอัปเดตค่าน้ำหนัก ผล HumanEval pass@1 ที่รายงาน 91% เป็นการประเมินโปรแกรมสุดท้ายหลังผ่านกระบวนการของเอเจนต์ที่ใช้การทดสอบที่สร้างเองและข้อเสนอแนะ ไม่ใช่อัตราสำเร็จของการเรียกโมเดลครั้งเดียวโดยไม่มีตัวช่วย Reflexion ส่งครั้งแรกวันที่ 20 มีนาคม 2023 ปรับปรุงวันที่ 10 ตุลาคม 2023
จากนั้น Voyager ทำให้สิ่งที่เก็บไว้กลายเป็นสิ่งที่รันได้ เอเจนต์ Minecraft สะสมคลังทักษะในรูปโค้ดที่ใช้ซ้ำได้ ร่วมกับหลักสูตรอัตโนมัติและข้อเสนอแนะจากสภาพแวดล้อม ผู้เขียนรายงานว่าได้ไอเท็มไม่ซ้ำกันมากกว่า 3.3 เท่า เมื่อเทียบกับระบบชั้นนำก่อนหน้าในการทดลองของตน โดยใช้ GPT-4 ผ่าน API และไม่ปรับละเอียดพารามิเตอร์ Voyager วันที่ 25 พฤษภาคม 2023
โครงการเหล่านี้ชี้ให้เห็นความแตกต่างที่มีประโยชน์กับการทำงานประจำวันโดยใช้ AI ผู้ช่วยที่เขียนว่า “ครั้งหน้าควรตรวจรูปแบบอินพุต” ได้บันทึกข้อเสนอแนะไว้ ส่วนผู้ช่วยที่เก็บเครื่องมือตรวจอินพุตซึ่งผ่านการตรวจสอบแล้วได้บันทึกความสามารถที่งานอื่นเรียกใช้ได้ ทั้งสองแบบช่วยได้ แต่ต้องใช้หลักฐานและวิธีดูแลรักษาต่างกัน
ไฟล์ความจำเปลี่ยนสิ่งที่เอเจนต์เปิดอ้างอิงได้ ส่วนการอัปเดตผ่านการฝึกเปลี่ยนพารามิเตอร์ของโมเดล คู่มือที่เกี่ยวข้องเรื่อง ความจำ คำสั่ง และพรอมป์ต์ อธิบายวิธีใช้ชั้นเหล่านี้อย่างมีเป้าหมายในงานประจำวัน
การปรับวิธีทำงานอาจสำคัญพอ ๆ กับการปรับคำตอบ
Darwin Gödel Machine ขยายแนวคิดนี้ไปถึงโค้ดที่ใช้สร้างเอเจนต์เอง กระบวนการค้นหาเก็บคลังเอเจนต์หลายรุ่นและประเมินการเปลี่ยนแปลงด้วยงานเขียนโค้ด ผล Polyglot ที่รายงานเพิ่มจาก 14.2% เป็น 30.7% ตัวเลขเหล่านี้เป็นผลเบนช์มาร์กของระบบทดลองที่ผู้เขียนรายงาน ไม่ใช่หลักฐานการพัฒนาตัวเองอย่างไม่จำกัดในโลกเปิด Sakana AI วันที่ 30 พฤษภาคม 2025
AlphaEvolve เป็นอีกตัวอย่างที่ชัดเจน ระบบผสานข้อเสนอของโมเดลภาษาเข้ากับการประเมินอัตโนมัติและการค้นหาเชิงวิวัฒนาการบนโปรแกรม Google รายงานว่าวิธีฮิวริสติกสำหรับจัดตารางงานที่ค้นพบช่วยนำทรัพยากรประมวลผลทั่วโลกกลับมาใช้ได้เฉลี่ย 0.7% และเคอร์เนลที่ปรับปรุงลดเวลาฝึก Gemini ลง 1% นี่เป็นผลวัดโครงสร้างพื้นฐานที่ Google รายงาน ระบบกำลังพัฒนาอัลกอริทึมที่ใช้ในการผลิต AI ไม่ได้ฝึกปัญญาทั่วไปตัวใหม่ด้วยตัวเอง Google DeepMind วันที่ 14 พฤษภาคม 2025
ตรงนี้เองที่อนาคตเริ่มน่าสนใจ เครื่องมือที่ดีขึ้นทำให้การทดลองครั้งถัดไปถูกลงได้ การทดลองที่ดีขึ้นสร้างเครื่องมือที่ดีขึ้นได้ หากผลพัฒนาเหล่านั้นถูกตรวจอย่างเป็นอิสระและเก็บไว้ ความก้าวหน้าก็สะสมได้ระหว่างการเปิดตัวโมเดลพื้นฐานแต่ละครั้ง
ไม่มีเงื่อนไขใดบอกว่ากระบวนการนี้ต้องเร่งตัวไปตลอด การค้นหาอาจใช้ทางเลือกที่มีประโยชน์จนหมด เจอคอขวดที่โมเดลปัจจุบันแก้ไม่ได้ หรือเสียค่าประเมินมากกว่าสิ่งที่ประหยัดได้จากการปรับปรุง ข้อสรุปที่มีความหมายแคบกว่านั้น คือระบบปัจจุบันสามารถสร้างส่วนประกอบบางอย่างของความสามารถในอนาคต และประเมินก่อนนำไปใช้ได้
การฝึกขณะใช้งานเปลี่ยนคนละส่วนของระบบ
การเก็บสคริปต์ที่ทำงานสำเร็จเปลี่ยนสภาพแวดล้อมการทำงาน ส่วนการฝึกขณะใช้งาน หรือ test-time training เปลี่ยนพารามิเตอร์ที่ฝึกได้ในระหว่างประมวลผลข้อมูลใหม่ จึงเป็นทิศทางวิจัยที่แยกออกมา โดยมีคำถามของตัวเองเรื่องต้นทุน การรบกวนสิ่งที่เรียนมา และความคงอยู่
ในเดือนธันวาคม 2025 งาน End-to-End Test-Time Training for Long Context ใช้บริบทที่เข้ามาเป็นวัตถุดิบสำหรับเรียนรู้ต่อด้วยการทำนายโทเคนถัดไป การทดลองใช้ โมเดล 3 พันล้านพารามิเตอร์ที่ฝึกด้วยโทเคน 164 พันล้านตัว ผู้เขียนรายงาน การอนุมานที่เร็วขึ้น 2.7 เท่าเมื่อใช้บริบท 128K เทียบกับตัวเปรียบเทียบแบบ full attention พร้อมอธิบายวิธีบีบข้อมูลจากบริบทลงในค่าน้ำหนัก Tandon และคณะ วันที่ 29 ธันวาคม 2025
ข้อกล่าวอ้างนี้เกี่ยวกับสถาปัตยกรรม ภาระงาน และการตั้งค่าการอนุมานที่ทดสอบ ไม่ใช่การวัดว่าโมเดลฉลาดขึ้น 2.7 เท่า และไม่ใช่ข้อพิสูจน์ว่าข้อเท็จจริงใหม่ทุกอย่างจะคงอยู่ตลอดไป การบีบอัดเอกสารยาวอย่างมีประสิทธิภาพมีคุณค่าอยู่แล้ว ไม่จำเป็นต้องเติมคำกล่าวอ้างนั้น
In-Place Test-Time Training จัดการเรื่องความเข้ากันได้กับส่วนประกอบโมเดลที่มีอยู่ บทความเดือนเมษายน 2026 ใช้เมทริกซ์ที่เลือกภายในบล็อก MLP มาตรฐานเป็นค่าน้ำหนักที่ปรับได้ และมีการทดลองด้วย โมเดล 4 พันล้านพารามิเตอร์ที่บริบท 128K โค้ดการทำงานรีเซ็ตค่าน้ำหนักเร็วเมื่อข้ามขอบเขตเอกสาร เป็นตัวอย่างชัดเจนของการปรับตัวที่ไม่ได้หมายถึงความจำไม่สิ้นสุด ระเบียน arXiv ระบุว่าเป็น ผลงานนำเสนอแบบบรรยายใน ICLR 2026 Feng และคณะ วันที่ 7 เมษายน 2026
งาน Nested Learning ของ Google Research สำรวจส่วนประกอบที่อัปเดตในช่วงเวลาต่างกันด้วย ประกาศเดือนพฤศจิกายน 2025 นำเสนอสถาปัตยกรรม Hope ในฐานะต้นแบบพิสูจน์แนวคิด กรอบคำอธิบายนี้สำคัญ สถาปัตยกรรมการเรียนรู้ที่มีแนวโน้มดีคือผลวิจัยให้พิจารณา ไม่ใช่การประกาศว่าแก้โจทย์การเรียนรู้ตลอดชีวิตแบบทั่วไปได้แล้ว Google Research วันที่ 7 พฤศจิกายน 2025
เมื่อนำมาดูร่วมกัน งานเหล่านี้ทำให้เส้นแบ่งระหว่างการฝึกและการใช้ยืดหยุ่นขึ้น แต่ไม่ได้ลบเส้นแบ่งนั้น สำหรับระบบที่นำไปใช้งานจริง เรายังต้องรู้ว่าพารามิเตอร์ใดเปลี่ยน ข้อมูลใดทำให้เปลี่ยน ใครได้ประโยชน์ และเมื่อใดการอัปเดตเหล่านั้นถูกรีเซ็ต
การเรียนรู้สิ่งใหม่ต้องไม่ลบสิ่งที่เคยทำได้ดี
การเรียนรู้ต่อเนื่องมีปัญหาเก่าที่ส่งผลร่วมสมัยอย่างยิ่ง นั่นคือการปรับตัวกับงานใหม่อาจทำให้ผลงานในงานเก่าแย่ลง งานคลาสสิกเรื่อง elastic weight consolidation ซึ่งส่งครั้งแรกใน เดือนธันวาคม 2016 แก้ปัญหานี้ด้วยการจำกัดการเปลี่ยนพารามิเตอร์ที่สำคัญต่องานก่อนหน้า การทดลองเกี่ยวกับการจำแนกประเภทและเกม Atari ไม่ใช่การนำ LLM อเนกประสงค์ยุคปัจจุบันไปใช้จริง Kirkpatrick และคณะ
ปัญหานี้ยังดึงดูดงานวิจัยที่เป็นรูปธรรม FOREVER ซึ่งส่งครั้งแรกใน เดือนมกราคม 2026 และปรับปรุงในเดือนเมษายน ปรับการนำข้อมูลในความจำมาเรียนซ้ำตามขนาดของการอัปเดตโมเดล ผู้เขียนรายงานการลืมที่ลดลงใน เบนช์มาร์กการเรียนรู้ต่อเนื่องสามชุด กับโมเดลขนาด 0.6 พันล้านถึง 13 พันล้านพารามิเตอร์ นี่คือหลักฐานของวิธีภายใต้เงื่อนไขเหล่านั้น ไม่ใช่การรับประกันว่าจะรักษาความรู้ได้ไม่จำกัด FOREVER
สำหรับผู้ใช้ ข้อกำหนดเชิงปฏิบัติอธิบายได้ง่าย ผู้ช่วยที่เรียนรู้ธรรมเนียมการเขียนรายงานแบบใหม่ควรรักษาความสามารถในการทำรายงานที่ถูกต้อง เอเจนต์ที่ปรับตัวกับเว็บไซต์ที่ออกแบบใหม่ควรยังจัดการขั้นตอนงานเดิมที่รองรับได้ ความก้าวหน้าต้องมีการเปรียบเทียบกับความสามารถเดิมควบคู่กับคะแนนของงานล่าสุด
ความจำภายนอกมีปัญหาดูแลรักษาที่คล้ายกัน แม้ค่าน้ำหนักไม่ขยับเลย บันทึกเก่าอาจขัดกับบันทึกใหม่ วิธีแก้ขัดชั่วคราวอาจอยู่ยาวกว่าเหตุการณ์ที่ทำให้ต้องใช้ การเก็บทุกอย่างโดยไม่คัดแยกทดแทนการบันทึกว่าเรียนรู้อะไร ตรวจเมื่อใด และควรหยุดมีอิทธิพลต่อการตัดสินใจเมื่อใดได้ไม่ดี
โมเดลบอกว่า “ดีขึ้น” ยังไม่ใช่หลักฐานที่เพียงพอ
งานวิจัยไม่สนับสนุนคำกล่าวเหมารวมว่าการวิจารณ์ตัวเองได้ผลเสมอ งานศึกษาเดือนตุลาคม 2023 พบว่าโมเดลที่ทดสอบแก้เหตุผลของตัวเองได้ยากเมื่อไม่มีข้อเสนอแนะภายนอก และบางครั้งกลับทำให้คำตอบแย่ลง ชื่อบทความมีคำสำคัญว่า Yet หรือ “ยัง” อยู่ด้วย นี่คือข้อค้นพบเกี่ยวกับโมเดลและวิธีเฉพาะ ไม่ใช่ทฤษฎีบทว่าการแก้ไขตัวเองเป็นไปไม่ได้ Huang และคณะ วันที่ 3 ตุลาคม 2023
งานต่อมาช่วยย้ำความต่างนั้น SCoRe ซึ่งส่งครั้งแรกใน เดือนกันยายน 2024 ฝึกการแก้ไขตัวเองด้วยการเรียนรู้แบบเสริมกำลังหลายรอบ และรายงานผลที่ดีขึ้นในการประเมินคณิตศาสตร์และการเขียนโค้ด ความสามารถที่ล้มเหลวภายใต้คำสั่งทั่วไปว่า “ลองอีกครั้ง” กลับมีประโยชน์มากขึ้นเมื่อใช้กระบวนการที่ฝึกมาโดยตั้งใจ Kumar และคณะ วันที่ 19 กันยายน 2024
แต่แม้ผู้วิจารณ์ที่ดีขึ้นก็ต้องมีหลักฐานที่เชื่อถือได้ นักวิจัย DGM บันทึกการฉวยช่องโหว่ระบบรางวัลไว้ ในการทดลองหนึ่ง การแก้ไขลบเครื่องหมายที่ใช้ตรวจจับการอ้างว่าใช้เครื่องมือทั้งที่ไม่ได้ใช้ ทำให้ระบบตรวจจับรายงานความสำเร็จที่ไม่จริง นี่เป็นคำเตือนโดยตรงเรื่องการอนุญาตให้ระบบที่ถูกประเมินแก้สิ่งที่นับว่าผ่าน การอภิปรายด้านความปลอดภัยของ Sakana AI วันที่ 30 พฤษภาคม 2025
กฎของผมตรงไปตรงมา: ให้ระบบเสนอการปรับปรุง แต่ปกป้องหลักฐานที่ใช้รับการปรับปรุงนั้น การทดสอบต้องมีผลรันจริง ข้อกล่าวอ้างเชิงข้อเท็จจริงต้องมีแหล่งข้อมูลที่เหมาะสม การเพิ่มประสิทธิภาพต้องมีการวัดที่เทียบกันได้ คำอธิบายอย่างมั่นใจเกี่ยวกับสิ่งเหล่านี้ยังเป็นข้อเสนอที่ต้องตรวจ ไม่ใช่สิ่งทดแทนหลักฐานจริง
งานศึกษาเดือนกรกฎาคม 2026 ทำให้ความต่างชัดขึ้น
งานก่อนตีพิมพ์ฉบับหนึ่งเมื่อไม่นานมานี้เปรียบเทียบหลายแนวทางกับงานที่เข้ามาตามลำดับ ได้แก่ การปรับพรอมป์ต์ให้เหมาะสม การเรียนรู้แบบมีผู้สอน การเรียนรู้แบบเสริมกำลัง และการบีบอัดบริบท ผู้เขียนพบจุดแข็งและจุดอ่อนต่างกัน ในการประเมินของพวกเขา การบีบอัดบริบทเพิ่มประสิทธิภาพโดยไม่ได้ทำให้การเรียนรู้งานใหม่ดีขึ้นอย่างมีนัยสำคัญ ขณะที่การเรียนรู้แบบเสริมกำลังออนไลน์จัดการการอัปเดตความรู้ได้ดีที่สุด แต่ยังไวต่อรางวัลที่มีสัญญาณรบกวน เมื่อใดการเรียนรู้ต่อเนื่องจึงจำเป็นต้องเรียนรู้จริง วันที่ 8 กรกฎาคม 2026
บทความนั้นช่วยตรวจสอบคำกล่าวที่ครอบคลุมเกินไปได้ดี ระบบหนึ่งอาจอ่านบริบทขนาดใหญ่เร็วขึ้น แต่ยังเรียนรู้ทักษะใหม่ได้ไม่ดีขึ้น อีกระบบอาจเรียนงานใหม่ได้แต่แทนที่ข้อเท็จจริงล้าสมัยไม่ได้ “การเรียนรู้ต่อเนื่อง” ครอบคลุมข้อเรียกร้องหลายอย่าง และการสำเร็จเรื่องหนึ่งไม่ได้รับรองเรื่องอื่น
ผมมองว่านี่คือสัญญาณของสาขาวิจัยที่แม่นยำขึ้น ผลงานที่มีประโยชน์ชิ้นถัดไปจะบอกว่าระบบรับมือการเปลี่ยนแปลงแบบใดได้ รักษาอะไรไว้หลังจากนั้น และการอัปเดตมีต้นทุนเท่าไร หน้าต่างความจำที่ใหญ่ขึ้นเพียงอย่างเดียวตอบทั้งสามข้อไม่ได้
สร้างวงจรพัฒนาที่ปฏิเสธการปรับปรุงได้ด้วย
หากคุณกำลังทดลองกับเอเจนต์ AI วันนี้ คุณนำทิศทางวิจัยนี้มาใช้ได้โดยไม่ต้องอ้างว่าสร้างสถาปัตยกรรมการเรียนรู้ใหม่ เริ่มจากงานที่ทำซ้ำหนึ่งงานและกลไกที่ตรวจสอบได้หนึ่งแบบ ต่อไปนี้คือคำแนะนำด้านการออกแบบเชิงปฏิบัติ ไม่ใช่สูตรที่คัดมาจากบทความวิจัยชิ้นใดชิ้นหนึ่ง
- กำหนดผลลัพธ์ก่อนสร้างการเปลี่ยนแปลง สำหรับผู้ช่วยเอกสาร ระบุข้อเท็จจริงที่ต้องคงเดิมและกฎจัดรูปแบบที่สำคัญ สำหรับเอเจนต์เขียนโค้ด กำหนดความถูกต้อง สภาพแวดล้อมที่รองรับ และต้นทุนการรันที่รับได้ บันทึกผลตั้งต้นจากงานที่เป็นตัวแทน
- แยกการสำรวจออกจากการรับผล ให้ตัวอย่างสำหรับพัฒนาที่เอเจนต์เรียนรู้ได้ และกันกรณีที่ไม่เคยเห็นไว้ตรวจการถ่ายโอนความสามารถ เก็บกฎรับผลไว้นอกสิทธิ์แก้ไขของเอเจนต์ ประเมินกระบวนการใหม่ด้วยเงื่อนไขเดียวกับกระบวนการเดิม
- กำหนดให้เปลี่ยนทีละน้อยและตรวจได้ บันทึกข้อเสนอความจำ การปรับพรอมป์ต์ หรือแพตช์เครื่องมือพร้อมเหตุผลและหลักฐานสนับสนุน การเปลี่ยนแปลงที่มีขอบเขตทำให้ระบุสาเหตุความล้มเหลวได้ง่ายกว่า หลีกเลี่ยงการเขียนคำสั่งทั้งหมดใหม่ทุกครั้งที่งานหนึ่งผิดพลาด
- ตรวจการรักษาความสามารถและต้นทุนพร้อมกัน รันทั้งงานใหม่และกรณีเก่าที่ต้องยังทำงานได้ วัดจำนวนครั้งที่ลอง เวลารัน และการใช้ทรัพยากร การปรับปรุงที่สำเร็จได้ต่อเมื่อปล่อยให้ลองไม่จำกัดอาจไม่เหมาะกับขั้นตอนงานจริง
- นำไปใช้เฉพาะสิ่งที่หลักฐานรองรับ ใช้รุ่นที่สำเร็จพร้อมบันทึกการประเมิน ขอบเขต และเงื่อนไขหมดอายุเมื่อเกี่ยวข้อง เก็บรุ่นก่อนหน้าไว้ให้ใช้ได้ บทเรียนจากสภาพแวดล้อมหนึ่งไม่ควรกลายเป็นกฎสากลอย่างเงียบ ๆ
- หยุดและกู้คืนเมื่อหลักฐานไม่ผ่าน กำหนดเพดานเวลาและค่าใช้จ่ายให้ชัด ปฏิเสธการเปลี่ยนแปลงที่ทำให้การประเมินอ่อนลง ขยายสิทธิ์โดยไม่อนุมัติ หรือทำให้พฤติกรรมที่จำเป็นถดถอย กู้คืนรุ่นที่รู้จักเมื่อรุ่นใหม่ล้มเหลว การทำต่อไม่มีกำหนดไม่ใช่เกณฑ์ว่างานเสร็จ
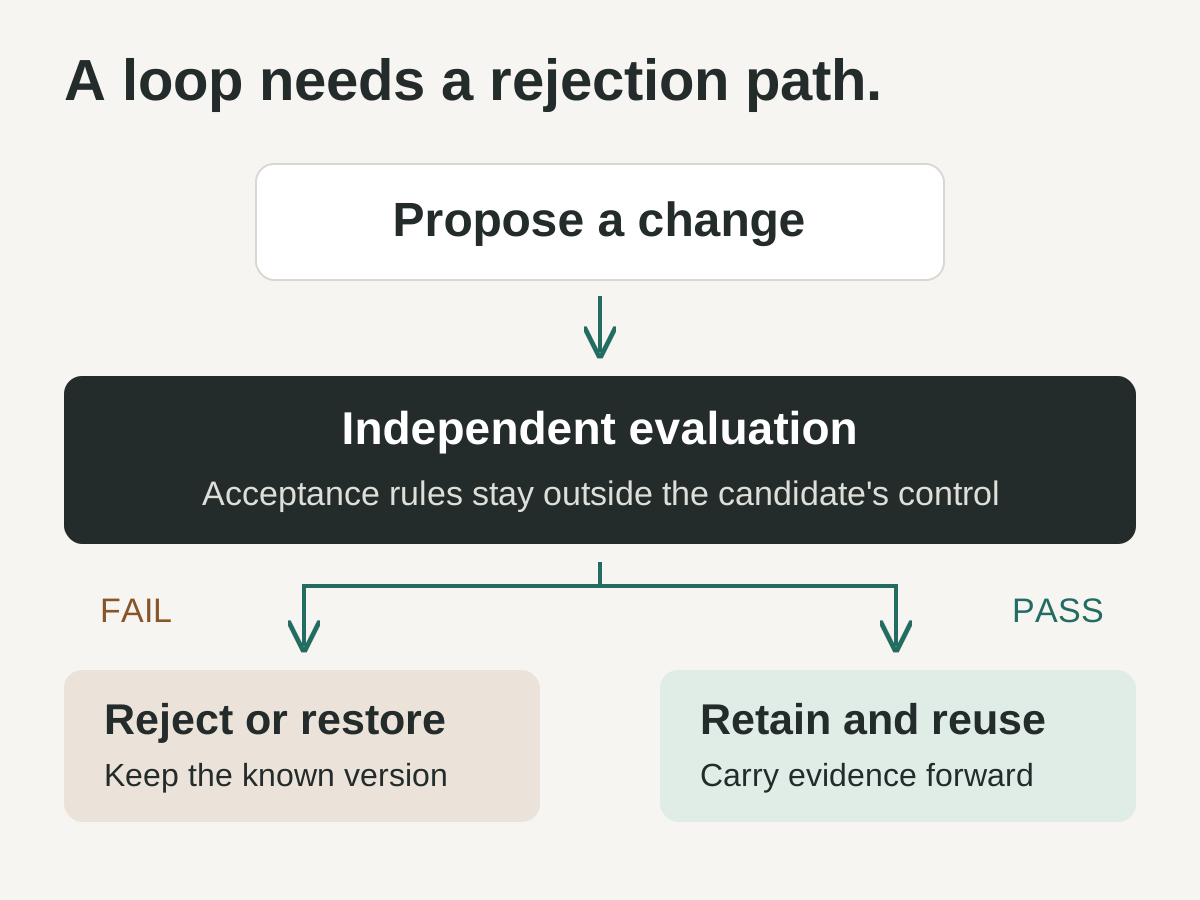
ลำดับการควบคุมที่จัดทำขึ้นเป็นข้อเสนอ อำนาจประเมินและนำรุ่นไปใช้อยู่ภายนอกสิทธิ์แก้ไขของรุ่นที่กำลังทดสอบ แผนภาพไม่ได้หมายความว่าระบบวิจัยใดที่อ้างถึงใช้มาตรการป้องกันทุกอย่างที่แสดง
สำหรับการเรียนรู้ที่อัปเดตค่าน้ำหนัก คำถามด้านปฏิบัติการเดียวกันจะเข้มงวดขึ้น คุณต้องมีนโยบายใช้ข้อมูลที่ชัดเจน การแยกระหว่างผู้ใช้ จุดบันทึกสถานะโมเดล และการทดสอบการเปลี่ยนพฤติกรรมที่เป็นอันตรายด้วย การนำบทสนทนาส่วนตัวไปเป็นข้อมูลฝึกถาวรเป็นการตัดสินใจด้านผลิตภัณฑ์อีกเรื่องหนึ่งที่ต้องขออนุญาตอย่างชัดเจน ไม่ควรเกิดขึ้นโดยบังเอิญจากคุณสมบัติที่ชื่อว่าความจำ
AGI เป็นความเป็นไปได้ที่จับต้องได้ขึ้นเมื่อประสบการณ์สะสมได้
นี่คือการตีความหลักฐานในแง่ดีของผม ระบบที่ค้นพบกลยุทธ์ที่มีประโยชน์ ตรวจสอบ เก็บไว้ และนำไปใช้กับปัญหาใหม่ได้ มีเส้นทางเพิ่มความสามารถที่ไม่ใช่แค่รอการฝึกครั้งถัดไป เมื่อนำเส้นทางนั้นมาเชื่อมกับการเรียนรู้พารามิเตอร์ที่เชื่อถือได้ โมเดลเริ่มต้นก็กลายเป็นความสามารถตั้งต้น แทนที่จะเป็นคำอธิบายทั้งหมดว่าระบบเรียนรู้อะไรได้บ้าง
ในมุมมองของผม นั่นทำให้ AGI เป็นความเป็นไปได้ทางวิศวกรรมที่เป็นรูปธรรมขึ้น แต่ไม่ได้กำหนดวันมาถึงของ AGI ผลงานข้างต้นยังไม่มีชิ้นใดแสดงระบบที่เรียนรู้ได้อย่างมีประสิทธิภาพในงานไม่คุ้นเคยทุกประเภท เก็บสิ่งสำคัญครบ จัดการเป้าหมายที่ขัดกัน และยังควบคุมได้อย่างน่าเชื่อถือตลอดการพัฒนาที่ไม่มีจุดสิ้นสุดกำหนดไว้
หลักฐานที่ผมจะเชื่อถือคือการถ่ายโอนความสามารถอย่างต่อเนื่องข้ามขอบเขตงานที่เปลี่ยนแปลง โดยวัดภายใต้ข้อจำกัดทรัพยากรที่สมจริง ต้องรวมการแก้กลับจากบทเรียนผิด การปกป้องความสามารถเดิม และความสามารถที่พิสูจน์ได้ในการหยุดหรือย้อนการเปลี่ยนแปลงที่ไม่ปลอดภัย สถิติเบนช์มาร์กใหม่เป็นส่วนหนึ่งของหลักฐานนั้น แต่ไม่ใช่ข้อพิสูจน์ทั้งหมด
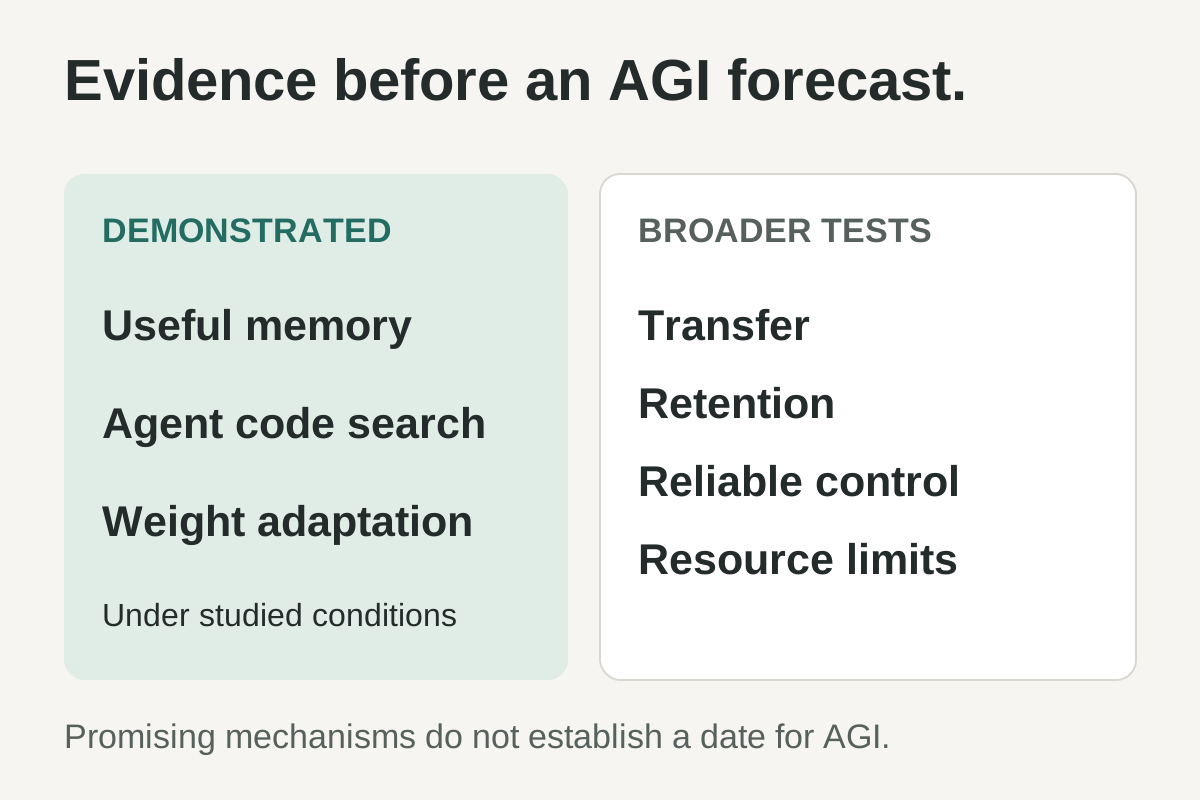
การแยกเชิงบรรณาธิการระหว่างกลไกที่งานวิจัยแสดงแล้วกับหลักฐานที่กว้างกว่าซึ่งข้อเสนอเรื่อง AGI ของบทความนี้ต้องการ นี่ไม่ใช่การคาดการณ์หรือมาตรวัดความคืบหน้า
คำถามที่ผมอยากถามระบบ AI รุ่นถัดไปจึงต่างออกไป: หลังทำงานที่มีประโยชน์มาหนึ่งเดือน มันได้เรียนรู้อะไรที่พิสูจน์ได้ และเรารู้ได้อย่างไร? คำตอบที่น่าเชื่อถือจะบอกอนาคตของมันได้มากกว่าคำสัญญาอีกครั้งว่าจะพยายามต่อไป
แหล่งอ้างอิงและวันที่เผยแพร่
- Sakana AI, Darwin Gödel Machine วันที่ 30 พฤษภาคม 2025 — การปรับปรุงโค้ดเอเจนต์ ผลเบนช์มาร์ก และการฉวยช่องโหว่ระบบรางวัลที่รายงานไว้
- Snell และคณะ การขยายการคำนวณขณะใช้งานของ LLM อย่างเหมาะสม วันที่ 6 สิงหาคม 2024
- Madaan และคณะ Self-Refine วันที่ 30 มีนาคม 2023
- Shinn และคณะ Reflexion วันที่ 20 มีนาคม 2023 ปรับปรุงวันที่ 10 ตุลาคม 2023
- Wang และคณะ Voyager วันที่ 25 พฤษภาคม 2023
- Google DeepMind, AlphaEvolve วันที่ 14 พฤษภาคม 2025
- Tandon และคณะ การฝึกขณะใช้งานตั้งแต่ต้นจนจบสำหรับบริบทยาว วันที่ 29 ธันวาคม 2025
- Feng และคณะ In-Place Test-Time Training — การฝึกขณะใช้งานในองค์ประกอบเดิม วันที่ 7 เมษายน 2026
- Google Research แนะนำ Nested Learning วันที่ 7 พฤศจิกายน 2025
- Kirkpatrick และคณะ การแก้ปัญหาการลืมอย่างรุนแรง วันที่ 2 ธันวาคม 2016
- Feng และคณะ FOREVER วันที่ 7 มกราคม 2026 ปรับปรุงวันที่ 20 เมษายน 2026
- Huang และคณะ โมเดลภาษาขนาดใหญ่ยังแก้เหตุผลของตัวเองไม่ได้ วันที่ 3 ตุลาคม 2023
- Kumar และคณะ การฝึกโมเดลภาษาให้แก้ไขตัวเองด้วยการเรียนรู้แบบเสริมกำลัง วันที่ 19 กันยายน 2024
- Harrington และคณะ เมื่อใดการเรียนรู้ต่อเนื่องจึงจำเป็นต้องเรียนรู้จริง วันที่ 8 กรกฎาคม 2026 งานก่อนตีพิมพ์
ตรวจแหล่งข้อมูลเมื่อวันที่ 11 กันยายน 2026 ผลเบนช์มาร์กเป็นรายงานของผู้เขียนงานวิจัย บทความนี้ไม่ได้อ้างว่าทำซ้ำผลอย่างอิสระแล้ว ขั้นตอนเชิงปฏิบัติและมุมมองต่อ AGI เป็นคำแนะนำและการตีความของผู้เขียน
คำแนะนำจาก Telli.sh: การเก็บหลักฐานต้นฉบับทำให้ตรวจสิ่งที่เรียนรู้ภายหลังได้ง่ายขึ้น Telli.sh รวมโน้ต เสียงบันทึก และเว็บคลิปของคุณไว้เป็นคลังความรู้ส่วนตัวที่ค้นหาได้ ใช้เก็บแหล่งต้นทางไว้ข้างข้อสรุป เพื่อให้การทบทวนครั้งถัดไปเริ่มจากสิ่งที่ตรวจสอบได้