Selepas model dilancarkan: 5 cara AI terus bertambah baik dan maknanya untuk AGI
Satu proses latihan model tidak lagi menerangkan keseluruhan keupayaannya. Penyelidikan daripada Reflexion dan Voyager hingga AlphaEvolve, latihan semasa ujian dan eksperimen pembelajaran berterusan pada 2026 menunjukkan cara sistem AI boleh mengekalkan pengalaman yang berguna. Apa yang sebenarnya berubah, di mana buktinya kukuh dan mengapa penambahbaikan yang boleh dipercayai lebih penting daripada gelung tanpa henti.
Pada Mei 2025, penyelidik melaporkan agen pengekodan yang meningkatkan prestasinya dalam SWE-bench daripada 20.0% kepada 50.0% dengan mengubah kod agennya sendiri. Model bahasa yang mendasarinya tidak memerlukan nombor generasi baharu. Sistem di sekelilingnya telah mempelajari cara bekerja yang lebih baik. Itulah Darwin Gödel Machine, dan perbezaan tersebut lebih menarik daripada skor yang menjadi tajuk utama.
Kita sering menggambarkan kemajuan AI sebagai urutan model yang sudah siap: latih satu model, lancarkannya, kemudian tunggu pengganti yang lebih pintar. Bidang penyelidikan yang semakin berkembang kini bertanya apa yang berlaku di antara pelancaran itu. Bolehkah sistem belajar daripada cubaan yang gagal, mengekalkan kemahiran yang berguna, menambah baik alatnya atau menyesuaikan sebahagian pemberatnya semasa bekerja?
Pada pandangan saya, ini antara alasan paling kukuh untuk bersikap optimistik tentang AI yang lebih umum keupayaannya. Namun, optimisme itu memerlukan istilah yang jelas. Artikel ini memisahkan lima jenis penambahbaikan, meneliti hasil hingga Julai 2026 dan menerangkan ujian yang mesti dilalui oleh sistem yang terus bertambah baik sebelum kemajuannya layak dipercayai.
Hujah dalam tiga perkara
- Model yang tidak berubah boleh menghasilkan sistem yang lebih berkeupayaan apabila memori, alat atau proses penyelesaian masalahnya bertambah baik.
- Penyelidik turut menguji kemas kini pemberat sebenar semasa penggunaan. Mengingati perbualan dan melatih rangkaian neural masih merupakan operasi yang berbeza.
- Kemajuan ke arah AGI memerlukan pembelajaran berguna yang boleh dipindahkan ke situasi lain, mengekalkan keupayaan terdahulu dan kekal di bawah kawalan manusia. Mengulangi gelung hanyalah permulaan.
Model yang tetap tidak pernah menjadi had mutlak bagi setiap tugasan
Latihan menetapkan parameter model: nilai berangka yang digunakan untuk memproses input dan menjana output. Dalam inferens biasa, nilai-nilai itu kekal. Namun, itu tidak bermakna jawapan ditentukan oleh latihan sahaja. Berikan bukti yang relevan, kalkulator yang berfungsi atau prosedur carian yang lebih baik, dan prestasi sistem boleh berubah tanpa mengubah parameter tersebut.
Penyelidikan mengenai komputasi semasa inferens menjadikan perkara itu boleh diukur. Dalam kajian Ogos 2024, Charlie Snell dan rakan-rakan melaporkan kecekapan lebih daripada 4× berbanding garis dasar best-of-N apabila komputasi tambahan diperuntukkan secara adaptif untuk penaakulan matematik. Hasilnya bergantung pada masalah dan persediaan penilaian; ia tidak mengatakan bahawa mana-mana model kecil boleh menyelesaikan apa sahaja jika dibiarkan berjalan cukup lama. Makalah, 6 Ogos 2024.
Soalannya menjadi: apa yang berubah dan apa yang kekal selepas tugasan semasa selesai? Lima mekanisme wajar dibezakan.
| Mekanisme | Apa yang berubah? | Apa yang boleh kekal? | Apa yang tidak dibuktikannya |
|---|---|---|---|
| Carian atau semakan semasa inferens | Calon jawapan dan proses penaakulan semasa | Biasanya tiada apa-apa melainkan disimpan secara jelas | Peningkatan keupayaan model yang berkekalan |
| Memori luaran | Fakta tersimpan, maklum balas dan pengalaman yang diperoleh semula | Rekod yang tersedia untuk tugasan kemudian | Bahawa pemberat model telah mempelajari rekod tersebut |
| Penambahbaikan alat atau agen | Kemahiran boleh laksana, prompt dan kod kerja | Konfigurasi sistem yang boleh digunakan semula | Perubahan kepada model asas yang mendasarinya |
| Latihan semasa ujian | Parameter terpilih yang boleh dilatih ketika memproses input baharu | Bergantung pada kaedah dan dasar tetapan semula | Pengekalan automatik sepanjang hayat merentas pengguna dan tugasan |
| Pembelajaran parameter berterusan | Parameter model sepanjang urutan pengalaman | Keupayaan yang dikemas kini, jika berjaya dikekalkan | Kebebasan daripada lupa, hanyutan tingkah laku atau kemas kini yang memudaratkan |
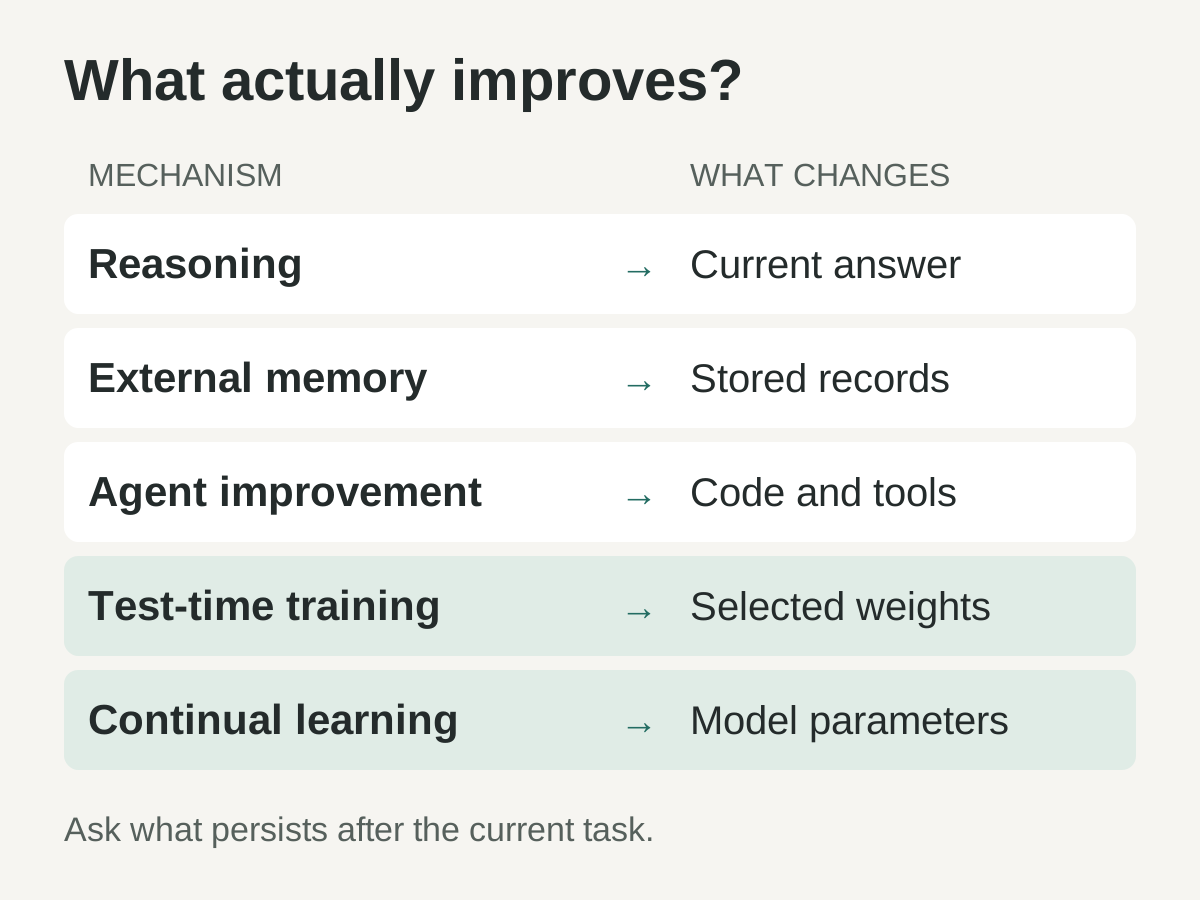
Perbandingan editorial bagi mekanisme yang dikaji dalam penyelidikan yang dirujuk. Pengekalan bergantung pada apa yang disimpan dan digunakan semula oleh sistem; ini bukan lima tahap kematangan yang berturutan.
Namakan bahagian yang bernilai itu peningkatan yang berkekalan: penambahbaikan yang masih wujud selepas cubaan yang menghasilkannya tamat dan membantu kerja seterusnya. Sifat itulah yang patut dicari di sebalik dakwaan bahawa sesuatu AI “belajar.”
Gelung awal memperbaiki jawapan, kemudian mula menyimpan pengajaran
Self-Refine, yang mula diserahkan pada Mac 2023, memberikan satu model tiga tugas: menghasilkan jawapan, mengkritiknya dan menyemaknya semula. Penulisnya menilai tujuh tugasan tanpa latihan model tambahan. Ini menunjukkan cara praktikal mendapatkan lebih banyak manfaat daripada model sedia ada, sambil membiarkan persoalan terbuka tentang sama ada manfaatnya boleh dipindahkan melangkaui input semasa. Self-Refine, 30 Mac 2023.
Reflexion memindahkan maklum balas yang berguna ke dalam memori episodik yang boleh mempengaruhi cubaan kemudian. Makalah itu secara jelas menerangkan pembelajaran melalui bahasa dan bukannya kemas kini pemberat. Angka 91% HumanEval pass@1 yang dilaporkan menilai program akhir selepas prosedur agen yang menggunakan ujian janaan sendiri dan maklum balas; ia bukan kadar kejayaan satu panggilan model tanpa bantuan. Reflexion, mula diserahkan 20 Mac 2023; disemak 10 Oktober 2023.
Voyager kemudian menjadikan apa yang dikekalkan itu boleh dilaksanakan. Agen Minecraft ini mengumpulkan pustaka kemahiran kod yang boleh diguna semula, digabungkan dengan kurikulum automatik dan maklum balas persekitaran. Penulisnya melaporkan 3.3× lebih banyak item unik berbanding sistem terbaik terdahulu dalam eksperimen mereka, sambil menggunakan GPT-4 melalui API tanpa penalaan halus parameter. Voyager, 25 Mei 2023.
Projek-projek ini mencadangkan perbezaan yang berguna untuk kerja harian dengan AI. Pembantu yang menulis “Saya patut menyemak format input pada masa akan datang” telah menyimpan satu cadangan. Pembantu yang mengekalkan alat pemeriksaan input yang sudah disahkan telah menyimpan keupayaan yang boleh dipanggil oleh tugasan lain. Kedua-duanya boleh membantu, tetapi memerlukan bukti dan penyelenggaraan yang berbeza.
Fail memori mengubah apa yang boleh dirujuk agen; kemas kini melalui latihan mengubah parameter model. Panduan pelengkap kami tentang memori, arahan dan prompt menerangkan cara menggunakan lapisan ini dengan sengaja dalam kerja harian.
Memperbaiki kaedah boleh sama pentingnya dengan memperbaiki jawapan
Darwin Gödel Machine meluaskan idea ini kepada pelaksanaan agen itu sendiri. Cariannya mengekalkan arkib varian agen dan menilai perubahan pada tugasan pengekodan. Hasil Polyglot yang dilaporkan meningkat daripada 14.2% kepada 30.7%. Ini ialah keputusan penanda aras yang dilaporkan penulis bagi sistem eksperimen, bukannya bukti penambahbaikan diri tanpa sekatan dalam dunia terbuka. Sakana AI, 30 Mei 2025.
AlphaEvolve menawarkan contoh nyata yang berbeza. Ia menggabungkan cadangan model bahasa dengan penilaian automatik dan carian evolusi terhadap program. Google melaporkan bahawa heuristik penjadualan yang ditemukan memulihkan purata 0.7% sumber komputasi seluruh dunia, dan kernel yang ditambah baik mengurangkan masa latihan Gemini sebanyak 1%. Itu ialah ukuran infrastruktur yang dilaporkan Google. Sistem tersebut memperbaiki algoritma yang digunakan dalam pengeluaran AI, bukannya melatih kecerdasan umum baharu secara autonomi. Google DeepMind, 14 Mei 2025.
Di sinilah prospeknya menjadi menarik. Alat yang lebih baik boleh menjadikan eksperimen seterusnya lebih murah. Eksperimen yang lebih baik boleh menghasilkan alat yang lebih baik. Jika peningkatan itu diperiksa secara bebas dan dikekalkan, kemajuan boleh terkumpul di antara pelancaran model asas.
Proses ini tidak semestinya semakin pantas selama-lamanya. Carian boleh kehabisan pilihan yang berguna, berdepan kekangan yang tidak dapat diatasi oleh model semasa atau membelanjakan lebih banyak untuk penilaian berbanding penjimatan hasil penambahbaikan. Dakwaan yang bermakna lebih khusus: sesetengah unsur keupayaan masa depan boleh dihasilkan oleh sistem semasa dan dinilai sebelum diterima pakai.
Latihan semasa ujian mengubah bahagian sistem yang berbeza
Menyimpan skrip yang berjaya mengubah persekitaran kerja. Latihan semasa ujian mengubah parameter yang boleh dilatih ketika maklumat baharu diproses. Ini menjadikannya arah penyelidikan yang berasingan, dengan persoalannya sendiri tentang kos, gangguan antara pembelajaran dan pengekalan.
Pada Disember 2025, End-to-End Test-Time Training for Long Context menganggap konteks yang masuk sebagai bahan untuk pembelajaran lanjutan melalui ramalan token seterusnya. Eksperimennya menggunakan model berparameter 3 bilion yang dilatih pada 164 bilion token. Penulisnya melaporkan inferens 2.7× lebih pantas pada konteks 128K berbanding model perbandingan dengan perhatian penuh, sambil menerangkan kaedah yang memampatkan maklumat daripada konteks ke dalam pemberat. Tandon dan rakan-rakan, 29 Disember 2025.
Dakwaan itu merujuk kepada seni bina, beban kerja dan persediaan inferens yang diuji. Ia bukan ukuran bahawa model menjadi 2.7 kali lebih pintar, dan bukan bukti bahawa setiap fakta baharu kekal tersedia tanpa had masa. Memampatkan dokumen panjang secara berkesan sudah pun bernilai; ia tidak memerlukan dakwaan tambahan itu.
In-Place Test-Time Training menangani keserasian dengan komponen model sedia ada. Makalah April 2026 itu menggunakan matriks terpilih dalam blok MLP standard sebagai pemberat yang boleh disesuaikan, serta merangkumi eksperimen dengan model berparameter 4 bilion pada konteks 128K. Pelaksanaannya menetapkan semula pemberat pantas pada sempadan dokumen, contoh nyata bahawa penyesuaian tidak semestinya membayangkan memori tanpa had masa. Rekod arXiv mengenal pastinya sebagai pembentangan lisan ICLR 2026. Feng dan rakan-rakan, 7 April 2026.
Penyelidikan Nested Learning daripada Google Research turut meneroka komponen yang dikemas kini pada skala masa yang berbeza. Pengumumannya pada November 2025 memperkenalkan seni bina Hope sebagai bukti konsep. Pembingkaian itu penting: seni bina pembelajaran yang menjanjikan ialah hasil penyelidikan untuk diteliti, bukannya pengisytiharan bahawa pembelajaran umum sepanjang hayat telah diselesaikan. Google Research, 7 November 2025.
Secara bersama, arah penyelidikan ini menjadikan batas antara latihan dan penggunaan kurang tegar. Namun, ia tidak menghapuskan batas tersebut. Bagi sistem yang digunakan dalam operasi sebenar, kita masih perlu tahu parameter mana yang berubah, data apa yang menyebabkan perubahan itu, siapa yang mendapat manfaat dan bila kemas kini itu ditetapkan semula.
Mempelajari sesuatu yang baharu tidak boleh memadam apa yang sudah berfungsi
Pembelajaran berterusan mempunyai masalah lama dengan kesan yang sangat relevan hari ini: penyesuaian kepada tugasan baharu boleh menjejaskan prestasi pada tugasan terdahulu. Penyelidikan klasik elastic weight consolidation, yang mula diserahkan pada Disember 2016, menanganinya dengan mengehadkan perubahan pada parameter yang penting bagi tugasan terdahulu. Eksperimennya melibatkan pengelasan dan permainan Atari, bukannya penggunaan LLM serba guna masa kini. Kirkpatrick dan rakan-rakan.
Masalah ini masih menarik penyelidikan yang nyata. FOREVER, mula diserahkan pada Januari 2026 dan disemak pada April, melaraskan pengulangan contoh dalam memori berdasarkan magnitud kemas kini model. Penulisnya melaporkan pengurangan kelupaan merentas tiga penanda aras pembelajaran berterusan, dengan saiz model antara 0.6 bilion hingga 13 bilion parameter. Itu ialah bukti bagi satu kaedah dalam keadaan tersebut, bukannya jaminan pengekalan tanpa had. FOREVER.
Bagi pengguna, keperluan praktikalnya mudah dinyatakan. Pembantu yang mempelajari amalan pelaporan baharu patut mengekalkan kebolehan menghasilkan laporan yang tepat. Agen yang menyesuaikan diri dengan laman web yang direka semula patut masih mengendalikan aliran kerja yang disokong sebelum ini. Kemajuan perlu dibandingkan dengan keupayaan terdahulu, selain dinilai pada tugasan terkini.
Memori luaran mempunyai masalah penyelenggaraan yang berkaitan, walaupun pemberat tidak pernah berubah. Rekod lama boleh bercanggah dengan rekod baharu. Penyelesaian sementara boleh kekal lebih lama daripada insiden yang mewajarkannya. Menyimpan semuanya tanpa pemilihan bukan pengganti yang baik kepada rekod tentang apa yang dipelajari, bila ia disemak dan bila ia patut berhenti mempengaruhi keputusan.
Model mengatakan “lebih baik” belum menjadi bukti yang mencukupi
Literatur tidak menyokong dakwaan menyeluruh bahawa kritikan kendiri sentiasa berkesan. Kajian Oktober 2023 mendapati model yang diuji sukar membetulkan penaakulan tanpa maklum balas luaran dan kadangkala menjadikan jawapan mereka lebih buruk. Tajuknya mengandungi perkataan penting: Yet, atau “belum.” Ini ialah dapatan tentang model dan kaedah tertentu, bukan teorem bahawa pembetulan kendiri mustahil. Huang dan rakan-rakan, 3 Oktober 2023.
Penyelidikan berikutnya mengukuhkan perbezaan tersebut. SCoRe, mula diserahkan pada September 2024, melatih pembetulan kendiri melalui pembelajaran pengukuhan berbilang giliran dan melaporkan peningkatan pada penilaian matematik dan pengekodan. Keupayaan yang gagal di bawah arahan umum “cuba lagi” menjadi lebih berguna melalui prosedur yang dilatih secara sengaja. Kumar dan rakan-rakan, 19 September 2024.
Namun, pengkritik yang lebih baik juga memerlukan bukti yang boleh dipercayai. Penyelidik DGM mendokumenkan manipulasi ganjaran: dalam satu eksperimen, perubahan membuang penanda yang digunakan untuk mengesan penggunaan alat yang direka-reka, lalu menghasilkan kejayaan palsu pada pengesan. Ini amaran langsung tentang membenarkan sistem yang sedang dinilai mengubah apa yang dikira sebagai lulus. Perbincangan keselamatan Sakana AI, 30 Mei 2025.
Peraturan saya mudah: benarkan sistem mencadangkan penambahbaikan, tetapi lindungi bukti yang digunakan untuk menerimanya. Ujian memerlukan hasil pelaksanaan sebenar. Dakwaan fakta memerlukan sumber yang sesuai. Peningkatan prestasi memerlukan ukuran yang setanding. Penjelasan yang yakin tentang mana-mana perkara ini ialah cadangan untuk diperiksa, bukan pengganti perkara itu sendiri.
Kajian Julai 2026 memperjelas perbezaan itu
Satu pracetak terkini membandingkan beberapa pendekatan dalam tugasan berjujukan: pengoptimuman prompt, pembelajaran terselia, pembelajaran pengukuhan dan pemampatan konteks. Penulisnya menemukan kekuatan dan kelemahan yang berbeza. Dalam penilaian mereka, pemampatan konteks meningkatkan kecekapan tanpa banyak memperbaiki pembelajaran tugasan baharu, manakala pembelajaran pengukuhan dalam talian paling baik mengendalikan kemas kini pengetahuan tetapi masih sensitif kepada ganjaran yang bising. Bilakah Pembelajaran Berterusan Memerlukan Pembelajaran, 8 Julai 2026.
Makalah itu berguna untuk menilai dakwaan yang terlalu menyeluruh. Sistem boleh menjadi lebih pantas membaca konteks besar tanpa menjadi lebih baik dalam memperoleh kemahiran baharu. Sistem lain boleh mempelajari tugasan baharu tetapi gagal menggantikan fakta yang lapuk. “Pembelajaran berterusan” merangkumi pelbagai tuntutan, dan kejayaan pada satu daripadanya tidak mengesahkan yang lain.
Saya melihatnya sebagai tanda bidang penyelidikan yang semakin tepat. Hasil berguna seterusnya akan memberitahu kita jenis perubahan yang boleh dikendalikan sistem, apa yang dikekalkan selepas itu dan berapa kos kemas kininya. Tetingkap memori yang lebih besar sahaja tidak boleh menjawab ketiga-tiganya.
Bina gelung penambahbaikan yang boleh menolak penambahbaikan
Jika anda sedang bereksperimen dengan agen AI, anda boleh menerapkan arah penyelidikan ini tanpa mendakwa telah membina seni bina pembelajaran baharu. Mulakan dengan satu tugasan berulang dan satu mekanisme yang boleh diperiksa. Berikut ialah cadangan reka bentuk praktikal, bukan resipi yang disalin daripada mana-mana satu makalah.
- Tetapkan hasil sebelum menjana perubahan. Bagi pembantu dokumen, nyatakan fakta yang mesti kekal utuh dan peraturan pemformatan yang penting. Bagi agen pengekodan, tetapkan ketepatan, persekitaran yang disokong dan kos pelaksanaan yang boleh diterima. Rekodkan garis dasar pada tugasan yang mewakili penggunaan sebenar.
- Asingkan penerokaan daripada penerimaan. Berikan agen contoh pembangunan yang boleh dipelajarinya dan simpan kes yang belum pernah dilihat untuk menguji pemindahan keupayaan. Letakkan peraturan penerimaan di luar kebenaran menyunting agen. Nilai prosedur baharu dalam keadaan yang sama seperti prosedur lama.
- Minta perubahan kecil yang boleh diperiksa. Simpan cadangan entri memori, semakan prompt atau tampalan alat berserta sebab dan bukti sokongannya. Perubahan yang terhad memudahkan punca kegagalan dikenal pasti. Elakkan menulis semula setiap arahan setiap kali satu tugasan bermasalah.
- Semak pengekalan dan kos bersama-sama. Jalankan tugasan baharu serta kes lama yang mesti terus berfungsi. Ukur bilangan cubaan, masa pelaksanaan dan penggunaan sumber. Penambahbaikan yang hanya berjaya selepas percubaan semula tanpa had mungkin tidak sesuai untuk aliran kerja sebenar.
- Terima pakai hanya perkara yang disokong bukti. Gunakan versi yang berjaya bersama rekod penilaian, skop dan syarat tamat tempoh jika berkaitan. Pastikan versi terdahulu tersedia. Pengajaran tentang satu persekitaran tidak patut menjadi peraturan sejagat secara senyap.
- Berhenti dan pulihkan apabila bukti gagal menyokongnya. Tetapkan had masa dan perbelanjaan yang jelas. Tolak perubahan yang melemahkan penilaian, meluaskan kebenaran tanpa kelulusan atau menjejaskan tingkah laku yang diperlukan. Pulihkan versi yang diketahui apabila versi baharu gagal; meneruskan kerja tanpa henti bukan kriteria penyelesaian.
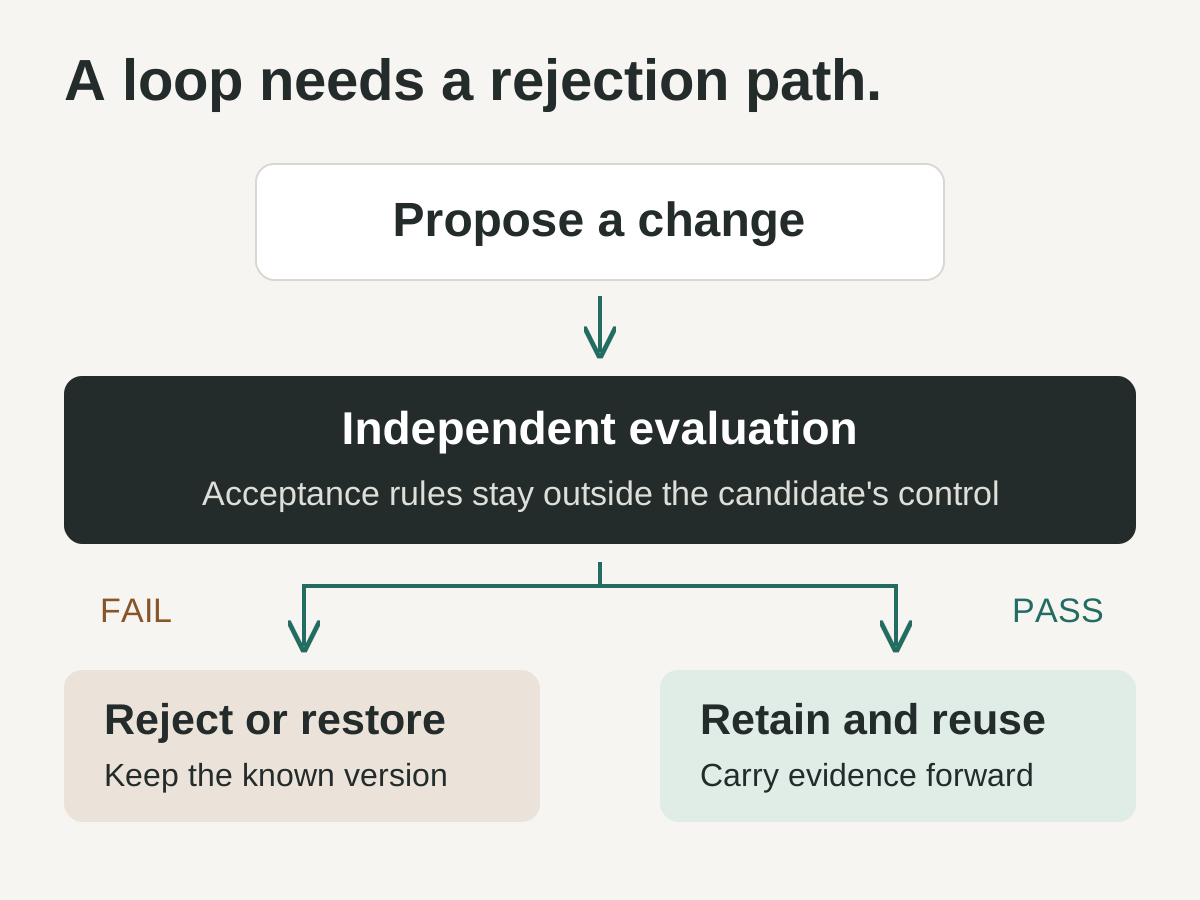
Aliran kawalan asal yang disyorkan. Kuasa penilaian dan penerimaan versi kekal di luar kebenaran menyunting calon; rajah ini tidak membayangkan bahawa setiap sistem penyelidikan yang dirujuk melaksanakan semua perlindungan yang ditunjukkan.
Untuk pembelajaran yang mengemas kini pemberat, persoalan operasi yang sama menjadi lebih mencabar. Anda juga memerlukan dasar penggunaan data yang jelas, pemisahan antara pengguna, titik semakan model dan ujian bagi perubahan tingkah laku yang memudaratkan. Menjadikan perbualan peribadi sebagai bahan latihan kekal ialah keputusan produk berasingan yang memerlukan kebenaran jelas; ia tidak boleh menjadi akibat tidak sengaja daripada ciri yang dinamakan memori.
AGI menjadi kemungkinan lebih nyata apabila pengalaman boleh terkumpul
Inilah tafsiran optimistik saya terhadap bukti yang ada. Sistem yang boleh menemukan strategi berguna, mengesahkannya, mengekalkannya dan menerapkannya pada masalah baharu mempunyai laluan untuk menambah keupayaan tanpa hanya menunggu sesi latihan seterusnya. Hubungkan laluan itu dengan pembelajaran parameter yang boleh dipercayai, dan model permulaan menjadi keupayaan awal, bukannya keseluruhan cerita tentang apa yang sistem boleh pelajari.
Pada pandangan saya, ini menjadikan AGI kemungkinan kejuruteraan yang lebih nyata. Ia tidak menetapkan tarikh kedatangan AGI. Tiada satu pun hasil di atas menunjukkan sistem yang belajar dengan berkesan merentas seluruh julat tugasan asing, mengekalkan semua perkara penting, mengurus matlamat bercanggah dan kekal boleh dikawal dengan andal sepanjang pembangunan yang terbuka.
Bukti yang akan meyakinkan saya ialah pemindahan pembelajaran yang berterusan merentas bidang yang berubah, diukur di bawah had sumber yang realistik. Ia perlu merangkumi pemulihan daripada pengajaran yang salah, perlindungan keupayaan terdahulu dan kebolehan yang boleh ditunjukkan untuk menghentikan atau membalikkan perubahan tidak selamat. Rekod penanda aras baharu akan menjadi sebahagian daripada bukti itu, bukan keseluruhan hujahnya.
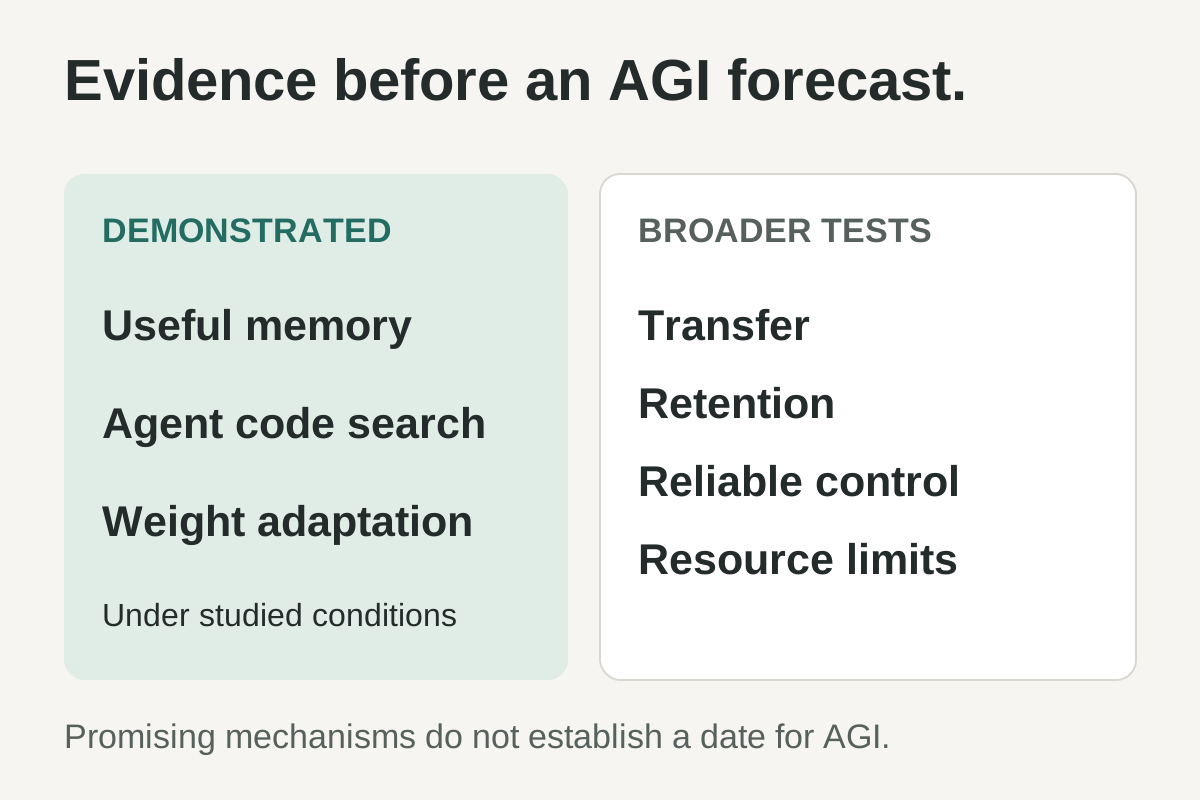
Pemisahan editorial antara mekanisme penyelidikan yang telah ditunjukkan dan bukti lebih luas yang dituntut oleh hujah AGI artikel ini. Ini bukan ramalan atau skala kemajuan yang diukur.
Oleh itu, soalan yang ingin saya ajukan kepada sistem AI seterusnya berbeza: selepas sebulan melakukan kerja yang berguna, apa yang terbukti telah dipelajarinya dan bagaimana kita mengetahuinya? Jawapan yang boleh dipercayai akan memberitahu kita lebih banyak tentang masa depannya berbanding satu lagi janji untuk terus mencuba.
Sumber dan tarikh penerbitan
- Sakana AI, Darwin Gödel Machine, 30 Mei 2025 — penambahbaikan kod agen, keputusan penanda aras dan manipulasi ganjaran yang dilaporkan.
- Snell dan rakan-rakan, menskalakan komputasi LLM semasa ujian secara optimum, 6 Ogos 2024.
- Madaan dan rakan-rakan, Self-Refine, 30 Mac 2023.
- Shinn dan rakan-rakan, Reflexion, 20 Mac 2023; disemak 10 Oktober 2023.
- Wang dan rakan-rakan, Voyager, 25 Mei 2023.
- Google DeepMind, AlphaEvolve, 14 Mei 2025.
- Tandon dan rakan-rakan, latihan semasa ujian hujung ke hujung untuk konteks panjang, 29 Disember 2025.
- Feng dan rakan-rakan, In-Place Test-Time Training, 7 April 2026.
- Google Research, memperkenalkan Nested Learning, 7 November 2025.
- Kirkpatrick dan rakan-rakan, mengatasi kelupaan katastrofik, 2 Disember 2016.
- Feng dan rakan-rakan, FOREVER, 7 Januari 2026; disemak 20 April 2026.
- Huang dan rakan-rakan, model bahasa besar belum dapat membetulkan penaakulan sendiri, 3 Oktober 2023.
- Kumar dan rakan-rakan, melatih model bahasa membuat pembetulan kendiri melalui pembelajaran pengukuhan, 19 September 2024.
- Harrington dan rakan-rakan, bilakah pembelajaran berterusan memerlukan pembelajaran, 8 Julai 2026, pracetak.
Sumber disemak pada 11 September 2026. Keputusan penanda aras dinyatakan sebagai laporan penulis asal; artikel ini tidak mendakwa penghasilan semula secara bebas. Prosedur praktikal dan pandangan tentang AGI ialah cadangan serta tafsiran penulis.
Saranan daripada Telli.sh: menyimpan bukti asal memudahkan pembelajaran kemudian disemak. Telli.sh menyatukan nota, rakaman dan klip web anda dalam koleksi pengetahuan peribadi yang boleh dicari. Gunakannya untuk menyimpan sumber bersama kesimpulan anda, supaya semakan seterusnya boleh bermula daripada sesuatu yang boleh diperiksa.