Dopo l'uscita del modello: 5 modi in cui l'IA può continuare a migliorare, e cosa significano per l'AGI
L'addestramento iniziale non racconta più tutta la storia delle capacità di un sistema IA. Da Reflexion e Voyager ad AlphaEvolve, al test-time training e agli esperimenti del 2026 sull'apprendimento continuo, la ricerca mostra come conservare esperienze utili. Cosa cambia davvero, dove le prove sono solide e perché un miglioramento verificabile conta più di un ciclo infinito.
Nel maggio 2025 alcuni ricercatori hanno presentato un agente di programmazione che aveva migliorato il proprio risultato su SWE-bench dal 20,0% al 50,0% modificando il proprio codice. Il modello linguistico sottostante non aveva bisogno di un nuovo numero di generazione. Il sistema che lo circondava aveva imparato a lavorare meglio. Era la Darwin Gödel Machine, e questa distinzione è più interessante del punteggio in evidenza.
Spesso descriviamo il progresso dell'IA come una successione di modelli finiti: addestrarne uno, pubblicarlo, aspettare un sostituto più intelligente. Un filone di ricerca in crescita chiede cosa possa succedere tra una versione e l'altra. Un sistema può imparare da un tentativo fallito, conservare una capacità utile, migliorare gli strumenti o adattare alcuni pesi mentre lavora?
A mio avviso, è una delle ragioni più credibili per essere ottimisti su un'IA più generale. Ma l'ottimismo richiede un vocabolario preciso. Questo articolo distingue cinque tipi di miglioramento, esamina risultati fino al luglio 2026 e spiega quali prove deve superare un sistema in miglioramento continuo prima che i suoi progressi meritino fiducia.
L'argomento in tre punti
- Un modello invariato può alimentare un sistema più capace quando migliorano memoria, strumenti o metodo di risoluzione dei problemi.
- I ricercatori stanno sperimentando anche veri aggiornamenti dei pesi durante l'utilizzo. Ricordare una conversazione e addestrare una rete neurale restano operazioni diverse.
- Avvicinarsi all'AGI richiederebbe un apprendimento utile che si trasferisca, conservi le capacità precedenti e rimanga sotto controllo umano. Ripetere un ciclo è solo l'inizio.
Un modello fisso non è mai stato un limite fisso per ogni compito
L'addestramento stabilisce i parametri del modello: i valori numerici usati per elaborare un input e generare un output. Nell'inferenza ordinaria questi valori restano fissi. Non significa che la risposta dipenda soltanto dall'addestramento. Fornisci al sistema prove pertinenti, una calcolatrice funzionante o una procedura di ricerca migliore, e le prestazioni possono cambiare senza modificare quei parametri.
La ricerca sul calcolo durante l'inferenza ha reso misurabile questo punto. In uno studio dell'agosto 2024, Charlie Snell e colleghi hanno riportato un'efficienza oltre quattro volte superiore a una procedura di riferimento best-of-N, distribuendo in modo adattivo il calcolo aggiuntivo per il ragionamento matematico. Il risultato dipendeva dal problema e dall'impostazione della valutazione; non diceva che qualsiasi piccolo modello può risolvere tutto se lo si lascia lavorare abbastanza a lungo. Articolo del 6 agosto 2024.
La domanda diventa: cosa cambia e cosa sopravvive al compito attuale? Cinque meccanismi meritano di essere tenuti distinti.
| Meccanismo | Cosa cambia? | Cosa può persistere? | Cosa non dimostra |
|---|---|---|---|
| Ricerca o revisione durante l'inferenza | Le risposte candidate e il processo di ragionamento attuale | Di solito nulla, salvo salvataggio esplicito | Un aumento duraturo delle capacità del modello |
| Memoria esterna | Fatti conservati, riscontri ed esperienze recuperate | Registrazioni disponibili ai compiti successivi | Che i pesi abbiano appreso quelle registrazioni |
| Miglioramento di strumenti o agenti | Capacità eseguibili, prompt e codice funzionante | Una configurazione del sistema riutilizzabile | Un cambiamento del modello di base sottostante |
| Test-time training | Parametri addestrabili selezionati durante l'elaborazione di nuovi input | Dipende dal metodo e dalla politica di ripristino | Memoria automatica per tutta la vita, tra utenti e compiti |
| Apprendimento continuo dei parametri | Parametri del modello lungo una sequenza di esperienze | Capacità aggiornate, se conservate con successo | Assenza di dimenticanza, deriva o aggiornamenti dannosi |
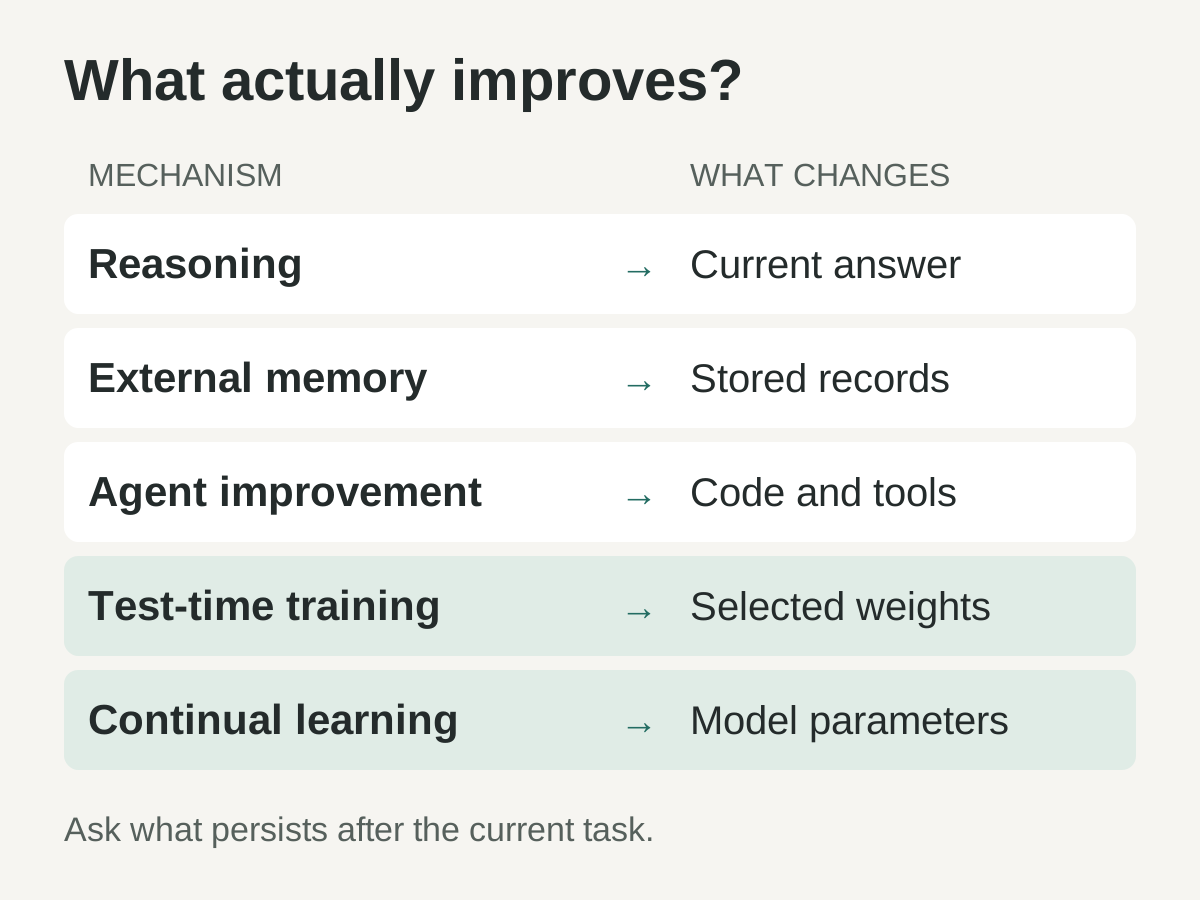
Confronto editoriale dei meccanismi studiati nelle ricerche citate. La persistenza dipende da ciò che il sistema conserva e riutilizza; non sono cinque livelli successivi di maturità.
Chiamiamo la parte preziosa il guadagno conservato: un miglioramento che sopravvive al tentativo da cui è nato e aiuta nel lavoro successivo. È questa la proprietà da cercare dietro l'affermazione che un'IA «impara».
I primi cicli miglioravano le risposte, poi hanno iniziato a conservare le lezioni
Self-Refine, presentato per la prima volta nel marzo 2023, assegnava a un modello tre compiti: produrre una risposta, criticarla e rivederla. Gli autori hanno valutato sette compiti senza ulteriore addestramento. Hanno mostrato un modo pratico per ottenere di più da un modello esistente, lasciando però aperta la domanda sul trasferimento dei benefici oltre l'input attuale. Self-Refine, 30 marzo 2023.
Reflexion spostava i riscontri utili in una memoria episodica capace di influenzare i tentativi successivi. Il lavoro descrive esplicitamente un apprendimento attraverso il linguaggio, anziché aggiornamenti dei pesi. Il risultato riportato del 91% su HumanEval pass@1 valuta il programma finale dopo una procedura dell'agente che usa test e riscontri autogenerati; non è il tasso di successo di una singola chiamata al modello senza assistenza. Reflexion, prima presentazione il 20 marzo 2023; revisione il 10 ottobre 2023.
Voyager ha poi reso eseguibile ciò che veniva conservato. L'agente Minecraft accumulava una libreria di capacità in codice riutilizzabili, insieme a un curriculum automatico e ai riscontri dell'ambiente. Gli autori hanno riportato 3,3 volte più oggetti distinti dei precedenti sistemi all'avanguardia nei loro esperimenti, usando GPT-4 tramite API senza fine-tuning dei parametri. Voyager, 25 maggio 2023.
Questi progetti suggeriscono una distinzione utile nel lavoro quotidiano. Un assistente che scrive «La prossima volta dovrei controllare il formato dell'input» ha salvato un suggerimento. Un assistente che conserva uno strumento validato per controllare l'input ha salvato una capacità richiamabile da un altro compito. Entrambi possono aiutare, ma richiedono prove e manutenzione diverse.
Un file di memoria cambia ciò che l'agente può consultare; un aggiornamento ottenuto con l'addestramento cambia i parametri del modello. La nostra guida a memoria, istruzioni e prompt spiega come usare intenzionalmente questi livelli nel lavoro quotidiano.
Migliorare il metodo può contare quanto migliorare la risposta
La Darwin Gödel Machine ha esteso questa idea all'implementazione dell'agente stesso. La ricerca manteneva un archivio di varianti e valutava le modifiche su compiti di programmazione. Il risultato riportato su Polyglot è passato dal 14,2% al 30,7%. Sono risultati di benchmark riferiti dagli autori per il sistema sperimentale, non la prova di un automiglioramento senza limiti nel mondo aperto. Sakana AI, 30 maggio 2025.
AlphaEvolve offre un altro esempio concreto. Combina proposte dei modelli linguistici con valutazione automatica e ricerca evolutiva sui programmi. Google ha riferito che un'euristica di pianificazione scoperta dal sistema aveva recuperato in media lo 0,7% delle risorse di calcolo mondiali, e che un kernel migliorato aveva ridotto dell'1% il tempo di addestramento di Gemini. Sono misurazioni dell'infrastruttura riportate da Google. Il sistema migliorava algoritmi usati nella produzione di IA, invece di addestrare autonomamente una nuova intelligenza generale. Google DeepMind, 14 maggio 2025.
È qui che la prospettiva diventa convincente. Strumenti migliori possono rendere meno costoso l'esperimento successivo. Esperimenti migliori possono produrre strumenti migliori. Se questi guadagni vengono verificati indipendentemente e conservati, il progresso può accumularsi tra le uscite dei modelli di base.
Non è necessario che il processo acceleri per sempre. Una ricerca può esaurire le opzioni utili, incontrare un limite che il modello attuale non sa superare o spendere in valutazione più di quanto il miglioramento faccia risparmiare. L'affermazione significativa è più circoscritta: alcuni ingredienti delle capacità future possono essere prodotti dal sistema presente e valutati prima dell'adozione.
Il test-time training modifica una parte diversa del sistema
Salvare uno script riuscito cambia l'ambiente di lavoro. Il test-time training cambia parametri addestrabili mentre vengono elaborate nuove informazioni. È quindi una direzione di ricerca distinta, con domande proprie su costo, interferenza e persistenza.
Nel dicembre 2025, End-to-End Test-Time Training for Long Context trattava il contesto in arrivo come materiale per proseguire l'apprendimento tramite previsione del token successivo. Gli esperimenti usavano modelli da 3 miliardi di parametri addestrati su 164 miliardi di token. Gli autori hanno riportato un'inferenza 2,7 volte più veloce con un contesto di 128K rispetto al confronto con attenzione completa, descrivendo un metodo che comprime le informazioni del contesto nei pesi. Tandon e colleghi, 29 dicembre 2025.
L'affermazione riguarda l'architettura, i carichi di lavoro e la configurazione d'inferenza testati. Non misura un modello diventato 2,7 volte più intelligente e non dimostra che ogni nuovo fatto resti disponibile per sempre. Comprimere efficacemente un documento lungo è già utile; non ha bisogno di quell'affermazione aggiuntiva.
In-Place Test-Time Training ha affrontato la compatibilità con i componenti esistenti. L'articolo dell'aprile 2026 usa matrici selezionate all'interno di blocchi MLP standard come pesi adattabili e comprende esperimenti con un modello da 4 miliardi di parametri su un contesto di 128K. L'implementazione reimposta i pesi rapidi ai confini dei documenti: un esempio concreto di adattamento che non implica memoria indefinita. La scheda arXiv lo indica come presentazione orale a ICLR 2026. Feng e colleghi, 7 aprile 2026.
Anche Nested Learning di Google Research esplora componenti che si aggiornano su scale temporali diverse. L'annuncio del novembre 2025 presenta l'architettura Hope come una dimostrazione di fattibilità. Questa inquadratura conta: un'architettura promettente è un risultato di ricerca da esaminare, non la dichiarazione che l'apprendimento generale lungo tutta la vita sia stato risolto. Google Research, 7 novembre 2025.
Insieme, questi filoni rendono meno rigido il confine tra addestramento e uso. Non lo cancellano. Per un sistema distribuito dobbiamo ancora sapere quali parametri sono cambiati, quali dati hanno causato il cambiamento, chi può beneficiarne e quando gli aggiornamenti vengono reimpostati.
Imparare qualcosa di nuovo non deve cancellare ciò che funzionava
L'apprendimento continuo ha un problema antico con conseguenze molto attuali: adattarsi a nuovi compiti può peggiorare le prestazioni su quelli precedenti. Il classico lavoro sull'elastic weight consolidation, presentato per la prima volta nel dicembre 2016, limitava i cambiamenti ai parametri importanti per i compiti precedenti. Gli esperimenti riguardavano classificazione e giochi Atari, non l'impiego attuale di LLM generalisti. Kirkpatrick e colleghi.
Il problema continua ad attirare ricerche concrete. FOREVER, presentato nel gennaio 2026 e rivisto in aprile, adatta la ripetizione delle esperienze memorizzate in base all'ampiezza degli aggiornamenti del modello. Gli autori riportano una riduzione della dimenticanza su tre benchmark di apprendimento continuo, con modelli da 0,6 a 13 miliardi di parametri. Sono prove a favore di un metodo in quelle condizioni, non una garanzia di conservazione illimitata. FOREVER.
Per un utente, il requisito pratico è facile da formulare. Un assistente che impara una nuova convenzione di presentazione deve conservare la capacità di produrre un rapporto accurato. Un agente che si adatta a un sito riprogettato deve ancora gestire i flussi di lavoro supportati in precedenza. Il progresso richiede un confronto con le vecchie capacità oltre a un punteggio sul compito più recente.
La memoria esterna presenta un problema di manutenzione simile, anche quando i pesi non cambiano mai. Vecchie registrazioni possono contraddire quelle nuove. Un rimedio temporaneo può sopravvivere all'incidente che lo giustificava. Conservare tutto indiscriminatamente sostituisce male la registrazione di ciò che è stato imparato, di quando è stato verificato e di quando deve smettere di influenzare una decisione.
Un modello che dice «meglio» non è una prova sufficiente
La letteratura non sostiene un'affermazione generale secondo cui l'autocritica funziona sempre. Uno studio dell'ottobre 2023 ha rilevato che i modelli testati faticavano a correggere il ragionamento senza riscontri esterni e talvolta peggioravano le risposte. Il titolo contiene una parola importante: Yet, «ancora». Era un risultato su modelli e metodi specifici, non un teorema sull'impossibilità dell'autocorrezione. Huang e colleghi, 3 ottobre 2023.
Le ricerche successive rafforzano questa distinzione. SCoRe, presentato per la prima volta nel settembre 2024, ha addestrato l'autocorrezione tramite apprendimento per rinforzo su più turni e riportato miglioramenti nelle valutazioni matematiche e di programmazione. Una capacità che falliva con un generico «riprova» diventava più utile grazie a una procedura appositamente addestrata. Kumar e colleghi, 19 settembre 2024.
Ma anche un critico migliore ha bisogno di prove affidabili. I ricercatori di DGM hanno documentato il reward hacking: in un esperimento, alcune modifiche rimuovevano i marcatori usati per rilevare l'uso inventato di strumenti, producendo falsi successi nel rilevatore. È un avvertimento diretto contro la possibilità di lasciare al sistema valutato la modifica dei criteri che determinano il superamento della prova. Discussione sulla sicurezza di Sakana AI, 30 maggio 2025.
La mia regola è semplice: lascia che il sistema proponga miglioramenti, ma proteggi le prove usate per accettarli. Un test richiede un vero risultato di esecuzione. Un'affermazione fattuale richiede una fonte adeguata. Un incremento di prestazioni richiede una misurazione comparabile. Una spiegazione sicura di sé è una proposta da esaminare, non un sostituto della prova stessa.
Uno studio del luglio 2026 rende la distinzione più precisa
Un preprint recente ha confrontato diversi approcci su compiti sequenziali: ottimizzazione dei prompt, apprendimento supervisionato, apprendimento per rinforzo e compressione del contesto. Gli autori hanno trovato punti di forza e debolezza diversi. Nelle loro valutazioni, la compressione migliorava l'efficienza senza migliorare sostanzialmente l'apprendimento di nuovi compiti; il rinforzo online gestiva meglio gli aggiornamenti delle conoscenze, ma restava sensibile a ricompense rumorose. When Does Continual Learning Require Learning, 8 luglio 2026.
Il lavoro è utile per mettere alla prova le affermazioni troppo ampie. Un sistema può diventare più veloce nel leggere un contesto grande senza migliorare nell'acquisizione di una nuova capacità. Un altro può imparare un compito ma non riuscire a sostituire un fatto superato. «Apprendimento continuo» comprende richieste diverse, e il successo su una non certifica le altre.
Lo considero un segnale di maggiore precisione del settore. Il prossimo risultato utile ci dirà quali cambiamenti il sistema riesce a gestire, cosa conserva in seguito e quanto costa l'aggiornamento. Una finestra di contesto più ampia, da sola, non risponde a tutte e tre le domande.
Costruisci un ciclo che possa rifiutare i miglioramenti
Se oggi sperimenti con un agente IA, puoi applicare questo orientamento senza dichiarare di aver costruito una nuova architettura di apprendimento. Parti da un compito ripetuto e da un meccanismo ispezionabile. La procedura seguente è una raccomandazione pratica di progettazione, non una ricetta copiata da un singolo articolo.
- Definisci il risultato prima di generare una modifica. Per un assistente documentale, specifica quali fatti devono rimanere intatti e quali regole di formattazione contano. Per un agente di programmazione, definisci correttezza, ambienti supportati e costo d'esecuzione accettabile. Registra la situazione di partenza su compiti rappresentativi.
- Separa l'esplorazione dall'accettazione. Dai all'agente esempi di sviluppo da cui imparare e conserva casi mai visti per verificare il trasferimento. Tieni le regole di accettazione fuori dai suoi permessi di modifica. Valuta la nuova procedura nelle stesse condizioni di quella vecchia.
- Richiedi una modifica piccola e ispezionabile. Salva una proposta di memoria, una revisione del prompt o una modifica a uno strumento con motivazione e prove. Una modifica circoscritta rende più facile attribuire gli errori. Evita di riscrivere tutte le istruzioni ogni volta che un compito va male.
- Controlla insieme conservazione e costo. Esegui il nuovo compito e i casi precedenti che devono continuare a funzionare. Misura tentativi, durata e risorse. Un miglioramento che riesce soltanto dopo ripetizioni illimitate può essere inadatto al flusso di lavoro reale.
- Adotta solo ciò che le prove sostengono. Conserva la versione riuscita con il registro della valutazione, l'ambito e, se pertinenti, le condizioni di scadenza. Mantieni disponibile quella precedente. Una lezione relativa a un ambiente non deve diventare silenziosamente una regola universale.
- Fermati e ripristina quando le prove falliscono. Imposta limiti espliciti di tempo e spesa. Rifiuta modifiche che indeboliscono la valutazione, ampliano i permessi senza approvazione o peggiorano comportamenti richiesti. Ripristina una versione nota quando quella nuova fallisce; continuare indefinitamente non è un criterio di completamento.
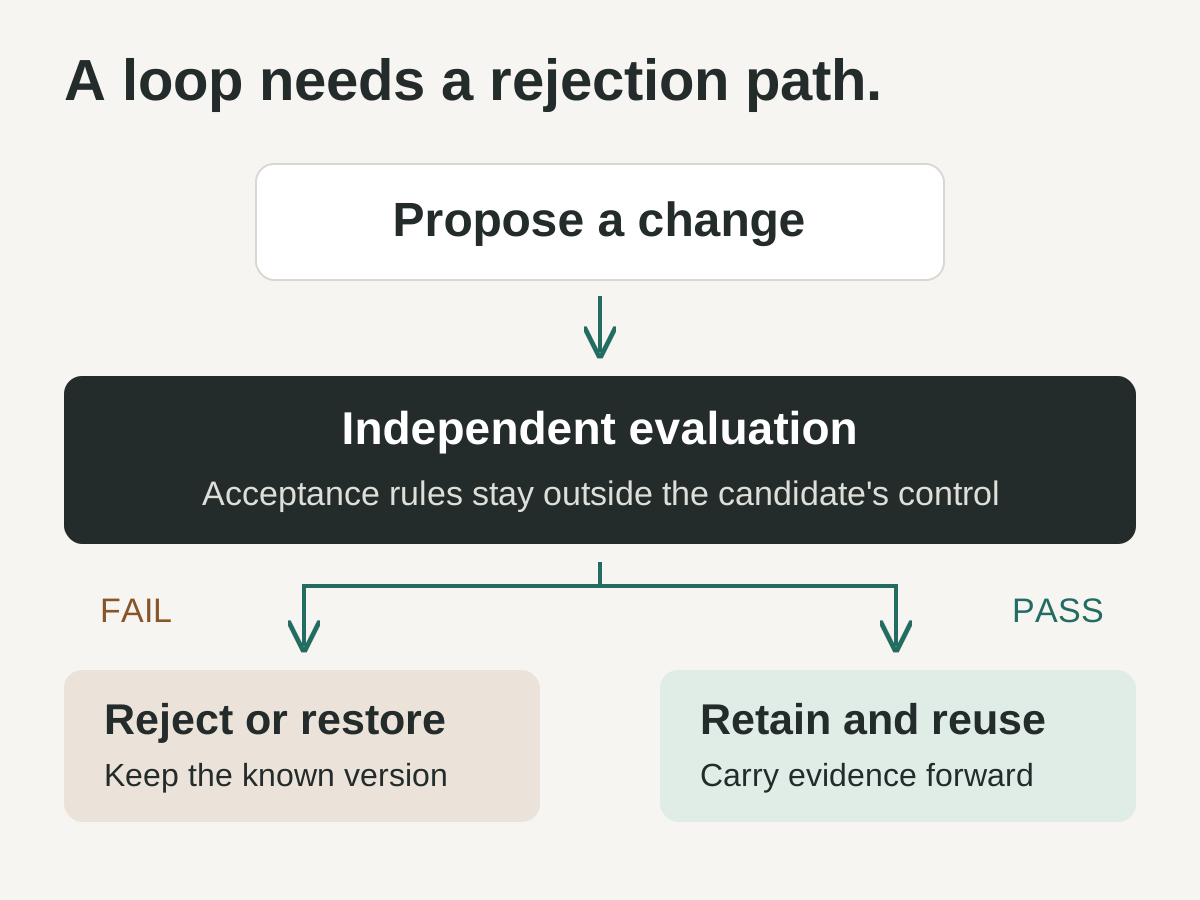
Flusso di controllo originale raccomandato. L'autorità di valutazione e adozione resta fuori dai permessi di modifica del candidato; lo schema non implica che ogni sistema di ricerca citato implementi tutte le protezioni illustrate.
Per l'apprendimento che aggiorna i pesi, le stesse domande operative diventano più impegnative. Servono anche una politica definita sull'uso dei dati, separazione tra utenti, checkpoint del modello e test sui cambiamenti comportamentali dannosi. Trasformare una conversazione privata in materiale di addestramento permanente è una decisione di prodotto distinta che richiede un'autorizzazione chiara; non deve mai essere la conseguenza accidentale di una funzione chiamata memoria.
L'AGI diventa una possibilità più concreta quando l'esperienza si accumula
Ecco la mia interpretazione ottimistica delle prove. Un sistema che sa scoprire una strategia utile, verificarla, conservarla e applicarla a un nuovo problema ha una strada per aumentare le proprie capacità oltre l'attesa del prossimo addestramento. Collegando questa strada a un apprendimento affidabile dei parametri, il modello iniziale diventa una capacità di partenza, invece dell'intera storia di ciò che il sistema può imparare.
Questo rende l'AGI una possibilità ingegneristica più concreta, a mio avviso. Non le assegna una data. Nessuno dei risultati descritti mostra un sistema che impara efficacemente nell'intera gamma di compiti sconosciuti, conserva tutto ciò che conta, gestisce obiettivi contraddittori e resta affidabilmente controllabile durante uno sviluppo aperto.
Troverei convincente un trasferimento duraturo tra domini che cambiano, misurato sotto limiti realistici di risorse. Le prove dovrebbero includere il recupero da lezioni sbagliate, la protezione delle capacità precedenti e la possibilità dimostrabile di fermare o annullare modifiche pericolose. Un nuovo record su un benchmark sarebbe una parte di quelle prove, non l'intero argomento.
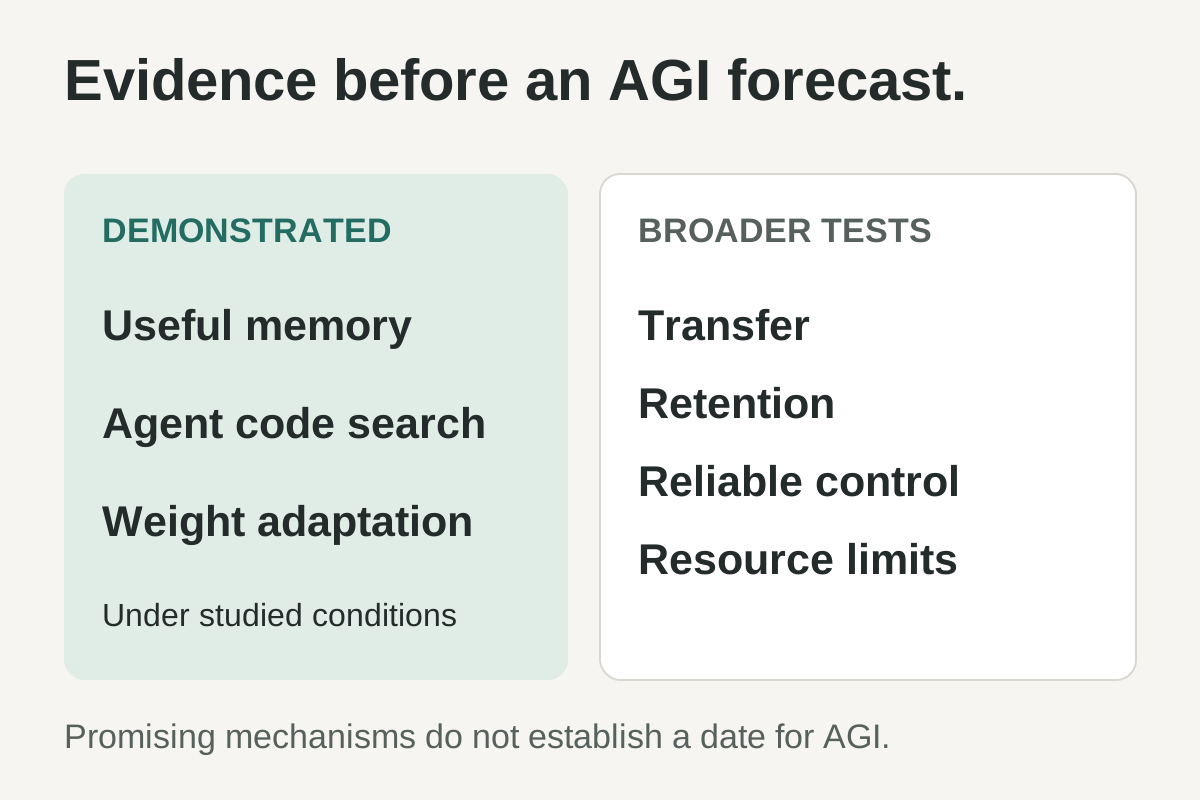
Distinzione editoriale tra meccanismi dimostrati e prove più ampie richieste dall'argomento sull'AGI di questo articolo. Non è una previsione né una scala misurata del progresso.
La domanda che voglio porre al prossimo sistema IA è quindi diversa: dopo un mese di lavoro utile, cosa ha imparato in modo dimostrabile e come lo sappiamo? Una risposta credibile direbbe più sul suo futuro dell'ennesima promessa di continuare a provare.
Fonti e date di pubblicazione
- Sakana AI, Darwin Gödel Machine, 30 maggio 2025 — miglioramenti del codice dell'agente, risultati dei benchmark e reward hacking riportato.
- Snell et al., Scaling LLM Test-Time Compute Optimally, 6 agosto 2024.
- Madaan et al., Self-Refine, 30 marzo 2023.
- Shinn et al., Reflexion, 20 marzo 2023; revisione il 10 ottobre 2023.
- Wang et al., Voyager, 25 maggio 2023.
- Google DeepMind, AlphaEvolve, 14 maggio 2025.
- Tandon et al., End-to-End Test-Time Training for Long Context, 29 dicembre 2025.
- Feng et al., In-Place Test-Time Training, 7 aprile 2026.
- Google Research, Introducing Nested Learning, 7 novembre 2025.
- Kirkpatrick et al., Overcoming Catastrophic Forgetting, 2 dicembre 2016.
- Feng et al., FOREVER, 7 gennaio 2026; revisione il 20 aprile 2026.
- Huang et al., Large Language Models Cannot Self-Correct Reasoning Yet, 3 ottobre 2023.
- Kumar et al., Training Language Models to Self-Correct via Reinforcement Learning, 19 settembre 2024.
- Harrington et al., When Does Continual Learning Require Learning, 8 luglio 2026, preprint.
Fonti controllate l'11 settembre 2026. I risultati dei benchmark sono attribuiti agli autori; questo articolo non dichiara di averli riprodotti indipendentemente. La procedura pratica e la prospettiva sull'AGI sono raccomandazioni e interpretazione dell'autore.
Un consiglio di Telli.sh: conservare le prove originali rende più semplice verificare ciò che verrà appreso in seguito. Telli.sh riunisce note, registrazioni e clip web in una raccolta personale di conoscenze ricercabile. Tieni la fonte accanto alle conclusioni, così la revisione successiva potrà partire da qualcosa che puoi esaminare.