Otto ore di distanza, una decisione: il passaggio di consegne asincrono in 10 minuti
Un sistema pratico di passaggio di consegne per i team in cui una giornata lavorativa finisce mentre ne inizia un'altra. I sei campi necessari a chi subentra, perché la conferma è importante, come scrivere scadenze non ambigue tra fusi orari e come verificare se il lavoro può riprendere in dieci minuti senza una riunione di ricostruzione.
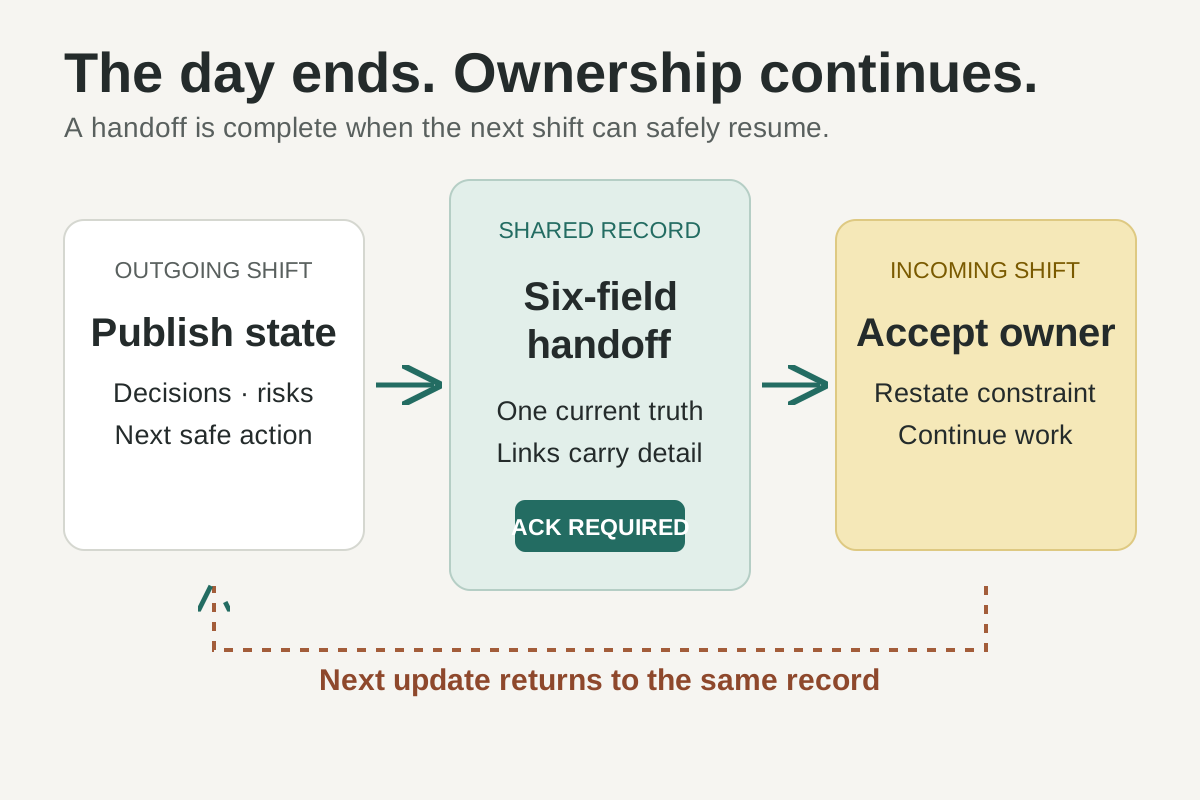
Un diagramma di flusso originale. Un passaggio di consegne è completo solo quando la persona successiva può identificare lo stato, la prossima mossa e la propria responsabilità senza ripercorrere il turno precedente.
A Seoul la giornata finisce alle 18:00. A Londra resta ancora gran parte del giorno. A San Francisco non è ancora iniziata la colazione.
Questa configurazione viene spesso presentata come un vantaggio di 24 ore: il lavoro può continuare mentre ciascuno dorme. In pratica, molti team distribuiti ottengono un sistema più lento. Londra trascorre la prima ora a ricostruire ciò che Seoul ha cambiato, San Francisco chiede un chiarimento quando Seoul è già offline e la successiva riunione comune ripete una decisione già presa.
Il problema non sono i fusi orari. È il passaggio di consegne. Questa guida definisce un trasferimento compatto che il collega entrante dovrebbe riuscire a comprendere e accettare in 10 minuti: stato attuale, decisioni, prove, prossima azione, rischi e responsabilità. Questi dieci minuti sono un obiettivo diagnostico proposto per questa guida, non un benchmark di settore pubblicato. La guida spiega inoltre quando il testo non basta e una breve chiamata durante la sovrapposizione è la scelta più sicura.
In breve:
- Un aggiornamento di stato descrive un'attività. Un passaggio di consegne trasferisce una responsabilità. Il secondo richiede un destinatario indicato e una conferma esplicita.
- Scrivi sei campi in un ordine fisso: stato, modifiche, decisioni, prossima azione, rischi e responsabile/orario. Metti in cima la verità operativa più recente.
- Non scrivere mai «domani», «Friday EOD» o un semplice
09:00tra fusi orari. Per eventi locali futuri, includi data, ora locale e zona IANA, per esempio2026-10-02 09:00 Europe/London.
Il follow-the-sun fallisce nel passaggio, non per il sole
I ricercatori diedero al modello un nome preciso prima che il lavoro da remoto diventasse una condizione professionale ordinaria. Nel 2009 Erran Carmel, Yael Dubinsky e J. Alberto Espinosa descrissero lo sviluppo follow-the-sun come lavoro trasferito ogni giorno da una sede a un'altra distante molti fusi orari, con l'obiettivo di ridurre la durata dei progetti. Il loro studio esplorativo osservò anche che la pratica era rara e spesso fraintesa. La scheda della pubblicazione di IBM Research.
Il loro articolo del 2010 sul Journal of Management Information Systems spiega chiaramente l'attrattiva: il lavoro può continuare senza interruzioni. Individua anche le condizioni che determinano se il modello sia utile: efficienza del calendario, efficienza del passaggio di consegne e coordinamento all'interno delle sedi e fra di esse. L'abstract della rivista elenca 12 proposizioni di ricerca invece di promettere un'accelerazione universale.
Questa precisazione conta. Tre giornate lavorative di otto ore non diventano automaticamente un unico giorno ininterrotto di 24 ore. Ogni trasferimento introduce ciò che chiameremo il costo di ripartenza: il tempo e gli errori generati quando la persona entrante deve dedurre lo stato, riscoprire le motivazioni e trovare la prossima azione sicura.
Se il costo di ripartenza è di 45 minuti in corrispondenza di due passaggi quotidiani, il processo nominale di 24 ore perde 90 minuti prima che inizi qualsiasi nuovo lavoro. Ancora più importante, il contesto mancante può mandare il turno successivo nella direzione sbagliata. Un passaggio veloce verso il compito sbagliato non è continuità.
L'obiettivo, quindi, non è «più asincrono». È la capacità di ripresa: un collega qualificato può proseguire il lavoro senza aspettare il turno precedente e senza formulare un'ipotesi nascosta?
Un aggiornamento di stato non trasferisce la responsabilità
Molti passaggi di consegne falliti iniziano con un messaggio che sembra del tutto ragionevole:
Buoni progressi sul checkout. L'API è quasi pronta.
C'è uno strano problema con i tentativi. Lo rivedrò domani.
Il messaggio riferisce un'attività, ma il turno entrante non può agire partendo da lì. Quale branch o ambiente è cambiato? Che cosa resta incompleto? Il problema dei nuovi tentativi è stato riprodotto o soltanto ipotizzato? Chi subentra deve indagarlo, evitare quell'area o continuare un'altra attività? Chi è responsabile del problema mentre l'autore dorme?
Un passaggio di consegne svolge una funzione grammaticale diversa. Trasferisce uno stato attivo e indica la persona o il ruolo responsabile dell'intervallo successivo.
Le linee guida pubblicate da Google SRE sulla gestione degli incidenti rendono esplicito il cambio di responsabilità. Raccomandano un documento dell'incidente aggiornato in tempo reale, con le informazioni più importanti in cima, e affermano che l'Incident Commander uscente deve dichiarare chiaramente il passaggio e rimanere fino alla conferma di chi subentra. Google SRE, «Managing Incidents». Un progetto ordinario non è un incidente di produzione, ma la regola di fondo si trasferisce bene: la responsabilità non passa soltanto perché un'informazione è stata inviata.
La stessa distinzione compare in un contesto ad alto rischio molto diverso. Uno studio prospettico di intervento pubblicato sul New England Journal of Medicine il 6 novembre 2014 ha valutato un pacchetto standardizzato di passaggio di consegne in nove ospedali universitari e su 10.740 ricoveri. Gli errori medici sono scesi da 24,5 a 18,8 ogni 100 ricoveri, una riduzione relativa del 23%, mentre gli eventi avversi prevenibili sono passati da 4,7 a 3,3 ogni 100 ricoveri, una riduzione relativa del 30%. La durata del passaggio orale non è cambiata in modo significativo: 2,4 contro 2,5 minuti per paziente. Lo studio I-PASS.
Non trasferire queste percentuali al software, al design o al marketing. Lo studio riguardava i passaggi di consegne tra specializzandi in pediatria e un pacchetto che includeva formazione, osservazione e lavoro sulla sostenibilità, non soltanto un modello. La lezione trasferibile è più circoscritta ma comunque preziosa: elementi scritti e orali standardizzati, uniti a formazione e conferma, possono migliorare la qualità del passaggio senza necessariamente renderlo più lungo.
Sei campi rendono il lavoro riprendibile
Usa gli stessi sei campi nello stesso ordine per ogni passaggio operativo. L'ordine fisso conta, perché chi subentra non dovrebbe passare i primi cinque minuti a capire come l'autore del giorno ha organizzato il messaggio.
- Stato attuale: la descrizione accurata più breve di ciò che è vero al momento del passaggio.
- Modifiche di questo turno: lavoro completato, con link all'artefatto o alla revisione.
- Decisioni prese: scelte definite e relative motivazioni; link al registro decisionale.
- Prossima azione sicura: una mossa concreta che la persona entrante può iniziare.
- Rischi e incognite: errori, ipotesi, percorsi bloccati e ciò che non deve essere modificato con leggerezza.
- Responsabile e orario: chi prende in carico l'intervallo successivo, entro quando è richiesta la conferma e quando si terrà il prossimo punto di controllo.
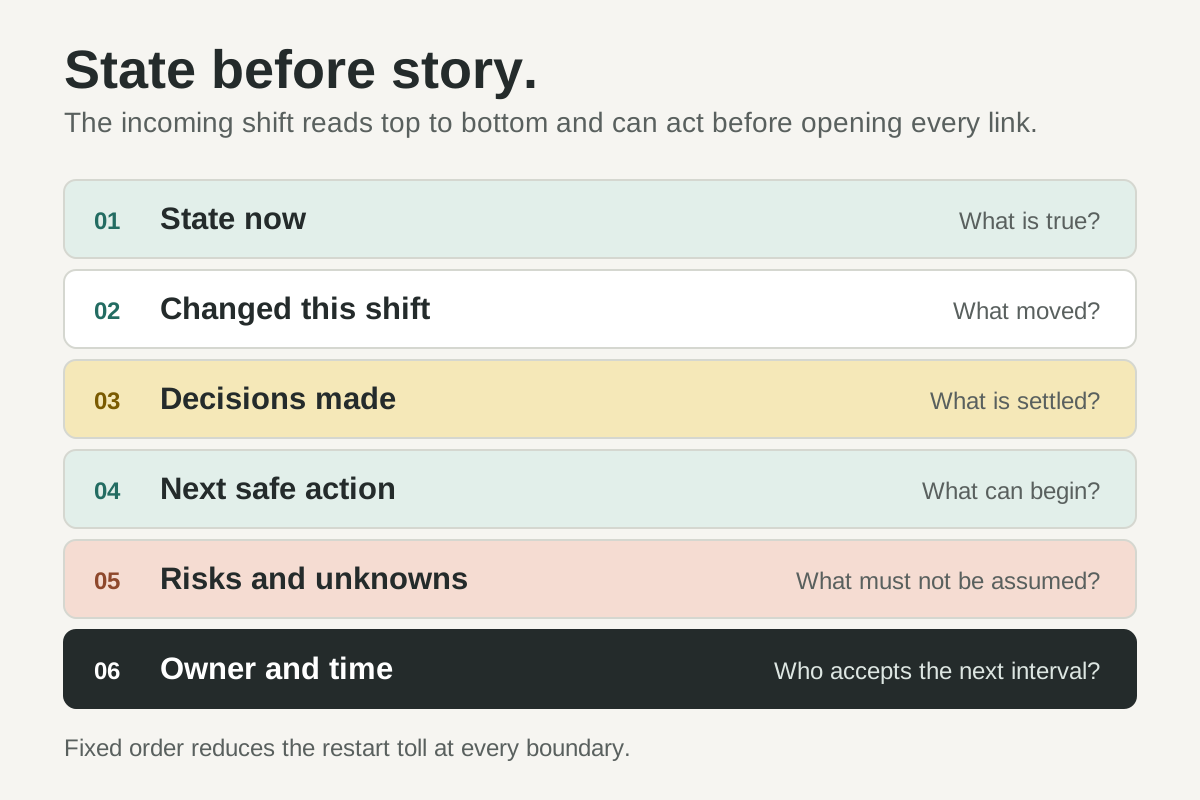
Figura 1: Chi subentra deve trovare la verità operativa prima del racconto. I link contengono i dettagli; la scheda contiene lo stato.
Ecco il messaggio precedente riscritto:
PASSAGGIO CHECKOUT · 2026-09-24T18:00+09:00 [Asia/Seoul]

STATO ATTUALE
L'endpoint dei nuovi tentativi è distribuito in staging dietro il flag
`checkout_retry_v2`. È disattivato per tutti gli account di test.
Il checkout principale non è cambiato.

MODIFICHE DI QUESTO TURNO
- Aggiunta la memorizzazione della chiave di idempotenza: PR #1842, commit 7ac2e91.
- Aggiunti 12 test; 11 passano. Il caso che fallisce è collegato più sotto.

DECISIONI PRESE
- Mantenere i nuovi tentativi lato server; non aggiungere un ciclo lato client.
- Motivo: rischio di doppio addebito. Decisione D-77.

PROSSIMA AZIONE SICURA
Riprodurre il test `retry_after_timeout` in staging registrando l'ID richiesta.
Non attivare il flag.

RISCHI / INCOGNITE
- Non è noto se il gateway riutilizzi lo stesso ID richiesta dopo un timeout di 30 s.
- Il cliente di test `acct_retry_04` può contenere tentativi obsoleti.

RESPONSABILE / ORARIO
Il reperibile di Londra prende in carico l'indagine dopo la conferma.
Confermare entro 2026-09-24 10:00 Europe/London.
Prossimo punto di controllo: 2026-09-24T14:00Z nella issue #912.
Il passaggio riscritto è più lungo di circa 100 parole e fa risparmiare un'ora di archeologia. Chi subentra sa cosa non fare, quale test eseguire, dove è cambiato il codice, perché è stata scelta quell'architettura e quando inizia la sua responsabilità.
Il campo della prossima azione sicura è il cardine. Un'indicazione generica come «continuare a indagare» lascia la definizione delle priorità alla persona con meno contesto. Un'azione sicura dovrebbe essere reversibile o chiaramente delimitata e produrre nuove prove anche se non risolve il problema.
Separa le decisioni definite dalle domande aperte
I team distribuiti tra fusi orari spesso decidono di nuovo lo stesso lavoro perché i loro passaggi mescolano tre stati: decisioni accettate, proposte in attesa di revisione e domande irrisolte. Il lettore del mattino vede un paragrafo ben formulato e presume che la questione sia chiusa. L'autore della sera si sveglia e scopre che un suggerimento è diventato un'implementazione.
Usa parole di stato esplicite. Le quattro etichette che seguono sono un vocabolario locale suggerito, non uno standard esterno:
| Etichetta | Significato | Cosa può fare il turno entrante |
|---|---|---|
DECIDED | La persona o il gruppo autorizzato ha scelto un'opzione | Eseguire entro i vincoli registrati |
PROPOSED | Una raccomandazione è pronta per la revisione | Verificare le ipotesi; non presentarla come regola |
OPEN | Mancano ancora prove o autorità | Raccogliere prove o segnalare la domanda indicata |
SUPERSEDED | Un registro successivo ha sostituito questa scelta | Seguire la sostituzione collegata |
Questo è più rigoroso della prosa ordinaria perché il costo dell'ambiguità cresce con il tempo di risposta. Un collega nella stessa stanza può chiedere: «L'abbiamo davvero deciso?». Un collega distante otto ore può aspettare un'intera giornata lavorativa per la risposta oppure procedere senza averla.
Ogni riga DECIDED dovrebbe contenere tre link o campi: chi aveva l'autorità, la breve motivazione e il registro decisionale permanente. Ogni riga OPEN dovrebbe indicare l'informazione mancante e la persona che può chiudere la questione. «Prezzi irrisolti» non basta. «OPEN: sconto annuale; Mina fornisce i dati sull'abbandono per durata del contratto entro il 2 ottobre» permette di riprendere il lavoro.
Il manuale pubblico sulla comunicazione di GitLab offre un esempio di questa preferenza per la documentazione. Nella versione consultata il 24 settembre 2026 descrive la comunicazione asincrona come punto di partenza, chiede ai team di mettere per iscritto le conclusioni delle conversazioni offline, preferisce issue e merge request pubbliche ai messaggi privati e indirizza decisioni e discussioni verso un'unica fonte attendibile. GitLab Communication. È il modello operativo di un'azienda, non una prova controllata che ogni impresa debba copiarne gli strumenti. Il principio utile è che una conversazione può avvenire ovunque, ma la sua conclusione ha bisogno di una sede permanente.
«Friday EOD» non è un orario
Il lavoro distribuito trasforma le espressioni temporali informali in difetti. «Domani mattina» dipende da chi legge. «Friday EOD» può descrivere una finestra di oltre 24 ore tra Auckland, Seoul, Londra e San Francisco. Anche 09:00 PST è fragile: le abbreviazioni vengono usate in modo incoerente e i cambi stagionali dell'ora interessano alcune regioni mentre altre restano fisse.
Per un evento concluso, scrivi un timestamp non ambiguo con il relativo offset UTC:
2026-09-24T18:00:00+09:00
RFC 3339, pubblicato nel luglio 2002, definisce un formato Internet per data e ora che include un offset numerico e presenta esempi come 1996-12-19T16:39:57-08:00, che rappresenta lo stesso istante di 1996-12-20T00:39:57Z. RFC 3339.
Per un evento futuro legato all'ora civile locale, includi data, ora locale e nome del fuso IANA:
2026-10-02 09:00 Europe/London
Perché includere il nome? Un offset numerico identifica un istante, ma i programmi locali futuri dipendono da regole sui fusi orari che i governi possono cambiare. La IANA Time Zone Database registra insiemi di regole basati sulle località. Per esempio, America/Denver e America/Phoenix possono condividere una descrizione convenzionale dell'ora delle Montagne Rocciose, ma applicare comportamenti diversi per l'ora legale. La teoria dei fusi orari di IANA. RFC 9557, pubblicato nell'aprile 2024, estende i timestamp Internet con informazioni aggiuntive, inclusi i nomi dei fusi IANA. RFC 9557.
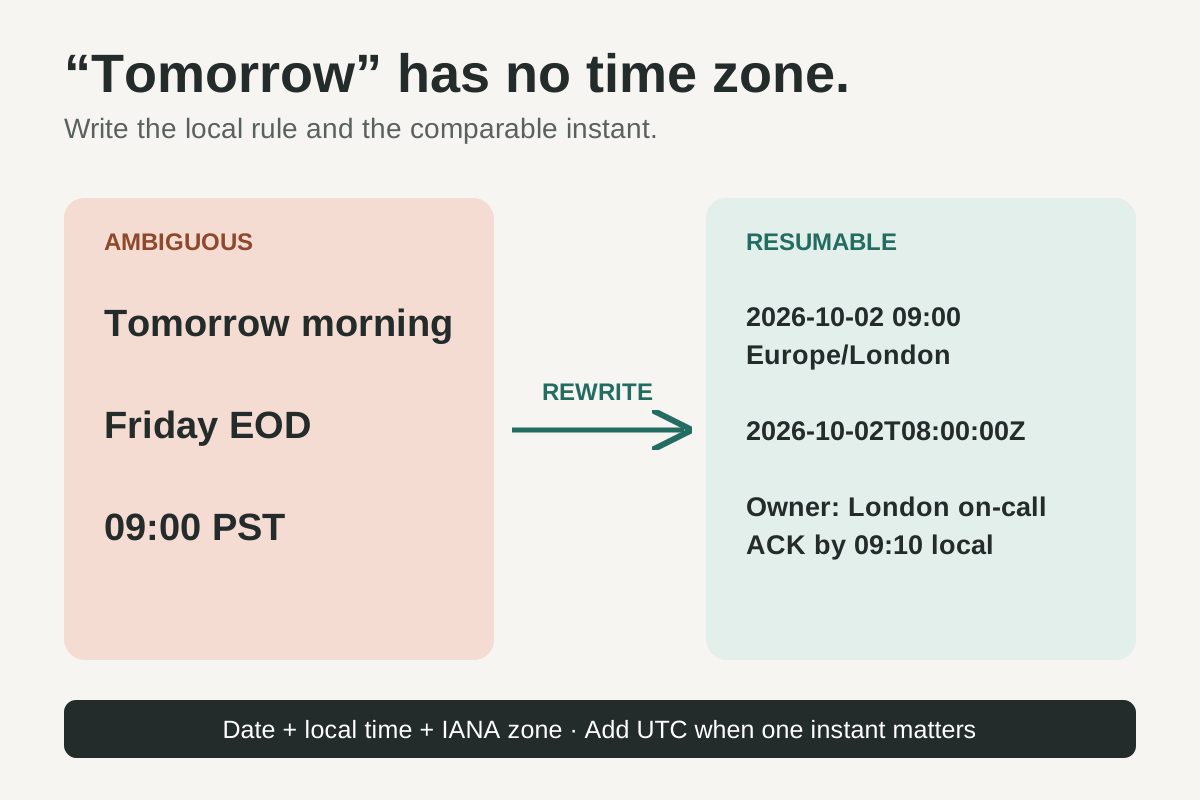
Figura 2: Il destinatario non dovrebbe dover dedurre di chi sia il domani, quale venerdì si intenda o se un'abbreviazione applichi l'ora legale.
Nelle note destinate alle persone, mostra sia l'ora locale del destinatario sia UTC quando il coordinamento è delicato. Il valore UTC rende l'istante confrontabile. Il fuso indicato preserva la regola locale prevista per la pianificazione nel calendario. Il software dovrebbe calcolare l'uno dall'altro; le persone non dovrebbero fare a mente l'aritmetica degli offset.
La conferma chiude il ciclo della responsabilità
L'invio è osservabile. La comprensione no.
Chi subentra dovrebbe confermare il passaggio con una breve riformulazione, non con un'emoji di reazione:
ACK 2026-09-24 09:08 Europe/London
Prendo in carico l'indagine sui nuovi tentativi del checkout fino al punto di
controllo delle 14:00Z. Riprodurrò `retry_after_timeout`; il feature flag rimane
disattivato. Il primo aggiornamento sarà pubblicato nella issue #912.
Richiede meno di un minuto e verifica quattro cose insieme: il destinatario ha visto il messaggio, ha compreso la prossima azione, ha accettato la responsabilità e sa dove pubblicare il nuovo stato. Un malinteso diventa visibile mentre il turno uscente potrebbe essere ancora raggiungibile.
Stabilisci una scadenza per la conferma. Se non arriva, la responsabilità non è passata. La persona uscente dovrebbe usare il percorso di escalation prestabilito invece di presumere che il silenzio significhi consenso. Per il lavoro di routine può bastare una menzione nel canale del team. Per un incidente, un processo regolamentato o una scadenza del cliente, può essere necessaria una chiamata in diretta.
La conferma non dovrebbe ripetere l'intera scheda. Il suo scopo è fungere da checksum, non da secondo passaggio. Ribadisci responsabile, azione immediata, vincolo critico e posizione del prossimo aggiornamento.
Usa una breve chiamata in sovrapposizione quando il testo non può sostenere il rischio
Il lavoro asincrono non è una preferenza morale. Alcuni stati sono troppo instabili o rilevanti per un trasferimento basato soltanto sui documenti.
Usa un passaggio in diretta quando è vera almeno una di queste condizioni:
- L'impatto attivo sui clienti o sulla sicurezza cambia più rapidamente di quanto il documento possa essere aggiornato.
- La prossima azione è irreversibile, distruttiva o ha conseguenze legali.
- La responsabilità è contestata o chi subentra non riesce a riformulare il piano con sicurezza.
- Il registro contiene prove contraddittorie che la persona uscente non ha risolto.
- Accesso, credenziali o stato dell'ambiente non possono essere verificati dal registro condiviso.
Mantieni la chiamata circoscritta. Apri la stessa scheda di passaggio, percorrila dallo stato al rischio, chiedi al nuovo responsabile di riformulare la prossima azione e registra la conferma nel documento. La chiamata integra il registro; non lo sostituisce.
Le linee guida di Google sugli incidenti seguono questa forma: documento di stato condiviso, trasferimento orale esplicito, conferma netta e comunicazione al gruppo più ampio di chi è ora al comando. L'artefatto permanente consente a tutti gli altri di orientarsi senza partecipare alla chiamata di passaggio.
Verifica se il lavoro riprende in 10 minuti
La metrica di qualità non è il numero di aggiornamenti pubblicati o di riunioni evitate. È il tempo necessario per una ripresa sicura.
Una volta alla settimana per quattro settimane, scegli un vero passaggio di consegne e chiedi alla persona entrante di avviare un timer di 10 minuti prima di aprirlo. La cadenza settimanale e la finestra di quattro settimane sono euristiche iniziali proposte qui; adattale al volume e al rischio del tuo team. Al termine dovrebbe rispondere a sei domande senza contattare l'autore:
- Che cosa è vero adesso?
- Che cosa è cambiato durante l'ultimo turno?
- Quali decisioni sono definite e perché?
- Qual è la mia prossima azione sicura?
- Che cosa devo evitare o segnalare?
- Dove e quando pubblico il prossimo stato?
Valuta ogni risposta come clear, found after searching o missing. Non ridurre il risultato a un solo numero di soddisfazione; ripara il campo che presenta problemi ricorrenti. Se il rischio manca spesso, spostalo più in alto. Se le motivazioni di una decisione richiedono di cercare nella trascrizione, crea un link diretto alla sezione pertinente. Se la conferma arriva regolarmente in ritardo, il ruolo destinatario o la scadenza sono sbagliati.
Tieni traccia anche delle riunioni di ricostruzione. Una riunione di ricostruzione è una chiamata programmata soprattutto per ricreare uno stato o una motivazione che avrebbero dovuto superare il confine nel passaggio di consegne. Etichettala quando avviene. Il conteggio non dimostrerà un rapporto causale, ma ogni caso offre un trasferimento concreto non riuscito da esaminare.
Dopo la quarta settimana esegui una prova di assenza: la persona che di solito scrive il passaggio non sarà disponibile per un turno. Un sistema resiliente dovrebbe continuare a funzionare senza brusche interruzioni quando chi possiede più contesto si prende un giorno libero. Se il lavoro si ferma, il flusso dipende ancora dalla memoria, indipendentemente da ciò che dicono i documenti.
Il punto essenziale: il lavoro asincrono è una catena di responsabilità accettate
I fusi orari non creano continuità. Creano l'opportunità per averla.
La catena reale è umana ed esplicita: una persona pubblica lo stato attuale, un'altra riformula la prossima mossa, la responsabilità passa di mano e il registro condiviso riceve l'aggiornamento successivo. Se manca un solo anello, il team ottiene una chat in ritardo, non un flusso di lavoro di 24 ore.
Progetta il passaggio per il collega che si sveglia otto ore dopo. Dagli lo stato prima della storia, una decisione prima del riepilogo della discussione, un orario preciso invece di «domani» e un'azione sicura che possa iniziare. Poi chiedi una conferma. Dieci minuti disciplinati al confine costano meno di una seconda riunione dedicata a ricostruire il giorno precedente.
Un luogo pratico in cui lasciare il registro condiviso: Telli.sh registra le riunioni, conserva la trascrizione e mantiene riepilogo e azioni nello stesso spazio di lavoro. Usa una nota permanente come punto di passaggio, così il turno entrante può verificare ciò che è stato detto senza aspettare che il turno precedente si svegli.
Crea uno spazio di lavoro Telli.sh e registra il prossimo passaggio di consegne
Fonti
- Carmel, Dubinsky ed Espinosa, «Follow the sun software development: New perspectives, conceptual foundation, and exploratory field study», IBM Research / HICSS – 3 aprile 2009; definizione, beneficio previsto sulla durata e contesto dello studio esplorativo.
- Carmel, Espinosa e Dubinsky, «Follow the Sun Workflow in Global Software Development», Journal of Management Information Systems – volume 27, numero 1, 2010, pp. 17-37; 12 proposizioni su efficienza del calendario, efficienza del passaggio e coordinamento.
- Starmer et al., «Changes in Medical Errors after Implementation of a Handoff Program», New England Journal of Medicine – 6 novembre 2014; nove ospedali, 10.740 ricoveri e risultati riportati su errori, eventi avversi e durata del passaggio. L'articolo precedente non generalizza le dimensioni dell'effetto medico al normale lavoro intellettuale.
- Google, Site Reliability Engineering: Managing Incidents – consultato il 24 settembre 2026; documento dell'incidente aggiornato in tempo reale, trasferimento esplicito del comando e conferma.
- GitLab Communication Handbook – consultato il 24 settembre 2026; comunicazione asincrona come punto di partenza, documentazione delle conclusioni offline, canali di lavoro pubblici e un'unica fonte attendibile. È una pratica aziendale, non uno studio controllato.
- IETF RFC 3339, Date and Time on the Internet: Timestamps – luglio 2002; sintassi non ambigua per data e ora su Internet e offset numerici.
- IANA, Theory and pragmatics of the tz code and data – consultato il 24 settembre 2026; regole dei fusi orari basate sulle località ed esempi di regioni con comportamenti diversi dell'ora civile.
- IETF RFC 9557, Date and Time on the Internet: Timestamps with Additional Information – aprile 2024; informazioni aggiuntive per i timestamp, inclusi i nomi dei fusi IANA.