Сможет ли общий ноутбук озвучить урок на тви без интернета?
Africa TTS 0.5.0 даёт голоса по умолчанию для 92 африканских языков и английского. Вот что стоит проверить в пилоте без сети.
Представьте местный учебный центр с общим ноутбуком и нестабильным интернетом. У преподавателя есть короткое задание на чтение на тви. Ученикам нужно услышать его дважды, до ответа и во время проверки. Напрашивается аудиозапись. Синтез речи помогает, когда текст часто меняется, когда нужны варианты упражнений или когда утверждённую запись ещё не сделали.
8 ноября 2026 года AfriSpeech выпустила Africa TTS 0.5.0. По описанию выпуска, пакет озвучивает текст на 92 африканских языках и английском и предлагает голос по умолчанию для каждого языка. Он работает на CPU и может синтезировать без сети после скачивания модели в кеш. Авторы публикуют онлайн-демо и записи для прослушивания. Образцы позволяют быстро послушать нужные языки до установки. Версия на PyPI · Официальные образцы речи
Для центра важен вопрос уже, чем число языков. Смогут ли слушатели разобрать нужные слова и понять материал на общем ноутбуке в своём варианте языка? Это требует проверки слушателями и проверки на устройстве. Обе полезнее начинать с реальных фраз центра.
Контекстная фотография радиостудии в Гане, 2017 год. Автор Joy Agyepong. Размер изменён на условиях CC BY-SA 4.0. Исходная фотография

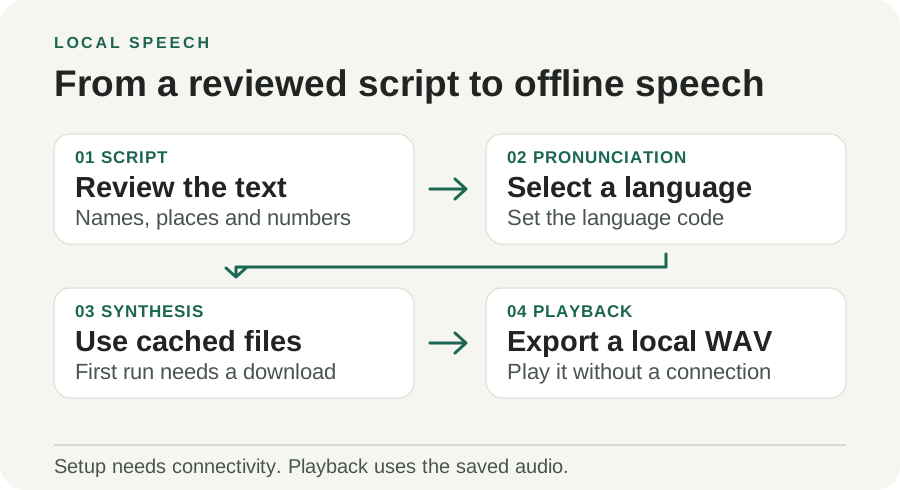
Иллюстрация Telli.sh. Модель скачивается при настройке. После кеширования необходимых файлов синтез и прослушивание могут оставаться на устройстве.
Голос по умолчанию упрощает подготовку первого урока
В выпуске есть простой способ начать. Передайте написанную фразу и трёхбуквенный код ISO, например twi для тви, swh для суахили или yor для йоруба. Пакет возьмёт голос по умолчанию и запишет речь в звуковой файл. Преподаватель может добавить файл в урок без сети или включить его напрямую, оставив написанный текст для сравнения.
Входной текст уже должен быть на языке, который ожидает слушатель. Для объявления на суахили нужен текст на суахили. Если материал был на другом языке, перевод и проверка носителем выполняются отдельно. Передайте переводчику привычные аудитории названия мест, единицы и даты. Храните утверждённый текст рядом со звуком, чтобы слушатель мог найти источник недопонимания.
Начните с материала, который легко подправить. Преподаватель может подготовить тексты одинаковой сложности и попросить двух носителей послушать их без чтения. Учебный центр может сделать звуковое дополнение к письменной инструкции и проверить, поняли ли участники порядок шагов. В обоих случаях сотрудник может записать короткую поправку, если синтетический голос затруднился с именем или необычной фразой.
Короткое объявление тоже подходит. Учебный центр меняет время семинара и размещает письменный и звуковой варианты в местном киоске. Попросите носителя проверить новое время до замены вчерашнего файла. Если голос читает основной текст хорошо, но время звучит двусмысленно, запишите предложение заново и оставьте письменный вариант на виду. Важная деталь ценнее удобства синтеза за один проход.
Решите, как обновлять звук до размещения на общем устройстве. Можно держать текстовый оригинал с датой и языком рядом с утверждённым WAV. После изменения урока прежний файл остаётся доступен, пока слушатель не подтвердит замену. На отключённом устройстве две устаревшие копии могут звучать одинаково убедительно. Короткий номер версии в интерфейсе урока показывает, что будет проиграно, без открытия рабочей папки.
Произношение формируется до речевой модели
Документация AfriSpeech описывает шестислойную ученическую модель со 110 млн параметров с учётом аудиокодека. Её получили дистилляцией из базовой модели с 24 слоями. При обучении меньшая модель приближала результат управляемой генерации большей. Это одна из причин возможности работы на CPU. Для общего ноутбука важно, сколько займёт создание пригодного файла, когда уже открыт урок. Сведения о модели
Модель получает IPA, международный фонетический алфавит, через языковой модуль обработки текста. Он преобразует написанное в звуковые единицы, ожидаемые моделью. Проект использует Africa G2P для поддерживаемых африканских языков и указывает eSpeak NG для английского. Поэтому необычное написание, заимствование или имя может вызвать ошибку даже в гладко звучащей речи. Сбой до акустического этапа даёт модели возможность бегло произнести неверный текст. Модель и обработка произношения
Авторы рекомендуют писать числа словами. Используйте привычную слушателю форму. Проверяйте написание из настоящих материалов: даты, время, диапазоны, сокращения и количества. Если введённый текст отличается от версии для произношения, храните их отдельно. Первый останется удобным для чтения, а второй покажет все поправки для синтеза.
Тексты с переходом на другой язык внутри предложения заслуживают отдельной проверки. В документации вызывающая сторона выбирает язык. Проверьте имена и цитаты в тексте, который в остальном одноязычный. Если один запуск даёт неожиданное произношение, разбейте материал на проверенные фрагменты. Это полезно для уроков, где иностранный термин должен сохраняться и звучать одинаково.
Данные обучения дают отправную точку
Карточка модели указывает 897 часов речи в обучающем наборе. В таблице по языкам у английского примерно 322,6 часа, у суахили 27,0, у тви 24,0, у йоруба 15,3. Это характеристика данных. Она не показывает, на каком местном варианте говорят ученики, как часто фраза встречалась при обучении и узнает ли слушатель синтезированное имя. Карточка и таблица языков
В выпуске также описан экспериментальный перечень из 657 языков без обучения. Они озвучиваются через самый близкий доступный обученный язык. Рассматривайте это как отдельное исследовательское направление. Для языка из основного перечня и языка, полученного через замену, есть разные доказательства. Если участники пилота полагаются на звук, начните с обученных языков и оцените, хватит ли экспериментальному варианту проверки носителями. Экспериментальные языки
Авторы приводят два результата. Первый — генерация в 2,4 раза быстрее реального времени на облачной машине с четырьмя vCPU. Второй — сравнение на отложенных данных, где Omnilingual ASR расшифровывала синтез. Africa TTS опередила MMS-TTS в 21 из 27 языков, для которых приведено сравнение. Обе цифры получены проектом. В реальном классе другие акценты, устройства, фоновые звуки и динамики. Расшифровка даёт приблизительную оценку разборчивости. На уроке важнее, как слушатель понял фразу. Тесты выпуска · Методы оценки
| Проверка | Что измерить на устройстве | Зачем |
|---|---|---|
| Первый запуск | Время настройки, размер загрузки, место после кеширования | На общем ноутбуке может быть мало диска или медленная связь |
| Генерация из кеша | Время от запроса до WAV при открытом уроке | Фоновые приложения влияют на скорость CPU |
| Ключевые факты | Верно ли повторяют имена, время, числа и инструкции | Естественная фраза может содержать одно важное неверное слово |
| Местный вариант | Оценка носителями нужных фраз и акцентов | Один код может охватывать разные варианты речи |
| Восстановление после сбоя | Продолжается ли урок с текстом или записью сотрудника | Модель или звуковое устройство могут подвести в нужный день |
Настройте работу без сети и проверьте после отключения
- Выберите короткий проверенный отрывок. Напишите приветствие, типовое упражнение и фрагмент с именами или числами. Попросите носителя проверить написание и формулировку.
- Создайте отдельное окружение Python. Для 0.5.0 указаны версии Python от 3.10 до 3.14. Активируйте подходящее виртуальное окружение и установите эту версию пакета.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- Спланируйте первую загрузку. Документация версии указывает около 440 МБ для модели по умолчанию. Скачайте её при настройке через разрешённую сеть или запустите синтез и подтвердите загрузку. Для английского установите указанную зависимость eSpeak NG. Сверьтесь с инструкциями перед сменой платформы или среды.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- Повторите без сети после настройки. Используйте аккаунт и кеш, предназначенные для урока. Сделайте новый WAV, откройте его на нужном устройстве и отдельно запишите время генерации и длину записи.
- Сначала дайте послушать, затем покажите текст. Включите файлы на рабочей громкости и попросите двух носителей или слушателей повторить ключевые факты. Сохраните версии текста и модели вместе с комментариями. При ошибке поправьте текст или замените запись и проверьте ещё раз.
Этот порядок полезен и при интересе к Android. AfriSpeech описывает комплект sherpa-onnx с модулем на C и обёрткой для Android. Проверьте настоящую сборку для телефона отдельно: у мобильного пакета и обычной настольной среды разные механизмы. Сравните холодный старт, место, звук и расход батареи на типовых устройствах и полных отрывках. Работающая команда на компьютере подтверждает пригодность одной среды. Телефону нужен свой запуск. Заметки о запуске на устройстве
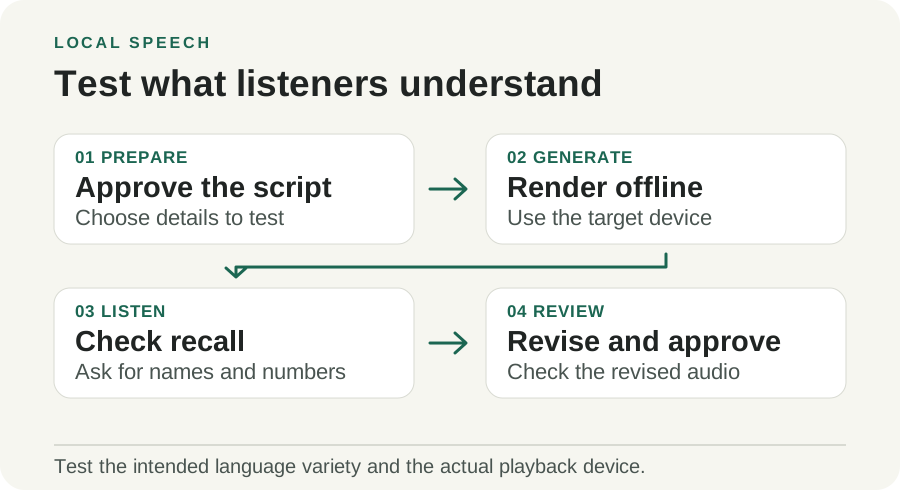
Иллюстрация Telli.sh. Попросите слушателей повторить важные факты до чтения, чтобы заметить ошибки произношения, которые пропустил бы редактор текста.
Проверьте лицензию голоса вместе с лицензией кода
Код Python-пакета распространяется по MIT. По описанию выпуска 0.5.0, модель и стандартные голоса идут по CC BY-NC 4.0. У английской зависимости eSpeak NG свои условия GPL. Проверяйте части отдельно перед распространением инструмента, голосовых файлов или сервиса. Публичная загрузка упрощает пробу, а для некоторых коммерческих целей нужна другая модель или отдельное разрешение. Лицензирование выпуска · Условия CC BY-NC 4.0
Пакет может использовать предоставленный образец голоса. Голос по умолчанию упрощает школьный пилот, потому что не нужно собирать запись человека. Для особого голоса получите согласие говорящего на выбранное использование и договоритесь, где останутся образец и готовые файлы. Центр может обойтись без этого решения, если сотрудники с согласия озвучивают поправки, а стандартный голос используется для вариантов упражнений.
Синтез без сети позволяет держать текст и голосовые материалы на устройстве. Онлайн-демо — отдельный путь. Отправка текста или голосового образца веб-сервису требует отдельного решения о передаче данных. Для проверки демо возьмите публичное предложение, а для материалов под правилами школы или организации используйте локальную обработку.
Критерий успеха определяет слушатель
Africa TTS помогает представить первый звуковой черновик людям, чей язык редко встречается в инструментах озвучивания. Полезный тест достаточно мал, чтобы его можно было проверить на слух. Возьмите отрывок, который людям действительно предстоит услышать, запустите без сети и попросите повторить важную деталь. Правильный ответ говорит о пилоте больше, чем длина списка языков.
Источники
- Africa TTS 0.5.0, выпуск 8 ноября 2026 года
- Карточка AfriSpeech и состав обучающих данных
- Методы оценки AfriSpeech
- Открытые образцы речи AfriSpeech
- Лицензия CC BY-NC 4.0
- Радиостудия в Гане, фотография Joy Agyepong, CC BY-SA 4.0
Чтобы сохранять обсуждения и решения по работе и находить их через поиск, создайте аккаунт в Telli.sh.