Năm giai đoạn, bốn sản phẩm: Telli.sh thực sự làm gì với một bản ghi cuộc họp
Đi qua toàn bộ quy trình của Telli.sh: ghi âm trực tiếp hoặc tải tệp âm thanh, phiên âm cuộc họp bằng AI kèm nhận diện người nói, dịch cuộc họp thời gian thực sang 44 ngôn ngữ đích, tóm tắt AI theo 10 định dạng và ghi chú có thể chia sẻ. Kèm những giới hạn thành thật, giá chính xác và điều mà độ chính xác phiên âm thực sự đòi hỏi.
Tám người đứng trong một căn phòng. Một người đang giải thích vì sao đợt migration bị trễ. Hai người nghe nửa vời. Ai đó đứng phía sau nói ra câu sẽ trở nên quan trọng sau ba tuần nữa, và không ai ghi lại.
Đó là nguyên liệu thô. Bài viết này nói về việc hệ thống của chúng tôi làm gì với nó, từng giai đoạn một, từ lúc âm thanh bắt đầu chảy cho tới lúc bạn dán một đường link vào kênh chat.
Nói rõ ngay từ đầu để không ai phải đoán: đây là bài viết về sản phẩm Telli.sh, do chính đội ngũ xây dựng nó viết. Chúng tôi đăng những bài như vậy theo định kỳ, bên cạnh các bài nghiên cứu. Điều chúng tôi cố làm ở đây là mô tả cỗ máy đủ chính xác để một người đọc hoài nghi có thể tự kiểm chứng — tên mô hình thật, con số thật, giới hạn thật — thay vì màn sương quen thuộc mang tên "ứng dụng AI".
Tóm tắt:
- Một bản ghi đi qua năm giai đoạn xử lý và để lại bốn sản phẩm được lưu riêng: bản phiên âm thô, bản đồ người nói, kịch bản đã tinh gọn, và một bản tóm tắt cho mỗi định dạng bạn áp dụng.
- Nhận diện người nói chạy trên
pyannote/speaker-diarization-community-1, xử lý theo từng khối và mang vector giọng nói đi tiếp, để cùng một người giữ nguyên nhãn từ phút thứ 5 tới phút thứ 50.- Dịch nhận 44 mã ngôn ngữ; bản thân giao diện có 15 ngôn ngữ; tóm tắt có 10 định dạng dựng sẵn cộng với các định dạng tùy chỉnh bạn tự đặt bằng tên, hướng dẫn và danh sách mục.
- Gói miễn phí là 60 phút mỗi tháng, không cần thẻ. Các gói trả phí là 5, 8 và 10 đô la mỗi tháng cho 300, 500 và 1.000 phút.
Ảnh: Klean Denmark, "Daily sprint meeting", Wikimedia Commons, CC BY-SA 2.0. Đúng kiểu cuộc họp mà cả quy trình này sinh ra để đối phó.
Âm thanh vào bằng hai đường, và hai đường đó không giống nhau
Có đúng hai điểm vào, và khác biệt giữa chúng định hình mọi thứ phía sau.
Thứ nhất là ghi âm trực tiếp. Trình duyệt mở một AudioContext cố định ở tần số lấy mẫu 16.000 Hz, nạp AudioWorklet và đệm tín hiệu micro theo khối 4.096 mẫu — ở 16 kHz tức là một gói mỗi 256 mili giây. Mỗi khối được chuyển từ số thực 32 bit sang PCM số nguyên 16 bit rồi đẩy qua WebSocket tới /ws/audio/{sessionId}. Một socket thứ hai, /ws/session/{id}, mang kênh điều khiển: đổi ngôn ngữ, cập nhật ngữ cảnh, lệnh SUMMARIZE, và lệnh FINISH để đóng phiên và ghi ghi chú.
Thứ hai là tải tệp lên. Bạn thả bản ghi vào cửa sổ tải lên, nó được truyền tới POST /upload, và phản hồi trả về dạng JSON phân dòng — một luồng, không phải vòng xoay chờ — nhờ vậy giao diện hiển thị tiến độ thật theo các bước có tên chứ không phải phần trăm bịa ra. Các giới hạn cứng nên nói thẳng: 500 MB mỗi tệp, và bộ chọn tệp chỉ nhận audio/*. Nếu cuộc họp của bạn nằm trong một bản quay màn hình MP4, bạn phải tách rãnh âm thanh ra trước. Hôm nay chúng tôi chưa làm hộ bạn việc đó.
Cả hai đường đều hợp về cùng một trục xử lý. Từ giai đoạn 1 trở đi, bản ghi trực tiếp và tệp tải lên được đối xử hệt nhau.
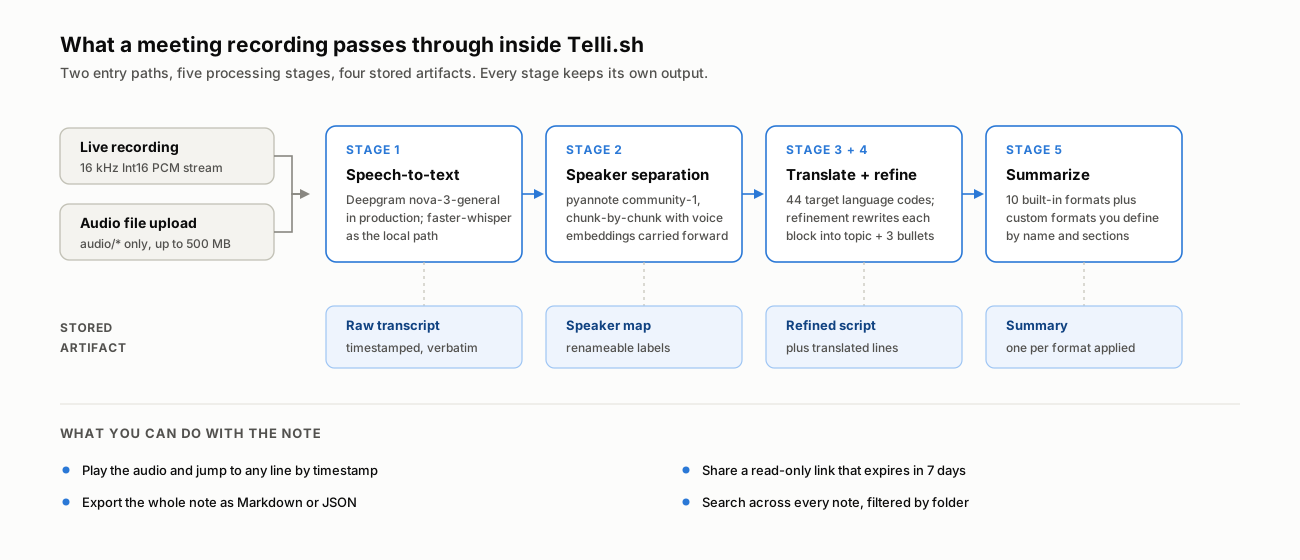
Mỗi giai đoạn giữ đầu ra của riêng nó. Giai đoạn sau không ghi đè giai đoạn trước.
Giai đoạn 1 và 2: nghe ra chữ, rồi xác định chữ đó của ai
Nhận dạng giọng nói chạy trước. Trên môi trường thật, cả nhánh xử lý theo lô lẫn nhánh streaming đều dùng mô hình nova-3-general của Deepgram; mã nguồn cũng có sẵn một nhánh chạy hoàn toàn cục bộ dựa trên faster-whisper cho triển khai tự vận hành, chọn bằng một thiết lập nhà cung cấp duy nhất. Lựa chọn đó ít quan trọng hơn nhiều người tưởng, vì một lý do chúng tôi đã viết dài: các mô hình giọng nói dẫn đầu trên các bảng xếp hạng độc lập hiện chỉ cách nhau khoảng 1,5 điểm phần trăm tỷ lệ lỗi từ. Động cơ không còn là nơi tạo ra khác biệt chất lượng nữa.
Khác biệt nằm ở nhận diện người nói.
Tách người nói chạy trên pyannote/speaker-diarization-community-1. Chi tiết triển khai thực sự quan trọng là cách xử lý bản ghi dài. Thay vì tách toàn bộ tệp trong một lượt, quy trình xử lý âm thanh theo khối và gán người nói ngay sau mỗi khối — nhưng vẫn duy trì một từ điển tích lũy các vector giọng nói cho từng người, rồi nhận diện lại dựa trên tập tích lũy đó ở mọi khối tiếp theo. Đó chính là cơ chế ngăn kiểu hỏng kinh điển: một bản ghi hai tiếng lặng lẽ đổi tên cùng một người từ SPEAKER_00 thành SPEAKER_03 rồi SPEAKER_07 khi cuộc họp kéo dài.
Khi một đoạn nằm vắt giữa hai lượt nói, nhãn thuộc về lượt phủ nhiều hơn, còn độ tương đồng vector đóng vai trò phân định trong các trường hợp phủ ít.
Bạn nhận nhãn chung chung — SPEAKER_00, SPEAKER_01 — vì mô hình không thể biết SPEAKER_01 là giám đốc kỹ thuật của bạn. Bạn đổi tên một lần trong ghi chú, và ánh xạ đó được lưu cùng ghi chú rồi áp dụng ở mọi nơi sau đó, kể cả khi xuất tệp và chia sẻ link. Đó là sự phân công thành thật: máy tách giọng, bạn cung cấp tên.
Mỗi giai đoạn thực sự để lại gì
Nguyên tắc thiết kế chúng tôi giữ là: không giai đoạn nào phá hủy đầu ra của giai đoạn trước. Bạn phải luôn quay lại được với những chữ đã thực sự được nói ra.
| Sản phẩm | Do giai đoạn nào tạo ra | Chứa gì | Dùng để làm gì |
|---|---|---|---|
| Bản phiên âm thô | Giai đoạn 1 + 2 | Các dòng nguyên văn có dấu thời gian, mỗi dòng kèm nhãn người nói | Kiểm tra câu chữ đúng như đã nói; bấm một dòng để tua âm thanh |
| Bản đồ người nói | Giai đoạn 2 (+ bạn chỉnh) | Ánh xạ nhãn sang tên trong ghi chú | Làm mọi khung nhìn khác đọc được — áp dụng trong ghi chú, bản xuất và link chia sẻ |
| Kịch bản tinh gọn | Giai đoạn 4 | Mỗi khối viết lại thành một dòng chủ đề in đậm cùng tối đa 3 ý | Lướt qua một cuộc họp dài mà không phải đọc hết |
| Dòng đã dịch | Giai đoạn 3 | Bản dịch gắn cạnh từng dòng gốc | Đọc một cuộc họp diễn ra bằng ngôn ngữ bạn không làm việc bằng nó |
| Bản tóm tắt | Giai đoạn 5 | Một tài liệu có cấu trúc cho mỗi định dạng bạn áp dụng | Thứ bạn thực sự gửi cho người khác |
Trong giao diện ghi chú, chúng hiện ra thành ba loại tab: Lịch sử (bản phiên âm thô), Kịch bản (bản tinh gọn), và một tab cho mỗi định dạng tóm tắt bạn đã tạo. Nếu âm thanh bản ghi được lưu, một trình phát nằm phía trên, và bấm vào bất kỳ dòng phiên âm nào sẽ tua âm thanh tới đúng dấu thời gian đó.
Giai đoạn 3: với dịch thuật, con số đáng nói là 44
Dịch cuộc họp thời gian thực là tính năng kéo về nhiều người dùng đầu tiên nhất, và phạm vi của nó đáng được nói cho chính xác, bởi "hỗ trợ hơn 100 ngôn ngữ" là tuyên bố khó kiểm chứng nhất trong nhóm sản phẩm này.
Có hai con số khác nhau, và chúng không phải một:
- 44 mã ngôn ngữ đích được chấp nhận để dịch. Tập này được liệt kê tường minh trong cấu hình backend và tách
zh-TWkhỏizh— điều nặng ký hơn vẻ ngoài của nó nếu bạn làm việc giữa Đài Loan và Trung Quốc đại lục. - 15 ngôn ngữ được hỗ trợ cho chính giao diện và cho ngôn ngữ mà AI viết bản tóm tắt: tiếng Anh, Hàn, Nhật, Trung, Đức, Pháp, Tây Ban Nha, Ý, Bồ Đào Nha, Nga, Ba Lan, Việt, Thái, Indonesia và Mã Lai.
Trong phiên trực tiếp, dịch diễn ra tăng dần chứ không gom lại ở cuối. Khi ranh giới dấu câu xuất hiện trong bản phiên âm, bản dịch của đoạn đó chảy vào bên cạnh bản gốc, và một bộ nhớ đệm theo phiên ngăn dịch lại phần văn bản không đổi. Khi tải tệp, các dòng được gom theo lô: lúc không ai nhìn màn hình, thông lượng quan trọng hơn độ trễ.
Ngoài ra còn có chế độ luồng dịch, tách biệt với chế độ ghi chú, dành cho trường hợp bản dịch chính là sản phẩm cuối — một cuộc trò chuyện song ngữ bạn cần theo kịp trực tiếp, chứ không phải cuộc họp cần biên bản.
Giai đoạn 4: giai đoạn không ai đòi mà ai cũng cần
Đến đây bài viết chuyển từ mô tả sang quan điểm, và chúng tôi sẽ không nói giảm: tinh gọn là giai đoạn bị đánh giá thấp nhất trong quy trình này.
Bản phiên âm nguyên văn lời nói của con người gần như không đọc nổi. Người ta bắt đầu lại câu, bỏ lửng, nói "ừ, ừ, đúng rồi" bốn lần, và chôn một quyết định trong chín mươi giây hắng giọng. Chép lại chuyện đó không sai một chữ thì vẫn là chín mươi giây hắng giọng.
Vì thế giai đoạn tinh gọn lấy từng khối hội thoại và viết lại theo ràng buộc chặt, được định nghĩa trong một mẫu prompt chứ không phải trong mã, nên chúng tôi chỉnh được mà không cần triển khai lại. Mỗi khối trở thành một dòng chủ đề in đậm rút ra từ nội dung — không phải tên vai trò, không dùng ngoặc vuông — theo sau là tối đa ba gạch đầu dòng, nhắm khoảng 300 ký tự mỗi khối. Tên người nói và dấu thời gian bị loại bỏ có chủ đích: chúng đã có trong bản phiên âm thô, và lặp lại chỉ khiến khung nhìn để lướt trở nên khó lướt hơn.
Một ràng buộc trong mẫu đó đáng được gọi tên: mô hình được yêu cầu bám theo văn phong của thứ nó nghe được, và đặc biệt không áp giọng họp hành công sở lên một cuộc trò chuyện thoải mái. Một câu chuyện ngoài hành lang được tóm tắt như biên bản hội đồng quản trị là sản phẩm tệ hơn cả việc không có tóm tắt.
Chúng tôi gọi kết quả đó là kịch bản — phiên bản đọc lướt một cái là hiểu, cách một tab so với phiên bản bạn có thể trích dẫn khi có tranh cãi.
Giai đoạn 5: mười định dạng tóm tắt, vì "tóm tắt" không phải một thứ duy nhất
Giai đoạn cuối tạo ra tài liệu bạn thật sự gửi đi. Bảo một mô hình ngôn ngữ "tóm tắt giúp" thì bạn nhận về bản tóm tắt của chẳng thứ gì cụ thể, nên ở đây định dạng là lựa chọn hạng nhất chứ không phải mặc định giấu kín.
Có mười định dạng dựng sẵn: Tóm tắt AI (chung), Biên bản họp, Báo cáo tổng hợp, Ghi chú bài giảng, Bài giảng đạo / Diễn thuyết, Hồ sơ tư vấn, Tóm tắt cuộc gọi, Phỏng vấn, Ghi chú ý tưởng và Dàn ý thuyết trình. Mỗi định dạng mang cấu trúc mục riêng: biên bản họp sinh ra tổng quan, nội dung thảo luận, quyết định và các bước tiếp theo; dàn ý thuyết trình sinh ra bố cục, mạch slide, thông điệp chính, ghi chú người trình bày và hành động kế tiếp. Bản thân tiêu đề các mục được bản địa hóa theo từng ngôn ngữ thay vì dịch lúc sinh nội dung — nhờ vậy bản tóm tắt tiếng Nhật đọc như tài liệu tiếng Nhật chứ không như văn bản tiếng Anh dịch ra.
Khi không định dạng nào trong mười cái vừa ý, bạn tự định nghĩa một định dạng tùy chỉnh: một cái tên, một bộ hướng dẫn, và danh sách mục bạn muốn, lưu lại và dùng nhiều lần. "Cập nhật hằng tuần cho hội đồng, kèm rủi ro và quyết định còn treo" là một định dạng chỉ viết một lần.
Bất kỳ định dạng nào cũng có thể áp dụng cho ghi chú sau khi mọi thứ đã xong, và mỗi cái tạo tab riêng. Tóm tắt cùng một bản ghi theo ba cách cho ba nhóm người đọc ở đây là cách dùng bình thường, không phải mẹo lách.
Độ chính xác phiên âm là một chồng lớp, không phải một con số
Nếu bạn đang so sánh công cụ trong nhóm này, đây là phần đáng để tranh luận.
Ngành công bố một con số — tỷ lệ lỗi từ — và con số đó đã hết tác dụng trong việc chọn sản phẩm, bởi tất cả đều dồn sát đáy. Chúng tôi mổ xẻ lập luận này chi tiết trong bài Độ chính xác STT là chưa đủ, gồm cả trường hợp một chữ "không" bị rơi làm đảo ngược cả quyết định trong khi chỉ tiêu tốn 0,016% ngân sách độ chính xác.
Bản thực dụng: độ chính xác phiên âm sống sót khi va vào một cuộc họp thật được dựng từ năm lớp, và mô hình âm học chỉ là lớp dưới cùng.
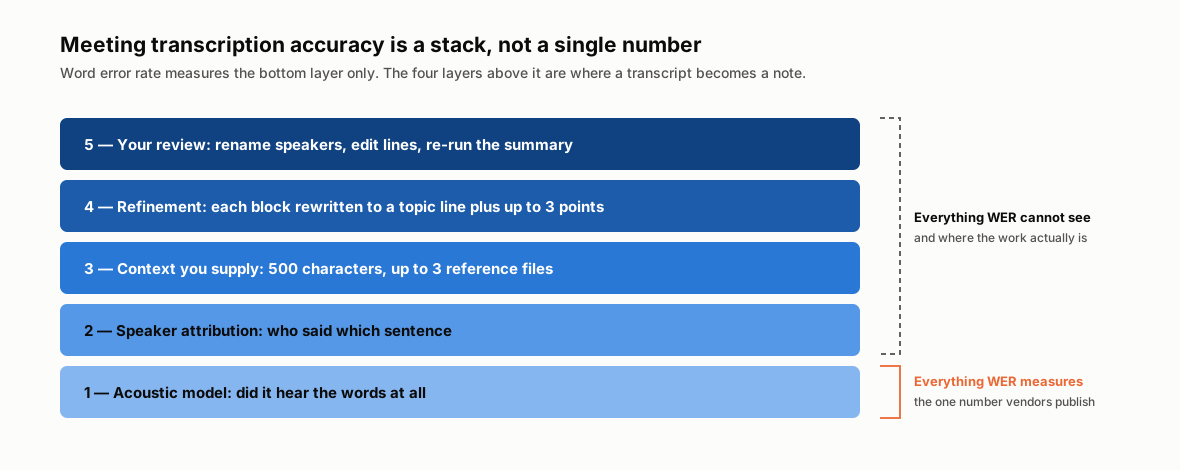
Tỷ lệ lỗi từ chỉ đo lớp 1. Các lớp 2 đến 5 mới quyết định bản phiên âm có dùng được hay không.
Lớp 3 là lớp người dùng kiểm soát trực tiếp mà phần lớn lại bỏ qua. Trước khi ghi âm hoặc tải lên, bạn có thể cung cấp một khối ngữ cảnh tối đa 500 ký tự — chủ đề, tên người tham dự, mã sản phẩm, từ viết tắt — và đính kèm tối đa 3 tệp tham khảo (PDF, ảnh hoặc văn bản), phần chữ trong đó được trích xuất ngay trên trình duyệt rồi gộp vào cùng hạn mức 500 ký tự ấy. Ngữ cảnh này được chuyển tới các giai đoạn AI.
Đây không phải tính năng cho vui. Danh từ riêng vừa là những từ mang nhiều thông tin nhất vừa là những từ hiếm gặp nhất trong mọi cuộc họp: tên dự án nội bộ, họ ít gặp, mã sản phẩm. Nói trước cho hệ thống biết "Kestrel" là sản phẩm và "Ravi" là người tốn mười lăm giây, và xóa đi những lỗi mà nếu không bạn sẽ ngồi sửa tay mười phút. Nếu sau bài này bạn chỉ thay đổi một điều, hãy điền ô ngữ cảnh.
Từ con số không đến ghi chú chia sẻ được, trong mười một bước
Cụ thể, từ lần chạy đầu tiên đến sản phẩm chia sẻ được:
- Đăng ký. Gói miễn phí là 60 phút mỗi tháng, không cần thẻ tín dụng, và chạy đúng quy trình như gói trả phí — đây là khác biệt hạn mức, không phải khác biệt tính năng.
- Chọn đường: bắt đầu ghi âm trực tiếp, hoặc mở cửa sổ tải lên và thả một tệp âm thanh (
audio/*, dưới 500 MB). - Đặt cặp ngôn ngữ. Nguồn có thể để ở chế độ tự nhận diện; ngôn ngữ đích quyết định bản dịch và bản tóm tắt ra bằng thứ tiếng nào.
- Điền ô ngữ cảnh — chủ đề, tên người, từ viết tắt, tối đa 500 ký tự. Đính kèm tối đa 3 tệp tham khảo nếu bạn có slide hoặc chương trình họp.
- Chọn thư mục nếu muốn ghi chú nằm ở chỗ cụ thể. Bạn có thể chuyển sau.
- Ghi âm, hoặc chờ luồng tải lên. Trong phiên trực tiếp, bản phiên âm hiện ra khi mọi người nói, kèm bản dịch chảy vào bên cạnh nếu bạn đã đặt ngôn ngữ đích. Khi tải lên, bạn sẽ thấy các bước có tên: nhận dạng giọng nói, phân tích, tinh gọn, tóm tắt, hoàn tất.
- Kết thúc phiên. Việc đó kích hoạt thông điệp điều khiển
FINISH, đẩy nốt đoạn cuối, chờ phần tinh gọn đang chạy, lưu âm thanh, sinh bản tóm tắt và ghi ghi chú. - Đổi tên người nói. SPEAKER_00 trở thành một cái tên đúng một lần, và ánh xạ lan ra mọi khung nhìn cùng mọi bản xuất.
- Đọc tab Kịch bản để nắm cuộc họp bàn chuyện gì; nhảy xuống Lịch sử và bấm một dòng để nghe âm thanh đúng khoảnh khắc đó khi thấy có gì sai sai.
- Sinh thêm định dạng tóm tắt nếu nhóm người đọc này cần biên bản họp còn nhóm kia cần báo cáo tổng hợp.
- Chia sẻ hoặc xuất tệp. Link chia sẻ chỉ đọc, hết hạn sau 7 ngày, và có thể đặt mật khẩu tùy chọn. Xuất tệp cho bạn Markdown hoặc JSON, với bản tóm tắt, các khối tinh gọn và toàn bộ bản phiên âm trong cùng một tệp.
Chi phí, bằng con số chính xác
Hạn mức tính theo số phút âm thanh đã xử lý, và đó là thứ duy nhất phân biệt các bậc.
| Gói | Số phút mỗi tháng | Hàng tháng | Hàng năm | Chi phí thực cho 100 phút |
|---|---|---|---|---|
| Miễn phí | 60 | USD 0 | — | — |
| Plus | 300 | USD 5,00 | USD 51,00 | USD 1,67 |
| Pro | 500 | USD 8,00 | USD 81,60 | USD 1,60 |
| Pro+ | 1.000 | USD 10,00 | USD 102,00 | USD 1,00 |
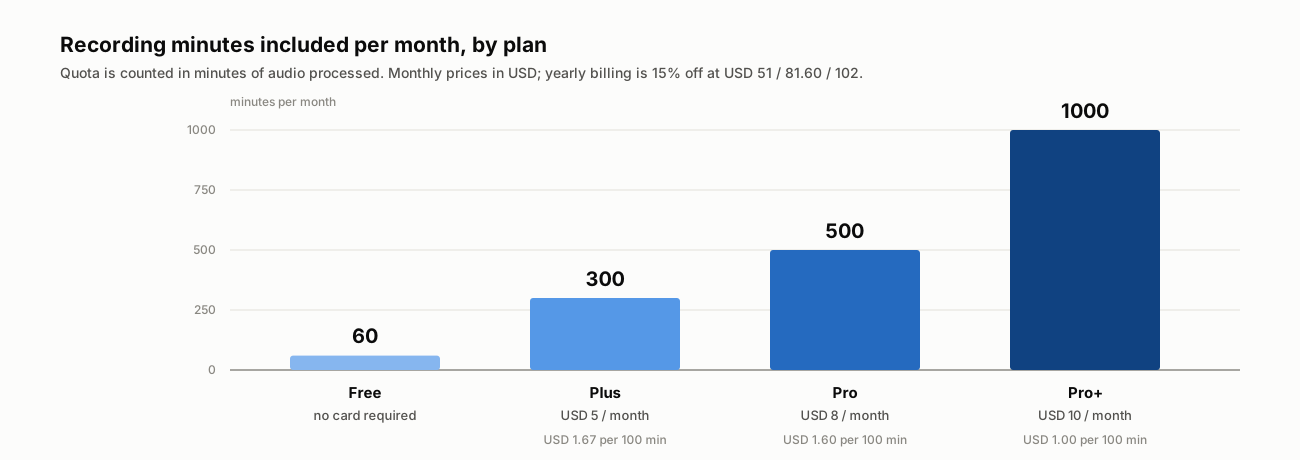
Thanh toán theo năm bằng giá tháng × 12 × 0,85. Bậc càng cao thì đơn giá mỗi phút càng tốt; quy trình thì không đổi.
Sáu mươi phút miễn phí là một cuộc họp dài, hoặc ba buổi họp nhanh. Đủ để trả lời câu hỏi duy nhất đáng hỏi: cái này có tạo ra một ghi chú mà bạn thật sự sẽ gửi đi không? Trên chính âm thanh của bạn, chứ không phải bản demo của nhà cung cấp.
Ghi lại cuộc họp tới của bạn theo thời gian thực
Telli.sh không làm gì
Một bài viết sản phẩm chỉ liệt kê khả năng thì là quảng cáo. Đây là cột còn lại.
Không nhận tệp video. Trình tải lên chỉ nhận audio/*. Hãy tách rãnh âm thanh trước.
Không tham gia cuộc gọi thay bạn. Không có bot nào gọi vào Zoom, Meet hay Teams rồi ngồi trong danh sách người tham dự. Bạn ghi âm căn phòng, hoặc âm thanh trên máy mình, hoặc tải tệp lên sau đó.
Không sửa được âm thanh tệ. Đây là ranh giới thành thật của cả nhóm sản phẩm. Một micro đa hướng của laptop đặt ở đầu bàn mười hai người, trong phòng tường cứng, sẽ cho ra kết quả tách người nói kém đi bất kể mô hình của hãng nào đang chạy — lời nói chồng lấn và người nói ở xa là chỗ việc quy gán vỡ đầu tiên. Một chiếc điện thoại đặt giữa bàn luôn thắng chiếc laptop ở cuối bàn, và không tốn đồng nào.
Không biết từ vựng của bạn nếu bạn không nói. Xem lớp 3 phía trên. Danh từ riêng lạ là nguồn lỗi phổ biến nhất, và ô ngữ cảnh là cách chữa.
Nhãn người nói bắt đầu ở dạng chung chung. Không hệ thống nào đoán được SPEAKER_01 là Priya. Bạn đổi tên một lần cho mỗi ghi chú.
Link chia sẻ có thời hạn. Bảy ngày, sau đó link chết. Đó là mặc định có chủ ý cho nội dung cuộc họp, không phải tính năng bị bỏ quên — nhưng cũng có nghĩa link chia sẻ không phải kho lưu trữ. Cần lưu lâu dài thì hãy xuất bản Markdown.
Chốt lại
Sai lầm ban đầu của chúng tôi là nghĩ đây là một sản phẩm phiên âm. Không phải. Phiên âm là giai đoạn một trên năm, và là giai đoạn gần được giải quyết nhất.
Thứ chúng tôi thực sự xây là khoảng cách giữa một bản ghi và một quyết định: biết ai đã nói, ép chín mươi giây hắng giọng xuống còn một câu nằm bên trong, chuyển câu đó sang ngôn ngữ mà người đọc dùng để làm việc, rồi đặt nó ở nơi một đồng nghiệp mở ra được. Bản ghi là bằng chứng. Ghi chú là thứ thay đổi chuyện sẽ xảy ra tuần sau.
Nếu ngay lúc này trong máy bạn đang có một bản ghi cuộc họp, đó là phép thử duy nhất đáng chạy. Của chúng tôi mất sáu mươi giây thiết lập và cho ra một ghi chú đã gửi cho bốn người.
Bắt đầu một phiên trực tiếp có dịch
Nguồn
- Độ chính xác STT là chưa đủ — blog Telli.sh, ngày 4 tháng 8 năm 2026 — toàn bộ lập luận về tỷ lệ lỗi từ, kèm khoảng cách trên bảng xếp hạng
- pyannote/speaker-diarization-community-1 — Hugging Face — mô hình tách người nói dùng trong quy trình này
- Tài liệu mô hình Deepgram Nova-3 — mô hình nhận dạng giọng nói dùng trên môi trường thật
- Bảng giá Telli.sh — hạn mức và giá đã trích ở trên
- Trang ảnh trên Wikimedia Commons — ảnh đầu bài, Klean Denmark, CC BY-SA 2.0
