Strata và Qwen3.8-Flash-Next: Chạy mô hình cấp 180B trên PC cá nhân như thế nào?
Hướng dẫn đối chiếu nguồn về kiến trúc Strata, thiết lập trên Windows và Linux, lộ trình Apple Silicon Mac thử nghiệm riêng, benchmark đã công bố và giới hạn của AI chạy cục bộ.
Một mô hình có khoảng 180 tỷ tham số chạy trên máy tính để bàn với card đồ họa 12 GB nghe có vẻ mâu thuẫn. Strata khiến điều đó trở nên khả thi, nhưng không phải bằng cách nhồi mọi tham số vào card. Thành tựu đáng chú ý hơn là phân bổ các phần khác nhau của một mô hình thưa sang những loại bộ nhớ và năng lực tính toán khác nhau, mà không biến mỗi token được tạo ra thành một nút thắt do truyền dữ liệu lưu trữ.
Tên chính thức của mô hình là Qwen3.8-Flash-Next, không phải Qwen3.8-Next-Flash. Qwen liệt kê lõi 125B tham số với 6B được kích hoạt, thêm thành phần embedding n-gram 51B và 4B dành cho dự đoán nhiều token. Tổng số làm tròn 180B mô tả các thành phần được lưu trữ; đó không phải lượng tính toán đặc một cách được thực hiện cho từng token. Thẻ mô hình Qwen
Thông tin thiết lập và hiệu năng dưới đây dựa trên bản sửa đổi Strata fb58e0dbc8399662c0e47c76578c6e878b14f6cf. Các số liệu benchmark là kết quả do dự án công bố; phần cứng, prompt, ngữ cảnh và biến thể mô hình của bạn có thể cho kết quả khác.
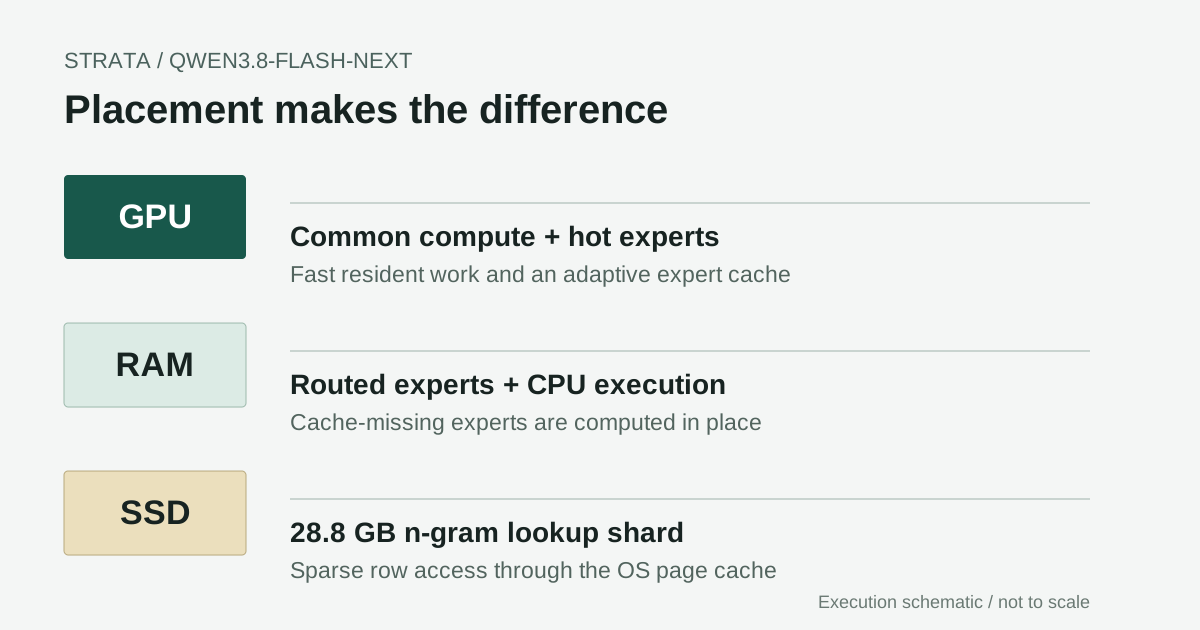
Sơ đồ nguyên bản dựa trên thiết kế thực thi được tài liệu hóa. Các tầng không vẽ theo tỷ lệ: dung lượng tải xuống, mức dùng RAM và phần lưu trú trên GPU là những đại lượng khác nhau.
Đột phá nằm ở cách phân bổ, không phải mô hình nhỏ hơn
Với bất kỳ mô hình cục bộ lớn bất thường nào, cần đặt ba câu hỏi: phải lưu trữ bao nhiêu, có bao nhiêu phần hoạt động cho một token, và phần việc đang hoạt động chạy ở đâu. Con số tham số hoạt động nhỏ chỉ trả lời câu hỏi thứ hai. Nó không xóa bỏ yêu cầu phải giữ các trọng số còn lại ở nơi có thể truy cập.
Strata là một engine suy luận và ứng dụng phục vụ cục bộ do cộng đồng phát triển trong kho mã Niko1221. Hướng dẫn thiết lập của dự án hỗ trợ cài đặt trên Windows và Linux, giao diện chat cục bộ, các API tương thích và tùy chọn nhập ảnh. Đây là dự án cộng đồng riêng, không phải sản phẩm máy tính để bàn chính thức của Qwen. Kho Strata
Thay đổi kỹ thuật hữu ích là ngừng xem PC như một GPU thiếu bộ nhớ. Máy tính để bàn còn có RAM hệ thống, các đơn vị vector của CPU và bộ nhớ đệm trang của hệ điều hành. Những tài nguyên này chậm hơn bộ nhớ GPU trong một số thao tác, nhưng không phải thao tác nào cũng kém phù hợp như nhau. Tra cứu một bảng lớn và nhân ma trận đặc không cần cùng một chính sách phân bổ.
Chính khác biệt đó khiến điểm nhấn này đáng chú ý. Mô hình vẫn lớn; runtime thay đổi lượng mô hình cần nằm trong bộ nhớ nhanh nhất tại một thời điểm nhất định. Điều này mở ra một hướng suy luận cục bộ thực tế, nhưng không chứng minh rằng mọi laptop phổ thông đều chạy tốt.
Kiến trúc thưa tạo ra cơ hội
Kiến trúc của Qwen kết hợp các khối Gated DeltaNet kiểu hồi quy với Qwen Sparse Attention, expert được định tuyến và embedding n-gram. Báo cáo kỹ thuật giải thích vì sao các thành phần này được thiết kế để mở rộng hiệu quả hơn. Strata không phát minh các thành phần mô hình đó; nó xây dựng chiến lược thực thi dựa trên các kiểu truy cập khác nhau của chúng. Báo cáo kiến trúc Qwen
Chi tiết định tuyến rất quan trọng. Mỗi trong 48 tầng có 512 expert định tuyến; 10 expert định tuyến được kích hoạt ở mỗi tầng, cùng với một expert dùng chung. Như vậy, có 24.576 expert định tuyến được lưu trên toàn bộ các tầng. Điều đó không có nghĩa chỉ 10 trong số 24.576 expert ấy được dùng trên toàn mô hình cho một token. Cấu hình kiến trúc Qwen
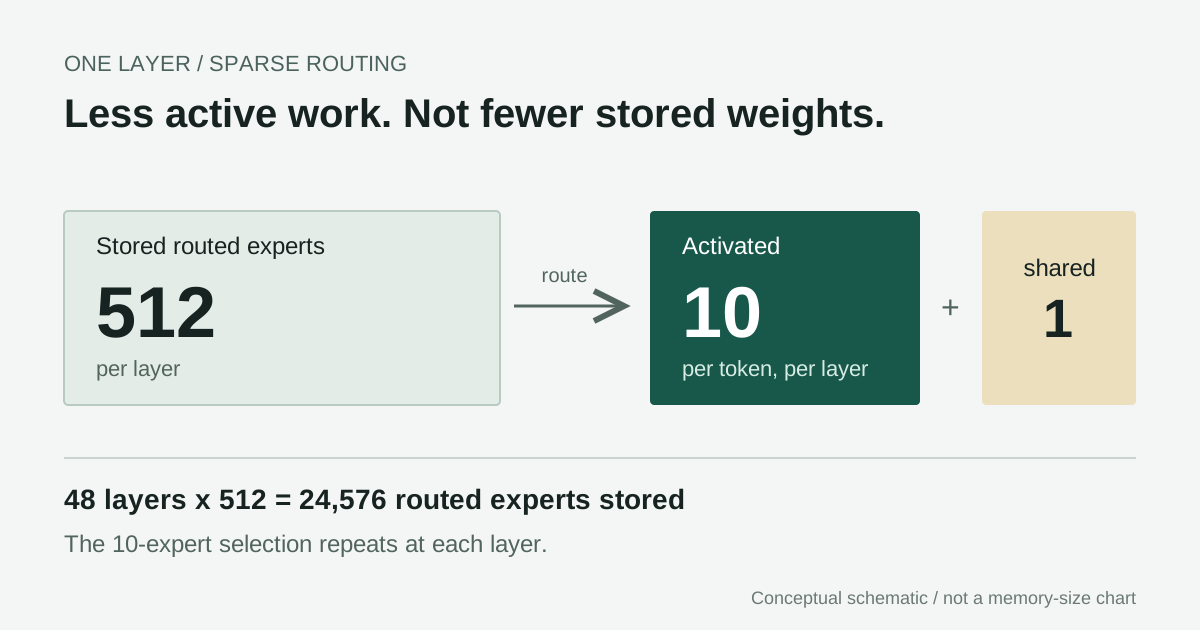
Chọn lọc làm giảm phần việc đang hoạt động, không giảm số lượng cần lưu. Sơ đồ này thể hiện một tầng, không phải toàn bộ mô hình 48 tầng.
Hãy xét hệ quả mà không cần dựa vào tuyên bố tốc độ nào. Nếu một expert hiếm khi được chọn, dành cố định bộ nhớ tăng tốc đắt đỏ cho nó có thể là cách dùng dung lượng kém hiệu quả. Nếu một thành phần khác được dùng ở mọi bước, việc liên tục chuyển nó đi có thể tốn kém. Bộ lập lịch hữu ích phải phân biệt các trường hợp này rồi quản lý những lần truy cập hụt không thể tránh.
Đó cũng là lý do không nên so sánh mô hình thưa cấp 180B với mô hình đặc 180B chỉ dựa trên số tham số. Ngược lại, gọi nó là “mô hình 6B” sẽ che khuất nhu cầu lưu trữ, định tuyến, trạng thái ngữ cảnh và chi phí truy cập trọng số phân tán. Cả hai cách nói tắt đều làm mờ bài toán kỹ thuật thực sự.
GPU, RAM và SSD đảm nhận các vai trò khác nhau
Theo thiết kế nền được tài liệu hóa, GPU giữ phần tính toán thường dùng và bộ nhớ đệm các expert định tuyến được truy cập thường xuyên. RAM hệ thống chứa trọng số expert định tuyến; CPU tính toán tại chỗ các expert bị thiếu trong bộ đệm GPU. Một bảng n-gram riêng được ánh xạ bộ nhớ trên SSD, các hàng cần thiết được phục vụ thông qua bộ nhớ đệm của hệ điều hành. Tổng quan thực thi Strata
Đường xử lý qua CPU này có ý nghĩa hơn nhiều so với nhãn “offload” chung chung. Trong lúc giải mã, khi trượt bộ đệm, hệ thống không nhất thiết phải sao chép mọi expert còn thiếu lên GPU rồi mới tiếp tục. Công việc của CPU và GPU có thể chồng lấp. Đổi lại, năng lực CPU và băng thông bộ nhớ hệ thống ảnh hưởng trực tiếp đến tốc độ đầu ra.
Thành phần n-gram lại có kiểu truy cập khác. Tra cứu vài hàng không giống với quét toàn bộ bảng. Vì vậy, giữ shard tra cứu đã lượng tử hóa 28.8 GB trên SSD có thể khả thi mà không có nghĩa là phải đọc toàn bộ mô hình từ đĩa cho mỗi token được tạo. Tuy nhiên, ổ đĩa chậm hoặc áp lực lớn lên bộ đệm trang vẫn có thể làm giảm khả năng phản hồi.
Giai đoạn prefill cũng khác với giải mã. Xử lý prompt ban đầu cho phép dùng các batch lớn hơn và chồng lấp việc truyền expert với công việc ở các lớp khác. Việc liên tục tạo token tiếp theo lại nhạy với độ trễ. Tài liệu chi tiết của dự án mô tả các kernel, cách lập lịch và hành vi bộ đệm khác nhau cho hai giai đoạn. Một con số thông lượng không thể tóm tắt cả hai. Chi tiết triển khai Strata
Theo cách tôi hiểu, đổi mới nằm ở một hệ thống phối hợp chứ không phải một thủ thuật nén đơn lẻ. Lượng tử hóa giảm dung lượng lưu trọng số; bộ đệm giảm truy cập lặp lại vào trọng số thường dùng; thực thi trên CPU xử lý các lần trượt bộ đệm; tra cứu thưa tránh nạp toàn bộ bảng khổng lồ. Bỏ đi bất kỳ lợi thế nào trong số này, một máy tính để bàn có ít bộ nhớ sẽ trở thành nơi chạy mô hình kém thuyết phục hơn nhiều.
Giải mã suy đoán chỉ tiết kiệm công khi bước kiểm tra chấp nhận
Strata cũng dùng thành phần dự đoán nhiều token của mô hình để đề xuất các đoạn tiếp nối ngắn, rồi kiểm tra chúng bằng mô hình đích. Thay vì trả chi phí cho một lượt chạy mô hình đích đầy đủ trên từng token đầu ra, bản nháp thành công có thể giúp lượt chạy đó chấp nhận nhiều token. Kho mã mô tả các bản nháp tối đa ba token trong nhánh MTP. Thiết kế và triển khai MTP
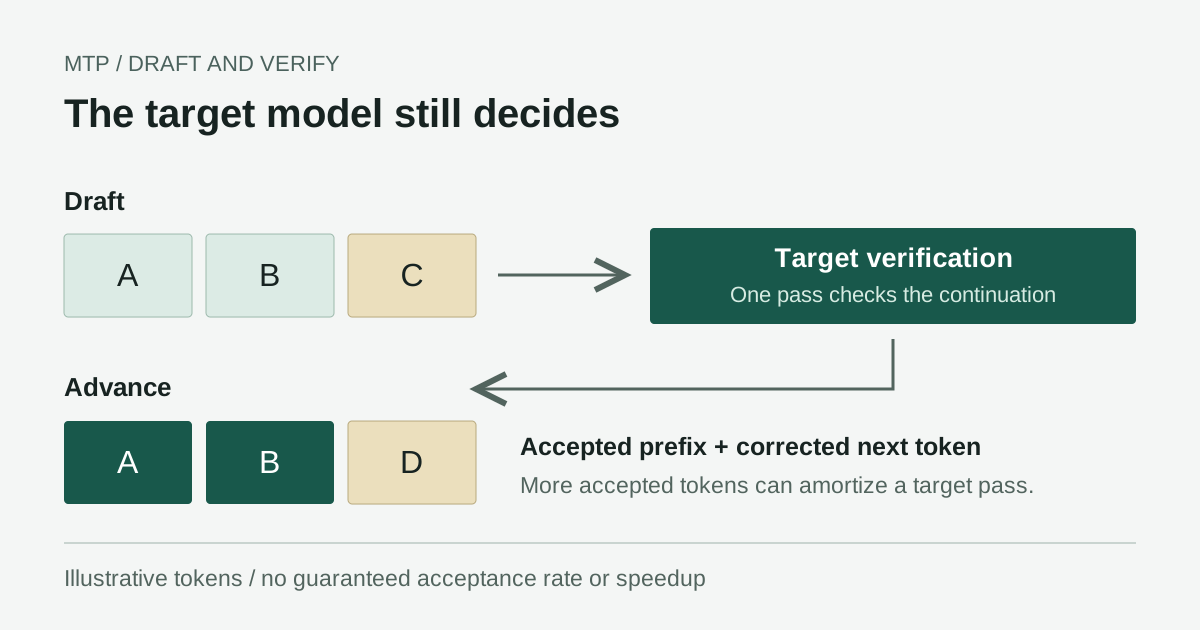
Ví dụ minh họa bước kiểm tra, không đảm bảo tỷ lệ chấp nhận hay mức tăng tốc đã đo được.
Đây là mức tăng tốc có điều kiện. Mã dễ dự đoán hoặc văn bản lặp lại có thể dễ tạo bản nháp hơn một bước chuyển lập luận chưa quen thuộc. Cách diễn đạt prompt, phương pháp lấy mẫu, độ dài đầu ra và biến thể mô hình đều có thể làm thay đổi tỷ lệ chấp nhận. Vì vậy không nên cho rằng một con số nổi bật đo trên một prompt cũng mô tả được tác vụ hay ngôn ngữ khác.
Việc kiểm tra nhắm đến chính mô hình đang chạy. Nó không khôi phục thông tin đã mất do lượng tử hóa và cũng không chứng minh tương đương với trọng số BF16 ban đầu. Cần tách bạch hai vấn đề này: thực thi suy đoán và chất lượng mô hình ở độ chính xác thấp trả lời những câu hỏi khác nhau.
Một điểm khác biệt nữa là tái sử dụng bộ đệm. Tiền tố hội thoại không đổi có thể giúp tiết kiệm công việc lặp lại, nhưng một lượt tiếp nối có bộ đệm nóng và một prompt dài hoàn toàn mới không phải các phép thử tương đương. Khi so sánh kết quả cục bộ, hãy ghi lại tiền tố có được tái sử dụng hay không. Dự án tài liệu hóa rõ cơ chế bộ đệm theo ranh giới thông điệp. Cách hoạt động của bộ đệm tiền tố
“GPU 12 GB” không có nghĩa là cài đặt chỉ cần 12 GB
Các bản lượng tử hóa GGUF đã công bố chia mô hình thành một shard chính và một shard n-gram cố định 28.8 GB. Kích thước tệp dưới đây tính theo GB thập phân và là dung lượng tải xuống, không phải yêu cầu bộ nhớ GPU. Projector thị giác tùy chọn cộng thêm khoảng 0.91 GB; các tệp tải thêm và tệp chuyển đổi tạm thời cần thêm dung lượng. Các tệp lượng tử hóa ISTA-DASLab
| Biến thể | Số bit trung bình mỗi trọng số lõi | Shard chính | Shard n-gram | Tổng dung lượng tải xuống |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
Chỉ tên định dạng không mô tả chính xác mọi tensor. Shard chính dùng nhiều định dạng kết hợp, còn shard n-gram dùng IQ4_NL. “Mô hình hai bit” là cách nói tắt tiện dụng nhưng dễ gây hiểu lầm nếu khiến người đọc nghĩ toàn bộ nội dung tải về dùng đúng hai bit cho mỗi tham số. Phương pháp lượng tử hóa
Để thử toàn bộ mô hình lần đầu, GPU được hỗ trợ từ 12 GB trở lên cùng 64 GB RAM hệ thống là mức cơ sở lập kế hoạch đáng tin cậy hơn việc chỉ nhìn vào tiêu đề về GPU. Kho mã cũng đề cập các lộ trình giảm RAM và biến thể Coder đã cắt tỉa. Đó là những cấu hình khác, không chứng minh máy 32 GB mang lại trải nghiệm toàn mô hình tương tự. Chọn mô hình Strata
Tôi sẽ dành sẵn 100-150 GB dung lượng SSD trống trước khi thử nghiệm. Đây là khoản dự phòng thận trọng để lập kế hoạch, không phải yêu cầu cố định từ nhà cung cấp: tổng thực tế phụ thuộc vào lượng tử hóa đã chọn, trợ giúp MTP, tệp thị giác tùy chọn và bộ nhớ đệm khi dựng/chuyển đổi. Một số đường tối ưu CPU cho Q2 có thể cần thêm một bản sao expert đáng kể. Hãy kiểm tra đúng lộ trình đã chọn thay vì mặc định một con số dung lượng đĩa áp dụng cho mọi trường hợp.
Trước khi chọn phần cứng, hãy xác định cấu hình bạn cần: mô hình đầy đủ hay đã cắt tỉa, ngữ cảnh ngắn hay dài, thị giác hay chỉ văn bản, và thông lượng liên tục hay chỉ dùng đôi lúc. Những lựa chọn ấy làm thay đổi vị trí nút thắt, còn benchmark bên dưới mô tả một hệ thống cụ thể.
Cài cấu hình cơ sở đã ghim phiên bản trước khi tinh chỉnh
Lộ trình tiêu chuẩn được tài liệu hóa hỗ trợ Windows 10/11 và Ubuntu 22.04/24.04, với GPU NVIDIA được hỗ trợ và một số GPU AMD được chọn. Hướng dẫn NVIDIA yêu cầu driver 580 trở lên. macOS và các backend tự dựng từ mã nguồn khác có yêu cầu riêng; các lệnh bên dưới không phải lộ trình thiết lập dùng chung cho mọi nền tảng. Hướng dẫn cài đặt chính thức
Trên Windows, kiểm tra trước khi tải
Nếu chưa có Git, hãy cài từ bản phân phối chính thức. Trong PowerShell, sao chép kho mã upstream và ghim vào phiên bản đã được xem xét ở đây:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
Lệnh kiểm tra tránh tải mô hình dung lượng lớn, nhưng launcher có thể tự thiết lập Python và một môi trường riêng. Cách hoạt động của bước kiểm tra thiết lập
Hãy đọc báo cáo phần cứng, kiểm tra các script thiết lập và xác nhận dung lượng trống trước khi tiếp tục. Sau đó khởi chạy thiết lập tương tác:
.\START-HERE.bat
Đối với lần thử ban đầu trên máy 64 GB, IQ2_XS là điểm bắt đầu hợp lý trong số các lựa chọn được tài liệu hóa. Dùng ngữ cảnh 32,768 token, chỉ văn bản và tắt Experimental Speed Projection. Cấu hình cơ sở nhỏ hơn này giúp khoanh vùng lỗi dễ hơn so với bắt đầu bằng ngữ cảnh tối đa, thị giác và bật mọi tối ưu hóa.
Hãy dự kiến phải tải xuống và cài dependency, chứ không phải một tệp thực thi nhỏ tự chứa mọi thứ. Tùy đường GPU, quá trình thiết lập dùng engine đã chuẩn bị sẵn hoặc công cụ dựng. Xem xét kỹ các lời nhắc liên quan đến driver, trình biên dịch hay quyền quản trị; đừng tắt antivirus hoặc cơ chế bảo vệ trình duyệt để ép cài đặt tiếp tục. Lấy driver cần thiết từ nhà sản xuất phần cứng.
Các lần khởi chạy sau dùng cùng launcher. Để mở lại phần thiết lập hoặc tránh xung đột cổng:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
Trên Ubuntu, dùng script thiết lập được tài liệu hóa
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Chọn backend phù hợp với GPU. Đường ROCm của AMD và đường CUDA của NVIDIA không thể dùng thay thế cho nhau. Hãy xem các lời nhắc cài gói hoặc trình biên dịch là thay đổi trên máy của bạn và cần được cân nhắc. Phiên bản đã ghim giúp bài viết có thể tái lập; các bản mới hơn có thể cải thiện hỗ trợ, vì vậy hãy đọc ghi chú phát hành trước khi chủ động nâng cấp.
Xác nhận có phản hồi trước khi kết nối agent
Sau khi tải xong, mở http://127.0.0.1:8080 trong trình duyệt cục bộ, hoặc cổng thay thế đã chọn. Gửi một câu hỏi ngắn, không nhạy cảm và xác nhận câu trả lời hoàn tất. Chỉ sau đó mới thử prompt dài hơn, tái sử dụng bộ đệm ở lượt tiếp theo và ngôn ngữ bạn định dùng. Theo dõi bộ nhớ và log máy chủ trong lần tải đầu tiên.
API tương thích được tài liệu hóa gồm GET /v1/models và POST /v1/chat/completions. Hãy khám phá mã định danh mô hình đang được phục vụ thay vì tự đoán một bí danh rồi chép sang client khác:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Dùng mã định danh trả về khi cấu hình client tương thích. Yêu cầu liệt kê mô hình thành công chứng minh khả năng khám phá, không chứng minh chất lượng tạo nội dung; phản hồi chat hoàn tất mới là phép kiểm tra đầu tiên có ý nghĩa. Trong lần thử ban đầu này, hãy tắt các công cụ agent có thể ghi tệp hoặc chạy lệnh shell.
Nếu card hết bộ nhớ, trước tiên hãy giảm ngữ cảnh và tắt thị giác. Nếu tiến trình bị hệ thống dừng hoặc máy hoán đổi bộ nhớ quá nhiều, hãy kiểm tra RAM hệ thống thay vì chỉ xem VRAM. Khi thiếu thư viện runtime, hãy tham khảo hướng dẫn riêng cho backend thay vì cài DLL tùy tiện. Dự án có hướng dẫn khắc phục theo triệu chứng. Khắc phục sự cố Strata
Trên Mac, cần phân biệt hỗ trợ mô hình với hỗ trợ Strata
Apple Silicon dùng bộ nhớ hợp nhất thay vì cách bố trí VRAM GPU và RAM hệ thống tách biệt trong benchmark máy tính để bàn. Trình cài đặt Strata ở phiên bản đã ghim không hướng dẫn lộ trình macOS được hỗ trợ; một yêu cầu hỗ trợ Mac không có nghĩa là việc chuyển nền tảng đã hoàn tất. Yêu cầu hỗ trợ Mac upstream
Người dùng Mac có thể đang nói đến hai thử nghiệm khác nhau. Một fork Strata-macOS do cộng đồng phát triển giữ lại giao diện và Python API với backend Metal cho các mô hình GGUF nhỏ hơn; các kiểm tra được tài liệu hóa dùng Qwen2.5, không phải cấu hình Flash-Next gốc. Fork này nêu rõ rằng không chuyển phần streaming expert CUDA hay đường MTP của Strata. Đừng xem fork đó như cách cài một cú nhấp cho mô hình đang bàn. Fork cộng đồng và phạm vi
Đối với chính Qwen3.8-Flash-Next, một lộ trình thử nghiệm riêng là bản dựng llama.cpp tương thích với Metal cùng các tệp GGUF chia shard của nhà phát hành. Đây không phải Strata trên Mac, và bảng tốc độ Windows bên dưới không áp dụng.
Dựng runtime Metal riêng biệt
Dùng máy Mac Apple Silicon, terminal ARM64 chạy native, công cụ dành cho nhà phát triển dòng lệnh của Apple, Git và CMake. Nếu thiếu CMake, hãy cài từ bản phân phối chính thức hoặc trình quản lý gói đáng tin cậy của bạn. Tài liệu dựng llama.cpp đã xem xét cho biết Metal được bật mặc định trên macOS. Ghim phiên bản engine cũng ngăn nhánh luôn thay đổi âm thầm làm thay đổi ví dụ trong tương lai. Hướng dẫn dựng Metal cho llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Tải cả hai shard IQ2_XS từ danh sách tệp của nhà phát hành vào cùng một thư mục và giữ nguyên tên gốc. Shard thứ hai vẫn cần thiết ngay cả khi các hàng tra cứu của nó được giữ trên đĩa. Thay đường dẫn mô hình ví dụ bên dưới bằng đường dẫn thực tế đến shard thứ nhất trên máy Mac:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
Nhà phát hành tài liệu hóa cách nạp tệp chia shard cùng các cờ mmap/lazy; engine đã xem xét có các tùy chọn đó. Chúng giúp bảng n-gram khả dụng khi cần thay vì buộc phải lưu trú toàn bộ trong bộ nhớ. Đây là tùy chọn của llama.cpp, không phải tùy chọn launcher Strata. Ví dụ nạp GGUF
Dung lượng vẫn rất quan trọng: shard IQ2_XS chính có 39.2 GB, chưa tính trạng thái runtime và phần bộ nhớ macOS sử dụng. Vì vậy, Mac 16 GB hoặc 24 GB không phải mức cơ sở đáng tin cậy để giữ toàn bộ mô hình trong bộ nhớ cho ví dụ này; ngay cả 64 GB cũng chỉ là điểm bắt đầu để lập kế hoạch, không đảm bảo chạy được. Kiểm tra áp lực bộ nhớ và swap trong Activity Monitor, bắt đầu với ngữ cảnh 4K và dừng nếu áp lực bộ nhớ duy trì ở mức cao. Đừng thay đổi giới hạn bộ nhớ kernel để ép một cấu hình không vừa chạy.
Hãy xác nhận nhật ký cho thấy Metal được chọn và một câu trả lời chỉ bằng văn bản hoàn tất mạch lạc trước khi thử thêm. Sau đó kiểm tra các prompt dài hơn rồi mới thêm giải mã suy đoán hoặc thị giác. Lộ trình này không bao gồm Mac Intel, thực thi phân tán trên nhiều máy Mac hay chuyển đổi sang MLX. Ở đây không có số liệu thông lượng Mac; kết quả phụ thuộc vào mẫu chip, dung lượng bộ nhớ hợp nhất, engine, lượng tử hóa và ngữ cảnh cụ thể.
Tốc độ đã công bố rất đáng khích lệ; độ trễ token đầu tiên lại kể câu chuyện khác
Để có phép so sánh tái lập, bảng sử dụng benchmark ngày 29 tháng 9 năm 2026, engine 0.1.26 thay vì trộn lẫn với các tiêu đề README mới hơn. Máy thử nghiệm dùng RTX 5070 12 GB trên PCIe 5.0 x16, Ryzen 5 7600 sáu lõi, 64 GB DDR5-5200 và Windows 10. Các bài thử dùng sinh tham lam, bật MTP, tắt ảnh và tạo 256 token. Điều kiện benchmark
| Biến thể | Giải mã prompt ngắn, token/s | Giải mã prompt dài, token/s | Prefill prompt trung bình, token/s | Token đầu tiên với prompt dài, giây |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
Các mức ngắn, trung bình và dài lần lượt chứa 3,562, 31,566 và 128,478 token prompt. Mỗi ô là kết quả một lần chạy, không phải giá trị trung bình kèm khoảng tin cậy. Lần chạy IQ2_XS dùng bản tinh chỉnh Swift 1.5 được tài liệu hóa, nên đây không phải phép so sánh chỉ thay lượng tử hóa có kiểm soát với mô hình gốc. Các giá trị được chép từ ma trận kết quả đã công bố. Số đo ở định dạng máy đọc được
Trường hợp prompt dài của Q2_0 mất 62.48 giây trước khi có token đầu tiên, dù sau đó giải mã ở tốc độ 73.73 token/s. Với người đang đợi xử lý một tài liệu mới, phút đầu tiên ấy rất đáng kể. Trải nghiệm có thể khác khi tiếp tục hội thoại và tái sử dụng ngữ cảnh. Không nên để tuyên bố token mỗi giây tối đa che khuất khác biệt này.
Các số liệu hỗ trợ một kết luận hữu ích nhưng có phạm vi hẹp: trên máy tính để bàn cụ thể của tác giả, một số cấu hình lượng tử hóa được chọn đạt tốc độ tạo nội dung tương tác. Chúng không chứng minh kết quả tương tự trên máy có băng thông thấp hơn, bằng tiếng Việt, khi lấy mẫu lập luận, bật thị giác hay phục vụ nhiều người dùng đồng thời. Token không phải từ, và cách token hóa theo ngôn ngữ cũng khiến việc so sánh tùy tiện trở nên phức tạp.
Ngữ cảnh gốc 262,144 token của mô hình và các tuyên bố về ngữ cảnh mở rộng cũng không đảm bảo cấu hình Strata bạn chọn có thể phục vụ độ dài đó một cách thoải mái. Trạng thái runtime, vị trí bộ đệm và RAM còn trống vẫn quan trọng. Hãy bắt đầu nhỏ và chỉ tăng ngữ cảnh khi khối lượng công việc thực sự cần đến, vì ngữ cảnh dài hơn làm tăng độ trễ và mức dùng bộ nhớ.
Chất lượng và các tính năng “tăng tốc” cần được kiểm tra riêng
Nhà phát hành lượng tử hóa công bố các phép so sánh chất lượng hữu ích, nhưng chúng không phải benchmark Strata từ đầu đến cuối. Chẳng hạn, điểm LiveCodeBench v6 là 87.43 với BF16 và 81.14 với Q2_0. Đây là lý do để thử các tác vụ bạn quan tâm, không phải lý do tuyên bố mọi đầu ra ít bit đều không dùng được hoặc mọi biến thể là tương đương. Đánh giá lượng tử hóa đã công bố
Experimental Speed Projection cần được cân nhắc đặc biệt. Dự án mô tả đây là tính năng control vector tùy chọn làm thay đổi hành vi mô hình; nó không đơn thuần là tối ưu số học vô hình. Hãy tắt tính năng này ở cấu hình cơ sở và công bố rõ nếu dùng khi so sánh. Câu trả lời nhanh hơn do nội dung đã thay đổi không phải cùng phép đo với việc thực thi nhanh hơn một công việc tương đương. Chi tiết tính năng thử nghiệm
Khi tự đánh giá, hãy ghi lại commit kho mã, phiên bản engine, lượng tử hóa và bản tinh chỉnh, GPU và VRAM, CPU, tốc độ RAM, SSD, driver, cấu hình ngữ cảnh và các công tắc tính năng. Sau đó đo ít nhất ba prompt mới hoàn toàn và ba lượt tiếp nối có dùng bộ đệm; báo cáo trung vị cùng khoảng dao động thay vì chọn lần chạy tốt nhất. Ghi số token prompt và đầu ra cùng thời gian đến token đầu tiên, tốc độ giải mã và tổng thời gian hoàn tất.
Kết hợp kiểm tra tốc độ với kiểm tra tính đúng đắn theo từng tác vụ: biên dịch và kiểm thử câu trả lời lập trình, đối chiếu câu trả lời về tài liệu với nguồn, đồng thời xác minh ngôn ngữ và thuật ngữ của đầu ra đa ngôn ngữ. Ghi lại lỗi, timeout và tình trạng cạn bộ nhớ bên cạnh các lượt chạy thành công.
Chạy cục bộ thay đổi quyền kiểm soát, không loại bỏ mọi rủi ro bảo mật
Giữ địa chỉ loopback mặc định. Đưa máy chủ mô hình cục bộ ra mạng LAN hoặc Internet làm thay đổi mô hình đe dọa, và API tương thích không mặc nhiên là dịch vụ có xác thực. Chính sách bảo mật Strata mô tả phạm vi bảo mật và cách bind cục bộ; chính sách không tuyên bố đã có kiểm toán bảo mật độc lập từ bên ngoài. Chính sách bảo mật Strata
Tạo nội dung cục bộ có thể giảm phụ thuộc vào nhà cung cấp suy luận lưu trữ, nhưng quyền riêng tư vẫn phụ thuộc vào toàn bộ quy trình. Log chat, ứng dụng client, tìm kiếm web, công cụ bên ngoài và bản sao lưu có thể gửi hoặc lưu dữ liệu ngoài tiến trình mô hình. Hãy xem xét các đường đi đó trước khi đưa tài liệu mật vào agent. “Chạy cục bộ” là một đặc điểm kiến trúc hữu ích, không phải chứng nhận quyền riêng tư toàn diện.
Giấy phép cũng có nhiều lớp. Giấy phép mã nguồn Strata không thay thế điều khoản qwen-community-1.0 của mô hình. Trọng số đã lượng tử hóa không xóa nghĩa vụ gắn với mô hình gốc. Hãy đọc các giấy phép áp dụng trước khi phân phối lại hoặc triển khai thương mại, thay vì cho rằng kho mã mở đồng nghĩa với quyền sử dụng không hạn chế. Giấy phép mô hình Qwen
Hàm ý là một kiểu máy tính AI cá nhân khác
Hàm ý lớn nhất không phải suy luận trên đám mây đã lỗi thời. Máy tính để bàn vẫn có giới hạn về phục vụ đồng thời, độ trễ token đầu tiên, mức tiêu thụ năng lượng, bảo trì và chất lượng mô hình. Hệ thống lưu trữ có thể vẫn là lựa chọn tốt hơn khi tính sẵn sàng hoặc lưu lượng yêu cầu cao quan trọng hơn quyền kiểm soát môi trường thực thi.
Điều Strata gợi ra là suy luận trên thiết bị người dùng có thể bị giới hạn bởi khả năng điều phối nhiều không kém dung lượng GPU. Tận dụng CPU, RAM và truy cập lưu trữ thưa tốt hơn có thể mở khóa một nhóm mô hình mà phép tính đơn giản “mọi thứ đều nằm trên GPU” sẽ loại bỏ. Băng thông bộ nhớ hệ thống trở thành một phần của cấu hình máy tính AI, không còn là yếu tố nghĩ đến sau cùng.
Đó là suy luận rút ra từ kiến trúc và kết quả đã công bố, không phải bảo đảm cho mọi mô hình tương lai. Điều này phụ thuộc vào việc mô hình có các thành phần thưa, có thể lưu đệm hoặc thiên về tra cứu để runtime khai thác hay không. Mô hình đặc với kiểu truy cập khác sẽ không tự có cùng lợi thế chỉ vì có số tham số tương tự.
Với nhà nghiên cứu hoặc nhà phát triển cá nhân, bước tiếp theo thực tế là một thử nghiệm giới hạn: phiên bản đã ghim, ngữ cảnh ngắn, máy được hỗ trợ, một vài tác vụ đại diện và bản ghi trung thực về chất lượng/độ trễ. Cột mốc chỉ có ý nghĩa khi được mô tả đúng như vậy. Một mô hình rất lớn đã trở thành khối lượng công việc có thể cân nhắc trên máy để bàn nhờ phân bổ và kiểm tra cẩn thận, chứ không phải vì các giới hạn phần cứng biến mất.
Ghi lại quyết định thiết lập cùng ghi chú nghiên cứu
Khi so sánh các cấu hình AI cục bộ, hãy lưu chung liên kết nguồn, chi tiết phần cứng, quan sát và câu hỏi còn bỏ ngỏ. Telli.sh có thể giúp sắp xếp các ghi chú và bản tóm tắt đó mà không ngụ ý có tích hợp Strata sẵn. Tạo tài khoản Telli.sh