Strata กับ Qwen3.8-Flash-Next: โมเดลระดับ 180B รันบนพีซีส่วนบุคคลได้อย่างไร
คู่มือที่ตรวจสอบแหล่งข้อมูลแล้วเกี่ยวกับสถาปัตยกรรมของ Strata การตั้งค่าบน Windows และ Linux เส้นทางทดลองแยกต่างหากสำหรับ Mac Apple Silicon ผลทดสอบที่เผยแพร่ และข้อจำกัดของ AI ในเครื่อง
การรันโมเดลที่มีพารามิเตอร์ราว 180 พันล้านตัวบนเดสก์ท็อปที่มีการ์ดจอ 12 GB ฟังดูขัดแย้งกัน Strata ทำให้แนวคิดนี้มีความเป็นไปได้ แต่ไม่ใช่ด้วยการบีบพารามิเตอร์ทุกตัวให้ลงไปอยู่ในการ์ดจอ ความสำเร็จที่น่าสนใจกว่าคือการทำให้ส่วนต่าง ๆ ของโมเดลแบบ sparse ใช้หน่วยความจำและการประมวลผลคนละชนิดกัน โดยไม่ทำให้ทุกโทเค็นที่สร้างขึ้นกลายเป็นคอขวดจากการถ่ายโอนข้อมูล
ชื่อโมเดลอย่างเป็นทางการคือ Qwen3.8-Flash-Next ไม่ใช่ Qwen3.8-Next-Flash Qwen ระบุแกนหลักที่มีพารามิเตอร์ 125B และเปิดใช้งาน 6B พร้อมส่วนประกอบ n-gram embedding เพิ่มอีก 51B และ multi-token prediction 4B ยอดรวมโดยประมาณที่ 180B หมายถึงส่วนประกอบที่จัดเก็บไว้ ไม่ใช่ปริมาณการคำนวณแบบ dense ที่ทำกับทุกโทเค็น การ์ดโมเดล Qwen
รายละเอียดการตั้งค่าและประสิทธิภาพด้านล่างอ้างอิง Strata รุ่น fb58e0dbc8399662c0e47c76578c6e878b14f6cf ตัวเลข benchmark เป็นผลวัดที่โครงการเผยแพร่ ฮาร์ดแวร์ พรอมป์ต์ บริบท และรุ่นย่อยของโมเดลที่คุณใช้ อาจให้ผลต่างออกไป
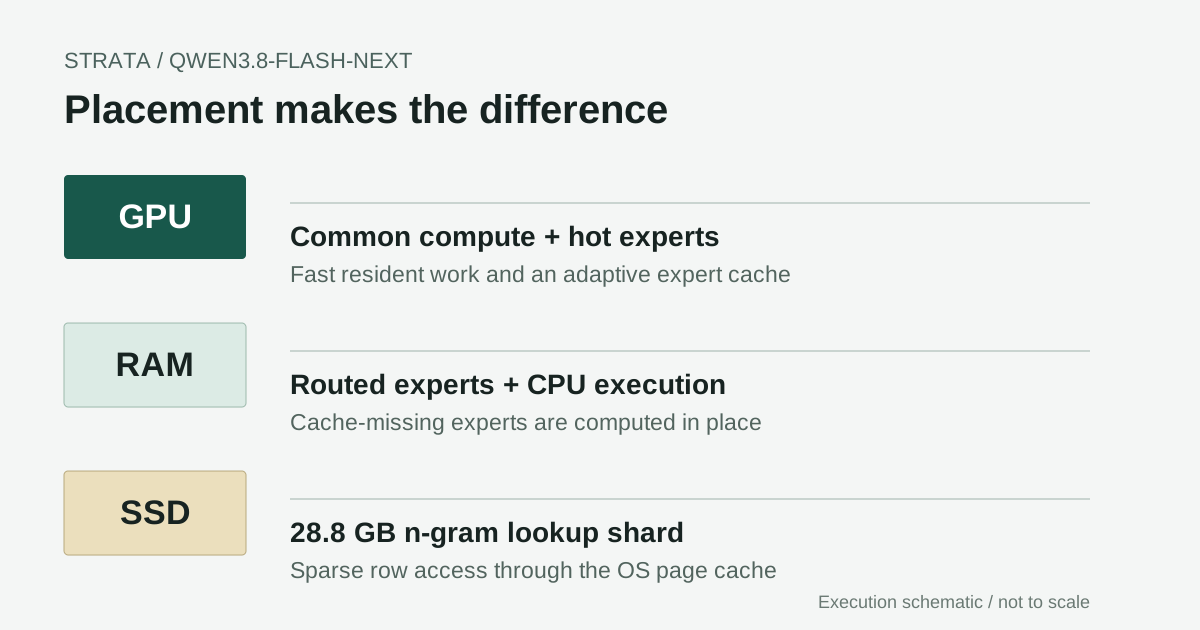
แผนภาพต้นฉบับอ้างอิงการออกแบบการทำงานตามเอกสารประกอบ สัดส่วนของแต่ละชั้นไม่ได้แสดงตามขนาดจริง: ขนาดดาวน์โหลด การใช้ RAM และการอยู่ในหน่วยความจำ GPU เป็นคนละปริมาณกัน
จุดเปลี่ยนสำคัญคือการจัดวาง ไม่ใช่การย่อโมเดล
มีสามคำถามที่ควรถามกับโมเดลในเครื่องขนาดใหญ่อย่างผิดปกติ: ต้องจัดเก็บเท่าไร มีส่วนใดทำงานอยู่กับโทเค็นหนึ่งตัว และงานที่กำลังทำอยู่ประมวลผลที่ไหน ตัวเลขพารามิเตอร์ที่ทำงานอยู่เพียงอย่างเดียวตอบแค่คำถามข้อสอง แต่ไม่ได้ทำให้ข้อกำหนดในการเก็บน้ำหนักส่วนที่เหลือไว้ในที่ที่เข้าถึงได้หายไป
Strata คือเอนจินอนุมานและแอปพลิเคชันให้บริการโมเดลในเครื่องที่ชุมชนพัฒนาขึ้นในรีโพซิทอรี Niko1221 การตั้งค่าตามเอกสารรองรับการติดตั้งบน Windows และ Linux มีอินเทอร์เฟซแชตในเครื่อง API ที่เข้ากันได้ และตัวเลือกรับภาพ นี่เป็นโครงการชุมชนแยกต่างหาก ไม่ใช่ผลิตภัณฑ์เดสก์ท็อปอย่างเป็นทางการของ Qwen รีโพซิทอรี Strata
การเปลี่ยนมุมคิดทางวิศวกรรมที่มีประโยชน์คือเลิกมองพีซีว่าเป็นเพียง GPU ที่มีหน่วยความจำไม่พอ เดสก์ท็อปยังมี RAM ของระบบ ชุดคำสั่งเวกเตอร์ของ CPU และ page cache ของระบบปฏิบัติการ ทรัพยากรเหล่านี้ช้ากว่าหน่วยความจำ GPU สำหรับงานบางชนิด แต่ไม่ได้แปลว่าไม่เหมาะกับงานทุกชนิดเท่ากัน การค้นหาตารางขนาดใหญ่กับการคูณเมทริกซ์แบบ dense ไม่จำเป็นต้องใช้นโยบายจัดวางแบบเดียวกัน
ความแตกต่างนี้ทำให้ประเด็นหลักน่าสนใจ โมเดลยังคงมีขนาดใหญ่ แต่ runtime ปรับว่าส่วนใดจำเป็นต้องอยู่ในหน่วยความจำที่เร็วที่สุดในแต่ละช่วงเวลาอย่างไร จึงเปิดทางให้อนุมานในเครื่องได้จริง โดยไม่ได้พิสูจน์ว่าแล็ปท็อปทั่วไปทุกเครื่องจะรันได้ดี
สถาปัตยกรรมแบบ sparse เปิดโอกาสนี้
สถาปัตยกรรมของ Qwen ผสานบล็อก Gated DeltaNet ในลักษณะคล้าย recurrent เข้ากับ Qwen Sparse Attention, routed experts และ n-gram embeddings รายงานทางเทคนิคอธิบายเหตุผลที่ออกแบบส่วนประกอบเหล่านี้เพื่อขยายขนาดอย่างมีประสิทธิภาพยิ่งขึ้น Strata ไม่ได้คิดค้นส่วนประกอบของโมเดลเหล่านี้ แต่สร้างกลยุทธ์การทำงานให้สอดคล้องกับรูปแบบการเข้าถึงข้อมูลที่แตกต่างกัน รายงานสถาปัตยกรรม Qwen
รายละเอียดการ routing มีความสำคัญ แต่ละชั้นจากทั้งหมด 48 ชั้นมี routed experts 512 ตัว โดย เปิดใช้ routed experts 10 ตัวต่อชั้น พร้อมกับ shared expert อีกหนึ่งตัว นั่นหมายความว่ามี routed experts จัดเก็บอยู่ทั้งหมด 24,576 ตัวตลอดทุกชั้น แต่ ไม่ได้ หมายความว่าจะใช้เพียง 10 ตัวจาก 24,576 ตัวนั้นในโมเดลทั้งหมดสำหรับโทเค็นหนึ่งตัว การตั้งค่าสถาปัตยกรรม Qwen
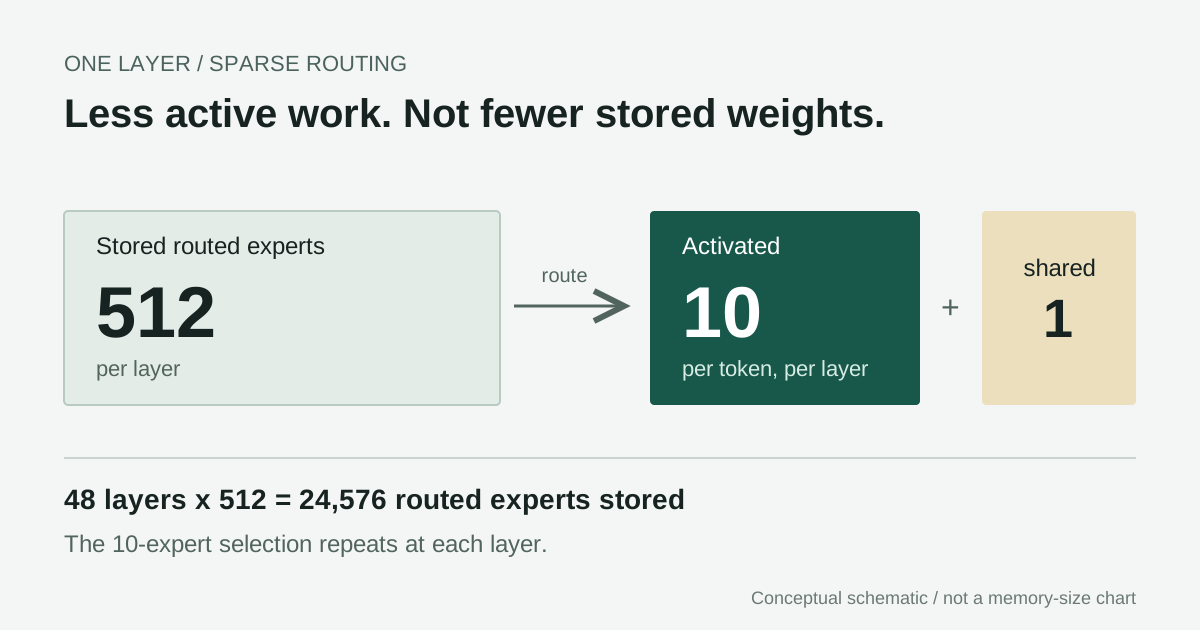
การเลือกช่วยลดงานที่ต้องทำ ไม่ได้ลดรายการที่ต้องจัดเก็บ แผนภาพนี้แสดงหนึ่งชั้น ไม่ใช่โมเดลทั้ง 48 ชั้น
ลองพิจารณาผลที่ตามมาโดยไม่ต้องอาศัยคำกล่าวอ้างเรื่องความเร็ว หากแทบไม่มีการเลือกใช้ expert บางตัว การยึดพื้นที่หน่วยความจำ accelerator ราคาแพงไว้กับ expert นั้นตลอดเวลาอาจเป็นการใช้ความจุที่ไม่คุ้ม หากมีการใช้ส่วนประกอบอื่นในทุกขั้นตอน การย้ายส่วนประกอบนั้นซ้ำ ๆ ก็มีแนวโน้มจะสิ้นเปลือง Scheduler ที่ดีต้องแยกแยะกรณีเหล่านี้ และจัดการ cache miss ที่หลีกเลี่ยงไม่ได้
นี่จึงเป็นเหตุผลที่ไม่ควรเปรียบโมเดลระดับ 180B แบบ sparse กับโมเดล 180B แบบ dense โดยดูแค่จำนวนพารามิเตอร์ ในทางกลับกัน การเรียกมันว่า “โมเดล 6B” ก็ละเลยข้อกำหนดด้านการจัดเก็บ การ routing สถานะบริบท และต้นทุนการเข้าถึงน้ำหนักที่กระจายอยู่ ทั้งสองวิธีทำให้ปัญหาทางวิศวกรรมที่แท้จริงคลุมเครือ
GPU, RAM และ SSD ทำงานคนละอย่าง
ตามโครงสร้างพื้นฐานในเอกสาร GPU เก็บงานคำนวณที่ใช้บ่อยและ cache ของ routed experts ที่มีการใช้งานบ่อย RAM ของระบบเก็บน้ำหนัก routed experts ส่วน CPU ประมวลผล expert ที่ไม่อยู่ใน GPU cache โดยตรง อีกส่วนหนึ่ง ตาราง n-gram ซึ่งทำ memory mapping ไว้จะอยู่บน SSD และส่งแถวที่ต้องการผ่าน cache ของระบบปฏิบัติการ ภาพรวมการทำงานของ Strata
เส้นทาง CPU นี้สำคัญกว่าคำว่า “offload” แบบกว้าง ๆ ที่ชวนให้เข้าใจ ระหว่างการถอดรหัส เมื่อเกิด cache miss ไม่จำเป็นต้องคัดลอก expert ที่ขาดไปยัง GPU ทั้งหมดก่อนจึงจะทำงานต่อได้ งานของ CPU และ GPU สามารถซ้อนทับกันได้ ข้อแลกเปลี่ยนคือความสามารถของ CPU และแบนด์วิดท์หน่วยความจำระบบมีผลต่อความเร็วในการสร้างข้อความโดยตรง
ส่วนประกอบ n-gram มีรูปแบบการเข้าถึงข้อมูลที่ต่างออกไปอีก การค้นหาไม่กี่แถวไม่เหมือนกับการสแกนทั้งตาราง การเก็บ shard สำหรับ lookup ที่ควอนไทซ์แล้วขนาด 28.8 GB ไว้บน SSD จึงทำได้จริง โดยไม่ได้หมายความว่าโมเดลทั้งชุดถูกอ่านจากดิสก์สำหรับทุกโทเค็นที่สร้างขึ้น อย่างไรก็ตาม ไดรฟ์ที่ช้าหรือ page cache ที่มีแรงกดดันสูงก็ยังทำให้การตอบสนองช้าลงได้
ขั้นตอน prefill ก็แตกต่างจากการถอดรหัสเช่นกัน การประมวลผลพรอมป์ต์เริ่มต้นเปิดโอกาสให้ใช้ batch ที่ใหญ่ขึ้นและซ้อนทับการย้าย expert กับงานในชั้นอื่นได้ การสร้างโทเค็นถัดไปซ้ำ ๆ ไวต่อความหน่วง เอกสารรายละเอียดของโครงการอธิบาย kernel, scheduling และพฤติกรรม cache แยกกันสำหรับแต่ละช่วง ตัวเลข throughput เพียงค่าเดียวสรุปทุกอย่างไม่ได้ รายละเอียดการทำงานของ Strata
ในมุมมองของเรา นวัตกรรมอยู่ที่การประสานทั้งระบบ ไม่ใช่กลเม็ดบีบอัดเพียงอย่างเดียว การควอนไทซ์ลดขนาดพื้นที่เก็บน้ำหนัก การทำ cache ลดการเข้าถึงน้ำหนักที่กำลังใช้งานซ้ำ การประมวลผลบน CPU จัดการ cache miss และการค้นหาแบบ sparse ช่วยเลี่ยงการโหลดตารางขนาดมหึมาทั้งหมด หากขาดข้อได้เปรียบข้อใดไป เดสก์ท็อปหน่วยความจำไม่มากก็จะเป็นเครื่องรันที่น่าเชื่อน้อยลงมาก
การคาดการณ์ช่วยลดงานได้เมื่อการตรวจสอบยอมรับ
Strata ยังใช้ส่วน multi-token prediction ของโมเดลเพื่อเสนอข้อความต่อเนื่องสั้น ๆ แล้วตรวจสอบด้วยโมเดลเป้าหมาย แทนที่จะเสียค่าใช้จ่ายกับการประมวลผลโมเดลเป้าหมายเต็มรอบสำหรับทุกโทเค็นที่ส่งออกแยกกัน draft ที่สำเร็จอาจทำให้รอบนั้นยอมรับหลายโทเค็นได้ รีโพซิทอรีระบุว่าเส้นทาง MTP สร้าง draft ได้สูงสุดสามโทเค็น การออกแบบและการทำงานของ MTP
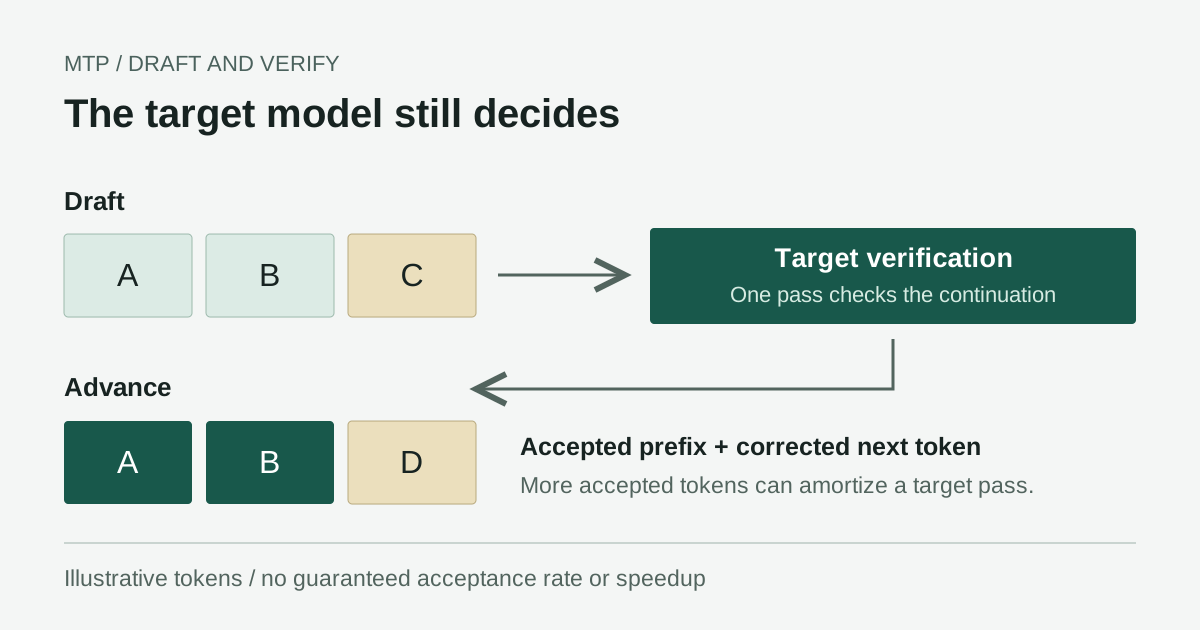
ตัวอย่างนี้แสดงกระบวนการตรวจสอบ ไม่ได้รับประกันอัตราการยอมรับหรือความเร็วที่เพิ่มขึ้นตามค่าที่วัดได้
นี่คือการเร่งความเร็วแบบมีเงื่อนไข โค้ดที่คาดเดาได้หรือข้อความซ้ำอาจสร้าง draft ได้ง่ายกว่าช่วงเปลี่ยนผ่านของการให้เหตุผลที่ไม่คุ้นเคย ถ้อยคำในพรอมป์ต์ การสุ่ม ความยาวเอาต์พุต และรุ่นของโมเดล ล้วนเปลี่ยนอัตราการยอมรับได้ ดังนั้นไม่ควรคาดว่าตัวเลขเด่นที่วัดจากพรอมป์ต์หนึ่งจะอธิบายงานหรือภาษาอื่นได้
การตรวจสอบมุ่งไปที่โมเดลที่กำลังรันอยู่จริง ไม่ได้กู้คืนข้อมูลที่สูญเสียไปจากการควอนไทซ์ และไม่ได้ยืนยันว่าเทียบเท่ากับน้ำหนัก BF16 ต้นฉบับ การแยกประเด็นสองอย่างนี้ออกจากกันสำคัญมาก: speculative execution กับคุณภาพของโมเดลความแม่นยำต่ำตอบคำถามคนละข้อ
อีกประเด็นหนึ่งคือการนำ cache กลับมาใช้ คำนำหน้าบทสนทนาที่ไม่เปลี่ยนแปลงอาจช่วยประหยัดงานซ้ำ แต่การถามต่อโดยมีบริบทที่อุ่นแล้วกับพรอมป์ต์ยาวใหม่เอี่ยมไม่ใช่การทดสอบแบบเดียวกัน ระบุว่ามีการใช้คำนำหน้าซ้ำหรือไม่เมื่อเปรียบเทียบผลในเครื่อง โครงการอธิบายการทำ cache ตามขอบเขตข้อความไว้อย่างชัดเจน พฤติกรรม prefix cache
“GPU 12 GB” ไม่ได้แปลว่าติดตั้งแค่ 12 GB
ไฟล์ GGUF แบบควอนไทซ์ที่เผยแพร่จะแบ่งเป็น shard หลักและ shard n-gram ขนาดคงที่ 28.8 GB ขนาดไฟล์ด้านล่างเป็น GB ฐานสิบและหมายถึงขนาดดาวน์โหลด ไม่ใช่ข้อกำหนดหน่วยความจำ GPU โปรเจกเตอร์ vision ซึ่งเป็นตัวเลือกเพิ่มขนาดราว 0.91 GB และการดาวน์โหลดเสริมกับไฟล์ชั่วคราวระหว่างแปลงต้องใช้พื้นที่เพิ่ม ไฟล์ quantization ของ ISTA-DASLab
| รุ่น | บิตเฉลี่ยต่อ weight ของแกนหลัก | Shard หลัก | Shard n-gram | ดาวน์โหลดรวม |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
ชื่อฟอร์แมตไม่ได้อธิบาย tensor ทุกตัวได้อย่างแม่นยำ shard หลักใช้ฟอร์แมตผสม ส่วน shard n-gram ใช้ IQ4_NL คำว่า “โมเดลสองบิต” เป็นคำย่อที่สะดวก แต่ชวนให้เข้าใจผิดหากหมายความว่าการดาวน์โหลดทั้งชุดใช้สองบิตต่อพารามิเตอร์อย่างพอดี วิธีการ quantization
สำหรับการทดลองโมเดลเต็มครั้งแรก GPU ที่รองรับขนาดตั้งแต่ 12 GB ขึ้นไปและ RAM ระบบ 64 GB เป็นฐานวางแผนที่น่าเชื่อถือกว่าการดูแค่ตัวเลข GPU รีโพซิทอรียังกล่าวถึงเส้นทางที่ใช้ RAM น้อยลงและรุ่น Coder ที่ prune แล้ว นั่นเป็นการตั้งค่าอีกแบบ ไม่ใช่หลักฐานว่าเครื่อง 32 GB จะให้ประสบการณ์โมเดลเต็มแบบเดียวกัน การเลือกโมเดลของ Strata
เราขอแนะนำให้กันพื้นที่ SSD ว่างไว้ 100-150 GB ก่อนเริ่มทดลอง นี่คือเผื่อพื้นที่อย่างระมัดระวัง ไม่ใช่ข้อกำหนดตายตัวจากผู้ผลิต เพราะยอดจริงขึ้นกับ quantization ที่เลือก ตัวช่วย MTP ไฟล์ vision ซึ่งเป็นตัวเลือก และ cache สำหรับ build/แปลงข้อมูล เส้นทางปรับประสิทธิภาพ CPU บางแบบสำหรับ Q2 อาจต้องใช้สำเนา expert เพิ่มเติมจำนวนมาก ตรวจสอบเส้นทางที่เลือก อย่าคิดว่ามีตัวเลขพื้นที่ดิสก์เดียวที่ใช้ได้กับทุกกรณี
ก่อนเลือกฮาร์ดแวร์ ให้กำหนดการตั้งค่าที่ต้องการ: โมเดลเต็มหรือรุ่น prune บริบทสั้นหรือยาว รองรับภาพหรือข้อความอย่างเดียว และต้องการ throughput ต่อเนื่องหรือใช้งานเป็นครั้งคราว ตัวเลือกเหล่านี้เปลี่ยนตำแหน่งของคอขวด และ benchmark ด้านล่างแสดงผลจากระบบหนึ่งแบบโดยเฉพาะ
ปักหมุดรุ่นพื้นฐานก่อนปรับแต่ง
เส้นทางมาตรฐานตามเอกสารรองรับ Windows 10/11 และ Ubuntu 22.04/24.04 พร้อม GPU NVIDIA และ AMD บางรุ่นที่รองรับ คำแนะนำ NVIDIA ระบุไดรเวอร์ 580 หรือใหม่กว่า macOS และ backend อื่นที่ build จากซอร์สมีข้อกำหนดแยกต่างหาก คำสั่งด้านล่างไม่ใช่วิธีติดตั้งที่ใช้ได้กับทุกแพลตฟอร์ม คู่มือติดตั้งอย่างเป็นทางการ
บน Windows ให้ตรวจสอบก่อนดาวน์โหลด
ติดตั้ง Git จากแหล่งแจกจ่ายอย่างเป็นทางการหากยังไม่มี ใน PowerShell ให้ clone รีโพซิทอรีต้นทางและปักหมุด revision ที่ทบทวนในบทความนี้:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
การตรวจสอบนี้ไม่ดาวน์โหลดโมเดลขนาดใหญ่ แต่ launcher อาจ bootstrap Python และสภาพแวดล้อมส่วนตัว พฤติกรรมการตรวจสอบการตั้งค่า
อ่านรายงานฮาร์ดแวร์ ตรวจสคริปต์ตั้งค่า และยืนยันพื้นที่ว่างก่อนดำเนินการ จากนั้นเริ่มการตั้งค่าแบบโต้ตอบ:
.\START-HERE.bat
สำหรับการทดลองเริ่มต้นบนเครื่อง RAM 64 GB นั้น IQ2_XS เป็นจุดเริ่มต้นที่เหมาะสมจากตัวเลือกในเอกสาร ใช้บริบท 32,768 โทเค็น เลือกข้อความอย่างเดียว และปิด Experimental Speed Projection ไว้ การเริ่มจากฐานที่เล็กกว่าช่วยแยกสาเหตุของปัญหาได้ง่ายกว่าการเปิดบริบทสูงสุด vision และการปรับแต่งทุกอย่างตั้งแต่แรก
คาดว่าจะมีการดาวน์โหลดและติดตั้ง dependency ไม่ใช่ไฟล์ปฏิบัติการขนาดเล็กที่รวมทุกอย่างไว้ในตัว เส้นทาง GPU อาจใช้เอนจินที่เตรียมไว้แล้วหรือเครื่องมือ build โปรดตรวจสอบคำขอเกี่ยวกับไดรเวอร์ compiler หรือสิทธิ์ผู้ดูแลระบบ อย่าปิดโปรแกรมป้องกันไวรัสหรือการป้องกันของเบราว์เซอร์เพื่อบังคับให้ติดตั้งผ่าน ดาวน์โหลดไดรเวอร์ที่จำเป็นจากผู้ผลิตฮาร์ดแวร์
การเปิดใช้ครั้งต่อไปใช้ launcher เดิม หากต้องการกลับไปตั้งค่าใหม่หรือหลีกเลี่ยงพอร์ตที่ชนกัน:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
บน Ubuntu ให้ใช้สคริปต์ตั้งค่าตามเอกสาร
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
เลือก backend ให้ตรงกับ GPU เส้นทาง ROCm ของ AMD และ CUDA ของ NVIDIA ใช้แทนกันไม่ได้ ให้ถือว่าคำขอติดตั้งจาก package manager หรือ compiler เป็นการเปลี่ยนแปลงในเครื่องของคุณซึ่งต้องตรวจสอบก่อน revision ที่ปักหมุดช่วยให้ทำซ้ำตามบทความได้ รุ่นใหม่อาจเพิ่มการรองรับ โปรดอ่าน release notes ก่อนตัดสินใจอัปเกรด
ตรวจสอบให้ได้คำตอบก่อนเชื่อมต่อ agent
เมื่อโหลดเสร็จแล้ว เปิด http://127.0.0.1:8080 ในเบราว์เซอร์ภายในเครื่อง หรือใช้พอร์ตสำรองที่เลือกไว้ ส่งคำถามสั้น ๆ ที่ไม่มีข้อมูลละเอียดอ่อนและตรวจว่าระบบตอบจนจบ จากนั้นค่อยลองพรอมป์ต์ยาวขึ้น การใช้ cache ซ้ำในคำถามต่อเนื่อง และภาษาที่ต้องการ ดูการใช้หน่วยความจำและบันทึกของเซิร์ฟเวอร์ระหว่างโหลดครั้งแรก
API ที่เข้ากันได้ตามเอกสารประกอบมี GET /v1/models และ POST /v1/chat/completions ให้ค้นพบรหัสโมเดลที่กำลังให้บริการ แทนการคัดลอกชื่อเรียกที่คาดเดาไปใส่ในไคลเอนต์อื่น:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
ใช้รหัสที่ระบบส่งกลับเมื่อตั้งค่าไคลเอนต์ที่เข้ากันได้ การเรียกรายการโมเดลสำเร็จยืนยันเพียงว่าค้นพบโมเดล ไม่ได้ยืนยันคุณภาพการสร้างข้อความ การได้รับคำตอบแชตจนจบต่างหากคือการตรวจสอบแรกที่มีความหมาย ปิดเครื่องมือ agent ที่เขียนไฟล์หรือรัน shell ไว้ในระหว่างการทดสอบเริ่มต้นนี้
หากการ์ดหน่วยความจำไม่พอ ให้ลดบริบทและปิด vision ก่อน หากโปรเซสถูกปิดหรือเครื่อง swap หนัก ให้ตรวจ RAM ระบบ ไม่ใช่ดูแค่ VRAM หากขาดไลบรารี runtime ให้ดูคำแนะนำเฉพาะ backend แทนการติดตั้ง DLL ที่ไม่ทราบที่มา โครงการมีคำแนะนำแยกตามอาการ การแก้ปัญหา Strata
บน Mac ให้แยกการรองรับโมเดลออกจากการรองรับ Strata
Apple Silicon ใช้หน่วยความจำแบบ unified แทนการแยก GPU VRAM กับ RAM ระบบแบบใน benchmark เดสก์ท็อป ตัวติดตั้ง Strata รุ่นที่ปักหมุดไว้ไม่มีเอกสารระบุเส้นทาง macOS ที่รองรับ และคำขอรองรับ Mac ก็ไม่ได้แปลว่าการพอร์ตเสร็จสมบูรณ์แล้ว คำขอรองรับ Mac ใน upstream
การทดลองที่ผู้ใช้ Mac อาจหมายถึงมีอยู่สองแบบที่ต่างกัน community fork ชื่อ Strata-macOS คงอินเทอร์เฟซและ Python API ไว้ พร้อม backend Metal สำหรับ โมเดล GGUF ขนาดเล็กกว่า การตรวจสอบตามเอกสารใช้ Qwen2.5 ไม่ใช่การตั้งค่า Flash-Next ต้นฉบับ และ fork นี้ระบุชัดว่าไม่ได้ย้าย CUDA expert streaming หรือเส้นทาง MTP ของ Strata อย่ามอง fork นี้เป็นการติดตั้งโมเดลที่กล่าวถึงในบทความได้ในคลิกเดียว ขอบเขตของ community fork
สำหรับ Qwen3.8-Flash-Next โดยเฉพาะ อีกเส้นทางทดลองหนึ่งคือ build llama.cpp ที่เข้ากันได้กับ Metal พร้อมไฟล์ GGUF แบบแยก shard จากผู้เผยแพร่ นี่ไม่ใช่ Strata บน Mac และตารางความเร็วของ Windows ด้านล่างใช้กับเส้นทางนี้ไม่ได้
Build runtime Metal แยกต่างหาก
ใช้ Mac ที่เป็น Apple Silicon, เทอร์มินัล native ARM64, เครื่องมือ command-line developer ของ Apple, Git และ CMake หากไม่มี CMake ให้ติดตั้งจากแหล่งแจกจ่ายอย่างเป็นทางการหรือ package manager ที่เชื่อถือได้ เอกสาร build ของ llama.cpp ที่ทบทวนระบุว่า macOS เปิดใช้ Metal เป็นค่าเริ่มต้น การปักหมุดเอนจินยังช่วยป้องกันไม่ให้ branch ที่เปลี่ยนแปลงอยู่เสมอทำให้ตัวอย่างเปลี่ยนไปโดยไม่รู้ตัว คำแนะนำ build Metal ของ llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
ดาวน์โหลด shard IQ2_XS ทั้งสองไฟล์ จากรายการไฟล์ของผู้เผยแพร่ลงในไดเรกทอรีเดียวกัน และคงชื่อไฟล์เดิมไว้ ต้องมี shard ที่สองแม้แถว lookup ของมันจะยังอยู่บนดิสก์ แทนที่พาธโมเดลตัวอย่างด้านล่างด้วยพาธจริงของ shard แรกบน Mac:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
ผู้เผยแพร่ระบุการโหลดหลายไฟล์และแฟล็ก mmap/lazy ในเอกสาร ส่วนเอนจินรุ่นที่ทบทวนมีตัวเลือกเหล่านี้ ช่วยให้ตาราง n-gram พร้อมใช้งานเมื่อร้องขอ โดยไม่ต้องเก็บทั้งหมดในหน่วยความจำ ตัวเลือกเหล่านี้เป็น ออปชันของ llama.cpp ไม่ใช่ออปชันของ launcher Strata ตัวอย่างการโหลด GGUF
ความจุยังคงสำคัญ: IQ2_XS มี shard หลักขนาด 39.2 GB ก่อนรวมสถานะ runtime และส่วนที่ macOS ใช้ ดังนั้น Mac ที่มีหน่วยความจำ 16 GB หรือ 24 GB จึงไม่ใช่ฐานที่น่าเชื่อถือสำหรับการให้โมเดลตัวอย่างนี้อยู่ในหน่วยความจำทั้งหมด แม้แต่ 64 GB ก็เป็นเพียงจุดตั้งต้นเพื่อวางแผน ไม่ใช่การรับประกันว่าจะผ่าน ตรวจสอบ memory pressure และ swap ใน Activity Monitor เริ่มจากบริบท 4K และหยุดหาก memory pressure ยังสูง อย่าเปลี่ยนขีดจำกัดหน่วยความจำ kernel เพื่อฝืนให้ผ่านเมื่อจัดสรรหน่วยความจำไม่พอ
ยืนยันว่าบันทึกแสดงการเลือก Metal และคำตอบแบบข้อความล้วนจบลงอย่างสมเหตุสมผลก่อนทดลองต่อ จากนั้นทดสอบพรอมป์ต์ที่ยาวขึ้นก่อนเพิ่ม speculative decoding หรือ vision เส้นทางนี้ไม่ครอบคลุม Mac Intel การประมวลผลกระจายข้าม Mac หลายเครื่อง หรือการแปลงเป็น MLX ที่นี่ไม่มีตัวเลข throughput ของ Mac; ผลลัพธ์ขึ้นอยู่กับรุ่นชิป ขนาด unified memory เอนจิน quantization และบริบทที่ใช้
ความเร็วที่เผยแพร่น่าสนใจ แต่เวลาได้โทเค็นแรกบอกอีกเรื่อง
เพื่อให้เปรียบเทียบได้ทำซ้ำได้ ตารางนี้ใช้ benchmark ของ เอนจิน 0.1.26 วันที่ 29 กันยายน 2026 แทนการนำตัวเลขพาดหัวจาก README ที่ใหม่กว่ามาปะปน เครื่องทดสอบใช้ RTX 5070 12 GB บน PCIe 5.0 x16, Ryzen 5 7600 หกคอร์, DDR5-5200 ขนาด 64 GB และ Windows 10 การทดสอบใช้ greedy generation เปิด MTP ปิดภาพ และสร้าง 256 โทเค็น เงื่อนไข benchmark
| รุ่น | ถอดรหัสพรอมป์ต์สั้น โทเค็น/วินาที | ถอดรหัสพรอมป์ต์ยาว โทเค็น/วินาที | Prefill พรอมป์ต์กลาง โทเค็น/วินาที | เวลาได้โทเค็นแรกของพรอมป์ต์ยาว วินาที |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
ระดับสั้น กลาง และยาวมีพรอมป์ต์ 3,562, 31,566 และ 128,478 โทเค็นตามลำดับ แต่ละช่องคือผลการรันหนึ่งครั้ง ไม่ใช่ค่าเฉลี่ยพร้อมช่วงความเชื่อมั่น การรัน IQ2_XS ใช้ fine-tune Swift 1.5 ตามที่ระบุไว้ จึงไม่ใช่การเปรียบเทียบแบบควบคุมที่เปลี่ยนเฉพาะ quantization กับโมเดลฐาน ค่าทั้งหมดคัดลอกจากเมทริกซ์ผลที่เผยแพร่ ค่าที่วัดในรูปแบบเครื่องอ่านได้
กรณีพรอมป์ต์ยาวของ Q2_0 ใช้เวลา 62.48 วินาทีก่อนโทเค็นแรก แม้หลังจากนั้นจะถอดรหัสได้ 73.73 โทเค็นต่อวินาที สำหรับผู้ใช้ที่รอเอกสารใหม่ เวลารอหนึ่งนาทีนี้สำคัญ ส่วนบทสนทนาต่อเนื่องที่นำบริบทกลับมาใช้ได้อาจให้ประสบการณ์ต่างออกไป ไม่ควรซ่อนความแตกต่างนี้ไว้หลังตัวเลขโทเค็นต่อวินาทีสูงสุด
ตัวเลขเหล่านี้สนับสนุนข้อสรุปที่จำกัดแต่มีประโยชน์: บนเดสก์ท็อปตามสเปกที่ผู้เขียนระบุ การตั้งค่า quantization บางแบบสร้างข้อความได้เร็วพอสำหรับการโต้ตอบ แต่ไม่ได้ยืนยันผลแบบเดียวกันบนเครื่องที่แบนด์วิดท์ต่ำกว่า ในภาษาเกาหลี การสุ่มให้เหตุผล เมื่อเปิด vision หรือเมื่อมีผู้ใช้พร้อมกัน โทเค็นไม่ใช่คำ และการแบ่งโทเค็นตามภาษาก็ทำให้การเปรียบเทียบแบบง่าย ๆ ซับซ้อนขึ้น
ขนาดบริบท native 262,144 โทเค็นของโมเดลและคำกล่าวอ้างเรื่องบริบทยาว ก็ไม่ได้รับประกันว่า Strata ที่คุณตั้งค่าจะให้บริการความยาวนั้นได้อย่างสบาย สถานะ runtime ตำแหน่งของ cache และ RAM ที่มีอยู่ยังสำคัญ เริ่มจากขนาดเล็กแล้วเพิ่มบริบทเมื่อภาระงานมีเหตุผลรองรับ โดยคำนึงถึงความหน่วงและหน่วยความจำที่เพิ่มขึ้น
ตรวจสอบคุณภาพและฟีเจอร์ “ความเร็ว” แยกจากกัน
ผู้เผยแพร่ quantization รายงานผลเปรียบเทียบคุณภาพที่มีประโยชน์ แต่ไม่ใช่ benchmark ของ Strata แบบครบวงจร ตัวอย่างเช่น คะแนน LiveCodeBench v6 คือ 87.43 สำหรับ BF16 และ 81.14 สำหรับ Q2_0 นี่เป็นเหตุผลให้ทดสอบงานที่คุณสนใจ ไม่ใช่เหตุผลให้สรุปว่าเอาต์พุต low-bit ทุกแบบใช้ไม่ได้ หรือทุกรุ่นเทียบเท่ากัน ผลประเมิน quantization ที่เผยแพร่
โปรดระมัดระวังเป็นพิเศษกับ Experimental Speed Projection โครงการอธิบายว่าฟีเจอร์ control-vector ที่เลือกเปิดได้จะเปลี่ยนพฤติกรรมของโมเดล ไม่ใช่เพียงการปรับคณิตศาสตร์เบื้องหลังที่มองไม่เห็น ให้ปิดไว้เป็นค่าพื้นฐาน และเปิดเผยหากใช้ในการเปรียบเทียบ คำตอบที่เร็วขึ้นเพราะเนื้อหาเปลี่ยนไป ไม่ใช่การวัดว่าใช้เวลาทำงานเท่าเดิมน้อยลง รายละเอียดฟีเจอร์ทดลอง
สำหรับการประเมินของคุณเอง ให้บันทึก commit ของรีโพซิทอรี เวอร์ชันเอนจิน quantization และ fine-tune รุ่น GPU และ VRAM, CPU, ความเร็ว RAM, SSD, ไดรเวอร์ การตั้งค่าบริบท และสวิตช์ฟีเจอร์ จากนั้นวัดพรอมป์ต์ใหม่อย่างน้อยสามรายการและคำถามต่อเนื่องที่ใช้ cache อย่างน้อยสามรายการ รายงานค่ามัธยฐานและช่วงแทนการเลือกผลที่ดีที่สุด พร้อมจำนวนโทเค็นของพรอมป์ต์และเอาต์พุต เวลาได้โทเค็นแรก อัตราถอดรหัส และเวลารวม
จับคู่การตรวจความเร็วกับการตรวจความถูกต้องตามงาน: คอมไพล์และทดสอบคำตอบด้านโค้ด เทียบคำตอบเกี่ยวกับเอกสารกับต้นฉบับ และตรวจภาษาและคำศัพท์ในเอาต์พุตหลายภาษา บันทึกความล้มเหลว timeout และหน่วยความจำไม่พอควบคู่กับรอบที่สำเร็จ
การรันในเครื่องเปลี่ยนการควบคุม แต่ไม่ได้ขจัดความเสี่ยงด้านความปลอดภัยทั้งหมด
คงค่าเริ่มต้นเป็น loopback การเปิดเซิร์ฟเวอร์โมเดลในเครื่องให้เข้าถึงได้จาก LAN หรืออินเทอร์เน็ตเปลี่ยนรูปแบบภัยคุกคาม และ API ที่เข้ากันได้ไม่ได้หมายความว่าเป็นบริการที่มีระบบยืนยันตัวตน นโยบายความปลอดภัยของ Strata อธิบายการ bind ในเครื่องและขอบเขตความปลอดภัย แต่ไม่ได้อ้างว่าผ่านการตรวจสอบความปลอดภัยอิสระจากภายนอก นโยบายความปลอดภัยของ Strata
การสร้างข้อความในเครื่องอาจลดการพึ่งพาผู้ให้บริการ inference บนโฮสต์ แต่ความเป็นส่วนตัวยังขึ้นกับ workflow ทั้งหมด บันทึกแชต แอปไคลเอนต์ การค้นหาเว็บ เครื่องมือภายนอก และข้อมูลสำรอง อาจส่งหรือเก็บข้อมูลไว้นอกโปรเซสโมเดล ตรวจสอบเส้นทางเหล่านี้ก่อนป้อนเอกสารลับเข้า agent “รันในเครื่อง” เป็นข้อเท็จจริงด้านสถาปัตยกรรมที่มีประโยชน์ ไม่ใช่ใบรับรองความเป็นส่วนตัวที่ครอบคลุมทุกด้าน
เรื่องใบอนุญาตก็มีหลายชั้นเช่นกัน ใบอนุญาตโค้ดของ Strata ไม่ได้ใช้แทนเงื่อนไข qwen-community-1.0 ของโมเดล น้ำหนักที่ควอนไทซ์ไม่ได้ลบข้อผูกพันที่ติดมากับโมเดลต้นฉบับ อ่านใบอนุญาตที่ใช้บังคับก่อนเผยแพร่ต่อหรือนำไปใช้เชิงพาณิชย์ อย่าสันนิษฐานว่ารีโพซิทอรีแบบเปิดหมายถึงใช้ได้โดยไม่มีข้อจำกัด ใบอนุญาตโมเดล Qwen
นัยสำคัญคือคอมพิวเตอร์ AI ส่วนบุคคลอีกแบบหนึ่ง
ข้อสรุปสำคัญที่สุดไม่ใช่ว่า inference บนคลาวด์ล้าสมัยแล้ว เดสก์ท็อปยังมีข้อจำกัดด้านการให้บริการพร้อมกัน เวลาได้โทเค็นแรก การใช้พลังงาน การดูแลรักษา และคุณภาพโมเดล ระบบโฮสต์ยังเป็นตัวเลือกที่ดีกว่าได้เมื่อความพร้อมใช้งานหรือปริมาณคำขอสูงสำคัญกว่าการควบคุมสภาพแวดล้อมการประมวลผล
สิ่งที่ Strata ชี้ให้เห็นคือ การประมวลผล AI ของผู้บริโภคอาจถูกจำกัดด้วยการประสานงานมากพอ ๆ กับความจุ GPU การใช้ CPU, RAM และการเข้าถึงพื้นที่จัดเก็บแบบ sparse ให้ดีขึ้นอาจปลดล็อกโมเดลกลุ่มหนึ่งที่การคำนวณแบบง่าย ๆ ว่าทุกอย่างต้องอยู่บน GPU จะตัดทิ้ง แบนด์วิดท์หน่วยความจำระบบจึงกลายเป็นส่วนหนึ่งของสเปกคอมพิวเตอร์ AI ไม่ใช่เรื่องที่คิดทีหลัง
นี่เป็นข้ออนุมานจากสถาปัตยกรรมและผลลัพธ์ที่เผยแพร่ ไม่ใช่คำรับประกันสำหรับโมเดลในอนาคตทุกตัว ทั้งหมดขึ้นกับการที่โมเดลเปิดให้ใช้ส่วนประกอบแบบ sparse ที่ทำ cache ได้ หรือมีรูปแบบการค้นหาที่ runtime นำไปใช้ประโยชน์ได้ โมเดล dense ที่มีรูปแบบการเข้าถึงข้อมูลต่างออกไปจะไม่ได้รับข้อได้เปรียบแบบเดียวกันเพียงเพราะมีจำนวนพารามิเตอร์ใกล้เคียงกัน
สำหรับนักวิจัยหรือนักพัฒนารายบุคคล ขั้นตอนถัดไปที่เป็นจริงได้คือการทดลองนำร่องในขอบเขตจำกัด: ปักหมุดเวอร์ชัน ใช้บริบทสั้น เครื่องที่รองรับ งานตัวแทนบางรายการ และบันทึกคุณภาพกับความหน่วงอย่างตรงไปตรงมา การอธิบายความคืบหน้าเช่นนี้ตามจริงทำให้ผลมีความหมาย โมเดลขนาดใหญ่มากกลายเป็นภาระงานเดสก์ท็อปที่เป็นไปได้ด้วยการจัดวางและตรวจสอบอย่างรอบคอบ ไม่ใช่เพราะข้อจำกัดด้านฮาร์ดแวร์หายไป
เก็บรายละเอียดการตั้งค่าไว้กับบันทึกงานวิจัย
เมื่อเปรียบเทียบการตั้งค่า AI ในเครื่อง ให้เก็บลิงก์แหล่งข้อมูล รายละเอียดฮาร์ดแวร์ ข้อสังเกต และคำถามที่ยังไม่มีคำตอบไว้ด้วยกัน Telli.sh ช่วยจัดระเบียบบันทึกและสรุปเหล่านั้นได้ โดยไม่ได้สื่อว่ามีการเชื่อมต่อกับ Strata ในตัว สร้างบัญชี Telli.sh