Strata dan Qwen3.8-Flash-Next: Cara Model Kelas 180B Berjalan pada PC Peribadi
Panduan berasaskan sumber tentang seni bina Strata, penyediaan Windows dan Linux, laluan Apple Silicon Mac yang berasingan, penanda aras yang diterbitkan dan batas AI setempat.
Model dengan kira-kira 180 bilion parameter yang berjalan pada komputer meja dengan kad grafik 12 GB kedengaran seperti percanggahan. Strata menjadikan kemungkinan itu munasabah, tetapi bukan dengan memadatkan setiap parameter ke dalam kad tersebut. Pencapaian yang lebih menarik ialah membolehkan bahagian-bahagian model sparse menggunakan jenis memori dan pengkomputeran yang berbeza tanpa menjadikan setiap token yang dijana sebagai kesesakan pemindahan data.
Nama rasmi model ini ialah Qwen3.8-Flash-Next, bukannya Qwen3.8-Next-Flash. Qwen menyenaraikan teras 125B parameter dengan 6B yang diaktifkan, komponen embedding n-gram tambahan 51B, dan 4B untuk ramalan berbilang token. Jumlah dibundarkan kepada 180B itu menerangkan komponen yang disimpan; ia bukan jumlah pengkomputeran dense bagi setiap token. Kad model Qwen
Butiran penyediaan dan prestasi di bawah merujuk pada revisi Strata fb58e0dbc8399662c0e47c76578c6e878b14f6cf. Angka penanda aras ialah ukuran yang diterbitkan oleh projek; hasil anda mungkin berbeza mengikut perkakasan, prompt, konteks dan varian model.
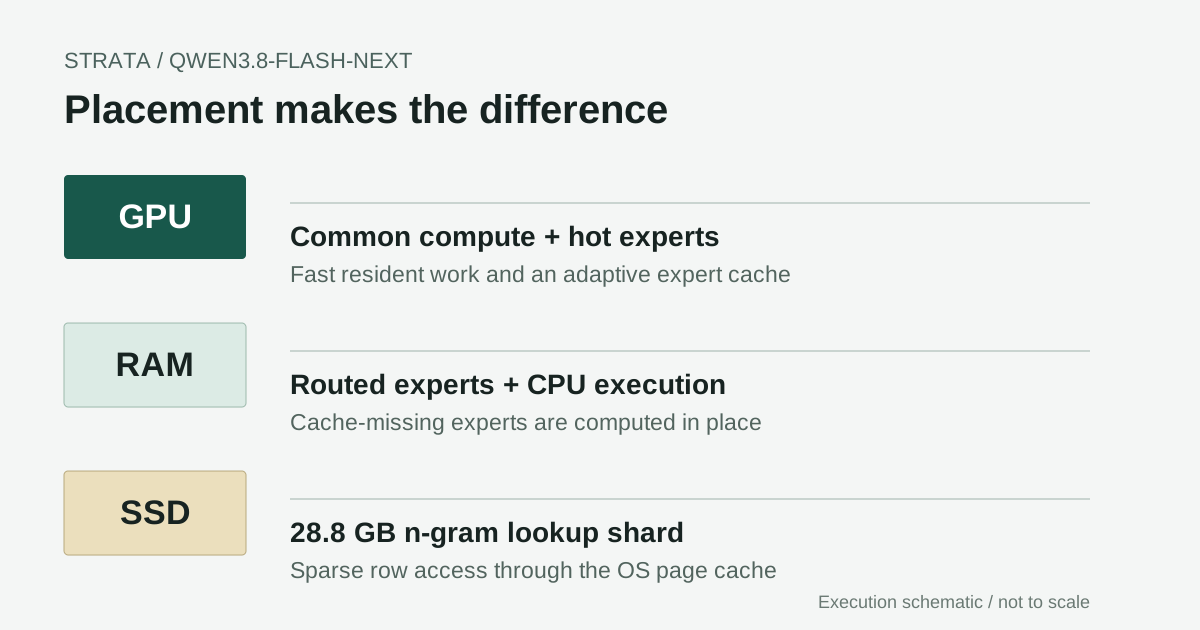
Skema asal berdasarkan reka bentuk pelaksanaan yang didokumenkan. Lapisan ini tidak dilukis mengikut skala: saiz muat turun, penggunaan RAM dan residensi GPU ialah kuantiti yang berbeza.
Penemuan utamanya ialah penempatan, bukannya model yang lebih kecil
Terdapat tiga soalan untuk setiap model setempat yang luar biasa besar: berapa banyak yang perlu disimpan, berapa banyak yang aktif bagi satu token, dan di mana kerja aktif itu dijalankan. Angka parameter aktif yang kecil hanya menjawab soalan kedua. Ia tidak menghapuskan keperluan untuk menyimpan baki pemberat di suatu tempat yang boleh dicapai.
Strata ialah enjin inferens dan aplikasi penyajian setempat yang dibangunkan komuniti dalam repositori Niko1221. Persediaan yang didokumenkan menyediakan pemasangan Windows dan Linux, antara muka sembang setempat, permukaan API yang serasi dan input imej pilihan. Ini projek komuniti yang berasingan, bukannya produk desktop rasmi Qwen. Repositori Strata
Perubahan kejuruteraan yang berguna ialah berhenti menganggap PC sebagai GPU yang kekurangan memori. Komputer meja juga mempunyai RAM sistem, unit vektor CPU dan cache halaman sistem pengendalian. Sumber ini lebih perlahan daripada memori GPU untuk sesetengah operasi, tetapi tidak sama-sama tidak sesuai untuk semua operasi. Carian jadual besar dan pendaraban matriks dense tidak memerlukan dasar penempatan yang sama.
Perbezaan inilah yang menjadikan dakwaan utama itu menarik. Modelnya kekal besar; runtime mengubah jumlah model yang perlu berada dalam memori terpantas pada sesuatu masa. Ini membuka laluan inferens setempat yang praktikal tanpa membuktikan bahawa setiap komputer riba biasa boleh menjalankannya dengan baik.
Seni bina sparse membuka peluang ini
Seni bina Qwen menggabungkan blok Gated DeltaNet gaya rekuren dengan Qwen Sparse Attention, routed expert dan embedding n-gram. Laporan teknikal menerangkan sebab komponen ini direka supaya boleh diskalakan dengan lebih cekap. Strata tidak mencipta komponen model tersebut; Strata membina strategi pelaksanaan berdasarkan corak aksesnya yang berbeza. Laporan seni bina Qwen
Butiran penghalaan itu penting. Setiap satu daripada 48 lapisan mempunyai 512 routed expert; 10 routed expert diaktifkan bagi setiap lapisan, bersama-sama satu shared expert. Ini bermakna 24,576 routed expert disimpan merentas semua lapisan. Ini tidak bermaksud hanya 10 daripada 24,576 expert itu digunakan di seluruh model bagi satu token. Konfigurasi seni bina Qwen
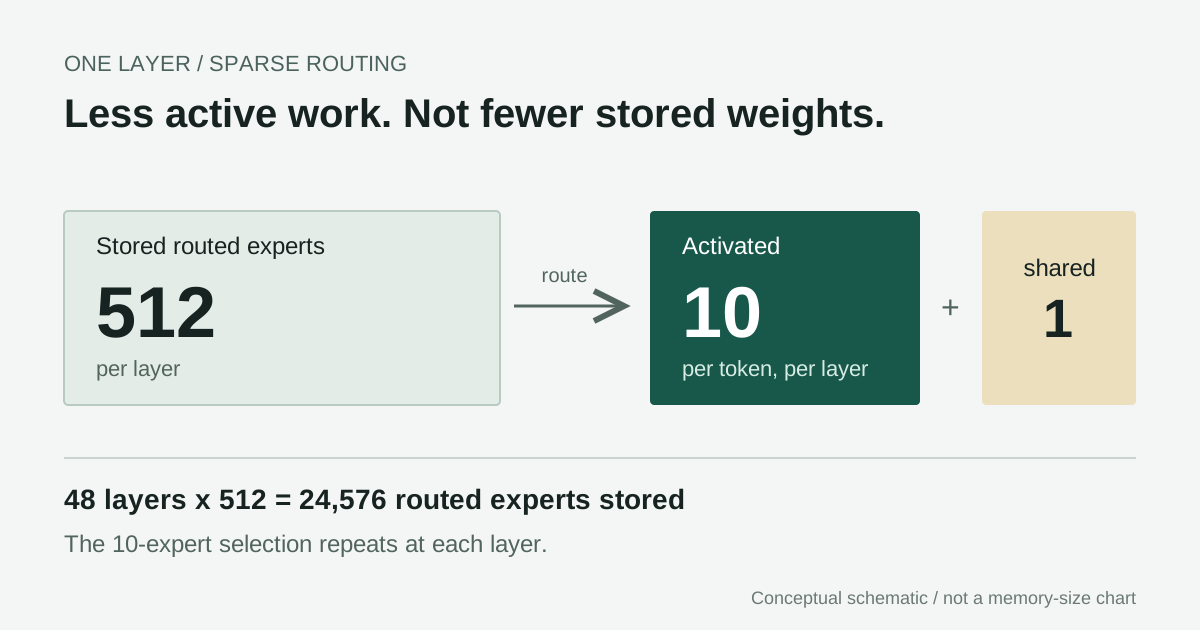
Pemilihan mengurangkan kerja aktif, bukan inventori yang disimpan. Rajah ini menggambarkan satu lapisan, bukannya keseluruhan model 48 lapisan.
Pertimbangkan akibatnya tanpa bergantung pada sebarang dakwaan kelajuan. Jika sesuatu expert jarang dipilih, meletakkannya secara kekal dalam memori pemecut yang mahal mungkin bukan penggunaan kapasiti yang baik. Jika komponen lain digunakan pada setiap langkah, memindahkannya berulang kali berkemungkinan mahal. Penjadual yang baik perlu membezakan keadaan ini, kemudian mengurus cache miss yang tidak dapat dielakkan.
Itulah juga sebabnya model sparse kelas 180B tidak patut dibandingkan dengan model dense 180B berdasarkan jumlah parameter semata-mata. Sebaliknya, menyebutnya "model 6B" menyembunyikan keperluan storan, penghalaan, keadaan konteks dan kos mengakses pemberat yang tersebar. Kedua-dua jalan pintas ini mengaburkan masalah kejuruteraan sebenar.
GPU, RAM dan SSD menjalankan tugas yang berbeza
Dalam garis dasar yang didokumenkan, GPU menyimpan pengkomputeran lazim dan cache routed expert yang kerap digunakan. RAM sistem menyimpan pemberat routed expert, dan CPU mengira expert yang tiada dalam cache GPU secara setempat. Jadual n-gram yang berasingan dipetakan ke memori dan kekal dalam SSD; baris yang diperlukan disediakan melalui cache sistem pengendalian. Gambaran keseluruhan pelaksanaan Strata
Laluan CPU itu lebih penting daripada label umum "offload". Semasa penyahkodan, cache miss tidak bermaksud setiap expert yang tiada perlu disalin ke GPU sebelum proses boleh diteruskan. Kerja CPU dan GPU boleh bertindih. Imbangannya ialah keupayaan CPU dan lebar jalur memori sistem kini mempengaruhi kelajuan output secara langsung.
Komponen n-gram pula mempunyai corak akses yang berbeza. Mendapatkan beberapa baris bukan beban kerja yang sama dengan mengimbas seluruh jadual. Oleh itu, shard carian terkuantasi 28.8 GB boleh dibiarkan dalam SSD tanpa membayangkan bahawa seluruh model dibaca dari cakera bagi setiap token yang dijana. Pemacu yang perlahan atau tekanan cache halaman yang tinggi masih boleh menjejaskan respons. Pemetaan fail dan cache halaman menyediakan bahagian yang diperlukan tanpa memindahkan seluruh jadual ke VRAM, sekali gus menjadikan SSD dan sistem pengendalian sebahagian daripada reka bentuk inferens.
Prefill juga berbeza daripada penyahkodan. Memproses prompt awal menyediakan kelompok yang lebih besar dan peluang untuk menindihkan pemindahan expert dengan kerja lapisan lain. Penjanaan token seterusnya secara berulang peka terhadap kependaman. Dokumentasi terperinci projek menerangkan kernel, penjadualan dan tingkah laku cache yang berbeza bagi fasa-fasa ini. Satu angka throughput tidak dapat merangkum kedua-duanya. Butiran pelaksanaan Strata
Penyahkodan spekulatif hanya menjimatkan kerja apabila pengesahan menerimanya
Strata juga menggunakan komponen ramalan berbilang token model untuk mencadangkan sambungan pendek dan mengesahkannya dengan model sasaran. Daripada membayar satu laluan penuh model sasaran bagi setiap token output, draf yang berjaya boleh membolehkan laluan itu menerima beberapa token sekali gus. Repositori menerangkan draf sehingga tiga token dalam laluan MTP-nya. Reka bentuk dan pelaksanaan MTP
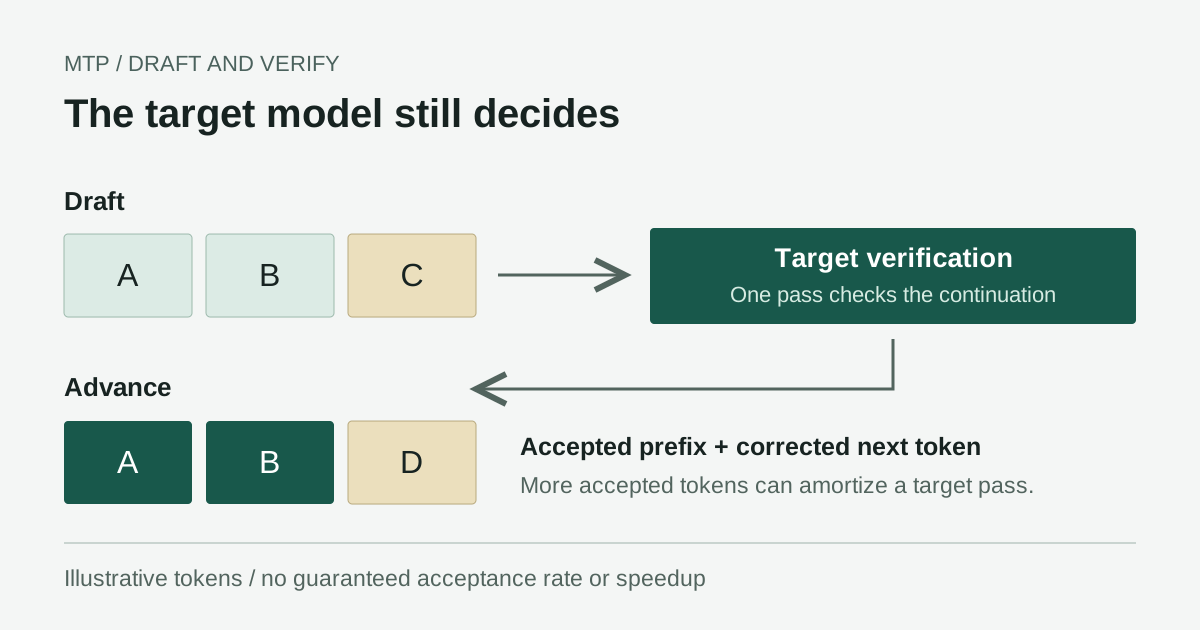
Contoh ini menggambarkan pengesahan, bukannya kadar penerimaan yang dijamin atau peningkatan kelajuan yang diukur.
Pecutan ini bersyarat. Kod yang boleh dijangka atau teks berulang mungkin lebih mudah didraf berbanding peralihan penaakulan yang tidak biasa. Susunan prompt, pensampelan, panjang output dan varian model boleh mengubah penerimaan. Oleh itu, tajuk utama yang diukur pada satu prompt tidak patut dianggap mewakili bahasa atau tugasan lain.
Pengesahan menyasarkan model yang benar-benar sedang dijalankan. Ia tidak memulihkan maklumat yang hilang akibat kuantasi dan tidak membuktikan kesetaraan dengan pemberat BF16 asal. Memisahkan kedua-dua isu ini penting: pelaksanaan spekulatif dan kualiti model berketepatan rendah menjawab soalan yang berbeza.
Perbezaan kedua berkaitan penggunaan semula cache. Awalan perbualan yang tidak berubah boleh menjimatkan kerja berulang, tetapi susulan dengan cache hangat dan prompt panjang yang baharu bukan ujian yang setara. Catat sama ada awalan digunakan semula semasa membandingkan hasil setempat. Projek ini mendokumenkan caching sempadan mesej secara jelas. Tingkah laku cache awalan
"GPU 12 GB" tidak bermaksud pemasangan 12 GB
Kuantasi GGUF yang diterbitkan membahagikan model kepada satu shard utama dan satu shard n-gram tetap berukuran 28.8 GB. Saiz fail di bawah menggunakan unit GB perpuluhan dan merujuk kepada saiz muat turun, bukannya keperluan memori GPU. Projector vision pilihan menambah kira-kira 0.91 GB; muat turun tambahan dan fail penukaran sementara memerlukan ruang tambahan. Fail kuantasi ISTA-DASLab
| Varian | Purata bit teras/berat | Shard utama | Shard n-gram | Jumlah muat turun |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
Nama format sahaja bukan gambaran tepat bagi setiap tensor. Shard utama menggunakan format campuran, manakala shard n-gram menggunakan IQ4_NL. "Model dua bit" ialah ringkasan yang mudah, tetapi mengelirukan jika membayangkan seluruh muat turun menggunakan tepat dua bit bagi setiap parameter. Metodologi kuantasi
Untuk percubaan model penuh yang pertama, GPU yang disokong dengan kapasiti sekurang-kurangnya 12 GB dan RAM sistem 64 GB ialah garis dasar perancangan yang lebih meyakinkan berbanding tajuk utama GPU sahaja. Repositori ini turut membincangkan laluan dengan RAM lebih rendah dan varian Coder yang dipangkas. Itu konfigurasi yang berbeza, bukannya bukti bahawa mesin 32 GB memberikan pengalaman model penuh yang sama. Pemilihan model Strata
Saya akan menyediakan 100-150 GB ruang SSD kosong sebelum mencuba. Ini peruntukan perancangan yang konservatif, bukannya keperluan vendor yang tetap: kuantasi pilihan, pembantu MTP, fail vision pilihan dan cache binaan/penukaran menentukan jumlah sebenar. Sesetengah laluan pengoptimuman CPU Q2 mungkin memerlukan salinan expert tambahan yang besar. Semak laluan yang dipilih dan jangan menganggap satu angka ruang cakera terpakai untuk semua keadaan.
Sebelum memilih perkakasan, tentukan konfigurasi yang anda perlukan: model penuh atau dipangkas, konteks pendek atau panjang, vision atau teks, serta throughput berterusan atau penggunaan sekali-sekala. Pilihan ini mengubah lokasi kesesakan, dan penanda aras di bawah menggambarkan satu sistem tertentu.
Pasang garis dasar berpaku sebelum membuat pelarasan
Laluan standard yang didokumenkan meliputi Windows 10/11 dan Ubuntu 22.04/24.04, dengan GPU NVIDIA yang disokong serta GPU AMD terpilih. Arahan NVIDIA menetapkan pemacu 580 atau lebih baharu. macOS dan backend binaan sumber mempunyai keperluan tersendiri; arahan di bawah bukan laluan penyediaan universal. Panduan pemasangan rasmi
Di Windows, semak sebelum memuat turun
Pasang Git daripada pengedaran rasminya jika belum ada. Dalam PowerShell, klon repositori upstream dan patok pada revisi yang disemak di sini:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
Pemeriksaan ini mengelakkan muat turun model yang besar, tetapi pelancarnya mungkin menyediakan Python dan persekitaran peribadi. Tingkah laku semakan persediaan
Baca laporan perkakasan, periksa skrip persediaan dan pastikan ruang kosong sebelum meneruskan. Kemudian mulakan persediaan interaktif:
.\START-HERE.bat
Untuk percubaan awal dengan RAM 64 GB, IQ2_XS ialah titik permulaan yang munasabah daripada pilihan yang didokumenkan. Gunakan konteks 32,768 token, teks sahaja, dan biarkan Experimental Speed Projection dimatikan. Garis dasar yang lebih kecil ini memudahkan pengasingan punca kegagalan berbanding bermula dengan konteks maksimum, vision dan semua pengoptimuman diaktifkan.
Jangkakan muat turun dan pemasangan kebergantungan, bukannya fail boleh laksana kecil yang serba lengkap. Bergantung pada laluan GPU, persediaan menggunakan enjin yang telah disediakan atau perkakasan binaan. Semak permintaan yang melibatkan pemacu, pengkompil atau keistimewaan pentadbir; jangan matikan antivirus atau perlindungan pelayar untuk memaksa pemasangan. Dapatkan sebarang pemacu yang diperlukan daripada vendor perkakasan.
Pelancaran seterusnya menggunakan pelancar yang sama. Untuk membuka semula persediaan atau mengelakkan konflik port:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
Di Ubuntu, gunakan skrip persediaan yang didokumenkan
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Pilih backend yang sepadan dengan GPU. Laluan ROCm AMD dan laluan CUDA NVIDIA tidak boleh saling menggantikan. Anggap permintaan pemasangan pengurus pakej atau pengkompil sebagai perubahan pada mesin anda sendiri yang perlu disemak. Revisi yang dipatok menjadikan artikel ini boleh dihasilkan semula; keluaran lebih baharu mungkin menambah baik sokongan, jadi baca nota keluaran sebelum menaik taraf dengan sengaja.
Pastikan respons berfungsi sebelum menyambungkan ejen
Selepas pemuatan selesai, buka http://127.0.0.1:8080 dalam pelayar setempat atau port alternatif yang dipilih. Hantar soalan ringkas yang tidak sensitif dan pastikan jawapannya selesai dijana. Selepas itu barulah cuba prompt yang lebih panjang, penggunaan semula cache susulan dan bahasa yang anda inginkan. Pantau penggunaan memori dan log pelayan semasa pemuatan pertama.
API serasi yang didokumenkan merangkumi GET /v1/models dan POST /v1/chat/completions. Kenal pasti pengecam model yang disajikan dan bukannya menyalin alias tekaan ke dalam klien lain:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Gunakan pengecam yang dipulangkan semasa mengkonfigurasi klien serasi. Permintaan senarai model yang berjaya membuktikan model telah ditemui, bukannya kualiti penjanaan; respons sembang yang selesai kekal sebagai semakan awal yang bermakna. Pastikan alat ejen yang menulis fail atau menjalankan shell dimatikan semasa ujian awal ini.
Jika memori kad grafik habis, kurangkan konteks dahulu dan matikan vision. Jika proses ditamatkan atau mesin banyak menggunakan swap, siasat RAM sistem dan bukannya VRAM sahaja. Untuk pustaka runtime yang hilang, rujuk arahan khusus backend dan bukannya memasang DLL sebarangan. Projek ini menyediakan panduan berdasarkan gejala. Penyelesaian masalah Strata
Di Mac, bezakan sokongan model daripada sokongan Strata
Apple Silicon menggunakan memori bersatu dan bukannya susunan VRAM GPU serta RAM sistem yang berasingan seperti dalam penanda aras komputer meja. Pemasang Strata yang dipatok tidak mendokumenkan laluan macOS yang disokong; permintaan sokongan Mac bukan port yang telah selesai. Permintaan Mac upstream
Terdapat dua eksperimen berbeza yang mungkin dimaksudkan pengguna Mac. Fork komuniti Strata-macOS mengekalkan antara muka dan API Python dengan backend Metal untuk model GGUF yang lebih kecil; semakan yang didokumenkan menggunakan Qwen2.5, bukannya konfigurasi Flash-Next asal. Fork itu secara jelas tidak memindahkan penstriman expert CUDA Strata atau laluan MTP. Jangan anggap fork tersebut sebagai pemasangan sekali klik bagi model yang dibincangkan di sini. Fork komuniti dan skopnya
Bagi Qwen3.8-Flash-Next itu sendiri, laluan eksperimen yang berasingan ialah binaan llama.cpp serasi Metal dengan fail GGUF berpecah daripada penerbitnya. Ini bukan Strata pada Mac, dan jadual kelajuan Windows di bawah tidak terpakai.
Bina runtime Metal yang berasingan
Gunakan Mac Apple Silicon, terminal ARM64 natif, alat pembangun baris perintah Apple, Git dan CMake. Jika CMake tiada, pasangnya daripada pengedaran rasmi atau pengurus pakej yang dipercayai. Dokumentasi binaan llama.cpp yang disemak mengaktifkan Metal secara lalai pada macOS. Mematok enjin ini juga mengelakkan branch yang sentiasa berubah daripada menukar contoh ini secara senyap pada masa hadapan. Arahan binaan Metal llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Muat turun kedua-dua shard IQ2_XS daripada senarai fail penerbit ke dalam satu direktori dan kekalkan nama asalnya. Shard kedua tetap diperlukan walaupun baris carian kekal pada cakera. Gantikan laluan model contoh di bawah dengan laluan shard pertama sebenar pada Mac anda:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
Penerbit mendokumenkan pemuatan fail berpecah serta flag mmap/lazy; enjin yang disemak menyediakan suis tersebut. Suis itu membolehkan jadual n-gram tersedia apabila diperlukan dan bukannya memerlukan keseluruhannya berada dalam memori. Suis tersebut ialah pilihan llama.cpp, bukannya pilihan pelancar Strata. Contoh pemuatan GGUF
Kapasiti tetap penting: shard utama IQ2_XS berukuran 39.2 GB sebelum mengambil kira keadaan runtime dan lebihan penggunaan macOS. Oleh itu, Mac 16 GB atau 24 GB bukan garis dasar residensi penuh yang munasabah bagi contoh ini; malah 64 GB hanyalah titik mula perancangan, bukannya jaminan berjaya. Semak tekanan memori dan swap dalam Activity Monitor, mulakan dengan konteks 4K, dan berhenti jika tekanan memori kekal tinggi. Jangan ubah had memori kernel untuk memaksa konfigurasi yang tidak muat.
Pastikan log menunjukkan Metal dipilih dan jawapan teks sahaja yang koheren selesai sebelum mencuba lebih lanjut. Kemudian uji prompt yang lebih panjang sebelum menambah penyahkodan spekulatif atau vision. Laluan ini tidak meliputi Mac Intel, pelaksanaan teragih berbilang Mac atau penukaran MLX. Tiada angka throughput Mac tersedia di sini; hasil bergantung pada cip, saiz memori bersatu, enjin, kuantasi dan konteks yang tepat.
Kelajuan terbitan menggalakkan; latensi token pertama menunjukkan sisi lain
Bagi perbandingan yang boleh dihasilkan semula, jadual ini menggunakan penanda aras enjin 0.1.26 bertarikh 29 September 2026, bukannya mencampurkan tajuk README yang lebih baharu. Mesinnya menggunakan RTX 5070 12 GB pada PCIe 5.0 x16, Ryzen 5 7600 enam teras, DDR5-5200 64 GB dan Windows 10. Ujian menggunakan penjanaan greedy, MTP aktif, imej dimatikan dan 256 token yang dijana. Keadaan penanda aras
| Varian | Penyahkodan prompt pendek, token/s | Penyahkodan prompt panjang, token/s | Prefill prompt sederhana, token/s | Token pertama prompt panjang, saat |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
Tahap pendek, sederhana dan panjang masing-masing mengandungi 3,562, 31,566 dan 128,478 token prompt. Setiap sel mewakili satu larian, bukannya purata dengan selang keyakinan. Larian IQ2_XS menggunakan fine-tune Swift 1.5 yang didokumenkan, jadi ini bukan perbandingan terkawal yang hanya berbeza dari segi kuantasi dengan model asas. Nilai disalin daripada matriks hasil yang diterbitkan. Ukuran yang boleh dibaca mesin
Kes prompt panjang Q2_0 mengambil masa 62.48 saat sebelum token pertama, walaupun penyahkodan seterusnya mencapai 73.73 token/s. Bagi pengguna yang menunggu dokumen baharu, minit pertama itu penting. Pengalaman bagi perbualan berterusan dengan konteks yang boleh digunakan semula mungkin berbeza. Kedua-duanya tidak patut disembunyikan di sebalik dakwaan maksimum token sesaat.
Angka ini menyokong kesimpulan yang terhad tetapi berguna: pada komputer meja khusus milik penulis, konfigurasi terkuantasi terpilih mencapai kelajuan penjanaan interaktif. Angka ini tidak membuktikan hasil yang sama pada mesin dengan lebar jalur lebih rendah, dalam bahasa Korea, dengan penaakulan bersampel, apabila vision diaktifkan atau dengan pengguna serentak. Token bukan perkataan, dan tokenisasi bahasa juga merumitkan perbandingan sambil lewa.
Konteks asli model sebanyak 262,144 token dan dakwaan konteks lanjutan juga tidak menjamin konfigurasi Strata pilihan anda dapat menyediakan panjang tersebut dengan selesa. Keadaan runtime, penempatan cache dan RAM yang tersedia tetap penting. Mulakan dengan kecil dan tingkatkan konteks hanya apabila beban kerja membenarkan kependaman serta memori tambahan.
Kualiti dan ciri "kelajuan" perlu disemak secara berasingan
Penerbit kuantasi melaporkan perbandingan kualiti yang berguna, tetapi itu bukan penanda aras Strata hujung ke hujung. Contohnya, skor LiveCodeBench v6 yang dilaporkan ialah 87.43 untuk BF16 dan 81.14 untuk Q2_0. Itu sebab untuk menguji tugasan yang anda pentingkan, bukannya sebab untuk mengisytiharkan semua output bit rendah tidak boleh digunakan atau semua varian setara. Penilaian kuantasi terbitan
Experimental Speed Projection memerlukan perhatian khusus. Projek ini menerangkan ciri control-vector pilihan yang mengubah tingkah laku model; ia bukan sekadar pengoptimuman aritmetik yang tidak kelihatan. Biarkan ciri itu dimatikan untuk garis dasar dan nyatakan jika digunakan dalam perbandingan. Jawapan yang lebih pantas akibat kandungannya berubah bukan ukuran yang sama dengan pelaksanaan lebih pantas bagi kerja yang setara. Butiran ciri eksperimen
Untuk penilaian sendiri, rekodkan commit repositori, versi enjin, kuantasi dan fine-tune, GPU dan VRAM, CPU, kelajuan RAM, SSD, pemacu, tetapan konteks dan togol ciri. Kemudian ukur sekurang-kurangnya tiga prompt baharu dan tiga susulan bercache, serta laporkan median dan julat dan bukannya memilih larian terbaik. Sertakan jumlah token prompt dan output bersama masa untuk token pertama, kadar penyahkodan dan jumlah masa.
Padankan semakan kelajuan dengan ujian ketepatan mengikut tugas: kompil dan uji jawapan pengekodan, bandingkan jawapan dokumen dengan sumbernya, serta sahkan bahasa dan istilah dalam output berbilang bahasa. Catat kegagalan, tamat masa dan kehabisan memori bersama-sama larian yang berjaya.
Pelaksanaan setempat mengubah kawalan, bukan semua risiko keselamatan
Kekalkan alamat loopback sebagai tetapan lalai. Mendedahkan pelayan model setempat kepada LAN atau internet mengubah model ancamannya, dan API serasi tidak semestinya perkhidmatan yang disahkan. Dasar keselamatan Strata menerangkan ikatan setempat dan skop keselamatannya; dasar itu tidak mendakwa adanya audit keselamatan luaran yang bebas. Dasar keselamatan Strata
Penjanaan setempat boleh mengurangkan pergantungan pada penyedia inferens terhos, tetapi privasi tetap bergantung pada keseluruhan aliran kerja. Log sembang, aplikasi klien, carian web, alat luaran dan sandaran boleh menghantar atau menyimpan data di luar proses model. Semak laluan tersebut sebelum memasukkan dokumen sulit ke dalam ejen. "Berjalan secara setempat" ialah fakta seni bina yang berguna, bukannya pensijilan privasi yang lengkap.
Pelesenan juga mempunyai beberapa lapisan. Lesen kod Strata tidak menggantikan terma qwen-community-1.0 bagi model. Pemberat terkuantasi tidak menghapuskan kewajipan yang terikat pada model asal. Baca lesen yang berkenaan sebelum pengedaran semula atau penggunaan komersial; jangan menganggap repositori terbuka bermakna penggunaan tanpa sekatan. Lesen model Qwen
Implikasinya ialah jenis komputer AI peribadi yang berbeza
Implikasi terkuatnya bukan bahawa inferens awan sudah lapuk. Komputer meja masih mempunyai batas dalam penyajian serentak, latensi token pertama, penggunaan tenaga, penyelenggaraan dan kualiti model. Sistem terhos boleh kekal sebagai pilihan yang lebih baik apabila ketersediaan atau jumlah permintaan tinggi lebih penting daripada kawalan terhadap persekitaran pelaksanaan.
Apa yang dicadangkan oleh Strata ialah inferens pengguna mungkin sama terhad oleh orkestrasi seperti oleh kapasiti GPU. Penggunaan CPU dan RAM yang lebih baik serta akses storan sparse boleh membuka kelas model yang akan ditolak oleh pengiraan mudah yang meletakkan semuanya dalam GPU. Lebar jalur memori sistem menjadi sebahagian daripada spesifikasi komputer AI, bukannya perkara sampingan.
Itu inferens daripada seni bina dan hasil terbitan, bukannya jaminan untuk setiap model akan datang. Ia bergantung pada model yang mendedahkan komponen sparse, boleh dicache atau berorientasikan carian yang dapat dimanfaatkan runtime. Model dense dengan corak akses berbeza tidak akan memperoleh kelebihan sama hanya kerana jumlah parameternya serupa.
Bagi penyelidik atau pembangun individu, langkah realistik seterusnya ialah percubaan terhad: versi yang dipatok, konteks pendek, mesin yang disokong, beberapa tugasan yang mewakili penggunaan sebenar serta rekod kualiti dan latensi yang jujur. Pencapaian ini bermakna tepat kerana diterangkan sebegitu. Model yang sangat besar menjadi beban kerja komputer meja yang munasabah melalui penempatan dan pengesahan yang teliti, bukannya kerana kekangan perkakasan telah lenyap.
Simpan keputusan persediaan bersama nota penyelidikan anda
Semasa membandingkan konfigurasi AI setempat, kumpulkan pautan sumber, butiran perkakasan, pemerhatian dan soalan yang belum terjawab bersama-sama. Telli.sh boleh membantu menyusun nota dan ringkasan tersebut tanpa membayangkan adanya integrasi Strata terbina dalam. Buka akaun Telli.sh