Strata dan Qwen3.8-Flash-Next: Bagaimana Model Kelas 180B Berjalan di PC Pribadi
Panduan berbasis sumber tentang arsitektur Strata, penyiapan Windows dan Linux, jalur Apple Silicon Mac yang terpisah, tolok ukur yang dipublikasikan, serta batas AI lokal.
Model dengan sekitar 180 miliar parameter yang berjalan di komputer desktop dengan kartu grafis 12 GB terdengar seperti sebuah kontradiksi. Strata membuat kemungkinan itu masuk akal, tetapi bukan dengan memadatkan semua parameter ke dalam kartu tersebut. Pencapaian yang lebih menarik adalah membuat bagian-bagian model sparse menggunakan jenis memori dan komputasi yang berbeda tanpa menjadikan setiap token yang dihasilkan sebagai hambatan perpindahan data.
Nama resmi model ini adalah Qwen3.8-Flash-Next, bukan Qwen3.8-Next-Flash. Qwen mencantumkan inti 125B parameter dengan 6B yang diaktifkan, komponen embedding n-gram tambahan 51B, dan 4B untuk prediksi multi-token. Total yang dibulatkan menjadi 180B menggambarkan komponen yang disimpan; angka itu bukan jumlah komputasi dense untuk setiap token. Kartu model Qwen
Detail penyiapan dan performa berikut merujuk pada revisi Strata fb58e0dbc8399662c0e47c76578c6e878b14f6cf. Angka tolok ukur adalah pengukuran yang dipublikasikan proyek; hasil dapat berbeda menurut perangkat keras, prompt, konteks, dan varian model Anda.
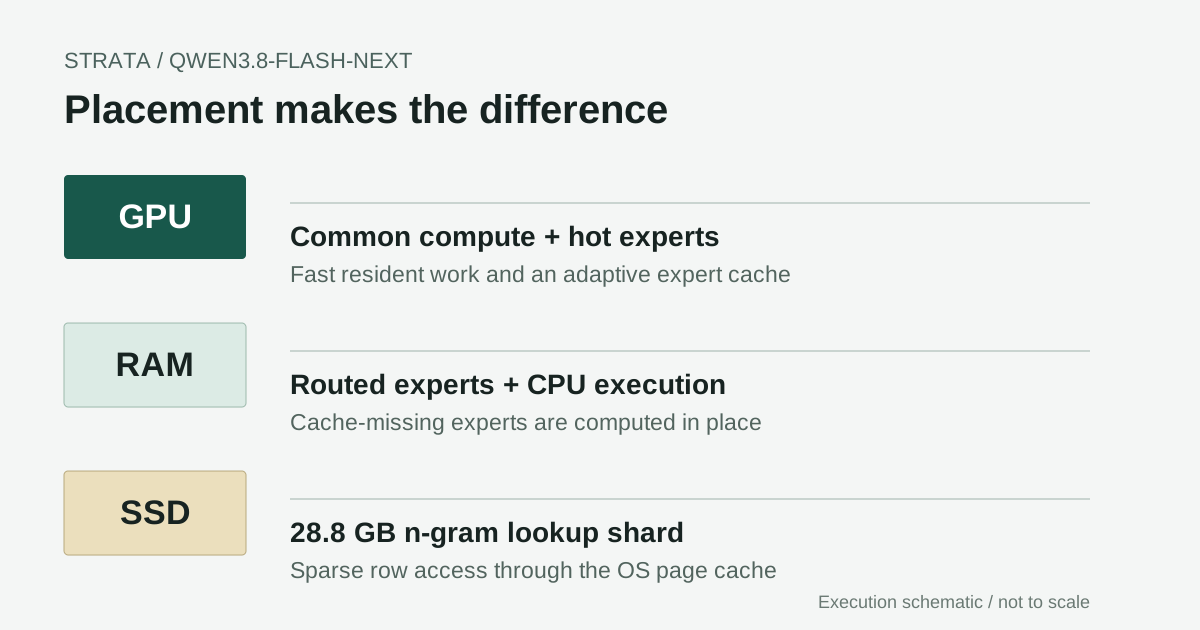
Skema orisinal berdasarkan rancangan eksekusi yang didokumentasikan. Tingkat-tingkat ini tidak digambar sesuai skala: ukuran unduhan, penggunaan RAM, dan residensi GPU adalah besaran yang berbeda.
Terobosan ada pada penempatan, bukan model yang lebih kecil
Ada tiga pertanyaan untuk setiap model lokal berukuran luar biasa besar: berapa banyak yang harus disimpan, berapa banyak yang aktif untuk satu token, dan di mana pekerjaan aktif itu dijalankan. Angka kecil untuk parameter aktif hanya menjawab pertanyaan kedua. Angka itu tidak menghapus keharusan untuk menyimpan bobot lainnya di suatu tempat yang dapat diakses.
Strata adalah mesin inferensi dan aplikasi penyajian lokal yang dikembangkan komunitas di repositori Niko1221. Penyiapan yang didokumentasikan menyediakan instalasi Windows dan Linux, antarmuka obrolan lokal, permukaan API yang kompatibel, serta masukan gambar opsional. Ini adalah proyek komunitas tersendiri, bukan produk desktop resmi Qwen. Repositori Strata
Perubahan rekayasa yang berguna adalah berhenti menganggap PC sebagai GPU dengan kapasitas memori yang tidak memadai. Desktop juga memiliki RAM sistem, unit vektor CPU, dan cache halaman sistem operasi. Sumber daya itu lebih lambat daripada memori GPU untuk sebagian operasi, tetapi tidak sama-sama tidak cocok untuk setiap operasi. Pencarian tabel besar dan perkalian matriks dense tidak membutuhkan kebijakan penempatan yang sama.
Perbedaan itulah yang membuat klaim utamanya menarik. Modelnya tetap besar; runtime mengubah seberapa banyak bagian yang perlu berada di memori tercepat pada saat tertentu. Ini membuka jalur inferensi lokal yang praktis tanpa membuktikan bahwa setiap laptop biasa dapat menjalankannya dengan baik.
Arsitektur sparse menciptakan peluang
Arsitektur Qwen menggabungkan blok Gated DeltaNet bergaya rekuren dengan Qwen Sparse Attention, routed expert, dan embedding n-gram. Laporan teknis menjelaskan alasan komponen-komponen ini dirancang agar lebih efisien saat diskalakan. Strata tidak menciptakan komponen model tersebut; Strata membangun strategi eksekusi berdasarkan pola aksesnya yang berbeda. Laporan arsitektur Qwen
Detail perutean itu penting. Masing-masing dari 48 layer memiliki 512 routed expert; 10 routed expert diaktifkan per layer, bersama satu shared expert. Artinya, 24,576 routed expert disimpan di seluruh layer. Ini bukan berarti hanya 10 dari 24,576 expert tersebut digunakan di seluruh model untuk satu token. Konfigurasi arsitektur Qwen
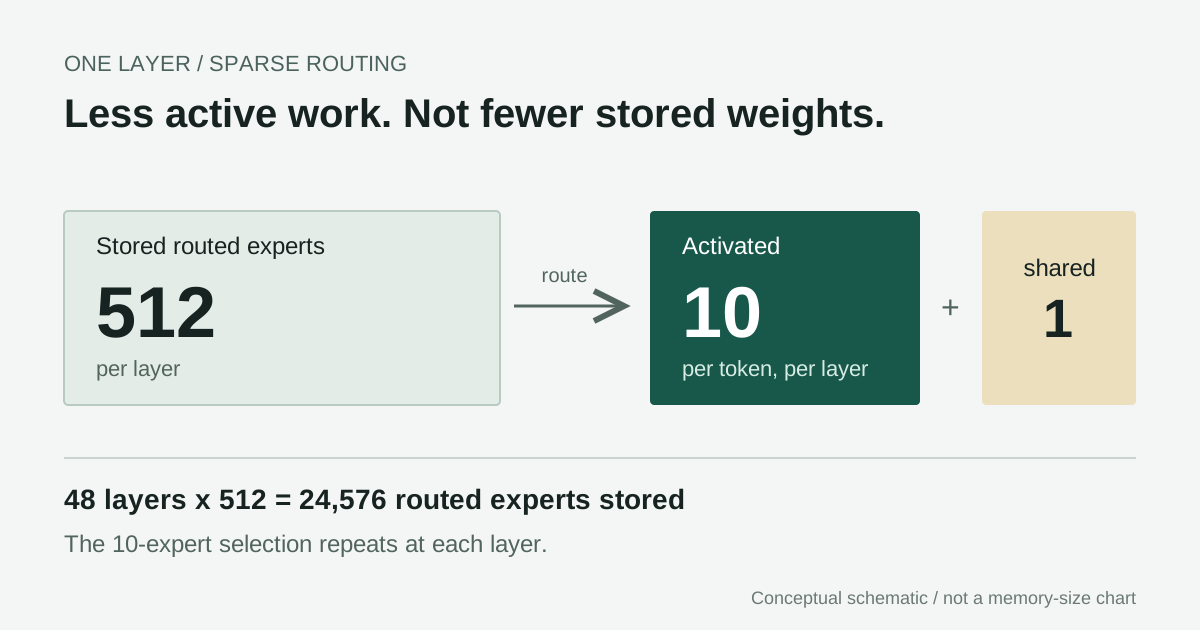
Seleksi mengurangi pekerjaan aktif, bukan inventaris yang disimpan. Diagram ini menggambarkan satu layer, bukan seluruh model yang terdiri dari 48 layer.
Pertimbangkan konsekuensinya tanpa bergantung pada klaim kecepatan apa pun. Jika suatu expert jarang dipilih, menempatkannya secara permanen di memori akselerator yang mahal mungkin bukan pemanfaatan kapasitas yang baik. Jika komponen lain digunakan pada setiap langkah, memindahkannya berulang kali kemungkinan akan mahal. Penjadwal yang berguna harus membedakan kasus-kasus ini lalu mengelola cache miss yang tidak dapat dihindarinya.
Itulah juga alasan model kelas 180B yang sparse tidak seharusnya dibandingkan dengan model dense 180B hanya berdasarkan jumlah parameter. Sebaliknya, menyebutnya "model 6B" menyembunyikan kebutuhan penyimpanan, perutean, status konteks, dan biaya mengakses bobot yang tersebar. Kedua penyederhanaan itu mengaburkan masalah rekayasa yang sebenarnya.
GPU, RAM, dan SSD mengerjakan hal yang berbeda
Dalam baseline yang didokumentasikan, GPU menyimpan komputasi umum dan cache routed expert yang sering digunakan. RAM sistem menampung bobot routed expert, dan CPU menghitung expert yang tidak ada di cache GPU secara langsung. Tabel n-gram terpisah dipetakan ke memori dan tetap berada di SSD, dengan baris yang diperlukan dilayani melalui cache sistem operasi. Ikhtisar eksekusi Strata
Jalur CPU itu lebih penting daripada sekadar label umum "offload". Saat dekode berlangsung, cache miss tidak berarti semua expert yang hilang harus disalin ke GPU sebelum proses berlanjut. Pekerjaan CPU dan GPU dapat berlangsung tumpang tindih. Konsekuensinya, kemampuan CPU dan bandwidth memori sistem kini berpengaruh langsung pada kecepatan keluaran.
Komponen n-gram memiliki pola akses yang berbeda lagi. Mengambil beberapa baris bukan beban kerja yang sama dengan memindai seluruh tabel. Karena itu, membiarkan shard lookup terkuantisasi 28.8 GB di SSD dapat dilakukan tanpa menyiratkan bahwa seluruh model dibaca dari disk untuk setiap token yang dihasilkan. Drive yang lambat atau tekanan cache halaman yang tinggi tetap dapat mengurangi responsivitas. Pemetaan berkas dan cache halaman menyajikan bagian yang diperlukan tanpa memindahkan seluruh tabel ke VRAM, sehingga SSD dan sistem operasi menjadi bagian dari rancangan inferensi.
Prefill juga berbeda dari dekode. Memproses prompt awal menyediakan batch yang lebih besar dan peluang untuk menumpangtindihkan pemindahan expert dengan pekerjaan layer lainnya. Menghasilkan token berikutnya secara berulang peka terhadap latensi. Dokumentasi terperinci proyek menjelaskan kernel, penjadwalan, dan perilaku cache yang berbeda untuk kedua tahap ini. Satu angka throughput tidak dapat merangkum keduanya. Detail implementasi Strata
Dekode spekulatif menghemat kerja hanya jika verifikasi menerima
Strata juga menggunakan komponen prediksi multi-token model untuk mengusulkan kelanjutan singkat lalu memverifikasinya dengan model target. Alih-alih membayar satu lintasan target penuh untuk setiap token keluaran, draf yang berhasil dapat membuat lintasan itu menerima beberapa token sekaligus. Repositori menjelaskan draf hingga tiga token dalam jalur MTP-nya. Rancangan dan implementasi MTP
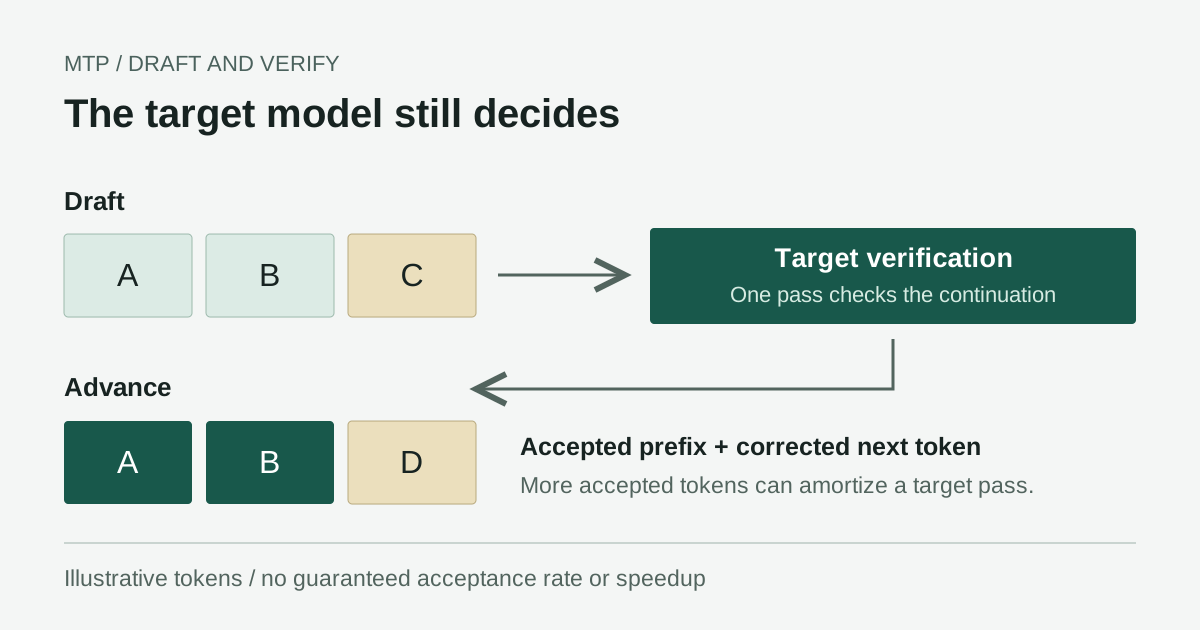
Contoh ini menggambarkan verifikasi, bukan tingkat penerimaan yang dijamin atau percepatan yang terukur.
Percepatan ini bersyarat. Kode yang mudah diprediksi atau teks berulang bisa lebih mudah didraf daripada transisi penalaran yang tidak familier. Susunan prompt, sampling, panjang keluaran, dan varian model dapat mengubah penerimaan. Karena itu, angka utama yang diukur pada satu prompt tidak boleh diasumsikan berlaku untuk bahasa atau tugas lain.
Verifikasi menyasar model yang benar-benar sedang dijalankan. Verifikasi tidak memulihkan informasi yang hilang akibat kuantisasi dan tidak membuktikan kesetaraan dengan bobot BF16 asli. Memisahkan kedua persoalan ini sangat penting: eksekusi spekulatif dan kualitas model berpresisi lebih rendah menjawab pertanyaan yang berbeda.
Perbedaan kedua menyangkut penggunaan ulang cache. Awalan percakapan yang tidak berubah dapat menghemat pekerjaan berulang, tetapi tindak lanjut dengan cache hangat dan prompt panjang baru bukan pengujian yang setara. Catat apakah awalan digunakan kembali saat membandingkan hasil lokal. Proyek mendokumentasikan caching batas pesan secara eksplisit. Perilaku cache awalan
"GPU 12 GB" bukan berarti instalasi 12 GB
Kuantisasi GGUF yang dipublikasikan membagi model menjadi satu shard utama dan satu shard n-gram tetap sebesar 28.8 GB. Ukuran file di bawah menggunakan satuan GB desimal dan merupakan ukuran unduhan, bukan kebutuhan memori GPU. Projector vision opsional menambah sekitar 0.91 GB; unduhan tambahan dan berkas konversi sementara memerlukan ruang lebih banyak. Berkas kuantisasi ISTA-DASLab
| Varian | Rata-rata bit inti/bobot | Shard utama | Shard n-gram | Total unduhan |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
Nama format saja bukan deskripsi tepat untuk setiap tensor. Shard utama menggunakan format campuran, sedangkan shard n-gram menggunakan IQ4_NL. "Model dua-bit" adalah singkatan praktis, tetapi menyesatkan jika menyiratkan bahwa seluruh unduhan menggunakan tepat dua bit per parameter. Metodologi kuantisasi
Untuk uji coba model penuh pertama, GPU yang didukung dengan kapasitas minimal 12 GB dan RAM sistem 64 GB merupakan baseline perencanaan yang lebih masuk akal daripada hanya berpatokan pada klaim GPU. Repositori juga membahas jalur dengan RAM lebih rendah dan varian Coder yang dipangkas. Itu konfigurasi berbeda, bukan bukti bahwa mesin 32 GB memberikan pengalaman model penuh yang sama. Pemilihan model Strata
Saya akan menyediakan 100-150 GB ruang SSD kosong sebelum bereksperimen. Ini alokasi perencanaan yang konservatif, bukan persyaratan vendor yang tetap: kuantisasi yang dipilih, helper MTP, berkas vision opsional, serta cache build/konversi menentukan total sebenarnya. Sejumlah jalur optimasi CPU Q2 dapat memerlukan salinan expert tambahan yang cukup besar. Periksa jalur yang dipilih alih-alih menganggap satu angka ruang disk berlaku universal.
Sebelum memilih perangkat keras, tentukan konfigurasi yang Anda perlukan: model penuh atau yang dipangkas, konteks pendek atau panjang, vision atau teks, serta throughput berkelanjutan atau penggunaan sesekali. Pilihan itu mengubah letak bottleneck, dan tolok ukur di bawah menggambarkan satu sistem tertentu.
Pasang baseline yang dipatok sebelum tuning
Jalur standar yang didokumentasikan mencakup Windows 10/11 dan Ubuntu 22.04/24.04, dengan GPU NVIDIA yang didukung serta GPU AMD tertentu. Instruksi NVIDIA menetapkan driver versi 580 atau lebih baru. macOS dan backend build dari sumber memiliki persyaratan tersendiri; perintah di bawah bukan panduan penyiapan universal. Panduan instalasi resmi
Di Windows, periksa sebelum mengunduh
Pasang Git dari distribusi resminya jika belum tersedia. Di PowerShell, klon repositori upstream dan patok ke revisi yang ditinjau di sini:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
Pemeriksaan ini menghindari unduhan model berukuran besar, tetapi peluncurnya mungkin menyiapkan Python dan lingkungan privat. Perilaku pemeriksaan penyiapan
Baca laporan perangkat keras, periksa skrip penyiapan, dan pastikan ruang kosong sebelum melanjutkan. Lalu mulai penyiapan interaktif:
.\START-HERE.bat
Untuk uji coba awal dengan RAM 64 GB, IQ2_XS merupakan titik awal yang wajar dari pilihan terdokumentasi. Gunakan konteks 32,768 token, teks saja, dan biarkan Experimental Speed Projection nonaktif. Baseline yang lebih kecil ini memudahkan pelacakan kegagalan dibandingkan memulai dengan konteks maksimum, vision, dan semua optimasi aktif.
Perkirakan akan ada unduhan dan pemasangan dependensi, bukan executable mungil yang berdiri sendiri. Bergantung pada jalur GPU, penyiapan menggunakan mesin yang telah disiapkan atau perkakas build. Tinjau permintaan yang melibatkan driver, compiler, atau hak administrator; jangan menonaktifkan antivirus atau perlindungan browser untuk memaksakan instalasi. Dapatkan driver yang diperlukan dari vendor perangkat keras.
Peluncuran berikutnya menggunakan peluncur yang sama. Untuk membuka kembali penyiapan atau menghindari bentrokan port:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
Di Ubuntu, gunakan skrip penyiapan yang didokumentasikan
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Pilih backend yang sesuai dengan GPU. Jalur ROCm AMD dan CUDA NVIDIA tidak dapat saling dipertukarkan. Perlakukan permintaan pemasangan dari pengelola paket atau compiler sebagai perubahan pada mesin Anda sendiri yang perlu ditinjau. Revisi yang dipatok membuat artikel ini dapat direproduksi; rilis yang lebih baru mungkin memperbaiki dukungan, jadi baca catatan rilisnya sebelum sengaja melakukan upgrade.
Pastikan ada respons sebelum menghubungkan agen
Setelah pemuatan selesai, buka http://127.0.0.1:8080 di browser lokal, atau port alternatif yang dipilih. Kirim pertanyaan singkat yang tidak sensitif dan pastikan jawabannya selesai dihasilkan. Setelah itu barulah coba prompt lebih panjang, penggunaan ulang cache pada tindak lanjut, dan bahasa yang Anda inginkan. Pantau penggunaan memori dan log server selama pemuatan pertama.
API kompatibel yang didokumentasikan mencakup GET /v1/models dan POST /v1/chat/completions. Temukan pengenal model yang disajikan, alih-alih menyalin alias tebakan ke klien lain:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Gunakan pengenal yang dikembalikan saat mengonfigurasi klien kompatibel. Permintaan daftar model yang berhasil membuktikan model ditemukan, bukan kualitas generasinya; respons obrolan yang selesai tetap menjadi pemeriksaan awal yang bermakna. Biarkan alat agen yang menulis berkas atau menjalankan shell tetap nonaktif selama pengujian pertama ini.
Jika memori kartu grafis habis, kurangi konteks terlebih dahulu dan nonaktifkan vision. Jika proses dihentikan atau mesin banyak menggunakan swap, periksa RAM sistem, bukan hanya VRAM. Untuk pustaka runtime yang hilang, ikuti instruksi khusus backend alih-alih memasang DLL sembarang. Proyek menyediakan panduan berdasarkan gejala. Pemecahan masalah Strata
Di Mac, bedakan dukungan model dari dukungan Strata
Apple Silicon menggunakan memori terpadu, bukan susunan VRAM GPU dan RAM sistem yang terpisah seperti pada tolok ukur desktop. Installer Strata yang dipatok tidak mendokumentasikan jalur macOS yang didukung; permintaan dukungan Mac bukan port yang telah selesai. Permintaan dukungan Mac upstream
Ada dua eksperimen berbeda yang mungkin dimaksud pengguna Mac. Fork komunitas Strata-macOS mempertahankan antarmuka dan API Python dengan backend Metal untuk model GGUF yang lebih kecil; pemeriksaan terdokumentasinya menggunakan Qwen2.5, bukan konfigurasi Flash-Next asli. Fork tersebut secara eksplisit tidak memindahkan streaming expert CUDA Strata atau jalur MTP. Jangan anggap fork itu sebagai instalasi sekali klik untuk model yang dibahas di sini. Fork komunitas dan cakupannya
Untuk Qwen3.8-Flash-Next itu sendiri, jalur eksperimental yang terpisah ialah build llama.cpp yang kompatibel dengan Metal dan berkas GGUF terpisah daripada penerbitnya. Ini bukan Strata di Mac, dan tabel kecepatan Windows di bawah tidak berlaku.
Bangun runtime Metal yang terpisah
Gunakan Mac Apple Silicon, terminal ARM64 native, alat pengembang command-line Apple, Git, dan CMake. Jika CMake belum tersedia, pasang dari distribusi resminya atau pengelola paket tepercaya. Dokumentasi build llama.cpp yang ditinjau mengaktifkan Metal secara default di macOS. Mematok mesin ini juga mencegah branch yang terus bergerak mengubah contoh secara diam-diam di masa mendatang. Instruksi build Metal llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Unduh kedua shard IQ2_XS dari daftar berkas penerbit ke satu direktori dan pertahankan nama aslinya. Shard kedua tetap diperlukan meskipun baris lookup-nya tetap berada di disk. Ganti jalur model contoh di bawah dengan jalur shard pertama yang sebenarnya di Mac Anda:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
Penerbit mendokumentasikan pemuatan berkas terpisah serta flag mmap/lazy; mesin yang ditinjau menyediakan opsi tersebut. Opsi itu membuat tabel n-gram tersedia sesuai permintaan, bukan mengharuskan seluruhnya berada di memori. Opsi tersebut adalah opsi llama.cpp, bukan opsi peluncur Strata. Contoh pemuatan GGUF
Kapasitas tetap penting: shard utama IQ2_XS berukuran 39.2 GB sebelum memperhitungkan status runtime dan overhead macOS. Karena itu, Mac 16 GB atau 24 GB bukan baseline residensi penuh yang masuk akal untuk contoh ini; bahkan 64 GB hanya titik awal perencanaan, bukan jaminan berhasil. Periksa tekanan memori dan swap di Activity Monitor, mulai dengan konteks 4K, lalu berhenti jika tekanan memori terus tinggi. Jangan mengubah batas memori kernel untuk memaksakan konfigurasi yang tidak muat.
Pastikan log menunjukkan Metal terpilih dan jawaban teks yang koheren selesai sebelum bereksperimen lebih jauh. Kemudian uji prompt yang lebih panjang sebelum menambahkan dekode spekulatif atau vision. Jalur ini tidak mencakup Mac Intel, eksekusi terdistribusi multi-Mac, atau konversi MLX. Tidak ada angka throughput Mac yang tersedia di sini; hasil bergantung pada chip, kapasitas memori terpadu, mesin, kuantisasi, dan konteks yang tepat.
Kecepatan yang dipublikasikan menjanjikan; latensi token pertama memberi gambaran lain
Untuk perbandingan yang dapat direproduksi, tabel ini menggunakan tolok ukur engine 0.1.26 tanggal 29 September 2026, bukan mencampurkan klaim README yang lebih baru. Mesinnya menggunakan RTX 5070 12 GB pada PCIe 5.0 x16, Ryzen 5 7600 enam inti, DDR5-5200 64 GB, dan Windows 10. Pengujian menggunakan generasi greedy, MTP aktif, gambar nonaktif, dan 256 token yang dihasilkan. Kondisi tolok ukur
| Varian | Dekode prompt pendek, token/s | Dekode prompt panjang, token/s | Prefill prompt sedang, token/s | Token pertama prompt panjang, detik |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
Tingkat pendek, sedang, dan panjang masing-masing berisi 3,562, 31,566, dan 128,478 token prompt. Setiap sel mewakili satu kali pengujian, bukan rata-rata dengan interval kepercayaan. Pengujian IQ2_XS menggunakan fine-tune Swift 1.5 yang terdokumentasi, jadi ini bukan perbandingan terkontrol yang hanya berbeda kuantisasi dengan model dasar. Nilai disalin dari matriks hasil yang dipublikasikan. Pengukuran yang dapat dibaca mesin
Kasus prompt panjang Q2_0 memerlukan 62.48 detik sebelum token pertama, meskipun dekode berikutnya mencapai 73.73 token/s. Bagi pengguna yang menunggu dokumen baru, menit pertama itu penting. Percakapan berkelanjutan dengan konteks yang dapat digunakan kembali bisa terasa berbeda. Keduanya tidak boleh disembunyikan di balik klaim tokens-per-second maksimum.
Angka ini mendukung kesimpulan yang terbatas tetapi berguna: pada desktop tertentu milik penulis, konfigurasi kuantisasi terpilih mencapai kecepatan generasi interaktif. Angka itu tidak membuktikan hasil yang sama pada mesin dengan bandwidth lebih rendah, dalam bahasa Korea, dengan penalaran sampling, saat vision diaktifkan, atau dengan pengguna serentak. Token bukan kata, dan tokenisasi bahasa juga membuat perbandingan kasual menjadi rumit.
Konteks native model sebesar 262,144 token dan klaim konteks panjang juga tidak menjamin konfigurasi Strata pilihan Anda dapat melayani panjang tersebut dengan nyaman. Status runtime, penempatan cache, dan RAM yang tersedia tetap berpengaruh. Mulailah dari ukuran kecil dan tingkatkan konteks hanya jika beban kerja memang membenarkan latensi dan memori tambahan.
Kualitas dan fitur "kecepatan" perlu diperiksa secara terpisah
Penerbit kuantisasi melaporkan perbandingan kualitas yang berguna, tetapi itu bukan tolok ukur Strata menyeluruh. Sebagai contoh, skor LiveCodeBench v6 yang dilaporkan adalah 87.43 untuk BF16 dan 81.14 untuk Q2_0. Itu alasan untuk menguji tugas yang Anda pedulikan, bukan alasan untuk menyatakan semua keluaran bit-rendah tidak dapat digunakan atau semua varian setara. Evaluasi kuantisasi yang dipublikasikan
Experimental Speed Projection perlu kehati-hatian khusus. Proyek menjelaskan fitur control-vector opsional yang mengubah perilaku model; fitur ini bukan sekadar optimasi aritmetika yang tak terlihat. Biarkan nonaktif untuk baseline dan ungkapkan jika digunakan dalam perbandingan. Jawaban yang lebih cepat karena kontennya berubah bukanlah pengukuran yang sama dengan eksekusi lebih cepat untuk pekerjaan yang setara. Detail fitur eksperimental
Untuk evaluasi sendiri, catat commit repositori, versi engine, kuantisasi dan fine-tune, GPU dan VRAM, CPU, kecepatan RAM, SSD, driver, pengaturan konteks, dan toggle fitur. Lalu ukur setidaknya tiga prompt baru dan tiga tindak lanjut dengan cache, serta laporkan median dan rentangnya, bukan memilih hasil terbaik. Sertakan jumlah token prompt dan keluaran bersama waktu hingga token pertama, laju dekode, dan total waktu.
Padukan pemeriksaan kecepatan dengan pengujian kebenaran yang sesuai untuk tiap tugas: kompilasi dan uji jawaban coding, bandingkan jawaban dokumen dengan sumbernya, serta periksa bahasa dan terminologi keluaran multibahasa. Catat kegagalan, timeout, dan kehabisan memori bersama hasil yang berhasil.
Eksekusi lokal mengubah kendali, bukan setiap risiko keamanan
Pertahankan alamat loopback sebagai pengaturan bawaan. Membuka server model lokal ke LAN atau internet mengubah model ancamannya, dan API kompatibel tidak otomatis merupakan layanan yang terautentikasi. Kebijakan keamanan Strata menjelaskan pengikatan lokal dan cakupan keamanannya; kebijakan itu tidak mengklaim adanya audit keamanan eksternal independen. Kebijakan keamanan Strata
Generasi lokal dapat mengurangi ketergantungan pada penyedia inferensi terhosting, tetapi privasi tetap bergantung pada seluruh alur kerja. Log obrolan, aplikasi klien, pencarian web, alat eksternal, dan cadangan dapat mengirim atau menyimpan data di luar proses model. Tinjau jalur-jalur itu sebelum menempatkan dokumen rahasia di dalam agen. "Berjalan lokal" adalah fakta arsitektur yang berguna, bukan sertifikasi privasi lengkap.
Lisensi juga memiliki beberapa lapisan. Lisensi kode Strata tidak menggantikan ketentuan qwen-community-1.0 untuk model. Bobot terkuantisasi tidak menghapus kewajiban yang melekat pada model asli. Baca lisensi yang berlaku sebelum redistribusi atau penerapan komersial, alih-alih menganggap repositori terbuka berarti penggunaan tanpa batas. Lisensi model Qwen
Implikasinya adalah jenis komputer AI pribadi yang berbeda
Implikasi terkuatnya bukan bahwa inferensi cloud sudah usang. Desktop tetap memiliki batas dalam penyajian serentak, latensi token pertama, konsumsi energi, pemeliharaan, dan kualitas model. Sistem terhosting tetap dapat menjadi pilihan lebih baik ketika ketersediaan atau volume permintaan tinggi lebih penting daripada kendali atas lingkungan eksekusi.
Yang ditunjukkan Strata adalah bahwa inferensi konsumen mungkin sama terbatasnya oleh orkestrasi seperti oleh kapasitas GPU. Pemanfaatan CPU dan RAM yang lebih baik serta akses penyimpanan sparse dapat membuka kelas model yang akan ditolak oleh kalkulasi sederhana yang mengharuskan semuanya berada di GPU. Bandwidth memori sistem menjadi bagian dari spesifikasi komputer AI, bukan lagi pertimbangan belakangan.
Itu adalah inferensi dari arsitektur dan hasil yang dipublikasikan, bukan jaminan untuk setiap model mendatang. Kesimpulan ini bergantung pada model yang menyediakan komponen sparse, dapat di-cache, atau berorientasi lookup yang dapat dimanfaatkan runtime. Model dense dengan pola akses berbeda tidak akan memperoleh keuntungan yang sama hanya karena jumlah parameternya serupa.
Bagi peneliti atau pengembang perorangan, langkah realistis berikutnya adalah uji coba terbatas: versi yang dipatok, konteks pendek, mesin yang didukung, beberapa tugas representatif, serta catatan kualitas dan latensi yang jujur. Tonggak ini bermakna justru jika dijelaskan seperti itu. Model yang sangat besar telah menjadi beban kerja desktop yang masuk akal berkat penempatan dan verifikasi yang cermat, bukan karena batas perangkat keras menghilang.
Simpan keputusan penyiapan bersama catatan riset Anda
Saat membandingkan konfigurasi AI lokal, simpan tautan sumber, detail perangkat keras, pengamatan, dan pertanyaan yang belum terjawab bersama-sama. Telli.sh dapat membantu mengatur catatan dan ringkasan tersebut tanpa menyiratkan adanya integrasi Strata bawaan. Buat akun Telli.sh