[บันทึกภาคสนาม AI ในเครื่อง 01] บททดสอบถัดไปของ Strata: ทำให้โมเดลใหญ่มีประโยชน์บนพีซีของคุณ
Strata รุ่นเบตา 0.2 กลายเป็นแอปเดสก์ท็อปแล้ว ตัวอย่างฮาร์ดแวร์ทั่วไปที่เผยแพร่สามชุดแสดงว่าอะไรใช้งานได้ อะไรใช้หน่วยความจำมาก และ AI ในเครื่องจะก้าวต่อไปทางไหน
การสาธิต AI ในเครื่องที่น่าสนใจที่สุด คือสิ่งที่คุณยังกลับมาใช้งานได้ในสัปดาห์หน้า โมเดลใหญ่ที่ตอบคำถามได้ชาญฉลาดบนพีซีเล่นเกมถือเป็นหมุดหมายสำคัญ แต่การเปิดบทสนทนาเดิมในวันพรุ่งนี้ หาไฟล์โมเดลเจอ และให้มันแก้ไขโครงการอย่างปลอดภัยได้ต่างหาก คือจุดเริ่มต้นของเครื่องมือที่มีประโยชน์
Strata ขยับเข้าใกล้กลุ่มหลังเมื่อออก 0.2.0-beta วันที่ 19 ตุลาคม 2026 พร้อมแอปเดสก์ท็อป อินเทอร์เฟซ Terminal และเอนจินที่แยกแพ็กเกจออกจากกัน ภายในวันที่ 23 ตุลาคม รุ่น 0.2.3 ก็ตามมาแล้ว ชื่อรุ่นเบตาที่ถูกต้องมีความสำคัญตอนเลือกดาวน์โหลด เพราะนี่คือสายรุ่น 0.2 ไม่ใช่การประกาศรุ่น 2.0 ในอนาคต รุ่นเบตา, รุ่นวันที่ 23 ตุลาคม
ตอนแรกของชุด “บันทึกภาคสนาม AI ในเครื่อง” จะสำรวจว่าความเปลี่ยนแปลงนี้ให้อะไรกับคนที่มีคอมพิวเตอร์อยู่แล้ว เราจะเชื่อมอินเทอร์เฟซใหม่เข้ากับตัวอย่างฮาร์ดแวร์ที่เผยแพร่สามชุด แยกตัวเลือกโมเดลออกจากความแตกต่างด้านสถาปัตยกรรม และพิจารณาพัฒนาการที่อาจทำให้การอนุมานในเครื่องกลายเป็นบริการที่พึ่งพาได้ทุกวัน
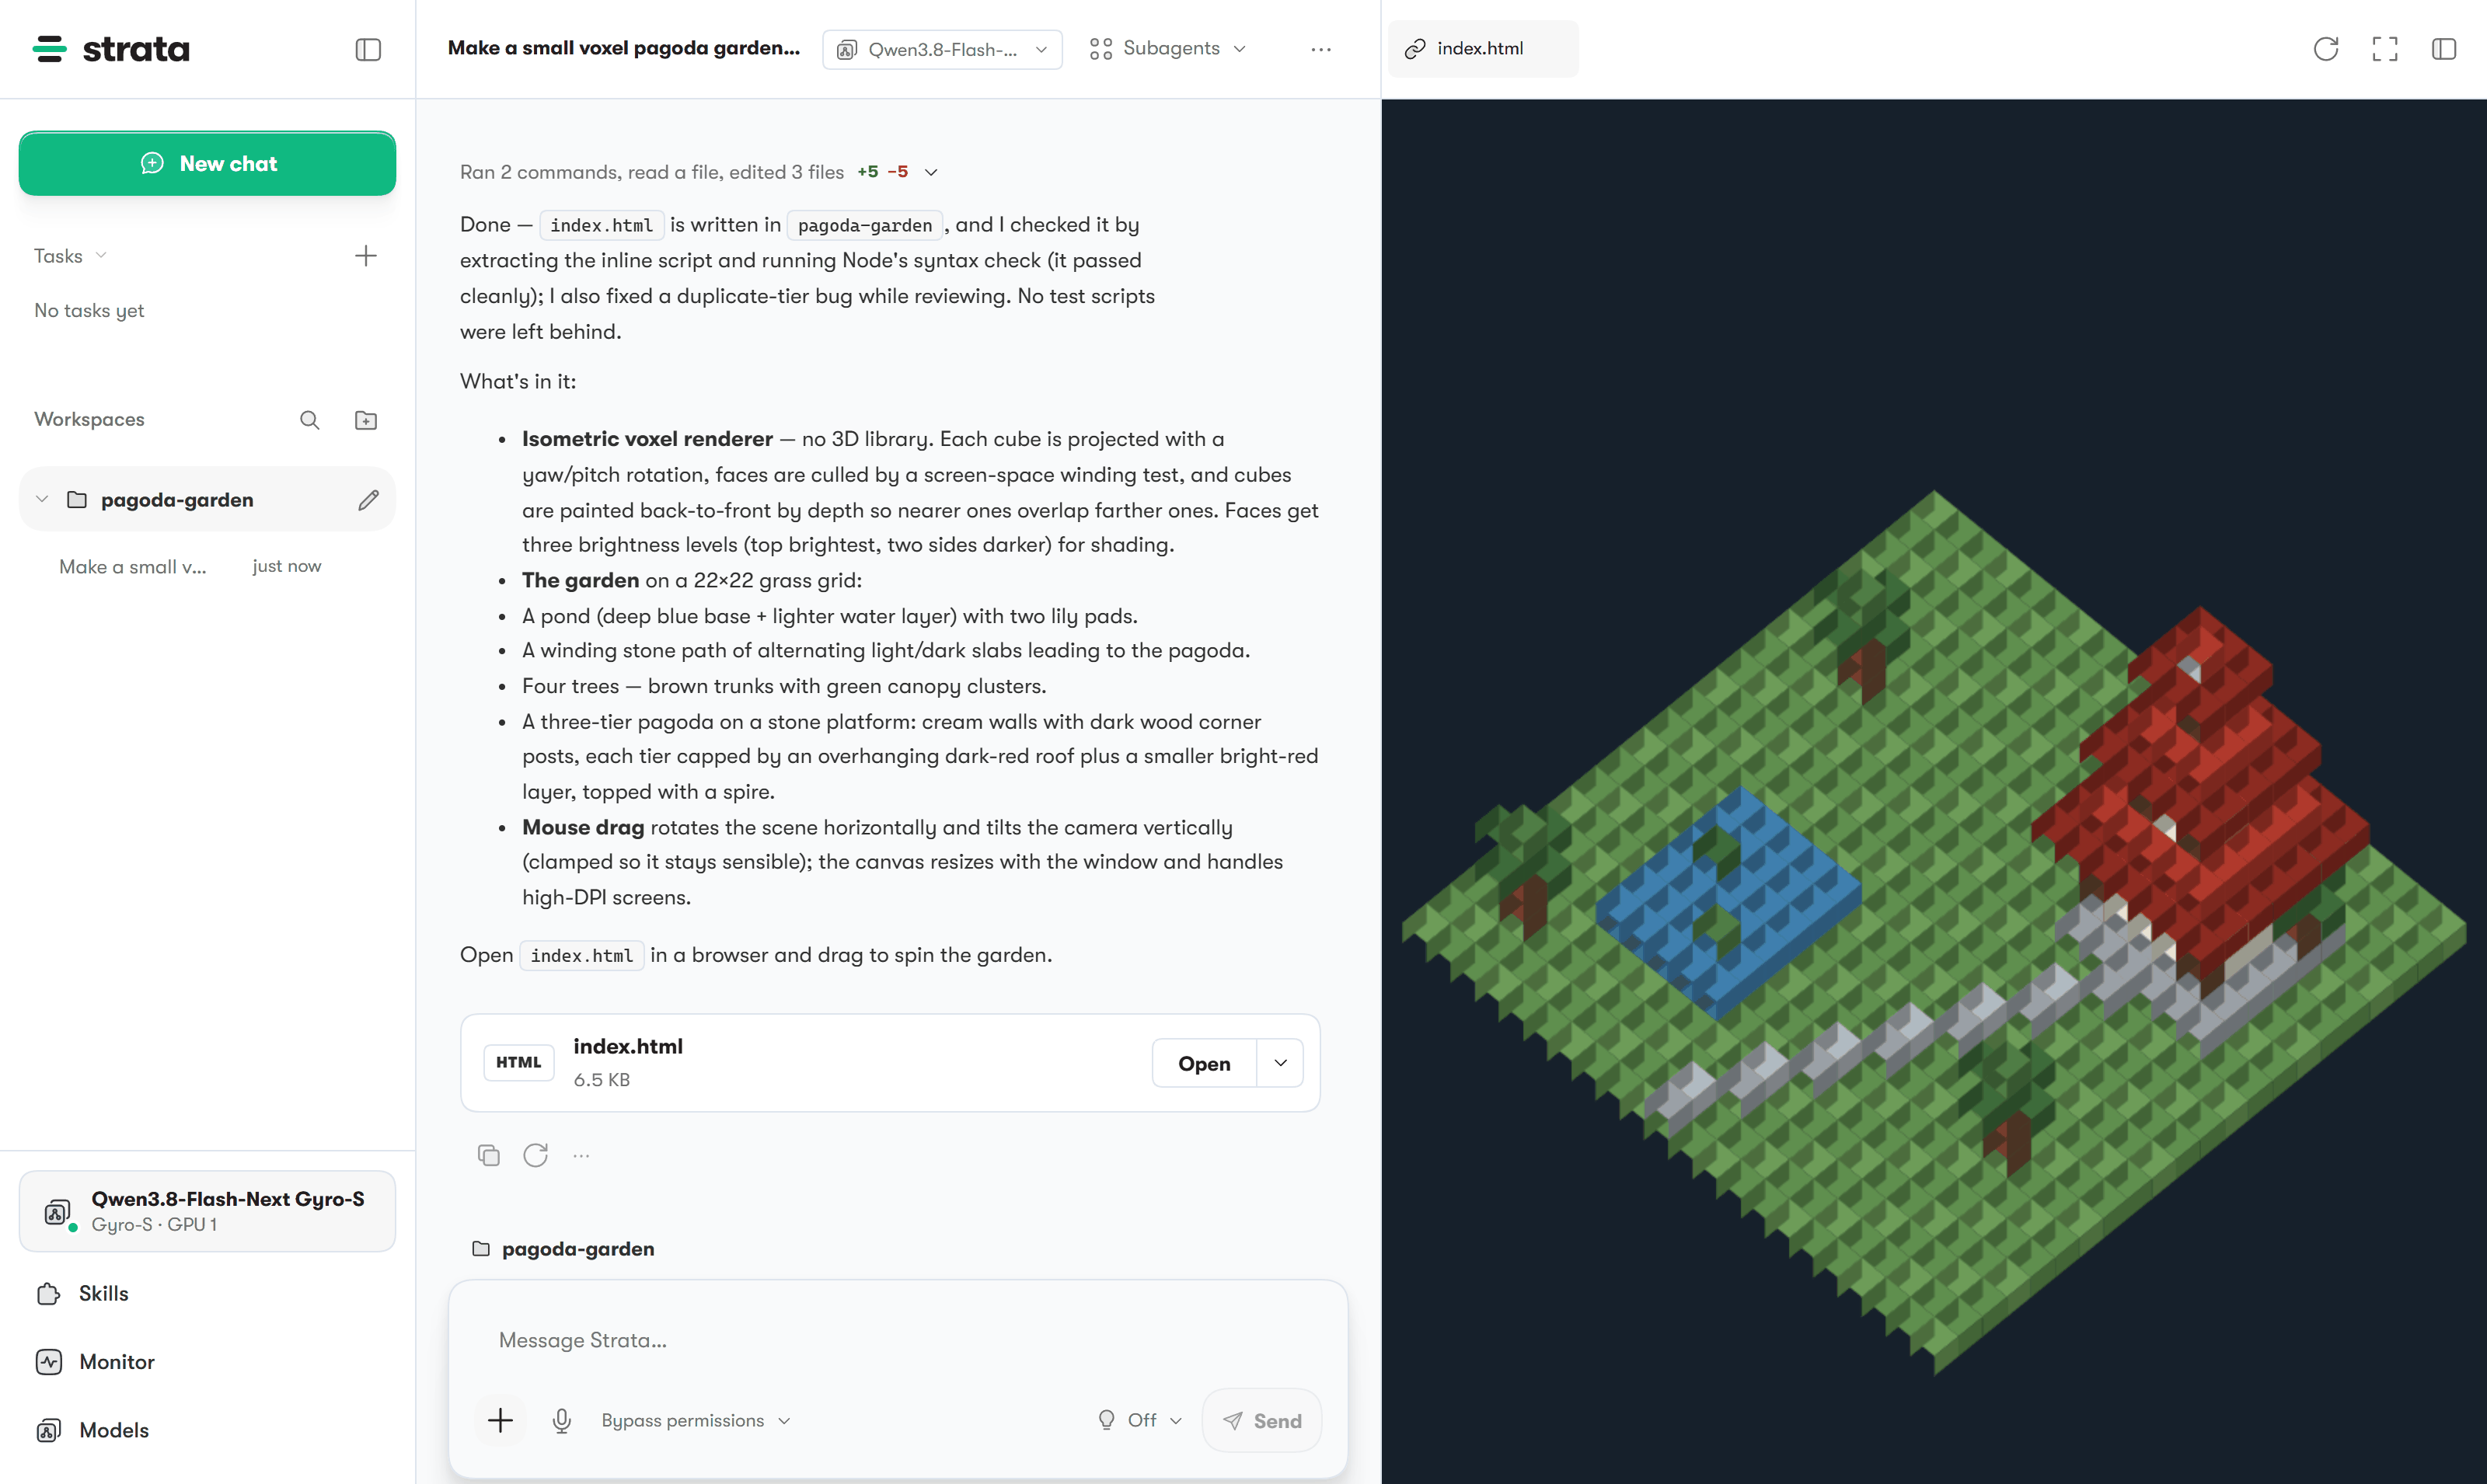
ภาพหน้าจอทางการของ Strata จากคลังโค้ดรุ่น 0.2.3 แสดงบทสนทนาเขียนโค้ดและตัวอย่าง HTML ภาพนี้ใช้แสดงอินเทอร์เฟซ ไม่ใช่ผลทดสอบที่ทำขึ้นสำหรับบทความนี้ © 2026 Niko1221 and the Strata contributors; แหล่งที่มา, สัญญาอนุญาต MIT.

รุ่นเบตาทำให้เอนจินกลายเป็นเครื่องมือที่กลับมาใช้งานต่อได้
แอปเดสก์ท็อปรวมการเลือกโมเดล การจัดการพื้นที่จัดเก็บ แชต การตรวจสอบฮาร์ดแวร์ และพื้นที่เขียนโค้ดไว้ด้วยกัน โหมดสิทธิ์ Manual จะถามก่อนเปลี่ยนแปลง ส่วนโหมด Bypass ที่อนุญาตมากกว่าจะให้อิสระแก่เอเจนต์มากขึ้น Terminal มีขั้นตอนแนะนำผ่าน strata launch และเชื่อมต่อกับไคลเอนต์เขียนโค้ดได้ ทั้งสองอินเทอร์เฟซใช้เอนจินพื้นฐานร่วมกัน บันทึกคุณสมบัติ 0.2.0-beta
สำหรับนักพัฒนา สิ่งนี้นำไปสู่ตัวอย่างการใช้งานที่ตรงไปตรงมา คือขอให้สร้างตัวแยกวิเคราะห์ขนาดเล็กในโครงการทดลอง ตรวจไฟล์ที่เสนอ รันชุดทดสอบ แล้วสนทนาต่อด้วยตัวอย่างที่ทำงานผิดพลาด สำหรับคนที่ทำงานกับเอกสารมาก งานแรกที่เทียบกันได้คือถามคำถามที่มีขอบเขตชัดเจนเกี่ยวกับข้อความที่ให้ไป แล้วขอข้อความอ้างอิงตรงตามต้นฉบับเพื่อสนับสนุนคำตอบ ทั้งสองสถานการณ์ไม่จำเป็นต้องเปลี่ยนโมเดลให้เป็นพนักงานที่ทำงานเองอย่างอิสระ
สิ่งที่ดีขึ้นในทางปฏิบัติคือความต่อเนื่อง หน้าจอเลือกโมเดลช่วยลดโอกาสเริ่มด้วยค่าที่เข้ากันไม่ได้ ตัวตรวจสอบฮาร์ดแวร์ช่วยอธิบายว่าทำไมแอปอื่นจึงกระทบประสิทธิภาพ และค่าตั้งล่วงหน้าที่บันทึกไว้ช่วยให้ทำการทดลองที่สำเร็จซ้ำได้ คุณสมบัติเหล่านี้ไม่ได้เพิ่มความสามารถในการให้เหตุผลของโมเดล แต่ลดงานระหว่างการมีความสามารถนั้นอยู่กับการนำมาใช้อย่างรับผิดชอบ
มุมมองของเราคือ การแข่งขันขั้นต่อไปของ AI ในเครื่องจะอยู่ที่ระยะห่างนี้ ประสบการณ์ที่ชนะจะทำให้เก็บค่าที่ใช้งานได้ดีไว้ได้ง่าย เข้าใจความผิดพลาดได้ง่าย และตรวจทานการกระทำที่เสี่ยงได้ง่าย
ระบบหน่วยความจำทั้งหมดของคอมพิวเตอร์กลายเป็นส่วนหนึ่งของโมเดล
เป้าหมายหลักของ Strata คือ Qwen3.8-Flash-Next ซึ่งมีแกนหลักขนาด 125 พันล้านพารามิเตอร์ กลยุทธ์การทำงานใช้หน่วยความจำ GPU สำหรับการคำนวณร่วมและผู้เชี่ยวชาญที่ต้องใช้บ่อย ใช้ RAM ระบบและ CPU กับผู้เชี่ยวชาญส่วนอื่น และเข้าถึง SSD เพื่อใช้ตารางค้นหา n-gram การ์ดจอที่ใหญ่ขึ้นช่วยได้ แต่ RAM และพื้นที่จัดเก็บของเครื่องยังคงเป็นส่วนหนึ่งของเส้นทางการอนุมาน ภาพรวมโครงการ, การออกแบบการทำงาน
ลองนึกว่าพีซีเป็นโรงงานที่มีโต๊ะทำงานหลายตัว โต๊ะที่เร็วที่สุดมีพื้นที่จำกัด รันไทม์จึงต้องตัดสินใจว่างานใดควรอยู่บนโต๊ะนั้นต่อ การตัดสินใจที่ดีขึ้นทำให้ฮาร์ดแวร์เดิมมีประโยชน์มากขึ้นได้ แต่ไม่อาจทำให้โต๊ะทุกตัวเร็วเท่ากัน
มีปริมาณสามอย่างที่ต้องพิจารณาแยกกัน ไฟล์ที่ดาวน์โหลดกินพื้นที่จัดเก็บ น้ำหนักโมเดลที่โหลดแล้วกับบัฟเฟอร์รันไทม์ใช้หน่วยความจำ ส่วนหน้าต่างบริบทจะเพิ่มสถานะการทำงานเมื่อบทสนทนายาวขึ้น ดังนั้นขนาดไฟล์อย่างเดียวจึงบอกไม่ได้ว่าต้องใช้ VRAM เท่าไร หรือคำตอบแรกจะปรากฏเร็วเพียงใด
คำแนะนำเริ่มต้นปัจจุบันของโครงการคือมี RAM และ VRAM รวมกันอย่างน้อย 32 GB พร้อม พื้นที่ดิสก์ว่างราว 80 GB สำหรับการตั้งค่าตามปกติ นี่เป็นแนวทางเริ่มต้น ไม่ใช่คำรับประกันว่าทุกโมเดล ทุกความยาวบริบท หรือทุกระบบปฏิบัติการจะอยู่ในงบนี้ได้ ไม่ควรถือว่าแล็ปท็อปพื้นฐาน 16 GB เทียบเท่าเดสก์ท็อปในตัวอย่างด้านล่าง ข้อกำหนดฮาร์ดแวร์
ชื่อโมเดลที่มากขึ้นไม่ได้แปลว่ามีสถาปัตยกรรมมากขึ้นเสมอไป
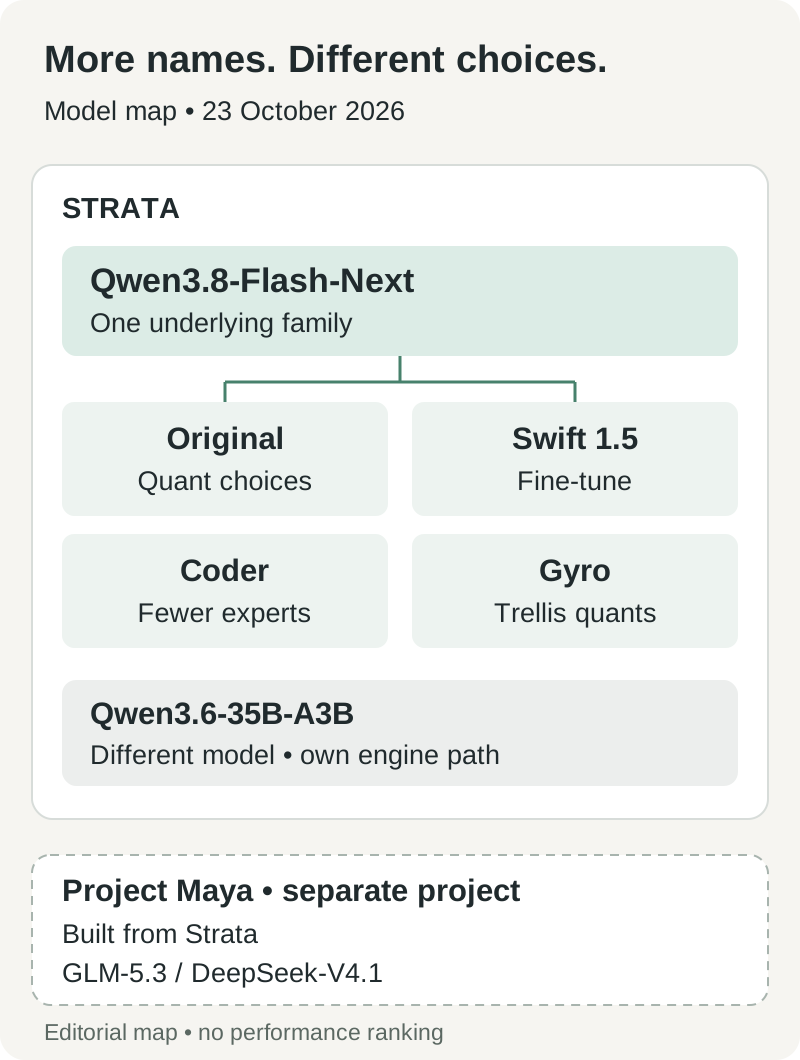
แผนภาพต้นฉบับที่กองบรรณาธิการจัดทำจากความสัมพันธ์ของโมเดลในเอกสาร ตรวจสอบวันที่ 23 ตุลาคม แขนงแสดงสายที่มาและการรองรับของรันไทม์ ไม่ได้หมายถึงคุณภาพเท่ากันหรือใช้ไฟล์แทนกันได้
Flash-Next ดั้งเดิม, Swift 1.5, Coder และ Gyro ตอบโจทย์ต่างกันภายใต้ตระกูลพื้นฐานเดียวกัน Swift เปลี่ยนพฤติกรรมด้วยการปรับจูน Coder ตัดผู้เชี่ยวชาญที่ถูกเลือกว่ามีประโยชน์น้อยกว่าสำหรับงานเขียนโค้ด ส่วน Gyro เปลี่ยนวิธีแทนน้ำหนักโมเดล การมองชื่อเหล่านี้เป็นโมเดลพื้นฐานสี่ตัวที่ไม่เกี่ยวข้องกันทำให้รายการดูหลากหลายกว่าความเป็นจริง คู่มือโมเดล
ความแตกต่างเหล่านี้มีผลจริง Coder เก็บผู้เชี่ยวชาญไว้ 256 จาก 512 ตัวในแต่ละชั้น และโครงการเตือนว่าประสิทธิภาพทั่วไปกับภาษาที่ไม่ใช่อังกฤษจะลดลง โมเดลที่เลือกเพราะพอดีกับเดสก์ท็อปสำหรับเขียนโค้ดจึงไม่ควรกลายเป็นค่าเริ่มต้นสำหรับถามเอกสารหลายภาษาโดยอัตโนมัติ การให้เหตุผลที่สั้นลงของ Swift อาจลดเวลารวมได้ โดยไม่ได้ทำให้ฮาร์ดแวร์สร้างแต่ละโทเค็นเร็วขึ้น ข้อแลกเปลี่ยนระหว่างรุ่น
Gyro-S ต้อง ดาวน์โหลด 58.5 GB แม้เอกสารระบุว่าหน่วยความจำสำหรับน้ำหนักโมเดลรวม RAM และ VRAM อยู่ที่ 27.6 GB ตาราง n-gram ยังอยู่บน SSD การประเมินของโครงการจัดคุณภาพไว้ต่ำกว่าตัวเลือกบิตต่ำที่มีขนาดใหญ่กว่า การใช้หน่วยความจำน้อยลงจึงมีสิ่งที่ต้องแลก เอกสาร Gyro
นอกจากนี้ยังมีโมเดลที่สองจริง ๆ คือ Qwen3.6-35B-A3B ซึ่งเป็นโมเดล mixture-of-experts ขนาด 35 พันล้านพารามิเตอร์ มีพารามิเตอร์ทำงาน 3 พันล้านตัว และใช้เส้นทางเอนจินแยกต่างหาก ตัวเลือกที่เอกสารระบุรวมถึงรูปภาพและคำขอพร้อมกันบนการตั้งค่า NVIDIA และ AMD ที่รองรับ ส่วนเอนจินบน Mac ไม่รันโมเดลนี้ ความแตกต่างนี้ทำให้เป็นทางเลือกที่ควรประเมิน เมื่อจำนวนพารามิเตอร์ที่ใหญ่ที่สุดในพาดหัวไม่ใช่ความต้องการจริงของคุณ การรองรับ Qwen3.6
เครื่องสามชุดที่เผยแพร่แสดงประโยชน์ใช้สอยสามแบบ
ตัวอย่างต่อไปนี้เผยแพร่โดยสมาชิกชุมชนหรือตัวโครงการเอง เป็นผลวัดจากการตั้งค่าเฉพาะ ไม่ใช่การทดสอบโดยตรงสำหรับบทความนี้ จุดประสงค์คือแสดงงานที่น่าจะทำได้และต้นทุนของมัน ไม่ใช่จัดอันดับคอมพิวเตอร์สามเครื่องด้วยพรอมป์ต์ที่เทียบกันไม่ได้
| ตัวอย่างที่เผยแพร่ | โมเดลและเงื่อนไขบริบท | ผลที่รายงาน | ช่วยให้ตัดสินใจเรื่องใด |
|---|---|---|---|
| ชุมชน วันที่ 9 ตุลาคม: RTX 3060 12 GB, Core i7-12700, 64 GB DDR4-3200, NVMe, Windows 11 | Strata 0.1.41; Q2_0 ดั้งเดิม; หน้าต่าง 131,072 โทเค็น; พรอมป์ต์ใหม่ 4,096 โทเค็น เอาต์พุต 256 โทเค็น; ปิดการให้เหตุผลและการมองภาพ; รันสามรอบ | มัธยฐานเอาต์พุต 42.9 โทเค็น/วินาที; 4.7 วินาทีก่อนโทเค็นแรก; รวม 10.6 วินาที | การ์ดรุ่นเก่า 12 GB รองรับงานสั้นแบบโต้ตอบได้เมื่อจับคู่กับ RAM ระบบจำนวนมาก |
| ชุมชน วันที่ 9–10 ตุลาคม: RX 9060 XT 16 GB, Ryzen 7 9800X3D, 64 GB DDR5-6000, Windows 11 | เอนจิน 0.1.40.3; IQ2_XS; หน้าต่าง 122,880 โทเค็น; prefill 8,192; อินพุตใหม่ 8,019 โทเค็น ระดับการให้เหตุผลต่ำ; รันสามรอบ | มัธยฐานพรอมป์ต์ 879.4 โทเค็น/วินาที เอาต์พุต 56.3 โทเค็น/วินาที รวม 11.212 วินาที | สำหรับอินพุตยาวระดับเอกสาร การตั้งค่าพรอมป์ต์อาจสำคัญพอ ๆ กับการ์ดที่เร็วขึ้น |
| ผลวัดของโครงการ ซึ่งบันทึกไว้ภายในวันที่ 23 ตุลาคม: M4 Mac mini หน่วยความจำรวม 32 GB | Gyro-S; สตรีมผู้เชี่ยวชาญจาก SSD; พื้นที่ผู้เชี่ยวชาญ 11–12 GB; ไม่มีชั้น draft; เรื่องเล่า 120 โทเค็น; ไม่ระบุหน้าต่างรวม | มัธยฐานเอาต์พุต 9.14 โทเค็น/วินาทีจากห้าคู่ที่สลับกัน; พรอมป์ต์แยก 4,065 โทเค็นอ่านได้ 109 โทเค็น/วินาที | เครื่องขนาดกะทัดรัดรันโมเดลใหญ่ได้ โดยแลกกับเวลารอ |
แหล่งที่มา: รายงาน RTX 3060, รายงาน RX 9060 XT, ผลวัดบน Mac รายงานเหล่านี้เก่ากว่าหรือแตกต่างจากแอปรุ่นที่ออกวันนี้
ตัวอย่าง RTX 3060 มีประโยชน์เพราะรวมช่วงรอก่อนมีเอาต์พุตด้วย อินเทอร์เฟซที่แสดงความเร็วประมาณ 43 โทเค็นต่อวินาทียังอาจหยุดรอขณะอ่านคำถาม รายงานยังบันทึกการลดความเร็วจากความร้อนและกิจกรรมเบื้องหลังที่ไม่ได้ควบคุม คุณค่าจึงอยู่ที่การบอกขอบเขตจริงของเครื่องหนึ่งเครื่อง แทนที่จะเป็นสเปก GPU ในอุดมคติ
สำหรับผู้ใช้ Radeon มีหลักฐานของกระบวนการทำงานที่เป็นรูปธรรมเกินกว่าการวนวัดความเร็ว ผู้ร่วมทดสอบรันงาน TypeScript สังเคราะห์สามงานผ่านไคลเอนต์เขียนโค้ด โดยทำงานละสามครั้งต่อโมเดล ทั้ง IQ2_XS และ IQ3_XXS ผ่านการรันงานทั้งเก้าครั้ง การตั้งค่า IQ2 ทำงานที่มีขอบเขตเหล่านั้นเสร็จเร็วกว่าและใช้หน่วยความจำเครื่องหลักน้อยกว่า ผลนี้สนับสนุนให้ลองงานเขียนโค้ดที่ทดสอบได้ แต่ไม่ได้ยืนยันคุณภาพเท่ากันบนคลังโค้ดที่ไม่คุ้นเคย การเปรียบเทียบงานเขียนโค้ดและชุดข้อมูลทดสอบ
ตัวอย่าง Mac ตอบอีกคำถามหนึ่งว่า ระบบ 32 GB ที่ค่อนข้างกะทัดรัดพอจะเข้าร่วมได้หรือไม่ คำตอบคือได้ ภายใต้การตั้งค่าสตรีมที่เผยแพร่ แต่พรอมป์ต์ IQ3_XXS อีกชุดที่ยาวประมาณ 30,000 โทเค็นในเอกสาร Mac ใช้เวลา 5.6 นาทีก่อนมีเอาต์พุตแรก งานแบตช์ที่รอได้กับผู้ช่วยที่สะดุดง่ายเมื่อถูกขัดจังหวะยอมรับความหน่วงได้ต่างกัน ผลวัดการสตรีมบน Mac
นี่คือทางเลือกที่ผู้อ่านควรนำกลับไปใช้ ใช้คำถามสั้นเพื่อดูพฤติกรรมการโต้ตอบ ใช้เอกสารยาวเพื่อดูต้นทุนของพรอมป์ต์ และใช้งานที่ตรวจสอบได้เพื่อดูว่าคำตอบมีประโยชน์หรือไม่ ตัวเลขเพียงตัวเดียวไม่อาจแทนทั้งสามด้านได้
การแก้ไขในเดือนตุลาคมแสดงว่าทำไมควรจดเลขรุ่นไว้ในบันทึกการตั้งค่า
รุ่นวันที่ 23 ตุลาคมรายงานว่า ความเร็วตอบเพิ่มขึ้น 6–19% บนเครื่องทดสอบ Windows Strix Halo ที่ใช้ IQ3_S โดยวัดสามรอบแบบจับคู่เทียบกับ 0.2.2 รุ่นนี้ยังมีแพ็กเกจเอนจิน Intel Arc Linux SYCL ซึ่งทดสอบด้วยการ์ด A750 การร่างด้วย DFlash2 มีเฉพาะ Terminal และต้องเลือกเปิดเอง ส่วน Auto ยังเลือก MTP เพราะทางเลือกใหม่ยังไม่ได้ชนะในทุกลักษณะงาน ผลวัดและข้อจำกัดของ 0.2.3
การปรับปรุงเหล่านี้มาคู่กับงานบำรุงรักษาซอฟต์แวร์ตามปกติ แท็ก v0.2.1.2 วันที่ 20 ตุลาคมแก้ปัญหาการเริ่ม Strix Halo บน Windows คู่มือฮาร์ดแวร์อธิบายปัญหาเดิมว่า การลงทะเบียนพื้นที่ผู้เชี่ยวชาญใช้หน่วยความจำ GPU ที่ว่างอยู่จนหมด จึงไม่มีช่องให้แคช ชิปที่รองรับกับตัวติดตั้งยังไม่เพียงพอ จนกว่าจะจัดการความรับผิดชอบในการใช้หน่วยความจำได้ถูกต้อง v0.2.1.2, คำอธิบายการเริ่ม Strix Halo
ปัจจุบันยังมีจุดติดขัดอยู่ด้วย Issue #3810 ซึ่งเปิดวันที่ 23 ตุลาคม รายงานว่าการตั้งค่า CUDA บน Windows ล้มเหลวจากปัญหาที่เกี่ยวกับเมทาดาทาการมองภาพในแพ็กเกจ ณ วันสิ้นสุดการค้นคว้าของบทความ นี่คือรายงานจากผู้ใช้ที่รอการแก้ไข ไม่ใช่หลักฐานว่าการติดตั้ง Windows ทุกครั้งจะล้มเหลว หากคุณใช้เส้นทางเดียวกัน ควรตรวจ issue และบันทึกรุ่นถัดไปก่อนใช้เวลาหลายชั่วโมงปรับโมเดลใหม่ รายงานการตั้งค่าบน Windows
การอัปเกรดก็ควรใส่ใจเช่นกัน บันทึกของ 0.2.3 แนะนำให้ผู้ใช้ 0.2.0-beta ถึง 0.2.1.2 รันตัวติดตั้ง Terminal อีกครั้ง เพราะรุ่นเหล่านั้นเปลี่ยนส่วนประกอบ Control เองไม่ได้ ตัวติดตั้งจะเก็บโมเดลและการตั้งค่าไว้ สำหรับ Mac ควรตรวจว่าแพ็กเกจที่ลงนามแล้วซึ่งต้องการปรากฏจริงหรือยัง เพราะหัวข้อข้อจำกัดที่ทราบของรุ่นเดียวกันระบุว่า ณ เวลาประกาศ บิลด์สำหรับ Mac ยังอยู่ระหว่างการลงนาม วิธีอัปเกรด
เริ่มจากงานที่มีประโยชน์หนึ่งอย่างและบริบทสั้น ๆ
คุณไม่จำเป็นต้องทำซ้ำการสาธิตที่ใช้บริบทมหาศาลเพื่อดูว่าคุ้มค่าหรือไม่ วงจรเล็ก ๆ ที่สำเร็จจะให้ค่าตั้งต้น รวมถึงความผิดพลาดและการแก้ไข ก่อนที่คุณจะจัดสรรพื้นที่เก็บข้อมูลเพิ่มหรือปล่อยให้เอเจนต์ทำงานกว้างขึ้น
- เลือกเส้นทางที่เอกสารระบุสำหรับฮาร์ดแวร์ของคุณ เปิด หน้ารุ่นทางการ แล้วเลือกระบบปฏิบัติการและแพ็กเกจ GPU ให้ตรง จดรุ่นแอปกับรุ่นเอนจินแยกกัน เก็บชุดติดตั้งที่ใช้งานได้อยู่ไว้ขณะประเมินการอัปเกรด
- เลือกโมเดลจากหน่วยความจำว่าง ภาษา และงาน ปิดแอปที่ใช้ทรัพยากรมากในครั้งแรก เริ่มจากขนาดที่แนะนำ บริบทราว 8K และคำขอพร้อมกันหนึ่งรายการ เก็บไฟล์โมเดลบน SSD ในเครื่อง
- ใช้ขั้นตอนตั้งค่าที่มีคำแนะนำ หน้าจอเลือกโมเดลหรือ
strata launchเปิดให้ตั้งค่าโมเดล พื้นที่จัดเก็บ บริบท รูปภาพ และการเข้าถึง คงการเข้าถึงเฉพาะในเครื่องและสิทธิ์ Manual ไว้สำหรับการฝึกเขียนโค้ดครั้งแรก คู่มือ Terminal - ถามสิ่งที่คุณตรวจสอบได้ ลองฟังก์ชันเล็กพร้อมชุดทดสอบ คำถามสามข้อเกี่ยวกับเอกสารที่ให้ไป หรือภาพหน้าจอที่มีป้ายกำกับซึ่งรู้คำตอบอยู่แล้ว บันทึกพรอมป์ต์และตรวจคำตอบกับแหล่งข้อมูลจริงหรือผลทดสอบ
- วัดเวลารอทั้งหมด จดเวลาเริ่มต้น เวลาก่อนเอาต์พุตแรก เวลารวมของงาน การใช้หน่วยความจำสูงสุด และความถูกต้อง จากนั้นทำซ้ำหนึ่งครั้งด้วยคำถามต่อเนื่องที่ใช้แคช และอีกครั้งด้วยพรอมป์ต์ใหม่ คงการตั้งค่าการร่างและการให้เหตุผลระหว่างการเปรียบเทียบนี้
- เพิ่มความซับซ้อนทีละตัวแปร เพิ่มบริบทเฉพาะเมื่องานจำเป็นต้องใช้ ประเมินรูปภาพ โมเดลอื่น หรือการเชื่อมต่อไคลเอนต์เขียนโค้ดแยกกัน เพื่อให้เมื่อเกิดการถดถอยจะระบุจุดตรวจสอบได้ชัดเจน
สำหรับรายงานประสิทธิภาพที่แบ่งปันได้ Strata มี strata bench run โปรโตคอลมาตรฐานของมันยังเป็น ฉบับร่างที่รอการตรวจสอบด้วยโครงการนำร่อง ณ วันที่ 23 ตุลาคม และแยกการโหลดโมเดลออกจากการอนุมานที่จับเวลาอย่างชัดเจน นิสัยสำคัญนี้มีประโยชน์ได้ทันที คือแนบฮาร์ดแวร์ การควอนไทซ์ ค่าที่มีผลจริง และผลลัพธ์ของงานไปกับตัวเลข โปรโตคอลเบนช์มาร์ก
แม้อนุมานในเครื่อง ก็ยังต้องตัดสินใจเรื่องการเชื่อมต่อรอบข้าง
เอกสารความเป็นส่วนตัวของ Strata ระบุว่าไม่มีเทเลเมทรีการใช้งาน และรันโมเดลที่ดาวน์โหลดแล้วแบบออฟไลน์ได้ การค้นหาเว็บ หน้าที่เปิด บริการโมเดลระยะไกล อุโมงค์เชื่อมต่อ และเครื่องมือที่ตั้งค่าไว้จะสร้างการเชื่อมต่อภายนอกเมื่อใช้งาน ดังนั้นบทสนทนากับโมเดลที่เป็นส่วนตัวจึงต้องมีกระบวนการทำงานรอบข้างที่เป็นส่วนตัวด้วย พฤติกรรมเครือข่ายและการดาวน์โหลด
เรื่องนี้เกี่ยวข้องโดยตรงกับตัวอย่างเอกสารและการเขียนโค้ด ผู้ช่วยที่อ่านไฟล์และรันคำสั่งได้มีความสามารถเกินกว่าการสร้างข้อความ ก่อนส่งข้อมูลลับให้ ควรตรวจโฟลเดอร์ทำงาน คำสั่งที่เสนออย่างละเอียด และปลายทางเครื่องมือภายนอกทุกจุด เก็บต้นฉบับและประวัติเวอร์ชันไว้เพื่อให้กู้คืนจากการแก้ไขที่ผิดพลาดได้
ตัวรับคำขออนุมานเริ่มต้นใช้ 127.0.0.1 การเปิดตัวรับคำขอบนเครือข่ายเปลี่ยนว่าใครบ้างเข้าถึงได้ Strata มีเอกสารเรื่องคีย์ API และตัวรับคำขอสำหรับแบ่งปันแยกต่างหาก แต่ผู้เปิดการเข้าถึงยังต้องรับผิดชอบการตัดสินใจนั้น API ที่เข้ากันได้ทำให้ต่อไคลเอนต์สะดวกขึ้น ไม่ได้ทำให้การตั้งค่าไคลเอนต์ทุกแบบเป็นส่วนตัว นโยบายความปลอดภัย
Project Maya แสดงว่าแนวคิดนี้ไปได้ไกลเพียงใดและต้องจ่ายอะไรบ้าง
พัฒนาการในภาพกว้างคือกลยุทธ์รันไทม์นี้กำลังถูกดัดแปลงให้ใช้กับโมเดลตระกูลอื่น Project Maya ให้เครดิต Strata อย่างชัดเจนว่าเป็นจุดเริ่มต้นของเอนจิน เซิร์ฟเวอร์ และแดชบอร์ด พร้อมงานเพิ่มเติมจำนวนมากเพื่อรองรับโมเดลของตน เป้าหมายที่เอกสารระบุได้แก่ GLM-5.3-Flash, 321B และ DeepSeek-V4.1-Flash-1017, 748B นี่คือโครงการแยกต่างหาก ไม่ใช่ตัวเลือกในเมนูโมเดลของ Strata โมเดลและเครดิตของ Maya
GLM Maya-S มีขนาดดาวน์โหลด 96.5 GB ส่วน DeepSeek Maya-S ใช้พื้นที่ 340 GB รวมตาราง Engram ตัวอย่างจากชุมชนจับคู่ RTX 5090 หนึ่งใบกับ Ryzen 9 7950X และ RAM 96 GB โดยรายงานว่า GLM Maya-M ทำได้มากกว่า 30 โทเค็นต่อวินาที เงื่อนไขเหล่านี้อธิบายว่าทำไมคำว่า “GPU ใบเดียว” จึงบอกการตั้งค่าฮาร์ดแวร์ทั่วไปได้ไม่ครบ ไฟล์ Maya และรายงานฮาร์ดแวร์
โอกาสนี้มีอยู่จริง เครื่องหนึ่งสามารถผสานหลายระดับของพื้นที่จัดเก็บและการคำนวณ เพื่อให้บริการโมเดลที่มีน้ำหนักทั้งหมดใหญ่กว่าหน่วยความจำของตัวเร่งได้ แต่ต้นทุนก็เติบโตด้วย การดาวน์โหลดหลายร้อยกิกะไบต์ เคอร์เนลเฉพาะโมเดล RAM ระบบที่ต้องเผื่อ และการรองรับแพลตฟอร์มเชิงทดลองล้วนเป็นภาระที่มีนัยสำคัญ การพอร์ตโมเดลใหญ่สำเร็จไม่ได้ยืนยันว่ามีตัวโหลดสากลสำหรับทุกสถาปัตยกรรม
สำหรับผู้อ่านส่วนใหญ่ Maya ยังเป็นพัฒนาการที่ควรติดตาม ก่อนจะเป็นตัวเลือกที่แนะนำให้เปลี่ยนไปใช้ คำถามที่มีประโยชน์คือโมเดลอื่นแก้งานที่โมเดลปัจจุบันทำไม่ได้หรือไม่ และให้ประโยชน์มากพอจะคุ้มฮาร์ดแวร์กับการดูแลเพิ่มหรือเปล่า จำนวนพารามิเตอร์อย่างเดียวตอบคำถามนี้ไม่ได้
หมุดหมายถัดไปคืองานที่พึ่งพาได้ และข้อเสนอสาธารณะชี้ไปทางนั้น
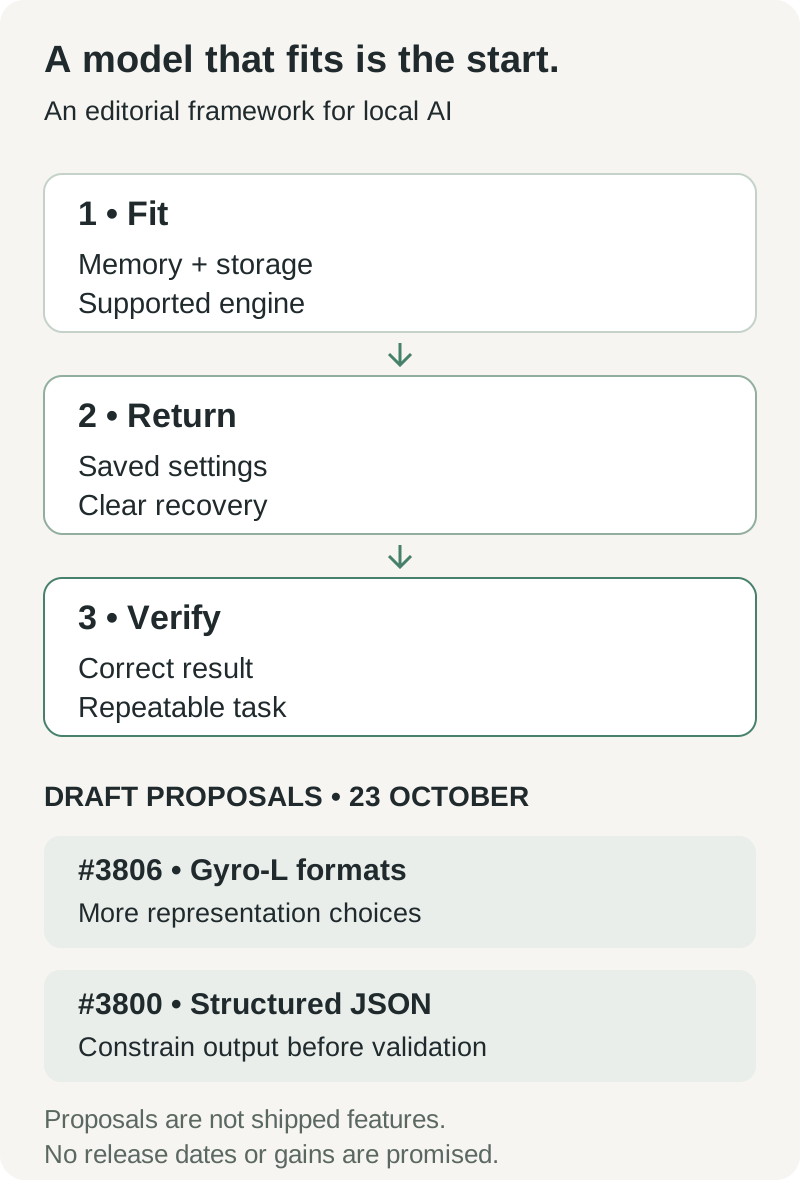
กรอบวิเคราะห์ต้นฉบับของกองบรรณาธิการ ลำดับด้านบนอธิบายเกณฑ์สำหรับนำมาใช้งาน ส่วนแถวด้านล่างระบุข้อเสนอสาธารณะที่ตรวจสอบวันที่ 23 ตุลาคม นี่ไม่ใช่กำหนดการออกเวอร์ชันที่รับปากไว้หรือการคาดการณ์ประสิทธิภาพ
Pull request ฉบับร่างที่ยังเปิดอยู่สองรายการให้สัญญาณเป็นรูปธรรมกว่าแผนรุ่น 2.0 ที่จินตนาการขึ้น #3806 เสนอการรองรับรูปแบบ trellis ของ Gyro-L ที่ปัจจุบันยังไม่รองรับ ส่วน #3800 เสนอการมาสก์โทเค็นสำหรับเอาต์พุต JSON ที่มีโครงสร้าง เพื่อให้การสร้างที่ไม่ถูกต้องต้องส่งคำขอใหม่ทั้งหมดน้อยครั้งลง ทั้งสองยังเป็นฉบับร่าง ณ วันที่ 23 ตุลาคม จึงยังไม่ควรอยู่ในรายการความสามารถที่ส่งมอบแล้ว ข้อเสนอ Gyro-L, ข้อเสนอเอาต์พุตมีโครงสร้าง
หากงานลักษณะนี้เข้าสู่รุ่นที่เชื่อถือได้ งานในเครื่องสองกลุ่มจะได้ประโยชน์ การรองรับรูปแบบที่ดีขึ้นให้วิธีแลกหน่วยความจำกับคุณภาพมากขึ้น ส่วนเอาต์พุตมีโครงสร้างที่น่าเชื่อถือขึ้นช่วยให้งานสกัดข้อมูลเอกสาร การติดป้ายกำกับ และการเรียกเครื่องมือสร้างข้อมูลที่โปรแกรมอื่นตรวจสอบได้อย่างปลอดภัย การปรับปรุงอย่างหลังอาจดูไม่หวือหวาในวิดีโอ แต่มีโอกาสสร้างคุณค่ามากกว่าในกระบวนการที่ทำซ้ำ
ความคาดหวังของเรามีเงื่อนไข การอนุมานส่วนบุคคลจะมีประโยชน์ขึ้นเมื่อรันไทม์เก็บค่าที่ใช้งานได้ ควบคุมการใช้หน่วยความจำให้อยู่ในขอบเขต และฟื้นตัวจากความผิดพลาดได้ การพอร์ตแบ็กเอนด์เพิ่มและการร่างที่ฉลาดขึ้นช่วยได้ก็ต่อเมื่อผู้อ่านเชื่อมสิ่งเหล่านั้นกับงานจริง โมเดลบนเดสก์ท็อปจะสมควรมีที่อยู่ได้ด้วยการสร้างงานที่คุณตรวจสอบและทำซ้ำได้
คำถามสำหรับคอมพิวเตอร์ AI ในเครื่องตัวถัดไปจึงเรียบง่าย พรุ่งนี้คุณจะมอบงานที่มีประโยชน์อย่างเดิมให้มันอีก แล้วเชื่อใจกระบวนการมากพอจะใช้ต่อได้หรือไม่?
แหล่งที่มาและบันทึกสำหรับอ่านต่อ
สิ้นสุดการค้นคว้า ณ 23 ตุลาคม 2026 สถานะรุ่น สถานะ issue และแพ็กเกจที่มีอาจเปลี่ยนหลังจากวันนั้น ผลวัดด้านบนคงวันที่เผยแพร่และการตั้งค่าดั้งเดิมไว้ ไม่มีการทำเบนช์มาร์กการอนุมานใหม่สำหรับบทความนี้
- Strata 0.2.0-beta, v0.2.1.2 และ บันทึกรุ่น 0.2.3
- คู่มือโมเดล Strata, การรองรับ Qwen3.6 และ เอกสาร Gyro
- ชุดเบนช์มาร์กจากชุมชน, เอกสาร Mac และ ร่างโปรโตคอลเบนช์มาร์ก
- Project Maya, ภาพหน้าจอ Strata ทางการ และ สัญญาอนุญาตของคลังโค้ด
เก็บการตัดสินใจเรื่อง AI ในเครื่องไว้คู่กับหลักฐาน
เมื่อเปรียบเทียบการตั้งค่า ให้เก็บลิงก์แหล่งข้อมูล ค่าฮาร์ดแวร์ ผลลัพธ์ของงาน และการแก้ไขไว้ด้วยกัน Telli.sh ช่วยจัดระเบียบบันทึกการค้นคว้าและบทสรุปเหล่านี้ได้ เมื่อการตั้งค่าของคุณเปลี่ยนไป สร้างบัญชี Telli.sh