[Nota Lapangan AI Setempat 01] Ujian Seterusnya untuk Strata: Menjadikan Model Besar Berguna pada PC Anda
Strata beta 0.2 kini menjadi aplikasi desktop. Tiga contoh perkakasan pengguna yang diterbitkan memperlihatkan kegunaannya, keperluan memori dan hala tuju AI setempat.
Demo AI setempat yang paling menarik ialah demo yang masih boleh digunakan minggu hadapan. Model besar yang memberikan jawapan bijak pada PC permainan memang suatu pencapaian; membuka perbualan yang sama esok, mencari fail model dan membenarkannya menyunting projek dengan selamat pula ialah permulaan sebuah alat yang berguna.
Strata mula melangkah ke kategori kedua melalui 0.2.0-beta pada 19 Oktober 2026: aplikasi desktop, antara muka Terminal dan enjin yang dibungkus secara berasingan. Menjelang 23 Oktober, 0.2.3 sudah tersedia. Nama sebenar beta itu penting sewaktu memilih muat turun: ini ialah siri keluaran 0.2, bukannya pengumuman versi 2.0 akan datang. Keluaran beta, keluaran 23 Oktober
Siri pertama Nota Lapangan AI Setempat ini meneliti manfaat perubahan tersebut kepada seseorang yang sudah mempunyai komputer. Kita akan mengaitkan antara muka baharu dengan tiga contoh perkakasan yang telah diterbitkan, membezakan pilihan model daripada seni bina yang berlainan, serta meneliti perkembangan yang boleh menjadikan inferens setempat suatu perkhidmatan harian yang boleh diharap.
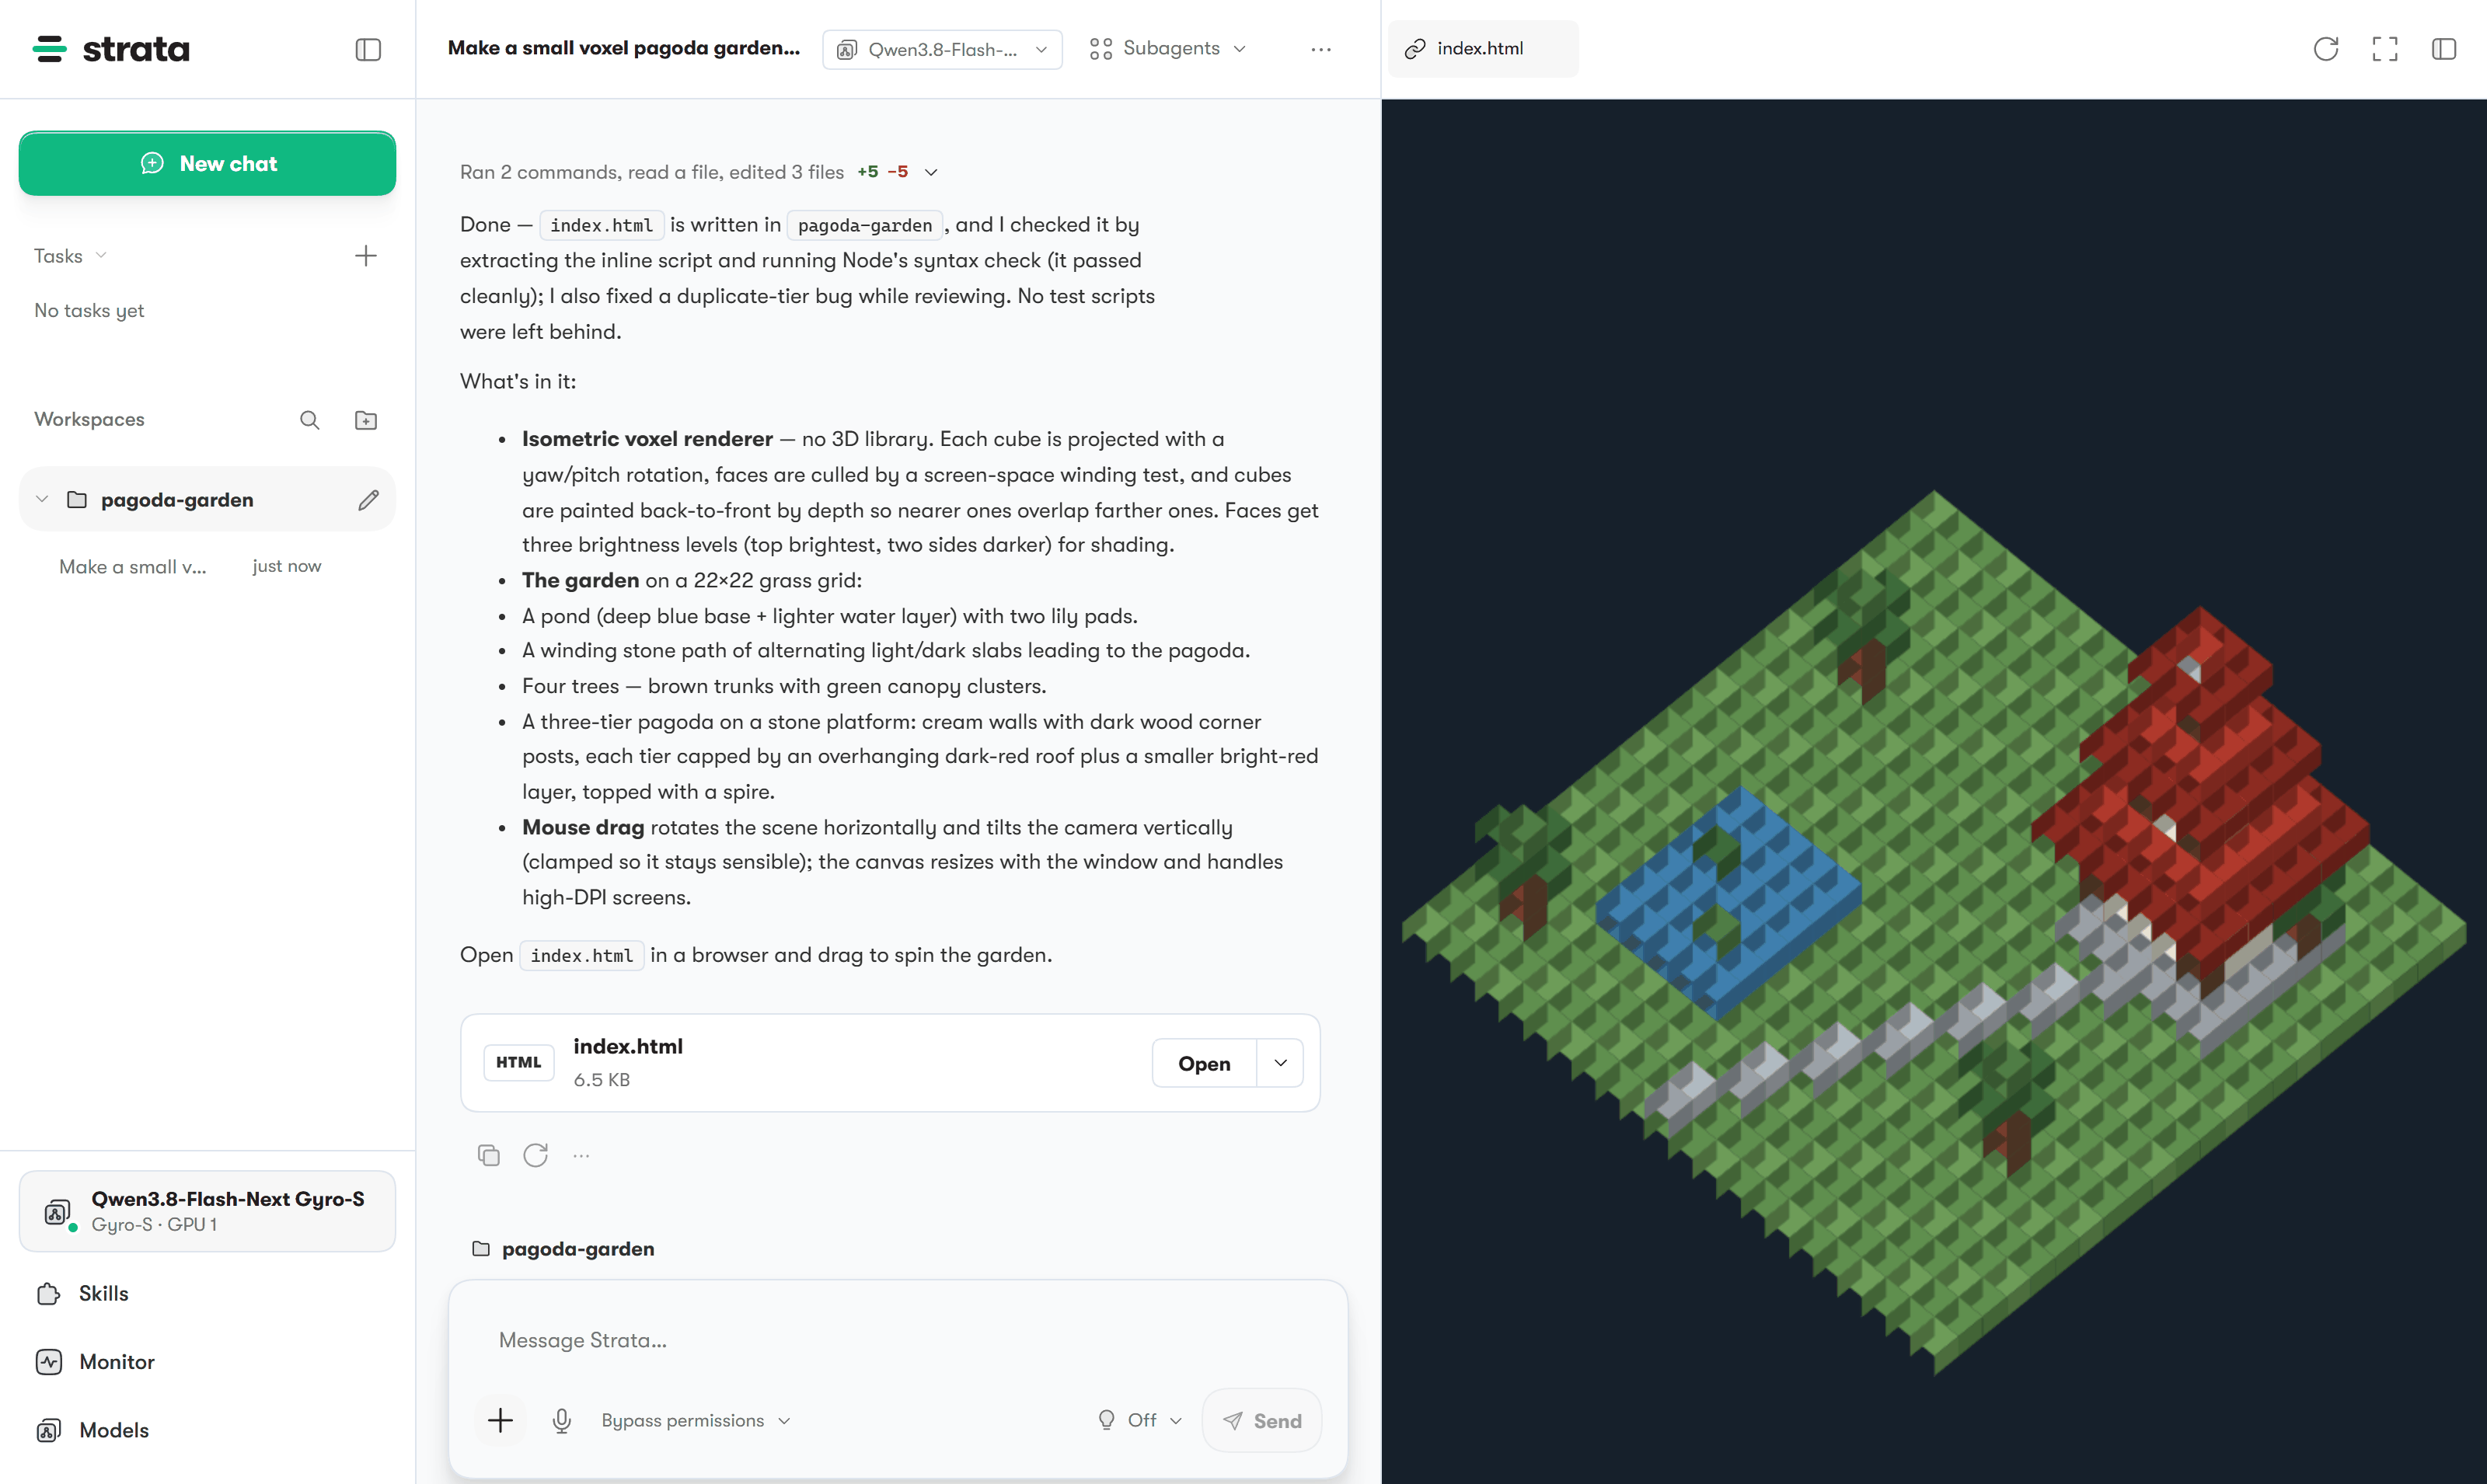
Tangkapan skrin rasmi Strata daripada repositori 0.2.3, memaparkan perbualan pengekodan dan pratonton HTML. Gambar ini menerangkan antara mukanya, bukannya ujian yang dijalankan untuk artikel ini. © 2026 Niko1221 dan penyumbang Strata; sumber, lesen MIT.

Beta menjadikan enjin itu alat yang boleh digunakan semula
Aplikasi desktop menghimpunkan pemilihan model, pengurusan storan, sembang, pemantauan perkakasan dan ruang kerja pengekodan. Mod kebenaran Manual meminta persetujuan sebelum membuat perubahan; mod Bypass yang lebih terbuka memberikan kebebasan lebih luas kepada ejen. Terminal menawarkan aliran berpandu strata launch serta sambungan kepada klien pengekodan. Kedua-duanya berkongsi enjin asas yang sama. Nota ciri 0.2.0-beta
Bagi pembangun, ini membuka contoh kegunaan yang mudah: minta penghurai kecil dalam projek percubaan yang boleh dibuang, semak fail yang dicadangkan, jalankan ujiannya, kemudian sambung perbualan dengan contoh yang gagal. Bagi pekerja yang kerap mengendalikan dokumen, tugas awal yang setanding ialah soalan berskop jelas tentang petikan yang dibekalkan, disusuli permintaan petikan sokongan yang tepat. Kedua-dua senario ini tidak memerlukan model dijadikan pekerja autonomi.
Peningkatan praktikalnya ialah kesinambungan. Pemilih model bergrafik mengurangkan kemungkinan memulakan konfigurasi yang tidak serasi; pemantau perkakasan membantu menerangkan sebab aplikasi lain mengubah prestasi; pratetap yang disimpan menjadikan percubaan berjaya sesuatu yang boleh diulangi. Ciri-ciri ini tidak meningkatkan kebolehan penaakulan model. Sebaliknya, ia mengurangkan kerja antara tersedianya kebolehan itu dengan penggunaannya secara bertanggungjawab.
Pada pandangan kami, persaingan AI setempat seterusnya tertumpu pada jarak tersebut. Pengalaman yang berjaya akan memudahkan pengguna mengekalkan konfigurasi yang baik, memahami kegagalan dan menyemak tindakan berisiko.
Seluruh sistem memori komputer menjadi sebahagian daripada model
Sasaran utama Strata ialah Qwen3.8-Flash-Next, yang terasnya mempunyai 125 bilion parameter. Strategi pelaksanaannya menggunakan memori GPU bagi pengiraan umum dan pakar yang kerap diperlukan, RAM sistem serta pelaksanaan CPU untuk pakar lain, dan capaian SSD bagi jadual carian n-gram. Kad grafik yang lebih besar membantu, namun RAM dan storan komputer tetap menjadi sebahagian daripada laluan inferens. Gambaran projek, reka bentuk pelaksanaan
Bayangkan PC sebagai bengkel dengan beberapa permukaan kerja. Ruang pada permukaan paling pantas adalah terhad, maka runtime perlu menentukan kerja yang patut kekal di situ. Keputusan yang lebih baik boleh menjadikan perkakasan sedia ada lebih berguna; ia tidak menjadikan setiap permukaan sama pantas.
Tiga ukuran perlu diberi perhatian secara berasingan. Muat turun menggunakan ruang storan. Pemberat yang dimuatkan dan penimbal runtime menggunakan memori. Tetingkap konteks menambah keadaan kerja apabila perbualan semakin panjang. Oleh itu, saiz fail sahaja tidak memberitahu jumlah VRAM yang diperlukan atau kepantasan jawapan pertama akan muncul.
Panduan permulaan semasa projek menyarankan sekurang-kurangnya 32 GB gabungan RAM dan VRAM, dengan kira-kira 80 GB ruang cakera kosong bagi persediaan lazimnya. Ini panduan awal, bukannya jaminan bahawa setiap model, panjang konteks atau sistem pengendalian boleh dimuatkan dalam peruntukan itu. Komputer riba asas 16 GB tidak wajar dianggap setara dengan komputer desktop di bawah. Keperluan perkakasan
Lebih banyak nama model tidak semestinya bermakna lebih banyak seni bina
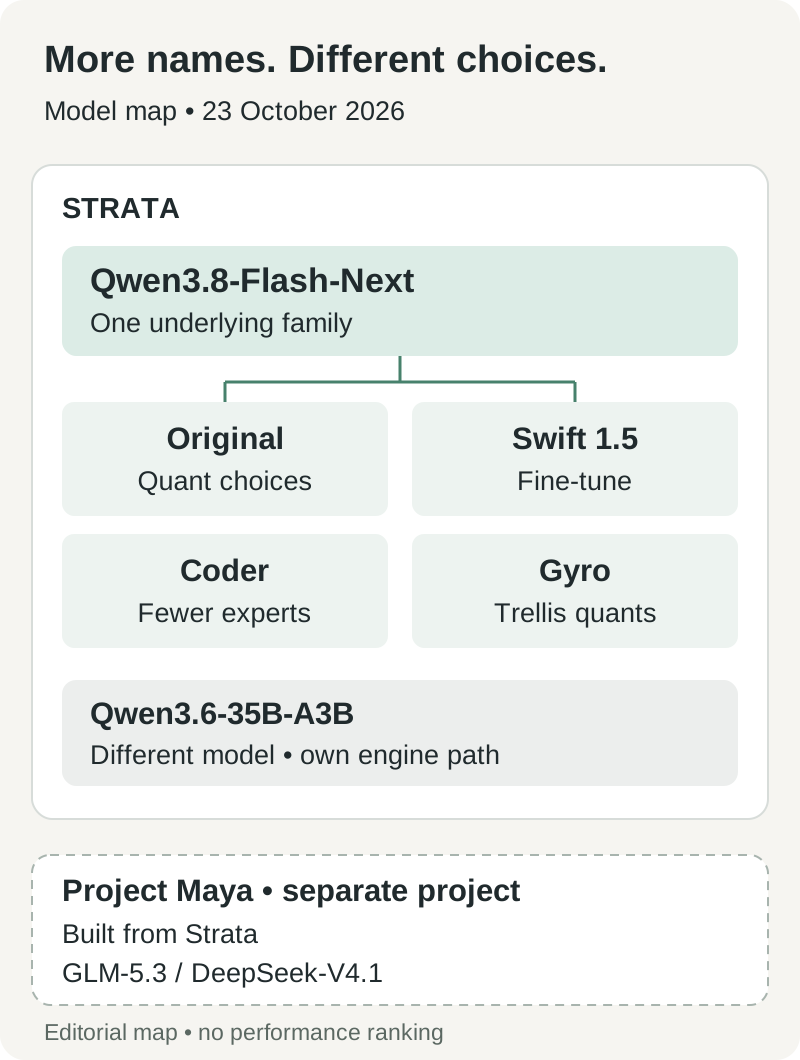
Peta editorial asli tentang hubungan model yang didokumenkan, disemak pada 23 Oktober. Cabangnya menunjukkan susur galur dan sokongan runtime, bukannya mutu setara atau fail yang boleh saling menggantikan.
Pilihan Flash-Next original, Swift 1.5, Coder dan Gyro menjawab keperluan berbeza dalam keluarga asas yang sama. Swift mengubah tingkah laku melalui penalaan halus. Coder membuang pakar yang dipilih kerana kurang berguna bagi tumpuan pengekodannya. Gyro mengubah cara pemberat diwakilkan. Menganggap nama-nama itu sebagai empat model asas yang tidak berkaitan menyebabkan katalog kelihatan lebih luas daripada keadaan sebenar. Panduan model
Perbezaan ini membawa kesan nyata. Coder mengekalkan 256 daripada 512 pakar pada setiap lapisan, dan projek memberi amaran tentang prestasi umum serta bahasa selain bahasa Inggeris yang lebih lemah. Model yang dipilih kerana sesuai pada desktop pengekodan tidak sepatutnya terus menjadi pilihan lalai untuk soalan dokumen berbilang bahasa. Penaakulan Swift yang lebih singkat boleh mengurangkan masa keseluruhan tanpa menjadikan perkakasan menjana setiap token dengan lebih pantas. Kompromi antara versi
Gyro-S memerlukan muat turun 58.5 GB, walaupun keperluan memori pemberat yang didokumenkan merentasi RAM dan VRAM ialah 27.6 GB. Jadual n-gramnya kekal pada SSD. Penilaian projek meletakkan mutunya di bawah pilihan bit rendah yang lebih besar; penggunaan memori yang lebih kecil datang bersama pengorbanan. Dokumentasi Gyro
Terdapat juga model kedua yang benar-benar berbeza: Qwen3.6-35B-A3B, model mixture-of-experts 35B dengan 3B parameter aktif, yang dikendalikan melalui laluan enjin berasingan. Pilihan yang didokumenkan merangkumi imej dan permintaan serentak pada konfigurasi NVIDIA dan AMD yang disokong; enjin Mac tidak menjalankannya. Perbezaan itu menjadikannya alternatif yang berbaloi dinilai apabila angka parameter terbesar bukan keperluan sebenar anda. Sokongan Qwen3.6
Tiga komputer yang diterbitkan menunjukkan tiga bentuk kegunaan
Contoh berikut diterbitkan oleh penyumbang komuniti atau projek itu sendiri. Angkanya ialah pengukuran konfigurasi tertentu, bukannya ujian langsung untuk artikel ini. Tujuannya menunjukkan kerja yang munasabah serta kosnya, bukannya menyusun kedudukan tiga komputer menggunakan prompt yang tidak sebanding.
| Contoh yang diterbitkan | Model dan keadaan konteks | Hasil yang dilaporkan | Keputusan yang dibantu |
|---|---|---|---|
| Komuniti, 9 Oktober: RTX 3060 12 GB, Core i7-12700, 64 GB DDR4-3200, NVMe, Windows 11 | Strata 0.1.41; Q2_0 original; tetingkap 131,072 token; prompt baharu 4,096 token, 256 token output; penaakulan dan penglihatan dimatikan; tiga larian | Median 42.9 token output/s; 4.7 saat hingga token pertama; 10.6 saat keseluruhan | Kad lama 12 GB boleh menyokong kerja singkat yang interaktif apabila dipadankan dengan RAM sistem yang besar |
| Komuniti, 9–10 Oktober: RX 9060 XT 16 GB, Ryzen 7 9800X3D, 64 GB DDR5-6000, Windows 11 | Enjin 0.1.40.3; IQ2_XS; tetingkap 122,880 token; prefill 8,192; input baharu 8,019 token, penaakulan rendah; tiga larian | Median 879.4 token prompt/s, 56.3 token output/s, 11.212 saat keseluruhan | Bagi input sepanjang dokumen, konfigurasi prompt boleh sama pentingnya dengan kad yang lebih pantas |
| Pengukuran projek, didokumenkan selewat-lewatnya pada 23 Oktober: M4 Mac mini, memori bersepadu 32 GB | Gyro-S; penstriman pakar daripada SSD; arena pakar 11–12 GB; tiada lapisan draf; cerita 120 token; jumlah tetingkap tidak dinyatakan | Median 9.14 token output/s sepanjang lima pasangan berselang-seli; prompt berasingan 4,065 token dibaca pada 109 token/s | Komputer kompak boleh menjalankan model besar, dengan kompromi masa menunggu |
Sumber: laporan RTX 3060, laporan RX 9060 XT, pengukuran Mac. Laporan ini mendahului atau berbeza daripada keluaran aplikasi hari ini.
Contoh RTX 3060 berguna kerana merangkumi tempoh menunggu sebelum output bermula. Antara muka yang memaparkan kira-kira 43 token sesaat masih boleh berhenti seketika semasa membaca soalan. Laporannya turut mencatatkan kelembapan akibat haba dan aktiviti latar yang tidak dikawal; nilainya ialah gambaran had realistik sebuah komputer, bukannya spesifikasi GPU yang diidealkan.
Bagi pengguna Radeon, terdapat bukti aliran kerja sebenar di luar gelung uji kelajuan. Penyumbangnya menjalankan tiga tugasan TypeScript sintetik sebanyak tiga kali bagi setiap model melalui klien pengekodan, dengan IQ2_XS dan IQ3_XXS lulus kesemua sembilan larian tugasan. Konfigurasi IQ2 menyelesaikan tugasan berskop itu dengan lebih cepat sambil menggunakan kurang memori hos. Ini menyokong percubaan kerja pengekodan yang boleh diuji; ia tidak membuktikan mutu yang sama pada repositori yang belum dikenali. Perbandingan pengekodan dan bahan ujian
Contoh Mac menjawab soalan berlainan: adakah sistem 32 GB yang agak kompak dapat turut serta? Ya, dengan konfigurasi penstriman yang diterbitkan. Namun, prompt IQ3_XXS berasingan sepanjang kira-kira 30K token dalam dokumentasi Mac mengambil 5.6 minit hingga output pertama. Tugasan kelompok yang boleh menunggu dan pembantu yang peka terhadap gangguan mempunyai peruntukan latensi berbeza. Pengukuran penstriman Mac
Itulah pertimbangan yang patut dibawa oleh pembaca. Gunakan soalan pendek untuk mengetahui sifat interaktifnya, dokumen panjang untuk mengetahui kos prompt, dan tugasan yang disahkan untuk mengetahui sama ada jawapannya berguna. Tiada satu angka yang boleh mewakili ketiga-tiganya.
Pembaikan Oktober menunjukkan sebab nombor versi perlu dicatat semasa persediaan
Keluaran 23 Oktober melaporkan peningkatan kelajuan jawapan 6–19% pada komputer ujian Windows Strix Halo dengan IQ3_S, diukur melalui tiga larian berpasangan berbanding 0.2.2. Ia turut menyediakan pakej enjin Intel Arc Linux SYCL, dengan A750 sebagai kad yang diuji. Drafting DFlash2 hanya tersedia melalui Terminal dan perlu diaktifkan secara pilihan; Auto terus memilih MTP kerana alternatif itu belum mengatasi MTP bagi semua beban kerja. Pengukuran dan batasan 0.2.3
Peningkatan tersebut hadir bersama penyelenggaraan perisian biasa. Tag v0.2.1.2 pada 20 Oktober menangani permulaan Strix Halo pada Windows. Panduan perkakasan menerangkan masalah terdahulu: pendaftaran arena pakar menghabiskan memori GPU yang tersedia sehingga tiada slot berbaki untuk cache. Cip yang disokong dan pemasang belum memadai sehingga pemilikan memori dibetulkan. v0.2.1.2, penjelasan permulaan Strix Halo
Masih ada masalah yang belum diselesaikan. Issue #3810, dibuka pada 23 Oktober, melaporkan ranap semasa persediaan Windows CUDA yang melibatkan metadata penglihatan dalam pakej. Ini laporan pengguna yang menunggu penyelesaian pada tarikh tutup penyelidikan artikel ini, bukannya bukti bahawa semua pemasangan Windows gagal. Jika laluan anda sepadan dengannya, semak issue itu dan nota keluaran berikutnya sebelum menghabiskan masa berjam-jam menala semula model. Laporan persediaan Windows
Naik taraf juga perlu diberikan perhatian: nota 0.2.3 mengarahkan pengguna 0.2.0-beta hingga 0.2.1.2 menjalankan semula pemasang Terminal kerana versi tersebut tidak boleh menukar komponen Control sendiri. Pemasang mengekalkan model dan tetapan. Bagi Mac, semak bahawa artifak bertandatangan yang dikehendaki benar-benar sudah tersedia: bahagian batasan diketahui bagi keluaran sama menyatakan binaan Mac masih melalui proses tandatangan sewaktu diterbitkan. Arahan naik taraf
Mulakan dengan satu tugas berguna dan konteks pendek
Anda tidak perlu menghasilkan semula demo konteks yang amat besar untuk mengetahui sama ada ini berbaloi. Kitaran kecil yang berjaya memberikan garis dasar, termasuk kegagalan dan pembetulannya, sebelum anda memperuntukkan lebih banyak storan atau membenarkan ejen bertindak dengan lebih luas.
- Pilih laluan yang didokumenkan untuk perkakasan anda. Buka halaman keluaran rasmi dan pilih pakej sistem pengendalian serta GPU yang sepadan. Catat versi aplikasi dan enjin secara berasingan. Kekalkan pemasangan yang sudah berfungsi semasa menilai naik taraf.
- Pilih model mengikut memori tersedia, bahasa dan tugasan. Tutup aplikasi berat untuk percubaan pertama. Mulakan dengan saiz yang disyorkan, konteks sekitar 8K dan satu permintaan pada satu-satu masa. Letakkan fail model pada storan SSD setempat.
- Gunakan persediaan berpandu. Pemilih model desktop atau
strata launchmenyediakan tetapan model, storan, konteks, imej dan capaian. Kekalkan capaian setempat sahaja serta kebenaran Manual untuk latihan pengekodan pertama. Panduan Terminal - Tanya sesuatu yang boleh disahkan. Cuba fungsi kecil berserta ujian, tiga soalan tentang dokumen yang dibekalkan, atau tangkapan skrin dengan label yang diketahui. Simpan prompt dan semak jawapan dengan sumber sebenar atau output ujian.
- Ukur keseluruhan masa menunggu. Catat masa permulaan, masa hingga output pertama, jumlah masa tugasan, penggunaan memori puncak dan ketepatan. Kemudian ulang sekali dengan soalan susulan yang menggunakan cache dan sekali dengan prompt baharu. Kekalkan tetapan drafting dan penaakulan sepanjang perbandingan itu.
- Tambah kerumitan satu pemboleh ubah pada satu masa. Panjangkan konteks hanya apabila tugas memerlukannya. Nilai imej, model lain atau sambungan klien pengekodan secara berasingan supaya punca kemerosotan dapat dikenal pasti dengan jelas.
Untuk laporan prestasi yang boleh dikongsi, Strata menyediakan strata bench run. Protokol piawainya masih merupakan draf yang menunggu pengesahan rintis pada 23 Oktober, dan secara jelas memisahkan pemuatan model daripada inferens yang diukur masanya. Amalan pentingnya sudah berguna: sertakan perkakasan, pengkuantuman, tetapan berkesan dan hasil tugasan bersama keputusan. Protokol penanda aras
Inferens setempat masih memerlukan keputusan pada titik sambungan
Dokumentasi privasi Strata menyatakan bahawa ia tidak mempunyai telemetri penggunaan dan boleh menjalankan model yang telah dimuat turun tanpa talian. Carian web, halaman yang dibuka, perkhidmatan model jauh, terowong dan alat yang dikonfigurasikan mewujudkan sambungan luaran apabila digunakan. Oleh itu, perbualan model yang peribadi turut memerlukan aliran kerja sekeliling yang menjaga privasi. Tingkah laku rangkaian dan muat turun
Hal ini amat berkaitan dengan contoh dokumen dan pengekodan tadi. Pembantu yang boleh membaca fail dan menjalankan arahan mempunyai keupayaan melangkaui penjanaan teks. Semak folder kerjanya, arahan tepat yang dicadangkan dan sebarang titik akhir alat luaran sebelum membekalkan bahan sulit. Simpan bahan asal dan sejarah versi supaya suntingan yang salah masih boleh dipulihkan.
Pendengar inferens lalai menggunakan 127.0.0.1; membuka pendengar rangkaian mengubah siapa yang boleh mencapainya. Strata mendokumenkan kunci API dan pendengar perkongsian yang berasingan, tetapi keputusan itu tetap menjadi tanggungjawab orang yang membolehkan capaian. API yang serasi memudahkan penyambungan klien, bukannya menjadikan setiap kemungkinan konfigurasi klien bersifat peribadi. Dasar keselamatan
Project Maya menunjukkan sejauh mana idea ini berkembang serta kosnya
Perkembangan lebih luas ialah strategi runtime itu sedang disesuaikan untuk keluarga model lain. Project Maya secara jelas memberikan kredit kepada Strata sebagai titik mula enjin, pelayan dan papan pemukanya, dengan kerja besar untuk modelnya sendiri. Sasaran yang didokumenkan merangkumi GLM-5.3-Flash, 321B, dan DeepSeek-V4.1-Flash-1017, 748B. Ia projek berasingan, bukannya pilihan dalam menu model Strata. Model dan kredit Maya
Muat turun GLM Maya-S bersaiz 96.5 GB; pilihan DeepSeek Maya-S menggunakan 340 GB termasuk jadual Engram. Satu contoh komuniti memadankan sebuah RTX 5090 dengan Ryzen 9 7950X dan RAM 96 GB, serta melaporkan lebih 30 token sesaat untuk GLM Maya-M. Keadaan itu menerangkan sebab “satu GPU” belum cukup untuk menggambarkan persediaan komputer pengguna. Fail Maya dan laporan perkakasan
Peluangnya nyata: sebuah komputer boleh menggabungkan beberapa peringkat storan dan pengiraan untuk menyediakan model yang keseluruhan pemberatnya melebihi memori pemecutnya. Kos turut meningkat. Muat turun beratus-ratus gigabait, kernel khusus model, lebihan memori sistem dan sokongan platform percubaan merupakan komitmen yang besar. Kejayaan membawa model besar ke platform lain tidak membuktikan adanya pemuat sejagat untuk setiap seni bina.
Bagi kebanyakan pembaca, Maya ialah perkembangan yang wajar diperhatikan sebelum disyorkan sebagai pengganti. Soalan yang berguna ialah sama ada model lain menyelesaikan tugas yang gagal diselesaikan model semasa anda, dengan manfaat yang cukup untuk mewajarkan perkakasan serta penyelenggaraan tambahan. Jumlah parameter sahaja tidak dapat menjawab soalan itu.
Pencapaian seterusnya ialah kerja yang boleh diharap, dan cadangan awam menuju ke situ
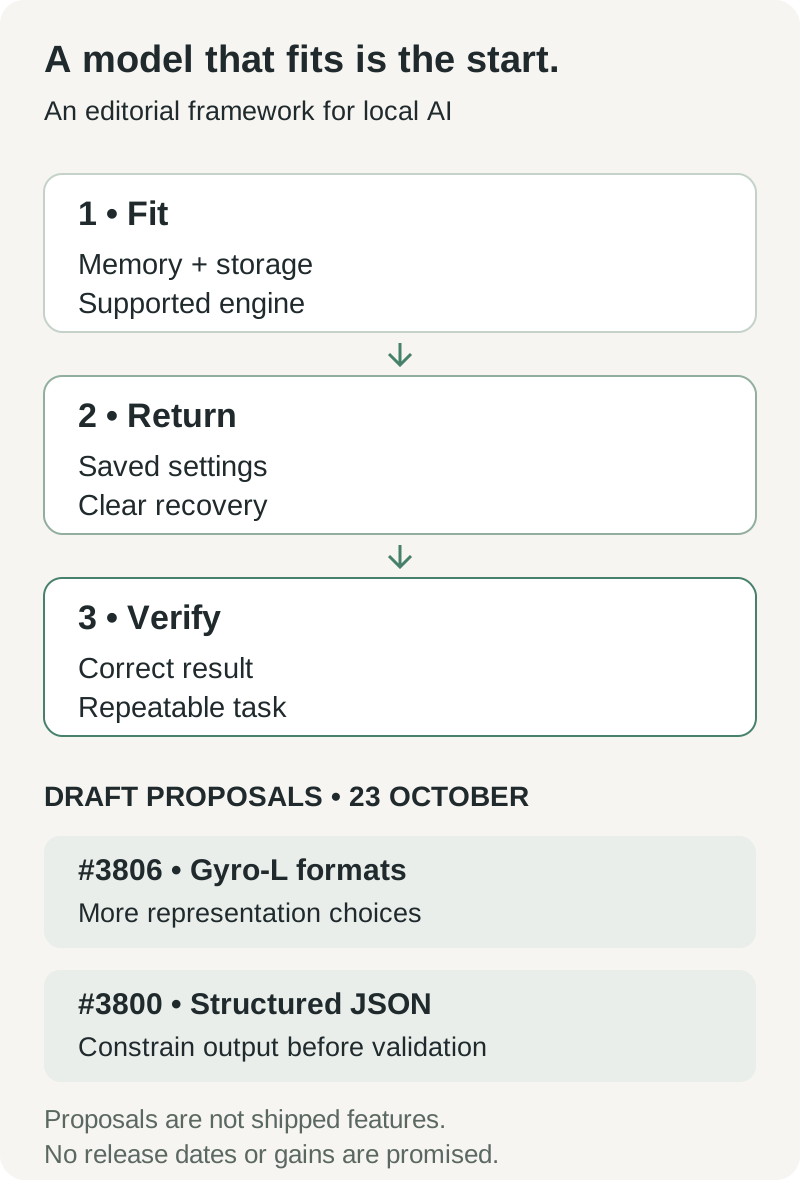
Kerangka editorial asli. Urutan atas menerangkan kriteria penggunaan; baris bawah mengenal pasti cadangan awam yang disemak pada 23 Oktober. Ini bukannya jadual keluaran yang dijanjikan atau ramalan prestasi.
Dua pull request draf yang masih terbuka memberikan petunjuk lebih nyata daripada pelan hala tuju 2.0 yang dibayangkan. #3806 mencadangkan sokongan bagi format trellis Gyro-L yang belum disokong sekarang. #3800 mencadangkan token masking bagi output JSON berstruktur supaya penjanaan tidak sah kurang memerlukan percubaan semula seluruh permintaan. Kedua-duanya masih draf pada 23 Oktober; kedua-duanya belum patut disenaraikan sebagai keupayaan yang telah dikeluarkan. Cadangan Gyro-L, cadangan output berstruktur
Jika kerja seperti ini mencapai keluaran yang boleh diharap, dua jenis beban kerja setempat akan mendapat manfaat. Sokongan format yang lebih baik memberikan pengguna lebih banyak pilihan untuk mengimbangi memori dengan mutu. Output berstruktur yang lebih boleh diharap membantu pengekstrakan dokumen, pelabelan dan panggilan alat menghasilkan data yang boleh disahkan dengan selamat oleh program lain. Peningkatan kedua kurang mengagumkan dalam video, namun berpotensi lebih bernilai dalam aliran kerja berulang.
Jangkaan kami bersyarat: inferens peribadi menjadi lebih berguna apabila runtime mengekalkan konfigurasi yang berfungsi, mengehadkan penggunaan memorinya dan pulih daripada kegagalan. Lebih banyak port backend dan drafting yang lebih bijak hanya membantu apabila pembaca boleh mengaitkannya dengan tugasan sebenar. Model desktop membuktikan nilainya dengan menghasilkan kerja yang boleh anda semak dan ulangi.
Maka soalan untuk komputer AI setempat seterusnya mudah sahaja: bolehkah anda memberikannya tugas berguna yang sama esok dan mempercayai prosesnya secukupnya untuk terus menggunakannya?
Sumber dan nota bacaan
Tarikh tutup penyelidikan: 23 Oktober 2026. Status keluaran, status issue dan artifak yang tersedia boleh berubah selepas tarikh itu. Pengukuran di atas mengekalkan tarikh penerbitan dan konfigurasi asalnya; tiada penanda aras inferens baharu dijalankan untuk artikel ini.
- Strata 0.2.0-beta, v0.2.1.2, dan nota keluaran 0.2.3.
- Panduan model Strata, sokongan Qwen3.6, dan dokumentasi Gyro.
- Koleksi penanda aras komuniti, dokumentasi Mac, dan draf protokol penanda aras.
- Project Maya, tangkapan skrin rasmi Strata, dan lesen repositorinya.
Simpan keputusan AI setempat bersama buktinya
Apabila membandingkan konfigurasi, simpan pautan sumber, tetapan perkakasan, hasil tugasan dan pembetulan bersama-sama. Telli.sh boleh membantu menyusun nota penyelidikan dan ringkasan itu seiring perkembangan persediaan anda. Cipta akaun Telli.sh