[Catatan Lapangan AI Lokal 01] Ujian Berikutnya bagi Strata: Membuat Model Besar Berguna di PC Anda
Strata versi beta 0.2 telah menjadi aplikasi desktop. Tiga contoh perangkat konsumen yang dipublikasikan menunjukkan manfaatnya, kebutuhan memorinya, dan arah AI lokal berikutnya.
Demo AI lokal yang paling menarik adalah demo yang masih bisa Anda gunakan minggu depan. Model besar yang menghasilkan jawaban cerdas di PC gaming memang sebuah pencapaian; membuka percakapan yang sama besok, menemukan berkas modelnya, dan mengizinkannya menyunting proyek dengan aman merupakan awal dari alat yang berguna.
Strata mulai masuk ke kategori kedua melalui 0.2.0-beta pada 19 Oktober 2026: aplikasi desktop, antarmuka Terminal, dan mesin yang dikemas terpisah. Pada 23 Oktober, 0.2.3 sudah hadir. Nama versi beta yang sebenarnya penting saat memilih unduhan: ini adalah lini rilis 0.2, bukan pengumuman versi 2.0 mendatang. Rilis beta, rilis 23 Oktober
Edisi pertama Catatan Lapangan AI Lokal ini membahas manfaat perubahan tersebut bagi orang yang sudah memiliki komputer. Kita akan menghubungkan antarmuka baru dengan tiga contoh perangkat keras yang telah dipublikasikan, membedakan pilihan model dari perbedaan arsitektur, dan menelaah perkembangan yang dapat membuat inferensi lokal menjadi layanan sehari-hari yang andal.
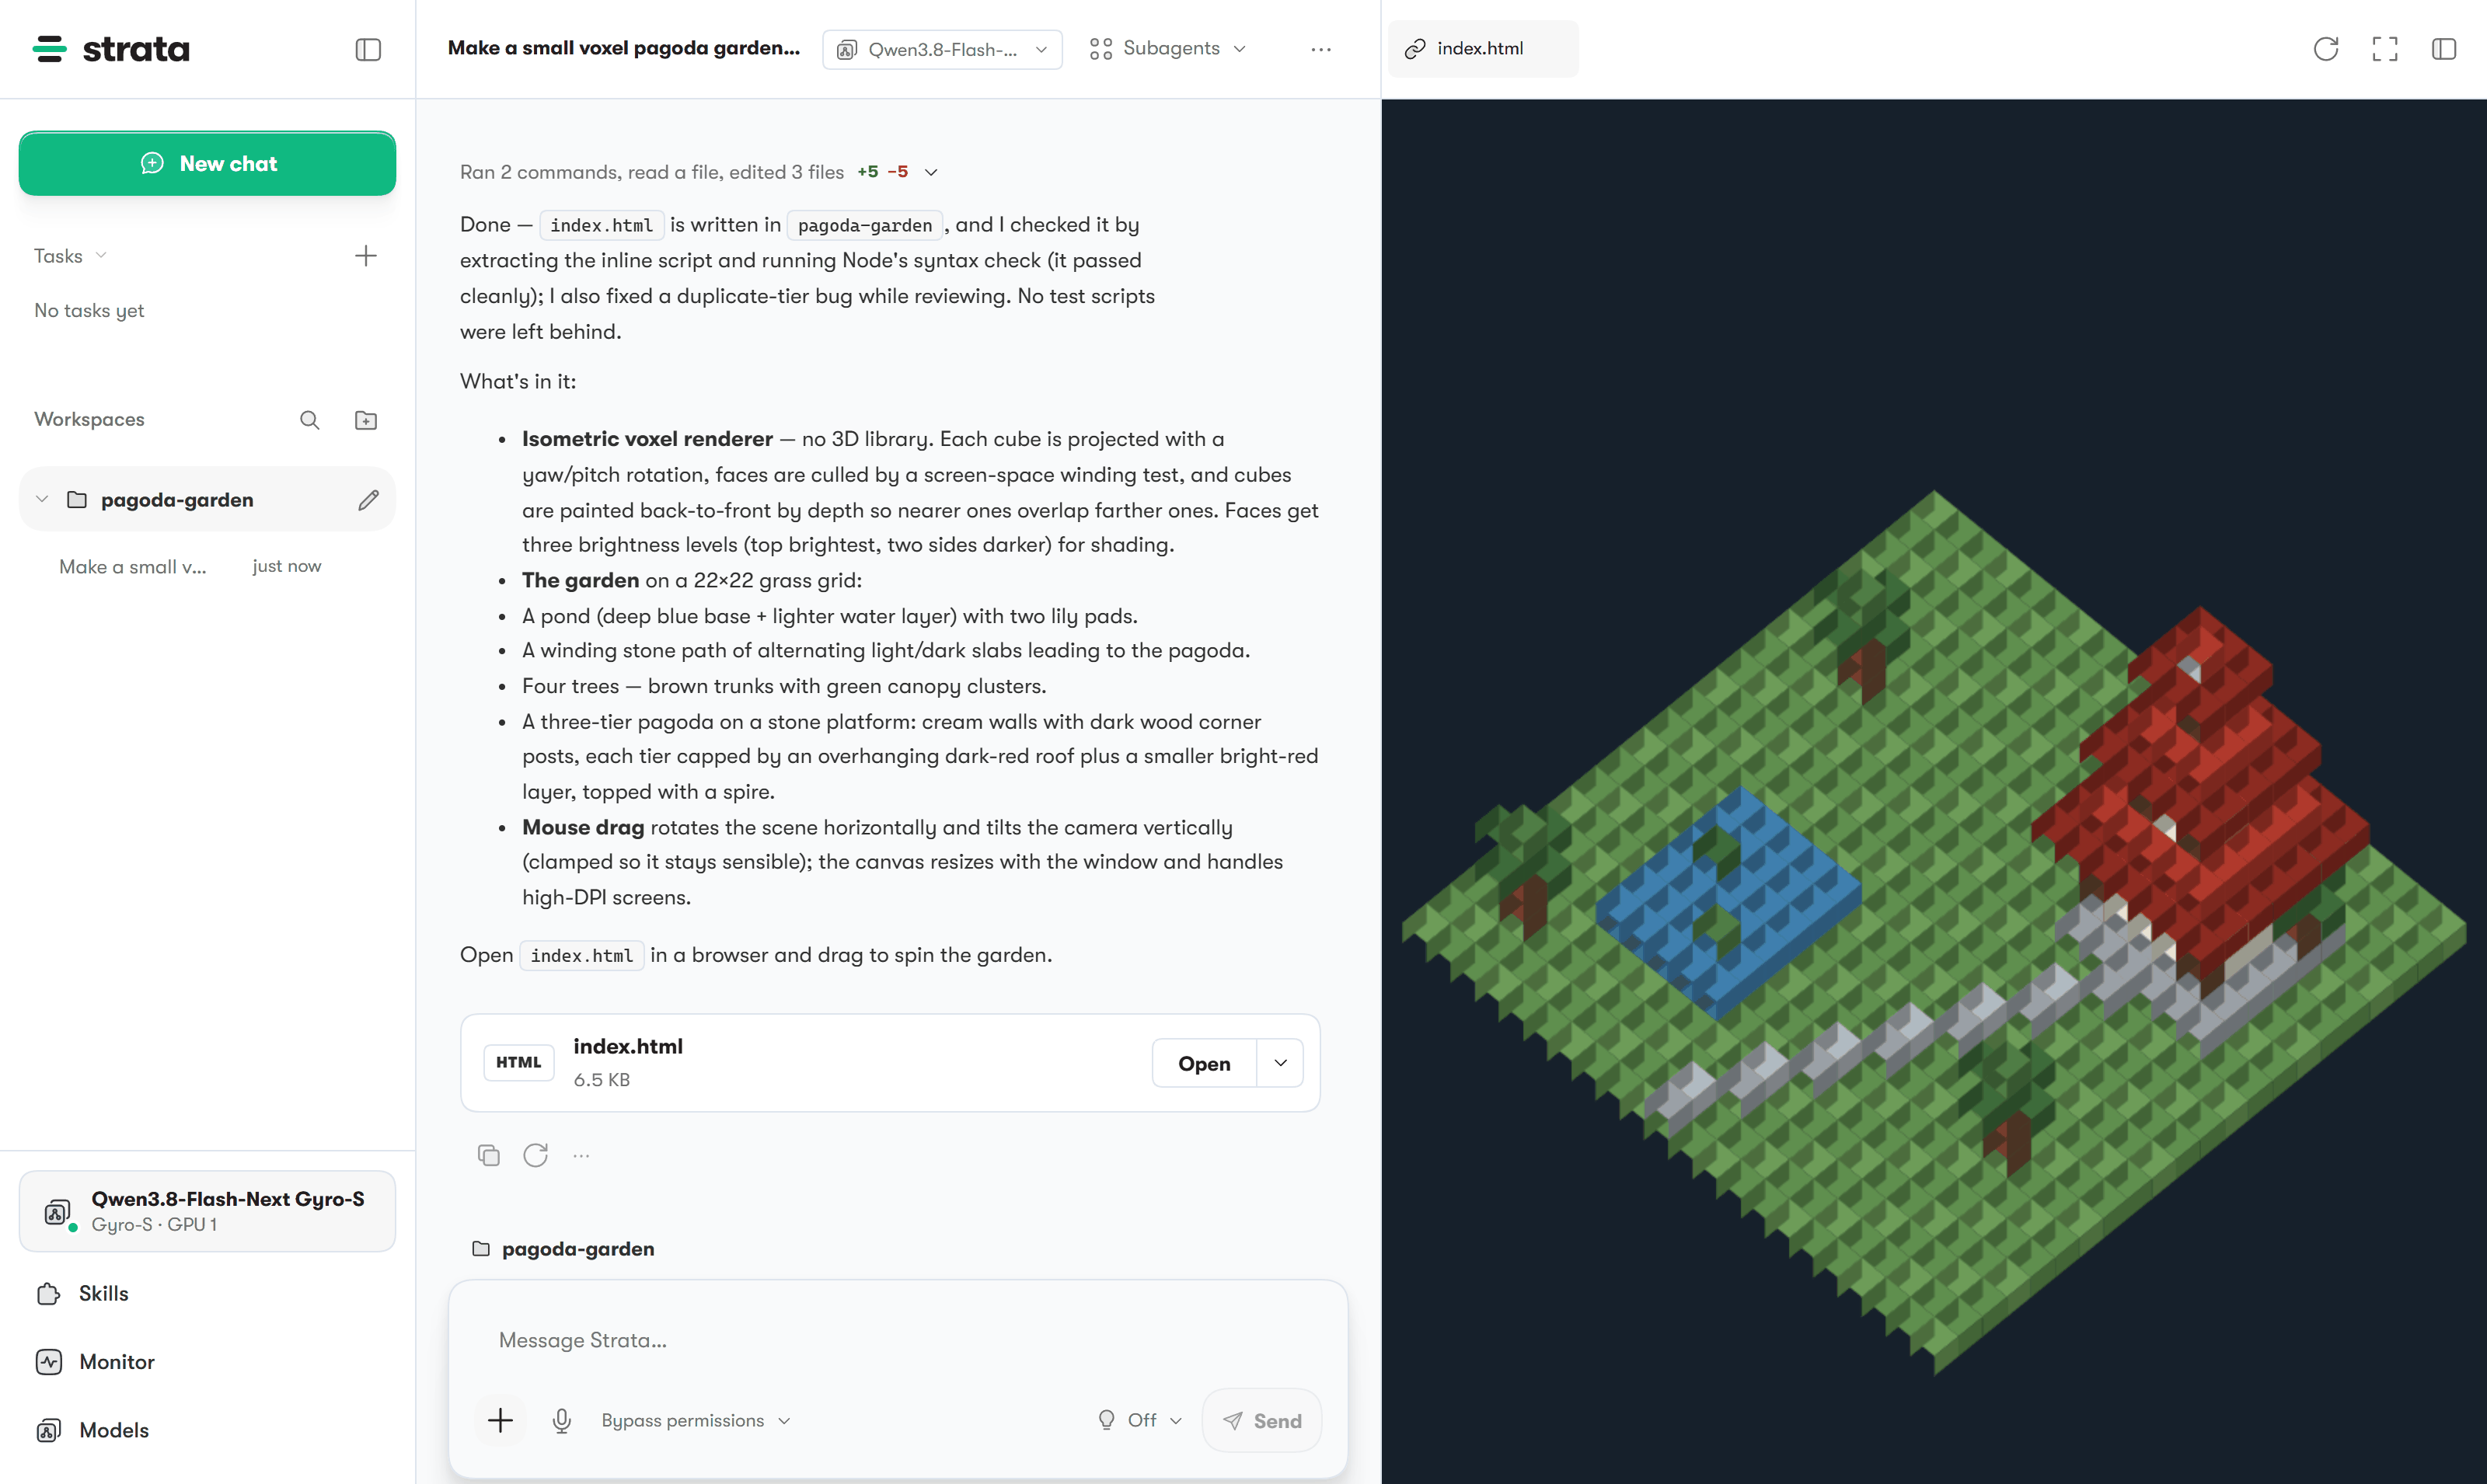
Tangkapan layar resmi Strata dari repositori 0.2.3, menampilkan percakapan pemrograman dan pratinjau HTML. Gambar ini memperlihatkan antarmuka, bukan pengujian yang dilakukan untuk artikel ini. © 2026 Niko1221 dan para kontributor Strata; sumber, lisensi MIT.

Versi beta membuat mesinnya menjadi alat yang bisa Anda gunakan kembali
Aplikasi desktop menyatukan pemilihan model, pengelolaan penyimpanan, percakapan, pemantauan perangkat keras, dan ruang kerja pemrograman. Mode izin Manual meminta persetujuan sebelum perubahan; mode Bypass yang lebih longgar memberi agen kebebasan lebih besar. Terminal menyediakan alur terpandu strata launch dan koneksi ke klien pemrograman. Keduanya memakai mesin dasar yang sama. Catatan fitur 0.2.0-beta
Bagi pengembang, ini membuka contoh penggunaan yang sederhana: minta parser kecil dalam proyek percobaan yang boleh dibuang, periksa berkas yang diusulkan, jalankan pengujiannya, lalu lanjutkan percakapan dengan contoh yang gagal. Bagi pekerja yang banyak menangani dokumen, tugas awal yang sebanding adalah pertanyaan dengan cakupan jelas tentang kutipan teks yang diberikan, dilanjutkan permintaan kutipan pendukung yang persis. Kedua skenario ini tidak mengharuskan model dijadikan pegawai otonom.
Peningkatan praktisnya adalah kesinambungan. Pemilih model grafis mengurangi peluang menjalankan konfigurasi yang tidak kompatibel; pemantau perangkat keras membantu menjelaskan mengapa aplikasi lain mengubah kinerja; preset tersimpan membuat percobaan yang berhasil dapat diulang. Fitur-fitur ini tidak meningkatkan kemampuan penalaran model. Fitur tersebut mengurangi pekerjaan yang diperlukan antara tersedianya kemampuan itu dan penggunaannya secara bertanggung jawab.
Menurut kami, persaingan AI lokal berikutnya terletak pada jarak itu. Pengalaman yang unggul akan memudahkan Anda mempertahankan konfigurasi yang bagus, memahami kegagalan, dan meninjau tindakan berisiko.
Seluruh sistem memori komputer menjadi bagian dari model
Sasaran utama Strata adalah Qwen3.8-Flash-Next, dengan inti berisi 125 miliar parameter. Strategi eksekusinya memakai memori GPU untuk komputasi umum dan expert yang sering dibutuhkan, RAM sistem dan eksekusi CPU untuk expert lainnya, serta akses SSD untuk tabel pencarian n-gram. Kartu grafis yang lebih besar memang membantu, tetapi RAM dan penyimpanan komputer tetap menjadi bagian dari jalur inferensi. Gambaran proyek, rancangan eksekusi
Bayangkan PC sebagai bengkel dengan beberapa meja kerja. Meja tercepat memiliki ruang terbatas, sehingga runtime harus memutuskan pekerjaan mana yang layak tetap berada di sana. Keputusan yang lebih baik dapat membuat perangkat keras yang ada menjadi lebih berguna; keputusan itu tidak membuat semua meja sama cepatnya.
Ada tiga besaran yang perlu diperhatikan secara terpisah. Unduhan memakan ruang penyimpanan. Bobot yang dimuat dan buffer runtime memakai memori. Jendela konteks menambah data kerja seiring panjangnya percakapan. Karena itu, ukuran berkas saja tidak memberi tahu berapa banyak VRAM yang diperlukan ataupun seberapa cepat jawaban pertama muncul.
Panduan awal proyek saat ini menyebut setidaknya 32 GB gabungan RAM dan VRAM, dengan sekitar 80 GB ruang disk kosong untuk penyiapan umumnya. Ini panduan awal, bukan jaminan bahwa setiap model, panjang konteks, atau sistem operasi akan muat dalam kapasitas tersebut. Laptop dasar dengan memori 16 GB tidak boleh dianggap setara dengan komputer desktop di bawah ini. Kebutuhan perangkat keras
Lebih banyak nama model tidak selalu berarti lebih banyak arsitektur
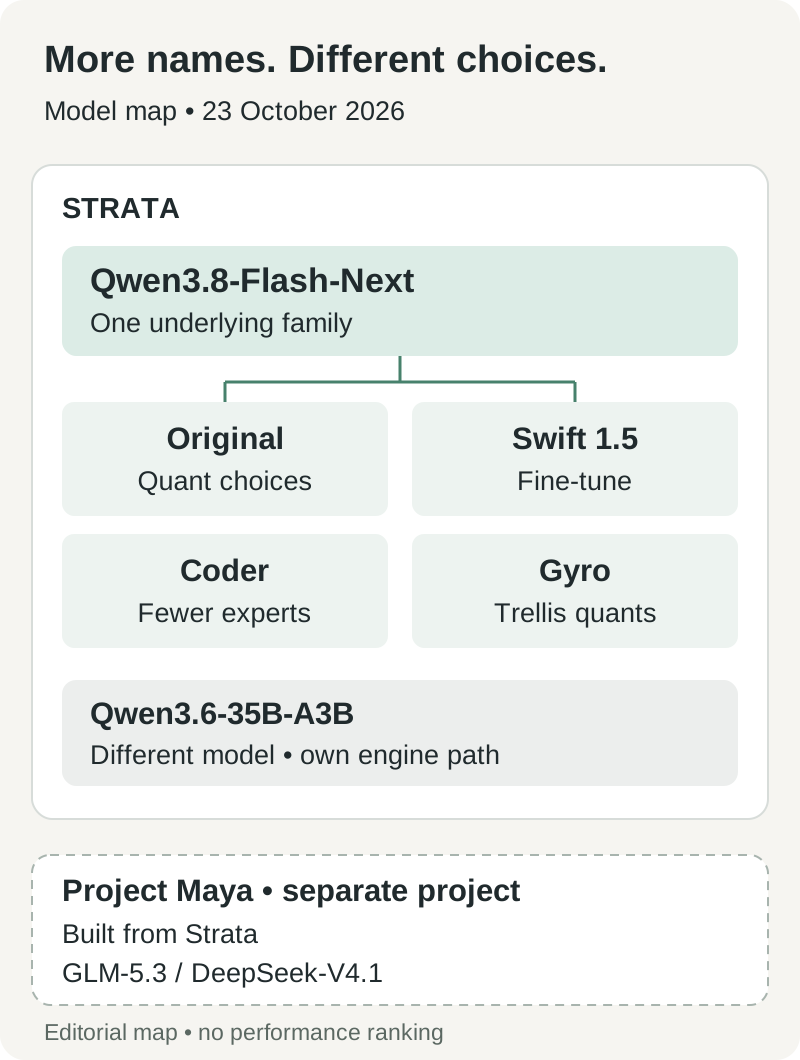
Peta editorial orisinal tentang hubungan model yang terdokumentasi, diperiksa pada 23 Oktober. Cabang menunjukkan garis keturunan dan dukungan runtime, bukan mutu yang setara atau berkas yang dapat saling menggantikan.
Pilihan Flash-Next original, Swift 1.5, Coder, dan Gyro menjawab kebutuhan berbeda dalam keluarga dasar yang sama. Swift mengubah perilaku melalui fine-tuning. Coder menghapus expert yang dipilih karena dinilai kurang berguna untuk fokus pemrogramannya. Gyro mengubah cara bobot direpresentasikan. Menganggap keempat nama itu sebagai model fondasi yang tidak saling berhubungan membuat katalognya tampak lebih luas daripada kenyataannya. Panduan model
Perbedaan ini berdampak nyata. Coder mempertahankan 256 dari 512 expert pada setiap lapisan, dan proyek memperingatkan bahwa kinerja umum serta bahasa selain Inggris lebih lemah. Model yang dipilih karena cocok untuk desktop pemrograman tidak otomatis layak menjadi pilihan bawaan untuk pertanyaan dokumen multibahasa. Penalaran Swift yang lebih pendek dapat memangkas waktu keseluruhan tanpa membuat perangkat keras menghasilkan setiap token lebih cepat. Kompromi antarversi
Gyro-S memerlukan unduhan 58.5 GB, meskipun kebutuhan memori bobotnya yang terdokumentasi di RAM dan VRAM adalah 27.6 GB. Tabel n-gram tetap berada di SSD. Evaluasi proyek menempatkan kualitasnya di bawah pilihan low-bit yang lebih besar; kebutuhan memori yang lebih kecil memiliki konsekuensi. Dokumentasi Gyro
Ada pula model kedua yang memang berbeda: Qwen3.6-35B-A3B, model mixture-of-experts 35B dengan 3B parameter aktif, yang ditangani melalui jalur mesin terpisah. Pilihan yang terdokumentasi mencakup gambar dan permintaan serentak pada konfigurasi NVIDIA dan AMD yang didukung; mesin Mac tidak menjalankannya. Perbedaan ini menjadikannya alternatif yang layak dievaluasi ketika jumlah parameter terbesar bukan kebutuhan Anda yang sebenarnya. Dukungan Qwen3.6
Tiga komputer yang dipublikasikan menunjukkan tiga jenis manfaat
Contoh berikut dipublikasikan oleh kontributor komunitas atau proyek itu sendiri. Angkanya merupakan pengukuran konfigurasi tertentu, bukan hasil pengujian langsung untuk artikel ini. Tujuannya menunjukkan pekerjaan yang masuk akal beserta biayanya, bukan memeringkat tiga komputer dengan prompt yang tidak sebanding.
| Contoh yang dipublikasikan | Model dan kondisi konteks | Hasil yang dilaporkan | Keputusan yang terbantu |
|---|---|---|---|
| Komunitas, 9 Oktober: RTX 3060 12 GB, Core i7-12700, 64 GB DDR4-3200, NVMe, Windows 11 | Strata 0.1.41; Q2_0 original; jendela 131,072 token; prompt baru 4,096 token, keluaran 256 token; penalaran dan penglihatan nonaktif; tiga kali pengujian | Median 42.9 token keluaran/detik; 4.7 detik hingga token pertama; total 10.6 detik | Kartu lama 12 GB dapat mendukung pekerjaan singkat interaktif bila dipasangkan dengan RAM sistem yang cukup besar |
| Komunitas, 9–10 Oktober: RX 9060 XT 16 GB, Ryzen 7 9800X3D, 64 GB DDR5-6000, Windows 11 | Mesin 0.1.40.3; IQ2_XS; jendela 122,880 token; prefill 8,192; masukan baru 8,019 token, penalaran rendah; tiga kali pengujian | Median 879.4 token prompt/detik, 56.3 token keluaran/detik, total 11.212 detik | Untuk masukan sepanjang dokumen, konfigurasi prompt bisa sama pentingnya dengan kartu yang lebih cepat |
| Pengukuran proyek, terdokumentasi paling lambat 23 Oktober: M4 Mac mini, memori terpadu 32 GB | Gyro-S; streaming expert dari SSD; arena expert 11–12 GB; tanpa lapisan draft; cerita 120 token; total jendela tidak disebutkan | Median 9.14 token keluaran/detik dalam lima pasangan berselang-seling; prompt terpisah 4,065 token dibaca pada 109 token/detik | Komputer ringkas dapat menjalankan model besar, dengan konsekuensi waktu tunggu |
Sumber: laporan RTX 3060, laporan RX 9060 XT, pengukuran Mac. Laporan ini mendahului atau berbeda dari rilis aplikasi saat ini.
Contoh RTX 3060 berguna karena mencakup waktu tunggu sebelum keluaran muncul. Antarmuka yang menampilkan sekitar 43 token per detik masih bisa berhenti sejenak saat membaca pertanyaan. Laporannya juga mencatat perlambatan akibat panas dan aktivitas latar belakang yang tidak dikendalikan; nilainya terletak pada gambaran batas realistis satu komputer, bukan spesifikasi GPU yang diidealkan.
Bagi pengguna Radeon, ada bukti alur kerja konkret di luar pengulangan uji kecepatan. Kontributor menjalankan tiga tugas TypeScript sintetis sebanyak tiga kali per model melalui klien pemrograman, dan IQ2_XS maupun IQ3_XXS lulus seluruh sembilan pelaksanaan tugas. Konfigurasi IQ2 menyelesaikan tugas dengan cakupan tersebut lebih cepat sekaligus memakai lebih sedikit memori host. Hasil ini mendukung percobaan pekerjaan pemrograman yang dapat diuji; hasilnya tidak membuktikan kualitas setara pada repositori yang belum dikenal. Perbandingan pemrograman dan bahan uji
Contoh Mac menjawab pertanyaan berbeda: apakah sistem 32 GB yang relatif ringkas bisa ikut menjalankannya? Ya, dengan konfigurasi streaming yang dipublikasikan. Namun, prompt IQ3_XXS terpisah sepanjang sekitar 30K token dalam dokumentasi Mac memerlukan 5.6 menit hingga keluaran pertama. Tugas batch yang dapat menunggu dan asisten yang sensitif terhadap jeda memiliki batas toleransi latensi berbeda. Pengukuran streaming Mac
Itulah pertimbangan yang sebaiknya dibawa pembaca. Gunakan pertanyaan singkat untuk mengetahui perilaku interaktif, dokumen panjang untuk mengetahui biaya pemrosesan prompt, dan tugas yang diverifikasi untuk mengetahui apakah jawabannya berguna. Tidak ada satu angka yang mewakili ketiganya.
Perbaikan Oktober menunjukkan pentingnya mencatat nomor versi saat penyiapan
Rilis 23 Oktober melaporkan peningkatan kecepatan jawaban 6–19% pada komputer uji Windows Strix Halo dengan IQ3_S, diukur melalui tiga pengujian berpasangan melawan 0.2.2. Rilis ini juga menyediakan paket mesin Intel Arc Linux SYCL, dengan A750 sebagai kartu yang diuji. Drafting DFlash2 hanya tersedia di Terminal dan harus diaktifkan sendiri; Auto tetap memilih MTP karena alternatifnya belum unggul pada semua beban kerja. Pengukuran dan batasan 0.2.3
Peningkatan tersebut hadir bersama pemeliharaan perangkat lunak biasa. Tag v0.2.1.2 pada 20 Oktober memperbaiki proses awal Strix Halo di Windows. Panduan perangkat keras menjelaskan masalah sebelumnya: pendaftaran arena expert menghabiskan memori GPU yang tersedia, sehingga tidak menyisakan slot untuk cache. Cip yang didukung dan program pemasang belum cukup sampai pengelolaan kepemilikan memorinya diperbaiki. v0.2.1.2, penjelasan proses awal Strix Halo
Masih ada kendala saat ini. Issue #3810, dibuka pada 23 Oktober, melaporkan crash penyiapan Windows CUDA yang melibatkan metadata penglihatan dalam paket. Ini laporan pengguna yang masih menunggu penyelesaian pada batas waktu riset artikel, bukan bukti bahwa setiap instalasi Windows gagal. Jika jalur penyiapan Anda cocok, periksa issue tersebut dan catatan rilis berikutnya sebelum menghabiskan berjam-jam menyetel ulang model. Laporan penyiapan Windows
Peningkatan versi juga perlu diperhatikan: catatan 0.2.3 meminta pengguna 0.2.0-beta hingga 0.2.1.2 menjalankan ulang pemasang Terminal karena versi tersebut tidak dapat mengganti komponen Control sendiri. Pemasang mempertahankan model dan pengaturan. Untuk Mac, periksa apakah artefak bertanda tangan yang diinginkan sudah benar-benar tersedia: bagian batasan yang diketahui pada rilis yang sama menyebut build Mac masih dalam proses penandatanganan saat dipublikasikan. Petunjuk peningkatan versi
Mulai dengan satu tugas berguna dan konteks pendek
Anda tidak perlu meniru demo konteks raksasa untuk mengetahui apakah alat ini bermanfaat. Siklus kecil yang berhasil memberi Anda patokan awal, termasuk kegagalan dan perbaikannya, sebelum menambah alokasi penyimpanan atau membiarkan agen bertindak luas.
- Pilih jalur yang didokumentasikan untuk perangkat keras Anda. Buka halaman rilis resmi dan pilih paket sistem operasi serta GPU yang sesuai. Catat versi aplikasi dan mesin secara terpisah. Pertahankan instalasi yang sudah berfungsi saat mengevaluasi peningkatan versi.
- Pilih model berdasarkan memori kosong, bahasa, dan tugas. Tutup aplikasi berat untuk percobaan pertama. Mulai dari ukuran yang disarankan, konteks sekitar 8K, dan satu permintaan dalam satu waktu. Simpan berkas model di SSD lokal.
- Gunakan penyiapan terpandu. Pemilih model desktop atau
strata launchmenyediakan pengaturan model, penyimpanan, konteks, gambar, dan akses. Pertahankan akses khusus lokal dan izin Manual untuk latihan pemrograman pertama. Panduan Terminal - Ajukan pertanyaan yang dapat Anda verifikasi. Coba fungsi kecil beserta pengujiannya, tiga pertanyaan tentang dokumen yang diberikan, atau tangkapan layar berisi label yang sudah diketahui. Simpan prompt dan cocokkan jawaban dengan sumber sebenarnya atau keluaran pengujian.
- Ukur seluruh waktu tunggu. Catat waktu mulai, waktu hingga keluaran pertama, total durasi tugas, penggunaan memori tertinggi, dan ketepatan. Kemudian ulangi sekali dengan pertanyaan lanjutan yang memanfaatkan cache dan sekali dengan prompt baru. Jangan ubah pengaturan drafting dan penalaran selama perbandingan itu.
- Tambahkan kerumitan satu variabel demi satu. Perbesar konteks hanya saat tugas membutuhkannya. Evaluasi gambar, model lain, atau koneksi klien pemrograman secara terpisah, agar sumber penurunan kinerja dapat ditelusuri dengan jelas.
Untuk laporan kinerja yang dapat dibagikan, Strata menyediakan strata bench run. Protokol standarnya masih berupa draf yang menunggu validasi uji coba pada 23 Oktober, dan secara eksplisit memisahkan pemuatan model dari inferensi yang diukur waktunya. Kebiasaan pentingnya sudah bermanfaat: sertakan perangkat keras, kuantisasi, pengaturan efektif, dan hasil tugas bersama angkanya. Protokol benchmark
Inferensi lokal tetap menyisakan keputusan di titik koneksi
Dokumentasi privasi Strata menyebut tidak adanya telemetri penggunaan dan kemampuan menjalankan model yang sudah diunduh secara offline. Pencarian web, halaman yang dibuka, layanan model jarak jauh, tunnel, dan alat yang dikonfigurasi membuat koneksi eksternal saat digunakan. Karena itu, percakapan model yang privat juga memerlukan alur kerja pendukung yang privat. Perilaku jaringan dan unduhan
Ini sangat relevan bagi contoh dokumen dan pemrograman. Asisten yang dapat membaca berkas dan menjalankan perintah memiliki kemampuan melebihi pembuatan teks. Tinjau folder kerjanya, perintah persis yang diusulkan, dan endpoint alat eksternal sebelum memberikan materi rahasia. Simpan dokumen asli dan riwayat versi agar penyuntingan yang salah tetap dapat dipulihkan.
Listener inferensi bawaan memakai 127.0.0.1; membuka listener jaringan mengubah siapa yang dapat mengaksesnya. Strata mendokumentasikan kunci API dan listener berbagi yang terpisah, tetapi keputusan itu tetap menjadi tanggung jawab orang yang mengaktifkan akses. API yang kompatibel memudahkan koneksi klien, bukan membuat setiap kemungkinan konfigurasi klien menjadi privat. Kebijakan keamanan
Project Maya menunjukkan jangkauan gagasan ini beserta biayanya
Perkembangan yang lebih luas adalah adaptasi strategi runtime tersebut ke keluarga model lain. Project Maya secara eksplisit mengakui Strata sebagai titik awal mesin, server, dan dasbornya, dengan pekerjaan besar untuk modelnya sendiri. Sasaran yang terdokumentasi mencakup GLM-5.3-Flash, 321B, dan DeepSeek-V4.1-Flash-1017, 748B. Maya merupakan proyek terpisah, bukan pilihan pada menu model Strata. Model dan kredit Maya
Unduhan GLM Maya-S berukuran 96.5 GB; pilihan DeepSeek Maya-S memakan 340 GB termasuk tabel Engram. Sebuah contoh komunitas memasangkan satu RTX 5090 dengan Ryzen 9 7950X dan RAM 96 GB, serta melaporkan lebih dari 30 token per detik untuk GLM Maya-M. Kondisi itu menjelaskan mengapa “satu GPU” belum menggambarkan penyiapan perangkat konsumen secara lengkap. Berkas Maya dan laporan perangkat keras
Peluangnya nyata: sebuah komputer dapat menggabungkan beberapa tingkat penyimpanan dan komputasi untuk melayani model yang keseluruhan bobotnya melebihi memori akselerator. Biayanya ikut membesar. Unduhan ratusan gigabita, kernel khusus model, cadangan memori sistem, dan dukungan platform eksperimental merupakan komitmen yang berarti. Keberhasilan port model besar tidak membuktikan adanya pemuat universal untuk setiap arsitektur.
Bagi kebanyakan pembaca, Maya adalah perkembangan yang perlu dipantau sebelum direkomendasikan sebagai pengganti. Pertanyaan yang berguna adalah apakah model berbeda menyelesaikan tugas yang gagal ditangani model Anda saat ini, dengan manfaat yang cukup untuk membenarkan tambahan perangkat keras dan pemeliharaan. Jumlah parameter saja tidak dapat menjawabnya.
Tonggak berikutnya adalah pekerjaan yang andal, dan usulan publik mengarah ke sana
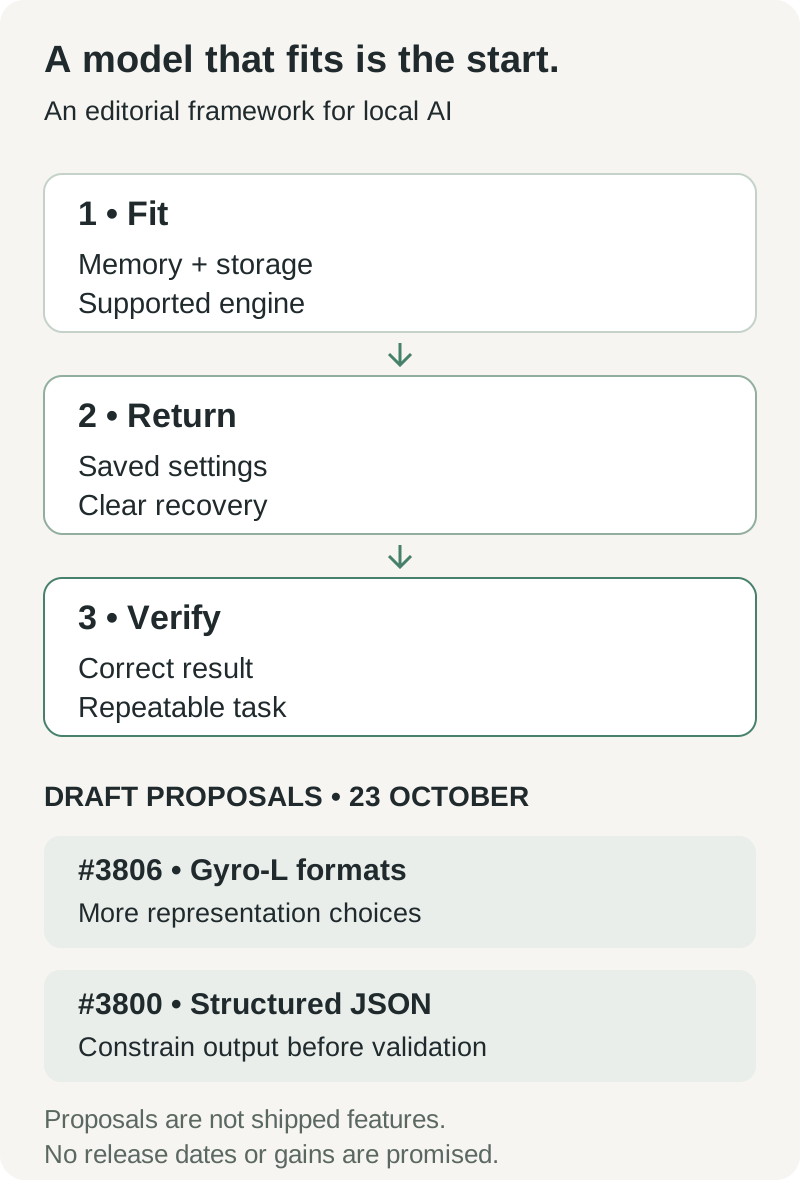
Kerangka editorial orisinal. Urutan atas menjelaskan kriteria adopsi; baris bawah menunjukkan usulan publik yang diperiksa pada 23 Oktober. Ini bukan jadwal rilis yang dijanjikan atau perkiraan kinerja.
Dua pull request draf yang masih terbuka memberi sinyal lebih konkret daripada peta jalan 2.0 yang dibayangkan. #3806 mengusulkan dukungan untuk format trellis Gyro-L yang saat ini belum didukung. #3800 mengusulkan token masking untuk keluaran JSON terstruktur agar generasi yang tidak valid lebih jarang memerlukan pengulangan seluruh permintaan. Keduanya masih berstatus draf pada 23 Oktober; keduanya belum termasuk kemampuan yang sudah dirilis. Usulan Gyro-L, usulan keluaran terstruktur
Jika pekerjaan seperti ini mencapai rilis yang andal, dua jenis beban kerja lokal akan diuntungkan. Dukungan format yang lebih baik memberi pengguna lebih banyak cara menukar kebutuhan memori dengan kualitas. Keluaran terstruktur yang lebih andal membantu ekstraksi dokumen, pelabelan, dan pemanggilan alat menghasilkan data yang dapat divalidasi program lain dengan aman. Peningkatan kedua kurang memukau dalam video, tetapi berpotensi lebih bernilai dalam alur kerja berulang.
Harapan kami bersyarat: inferensi pribadi menjadi lebih berguna ketika runtime mempertahankan konfigurasi yang berfungsi, membatasi penggunaan memori, dan pulih dari kegagalan. Lebih banyak port backend dan drafting yang lebih cerdik hanya membantu jika pembaca dapat menghubungkannya dengan tugas nyata. Model desktop layak dipertahankan jika menghasilkan pekerjaan yang dapat Anda periksa dan ulangi.
Karena itu, pertanyaan untuk komputer AI lokal berikutnya sederhana: bisakah Anda memberinya tugas berguna yang sama besok dan cukup memercayai prosesnya untuk terus menggunakannya?
Sumber dan catatan bacaan
Batas waktu riset: 23 Oktober 2026. Status rilis, status issue, dan artefak yang tersedia dapat berubah setelah tanggal tersebut. Pengukuran di atas mempertahankan tanggal publikasi dan konfigurasi aslinya; tidak ada benchmark inferensi baru yang dilakukan untuk artikel ini.
- Strata 0.2.0-beta, v0.2.1.2, dan catatan rilis 0.2.3.
- Panduan model Strata, dukungan Qwen3.6, dan dokumentasi Gyro.
- Kumpulan benchmark komunitas, dokumentasi Mac, dan draf protokol benchmark.
- Project Maya, tangkapan layar resmi Strata, dan lisensi repositorinya.
Simpan keputusan AI lokal Anda bersama buktinya
Saat membandingkan konfigurasi, simpan tautan sumber, pengaturan perangkat keras, hasil tugas, dan koreksi di satu tempat. Telli.sh dapat membantu menata catatan riset dan rangkuman tersebut seiring berkembangnya penyiapan Anda. Buat akun Telli.sh