Strata 0.2.17 อยากใช้ RAM มากขึ้น พีซีทำงานของคุณควรยอมหรือไม่?
งบหน่วยความจำใหม่ของ Strata อาจลดการอ่าน SSD ขณะที่ค่าเริ่มต้นอีกตัวช่วยรักษาความเที่ยงตรงของผลลัพธ์ มาดูว่าการตั้งค่าใดเหมาะกับพีซีที่ใช้ทำงานด้วย และควรทดสอบข้อแลกเปลี่ยนอย่างไร
โมเดลบนเครื่องอาจตอบได้เร็วขึ้น แต่ทำให้ส่วนอื่นของคอมพิวเตอร์ใช้งานไม่คล่องเหมือนเดิม หากเครื่องนั้นยังต้องเปิดเบราว์เซอร์ โปรแกรมเขียนงาน และวิดีโอคอล ผลลัพธ์ทั้งสองอย่างควรอยู่ในการประเมินเดียวกัน
Strata 0.2.17 ซึ่งออกเมื่อวันที่ 20 พฤศจิกายน 2026 ทำให้ข้อแลกเปลี่ยนนี้เห็นได้ชัดเป็นพิเศษ สำหรับไฟล์โมเดลบางแบบที่เก็บน้ำหนักของ expert ทั้งหมดไว้ใน RAM ไม่ได้ การตั้งค่าที่เน้นประสิทธิภาพจะเพิ่มพื้นที่ที่จัดสรรให้เก็บข้อมูลค้างไว้ในหน่วยความจำ รุ่นนี้ยังปิดการปรับแต่งอีกตัวหนึ่ง หลังผู้ใช้รายงานว่าคำตอบมีคุณภาพลดลง
คำถามที่มีประโยชน์คือ พีซีของคุณเป็นเครื่องสำหรับอนุมานโดยเฉพาะ หรือยังเป็นคอมพิวเตอร์ทำงานประจำวันด้วย การอัปเดตนี้เป็นเหตุผลให้ทดสอบความแตกต่างดังกล่าว แทนที่จะมองตัวเลขโทเคนต่อวินาทีที่สูงขึ้นว่าเป็นผลลัพธ์ทั้งหมด
สามเรื่องที่ควรรู้: ตัวอย่าง 64 GiB ใช้กับไฟล์ Unsloth ที่รองรับและฮาร์ดแวร์ที่ระบุเท่านั้น แอปสามารถคงงบเดิมที่เผื่อการทำงานไว้ได้ และการเก็บข้อมูลค้างในหน่วยความจำกับการข้ามเส้นทางประมวลผลของโมเดลเป็นคนละการควบคุม
เพิ่มอีกเจ็ด GiB อาจลดการอ่าน SSD ได้มากกว่าที่คิด
Strata เป็นรันไทม์โมเดลบนเครื่องที่ประสานทรัพยากรของคอมพิวเตอร์เพื่อรันโมเดลที่รองรับ หลังการเปลี่ยน engine ที่อธิบายไว้ใน 0.2.16 แอปและ Terminal รุ่นใหม่เป็นเวอร์ชัน 0.2.17 ส่วน engine และตัวอัปเดต Control เป็นเวอร์ชัน 0.1.63 รุ่นนี้มีไฟล์ดาวน์โหลดสำหรับ Windows, Linux, Mac และ DGX Spark แต่การมีไฟล์สำหรับระบบปฏิบัติการหนึ่งไม่ได้หมายความว่าทุกโมเดลและทุกเส้นทางประมวลผลจะทำงานได้บนทุกเครื่อง
การเปลี่ยนแปลงด้านหน่วยความจำเกี่ยวข้องกับไฟล์ Unsloth UD-Q4_K_XL และ UD-IQ4_XS ในกรณีที่เก็บ expert ทั้งหมดไว้ใน RAM ไม่ได้ กฎการตั้งค่าใหม่จะหัก 17 GiB และ KV cache ที่สตรีมออกจาก RAM ทั้งหมด เพื่อกำหนดว่าจะเก็บน้ำหนัก expert ไว้เท่าใด กฎเดิมหัก 24 GiB ตัวเลขนี้เป็นงบสำหรับข้อมูลที่ค้างในหน่วยความจำของเส้นทางประมวลผลหนึ่ง ไม่ใช่คำรับรองว่าโมเดลทั้งตัว cache และระบบปฏิบัติการจะใช้พื้นที่รวมกันไม่เกินตัวเลขนั้น
ทำไมเพิ่มเพียงไม่กี่ GiB จึงสำคัญ? หากน้ำหนักที่ต้องใช้อยู่ในหน่วยความจำแล้ว รันไทม์ไม่ต้องดึงข้อมูลนั้นจากสตอเรจอีก prompt ที่หนักอาจได้ประโยชน์นี้ซ้ำผ่านการเข้าถึงจำนวนมาก ความสัมพันธ์จึงซับซ้อนกว่าการเทียบเจ็ด GiB กับขนาดไฟล์อินพุตหนึ่งไฟล์ ทั้งยังขึ้นกับว่าเวิร์กโหลดเรียกใช้ expert ใดและรันไทม์เก็บอะไรไว้ใน cache แล้วบ้าง
ตัวอย่างของผู้ดูแลโครงการใช้ขีดจำกัดหน่วยความจำจริง 64 GiB, UD-Q4_K_XL, การ์ด RTX PRO 4500 Blackwell และ prompt ราว 65K โทเคน ตารางในบันทึกรุ่น รายงานผลดังต่อไปนี้ นี่เป็นการวัดของโครงการบนการตั้งค่านี้ ไม่ใช่การคาดการณ์สำหรับคอมพิวเตอร์ 64GB ทุกเครื่อง
| งบเก็บ expert ค้างในหน่วยความจำ | ปริมาณอ่าน SSD สำหรับ prompt ที่ระบุ | อัตราถอดรหัส | RAM ว่างที่รายงาน | โปรแกรม 8 GiB ที่เปิดภายหลัง |
|---|---|---|---|---|
| 40 GiB ตัวอย่างเดิม | 97.7 GB | 57.7 โทเคน/วินาที | 16.6 GiB | ทำงานต่อได้ |
| 47 GiB ตัวอย่างใหม่ | 37.0 GB | 84.2 โทเคน/วินาที | 9.3 GiB | ทำงานต่อได้ |
| 52 GiB การทดสอบเพิ่มเติม | 0.9 GB | 83.4–88.6 โทเคน/วินาที | 6.6 GiB | ถูกยุติการทำงาน |
แถวสุดท้ายคือจุดที่น่าสนใจ การลดการอ่านสตอเรจจนเกือบเป็นศูนย์ไม่ได้ทำให้อัตราถอดรหัสเพิ่มขึ้นมากในระดับเดียวกัน และอีกโปรแกรมหนึ่งก็ทำงานต่อไม่ได้ ตารางนี้สนับสนุนการเลือกงบจากการวัดจริง แทนที่จะจัดหน่วยความจำให้การอนุมานมากที่สุดเท่าที่ทำได้
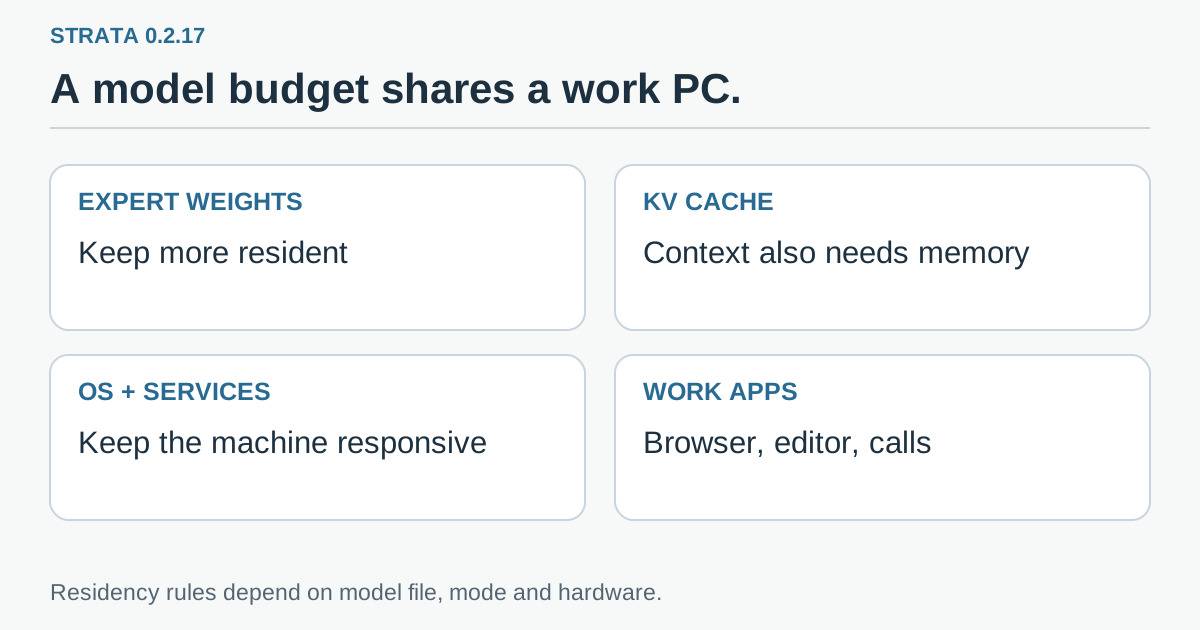 ภาพอธิบายที่เราจัดทำขึ้น: น้ำหนัก expert, cache ของรันไทม์ที่เปลี่ยนไป และแอปประจำวันใช้หน่วยความจำของเครื่องร่วมกัน กฎการเก็บข้อมูลค้างในรุ่นนี้ใช้เฉพาะเส้นทางโมเดลที่ระบุ
ตัวเลือกเผื่อหน่วยความจำให้การทำงานในแอปเป็นจุดเริ่มต้นที่มีประโยชน์
ลองนึกถึงเวิร์กสเตชันของนักพัฒนาที่เปิดเบราว์เซอร์ทิ้งไว้นาน IDE กำลังทำดัชนีคลังโค้ด และผู้ช่วยบนเครื่องกำลังเตรียมคำตอบจากเอกสารขนาดใหญ่ การตั้งค่าที่เร็วที่สุดเมื่อรันผู้ช่วยลำพังมีประโยชน์น้อยลง หาก IDE เริ่มใช้ swap หรือการประชุมวิดีโอไม่เสถียร สิ่งที่ควรใช้เป็นฐานเปรียบเทียบคือการทำงานทั้งช่วง
แอป Strata มีตัวเลือก “Leave 20% for my work” หรือเผื่อ 20% ให้การทำงานของฉัน บันทึกรุ่นระบุว่าตัวเลือกนี้คงงบเดิมไว้ คือ 40 GiB ในตัวอย่าง 64 GiB ส่วน Terminal, strata serve, Docker และโหมดประสิทธิภาพเต็มในแอปใช้การจัดสรรใหม่ งบที่ผู้ใช้กำหนดหรือค่าพื้นที่สำรองที่ตั้งไว้อย่างชัดเจนมีลำดับความสำคัญสูงกว่า การติดตั้ง 0.2.16 เดิมสามารถรับการย้ายงบครั้งเดียวได้เมื่อเรียกคำสั่ง Strata ครั้งแรกหลังอัปเดต โดยไม่ต้องรันการตั้งค่าแยก เว้นแต่ผู้ใช้กำหนดพื้นที่ไว้เองแล้ว
ความแตกต่างนี้สำคัญเมื่อคนสองคนบอกว่าทดสอบค่าเริ่มต้นเหมือนกัน คนหนึ่งอาจใช้โหมดเผื่อการทำงานในแอปเดสก์ท็อป ขณะที่อีกคนเริ่มเซิร์ฟเวอร์จาก Terminal ทั้งคู่ใช้แอปเวอร์ชันเดียวกันแต่ตัดสินใจเรื่องข้อมูลค้างในหน่วยความจำต่างกันได้ จึงควรบันทึกโหมดเริ่มทำงานควบคู่กับเวอร์ชันก่อนเปรียบเทียบผล
บันทึกรุ่นยังอธิบายข้อยกเว้น เครื่องที่ CPU/GPU ใช้หน่วยความจำร่วมกัน เช่น Strix Halo และเส้นทางแบ่งเลเยอร์ระหว่างการ์ดสองใบยังคงพื้นที่สำรองแบบเดิม ไฟล์โมเดลอื่นที่ระบุ ได้แก่ IQ2_XS, IQ3_XXS, IQ3_S และ Q2_0 ไม่ได้รับงบการเก็บค้างนี้ในทั้งสองเวอร์ชัน ดังนั้นการคัดลอกกฎหน่วยความจำจากตัวอย่างหนึ่งจึงใช้แทนการตรวจการตั้งค่าโมเดลที่แท้จริงไม่ได้
สำหรับ Windows engine ใหม่ยังจำกัดการจองเริ่มต้นไว้ที่หน่วยความจำว่างที่ใช้ได้ลบ 4.25 GiB เครื่องที่มีงานอยู่มากจึงอาจเริ่มต่ำกว่าตัวเลขจัดสรร 47 GiB ที่กล่าวถึง บันทึกรุ่นระบุชัดว่าพฤติกรรมบน Windows นี้ไม่ได้วัดในตัวอย่าง อีกทั้งปรับวิธีจัดกลุ่มเครื่อง Windows ที่ระบุว่า 64GB เมื่อระบบรายงานราว 63.1 GiB รายละเอียดเหล่านี้ช่วยอธิบายว่าทำไมการจัดสรรที่สังเกตได้จึงต่างออกไป แต่ไม่ได้ทำให้การทดสอบที่เผยแพร่กลายเป็น benchmark ของ Windows
ข้อเสนอแนะในการใช้งานของเราคือ เริ่มจากตัวเลือกสำรองพื้นที่บนคอมพิวเตอร์ที่ใช้โต้ตอบทำงานทุกวัน ค่อยทดลองการจัดสรรที่ใหญ่ขึ้นโดยตั้งใจเปรียบเทียบขณะเวิร์กโหลดที่ต้องการกำลังทำงาน แทนการยืมหน่วยความจำจากแอปที่บังเอิญปิดไปตอนทดสอบ
คำตอบที่เร็วกับคำตอบที่คงพฤติกรรมเดิมต้องใช้คนละสวิตช์
การเปลี่ยนแปลงใหญ่อีกข้อเกี่ยวกับ “Skip rarely used parts of the model” หรือข้ามส่วนที่ไม่ค่อยใช้ของโมเดล ซึ่งเป็นการตั้งค่า Expert ที่แทนด้วย STRATA_ROUTE_TAIL_SKIP นี่ไม่ใช่งบ RAM
บันทึกรุ่นอธิบายว่า ภายใต้เงื่อนไขการเลือกเส้นทางที่เกี่ยวข้อง การปรับแต่งนี้อาจละงานของ expert ที่ปกติจะต้องคัดลอกและคำนวณ ก่อนหน้านี้มันทำงานโดยค่าเริ่มต้นบนเส้นทาง NVIDIA และ Radeon RX 9000 ผู้ดูแลเปลี่ยนพฤติกรรมอัตโนมัติหลังได้รับรายงานว่าคุณภาพลดลง ใน 0.2.17 จะปิดไว้ เว้นแต่ผู้ใช้เปิดอย่างชัดเจน
การเก็บน้ำหนักที่จำเป็นไว้ใกล้ตัวประมวลผลมากขึ้นต่างจากการตัดสินใจไม่ทำงานบางส่วนของโมเดลอย่างสำคัญ วิธีแรกเปลี่ยนตำแหน่งที่พบข้อมูล วิธีหลังเปลี่ยนการคำนวณ แม้ทั้งคู่เพิ่ม throughput ได้ ก็ไม่ควรประเมินความเสี่ยงของผลลัพธ์เสมือนเป็นเทคนิคเดียวกัน
ในตัวอย่าง RTX 5090 ของผู้ดูแลที่ใช้ UD-Q4_K_XL และ DFlash2 คำขอห้าประเภทที่ทดสอบสองรอบมีอัตราถอดรหัสเฉลี่ย 73.4 โทเคน/วินาทีเมื่อปิดการข้ามเส้นทาง และ 94.5 เมื่อเปิด บันทึกเดียวกันยังมีการวัดความแตกต่างของโทเคนโดยบังคับลำดับโทเคน นี่เป็นการเปรียบเทียบการตั้งค่าที่โครงการเผยแพร่ ไม่ใช่คะแนนว่าคำตอบที่ได้มีประโยชน์ ปลอดภัย หรือถูกต้องสำหรับแอปของคุณหรือไม่
ผลในชีวิตประจำวันคือ การอัปเดตอาจทำให้ throughput ของบางเส้นทางลดลง ขณะเดียวกันก็คืนพฤติกรรมการเลือกเส้นทางที่ครบถ้วนกว่าเดิม นั่นอาจเป็นผลที่ตั้งใจไว้ หากงานของคุณคือเช็กตัวเลขให้ตรง สร้างผลลัพธ์ที่มีโครงสร้าง หรือทำตามคำสั่งยาก การรักษาพฤติกรรมที่ต้องการอาจมีค่ามากกว่าการพ่นข้อความได้เร็วขึ้น
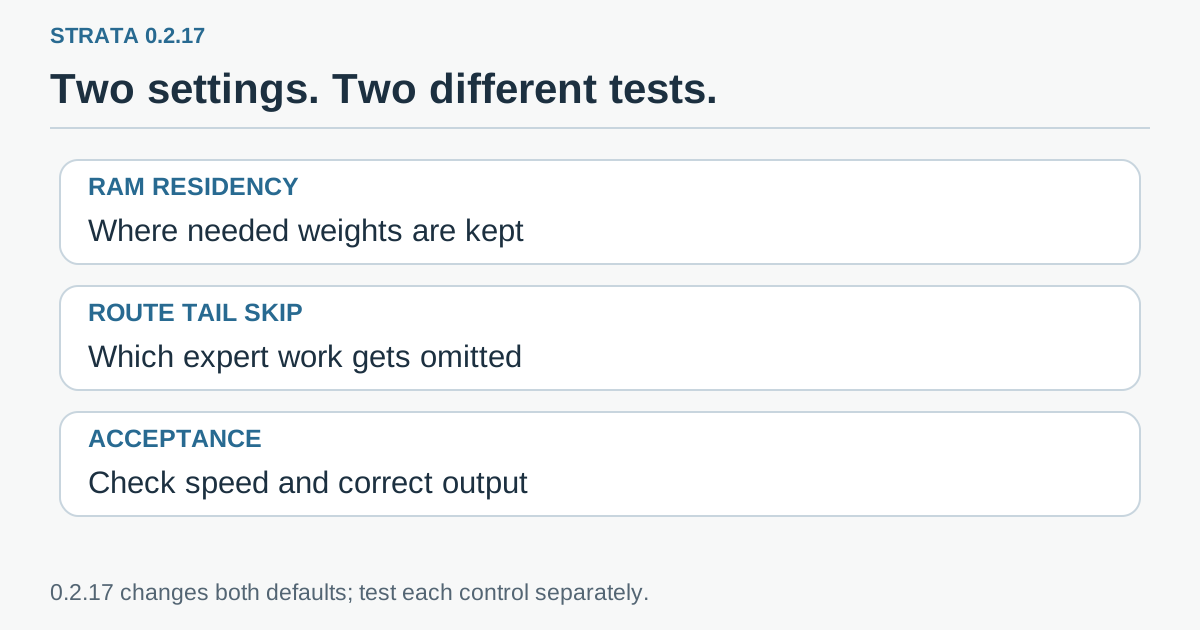 รายการประเมินที่เราจัดทำขึ้น: วัดความตึงตัวของทรัพยากรแยกจากคุณภาพคำตอบ การเปลี่ยนข้อมูลที่เก็บค้างกับการเปลี่ยนการข้ามเส้นทางเป็นคนละการทดลอง
ค่าที่ปรับเองเดิมเป็นส่วนหนึ่งของประวัติการอัปเกรด
ค่าเริ่มต้นอัตโนมัติกับค่าที่ผู้ใช้เลือกอย่างชัดเจนไม่ได้ย้ายเหมือนกัน หากคุณไม่เคยเปลี่ยนการตั้งค่าเส้นทาง หรือใช้ค่าอัตโนมัติ พฤติกรรมอัตโนมัติใหม่คือปิด หากเคยเลือกระดับ rank 7 หรือระดับอื่นเอง บันทึกรุ่นระบุว่าจะคงค่านั้นไว้ ค่า 0 ที่กำหนดไว้อย่างชัดเจนก็ยังหมายถึงปิด
วิธีนี้รักษาการตั้งค่าที่ตั้งใจเลือกไว้ แต่ยังหมายความว่าการอัปเดตสองเครื่องไม่ได้ทำให้พฤติกรรมตรงกันเสมอไป เครื่องหนึ่งอาจเก็บการทดลองเก่าที่ใครบางคนเปิดไว้หลายเดือนก่อน ก่อนวินิจฉัยว่าคุณภาพหรือประสิทธิภาพถดถอย ให้ตรวจค่าที่ถูกนำต่อมาด้วย
บันทึกรุ่นแสดง strata launch --set STRATA_ROUTE_TAIL_SKIP=7 เป็นวิธีเปิดพฤติกรรม rank-7 ให้ถือเป็นการทดลองแบบเลือกเข้าร่วม ไม่ใช่ขั้นตอนอัปเกรดที่ทุกคนควรรัน หากปัญหาที่ต้องการแก้คือผลลัพธ์ไม่สม่ำเสมอ ให้ตรวจว่าปิดการปรับเส้นทางแล้วก่อน แทนการเปิดเพื่อเรียกตัวเลข throughput เดิมกลับมา
0.2.17 ยังมีค่าเริ่มต้นอื่น รวมถึงการเปลี่ยนการอ่าน prompt และการถอดรหัสเฉพาะฮาร์ดแวร์ บางอย่างอาจเปลี่ยนข้อความที่สร้างขึ้น นี่จึงเป็นอีกเหตุผลที่ไม่ควรเปลี่ยนหลายค่าพร้อมกันแล้วสรุปว่าความแตกต่างทั้งหมดมาจาก RAM เวอร์ชัน ไฟล์โมเดล เส้นทางฮาร์ดแวร์ และค่าที่กำหนดทับอย่างชัดเจนประกอบกันเป็นการตั้งค่าที่คุณทดสอบจริง
เปรียบเทียบขณะแอปที่คุณตั้งใจใช้งานยังเปิดอยู่
การทดสอบที่มีประโยชน์ไม่จำเป็นต้องมีห้องแล็บ แต่ต้องมีคำถามที่ทำซ้ำได้ สำหรับพีซีทำงาน ให้ถามว่าผู้ช่วยทำงานตัวอย่างจนเสร็จได้หรือไม่ขณะที่ส่วนอื่นของเครื่องยังใช้งานได้ สำหรับเซิร์ฟเวอร์เฉพาะทาง ให้ถามว่างบที่เลือกช่วยให้บริการที่ตั้งใจรันพร้อมกันทำงานได้โดยไม่เกิดปัญหาหน่วยความจำหรือไม่
- บันทึกการตั้งค่าเริ่มต้น จดเวอร์ชันแอปและ engine ระบบปฏิบัติการ RAM, GPU ไฟล์โมเดลที่แน่นอน โหมดเริ่มทำงาน ขนาดบริบท และค่าหน่วยความจำหรือเส้นทางที่ตั้งเอง คงโมเดลและรูปแบบ quantization เดิมไว้ระหว่างเปรียบเทียบ
- เลือกงานตัวแทนสามแบบ เช่น คำถามสั้น คำขอจากเอกสารยาว และการสกัดข้อมูลแบบมีโครงสร้างที่รู้ฟิลด์บังคับล่วงหน้า ทั้งหมดเป็นตัวอย่างงานที่แนะนำ ไม่ใช่งานที่เราทดลองเพื่อบทความนี้
- สร้างฐานด้วยโหมดสำรองพื้นที่ให้การทำงาน เปิดเบราว์เซอร์ โปรแกรมเขียนงาน และแอปปกติอื่นไว้ สังเกตหน่วยความจำว่าง กิจกรรมสตอเรจ เวลารอคำตอบแรก อัตราสร้างข้อความ และดูว่าแอปเหล่านั้นยังตอบสนองดีหรือไม่
- เปลี่ยนเฉพาะข้อมูลที่เก็บค้างในหน่วยความจำ เปรียบเทียบการจัดสรรที่เน้นประสิทธิภาพโดยคงค่าเส้นทางเดิม เฝ้าดูความตึงตัวของหน่วยความจำทั้งระหว่างงานและเมื่อเปิดแอปปกติอีกตัวภายหลัง
- ประเมินผลลัพธ์ ตรวจข้อเท็จจริงที่ต้องมี รูปแบบ การทำตามคำสั่ง และความสม่ำเสมอเมื่อทำซ้ำ ผลสกัดข้อมูลที่ถูกไวยากรณ์แต่ขาดรายการบังคับยังต้องถือว่าล้มเหลว
- ทดสอบการข้ามเส้นทางแยกต่างหากหากจำเป็น คงงบเก็บค้างที่เลือกไว้ เปรียบเทียบผลกับตัวอย่างที่ใช้เป็นเกณฑ์ยอมรับ แล้วตัดสินว่าความเร็วที่เพิ่มขึ้นคุ้มกับการเปลี่ยนแปลงที่พบหรือไม่
สำหรับเอกสารยาว ให้บันทึกทั้งการเริ่มแบบเย็นและคำขอซ้ำ cache อาจทำให้ครั้งที่สองต่างจากครั้งแรกมาก อย่านำผลที่ cache อุ่นแล้วของการตั้งค่าหนึ่งไปปนกับครั้งแรกที่อีกการตั้งค่าพบเอกสารนั้น
บันทึกความล้มเหลวด้วย แทนการเฉลี่ยจนมองไม่เห็น คำตอบเร็วที่ตามด้วยหน่วยความจำไม่พอไม่ใช่ผลดีสำหรับบริการเบื้องหลัง การใช้โปรแกรมเขียนงานได้ต่อเนื่องไม่สะดุดอาจเป็นผลตัดสินสำหรับโน้ตบุ๊กทำงาน แม้อีกการตั้งค่าจะชนะในคอลัมน์อัตราถอดรหัส
การตั้งค่าที่ดีกว่าต้องเหลือที่ให้งานจริงของคุณ
Strata 0.2.17 ทำให้การอนุมานบนเครื่องรู้สึกเหมือนบริหารคอมพิวเตอร์เล็กที่ใช้ทรัพยากรร่วมกัน มากกว่าทำ benchmark ตัวเร่งประมวลผลเพียงตัวเดียว หน่วยความจำเหมือนโต๊ะส่วนกลาง วางข้อมูลโมเดลเพิ่มบนโต๊ะอาจลดการเดินไปหยิบจากที่เก็บ แต่งานจริงก็ยังต้องมีพื้นที่ให้ทำ
สำหรับเครื่องเฉพาะทาง การจัดสรรใหม่เป็นเหตุผลให้วัดว่าการอ่านที่ลดลงช่วยเวิร์กโหลดที่ให้บริการหรือไม่ สำหรับเวิร์กสเตชันประจำวัน ตัวเลือกสำรองพื้นที่เป็นจุดเริ่มต้นที่สมเหตุสมผล ในทั้งสองกรณี ให้รักษาความเที่ยงตรงของผลลัพธ์เป็นเกณฑ์ยอมรับของตัวเอง การตั้งค่าที่เร็วขึ้นควรได้ใช้งานเมื่อทั้งงานดีขึ้น ไม่ใช่แค่ตัวนับโทเคน
แหล่งข้อมูลและสื่อทางการ
- Strata 0.2.17 วันที่ 20 พฤศจิกายน 2026: การตั้งค่า การวัดภายใต้เงื่อนไขที่ระบุ และพฤติกรรมการอัปเดต
- บันทึกการเปลี่ยน engine ของ Strata 0.2.16
- ภาพประกอบหน้าจอ Strata ทางการ ลิงก์นี้นำไปยังภาพของผลิตภัณฑ์จริง ส่วนกราฟิกที่แนบมากับบทความเป็นภาพอธิบายที่เราจัดทำขึ้น
ตัวเลขการวัดข้างต้นอ้างอิงจากโครงการและคงเงื่อนไขฮาร์ดแวร์กับโมเดลไว้ ส่วนขั้นตอนการประเมินเป็นแนวทางที่เสนอให้ผู้อ่านนำไปใช้
คำแนะนำจาก Telli.sh: เก็บการตั้งค่า prompt ตัวแทน และบันทึกเปรียบเทียบไว้ด้วยกัน เพื่อให้การอัปเดตครั้งต่อไปเริ่มจากฐานที่มีประโยชน์ เริ่มบันทึกแรกของคุณด้วย Telli.sh