Strata 0.2.17 Ingin Memakai Lebih Banyak RAM Anda. Perlukah PC Kerja Mengizinkannya?
Anggaran memori baru Strata dapat mengurangi lalu lintas SSD, sementara pengaturan bawaan lain menjaga kesetiaan keluaran. Pelajari pilihan untuk PC kerja bersama dan cara menguji komprominya.
Model lokal bisa menjawab lebih cepat sekaligus membuat komputer yang menjalankannya kurang nyaman digunakan. Pada mesin yang juga menjalankan peramban, editor, dan panggilan video, kedua hasil itu perlu masuk dalam tolok ukur yang sama.
Strata 0.2.17, dirilis pada 20 November 2026, memperlihatkan kompromi tersebut dengan sangat jelas. Untuk berkas model tertentu yang bobot pakarnya tidak dapat seluruhnya ditampung dalam RAM, konfigurasi berorientasi performanya memperbesar alokasi yang dipertahankan di memori. Rilis ini juga menonaktifkan sebuah optimasi terpisah setelah pengguna melaporkan penurunan kualitas jawaban.
Pertanyaan yang berguna adalah apakah PC Anda merupakan mesin khusus inferensi atau masih menjadi komputer kerja. Pembaruan ini memberi alasan untuk menguji perbedaan tersebut, alih-alih menganggap angka token per detik yang lebih tinggi sebagai keseluruhan hasil.
Tiga hal yang perlu diketahui: contoh 64 GiB hanya berlaku untuk berkas Unsloth yang didukung dan konfigurasi perangkat keras yang disebutkan; aplikasi dapat mempertahankan anggaran lama yang lebih ramah pekerjaan; dan residensi memori serta melewatkan rute model merupakan dua kontrol berbeda.
Tambahan tujuh GiB dapat menghemat pembacaan SSD secara mengejutkan
Strata adalah runtime model lokal yang mengoordinasikan sumber daya mesin untuk menjalankan model yang didukung. Setelah peralihan mesin yang dijelaskan dalam 0.2.16, versi aplikasi dan Terminal barunya adalah 0.2.17. Mesin serta pembaru Control-nya menggunakan versi 0.1.63. Rilis ini menyediakan unduhan untuk Windows, Linux, Mac, dan DGX Spark, meskipun tersedianya unduhan untuk sebuah sistem operasi tidak berarti setiap model dan jalur eksekusi bekerja pada setiap mesin.
Perubahan memori ini menyangkut berkas Unsloth UD-Q4_K_XL dan UD-IQ4_XS ketika seluruh pakarnya tidak dapat terus berada dalam RAM. Aturan konfigurasi baru mengurangi total RAM sebesar 17 GiB dan ukuran cache KV yang dialirkan untuk menentukan jumlah bobot pakar yang dipertahankan. Aturan lama menguranginya sebesar 24 GiB. Ini adalah anggaran residensi bagi jalur eksekusi tertentu, bukan janji bahwa keseluruhan model, cache, dan sistem operasi akan muat dalam angka tersebut.
Mengapa tambahan beberapa GiB dapat berpengaruh? Jika bobot yang diperlukan sudah tersedia di memori, runtime dapat menghindari pengambilan ulang dari penyimpanan. Prompt yang berat dapat memanfaatkan keunggulan ini berkali-kali. Hubungannya pun lebih rumit daripada membandingkan tujuh GiB dengan ukuran satu berkas masukan. Hasilnya juga bergantung pada pakar mana yang diakses beban kerja serta apa yang sudah disimpan runtime dalam cache.
Contoh dari pengelola proyek memakai batas memori nyata 64 GiB, UD-Q4_K_XL, kartu RTX PRO 4500 Blackwell, dan prompt sekitar 65K token. Tabel rilis melaporkan hasil berikut. Angka ini merupakan pengukuran proyek untuk konfigurasi tersebut, bukan perkiraan bagi setiap komputer 64GB.
| Anggaran bobot pakar yang menetap | Pembacaan SSD untuk prompt yang disebutkan | Laju dekode | RAM bebas yang dilaporkan | Program 8 GiB yang dijalankan kemudian |
|---|---|---|---|---|
| 40 GiB, contoh lama | 97.7 GB | 57.7 token/dtk | 16.6 GiB | Tetap berjalan |
| 47 GiB, contoh baru | 37.0 GB | 84.2 token/dtk | 9.3 GiB | Tetap berjalan |
| 52 GiB, pengujian tambahan | 0.9 GB | 83.4–88.6 token/dtk | 6.6 GiB | Dihentikan paksa |
Baris terakhir justru paling menarik. Menurunkan lalu lintas penyimpanan hingga hampir nol tidak menghasilkan peningkatan kecepatan dekode yang sama dramatisnya, sementara program lain gagal. Tabel tersebut mendukung anggaran yang ditentukan lewat pengukuran, bukan memaksimalkan jumlah memori untuk inferensi.
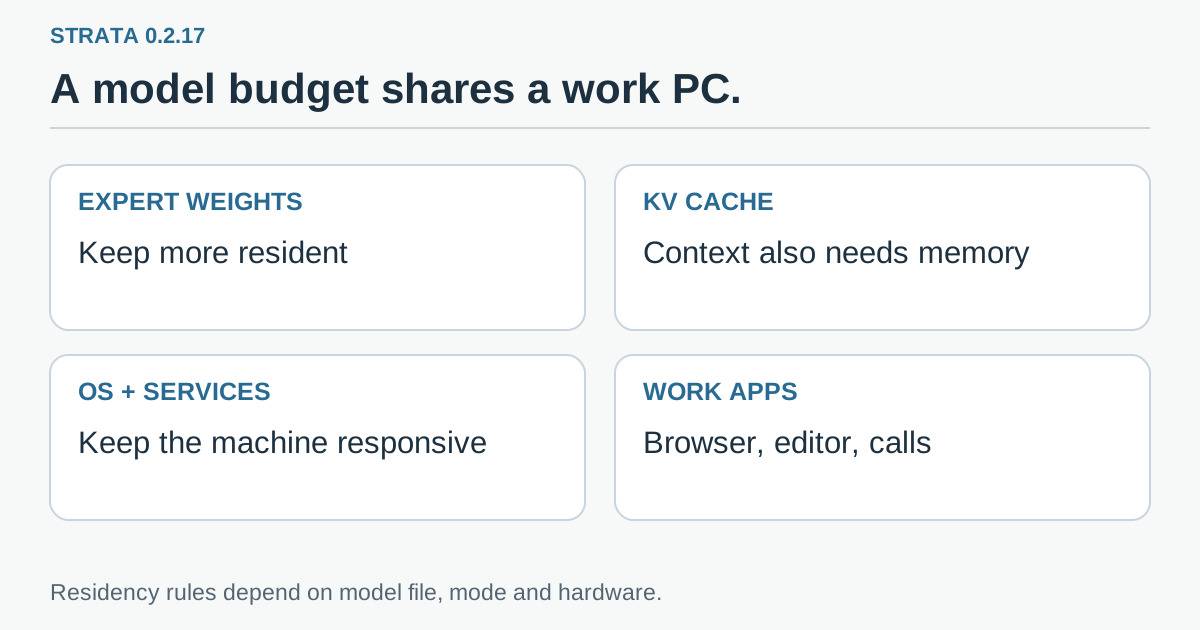 Grafik penjelasan orisinal: bobot pakar, cache runtime yang berubah-ubah, dan aplikasi sehari-hari berbagi memori mesin. Aturan residensi dalam rilis hanya berlaku bagi jalur model yang disebutkan.
Cadangan kerja dalam aplikasi merupakan pilihan awal yang berguna
Bayangkan sebuah workstation pengembang sebagai ilustrasi. Ada sesi peramban panjang, IDE yang sedang mengindeks repositori, serta asisten lokal yang menyiapkan jawaban dari dokumen besar. Konfigurasi asisten yang paling cepat ketika diuji sendirian menjadi kurang berguna jika IDE mulai sering menggunakan swap atau rapat video menjadi tidak andal. Patokan yang tepat adalah seluruh sesi kerja.
Aplikasi Strata menawarkan opsi berlabel “Leave 20% for my work.” Menurut catatan rilis, opsi ini mempertahankan anggaran lama: 40 GiB pada contoh 64 GiB. Terminal, strata serve, Docker, dan mode performa penuh aplikasi memakai alokasi yang lebih baru. Anggaran yang ditentukan pengguna atau pengaturan cadangan eksplisit tetap didahulukan. Instalasi 0.2.16 yang ada dapat menerima migrasi anggaran satu kali pada perintah Strata pertama setelah pembaruan, tanpa menjalankan konfigurasi terpisah, kecuali alokasi sebelumnya diatur secara eksplisit oleh pengguna.
Perbedaan itu penting ketika dua orang mengatakan bahwa mereka menguji pengaturan bawaan. Yang satu mungkin menggunakan mode cadangan kerja di aplikasi desktop, sementara yang lain meluncurkan server dari Terminal. Mereka bisa menjalankan versi aplikasi yang sama dengan keputusan residensi berbeda. Catat mode peluncuran bersama versinya sebelum membandingkan hasil.
Rilis ini juga menjelaskan beberapa pengecualian. Mesin dengan memori CPU/GPU bersama seperti Strix Halo serta jalur pembagian lapisan ke dua kartu mempertahankan cadangan lama. Berkas model lain yang tercantum—IQ2_XS, IQ3_XXS, IQ3_S, dan Q2_0—tidak menerima anggaran residensi ini pada kedua versi. Karena itu, menyalin aturan memori dari satu contoh bukan pengganti yang baik untuk memeriksa konfigurasi model yang tepat.
Pada Windows, mesin baru juga membatasi alokasi awalnya pada memori bebas yang tersedia dikurangi 4.25 GiB. Akibatnya, mesin yang sibuk dapat memulai dengan alokasi di bawah angka utama 47 GiB. Rilis tersebut secara eksplisit mengatakan bahwa perilaku Windows ini tidak diukur dalam contoh. Rilis ini juga menyesuaikan klasifikasi mesin Windows nominal 64GB ketika sistem melaporkan sekitar 63.1 GiB. Rincian itu membantu menjelaskan alokasi berbeda yang teramati; rincian tersebut tidak mengubah pengujian yang dipublikasikan menjadi tolok ukur Windows.
Rekomendasi praktis kami adalah memulai dengan opsi cadangan pada komputer yang digunakan secara interaktif. Cobalah alokasi lebih besar sebagai perbandingan yang disengaja saat beban kerja tujuan sedang berjalan, alih-alih mengambil memori dari aplikasi yang kebetulan Anda tutup untuk pengujian.
Jawaban cepat dan jawaban yang setia memerlukan sakelar terpisah
Perubahan besar kedua menyangkut “Skip rarely used parts of the model,” pengaturan Expert yang diwakili oleh STRATA_ROUTE_TAIL_SKIP. Ini bukan anggaran RAM.
Rilis menjelaskan bahwa, pada kondisi perutean terkait, optimasi ini dapat menghilangkan pekerjaan pakar yang seharusnya disalin dan dihitung. Sebelumnya, optimasi tersebut aktif secara bawaan pada jalur NVIDIA dan Radeon RX 9000. Pengelola mengubah perilaku otomatis setelah adanya laporan penurunan kualitas. Pada 0.2.17, optimasi ini nonaktif kecuali pengguna mengaktifkannya secara eksplisit.
Ada perbedaan penting antara menyimpan bobot yang diperlukan lebih dekat ke prosesor dan memilih untuk tidak mengerjakan sebagian komputasi model. Cara pertama mengubah lokasi data ditemukan. Cara kedua mengubah komputasinya. Meskipun keduanya meningkatkan throughput, risiko keluarannya tidak boleh dinilai seolah-olah keduanya adalah teknik yang sama.
Pada contoh RTX 5090 milik pengelola, dengan UD-Q4_K_XL dan DFlash2, lima jenis permintaan dalam dua putaran menghasilkan rata-rata laju dekode 73.4 token/dtk ketika pelewatan rute nonaktif dan 94.5 ketika aktif. Catatan yang sama menyertakan pengukuran divergensi dengan token yang dipaksakan. Ini merupakan perbandingan konfigurasi yang diterbitkan proyek, bukan penilaian apakah jawaban yang dihasilkan berguna, aman, atau benar untuk aplikasi Anda.
Dampak sehari-harinya adalah pembaruan dapat mengurangi throughput pada jalur tertentu sambil memulihkan perilaku perutean yang lebih lengkap. Itu dapat menjadi hasil yang memang diinginkan. Jika penggunaan Anda mencakup memeriksa angka persis, menghasilkan keluaran terstruktur, atau mengikuti instruksi sulit, menjaga perilaku yang diharapkan bisa lebih bernilai daripada aliran teks yang lebih cepat.
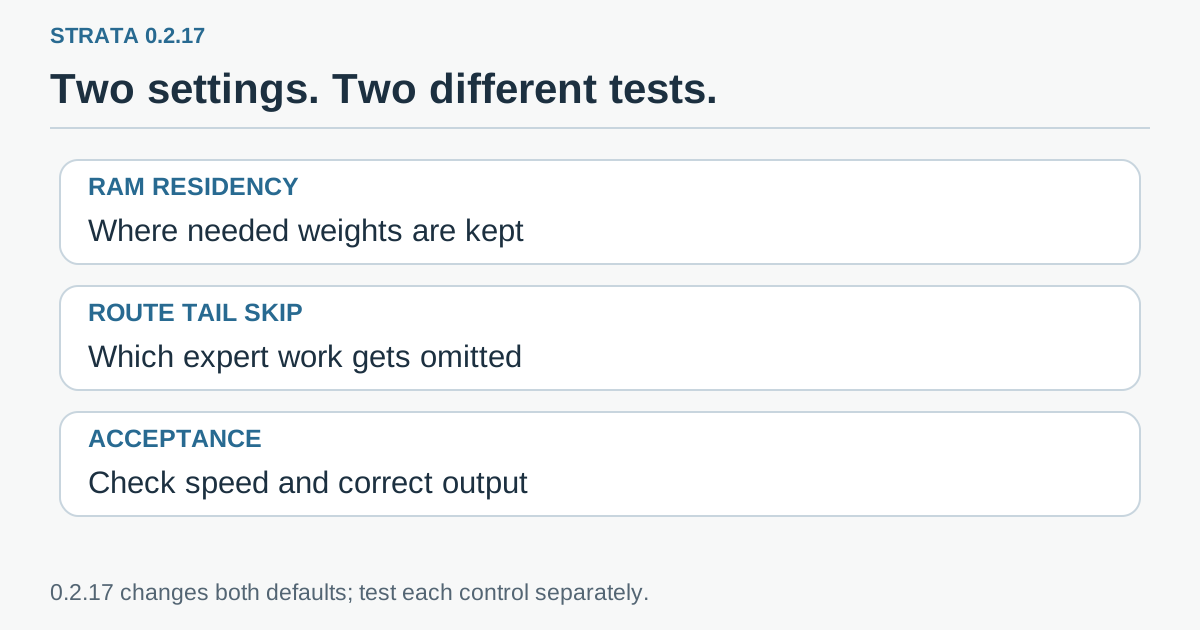 Daftar evaluasi orisinal: ukur tekanan sumber daya secara terpisah dari kualitas jawaban. Mengubah residensi memori dan mengubah pelewatan rute adalah dua eksperimen berbeda.
Pengaturan khusus yang sudah ada merupakan bagian dari riwayat pembaruan Anda
Pengaturan bawaan otomatis dan pilihan eksplisit tidak bermigrasi dengan cara yang sama. Jika Anda belum pernah mengubah pengaturan rute, atau menggunakan nilai otomatisnya, perilaku otomatis yang baru adalah nonaktif. Jika Anda secara eksplisit memilih peringkat 7 atau peringkat lain, catatan rilis mengatakan pilihan itu tetap dipertahankan. Nilai nol yang dipilih secara eksplisit tetap berarti nonaktif.
Hal itu melindungi konfigurasi yang disengaja, tetapi juga berarti memperbarui dua mesin belum tentu menyamakan perilakunya. Salah satu mesin mungkin mempertahankan eksperimen lama yang diaktifkan seseorang berbulan-bulan lalu. Sebelum mendiagnosis regresi, periksa pengaturan yang ikut dibawa saat pembaruan.
Rilis mendokumentasikan strata launch --set STRATA_ROUTE_TAIL_SKIP=7 sebagai cara mengaktifkan perilaku peringkat 7. Perlakukan ini sebagai eksperimen pilihan, bukan langkah pembaruan yang harus dijalankan semua orang. Jika masalah yang ingin dipecahkan adalah keluaran tidak konsisten, terlebih dahulu pastikan optimasi rute nonaktif, bukan mengaktifkannya untuk mengembalikan angka throughput lama.
Ada pula pengaturan bawaan lain dalam 0.2.17, termasuk perubahan pembacaan prompt dan dekode khusus perangkat keras. Beberapa dapat mengubah teks yang dihasilkan. Ini alasan lain untuk tidak mengubah banyak pengaturan sekaligus lalu mengaitkan seluruh perbedaan dengan RAM. Versi, berkas model, jalur perangkat keras, dan penggantian eksplisit bersama-sama membentuk konfigurasi yang benar-benar Anda uji.
Jalankan perbandingan dengan aplikasi yang memang ingin tetap Anda buka
Pengujian berguna tidak memerlukan laboratorium, tetapi memerlukan pertanyaan yang bisa diulang. Untuk PC kerja, tanyakan apakah asisten menyelesaikan tugas yang mewakili penggunaan Anda sementara seluruh mesin tetap nyaman digunakan. Untuk server khusus, tanyakan apakah anggaran yang dipilih mendukung layanan bersamaan yang dituju tanpa kegagalan memori.
- Catat konfigurasi awal. Rekam versi aplikasi dan mesin, sistem operasi, RAM, GPU, berkas model yang tepat, mode peluncuran, ukuran konteks, serta pengaturan memori atau rute eksplisit. Pertahankan model dan kuantisasi yang sama selama perbandingan.
- Pilih tiga pekerjaan yang representatif. Misalnya, gunakan pertanyaan singkat, permintaan berbasis dokumen panjang, dan ekstraksi terstruktur dengan kolom wajib yang sudah diketahui. Ini adalah saran kasus uji, bukan tugas yang kami jalankan untuk artikel ini.
- Tetapkan patokan cadangan kerja. Biarkan peramban, editor, dan aplikasi normal lain tetap terbuka. Amati memori bebas, aktivitas penyimpanan, jeda respons pertama, laju generasi, dan apakah aplikasi tersebut tetap responsif.
- Ubah hanya residensi. Bandingkan alokasi berorientasi performa dengan pengaturan rute yang sama. Perhatikan tekanan memori selama tugas berlangsung dan ketika aplikasi normal lain dijalankan setelahnya.
- Evaluasi keluarannya. Periksa fakta wajib, pemformatan, kepatuhan terhadap instruksi, serta konsistensi dalam pengulangan. Perlakukan ekstraksi yang sintaksnya valid tetapi menghilangkan item wajib sebagai kegagalan.
- Uji pelewatan rute secara terpisah jika diperlukan. Pertahankan anggaran residensi yang sudah dipilih. Bandingkan hasil dengan contoh penerimaan Anda, lalu tentukan apakah kenaikan throughput sepadan dengan perubahan yang teramati.
Untuk dokumen panjang, catat baik awal dingin maupun permintaan ulang. Cache dapat membuat pengujian kedua terlihat sangat berbeda dari yang pertama. Jangan mencampur hasil hangat satu konfigurasi dengan pertemuan pertama konfigurasi lain dengan dokumen tersebut.
Catat pula kegagalan, bukan menghilangkannya lewat perataan. Jawaban cepat yang diikuti kehabisan memori bukan hasil baik untuk layanan latar belakang. Sesi editor yang tidak terganggu dapat menjadi hasil penentu untuk laptop kerja, meskipun pengaturan lain unggul dalam kolom laju dekode.
Pengaturan yang lebih baik menyisakan ruang untuk pekerjaan Anda sebenarnya
Strata 0.2.17 membuat inferensi lokal terasa tidak lagi seperti tolok ukur akselerator tunggal, melainkan pengelolaan komputer kecil yang dipakai bersama. Memori adalah meja bersama: menaruh lebih banyak materi model di atasnya dapat mengurangi perjalanan ke penyimpanan, tetapi pekerjaan tetap memerlukan tempat.
Untuk mesin khusus, alokasi baru merupakan alasan untuk mengukur apakah berkurangnya pembacaan meningkatkan beban kerja yang Anda layani. Untuk workstation sehari-hari, opsi cadangan menjadi titik awal yang masuk akal. Dalam kedua kasus, pertahankan kesetiaan keluaran sebagai kriteria penerimaan tersendiri. Pengaturan yang lebih cepat layak dipilih ketika keseluruhan tugas—bukan sekadar penghitung token—menjadi lebih baik.
Sumber dan media resmi
- Rilis Strata 0.2.17, 20 November 2026: pengaturan, pengukuran dengan batas kondisi, dan perilaku pembaruan.
- Catatan peralihan mesin Strata 0.2.16.
- Ilustrasi antarmuka resmi Strata. Tautan ini menuju subjek yang sebenarnya; grafik yang disertakan merupakan penjelasan orisinal.
Pengukuran di atas diatribusikan kepada proyek dan mempertahankan kondisi perangkat keras serta modelnya. Prosedur evaluasi merupakan alur kerja yang disarankan bagi pembaca.
Rekomendasi Telli.sh: Simpan konfigurasi, prompt representatif, dan catatan perbandingan bersama agar pembaruan berikutnya dimulai dengan patokan yang berguna. Mulai catatan pertama Anda dengan Telli.sh.