เดือนนี้ Nova-3 ถอดเสียงได้ภาษาที่ 58 แต่มีแค่ 10 ภาษาที่พูดปนกันในประโยคเดียวได้
วันที่ 4 สิงหาคม 2026 Deepgram เพิ่มภาษาปัญจาบและเนปาลเข้าไปใน Nova-3 และวันที่ 7 สิงหาคมก็เพิ่มภาษาอาร์เมเนีย พร้อมปรับปรุงภาษาทมิฬ อินโดนีเซีย และเบลารุส เมื่อเก้าเดือนก่อนโมเดลนี้รองรับ 31 ภาษา วันนี้เอกสารระบุไว้ 58 ภาษา แต่การสลับภาษากลางประโยคยังทำได้แค่ 10 ภาษาเท่านั้น และ changelog ของเดือนสิงหาคมเองก็แสดงว่าภาษาอินโดนีเซียดีขึ้นเฉพาะฝั่งแบตช์ ส่วนเบลารุสดีขึ้นเฉพาะฝั่งสตรีมมิ่ง บทความนี้สำรวจความเร็วของการขยายภาษาในระบบรู้จำเสียงพูดที่ใช้ถอดเสียงการประชุม และสิ่งที่คำว่ารองรับกำลังปิดบังอยู่
วันที่ 4 สิงหาคม 2026 Deepgram เพิ่มภาษาปัญจาบและภาษาเนปาลเข้าไปในโมเดลรู้จำเสียงพูด Nova-3 อีกสามวันต่อมาก็เพิ่มภาษาอาร์เมเนีย พร้อมกับโมเดลภาษาเดี่ยวรุ่นปรับปรุงสำหรับภาษาทมิฬ อินโดนีเซีย และเบลารุส
changelog สองรายการ รวมกันสิบเอ็ดบรรทัด ไม่มีข่าวประชาสัมพันธ์ใดๆ แต่สำหรับใครก็ตามที่ต้องประชุมด้วยภาษาเหล่านี้ นี่คือเรื่องที่มีน้ำหนักที่สุดที่เกิดขึ้นกับวงการรู้จำเสียงพูดในเดือนนี้
สิ่งที่มีค่ากว่าตัว changelog คือรูปแบบที่อยู่เบื้องหลังมัน ในเดือนธันวาคม 2025 release notes ของ Deepgram เองระบุว่า Nova-3 รองรับ 31 ภาษา วันนี้ 31 สิงหาคม 2026 เมื่อเรานับรหัสภาษาฐานที่ไม่ซ้ำกันใน Models & Languages Overview ของ Deepgram ตัวเลขที่ได้คือ 58 นี่คือความเร็วที่ทั้งอุตสาหกรรมกำลังเคลื่อนที่ และมันได้เปลี่ยนสิ่งที่คุณควรคาดหวังจากไฟล์ถอดเสียงไปแล้วอย่างเงียบๆ
บทความนี้ทำสามอย่าง หนึ่ง ใส่ตัวเลขและวันที่ที่แน่นอนให้กับการขยายตัวครั้งนี้โดยอ้างอิงจากแหล่งข้อมูลปฐมภูมิ สอง อธิบายว่าทำไมตัวเลขจำนวนภาษาที่พาดหัวถึงแทบไม่มีความหมายเลยเมื่ออยู่ลำพัง และคุณต้องเปลี่ยนไปถามคำถามสามข้อไหนแทน สาม แจกแจงว่าการอัปเดตของเดือนสิงหาคมเปลี่ยนอะไรจริงๆ สำหรับการประชุมที่มีคนพูดภาษาปัญจาบ เนปาล อาร์เมเนีย ทมิฬ หรืออินโดนีเซียนั่งอยู่ในห้อง
TL;DR:
- 58 เทียบกับ 31 เอกสารของ Nova-3 ระบุ 31 ภาษาเมื่อวันที่ 10 ธันวาคม 2025 และระบุรหัสภาษาฐานที่ไม่ซ้ำกัน 58 รหัสเมื่อวันที่ 31 สิงหาคม 2026 รวมแล้วเพิ่มขึ้น 39 ภาษาผ่าน changelog ที่ระบุวันที่ไว้เก้ารายการ
- ความครอบคลุมไม่ใช่ตัวเลขเดียว โหมดสลับภาษา
language=multiของ Deepgram ครอบคลุม 10 ภาษาพอดี ได้แก่ อังกฤษ สเปน ฝรั่งเศส เยอรมัน ฮินดี รัสเซีย โปรตุเกส ญี่ปุ่น อิตาลี และดัตช์ ส่วนอีก 48 ภาษาที่เหลือทำได้ทีละภาษาเท่านั้น- แบตช์กับสตรีมมิ่งคือคนละผลิตภัณฑ์ รีลีสวันที่ 7 สิงหาคมปรับปรุงภาษาทมิฬทั้งสองเส้นทาง ปรับปรุงอินโดนีเซียเฉพาะแบตช์ และปรับปรุงเบลารุสเฉพาะสตรีมมิ่ง changelog รายการเดียวกัน แต่ให้ผลลัพธ์สามแบบ
- โมเดลภาษาเดี่ยวยังชนะอยู่ สำหรับ 48 ภาษาจาก 58 ภาษาของ Nova-3 โมเดลเฉพาะทางไม่ได้แค่ดีกว่าโหมดหลายภาษา แต่มันคือตัวเลือกเดียวที่มีอยู่จริง
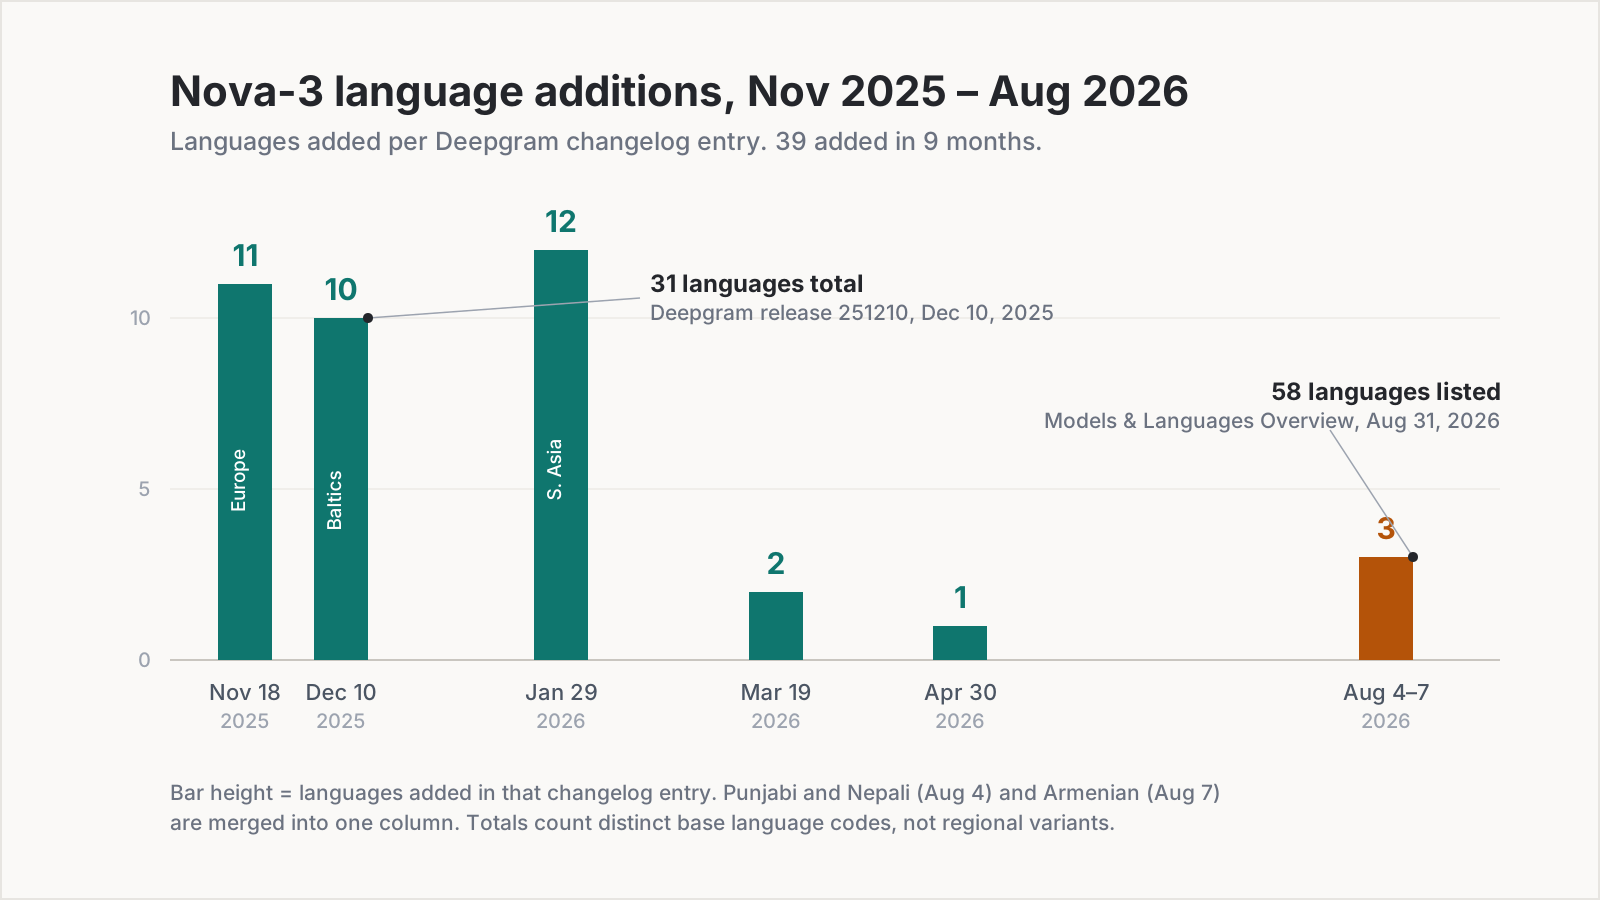
แผนภูมิ: Telli.sh จัดทำจาก changelog ของ Deepgram ระหว่างวันที่ 18 พฤศจิกายน 2025 ถึง 10 สิงหาคม 2026 และจาก Models & Languages Overview ที่ดึงข้อมูลเมื่อวันที่ 31 สิงหาคม 2026
สามสิบเอ็ดภาษาในเดือนธันวาคม ห้าสิบแปดภาษาในเดือนสิงหาคม
ผู้ให้บริการระบบรู้จำเสียงพูดแทบไม่เคยประกาศเรื่องความครอบคลุมภาษาแบบเดียวกับที่ประกาศเรื่องความแม่นยำ มันมาในรูป release notes ครั้งละไม่กี่ภาษา และผลสะสมนั้นมองข้ามได้ง่ายมากถ้าคุณไม่ย้อนกลับไปบวกมันเอง เราจึงบวกให้แล้ว
รีลีส 251118 ของ Deepgram ลงวันที่ 18 พฤศจิกายน 2025 ขยายการรองรับภาษาเดี่ยวของ Nova-3 ด้วย 11 ภาษาใหม่ ได้แก่ บัลแกเรีย เช็ก ฟินแลนด์ ฮินดี ฮังการี ญี่ปุ่น เกาหลี โปแลนด์ รัสเซีย ยูเครน และเวียดนาม สามสัปดาห์ถัดมา รีลีส 251210 ลงวันที่ 10 ธันวาคม 2025 เพิ่มอีก 10 ภาษาจากยุโรปใต้ แถบบอลติก และเอเชียตะวันออกเฉียงใต้ ได้แก่ กรีก โรมาเนีย สโลวัก คาตาลัน ลิทัวเนีย ลัตเวีย เอสโตเนีย เฟลมิช เยอรมันสวิส และมลายู release note ฉบับนั้นมีประโยคที่มีประโยชน์ที่สุดในเรื่องราวทั้งหมดนี้ นั่นคือ Nova-3 รองรับ 31 ภาษาแล้ว
จากจุดนั้นการเพิ่มภาษาก็ไม่เคยหยุด รีลีส 260129 วันที่ 29 มกราคม 2026 เพิ่มอีก 12 ภาษา รวมถึงเบลารุส เบงกอล บอสเนีย และโครเอเชีย รีลีส 260319 วันที่ 19 มีนาคม 2026 นำภาษาไทยและกวางตุ้งเข้ามา รีลีส 260430 วันที่ 30 เมษายน 2026 เพิ่มภาษาคุชราต แล้วก็ถึงเดือนสิงหาคม ปัญจาบและเนปาลในวันที่ 4 อาร์เมเนียในวันที่ 7
บวกภาษาที่มีเอกสารยืนยันทั้งหมดตั้งแต่วันที่ 18 พฤศจิกายน 2025 ถึง 10 สิงหาคม 2026 คุณจะได้ 39 ภาษาในเวลาไม่ถึงเก้าเดือน คิดคร่าวๆ คือหนึ่งภาษาใหม่ทุกเจ็ดวัน อย่างต่อเนื่อง และมาจากผู้ให้บริการรายเดียว
มีรายละเอียดหนึ่งที่ควรสังเกต เพราะมันบอกอะไรบางอย่างเกี่ยวกับวิธีที่รีลีสเหล่านี้เดินทางมาถึงคุณจริงๆ changelog ฝั่งคลาวด์ระบุว่าภาษาปัญจาบและเนปาลมาถึงวันที่ 4 สิงหาคม 2026 ส่วนรีลีสแบบ self-hosted ที่ห่อโมเดลชุดเดียวกัน คือ 260812 ลงวันที่ 12 สิงหาคม ห่างกันแปดวันระหว่าง API แบบโฮสต์กับ container image ถ้าคุณรัน Deepgram บนฮาร์ดแวร์ของตัวเอง คำว่ารองรับมาถึงคุณช้ากว่าคนอื่นเกินหนึ่งสัปดาห์
คำว่ารองรับไม่ใช่เรื่องเดียว แต่เป็นคำถามสามข้อ
ทีนี้มาถึงส่วนที่ตัวเลขพาดหัวปิดบังไว้ เมื่อผู้ให้บริการบอกว่าภาษาหนึ่งได้รับการรองรับแล้ว คำคำเดียวนั้นกำลังทำงานอย่างน้อยสามอย่างพร้อมกัน และงานทั้งสามนี้แยกทางกันอยู่ตลอดเวลา
คุณใช้มันแบบเรียลไทม์ได้ไหม หรือได้เฉพาะย้อนหลัง การถอดเสียงแบบแบตช์กับแบบสตรีมมิ่งรันคนละโมเดลและมีข้อจำกัดคนละแบบ โมเดลสตรีมมิ่งต้องตัดสินใจเลือกคำก่อนจะได้ยินจนจบประโยค ส่วนโมเดลแบตช์ได้ไฟล์เสียงทั้งไฟล์ ผู้ให้บริการปล่อยทั้งสองอย่างแยกกัน และไม่ได้ปล่อยพร้อมกันเสมอไป
โมเดลนี้ดีจริงแค่ไหน คำว่ารองรับบอกคุณแค่ว่ารหัสภาษาจะถูกยอมรับ ไม่ได้บอกว่าผลลัพธ์ใช้กับการประชุมคณะกรรมการได้ ภาษาที่เพิ่งเพิ่มเข้ามาเมื่อเดือนที่แล้วกับภาษาที่ผ่านการปรับปรุงมาสี่รอบ ปรากฏอยู่ในช่องเดียวกันของตารางเดียวกัน
มันปนกับอีกภาษาหนึ่งได้ไหม ข้อนี้แทบไม่มีใครตรวจจนกว่ามันจะพัง การถอดเสียงประชุมที่ทุกคนพูดภาษาเนปาล เป็นคนละโจทย์ทางเทคนิคกับการถอดเสียงประชุมที่คนสลับไปมาระหว่างเนปาลกับอังกฤษกลางประโยค และโจทย์ข้อหลังถูกแก้ไว้ให้ภาษาจำนวนน้อยกว่ามาก
changelog ของเดือนสิงหาคมเองคือภาพประกอบของคำถามข้อแรกที่ชัดเจนที่สุดเท่าที่เราเห็นมาในรอบปี รายการวันที่ 7 สิงหาคมปรับปรุงสี่อย่าง และมันไม่ได้ปรับปรุงอย่างเท่าเทียมกัน
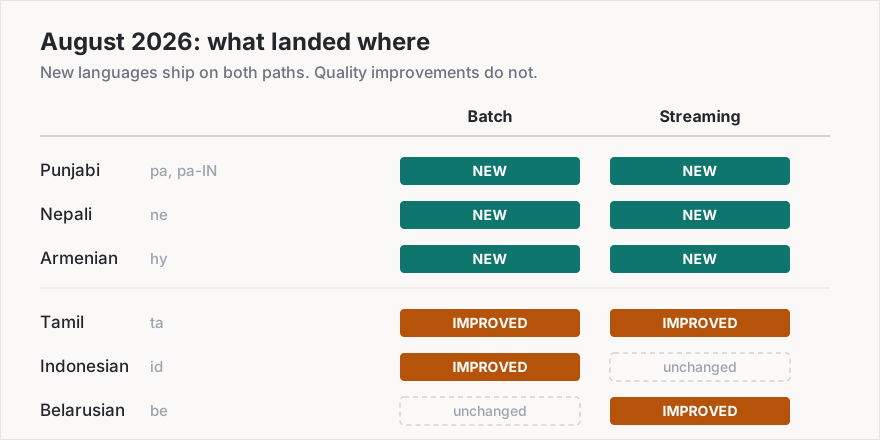
แผนภูมิ: Telli.sh จัดทำจาก changelog ของ Deepgram วันที่ 4 และ 7 สิงหาคม 2026
ภาษาปัญจาบ เนปาล และอาร์เมเนียมาถึงพร้อมกันทั้งสองเส้นทาง Deepgram ระบุตรงๆ ว่าโมเดลทั้งแบบแบตช์และสตรีมมิ่งพร้อมใช้งานสำหรับภาษาเหล่านี้ ภาษาทมิฬได้โมเดลรุ่นปรับปรุงทั้งฝั่งแบตช์และสตรีมมิ่ง ภาษาอินโดนีเซียได้โมเดล แบตช์ รุ่นปรับปรุง แต่ไม่ได้อะไรใหม่สำหรับสตรีมมิ่ง ภาษาเบลารุสได้โมเดล สตรีมมิ่ง รุ่นปรับปรุง แต่ไม่ได้อะไรใหม่สำหรับแบตช์
ถ้าคุณกำลังถอดเสียงบทสัมภาษณ์ภาษาอินโดนีเซียที่บันทึกไว้ วันที่ 7 สิงหาคมเป็นวันที่ดีสำหรับคุณ ถ้าคุณกำลังประชุมสดเป็นภาษาอินโดนีเซีย วันที่ 7 สิงหาคมไม่ได้เปลี่ยนอะไรเลย ข้อเท็จจริงทั้งสองข้ออยู่ในลิสต์เดียวกันของ changelog รายการเดียวกัน และไม่มีบทสรุปของรายการนั้นที่จะบอกคุณได้ว่าข้อไหนใช้กับคุณ
ความไม่สมมาตรนี้ไม่ใช่ความมักง่าย มันสะท้อนข้อเท็จจริงที่ว่านี่คือโมเดลคนละตัวจริงๆ ที่มีงบประมาณการเทรนและการตรวจสอบต่างกัน และมันคือเหตุผลเดียวที่หนักแน่นที่สุดว่าทำไมคุณควรอ่าน changelog ของผู้ให้บริการในระดับภาษาแต่ละภาษา ไม่ใช่ระดับพาดหัว
หน้าผาความครอบคลุม: 58 ภาษา แต่คุยได้ 10 ภาษา
ทีนี้มาถึงคำถามข้อที่สาม ซึ่งเป็นจุดที่ช่องว่างน่าสนใจที่สุดซ่อนอยู่
โหมดสลับภาษาของ Deepgram เปิดใช้ด้วยพารามิเตอร์เดียวคือ language=multi และมันทำให้คำขอเดียวรับมือกับผู้พูดที่สลับภาษาไปมากลางประโยคได้ มันมีประโยชน์จริง และมีให้ใช้บน Nova-2, Nova-3 และ Flux Multilingual มันยังแคบกว่าแคตตาล็อกภาษาเดี่ยวอยู่มากด้วย
บน Nova-3 นั้น language=multi ครอบคลุมสิบภาษาพอดี ได้แก่ อังกฤษ สเปน ฝรั่งเศส เยอรมัน ฮินดี รัสเซีย โปรตุเกส ญี่ปุ่น อิตาลี และดัตช์ ส่วนบน Nova-2 พารามิเตอร์เดียวกันครอบคลุมสองภาษา คือสเปนกับอังกฤษ
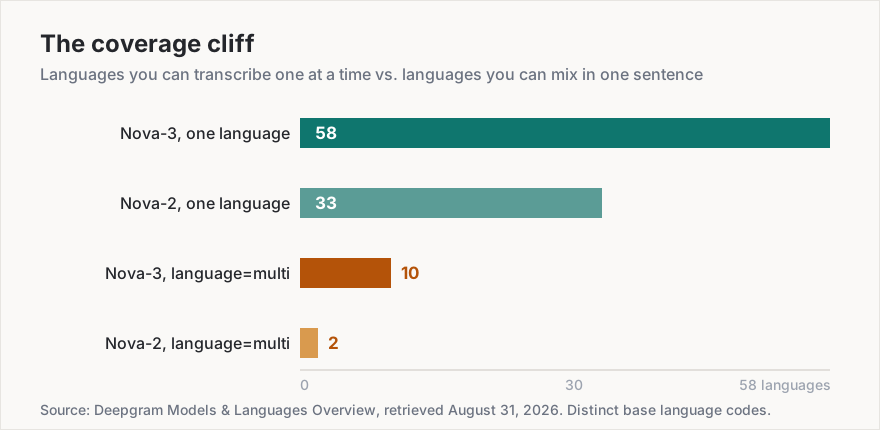
แผนภูมิ: Telli.sh จัดทำจาก Deepgram Models & Languages Overview ที่ดึงข้อมูลเมื่อวันที่ 31 สิงหาคม 2026 การนับใช้รหัสภาษาฐานที่ไม่ซ้ำกัน ไม่รวมตัวแปรตามภูมิภาคและระบบเขียน
เราขอเรียกมันว่า หน้าผาความครอบคลุม คือระยะห่างระหว่างภาษาที่ผู้ให้บริการประกาศไว้ กับภาษาที่การประชุมจริงอันยุ่งเหยิงและปนอังกฤษครึ่งประโยคของคุณได้รับการจัดการจริง ห้าสิบแปดภาษายืนอยู่บนยอดหน้าผานั้น สิบภาษารอดจากการตกลงมา
สำหรับ 48 ภาษาที่อยู่ผิดฝั่ง ทั้งปัญจาบ เนปาล อาร์เมเนีย ทมิฬ เบงกอล ไทย เกาหลี เวียดนาม มลายู และที่เหลือ โมเดลภาษาเดี่ยวเฉพาะทางไม่ได้เป็นแค่ตัวเลือกที่ดีกว่า มันคือตัวเลือกเดียว ไม่มีเส้นทางสลับภาษาให้เอาไปเทียบด้วยซ้ำ
นี่คือประเด็นสำคัญ และมันสวนทางกับสัญชาตญาณที่ว่าโหมดหลายภาษาย่อมเก่งกว่าเสมอ สำหรับภาษาส่วนใหญ่ของโลก โมเดลภาษาเดี่ยวคือตัวเลือกขั้นสูง ไม่ใช่ตัวสำรอง โมเดลเฉพาะทางถูกเทรนบนระบบเสียงของภาษาเดียว การกระจายคำศัพท์ของภาษาเดียว ตัวเลขและวันที่ของภาษาเดียว ส่วนโมเดลหลายภาษาต้องแบกสิบภาษาไว้พร้อมกันแล้วตัดสินทีละคำว่ากำลังได้ยินภาษาไหน เมื่อคุณรู้อยู่แล้วว่าการประชุมนี้เป็นภาษาทมิฬ การบอกเอนจินไปตรงๆ ไม่ใช่ข้อจำกัดที่คุณกำลังยอมรับ แต่มันคือคอนฟิกที่แม่นยำที่สุดเท่าที่คุณมี
language=multi (สลับภาษา) | โมเดลภาษาเฉพาะทาง | |
|---|---|---|
| ความครอบคลุมภาษาบน Nova-3 | 10 ภาษา | 58 ภาษา |
| ความครอบคลุมภาษาบน Nova-2 | 2 ภาษา (สเปน + อังกฤษ) | 33 ภาษา |
| รับมือการสลับภาษากลางประโยค | ได้ | ไม่ได้ เสียงที่นอกภาษาจะทำให้คุณภาพตก |
| ความแม่นยำเมื่อรู้ภาษาแน่ชัดภาษาเดียว | ต่ำกว่า เพราะโมเดลต้องตัดสินระหว่างตัวเลือก | สูงกว่า เพราะโมเดลถูกทำมาเฉพาะทาง |
| Keyterm prompting | ได้บน Nova-3 Multi สูงสุด 500 โทเคน (ราว 100 คำ) ตั้งแต่ 10 ธันวาคม 2025 | ได้ |
| ค่าที่แนะนำสำหรับสตรีมมิ่ง | endpointing=100 ตามคู่มือของ Deepgram | ค่า endpointing เริ่มต้น |
| รองรับปัญจาบ เนปาล อาร์เมเนีย ทมิฬ | ไม่ | ใช่ |
วิธีอ่านตารางนี้ในทางปฏิบัติคือ ถ้าการประชุมของคุณสลับอังกฤษกับสเปนแบบประโยคต่อประโยคจริงๆ ให้ใช้ multi แล้วยอมรับการแลกด้านความแม่นยำ แต่ถ้าการประชุมของคุณเป็นภาษาทมิฬที่มีคำยืมภาษาอังกฤษโผล่มาเป็นครั้งคราว ซึ่งคือสิ่งที่การประชุมแบบหลายภาษาส่วนใหญ่เป็นจริงๆ ให้ตั้ง language=ta แล้วปล่อยให้โมเดลเฉพาะทางทำงานของมัน
เดือนนี้ใครได้ถอดเสียงการประชุมที่ดีขึ้นจริง ๆ
พอเรื่องสถาปัตยกรรมแค่นี้ มีหกภาษาที่เปลี่ยนสถานะในเดือนสิงหาคม 2026 และหลังรหัสภาษาแต่ละตัวคือประชากรที่ถอดเสียงประชุมได้แย่มาตลอด หรือไม่ได้ถอดเลย
| ภาษา | รหัส | จำนวนผู้พูด | สิ่งที่เปลี่ยนในเดือนสิงหาคม 2026 |
|---|---|---|---|
| ปัญจาบ | pa, pa-IN | ราว 125 ล้านคน | ใหม่บน Nova-3 ทั้งแบตช์และสตรีมมิ่ง (4 ส.ค.) |
| เนปาล | ne | ราว 16 ล้านคน | ใหม่บน Nova-3 ทั้งแบตช์และสตรีมมิ่ง (4 ส.ค.) |
| อาร์เมเนีย | hy | ราว 6.7 ล้านคน | ใหม่บน Nova-3 ทั้งแบตช์และสตรีมมิ่ง (7 ส.ค.) |
| ทมิฬ | ta | ราว 75 ล้านคนที่เป็นเจ้าของภาษา | โมเดลดีขึ้น ทั้งแบตช์และสตรีมมิ่ง (7 ส.ค.) |
| อินโดนีเซีย | id | ราว 199 ล้านคน รวมผู้ใช้เป็นภาษาที่สอง | โมเดลแบตช์ดีขึ้นเท่านั้น (7 ส.ค.) |
| เบลารุส | be | ราว 7.6 ล้านคน | โมเดลสตรีมมิ่งดีขึ้นเท่านั้น (7 ส.ค.) |
ตัวเลขผู้พูด: ข้อมูล Ethnologue ที่รวบรวมไว้บน Wikidata (พร็อพเพอร์ตี P1098) ดึงข้อมูลเมื่อวันที่ 31 สิงหาคม 2026 ตัวเลขปัดเศษแล้ว
คิดคร่าวๆ คือราว 430 ล้านคนที่ภาษาของตัวเองได้ระบบรู้จำเสียงพูดที่ดีขึ้นแบบวัดผลได้ภายในสัปดาห์เดียว และในจำนวนนั้นราว 148 ล้านคน ซึ่งก็คือผู้พูดภาษาปัญจาบ เนปาล และอาร์เมเนีย เปลี่ยนจากการไม่มีตัวเลือกระดับชั้นหนึ่งบน Nova-3 เลย มาเป็นมีทั้งฝั่งแบตช์และสตรีมมิ่ง
ลองนึกภาพว่านั่นหมายถึงอะไรในห้องประชุมจริง สแตนด์อัพของทีมวิศวกรรมในจัณฑีครห์ ที่เมื่อก่อนต้องพูดภาษาที่สองเพื่อเอาใจเครื่องมือ หรือไม่ก็ปล่อยให้ไม่มีบันทึกเลย ตอนนี้ผลิตไฟล์ถอดเสียงแบบเรียลไทม์ได้แล้ว การสรุปงานภาคสนามขององค์กรพัฒนาเอกชนในกาฐมาณฑุกลายเป็นบันทึกที่ค้นหาได้ แทนที่จะเป็นสมุดจดของใครสักคน การให้ปากคำทางกฎหมายในภาษาอาร์เมเนียถอดเสียงสดได้ แทนที่จะต้องส่งออกไปให้คนถอดโดยคิดเงินเป็นนาที
มีผลลัพธ์อันดับสองที่สำคัญยิ่งกว่าตัวไฟล์ถอดเสียงเสียอีก เมื่อเสียงพูดในภาษาหนึ่งอ่านได้ด้วยเครื่องแบบเรียลไทม์แล้ว ทุกอย่างที่อยู่ปลายน้ำจะปลดล็อกพร้อมกันทันที ทั้งการแปลสดสำหรับผู้เข้าร่วมทางไกล การสรุปอัตโนมัติ การดึงรายการงานที่ต้องทำ และการค้นหาข้ามการประชุมทั้งปี ระบบรู้จำเสียงพูดคือคอขวดของทั้งสายพาน ทุกภาษาที่ผ่านด่านนี้ไปได้ จะได้รับมรดกเป็นไปป์ไลน์ทั้งชุดที่เคยสร้างไว้ให้ภาษาอังกฤษ
ถ้าคุณอยู่ในทีมที่มีใครสักคนสลับไปพูดอังกฤษเป็นนิสัยเพราะเครื่องมือไม่รองรับภาษาของเรา นี่คืออัปเดตที่ยุติข้อประนีประนอมนั้น
วิธีเลือกการตั้งค่าภาษาสำหรับประชุมสองภาษาและประชุมหลายภาษา
การปรับปรุงฝั่งเอนจินจะช่วยได้ก็ต่อเมื่อคุณตั้งค่าเซสชันถูกต้อง และค่าเริ่มต้นมักผิดสำหรับทีมที่ใช้หลายภาษา ห้าขั้นตอน เรียงตามลำดับ
- เริ่มจากดูว่าการประชุมมีภาษาหลักภาษาเดียว หรือปนกันจริงๆ คำยืมภาษาอังกฤษที่โผล่มาเป็นครั้งคราวในการประชุมภาษาทมิฬนับเป็น หนึ่ง ภาษา ส่วนการสลับประโยคเต็มไปมาระหว่างสเปนกับอังกฤษนับเป็น สอง ภาษา มีเฉพาะกรณีหลังเท่านั้นที่ต้องใช้การสลับภาษา
- ถ้าเป็นภาษาเดียว ให้ระบุภาษานั้นไปตรงๆ ใช้
model=nova-3คู่กับรหัสที่เจาะจง เช่นlanguage=paสำหรับปัญจาบlanguage=neสำหรับเนปาล และlanguage=hyสำหรับอาร์เมเนีย อย่าปล่อยให้ระบบตรวจจับเอง คุณรู้คำตอบอยู่แล้ว และการบอกโมเดลไม่มีต้นทุนอะไรเลย - ถ้าปนกันจริงๆ ให้เทียบภาษาเหล่านั้นกับรายชื่อสิบภาษาก่อน ตั้ง
language=multiก็ต่อเมื่อทุกภาษาในห้องอยู่ในกลุ่มอังกฤษ สเปน ฝรั่งเศส เยอรมัน ฮินดี รัสเซีย โปรตุเกส ญี่ปุ่น อิตาลี ดัตช์ ถ้ามีภาษาใดไม่อยู่ในนั้นmultiจะช่วยคุณไม่ได้ และโมเดลของภาษาหลักคือทางเลือกที่ดีที่สุดที่คุณมี - สำหรับเซสชันสดที่ใช้
multiให้ตั้งendpointingเป็น 100 คู่มือการสลับภาษาของ Deepgram เองแนะนำ 100 มิลลิวินาทีสำหรับกรณีสลับภาษาโดยเฉพาะ แทนค่าเริ่มต้นที่สูงกว่านั้น ค่า endpointing ที่ยาวเกินไปจะทำให้วลีที่สลับภาษาถูกกลืนเข้าไปในเซกเมนต์ที่ผิด - ตรวจสอบแบตช์และสตรีมมิ่งแยกกันก่อนจะไปสัญญาอะไรกับใคร อย่างที่วันที่ 7 สิงหาคมแสดงให้เห็น การปรับปรุงฝั่งหนึ่งไม่ใช่การปรับปรุงอีกฝั่ง ให้เอาไฟล์ตัวอย่างความยาว 10 นาทีชุดเดียวกันรันผ่านทั้งสองเส้นทางแล้วเทียบกัน แทนที่จะเดาว่า changelog รายการหนึ่งใช้ได้กับเส้นทางของคุณ
เราเคยเขียนถึงอีกแง่มุมหนึ่งของเรื่องนี้ไว้เมื่อเดือนมิถุนายน คือ อัปเดตกลางปีของ Deepgram เรื่องเซสชันสดแบบปรับเปลี่ยนได้และการแยกผู้พูด ซึ่งรวมถึงคำสั่งควบคุม UpdateListen ที่ทำให้เซสชันซึ่งกำลังทำงานอยู่เปลี่ยนคำใบ้ภาษาได้โดยไม่ต้องเชื่อมต่อใหม่ ขั้นตอนที่ 2 ข้างต้นกับความสามารถนี้เข้ากันได้ดี ตั้งภาษาไว้ชัดเจนตั้งแต่เริ่ม แล้วปรับกลางการประชุมถ้าห้องเปลี่ยนภาษาจริง
บทสรุป: ความครอบคลุมเลิกเป็นตัวเลข แล้วกลายเป็นเมทริกซ์
สัญชาตญาณเวลาเปรียบเทียบเอนจินเสียงพูดคือมองหาตัวเลขที่ใหญ่ที่สุด ทอเคนไนเซอร์ของ Whisper จาก OpenAI ประกาศโทเคนภาษาไว้ 100 รายการมาตั้งแต่ปี 2022 ซึ่งเกือบสองเท่าของ 58 ภาษาบน Nova-3 และการเปรียบเทียบนั้นแทบไม่บอกอะไรเลย เพราะ Whisper ไม่มีเส้นทางสตรีมมิ่งในตัว และโทเคนที่ประกาศไว้ไม่ใช่โมเดลที่ผ่านการตรวจสอบสำหรับใช้งานจริง Nova-3 ระบุภาษาน้อยกว่า แต่ส่งมอบจริงเป็นรายภาษา รายโหมด พร้อมหลักฐานที่ระบุวันที่
ตัวเลขที่อธิบายความครอบคลุมจริงของเอนจินไม่ใช่จำนวนนับ แต่เป็นเมทริกซ์ ภาษา คูณ โหมด คูณ ระดับคุณภาพ ห้าสิบแปดภาษาแบบทีละภาษา สิบภาษาที่ปนกันได้ หนึ่งภาษาดีขึ้นเฉพาะแบตช์ไม่ใช่สตรีมมิ่ง อีกภาษาดีขึ้นเฉพาะสตรีมมิ่งไม่ใช่แบตช์ ในรีลีสเดียวกัน วันเดียวกัน
ดังนั้นคำถามที่ควรเอาไปถามในการประเมินผู้ให้บริการครั้งหน้าจึงไม่ใช่ว่าคุณรองรับกี่ภาษา แต่คือ สำหรับภาษาของฉัน บนเส้นทางของฉัน ณ วันที่เท่าไร
Telli.sh อยู่ตรงไหนในเรื่องนี้: ทั้งหมดข้างต้นคือรายละเอียดระดับเอนจิน และเราคิดว่าทีมส่วนใหญ่ไม่ควรต้องรู้เรื่องพวกนี้เลย Telli.sh วางตัวอยู่บนชั้นนั้นและตัดสินใจแทนคุณตามรายการที่เป็นข้อๆ ข้างบน ทั้งการเลือกโมเดลเฉพาะทางเมื่อการประชุมมีภาษาเดียว การดูแลให้ไฟล์อัปโหลดและเซสชันสดวิ่งอยู่บนเส้นทางที่ถูกต้องของตัวเอง และการรับมรดกการปรับปรุงเอนจินอย่างของเดือนสิงหาคมภายในสัปดาห์ที่มันออก ไม่ใช่รอถึงการย้ายระบบครั้งหน้าของคุณ เหนือไฟล์ถอดเสียงขึ้นไป เรามีการแปลสดเป็น 44 ภาษาปลายทางและอินเทอร์เฟซ 15 ภาษา คนที่เข้าร่วมสแตนด์อัพภาษาปัญจาบของคุณจากวอร์ซอจึงอ่านมันเป็นภาษาโปแลนด์ได้ในขณะที่มันกำลังเกิดขึ้น
เริ่มบันทึกการประชุมพร้อมแปลสด
แหล่งข้อมูล
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — ภาษาปัญจาบ (
pa,pa-IN) และเนปาล (ne) พร้อมใช้ทั้งแบตช์และสตรีมมิ่ง - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — ภาษาอาร์เมเนีย (
hy) เป็นภาษาใหม่ โมเดลแบตช์รุ่นปรับปรุงสำหรับทมิฬและอินโดนีเซีย โมเดลสตรีมมิ่งรุ่นปรับปรุงสำหรับทมิฬและเบลารุส - Deepgram Models & Languages Overview — ตารางภาษาฉบับเต็มของ Nova-3 และ Nova-2 พร้อมรายชื่อภาษาของ
multiดึงข้อมูลเมื่อวันที่ 31 สิงหาคม 2026 - Deepgram Multilingual Codeswitching guide — การใช้งาน
language=multiและคำแนะนำendpointing=100ดึงข้อมูลเมื่อวันที่ 31 สิงหาคม 2026 - Deepgram Self-Hosted release 251210, December 10, 2025 — ระบุว่า Nova-3 รองรับ 31 ภาษาแล้ว และ keyterm prompting หลายภาษาสูงสุด 500 โทเคน
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11 ภาษาใหม่ พร้อมโมเดลตรวจจับภาษา 36 ภาษา
- Deepgram Self-Hosted release 260129, January 29, 2026 — 12 ภาษาใหม่บน Nova-3 รวมถึงเบลารุส เบงกอล บอสเนีย และโครเอเชีย
- Deepgram Self-Hosted release 260319, March 19, 2026 — ภาษาไทยและกวางตุ้ง
- Deepgram Self-Hosted release 260430, April 30, 2026 — ภาษาคุชราต
- Deepgram Self-Hosted release 260812, August 12, 2026 — ชุด self-hosted ของภาษาเนปาลและปัญจาบ ตามหลัง changelog ฝั่งคลาวด์แปดวัน
- OpenAI Whisper tokenizer language table — โทเคนภาษาที่ประกาศไว้ 100 รายการ ดึงข้อมูลเมื่อวันที่ 31 สิงหาคม 2026
- Wikidata property P1098 (number of speakers) — จำนวนผู้พูดจาก Ethnologue สำหรับ
pa,ne,hy,ta,id,beดึงข้อมูลเมื่อวันที่ 31 สิงหาคม 2026 - บทความเดือนมิถุนายน 2026 ของเราเกี่ยวกับอัปเดตเซสชันสดและการแยกผู้พูดของ Deepgram