[สมุดไอเดีย AI 01] SlideOn: โมเดลค้นหาที่เล็กลงพร้อมตัวควบคุมต้นทุนสองแบบ
รู้จัก SlideOn และ mSlideOn จาก LightOn โมเดลค้นคืนแบบเบาบางสำหรับเอกสารภาษาอังกฤษและหลายภาษา พร้อมการทดลองเบื้องต้นและวิธีเปรียบเทียบคุณภาพ ความเร็ว และพื้นที่จัดเก็บอย่างชัดเจน
สมุดไอเดีย AI ชวนสำรวจแนวคิดและความเป็นไปได้ในการใช้งานจริงของโมเดลและเครื่องมือ AI ที่เพิ่งเริ่มปรากฏขึ้น
คุณจำได้ว่ามีเอกสารอธิบายวิธียกเลิกคำสั่งซื้อ แต่ช่องค้นหาจำได้เพียงคำว่า การยกเลิก ขณะที่เอกสารกลับเรียกกระบวนการเดียวกันว่า การถอนคำสั่งซื้อ คลังเอกสารจึงอาจมีคำตอบที่ต้องการอยู่แล้ว แต่ยังค้นหาได้ยาก
LightOn เปิดตัว SlideOn และ mSlideOn เมื่อวันที่ 19 ตุลาคม 2026 ในฐานะโมเดลสองตัวสำหรับค้นคืนเอกสารที่เกี่ยวข้อง SlideOn เน้นภาษาอังกฤษ ส่วน mSlideOn ขยายแนวทางนี้ไปยังข้อความหลายภาษา เอกสารยาว และโค้ด จุดที่น่าสนใจคือมีงบประมาณให้ปรับได้สองส่วน ได้แก่ จำนวนคุณลักษณะที่คำค้นใช้ และจำนวนคุณลักษณะที่เก็บไว้สำหรับเอกสารแต่ละฉบับ ประกาศจาก LightOn
บทความนี้อธิบายว่าโมเดลเหล่านี้เหมาะกับงานใด ตัวควบคุมทั้งสองเปลี่ยนอะไร และจะเริ่มเปรียบเทียบในขนาดเล็กก่อนสร้างบริการค้นหาได้อย่างไร คุณไม่จำเป็นต้องสร้างแอปแชตใหม่เพื่อเข้าใจแนวคิดนี้ เริ่มจากคำถาม เอกสารไม่กี่ฉบับ และนิยามของผลลัพธ์ที่มีประโยชน์ก็เพียงพอ
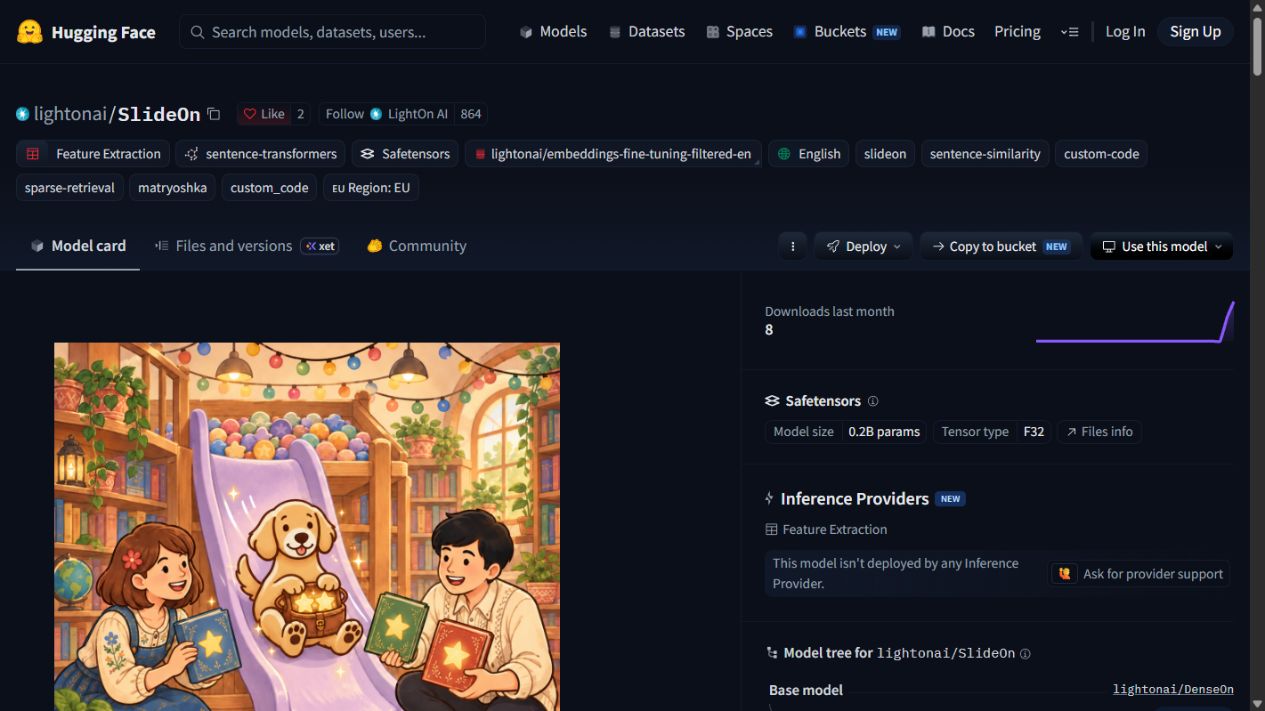 ภาพหน้าจอโมเดลการ์ดสาธารณะ ถ่ายเมื่อวันที่ 20 ตุลาคม 2026 ที่มา: LightOn บน Hugging Face นี่คือหน้าโมเดลที่เผยแพร่ ไม่ใช่ผลการอนุมานบนเครื่องของเรา หน้าจอยังแสดงด้วยว่าโมเดลที่ดาวน์โหลดได้อาจไม่มีผู้ให้บริการอนุมานแบบโฮสต์
ก่อนตอบคำถาม การค้นหาต้องคัดแหล่งข้อมูลให้ดี
ตัวค้นคืนจัดอันดับเอกสารตามคำค้น โดยไม่จำเป็นต้องเขียนคำตอบ สรุปไฟล์ หรือตัดสินว่าบริษัทควรเปลี่ยนนโยบายหรือไม่ หน้าที่เฉพาะหน้าของมันแคบกว่านั้น คือวางแหล่งข้อมูลที่เกี่ยวข้องมากที่สุดไว้ใกล้ด้านบน
ลองนึกถึงคู่มือภายในที่มีสามหน้าเกี่ยวกับการคืนสินค้า การจัดส่ง และวันหยุดพนักงาน คำถามเรื่องส่งคืนสินค้าที่เสียหายควรดึงหน้าการคืนสินค้าขึ้นมา หากผลลัพธ์แรกกลับพูดถึงปฏิทินวันหยุด ตัวสร้างคำตอบที่ทำงานต่อจากนั้นก็เริ่มต้นด้วยหลักฐานผิดชุดไปแล้ว แม้จะใช้ภาษาลื่นไหลเพียงใดก็ตาม
ความแตกต่างนี้ทำให้การค้นคืนมีประโยชน์ได้แม้ไม่มี AI สร้างข้อความ เจ้าหน้าที่สนับสนุนเปิดเอกสารที่จัดอันดับไว้ได้โดยตรง นักวิจัยรวบรวมข้อความมาเปรียบเทียบได้ เครื่องมือเขียนโค้ดใช้การค้นคืนเพื่อหาโค้ดที่น่าจะเกี่ยวข้อง ก่อนให้คนตรวจสอบต่อได้
ยังเป็นการแยกความรับผิดชอบที่มีประโยชน์ด้วย การค้นคืนช่วยระบุตำแหน่งหลักฐาน ส่วนเอกสารต้นฉบับยังเป็นที่สำหรับตรวจถ้อยคำ วันที่ และข้อยกเว้น ผลลัพธ์ที่ดีควรช่วยให้เข้าถึงแหล่งนั้นได้ง่ายขึ้น แทนที่จะใช้คะแนนความมั่นใจมาแทนที่แหล่งข้อมูล
การค้นหาแบบเบาบางเก็บสมุดที่อยู่ที่เลือกเฉพาะรายการ
ลองมองดัชนีค้นหาเป็นสมุดที่อยู่ ดัชนีคำสำคัญแบบทั่วไปบันทึกว่าเอกสารใดมีคำใดอยู่ โมเดลแบบเบาบางที่เรียนรู้ได้สร้างสมุดที่อยู่อีกแบบหนึ่ง โดยกำหนดน้ำหนักให้ชุดคุณลักษณะที่เรียนรู้มาจำนวนค่อนข้างน้อย แล้วใช้คุณลักษณะที่เปิดใช้งานร่วมกันเพื่อให้คะแนนคำค้นเทียบกับเอกสาร
คำว่า เบาบาง อธิบายการเลือกใช้อย่างจำกัดนี้ ตัวแทนข้อมูลอาจมีตำแหน่งที่เป็นไปได้มากมาย แต่ใช้เพียงบางส่วนสำหรับข้อความหนึ่งชุด ดัชนีกลับด้านสามารถเชื่อมคุณลักษณะที่เปิดใช้งานแต่ละตัวกับเอกสารที่ใช้มัน ช่วยให้เครื่องมือค้นหาเน้นรายการโพสติงที่เกี่ยวข้องได้
โมเดลการ์ดของ SlideOn ระบุว่ามี คุณลักษณะที่เรียนรู้ได้ 32,768 ตำแหน่ง พร้อมตัวควบคุมการตัดคุณลักษณะของคำค้นและเอกสารที่แยกจากกัน ตำแหน่งเหล่านี้เป็นตัวแปรแฝงที่เรียนรู้มา ไม่ใช่พจนานุกรมคำภาษาอังกฤษที่อ่านความหมายได้ตรงไปตรงมา จึงไม่ควรตีความว่าคุณลักษณะหมายเลข 100 ต้องเป็นคำพ้องของ “การคืนสินค้า” โมเดลการ์ด SlideOn
รายละเอียดนี้สำคัญเวลาอธิบายผลลัพธ์ ตัวแทนแบบเบาบางอาจประหยัดต้นทุนค้นหาได้ โดยไม่ได้ทำให้ทุกการตัดสินใจภายในอธิบายเป็นภาษาคนได้ คำอธิบายที่ใช้ได้จริงสำหรับผู้ใช้ยังควรเป็นข้อความที่เกี่ยวข้องจากเอกสารต้นฉบับ พร้อมบริบทมากพอให้ตรวจว่าทำไมจึงตรงกับคำถาม
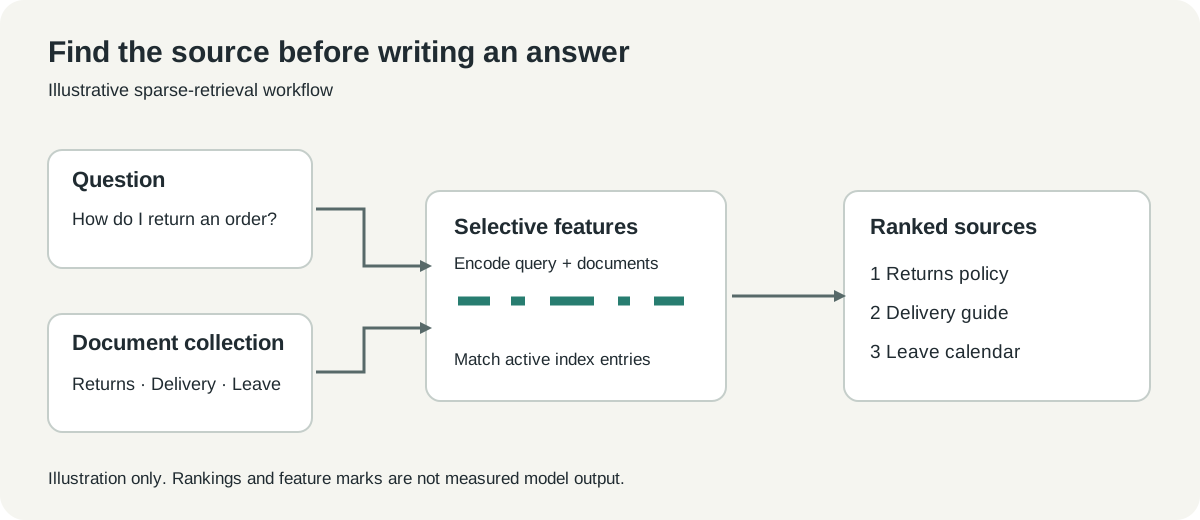 แผนภาพอธิบายที่จัดทำขึ้นใหม่ เครื่องหมายคุณลักษณะในตัวอย่างมีไว้แสดงกระบวนการ ไม่ใช่ค่าการเปิดใช้งานที่วัดจาก SlideOn
เลือกโมเดลให้ตรงกับคลังเอกสารที่มีจริง
ชื่อทั้งสองหมายถึงจุดเริ่มต้นที่เกี่ยวข้องกัน ไม่ใช่การตั้งค่าภาษาที่สลับแทนกันได้ ในประกาศเปิดตัว LightOn ระบุว่า SlideOn มี 174 ล้านพารามิเตอร์ และ mSlideOn มี 339 ล้านพารามิเตอร์ ตัวเลขที่มากกว่าเพียงอย่างเดียวไม่ได้บอกว่าตัวใดจะทำงานกับคลังเอกสารของคุณได้ดีกว่า ประกาศวันที่ 19 ตุลาคม
| คลังเอกสารของคุณ | ตัวเลือกแรกที่เหมาะจะลอง | คำถามที่การทดลองควรตอบ |
|---|---|---|
| บทความช่วยเหลือภาษาอังกฤษ | SlideOn | ค้นพบบทความที่ถูกต้องหรือไม่ เมื่อคำค้นใช้ถ้อยคำต่างจากเอกสาร |
| เอกสารหลายภาษา | mSlideOn | แต่ละภาษาที่สำคัญทำงานได้ดีหรือไม่ และการค้นข้ามภาษาเป็นไปตามที่ต้องการหรือไม่ |
| เอกสารเทคนิคยาว | mSlideOn พร้อมแผนแบ่งส่วนข้อความที่รอบคอบ | ส่วนที่เกี่ยวข้องยังคงอยู่หลังการเตรียมข้อมูลและการจัดอันดับหรือไม่ |
| ซอร์สโค้ดปนกับข้อความอธิบาย | mSlideOn เป็นหนึ่งในตัวเลือก | ไฟล์ที่ได้มีประโยชน์ต่อผู้ที่รู้จักรีโพซิทอรีหรือไม่ |
ป้ายว่ารองรับหลายภาษาเป็นเหตุผลให้สำรวจต่อ ไม่ใช่ทางลัดข้ามการประเมิน แค็ตตาล็อกสองภาษาอาจมีเอกสารแปล นโยบายแต่ละภูมิภาคที่แตกต่างกัน และคำศัพท์ที่ไม่มีคำแปลตรงตัวเพียงคำเดียว สิ่งเหล่านี้เป็นปัญหาการค้นคืนคนละแบบ แม้เอกสารจะใช้แท็กภาษาเดียวกัน
เช่น ลองค้นนโยบายคืนเงินภาษาฝรั่งเศสด้วยคำถามภาษาอังกฤษ นี่คืองานค้นข้ามภาษา ส่วนการค้นเอกสารฝรั่งเศสด้วยคำค้นฝรั่งเศสคืองานภาษาเดียวกัน ควรบันทึกแยกกัน เพราะคะแนนรวมอาจซ่อนประสบการณ์ที่อ่อนแอของผู้อ่านบางกลุ่ม
หลักการเดียวกันใช้กับโค้ด การหาไฟล์เรื่อง “การกู้คืนเซสชัน” ต่างจากการค้นชื่อฟังก์ชันที่ตรงตัว ควรเก็บทั้งคำค้นตัวระบุแบบตรงตัวและคำถามเชิงอธิบายไว้ในการเปรียบเทียบ เพราะระบบค้นหาที่ใช้งานได้ดีมักต้องรองรับทั้งสองแบบ
การทดลองแรกทำในโน้ตบุ๊กได้
เริ่มจากข้อความสาธารณะหรือข้อความสังเคราะห์ และสภาพแวดล้อม Python ที่สะอาด ตัวอย่างที่เผยแพร่ใช้ SparseEncoder ของ Sentence Transformers ซึ่งเป็นอินเทอร์เฟซโหลดโมเดล ไม่ใช่เซิร์ฟเวอร์ค้นหาครบชุด ตัวอย่างต่อไปนี้ดัดแปลงจากวิธีทางการ ตรวจสอบเมื่อวันที่ 20 ตุลาคม 2026 วิธีใช้ในเอกสาร
- เปิดโมเดลการ์ดและตรวจโค้ดอนุมานที่กำหนดเองกับไลบรารีที่ต้องใช้ ตัวโหลดด้านล่างใช้
trust_remote_code=Trueซึ่งอนุญาตให้รันโค้ด Python จากรีโพซิทอรีนั้น ควรใช้ revision ที่ตรวจแล้วเพื่อให้ทดลองซ้ำได้ - สร้างสภาพแวดล้อมแยกและติดตั้งไลบรารีในช่วงเวอร์ชันที่เอกสารระบุ
- เข้ารหัสคำค้นหนึ่งรายการและเอกสารสั้นไม่กี่ฉบับ ใช้เมธอดคำค้นและเอกสารของโมเดล แทนการเติมคำนำหน้าด้วยตัวเอง
- ตรวจคะแนนควบคู่กับข้อความจริง การตรวจครั้งแรกนี้ดูเรื่องลำดับ ไม่ใช่หาเกณฑ์คะแนนที่ใช้ได้ทุกกรณี
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
เอกสารด้านบนเป็นตัวอย่างที่แต่งขึ้นเพื่อสอน ไม่มีการอ้างผลลัพธ์หรือความแม่นยำที่วัดได้จากโค้ดนี้ คุณควรตรวจว่าเอกสารคืนสินค้าขึ้นอันดับแรกหรือไม่ แล้วลองถามใหม่ด้วยถ้อยคำอื่นและตัวเลือกที่ตั้งใจให้ยาก
อย่าหยุดเมื่อคำค้นที่ง่ายที่สุดทำงานได้ ลองถามเรื่องยกเลิกก่อนส่งสินค้า พัสดุเสียหายหลังจัดส่ง และการคืนเงินหลังพ้นกำหนด หากคลังเอกสารไม่มีคำตอบ การทดสอบควรเปิดเผยช่องว่างนั้น แทนที่จะให้รางวัลกับผลลัพธ์ที่ดูดีแต่ไม่เกี่ยวข้อง
งบประมาณสองส่วนตอบต้นทุนคนละคำถาม
การตัดคุณลักษณะคำค้นจำกัดจำนวนคุณลักษณะที่ใช้เมื่อถามคำถาม ส่วนการตัดคุณลักษณะเอกสารจำกัดจำนวนที่เก็บไว้ต่อรายการในดัชนี ในบริการขนาดใหญ่ งบประมาณแรกเกี่ยวกับงานที่เกิดซ้ำทุกครั้งที่ค้นหา ส่วนงบประมาณที่สองยังกระทบดัชนีซึ่งคงอยู่ระหว่างการค้นหา
การทดลองที่มีประโยชน์เปลี่ยนทีละงบประมาณ คงตัวแทนเอกสารไว้แล้วปรับการตัดคุณลักษณะคำค้น จากนั้นทำซ้ำด้วยงบประมาณเอกสารแบบอื่น หากเปลี่ยนพร้อมกัน ผลที่ต่างไปจะช่วยได้น้อยว่าการเปลี่ยนใดเป็นสาเหตุ
ไม่มีค่าที่ “เล็กพอ” สำหรับทุกงาน FAQ สั้น คลังหลายภาษา และรีโพซิทอรีซอฟต์แวร์มีการกระจายของภาษา ความยาว และความซ้ำต่างกัน การตั้งค่าที่เหมาะกับคำถามกว้างอาจทำรายละเอียดหายาก ซึ่งใช้แยกขั้นตอนสองแบบที่แทบเหมือนกัน หลุดหายไป
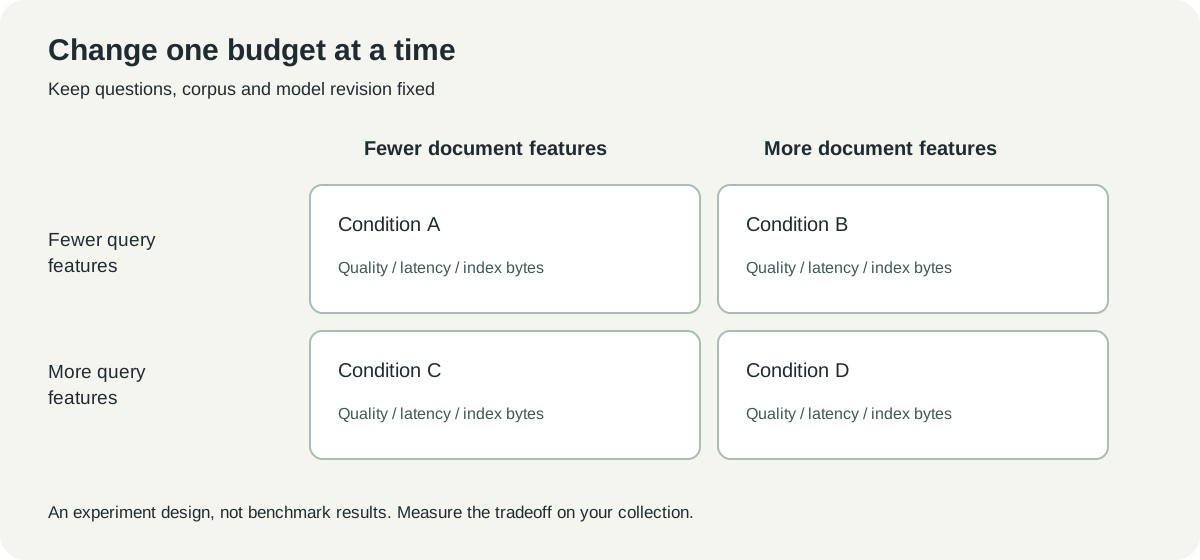 แผนการทดลองที่จัดทำขึ้นใหม่ ทั้งหมดเป็นเงื่อนไขเปรียบเทียบ ไม่ใช่ผลเบนช์มาร์กหรือค่าที่แนะนำสำหรับระบบจริง
แยกคุณภาพ เวลา และพื้นที่จัดเก็บไว้คนละคอลัมน์ หากค้นหาเร็วขึ้นแต่บทความที่เกี่ยวข้องหลุดจากหน้าแรก การประหยัดเวลานั้นก็มีต้นทุน หากดัชนีที่ใหญ่ขึ้นไม่ได้ช่วยคำถามที่ผู้คนถามจริง พื้นที่ที่เพิ่มขึ้นอาจไม่คุ้มค่า
คะแนนเบนช์มาร์กไม่ใช่เวลาตอบสนอง
โมเดลการ์ดรายงาน 56.68 nDCG@10 บน BEIR-15 สำหรับ SlideOn แบบไม่ตัดคุณลักษณะ นี่คือผลคุณภาพการจัดอันดับที่ผู้เผยแพร่รายงานจากชุดข้อมูลเบนช์มาร์ก ไม่ใช่ความน่าจะเป็นที่คำตอบใดคำตอบหนึ่งถูกต้อง และไม่ใช่จำนวนมิลลิวินาที การประเมินที่เผยแพร่
การอธิบายประสิทธิภาพของ LightOn แยกตัวแทนภาระคำนวณ retrieval FLOPS ออกจาก latency ที่วัดจริง และแยกจำนวนค่าที่ไม่เป็นศูนย์ของเอกสารออกจากขนาดดัชนีเป็นไบต์ ควรรักษาความแตกต่างนี้ในตารางเปรียบเทียบ ตัวแทนทางคณิตศาสตร์ช่วยอธิบายกลไก ส่วนการวัดระบบจริงบอกว่าระบบของคุณทำอะไรได้จริง
สำหรับการประเมินขนาดเล็ก นาฬิกาจับเวลาอย่างเดียวก็ยังไม่ครบ การโหลดโมเดลครั้งแรก การเข้ารหัสเอกสาร การสร้างดัชนี และการค้นซ้ำเป็นคนละช่วง ควรรายงานเวลาเริ่มต้นแบบเย็นแยกจากการค้นเมื่อระบบพร้อมแล้ว และระบุว่าเวลารวมการเข้ารหัสคำค้นหรือไม่
คะแนนคุณภาพก็ต้องระมัดระวังเช่นกัน ตัวค้นคืนอาจพบเอกสารถูกฉบับ แต่ดันส่วนข้อความผิดขึ้นด้านบนของไฟล์ยาว ควรบันทึกว่าหน่วยตัดสินคือไฟล์ หัวข้อ หรือข้อความช่วงหนึ่ง และใช้หน่วยเดียวกันกับทุกตัวเลือก
คลังข้อมูลสามแบบช่วยให้เห็นสิ่งที่ต้องแลก
คู่มือปฏิบัติงานเป็นตัวอย่างแรกที่ดี เพราะมักรู้ชัดว่าต้องการผลลัพธ์ใด เขียนคำถามเรื่องคืนสินค้า การส่งล่าช้า และการเข้าถึงบัญชี แล้วระบุหน้าที่เป็นแหล่งอ้างอิงหลักของแต่ละคำถาม รวมคำถามที่ใช้ถ้อยคำต่างจากหัวข้อหน้า เพื่อทดสอบมากกว่าการจับคู่ชื่อเรื่อง
คลังโครงการหลายภาษาเพิ่มความท้าทายอีกอย่าง เรื่องเดียวกันอาจปรากฏในบันทึกประชุม ประกาศที่แปลแล้ว และแผนเก่า ใช้เมทาดาทาแยกนโยบายปัจจุบันออกจากการหารือในอดีต ความคล้ายเชิงความหมายไม่ได้ตัดสินว่าองค์กรควรยึดเวอร์ชันใด
คลังเอกสารนักพัฒนาเพิ่มทั้งสตริงตรงตัวและเนื้อหาที่เกือบซ้ำ คำถามเรื่อง timeout อาจต้องใช้ทั้งคู่มือแนวคิดและคีย์ตั้งค่า เก็บการค้นหาคำตรงตัวไว้เป็นฐานเปรียบเทียบ แล้วดูว่าแนวทางผสมคุ้มกับความซับซ้อนสำหรับคำถามจริงหรือไม่
นี่คือสถานการณ์ประเมินที่เสนอให้ลอง ไม่ใช่กรณีศึกษาที่นำไปใช้จริง เป้าหมายคือทำเกณฑ์ยอมรับให้ชัด ในทุกกรณี สิ่งสำคัญคือรายการคำถาม แหล่งข้อมูลที่ยอมรับ และอันดับที่สังเกตได้ ซึ่งผู้อื่นตรวจสอบต่อได้
ทำการเปรียบเทียบแรกให้เล็กพอจะเสร็จ
อาจเริ่มด้วยคำถามตัวแทน 30 ข้อ แทนกองคำค้นที่ไม่สิ้นสุด แบ่งเป็นการค้นทั่วไป การถามด้วยถ้อยคำใหม่ กรณีกำกวม และคำถามที่คลังเอกสารตอบไม่ได้ นี่เป็นข้อเสนอเริ่มต้น ไม่ใช่เบนช์มาร์กที่เป็นตัวแทนเชิงสถิติ
ให้ผู้เชี่ยวชาญเนื้อหาตัดสินผลลัพธ์ที่คาดหวังก่อนปรับค่า ไม่เช่นนั้นทุกอันดับที่ผิดคาดจะชวนให้ตีความใหม่ว่าคำถาม “หมายถึงอะไรกันแน่” เก็บคำถามอีกชุดที่ยังไม่แตะไว้ตรวจท้ายสุด เพื่อไม่ให้ค่าที่ปรับจดจำเพียงตัวอย่างระหว่างพัฒนา
บันทึก revision ของโมเดล กฎเตรียมข้อมูล ขนาดส่วนข้อความ ค่าตัดคุณลักษณะ และรายละเอียดเครื่อง การเปลี่ยนอย่างใดอย่างหนึ่งอาจทำผลเปรียบเทียบเปลี่ยน การทดลองสั้นที่คนอื่นทำซ้ำได้มีประโยชน์กว่าคะแนนสูงที่ไม่เหลือข้อมูลนำเข้า
สุดท้าย ตรวจหน้าผลลัพธ์ในขนาดจอที่ผู้คนใช้จริง แม้ผลอันดับแรกจะถูกต้อง แต่ผู้ใช้ก็ยังติดขัดได้หากชื่อถูกตัดจนจำไม่ได้ หรือข้อความตัวอย่างซ่อนประโยคสำคัญ คุณภาพการค้นคืนกับคุณภาพอินเทอร์เฟซมาพบกันตอนที่คนเลือกว่าจะเปิดอะไร
การค้นหาที่ดีทำให้เส้นทางสู่แหล่งข้อมูลสั้นลง
เรามองว่าแนวคิดที่มีประโยชน์ของ SlideOn คือการแยกงบประมาณคุณภาพและทรัพยากรออกเป็นตัวควบคุมที่ทดสอบได้ นี่เป็นจุดเริ่มต้นที่ใช้ได้จริงกว่าการคิดว่าทุกปัญหาค้นหาต้องใช้โมเดลสร้างคำตอบที่ใหญ่ขึ้น มันชวนให้ทดลองอย่างพอเหมาะ: คงคำถามไว้ ปรับตัวแทนข้อมูล แล้วตรวจว่าผู้คนค้นพบอะไรได้จริง
เริ่มจากเอกสารที่ทีมของคุณหาไม่เจอซ้ำ ๆ หากตัวค้นคืนใหม่ดึงมันขึ้นมาได้สม่ำเสมอแม้ใช้ถ้อยคำต่างกัน คุณก็มีการปรับปรุงที่จับต้องได้ให้พัฒนาต่อ จุดหมายยังเป็นแหล่งข้อมูลที่อ่านได้ หน้าที่ของโมเดลคือย่นเส้นทางไปถึงจุดนั้น
แหล่งข้อมูลและสื่อ
ตรวจสอบเมื่อวันที่ 20 ตุลาคม 2026 ตัวอย่างตั้งค่าดัดแปลงจากโมเดลการ์ดสาธารณะ ไม่ได้อ้างว่าติดตั้ง อนุมานบนเครื่อง หรือทำเบนช์มาร์กอิสระแล้ว ภาพหน้าจอ: หน้าโมเดลสาธารณะของ LightOn บน Hugging Face ซึ่งผู้เขียนเป็นผู้ถ่าย แผนภาพทั้งสองจัดทำขึ้นใหม่ ที่มาของสื่อและประกาศสิทธิ์อยู่ใน บันทึกสื่อ
- ประกาศเปิดตัว LightOn วันที่ 19 ตุลาคม 2026
- โมเดลการ์ดและวิธีใช้ SlideOn
- โมเดลการ์ดและรายละเอียดภาษา mSlideOn
- รีโพซิทอรีฝึกและประเมินโมเดล
เก็บคำถามไว้ข้างหลักฐาน
บันทึกชุดคำค้น ลิงก์ต้นทาง และบันทึกตรวจสอบไว้ด้วยกัน เพื่อให้การเปรียบเทียบภายหลังตอบคำถามชุดเดิม Telli.sh ช่วยจัดระเบียบบันทึกการค้นคว้านี้ได้ สร้างบัญชี Telli.sh