[Buku Catatan Ide AI 01] SlideOn: model pencarian lebih kecil dengan dua kendali biaya yang berguna
Kenali SlideOn dan mSlideOn dari LightOn: model retrieval sparse untuk menemukan dokumen berbahasa Inggris dan multibahasa, dengan eksperimen awal serta cara jelas membandingkan kualitas, kecepatan, dan penyimpanan.
Buku Catatan Ide AI menelusuri gagasan dan kemungkinan penggunaan praktis di balik model serta alat AI yang baru mulai bermunculan.
Anda ingat ada dokumen yang menjelaskan cara membatalkan pesanan. Kotak pencarian hanya mengenali kata pembatalan. Sayangnya, dokumen menyebut proses yang sama sebagai penarikan pesanan. Sebuah koleksi dapat memuat jawaban yang tepat, tetapi tetap sulit digunakan.
LightOn memperkenalkan SlideOn dan mSlideOn pada 19 Oktober 2026, sebagai dua model untuk mengambil dokumen yang relevan. SlideOn berfokus pada bahasa Inggris; mSlideOn memperluas pendekatan ini ke teks multibahasa, dokumen panjang, dan kode. Daya tarik khususnya adalah dua anggaran yang dapat disesuaikan: jumlah fitur yang digunakan kueri dan jumlah fitur yang disimpan setiap dokumen. Pengumuman LightOn
Pengantar ini menjelaskan posisi kedua model, perubahan yang dihasilkan kendali tersebut, serta cara mencoba perbandingan kecil sebelum membangun layanan pencarian. Anda tidak memerlukan aplikasi percakapan baru untuk memahami idenya. Mulailah dengan pertanyaan, beberapa dokumen, dan definisi hasil yang berguna.
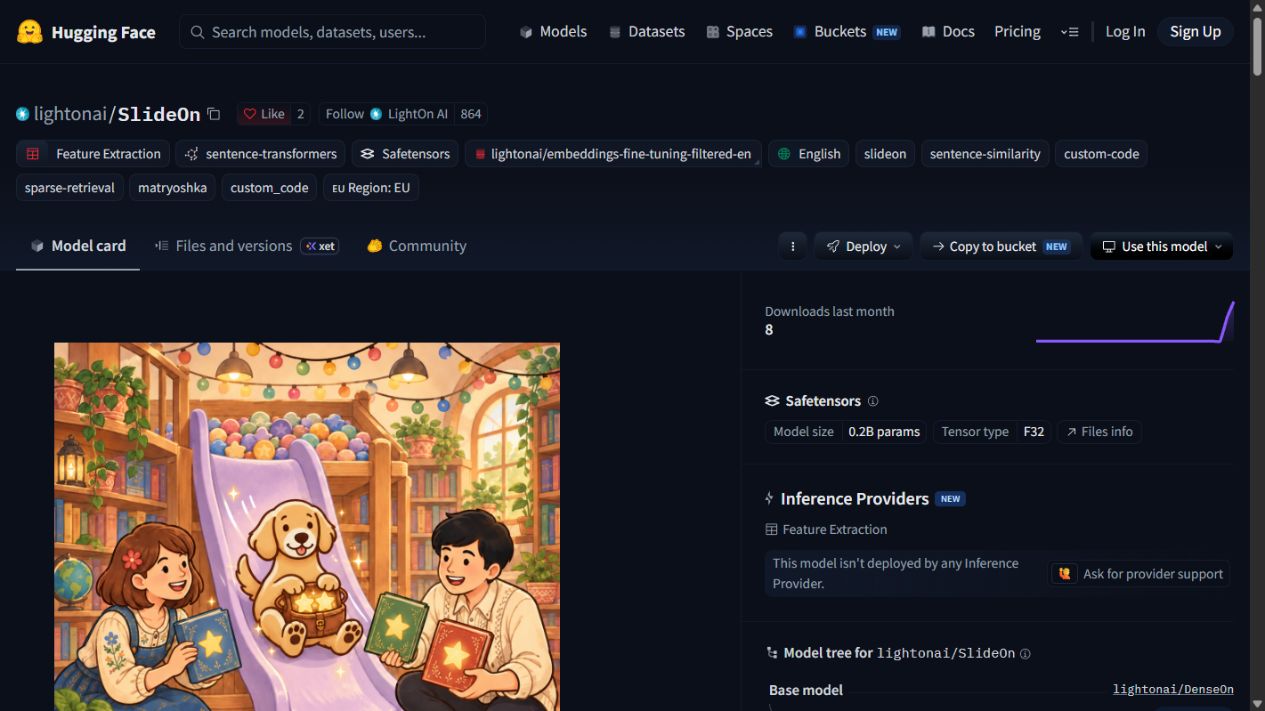 Layar kartu model publik yang diambil pada 20 Oktober 2026. Sumber: LightOn di Hugging Face. Ini halaman model yang dipublikasikan, bukan hasil inferensi lokal; antarmukanya juga menunjukkan bahwa model yang dapat diunduh belum tentu memiliki penyedia inferensi terkelola.
Pencarian membutuhkan daftar pendek yang baik sebelum jawaban
Retriever mengurutkan dokumen berdasarkan kueri. Ia tidak harus menulis jawaban, merangkum berkas, atau memutuskan apakah perusahaan perlu mengubah kebijakan. Tugas langsungnya lebih sempit: menempatkan bahan sumber paling relevan di dekat urutan teratas.
Bayangkan buku panduan internal dengan tiga halaman tentang pengembalian barang, pengiriman, dan cuti staf. Pertanyaan mengenai pengembalian pesanan yang rusak seharusnya mengangkat halaman pengembalian. Jika hasil pertama justru membahas kalender cuti, pembangkit jawaban yang fasih di tahap berikutnya sudah memulai dengan bukti yang salah.
Perbedaan ini membuat retrieval berguna bahkan tanpa AI generatif. Spesialis dukungan dapat langsung membuka dokumen yang diurutkan. Peneliti dapat mengumpulkan kutipan untuk dibandingkan. Alat pemrograman dapat memakai retrieval untuk menemukan implementasi yang mungkin relevan sebelum diperiksa manusia.
Ada pula pemisahan tanggung jawab yang berguna. Retrieval membantu menemukan bukti; dokumen asli tetap menjadi tempat untuk memeriksa redaksi, tanggal, dan pengecualian. Hasil yang baik seharusnya memudahkan akses ke sumber tersebut, bukan menggantinya dengan skor keyakinan.
Pencarian sparse menyimpan buku alamat yang selektif
Bayangkan indeks pencarian sebagai buku alamat. Indeks kata kunci konvensional mencatat dokumen mana yang mengandung suatu istilah. Model sparse terlatih membuat buku alamat jenis lain: memberi bobot pada sekumpulan fitur terpelajari yang relatif kecil, lalu menggunakan fitur aktif bersama untuk menilai kecocokan kueri dengan dokumen.
Kata sparse menggambarkan selektivitas itu. Sebuah representasi dapat memiliki banyak posisi yang mungkin, tetapi hanya memakai sebagian kecil untuk teks tertentu. Indeks terbalik dapat mengaitkan setiap fitur aktif dengan dokumen yang memakainya, sehingga mesin pencarian berfokus pada daftar posting yang relevan.
Kartu model SlideOn menyebut 32,768 fitur terpelajari yang mungkin, dengan kendali pemangkasan kueri dan dokumen yang terpisah. Posisi fitur itu merupakan variabel laten terpelajari, bukan kamus kata bahasa Inggris yang transparan. Jangan menganggap fitur 100 pasti merupakan sinonim untuk “pengembalian”. Kartu model SlideOn
Detail terakhir itu penting saat menjelaskan hasil. Representasi sparse dapat menghemat pencarian tanpa membuat setiap keputusan internal mudah dibaca manusia. Penjelasan praktis bagi pengguna tetap sebaiknya berupa bagian relevan dari dokumen sumber, dengan konteks yang cukup untuk memeriksa alasan kecocokannya.
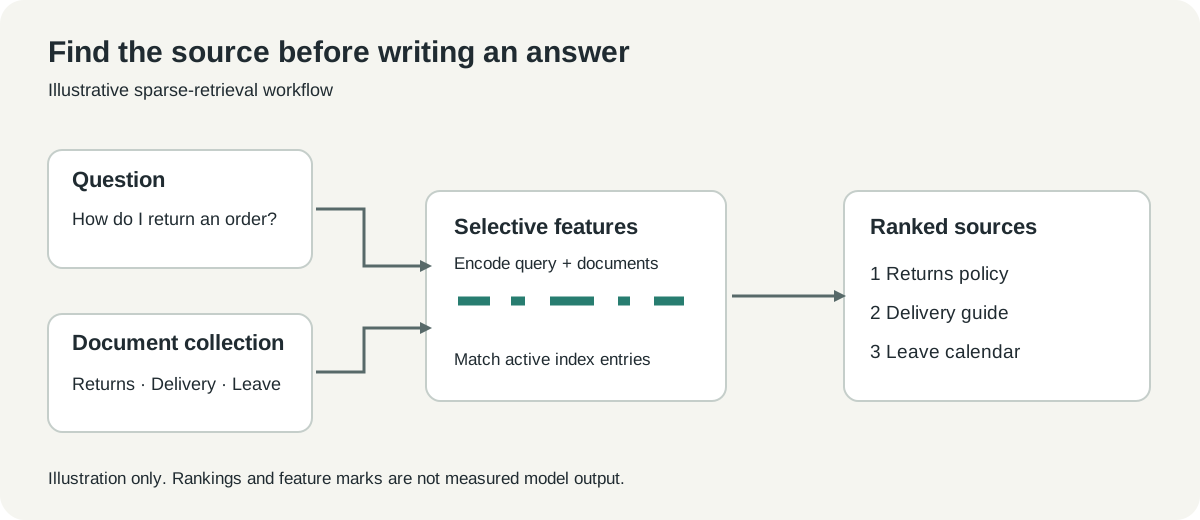 Diagram penjelasan orisinal. Tanda fitur contoh menggambarkan proses, bukan aktivasi yang diukur dari SlideOn.
Pilih model untuk koleksi yang benar-benar Anda miliki
Kedua nama menggambarkan titik awal yang berkaitan, bukan pengaturan bahasa yang dapat saling dipertukarkan. Dalam rilisnya, LightOn mencantumkan 174 juta parameter untuk SlideOn dan 339 juta parameter untuk mSlideOn. Angka yang lebih besar saja tidak menentukan mana yang lebih cocok untuk koleksi Anda. Rilis 19 Oktober
| Koleksi Anda | Kandidat awal yang masuk akal | Pertanyaan yang perlu dijawab dalam uji coba |
|---|---|---|
| Artikel bantuan bahasa Inggris | SlideOn | Apakah artikel yang benar ditemukan saat kueri memakai redaksi berbeda? |
| Dokumen dalam beberapa bahasa | mSlideOn | Apakah setiap bahasa penting bekerja dengan baik dan kueri lintas bahasa berperilaku sesuai kebutuhan? |
| Dokumen teknis panjang | mSlideOn, dengan rencana pemenggalan teks yang disengaja | Apakah bagian relevan bertahan setelah prapemrosesan dan pengurutan? |
| Kode sumber bercampur uraian | mSlideOn sebagai kandidat | Apakah berkas yang dikembalikan berguna bagi orang yang memahami repositori? |
Label multibahasa adalah alasan untuk menyelidiki, bukan jalan pintas melewati evaluasi. Katalog dwibahasa dapat memuat salinan terjemahan, kebijakan regional yang berbeda, dan istilah tanpa satu padanan harfiah. Itu adalah masalah retrieval yang berbeda, meskipun dokumennya memiliki tag bahasa yang sama.
Misalnya, bayangkan mencari kebijakan pengembalian dana bahasa Prancis dengan pertanyaan bahasa Inggris. Itu tugas lintas bahasa. Mencari dokumen bahasa Prancis dengan kueri bahasa Prancis adalah tugas dalam bahasa yang sama. Catat secara terpisah: skor agregat dapat menyembunyikan pengalaman lemah bagi kelompok pembaca tertentu.
Prinsip yang sama berlaku untuk kode. Menemukan berkas sumber tentang “pemulihan sesi” berbeda dari mencocokkan nama fungsi secara persis. Sertakan kueri pengenal persis dan pertanyaan deskriptif dalam perbandingan, karena sistem pencarian yang berguna sering membutuhkan keduanya.
Eksperimen pertama dapat dilakukan dalam notebook
Mulailah dengan teks publik atau sintetis dan lingkungan Python bersih. Contoh yang dipublikasikan memakai SparseEncoder dari Sentence Transformers; ini antarmuka pemuatan model, bukan server pencarian lengkap. Contoh berikut diadaptasi dari resep resmi, diperiksa pada 20 Oktober 2026. Penggunaan dalam dokumentasi
- Buka kartu model dan tinjau kode inferensi khusus beserta dependensi repositorinya. Pemuat berikut memakai
trust_remote_code=True, yang mengizinkan implementasi Python repositori tersebut dieksekusi; gunakan revisi yang sudah diperiksa agar eksperimen dapat diulang. - Buat lingkungan terisolasi dan pasang rentang pustaka yang didokumentasikan.
- Enkode satu kueri dan beberapa dokumen pendek. Gunakan metode kueri dan dokumen milik model, alih-alih menambahkan awalan secara manual.
- Periksa skor berdampingan dengan teks dokumen sebenarnya. Pemeriksaan awal ini mengenai pengurutan, bukan ambang skor universal.
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
Dokumen di atas merupakan contoh pengajaran rekaan. Tidak ada klaim keluaran atau akurasi terukur yang disertakan pada kode ini. Periksa apakah dokumen pengembalian berada di urutan pertama, lalu coba parafrasa dan alternatif yang sengaja dibuat sulit.
Jangan berhenti setelah kueri termudah berhasil. Tanyakan pembatalan sebelum pengiriman, paket rusak setelah diterima, dan pengembalian dana setelah tenggat. Jika koleksi tidak menjawab pertanyaan, pengujian harus mengungkap ketiadaan itu, bukan memberi nilai pada hasil menarik tetapi tidak relevan.
Dua anggaran menjawab dua pertanyaan biaya yang berbeda
Pemangkasan kueri membatasi fitur yang dipakai saat mengajukan pertanyaan. Pemangkasan dokumen membatasi fitur yang disimpan untuk setiap item dalam indeks. Dalam layanan besar, anggaran pertama menyangkut pekerjaan yang diulang setiap pencarian; anggaran kedua juga memengaruhi indeks yang tetap tersimpan di antara pencarian.
Uji coba yang berguna mengubah satu anggaran pada satu waktu. Pertahankan representasi dokumen saat menyesuaikan pemangkasan kueri, lalu ulangi dengan anggaran dokumen alternatif. Jika keduanya berubah sekaligus, hasil yang berbeda tidak banyak membantu menentukan perubahan penyebabnya.
Tidak ada pengaturan “cukup kecil” yang universal. FAQ pendek, arsip multibahasa, dan repositori perangkat lunak memiliki distribusi bahasa, panjang, dan pengulangan berbeda. Konfigurasi yang cocok untuk pertanyaan luas dapat kehilangan detail langka yang membedakan dua prosedur hampir identik.
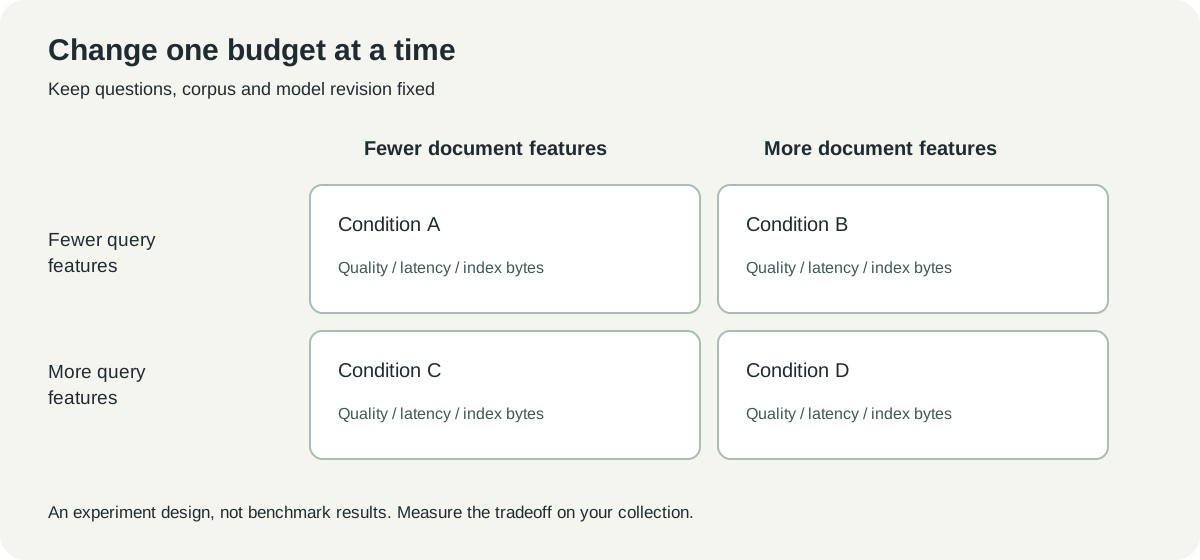 Rencana eksperimen orisinal. Ini kondisi perbandingan, bukan hasil benchmark atau pengaturan produksi yang disarankan.
Simpan kualitas, waktu, dan penyimpanan dalam kolom terpisah. Jika pencarian lebih cepat tetapi artikel relevan hilang dari halaman pertama, peningkatan waktunya tidak gratis. Jika indeks lebih besar tidak memberi manfaat berarti pada pertanyaan yang benar-benar diajukan, penyimpanan tambahannya mungkin tidak layak.
Angka benchmark bukan pengukuran waktu respons
Kartu model melaporkan 56.68 nDCG@10 pada BEIR-15 untuk pengaturan SlideOn tanpa pemangkasan. Itu hasil kualitas pengurutan yang diatribusikan pada dataset benchmark, bukan probabilitas bahwa jawaban tertentu benar. Angka tersebut juga bukan jumlah milidetik. Evaluasi yang dipublikasikan
Pembahasan efisiensi LightOn membedakan proksi retrieval FLOPS dari latensi terukur, serta jumlah nilai tidak nol dokumen dari ukuran indeks dalam byte. Pertahankan perbedaan itu dalam tabel perbandingan. Proksi matematis membantu menjelaskan mekanisme; pengukuran operasional memberi tahu apa yang benar-benar dilakukan sistem Anda.
Untuk evaluasi kecil, stopwatch saja juga belum lengkap. Pemuatan model awal, pengodean dokumen, pembangunan indeks, dan kueri berulang adalah tahap berbeda. Laporkan startup dingin terpisah dari pencarian hangat, dan jelaskan apakah waktu mencakup pengodean kueri.
Kehati-hatian yang sama berlaku pada skor kualitas. Retriever dapat menemukan dokumen yang tepat tetapi menempatkan bagian yang salah di dekat atas berkas panjang. Catat apakah unit penilaiannya berkas, bagian, atau paragraf, dan gunakan unit yang sama untuk setiap kandidat.
Tiga koleksi praktis memperjelas kompromi
Buku panduan operasional cocok sebagai contoh awal karena hasil yang diinginkan sering jelas. Tulis pertanyaan tentang pengembalian, keterlambatan pengiriman, dan akses akun, lalu tentukan halaman otoritatif untuk masing-masing. Sertakan pertanyaan dengan redaksi berbeda dari judul halaman agar yang diuji lebih dari sekadar kecocokan judul.
Arsip proyek multibahasa menambahkan tantangan lain: topik yang sama dapat muncul dalam catatan rapat, pengumuman terjemahan, dan rencana lama. Gunakan metadata untuk membedakan kebijakan terkini dari diskusi historis. Kemiripan semantik tidak menentukan versi mana yang seharusnya diikuti organisasi.
Koleksi dokumentasi pengembang menambahkan string persis dan duplikat dekat. Pertanyaan tentang timeout mungkin memerlukan panduan konseptual sekaligus kunci konfigurasi. Pertahankan pencarian leksikal sebagai baseline, lalu periksa apakah pendekatan hibrida sepadan dengan kompleksitasnya untuk pertanyaan Anda.
Ini skenario evaluasi yang disarankan, bukan studi kasus penerapan. Tujuannya membuat kriteria penerimaan konkret. Dalam setiap kasus, artefak pentingnya adalah daftar pertanyaan, sumber yang diterima, dan urutan hasil yang diamati sehingga orang lain dapat meninjaunya.
Buat perbandingan pertama cukup kecil agar selesai
Gunakan mungkin 30 pertanyaan representatif, bukan tumpukan kueri tanpa batas. Bagi menjadi pencarian biasa, parafrasa, kasus ambigu, dan pertanyaan yang tidak dapat dijawab koleksi. Ini rancangan awal usulan, bukan benchmark yang representatif secara statistik.
Mintalah ahli materi menilai hasil yang diharapkan sebelum penalaan. Jika tidak, setiap urutan mengejutkan mengundang penjelasan baru tentang apa yang “sebenarnya dimaksud” pertanyaan. Sisihkan pertanyaan yang belum disentuh untuk pemeriksaan akhir agar pengaturan tidak sekadar menghafal contoh selama pengembangan.
Catat revisi model, aturan prapemrosesan, ukuran potongan, pengaturan pemangkasan, dan spesifikasi mesin. Perubahan salah satunya dapat mengubah perbandingan. Pengujian singkat yang dapat diulang orang lain lebih berguna daripada skor besar yang masukan aslinya telah hilang.
Terakhir, periksa layar hasil pada ukuran yang akan digunakan orang. Hasil teratas yang benar tetap gagal membantu jika judul terpotong hingga sulit dikenali atau cuplikan menyembunyikan kalimat penentu. Kualitas retrieval dan antarmuka bertemu saat seseorang memilih apa yang akan dibuka.
Pencarian lebih baik mempersingkat jalan menuju sumber
Menurut kami, ide berguna SlideOn adalah pemisahan anggaran kualitas dan sumber daya menjadi kendali yang dapat diuji. Itu titik awal lebih praktis daripada menganggap setiap masalah pencarian memerlukan model jawaban lebih besar. Pendekatan ini mengundang eksperimen sederhana: pertahankan pertanyaan, variasikan representasi, dan periksa apa yang benar-benar dapat ditemukan orang.
Mulailah dengan dokumen yang berulang kali gagal ditemukan tim Anda. Jika retriever baru konsisten mengangkatnya meski redaksinya berbeda, ada peningkatan konkret yang dapat dikembangkan. Tujuannya tetap sumber yang dapat dibaca; tugas model adalah mempersingkat jalurnya.
Sumber dan media
Diperiksa pada 20 Oktober 2026. Contoh penyiapan mengadaptasi kartu model publik; tidak ada klaim instalasi, inferensi lokal, atau benchmark independen. Tangkapan layar: halaman model publik LightOn di Hugging Face, diambil penulis. Kedua diagram merupakan karya orisinal. Sumber aset dan pemberitahuan lisensi menyertai catatan media.
- Rilis LightOn, 19 Oktober 2026
- Kartu model dan penggunaan SlideOn
- Kartu model mSlideOn dan rincian bahasa
- Repositori pelatihan dan evaluasi
Simpan pertanyaan berdampingan dengan bukti
Simpan kumpulan kueri, tautan sumber, dan catatan peninjauan bersama agar perbandingan berikutnya menjawab pertanyaan yang sama. Telli.sh dapat membantu menata catatan riset tersebut. Buat akun Telli.sh