ตัวละคร Runway สตรีมได้ 24 เฟรมต่อวินาที แต่รอคำตอบนานแค่ไหน
งานวิจัยจาก Runway แยกเวลาที่ใช้สร้างวิดีโอสดออกจากเวลาที่ผู้ใช้รอระหว่างสนทนา
เมื่อลูกค้าถามจบ ตัวละครดิจิทัลมีเวลาเพียงสั้น ๆ ให้ตอบรับ วิดีโออาจเล่นได้ลื่นเมื่อเริ่มแล้ว แต่ความเงียบก่อนคำตอบแรกยังทำให้รู้สึกเหมือนสายหลุดได้ บทความวิจัยใหม่ของ Runway ให้รายละเอียดมากพอที่จะตามดูว่าช่วงรอนี้มาจากไหน
Runway เปิดตัว Characters เมื่อวันที่ 9 มีนาคม 2026 ต้นฉบับก่อนตีพิมพ์วันที่ 3 พฤศจิกายนอธิบายระบบเบื้องหลังอวตารสนทนาที่สร้างวิดีโอไปพร้อมกับการพูด จึงเป็นคำอธิบายเชิงเทคนิคของผลิตภัณฑ์ที่มีอยู่แล้ว ผู้เขียนจาก Runway รายงานผลจากระบบของตน รวมถึงการรันวิดีโอบน NVIDIA H100 สี่ตัว ตัวเลขเหล่านี้ช่วยตั้งคำถามสำหรับการทดลองได้ชัดขึ้น ส่วนอุปกรณ์ การเชื่อมต่อ หรือแอปอื่นต้องวัดในสภาพแวดล้อมจริงของตน
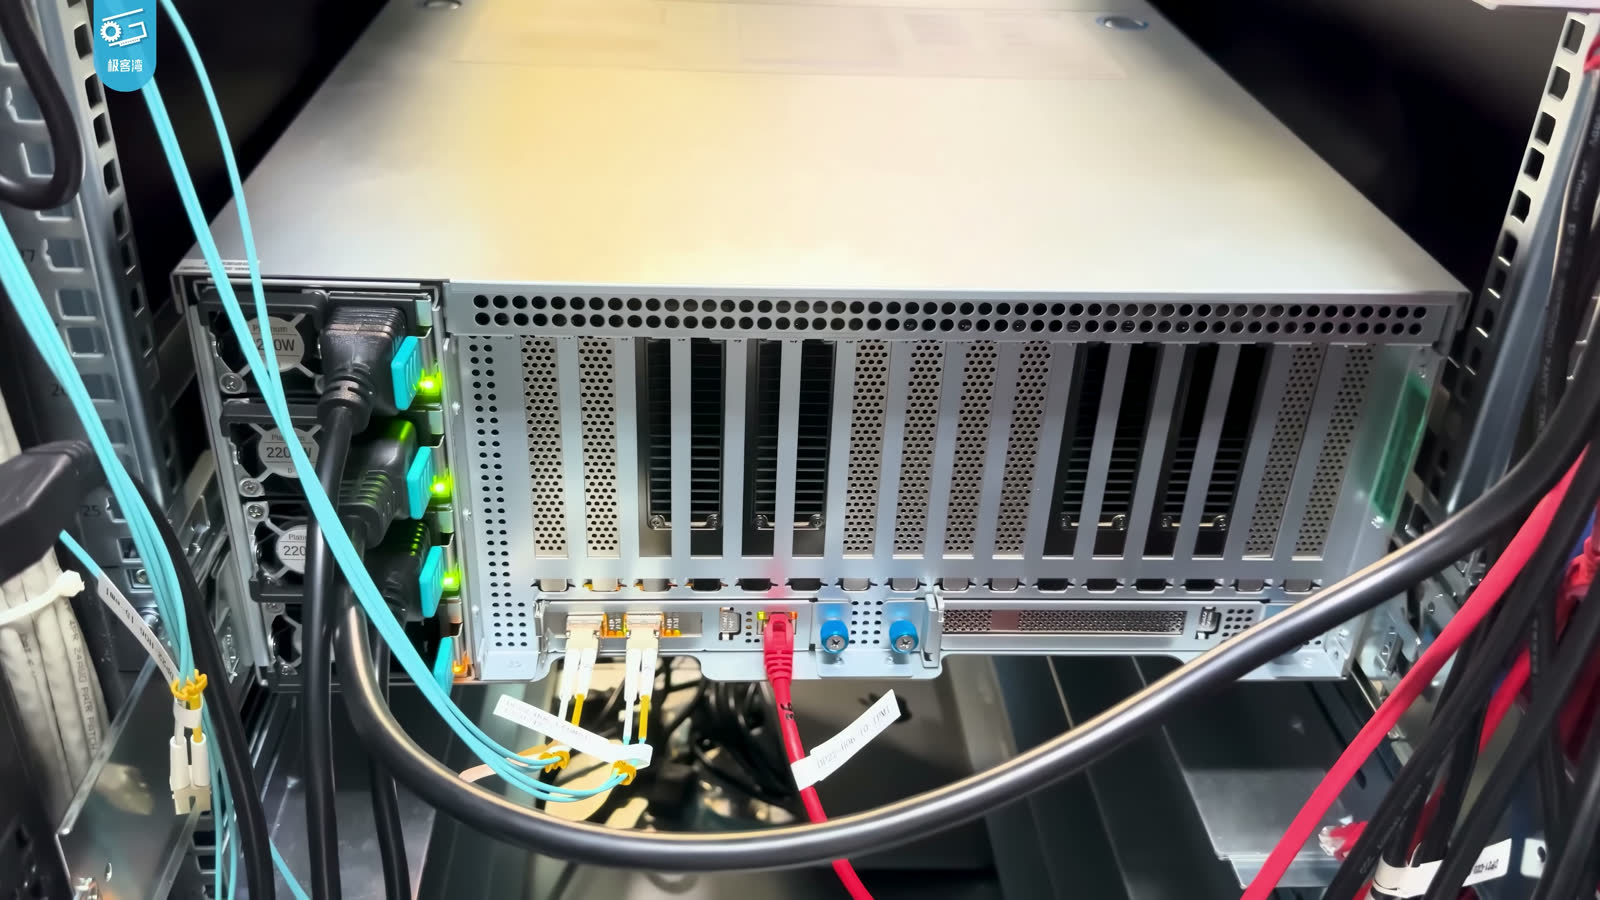
เซิร์ฟเวอร์ที่ใช้ทดสอบ H100 ซึ่งเป็น GPU รุ่นที่ใช้ในงานวิจัยของ Runway ภาพประกอบโดย 极客湾Geekerwan ปรับขนาด ภายใต้ CC BY 3.0 ที่มาของภาพ · สัญญาอนุญาต

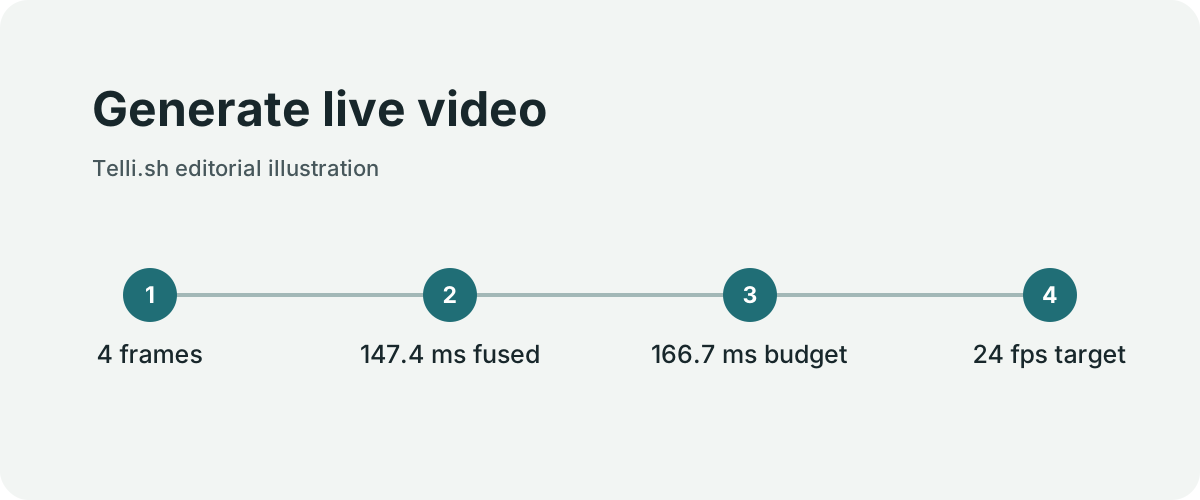
เฟรมแต่ละชุดมีเวลาประมาณ 167 มิลลิวินาที
การสร้างวิดีโอสด ภาพประกอบจัดทำโดย Telli.sh
ที่ 24 เฟรมต่อวินาที ต้องเตรียมเฟรมชุดละสี่เฟรมให้พร้อมประมาณทุก 167 มิลลิวินาที หากชุดเฟรมมาช้ากว่าที่เครื่องเล่นใช้ ระบบต้องบัฟเฟอร์เพิ่ม ปรับคุณภาพ หรือเปลี่ยนวิธีทำงานเพื่อให้ภาพเคลื่อนไหวต่อเนื่อง เฟรมหนึ่งชุดอาจใช้เวลาเกือบครบ 167 มิลลิวินาทีแม้วิดีโอที่เห็นจะลื่น
ผู้เขียนอธิบายระบบขนาดประมาณ 57 พันล้านพารามิเตอร์ที่สร้างเฟรมขนาด 704 × 1,088 พิกเซล เวลามัธยฐานต่อขั้นดิฟฟิวชันคือ 240.9 มิลลิวินาทีในการตั้งค่าอ้างอิง 159.3 มิลลิวินาทีหลังปรับประสิทธิภาพแบบหนึ่ง และ 147.4 มิลลิวินาทีหลังรวมขั้นตอนเพิ่ม สถานะแฝงหนึ่งชุดที่ขจัดสัญญาณรบกวนแล้วตรงกับสี่เฟรม และตัวถอดรหัสทำงานซ้อนกันเป็นอีกช่วง ตัวเลขต่อขั้นนี้มีขอบเขตการวัดต่างจากเวลาตอบสนองที่ผู้ใช้สัมผัส
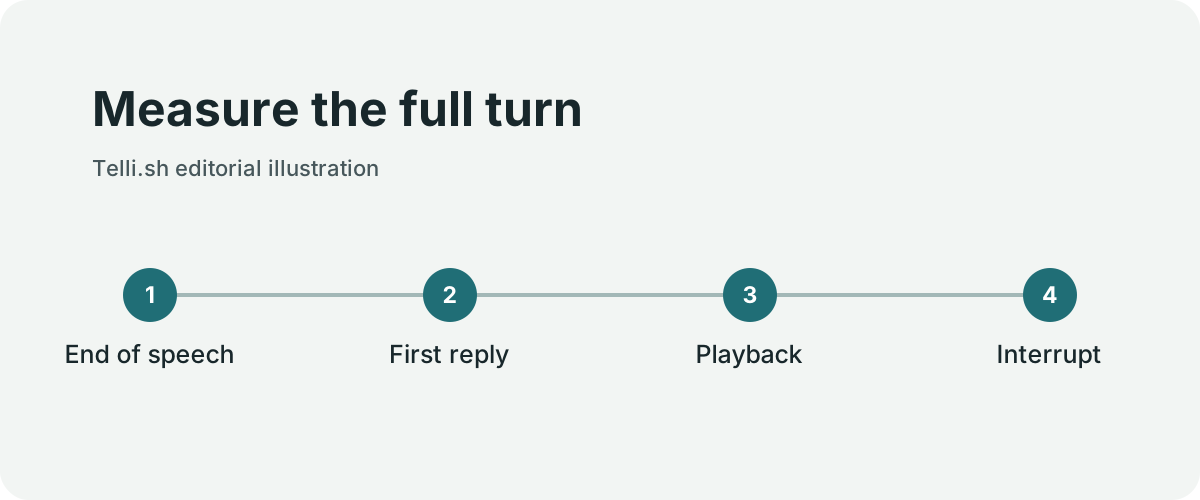
อีกประเด็นคือวิดีโออาจสร้างต่อเนื่องทันเมื่อเริ่มชุดแรกแล้ว งานวิจัยรายงานเวลาไปป์ไลน์วิดีโอ 0.49 วินาที และเวลามัธยฐานประมาณ 2.1 วินาทีต่อรอบสนทนาเต็มภายใต้เงื่อนไขที่วัด การประมวลผลคำพูด การสร้างคำตอบ การสังเคราะห์เสียง การส่งข้อมูล และการเริ่มเล่นที่ผู้ใช้รับรู้ได้ล้วนมีผล แต่ละช่วงอาจทำงานซ้อนกัน การเอาเวลาวิดีโอไปลบออกจากเวลารวมจึงระบุเวลาของขั้นตอนใดขั้นตอนหนึ่งไม่ได้
| ตัวชี้วัด | ตอบคำถามอะไร | ควรวัดอะไรในโครงการนำร่อง |
|---|---|---|
| เฟรมต่อวินาที | ภาพเคลื่อนไหวต่อเนื่องได้หรือไม่ | เฟรมที่ไปถึงเครื่องและช่วงภาพขาดระหว่างคำตอบยาว |
| เวลาจนเริ่มเล่นคำตอบแรก | หลังถามจบต้องรอเงียบนานเท่าไร | ค่ามัธยฐานและกรณีที่ช้าบนอุปกรณ์ฝั่งผู้ใช้ |
| การตอบสนองเมื่อถูกขัดจังหวะ | ผู้ใช้พูดต่อได้โดยไม่ต้องรอหรือไม่ | เวลาตั้งแต่เริ่มขัดจังหวะจนเสียงหยุด |
| ความตรงกันของเสียงกับภาพ | คำพูดกับการเคลื่อนไหวสอดคล้องกันหรือไม่ | ความคลาดหลังถูกขัดจังหวะ ภาพค้าง และกลับมาเล่น |
งานแบบไหนที่ตัวละครเคลื่อนไหวช่วยได้จริง
ตัวอย่างหนึ่งคือจุดสาธิตผลิตภัณฑ์ในพิพิธภัณฑ์หรือโชว์รูม ผู้เข้าชมถามว่าปุ่มควบคุมใช้ทำอะไร แอปเลือกคำตอบสั้นจากเนื้อหาที่อนุมัติ แล้วให้ตัวละครตอบขณะที่แผนภาพยังแสดงอยู่ ใบหน้าที่มองเห็นชัด ทิศทางสายตา หรือสัญญาณว่าเมื่อใดถึงคิวพูดอาจช่วยผู้ที่เดินเข้ามาลองได้ หากการเชื่อมต่อไม่เสถียร ระบบอาจเปลี่ยนไปใช้คำอธิบายเป็นข้อความ
อีกกรณีคือการฝึกพนักงานด้วยบทบาทสมมติ ผู้ฝึกซ้อมรับมือลูกค้าที่ไม่พอใจ แล้วรับข้อเสนอแนะจากแอปฝึกอบรม การจับเวลาซับซ้อนกว่าคำทักทายตามบท ตัวละครต้องรู้จักหยุดเมื่อได้ยินประโยคที่ยังพูดไม่จบ รับมือเมื่อถูกขัด และกลับเข้าสู่บทสนทนาหลังเข้าใจคำพูดผิด การทดลองที่ดีบันทึกด้วยว่าผู้เข้าร่วมต้องพูดซ้ำหรือพูดทับตัวละครหรือไม่ ควบคู่กับการวัดความหน่วงทั่วไป
ความยินยอมและการใช้ภาพแทนบุคคลมีผลเมื่ออวตารใช้รูปลักษณ์หรือเสียงคนจริง องค์กรกำหนดได้ว่าใครสร้างตัวละครได้ นำรูปลักษณ์ไปแสดงที่ใด และขอให้นำออกอย่างไร ในการทดลอง การใช้ตัวละครสังเคราะห์ที่เห็นได้ชัดหรือผู้แสดงที่มีหลักฐานการอนุญาตช่วยแยกผลด้านอินเทอร์เฟซออกจากคำถามเรื่องสิทธิ์ในภายหลัง
ตัวเลขจากการใช้งานจริงยังเหลือคำถามอะไร
การวัดรอบสนทนาทั้งหมด ภาพประกอบจัดทำโดย Telli.sh
ผู้เขียนรายงานว่า 99.5% ของเซสชันที่ยาวอย่างน้อยหนึ่งวินาทีมีอัตราเฉลี่ยมากกว่า 23.5 เฟรมต่อวินาที ฐานนับและช่วงเวลาที่ใช้เฉลี่ยมีผลต่อการตีความ เซสชันอาจผ่านเกณฑ์เฉลี่ยแต่ยังมีภาพค้างให้เห็นได้ หรือคำตอบอาจมาเร็วแต่เล่นต่อได้ไม่ลื่น งานวิจัยยังไม่ได้บอกการกระจายของเวลาตอบครั้งแรกสำหรับจำนวนผู้ใช้พร้อมกันที่ผู้ซื้อแต่ละรายคาดไว้
การทดลองขนาดเล็กควรรวมเครือข่ายสำนักงานทั่วไป เครือข่ายมือถือที่มีข้อจำกัด และอุปกรณ์แบบที่ผู้เข้าชมใช้จริง เริ่มจากเกณฑ์อ้างอิงที่มีเสียงและบทถอด แล้วทดสอบคำถามเดิมกับตัวละคร เปรียบเทียบอัตราทำงานสำเร็จ เลิกกลางทาง และขัดจังหวะ ใช้คำตอบตามบทและนโยบายบทสนทนาเดิมเพื่อแยกผลของอินเทอร์เฟซ บันทึกกรณีตอบช้าควบคู่กับตัวอย่างที่สำเร็จ
การตั้งค่าฮาร์ดแวร์จากงานวิจัยยังบอกต้นทุนการสนทนาของผู้ซื้อไม่ได้ หน่วยต้นทุนที่ใช้ได้จริงอาจเป็นการฝึกหนึ่งรอบที่จบ หรือคำถามของผู้เข้าชมหนึ่งข้อที่ตอบถูก จำนวนเวลาวิดีโอที่สร้างมีความหมายเมื่อทีมรู้ว่าส่วนใดมีประโยชน์ เดโมวิดีโอแสดงรูปลักษณ์และการเคลื่อนไหว ส่วนบทสนทนาที่ติดเครื่องมือวัดบอกได้ว่าแอปพร้อมสำหรับกลุ่มผู้ใช้จริงหรือยัง
ดูหนึ่งบทสนทนาแบบเฟรมต่อเฟรม
บทความรายงานการกระจายความหน่วงสองชุดโดยละเอียด ในการสนทนา 43 รอบที่ทำเครื่องหมายไว้ เวลาตั้งแต่ผู้ใช้พูดจบจนได้ยินเสียงอวตารฝั่งไคลเอนต์มีมัธยฐาน 2.13 วินาที เปอร์เซ็นไทล์ที่ 10 และ 90 อยู่ที่ 1.45 และ 3.00 วินาที ส่วนเวลาจากเสียงแรกของเอเจนต์ถึงเฟรมแรกที่เห็นว่ากำลังพูดตามที่ LiveKit จับได้ มีมัธยฐาน 493 มิลลิวินาที เปอร์เซ็นไทล์ที่ 10 และ 90 อยู่ที่ 421 และ 562 มิลลิวินาที ตัวเลขชุดแรกคือความเงียบก่อนเริ่มได้ยินคำตอบในเงื่อนไขทดสอบ ชุดที่สองวัดการเริ่มของภาพขณะพูด ผู้เข้าชมรับรู้ทั้งสองช่วงได้
การวัดอัตราเฟรมมาจากข้อมูลอีกชุดหนึ่ง ผู้เขียนระบุว่าเก็บข้อมูลจากเวิร์กเกอร์เป็นเวลาเจ็ดสัปดาห์และระบุว่าเซสชันใดถูกนับ การนำร่องในสถานที่ที่คนพลุกพล่านอาจเสริมผลดังกล่าวด้วยการจับช่วงภาพขาดทันทีหลังขัดจังหวะ หรือเมื่อผู้เข้าชมจำนวนมากเริ่มพร้อมกัน ให้บันทึกเสียงและภาพจากไคลเอนต์จริงเพื่อรวมผลของเครือข่ายและการเล่นไว้ด้วย
เพื่อวัดอย่างเที่ยงธรรม ให้ทำเครื่องหมายเวลาที่คนพูดจบ เวลาที่เอเจนต์เริ่มตอบ และเฟรมแรกที่เห็นตัวละครพูด ใช้คำถามซ้ำที่ทราบคำตอบที่คาดไว้ ผู้ทดสอบจะแยกคำตอบถูกที่มาช้าออกจากคำตอบเร็วแต่ไม่ตรงคำถามได้ ใส่การขัดจังหวะสองสามครั้งโดยกำหนดจังหวะให้ตรงกันในทั้งสองอินเทอร์เฟซ
เปรียบเทียบต้นทุนต่อเซสชันที่ทำสำเร็จ
ศูนย์ช่วยเหลือ Runway ระบุว่าคิด 2 เครดิตเมื่อเริ่มและอีก 2 เครดิตต่อเวลาใช้งานจริง 6 วินาที ที่ราคา 0.01 ดอลลาร์ต่อเครดิตก่อนภาษี เซสชันที่ใช้งานจริง 60 วินาทีเป็นตัวอย่างที่ใช้ 22 เครดิต หรือ 0.22 ดอลลาร์ตามอัตรานี้ นี่คือตัวอย่างตามวิธีคิดค่าบริการที่เผยแพร่ ยอดจริงขึ้นกับบัญชี เวลาใช้งาน ราคาปัจจุบัน และส่วนของแอปที่คิดแยก
ทีมที่เปรียบเทียบกับระบบเสียงอย่างเดียวสามารถวัดต้นทุนต่อบทสนทนาที่จบ บางคนจะเลิกก่อนอวตารพูดจบ บางคนต้องเริ่มใหม่เมื่อเครือข่ายมีปัญหาหรือคำตอบไม่ชัด เซสชันเหล่านี้ใช้ทรัพยากรแม้งานเดิมจะไม่สำเร็จ เมื่อวัดอัตราสำเร็จ ให้รวมเซสชันที่เลิกกลางทางในฐานนับและรวมค่าใช้จ่ายของเซสชันเหล่านั้นในยอดด้วย
ต้นทุนการกำกับและตรวจเนื้อหาก็อาจเปลี่ยน บริษัทอาจต้องตรวจว่าคำพูดที่สร้างขึ้นตรงตามนโยบาย ผู้บรรยายสังเคราะห์แสดงได้ในภูมิภาคที่ตั้งใจ และผู้เข้าชมติดต่อพนักงานได้อย่างไรเมื่อระบบตอบไม่ได้ ทดสอบเส้นทางเหล่านี้พอ ๆ กับระบบเรนเดอร์ ทางเลือกสำรองที่ออกแบบดีช่วยลดผลกระทบของเครือข่ายช้าต่อผู้เข้าชม
ทดลองเปรียบเทียบพร้อมเก็บข้อมูล
- เลือกปฏิสัมพันธ์ที่อนุมัติแล้วหนึ่งแบบที่ทราบคำตอบถูกและผลสำเร็จชัดเจน
- ลองเกณฑ์อ้างอิงแบบข้อความหรือเสียงกับแบบอวตาร โดยใช้แหล่งคำตอบและนโยบายบทสนทนาเดียวกัน
- ทำคำถามแต่ละข้อซ้ำบนอุปกรณ์และเครือข่ายที่ผู้เข้าชมใช้ ใส่คำตอบยาว การจงใจขัดจังหวะ และการหลุดชั่วครู่
- บันทึกเวลาเริ่มตอบ เวลาเริ่มภาพพูด ช่วงเล่นขาด การขัดจังหวะที่สำเร็จ และผู้เข้าชมทำงานจบหรือไม่
- ตรวจกรณีล้มเหลวพร้อมหลักฐานการเล่น ระบุว่าปัญหามาจากการรู้จำเสียง การสร้างคำตอบ การจับจังหวะ เครือข่าย หรืออินเทอร์เฟซ
- เปรียบเทียบจำนวนเซสชันที่สำเร็จและต้นทุนรวมทั้งสองแบบก่อนขยายไปสู่งานที่ยาวขึ้นหรือมีผู้ใช้มากขึ้น
การทดลองนี้แสดงได้ว่าภาพเคลื่อนไหวช่วยตรงไหน ตัวละครอาจทำให้จังหวะผลัดกันพูดชัดขึ้นสำหรับกลุ่มหนึ่ง และเพิ่มเวลารอที่ไม่จำเป็นสำหรับอีกกลุ่ม ผลนำร่องต้องอ่านร่วมกับรูปแบบการสนทนา เครือข่าย และอุปกรณ์ที่ใช้วัด
ดูการเปลี่ยนแปลงด้านกำลังประมวลผลเบื้องหลังตัวเลข
ผู้เขียนอธิบายการลดจาก H100 แปดตัวเหลือสี่ตัวสำหรับเซสชันเรียลไทม์หนึ่งเซสชัน การตั้งค่าสี่ตัวที่ยังไม่ใช้การรวมขั้นตอนระยะหลังทำได้ 24.5 เฟรมต่อวินาทีตามรายงาน ผลนี้แสดงว่าฮาร์ดแวร์และซอฟต์แวร์ชุดหนึ่งทำถึงเป้ากับงานที่ระบุ การรองรับงานพร้อมกันในภาระงานอื่นหรือฮาร์ดแวร์ที่จัดให้บัญชีผู้ซื้อต้องสอบถามและวัดต่างหาก
ผู้ซื้อถามผู้ให้บริการได้ว่าส่วนใดเริ่มก่อน เกิดอะไรขึ้นเมื่อกำลังประมวลผลจำกัด และเซสชันกู้คืนอย่างไร โชว์รูมอาจยอมรับภาพสะดุดสั้น ๆ หากเสียงยังไปต่อและได้คำตอบ ส่วนแอปฝึกที่ต้องให้ภาพกับเสียงตรงกันอาจต้องหยุด แสดงสถานะให้ชัด และเริ่มต่อจากตำแหน่งที่รู้ ลองทำอย่างเดิมหลังขัดจังหวะเพื่อดูว่าแอปทราบไหมว่าผู้ใช้ฟังไปถึงส่วนใด
การแลกเปลี่ยนนี้มีผลเมื่อคนพูดแทรกกลางประโยค ระบบอาจเก็บเสียงหรือวิดีโอที่สร้างไว้ล่วงหน้าเพื่อให้เล่นต่อเนื่อง บัฟเฟอร์ที่ใหญ่เกินไปทำให้ตัวละครพูดต่อแม้ผู้ใช้พยายามแทรก ส่วนบัฟเฟอร์เล็กอาจอ่อนไหวต่อเครือข่ายที่ผันผวน วัดเวลาที่เสียงหยุดจริงกับเวลาถึงคำตอบถัดไปแยกกัน
ลองกู้คืนในแบบที่ผู้ใช้เข้าใจได้
การทดลองกับผู้เข้าชมกลุ่มเล็กสามารถลดความเร็วการเชื่อมต่อขณะกำลังเล่นคำตอบ บันทึกว่าเสียงหยุดไหม ภาพค้างหรือไม่ และอินเทอร์เฟซแจ้งอะไร จากนั้นคืนเครือข่ายเป็นปกติและดูว่าตัวละครพูดต่อจากเดิม ขอให้ถามซ้ำ หรือส่งไปช่องทางอื่น แต่ละผลส่งผลต่างกันต่อคนที่ยืนหน้าเครื่องบริการ
เมื่อระบบกลับมาทำงานไม่ได้ ให้ผู้เข้าชมใช้บทถอดเสียง ช่องทางข้อความที่เข้าถึงได้ หรือส่งต่อให้เจ้าหน้าที่หากแอปรองรับ งานสั้นอาจทำต่อจนจบได้แม้วิดีโอขัดข้อง แบบฝึกหัดยาวอาจต้องกลับไปจุดบันทึก พฤติกรรมที่เหมาะขึ้นกับว่าบทสนทนาดำเนินไปแล้วมากเท่าไร
การทดสอบโหลดทั่วไปเริ่มได้ด้วยการมาถึงสามรูปแบบ เปรียบเทียบเซสชันยาวหนึ่งครั้ง เซสชันสั้นหลายครั้งที่แยกกัน และกลุ่มที่เริ่มพร้อมกัน ดูทั้งเวลาเริ่มตอบและกรณีที่ช้าที่สุดในแต่ละแบบ สตรีมที่ทำได้ตามเป้าเมื่อเริ่มเล่นแล้วอาจยังให้ประสบการณ์ไม่ดีหากผู้เข้าชมต้องรอเริ่มนานขึ้นเมื่อคนเข้ามาพร้อมกัน
แหล่งข้อมูล
หากต้องการเก็บบันทึกการสนทนาและการตัดสินใจเบื้องหลังงานให้ค้นหาได้ สร้างบัญชี Telli.sh.