Robot yang unggul di demo bisa kalah di tempat kerja Anda
Evaluasi robot fisik terdistribusi RoboColosseum menunjukkan mengapa kinerja bisa berubah menurut perangkat keras, tugas, dan fine-tuning. Rancang uji coba sesuai pekerjaan yang dibutuhkan.
Dua lengan robot terlihat sama meyakinkannya dalam video. Lengan pertama tergelincir saat memegang wadah yang belum dikenal. Lengan kedua berhasil menggenggam, tetapi menaruhnya di bak yang salah. Tim operasi yang harus memilih perlu tahu kegagalan mana yang akan terjadi di lini mereka dan apa yang diperlukan untuk pulih.
RoboColosseum adalah upaya riset untuk membandingkan kebijakan kendali robot pada perangkat keras fisik di berbagai lokasi evaluasi. Dalam versi arXiv 2 November, peneliti melaporkan 5.699 perbandingan berpasangan di 124 lokasi. Mereka mendapati kesesuaian peringkat yang rendah antarwujud fisik robot dan melaporkan bahwa kinerja relatif bisa berubah setelah fine-tuning. Pembeli dan peneliti dapat memakai temuan itu untuk merancang evaluasi yang lebih baik sebelum mengambil keputusan dari rangkaian video demo.
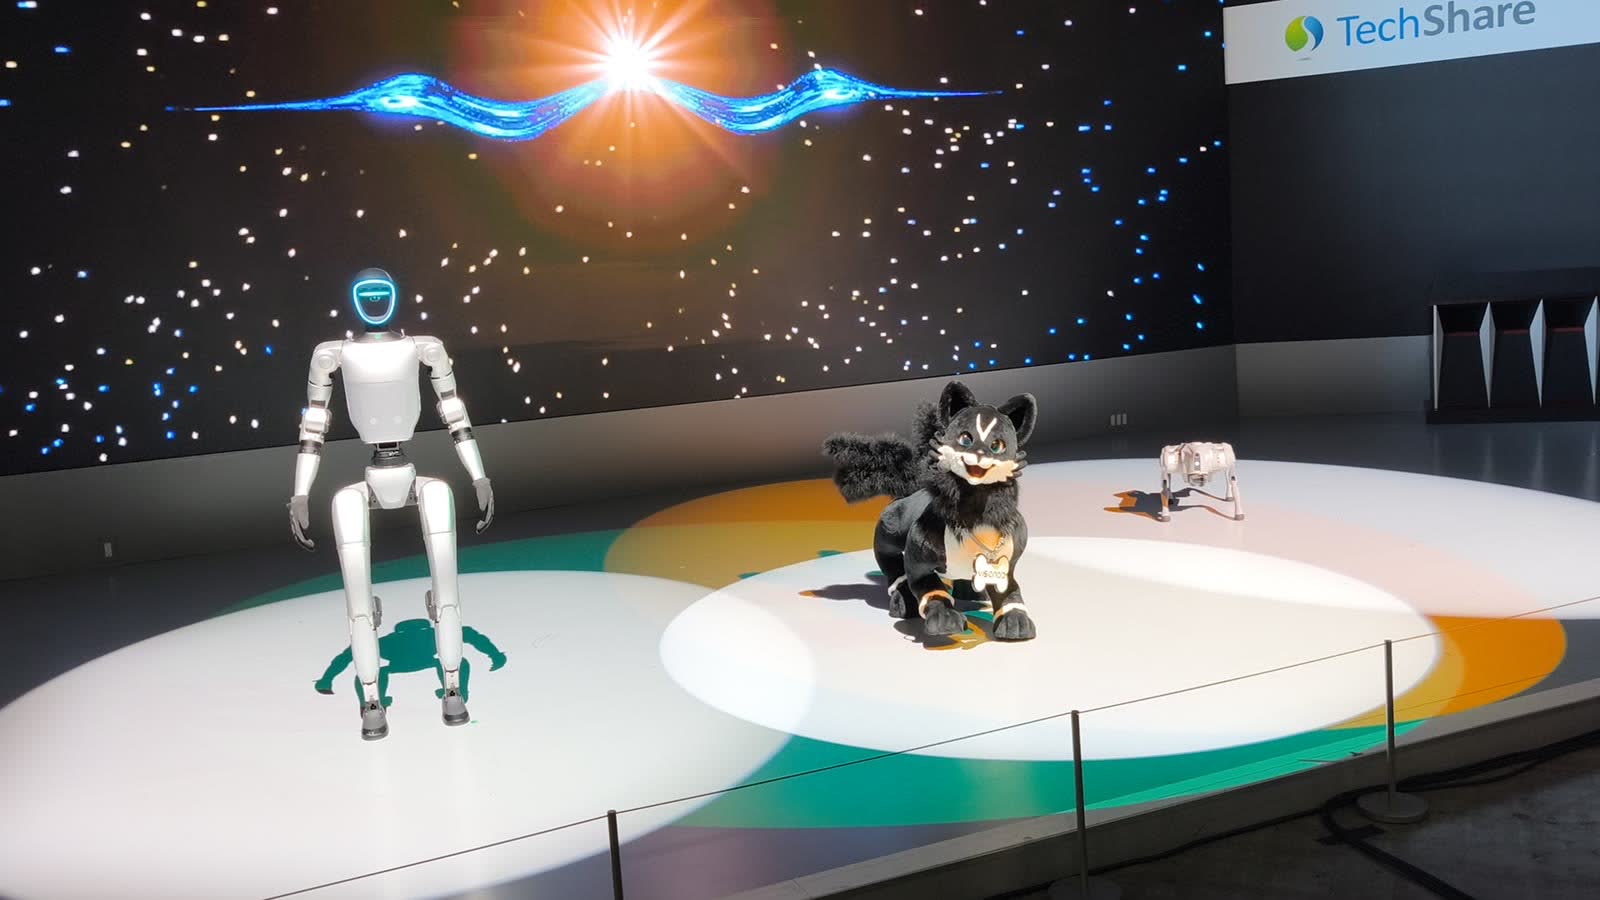
Unitree G1 (kiri), salah satu platform robot yang dievaluasi, di Japan Mobility Show 2025. Foto oleh RuinDig/Yuki Uchida, diubah ukurannya, CC BY 4.0. Sumber gambar · Lisensi.

Peringkat berlaku untuk robot, tugas, dan kondisi tertentu
Evaluasi robot di lokasi. Ilustrasi asli Telli.sh.
Satu kebijakan bisa bekerja baik untuk kombinasi robot, posisi sensor, dan tugas tertentu. Ganti penjepit atau ubah tempat objek masuk ke ruang kerja, dan keterampilan yang agak berbeda bisa menentukan keberhasilan. Kebijakan yang sudah melalui fine-tuning juga berbeda dari kebijakan yang digunakan langsung. Kinerjanya bergantung pada demonstrasi dan proses adaptasi yang diterimanya.
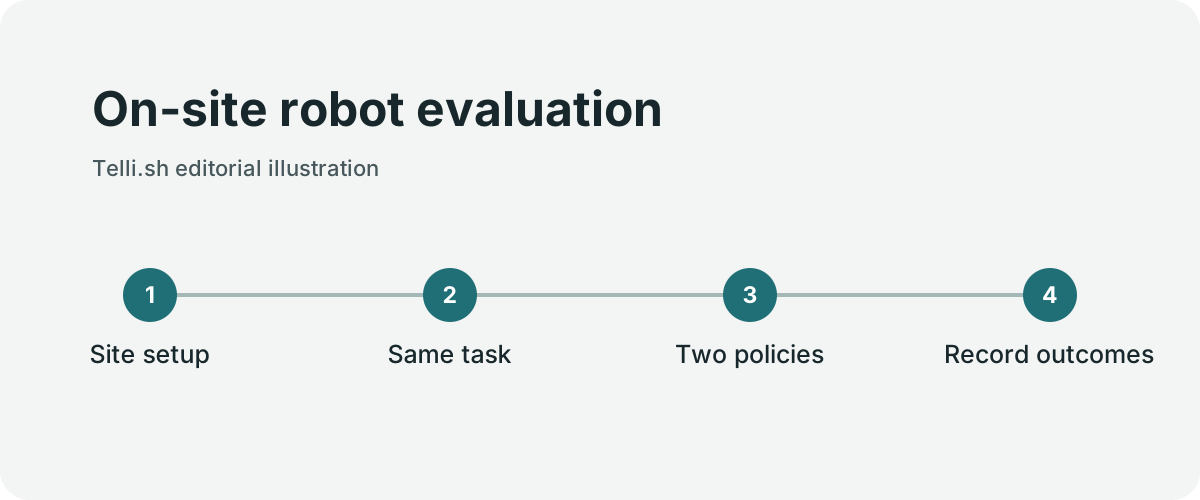
Studi ini membandingkan kebijakan dalam kondisi lokal yang dipadankan. Di jalur terbuka, penilai membandingkan percobaan pada tugas yang sama tanpa mengetahui model mana yang menghasilkan setiap percobaan. Jalur fine-tuning memakai rangkaian tugas dan demonstrasi yang lebih terkendali. Ini memisahkan dua pertanyaan, yaitu apa yang terjadi ketika instruksi baru diberikan dan seberapa baik kebijakan beradaptasi setelah menerima contoh.
| Hal yang digambarkan hasil | Hal yang masih perlu diketahui tim penerapan |
|---|---|
| Satu wujud fisik robot | Apakah perangkat keras dan sensornya menyerupai milik Anda |
| Satu distribusi tugas | Objek, tata letak, dan pengecualian apa yang tercakup |
| Kebijakan yang sudah disetel | Demonstrasi, waktu, dan komputasi yang menghasilkannya |
| Penilaian preferensi atau kemajuan | Seberapa sering siklus selesai tanpa intervensi |
| Periode evaluasi | Apakah konfigurasi sesuai dengan versi yang akan diterapkan |
Makalah tersebut melaporkan rendahnya kesesuaian peringkat pada empat wujud fisik dalam studi. Situs proyek bisa mencantumkan perangkat evaluasi aktif yang lebih baru dan lebih beragam. Gunakan cakupan studi saat menjelaskan angkanya. Inventaris platform publik menggambarkan apa yang ditawarkan saat ini, sedangkan makalah menggambarkan eksperimen pada satu titik waktu.
Perhatikan bagaimana kegagalan terjadi
Menilai kemajuan parsial. Ilustrasi asli Telli.sh.
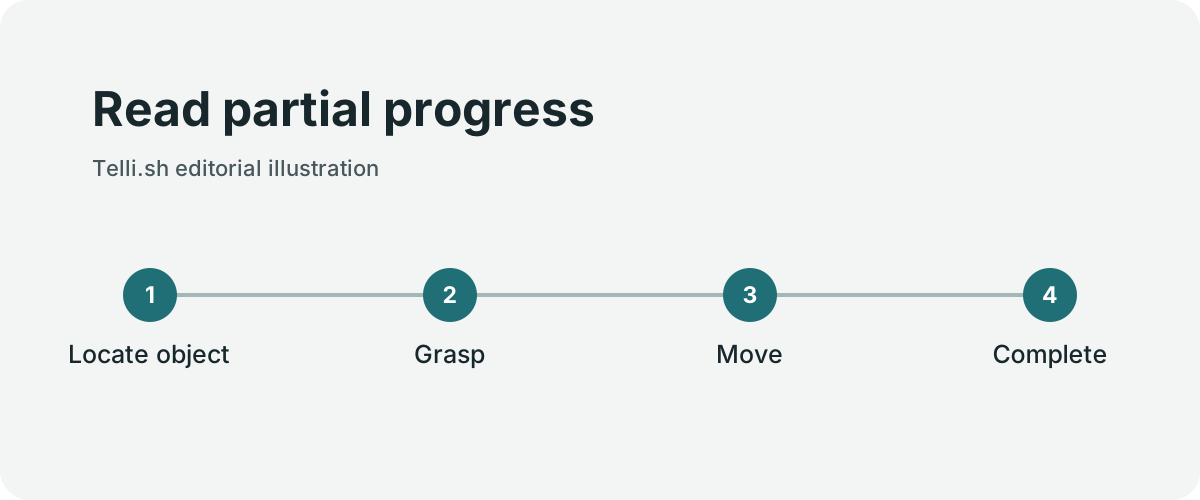
Studi melaporkan bahwa tidak satu pun kebijakan yang diuji menuntaskan lima tugas pada satu konfigurasi Unitree G1. Skor kemajuannya tetap berbeda. Pembedaan itu membantu memahami apakah model gagal pada tahap awal atau mendekati akhir. Temuan ini menggambarkan tugas dan kebijakan tersebut di bawah kondisi studi.
Bayangkan tugas sortir dengan lima tahap, yaitu mengenali objek, mendekatinya, menggenggam, memindahkan, lalu melepaskannya di tempat yang tepat. Model yang konsisten mencapai tahap pelepasan mungkin layak diperbaiki jika langkah terakhir sederhana. Jika kegagalannya menjatuhkan benda berat, skor kemajuan yang sama tingginya tidak banyak membantu operasi. Kemajuan parsial menunjukkan tempat untuk menyelidiki. Konsekuensi fisik menentukan apakah perilaku itu layak dibawa ke tempat kerja.
Percobaan ulang mudah luput dalam demonstrasi singkat. Pada lini yang sibuk, percobaan ulang memakan waktu dan mungkin memerlukan orang untuk menata ulang area kerja. Keberhasilan dalam sepuluh detik dengan pemulihan satu menit pada sebagian eksekusi bisa memberi kapasitas produksi lebih buruk daripada kebijakan yang lebih lambat dengan lebih sedikit intervensi. Ukur keberhasilan dan waktu pemulihan dalam cukup banyak siklus untuk melihat gangguan yang berpengaruh.
Peninjauan visual berguna di sini. Simpan cuplikan dari beberapa keberhasilan penuh, percobaan parsial, dan kegagalan dengan penyebab berbeda. Video yang berakhir sesaat setelah robot menggenggam objek bisa menghilangkan tahap pelepasan. Penilai yang melihat seluruh percobaan dapat membedakan pekerjaan selesai dari gerakan yang tampak menjanjikan.
Uji lapangan bisa belajar dari cara riset membandingkan kebijakan
Uji coba sebaiknya dimulai dari pekerjaan yang benar-benar dibutuhkan lokasi. Gudang mungkin perlu menangani wadah campuran berisi kemasan reflektif dan sesekali kotak penyok. Laboratorium mungkin perlu serangkaian serah terima alat kecil. Tugas, keadaan awal, dan hasil yang diharapkan membuat pengujian dapat diulang serta membantu vendor memahami hal yang perlu diperbaiki.
- Pilih tugas yang keberhasilannya bisa diamati. Catat susunan awal dan kondisi selesai. Sertakan objek yang representatif dan beberapa kasus menantang yang tetap sesuai dengan pekerjaan.
- Catat robot, sensor, efektor ujung, kondisi lokasi, dan versi kebijakan. Jika memungkinkan, jalankan kebijakan pesaing pada konfigurasi dan instruksi lokal yang sama.
- Pisahkan eksekusi dengan pengaturan bawaan dari eksekusi setelah adaptasi. Catat jumlah demonstrasi dan pekerjaan yang dibutuhkan untuk adaptasi serta contoh mana yang disisihkan.
- Amati keberhasilan penuh, kemajuan parsial, waktu penyelesaian, dan intervensi. Masukkan percobaan yang gagal saat persiapan atau memerlukan penataan ulang oleh operator.
- Ulangi pengujian pada giliran kerja atau lokasi yang mengubah satu kondisi relevan. Misalnya, gunakan campuran objek yang berbeda atau ukur perilaku ketika tugas dimulai sedikit melenceng dari tengah.
- Evaluasi kontrol penerapan dan keselamatan fisik bersama petugas berkualifikasi serta prosedur setempat. Tolok ukur riset mengukur perilaku kebijakan. Evaluasi tempat kerja juga memperhitungkan orang dan peralatan di sekitar robot.
Jika tim menilai perbedaan kualitatif, coba tinjau cuplikan yang dianonimkan secara berpasangan. Beri penilai definisi tertulis untuk perilaku yang dapat diterima dan cara menandai percobaan yang tidak aman atau tidak dapat digunakan. Simpan metadata secukupnya untuk memahami perbedaan penilaian kemudian. Menyamarkan identitas dapat mengurangi preferensi merek, sementara rubrik bersama membantu penilai di lokasi berbeda menilai hasil yang sama.
Bandingkan jalur evaluasi sebelum membandingkan kebijakan
Open Track dan Fine-tune Track mengajukan pertanyaan terkait dengan rancangan eksperimen yang berbeda. Open Track memakai 5.699 perbandingan berpasangan di 124 lokasi sebagaimana dilaporkan dalam pracetak. Uji berpasangan menunjukkan bagaimana dua kebijakan bekerja saat tugas dan lokasi sebanding. Angka tersebut tidak berarti setiap robot diuji untuk semua tugas di setiap lokasi.
Fine-tune Track memakai 100 demonstrasi per tugas untuk 20 tugas dalam evaluasi yang dilaporkan makalah. Peneliti melaporkan bahwa Unitree G1 tidak menuntaskan satu pun dari lima tugas yang dievaluasi pada jalur itu, dengan skor kemajuan rata-rata berkisar 13,3% hingga 23,2%. Skor parsial memberi pembaca lebih banyak informasi tentang kesenjangan daripada satu angka nol di hasil akhir. Skor itu menunjukkan kebijakan dapat membuat kemajuan yang teramati menurut rubrik meski tugas belum selesai.
Peneliti melaporkan koefisien konkordansi Kendall sebesar 0,24 untuk peringkat kemajuan di empat kelompok tugas khusus perangkat keras. Angka ini mengukur kesesuaian antarperingkat, terpisah dari persentase tugas selesai. Kelompok tugas berbeda baik pada wujud fisik robot maupun tugas dan kondisi yang digunakan. Rendahnya kesesuaian memberi alasan untuk memvalidasi kombinasi pilihan di lokasi sendiri. Hasil ini belum mengisolasi bentuk robot sebagai penyebab perbedaan peringkat.
Padankan kedua giliran kerja dalam uji lapangan
Misalkan pusat distribusi ingin robot memindahkan sisipan kemasan yang sama dari baki ke karton pada dua giliran kerja. Operator melihat bahwa giliran malam menerima baki yang berbeda dan mendapat lebih sedikit cahaya alami. Jalankan kedua kandidat kebijakan dalam kedua kondisi tersebut, sehingga uji tidak kehilangan perbedaan lapangan. Selang-seling urutannya dalam tiap giliran agar baterai yang melemah, dudukan yang bergeser, atau pengalaman operator tidak terus menguntungkan kandidat yang sama.
Catat posisi dan orientasi awal objek, setelan sensor atau pencahayaan yang diizinkan, cara pekerja boleh mengintervensi, dan kriteria penempatan selesai. Simpan video kegagalan serta catatan intervensi. Jika kinerja satu kebijakan baru meningkat setelah posisi baki diperbaiki, intervensi itu mungkin lebih relevan bagi penerapan daripada rata-rata akhir. Pengamatan ini bisa mengarah pada perubahan dudukan atau pemilihan kasus yang lebih baik untuk pengujian berikutnya.
Lembar penilaian yang berguna memberikan nilai parsial pada tahap yang dapat diamati. Penjepit yang menemukan sisipan yang tepat tetapi tidak dapat mengangkatnya membutuhkan perbaikan berbeda dari penjepit yang bisa mengangkat tetapi gagal memasukkannya ke karton. Gunakan definisi sederhana untuk tiap tahap agar dua penilai menafsirkan percobaan secara konsisten. Tambahkan kategori terpisah untuk penghentian aman. Eksekusi yang berhenti karena pekerja masuk ke area mungkin telah berperilaku benar meskipun tugas belum selesai.
Tentukan bukti yang layak untuk maju ke tahap berikutnya
Demo laboratorium yang berhasil bisa menjadi dasar uji di lokasi, dan uji lokasi yang berhasil bisa menjadi dasar untuk uji coba yang lebih lama. Tiap keputusan memiliki ambang penerimaan sendiri. Tim pengadaan bisa meminta pengulangan hasil pada dua giliran umum sebelum membahas perluasan ke area yang kurang dapat diprediksi. Peneliti bisa meminta label kegagalan dan kondisi pengulangan sebelum menyimpulkan kebijakan berhasil dipindahkan.
Ketika hasil berbeda, catat kondisi yang berubah dan tindakan yang gagal. Peringkat yang terbalik bisa mengungkap tugas yang belum terwakili dalam tolok ukur semula. Itu membantu tim memutuskan apakah membutuhkan robot lain, kebijakan berbeda, area kerja yang dimodifikasi, atau pengujian yang lebih representatif.
Perhatikan perubahan peringkat dalam makalah
Fine-tune Track memberi contoh konkret perubahan peringkat pada empat kelompok tugas. π0.5 menempati posisi pertama dalam peringkat kemajuan pada Franka dan Bimanual-YAM, lalu posisi keempat pada G1. GR00T N1.7 memimpin kelompok tugas SO-101, tetapi berada di posisi keempat pada Franka dan Bimanual-YAM. Hasil tersebut berlaku pada kelompok tugas dan metrik kemajuan yang dilaporkan. Tim pengadaan dapat melihat urutan itu sebagai contoh perubahan peringkat saat kombinasi tugas, kondisi, dan perangkat keras berubah.
Makalah juga meneliti pemilihan aktif terhadap perbandingan yang akan dijalankan. Dalam analisisnya, sekitar 400 hingga 500 evaluasi yang dipilih secara adaptif mencapai sekitar 90% kesesuaian dengan peringkat berdasarkan data lengkap, dibandingkan sekitar 1.000 evaluasi dengan pemilihan seragam. Hasil itu berlaku untuk rancangan evaluasi tersebut. Gagasan yang dapat dipakai dalam uji lokal adalah memberi lebih banyak pengulangan pada kasus yang sulit membedakan kandidat teratas sambil tetap menjaga jumlah minimum tetap untuk kasus representatif.
Lokasi kerja dapat memisahkan putaran awal dan putaran adaptif. Pada putaran awal, beri kedua kandidat pekerjaan dan aturan intervensi yang sama. Pada putaran kedua, ulangi kondisi ketika bukti awal belum jelas. Pertahankan aturan penerimaan semula. Jika suatu kondisi dikecualikan karena keselamatan atau kendala praktis, catat alasannya. Laporan akhir perlu menjelaskan bagaimana percobaan tambahan mengubah keputusan.
Cari informasi tentang pekerjaan yang paling penting
Evaluasi terdistribusi dapat menghimpun berbagai kondisi yang sulit direproduksi satu laboratorium. Uji coba lokal memberi pemahaman mendalam atas pekerjaan yang menjadi tanggung jawab tim Anda. Kedua pendekatan bisa dipakai bersama. Gunakan bukti yang luas untuk mencari kandidat, lalu rancang evaluasi sendiri untuk menemukan pengecualian yang menentukan manfaat sistem.
Perbandingan terbaik dapat diulang tim setelah kebijakan baru atau perubahan perangkat keras. Simpan tugas, konfigurasi, dan contoh kegagalan bersama skor. Ketika peringkat bergeser, tim memiliki cukup informasi untuk menilai apakah perubahan itu memperbaiki pekerjaan.
Sumber
Untuk menyimpan catatan percakapan dan keputusan di balik pekerjaan Anda yang dapat ditelusuri, Buat akun Telli.sh.