[สมุดไอเดีย AI 04] จากการตัดสินใจแบบ Jev สู่ภาพ: รู้จัก QEV โมเดลขนาดเล็กบน Qwen
ทำไมโมเดลตัดสินใจจากภาพจึงเริ่มปรากฏบน Qwen การรองรับภาพแบบทดลองของ Jev เปลี่ยนอะไร และโครงการ QEV ระดับ 2B ที่รันในเครื่องอยู่ตรงไหน
สมุดไอเดีย AI ชวนสำรวจแนวคิดและความเป็นไปได้ในการใช้งานจริงของโมเดลและเครื่องมือ AI ที่เพิ่งเริ่มปรากฏขึ้น
ภาพถ่ายเข้ามาในกระบวนการคัดแยก แอปต้องเลือกระหว่างพลาสติก แก้ว และโลหะ ตรวจว่าสิ่งของอยู่ในหมวดที่กำหนดหรือไม่ แล้วส่งค่าที่ซอฟต์แวร์ใช้ต่อได้ ย่อหน้าอธิบายขวดที่อ่านลื่นไหลอาจน่าสนใจ แต่ยังทิ้งอีกหนึ่งขั้นระหว่างโมเดลกับการตัดสินใจ
Jev ทำให้ผู้คนสนใจอินเทอร์เฟซอีกแบบ: ให้สถานการณ์ คำถาม และคำตอบที่อนุญาตแก่โมเดล แล้วรับการตัดสินใจแบบมีโครงสร้างพร้อมความน่าจะเป็น คำถามถัดไปเป็นธรรมชาติว่า อินเทอร์เฟซนี้จะใช้กับสิ่งที่โมเดลเห็นได้เช่นเดียวกับสิ่งที่อ่านหรือไม่
ตอนนี้ทำได้หลายรูปแบบ TypeSafe เปิดตัว การรองรับภาพแบบทดลองสำหรับ Jev เมื่อวันที่ 14 ตุลาคม 2026 โครงการอิสระก็เริ่มปรับ backbone ภาพและภาษาของ Qwen ให้ตัดสินใจแบบ Jev เช่นกัน หนึ่งในนั้นคือ QEV โมเดลรันในเครื่องบน Qwen3.5-2B ที่ให้ตัวเลือก คะแนนแบบมีลำดับ การตัดสินจริงเท็จ และการงดตอบ ประกาศ Jev, รีโพซิทอรี QEV
การเปิดเผยของผู้เขียน: QEV เป็นโครงการที่ผู้เขียนบทความนี้ดูแลโดยอิสระ บทแนะนำนี้แยกรุ่นที่เผยแพร่แล้วจากคุณสมบัติที่มีเฉพาะซอร์ส โดยใช้เอกสารสาธารณะและตัวอย่างที่บันทึกไว้ ไม่ได้นำเสนอการประเมินโมเดลอิสระครั้งใหม่
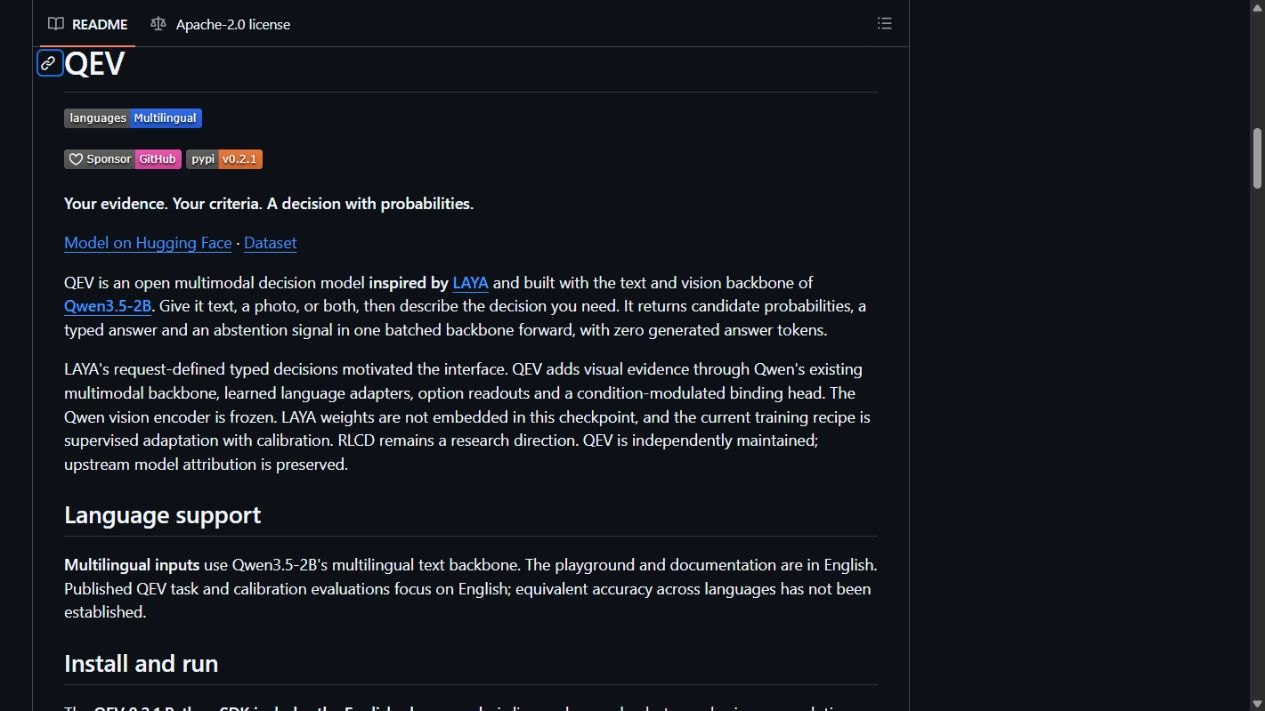 รีโพซิทอรีสาธารณะ ของ QEV ถ่ายวันที่ 20 ตุลาคม 2026 นี่คือหน้าจอเอกสาร ไม่ใช่การสาธิตอนุมานบนเครื่อง
ทำไมโมเดลตัดสินใจจึงให้ความรู้สึกต่างจากแชตบอต
แชตบอตมักเขียนคำตอบทีละโทเคน โมเดลตัดสินใจมีประโยชน์เมื่อแอปรู้อยู่แล้วว่าคำตอบควรมีรูปแบบใด เช่น เลือกปลายทาง ให้ระดับเงื่อนไขตามมาตราที่เรียงลำดับ หรือตัดสินว่าข้อความเป็นจริงหรือไม่
ตัวเลือกคำตอบเปลี่ยนตามคำขอได้ ระบบสนับสนุนอาจมีฝ่ายเรียกเก็บเงินและฝ่ายเทคนิควันนี้ แล้วเพิ่มกู้บัญชีในวันพรุ่งนี้ กระบวนการคัดแยกภาพอาจให้คำอธิบายวัสดุหกแบบในคำถามหนึ่ง และกฎจัดการอีกชุดในคำถามถัดไป โมเดลต้องเชื่อมหลักฐานปัจจุบันกับคำอธิบายเหล่านั้น แทนเลือกจากรายชื่อป้ายกำกับที่ฝึกไว้ถาวรเพียงชุดเดียว
primitive ที่คุ้นเคยของ Jev คือ choice, score และ noul ใน QEV choice ให้การแจกแจงของตัวเลือกที่ส่งมา score ใช้ระดับที่เรียงตามลำดับและให้ทั้งความน่าจะเป็นกับระดับคาดหมาย ส่วนคำถาม noul ใช้เกณฑ์จริงและเท็จ เหล่านี้เป็นข้อตกลงผลลัพธ์คนละชนิด แม้ใช้โมเดลฐานเดียวกัน เอกสารอ้างอิง QEV API
ความน่าจะเป็นทำให้เห็นขอบเขต: หากตัวเลือกสองตัวนำกันเพียงเล็กน้อย อาจส่งให้ตรวจแทนทำอัตโนมัติ แต่มันไม่ได้ทำให้การตัดสินใจถูกต้อง แอปยังต้องมีนโยบายเรื่องความไม่แน่นอน ข้อมูลไม่เหมาะสม และต้นทุนของความผิดพลาด
Jev มีเส้นทางรับภาพแบบทดลองแล้ว
เหตุผลในอดีตต้องปรับให้ทันปัจจุบัน การแนะนำ QEV โดยบอกว่า Jev ยังรับภาพไม่ได้จะทำให้เข้าใจผิด ประกาศเดือนตุลาคมของ TypeSafe เปิดข้อมูลภาพแบบทดลองใน Jev 1.13 และ 1.14 ผ่าน header TypeSafe-Danger-Zone-Images ส่วน Jev 1.14 ยังเพิ่ม primitive เชิงพื้นที่ Box ด้วย ประกาศระบุว่าคุณสมบัติภาพเหล่านี้ยังอยู่ในขั้นทดลอง ประกาศ Jev 1.14
สิ่งนี้เปลี่ยนวิธีเปรียบเทียบ คำถามที่มีประโยชน์คือรูปแบบนำไปใช้ ข้อตกลงข้อมูลนำเข้า และพฤติกรรมตัดสินใจใดเหมาะกับกระบวนการหนึ่ง การทดลอง Jev แบบโฮสต์ โมเดลวิจัย และการปรับ Qwen ในเครื่อง อาจมีแนวคิดการตัดสินใจในขอบเขตร่วมกัน แต่ต่างกันมากด้านแพ็กเกจและการทำงานที่รองรับ
QEV ไม่มีสิ่งเทียบเท่า Box ของ Jev ที่ระบุในเอกสาร มันเป็น implementation อิสระ ไม่ใช่น้ำหนักของ TypeSafe หรือรุ่น Jev ทางการ การใช้ชื่อ primitive ร่วมหรือ endpoint แบบ SystemOne เป็นจุดเริ่มต้นการเชื่อมต่อ ไม่ใช่หลักฐานว่าทุกคำขอย้ายข้ามผลิตภัณฑ์โดยไม่แก้ได้
ทำไม Qwen จึงปรากฏในโครงการเหล่านี้
backbone ภาพและภาษานำข้อมูลข้อความและภาพเข้าสู่โมเดลร่วมกันอยู่แล้ว จึงเป็นจุดเริ่มต้นที่ใช้ได้จริงสำหรับโครงการตัดสินใจ: รักษาความเข้าใจภาพไว้ แล้วปรับวิธีเชื่อมหลักฐานกับคำตอบที่แอปส่งมา
ตัวอย่างสาธารณะสองโครงการแสดงว่านี่เป็นทิศทางกว้างกว่ารีโพซิทอรีเดียว:
| โครงการ | แนวทางที่อธิบายต่อสาธารณะ | ควรตีความสถานะอย่างไร |
|---|---|---|
| PixelJev | ศึกษาการเลือกจากภาพแบบ Jev บน backbone Qwen3.5 ขนาดเล็ก รวมรุ่น 2B และ 4B | งานวิจัยเรื่องการเลือกจากภาพ ไม่ใช่หลักฐานของบริการแทน Jev แบบโฮสต์ครบชุด |
| AutoTrust JEV-27B-VL | ใช้ Qwen3.8-27B พร้อมหัวตัดสินใจและ adapters | โมเดลอิสระที่ใหญ่กว่า โมเดลการ์ดแยกพฤติกรรมตัดสินใจที่ฝึกจากข้อความออกจากการใช้ภาพแบบ zero-shot |
| QEV | ปรับ Qwen3.5-2B สำหรับ choice, score และ noul | โครงการในเครื่องระดับ 2B มี SDK เผยแพร่แล้ว และส่วนขยายซอร์สที่อธิบายแยกต่างหาก |
งานวิจัย PixelJev ช่วยให้เข้าใจแนวคิดสถาปัตยกรรม คือเชื่อมภาพและตัวเลือกระหว่างรันเข้ากับส่วนอ่านผลตัดสินใจ โมเดลการ์ด AutoTrust แสดง implementation อีกขนาด พร้อมระบุว่ายังไม่มีการยืนยันการสอบเทียบภาพอย่างเป็นระบบ ทั้งหมดเป็นตัวอย่างรูปแบบการออกแบบที่เริ่มเกิดขึ้น ไม่ใช่อันดับเบนช์มาร์กหรือรายชื่อผลิตภัณฑ์ที่เข้ากันได้เท่ากัน งานวิจัย PixelJev, โมเดลการ์ด AutoTrust
ที่ของ QEV ในภาพรวมนี้คือการใช้ในเครื่องขนาดกะทัดรัด คำว่า “เล็ก” อธิบายระดับ backbone เมื่อเทียบกับโมเดลภาพและภาษาที่ใหญ่กว่ามาก ไม่ได้แปลว่าติดตั้งทั้งหมดเพียงไม่กี่เมกะไบต์ หรือทำงานทันทีบนทุกอุปกรณ์
QEV เปลี่ยนภาพเป็นการตัดสินใจอย่างไร
QEV ใช้ backbone ข้อความและภาพ Qwen3.5-2B เพียงตัวเดียว สถาปัตยกรรมที่เผยแพร่เพิ่มการปรับฝั่งภาษาและส่วนอ่านผลซึ่งผูกสถานการณ์กับคำถามเข้ากับคำอธิบายตัวเลือกที่ส่งมา โมเดลให้คะแนนตัวเลือกโดยตรง แทนสร้างประโยคคำตอบแล้วให้ parser อีกตัวดึงป้ายกำกับ โมเดลการ์ดสาธารณะ
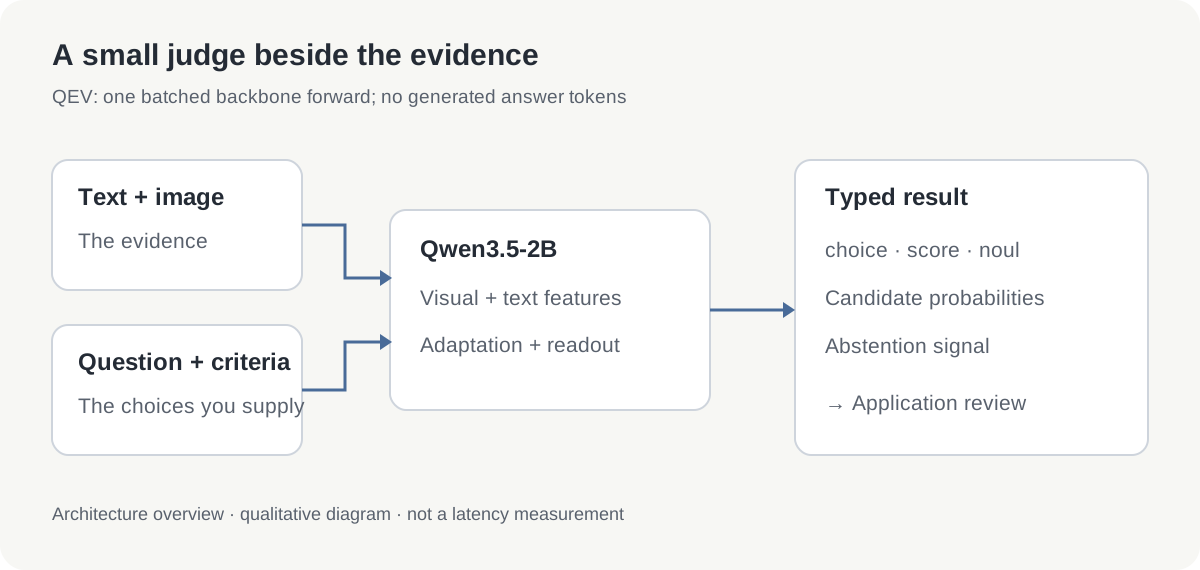 แผนภาพอธิบายที่จัดทำขึ้นใหม่ ลูกศรแสดงเส้นทางตัดสินใจในเอกสาร ไม่ใช่การเปรียบเทียบความเร็วที่วัดแล้ว
ใน SDK ที่เผยแพร่ หนึ่งคำขอมีข้อความ ภาพหนึ่งภาพ หรือทั้งสองได้ รองรับหนึ่งถึงสี่คำถาม โดย choice มีสองถึงสิบหกตัวเลือก และ score มีสองถึงสิบหกระดับเรียงลำดับ จึงทำกลุ่มการตัดสินใจที่เกี่ยวข้องขนาดเล็กได้โดยไม่เปลี่ยนทุกคำถามเป็นแชตแยก เอกสารอ้างอิง API
ลองพิจารณาภาพพร้อมคำสั่งสั้นว่า “เลือกวัสดุตามคำอธิบายเหล่านี้” คำถามที่สองอาจถามว่าตรงกลุ่มนโยบายใด และคำถามที่สามถามว่าตรงเงื่อนไขจริงเท็จที่กำหนดหรือไม่ ภาพคือหลักฐานร่วม ส่วนเกณฑ์กำหนดความหมายของการตัดสินใจแต่ละข้อ
เส้นทางอนุมานในเอกสารสร้างโทเคนคำตอบเป็นศูนย์ จึงตัดแหล่งความผันแปรด้านรูปแบบออก แต่ไม่ได้ตัด vision encoder การคำนวณ backbone การเตรียมภาพ หรือภาระของแอป “ไม่สร้างคำตอบ” กับ “ไม่มีต้นทุนคำนวณ” เป็นคนละคำกล่าวอย่างมาก
อ่านตัวอย่างขวดในฐานะตัวอย่าง
รีโพซิทอรี QEV มีภาพที่ได้รับสิทธิ์และผลลัพธ์ที่บันทึกไว้สำหรับขวดพลาสติก เป็นวิธีดูโครงสร้างคำตอบที่มีประโยชน์ก่อนติดตั้งอะไร
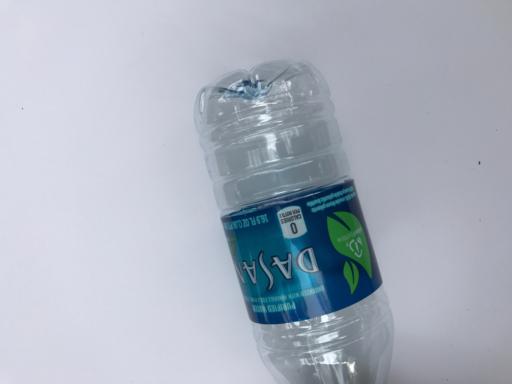 ข้อมูลนำเข้าตัวอย่างจาก ชุดตัวอย่างภาพถ่าย QEV มีต้นทางจาก TrashNet ลิขสิทธิ์ 2017 Gary Thung ใบอนุญาต MIT โดยเก็บ ประกาศใบอนุญาต ไว้ด้วย
| คำถามในชุดตัวอย่างที่เผยแพร่ | ผลที่บันทึก | ความหมาย |
|---|---|---|
| เลือกจากวัสดุหกชนิด | พลาสติก ความน่าจะเป็นประมาณ 0.9361 | พลาสติกได้สัดส่วนสูงสุดในตัวเลือกที่ส่งมา |
| เลือกกลุ่มนโยบายตามลำดับ | ระดับคาดหมายประมาณ 0.4254 บนมาตรา 0–2 | ค่าเฉลี่ยถ่วงน้ำหนักของดัชนีกลุ่มทั้งสามที่กำหนด |
| อยู่ในกลุ่มแก้ว กระดาษ หรือพลาสติกหรือไม่ | จริง ความน่าจะเป็นประมาณ 0.7903 | เกณฑ์จริงเท็จได้รับน้ำหนักมากกว่าทางเลือกเท็จ |
คะแนนต้องระมัดระวังเป็นพิเศษ ในชุดนี้ กลุ่ม 0 รวมแก้วกับพลาสติก กลุ่ม 1 รวมโลหะกับขยะ และกลุ่ม 2 รวมกระดาษแข็งกับกระดาษ ลำดับเป็นนโยบายตัวอย่าง ตัวเลข 0.4254 ไม่ใช่ระดับความปลอดภัย มาตรฐานรีไซเคิล หรือความมั่นใจในการเลือกวัสดุ
เช่นกัน ความน่าจะเป็นพลาสติกอธิบายคำขอนี้และตัวเลือกของมัน ไม่ใช่หลักฐานว่า 93.61% ของภาพขวดทั้งหมดจะถูกจัดประเภทถูก นี่คือชุดตัวอย่างรุ่นที่เคยตรวจแล้ว ไม่ใช่การทดสอบใหม่บนข้อมูลกันไว้ และผลด้านบนเป็นบันทึกของโครงการ ไม่ได้ทำซ้ำเพื่อบทความนี้
“เข้ากันได้กับ Jev” ควรหมายถึงอะไรในที่นี้
ความเข้ากันได้เข้าใจง่ายที่สุดเมื่อแยกเป็นชั้น มีทั้งแนวคิดร่วมเรื่องการตัดสินใจที่คำขอกำหนด schema JSON ที่แน่นอน ข้อมูลนำเข้าที่รองรับ และพฤติกรรมผลลัพธ์แต่ละชนิด การตรงกันชั้นหนึ่งไม่ได้ทำให้ชั้นอื่นตรงกันอัตโนมัติ
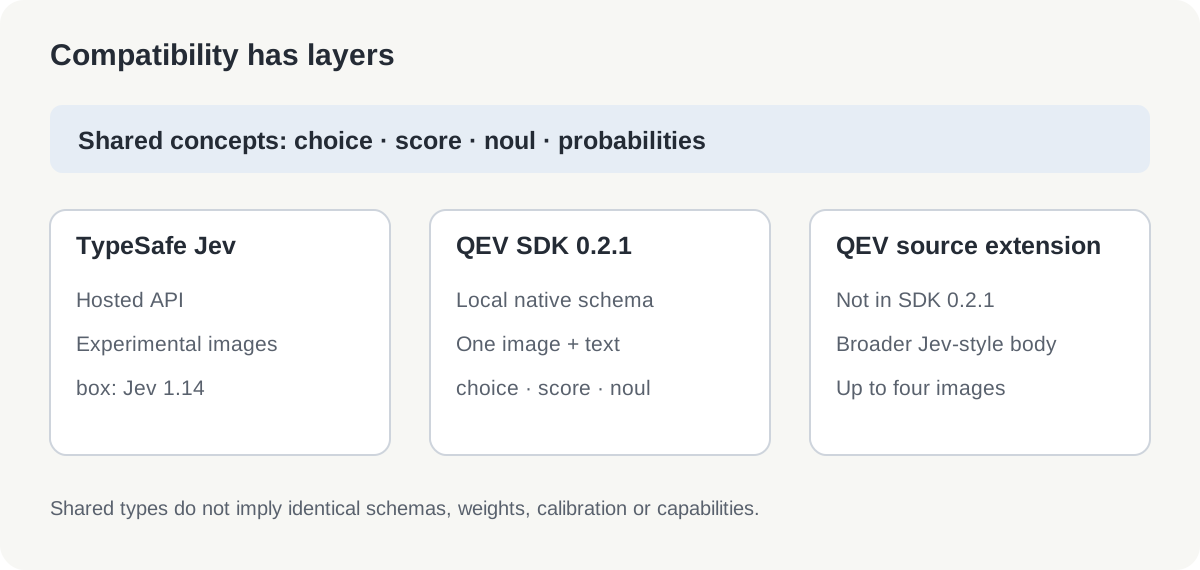 แผนภาพความเข้ากันได้ที่จัดทำขึ้นใหม่ ตรวจวันที่ 20 ตุลาคม 2026 ส่วนขยายซอร์สแยกจากข้อตกลง SDK ที่บรรจุแพ็กเกจ
SDK QEV 0.2.1 ที่บรรจุแพ็กเกจใช้ schema คำขอ native ของ QEV และภาพไม่บังคับหนึ่งภาพ ส่วน checkout ซอร์สสาธารณะยังอธิบายการรับคำขอแบบ Jev/SystemOne ที่กว้างกว่า และภาพเรียงลำดับสูงสุดสี่ภาพ ไม่ควรสมมติว่าส่วนขยายซอร์สเหล่านี้มีในแพ็กเกจ 0.2.1 ที่เผยแพร่แล้ว API และบันทึกรุ่น, รุ่น 0.2.1
ในการเชื่อมต่อ เริ่มจากคำขอที่รู้หนึ่งชุด แล้วเปรียบเทียบการตรวจความถูกต้อง ฟิลด์คำตอบ ลำดับตัวเลือก และพฤติกรรมความไม่แน่นอน พาธ /v1/systemone ที่คุ้นเคยเพียงอย่างเดียวไม่ได้พิสูจน์ว่าแทนบริการหรือ SDK ของ TypeSafe ได้ทุกกรณีทันที
ลองดูครั้งแรกอย่างเป็นขั้นตอน
สำหรับการสำรวจแรก playground ในเครื่องตรวจดูง่ายกว่าการเชื่อมเข้ากับแอป
- เตรียมสภาพแวดล้อม Python 3.12 และเปิดใช้งาน
- ติดตั้งรุ่นที่ตรึงไว้และเริ่ม playground ด้วยคำสั่งด้านล่าง
- เปิด
http://127.0.0.1:7860เลือกตัวอย่าง แล้วตรวจความน่าจะเป็นตัวเลือกและการงดตอบ
python -m pip install qev==0.2.1
qev playground
playground ในเอกสารรันในเครื่องที่ http://127.0.0.1:7860 มีภาพตัวอย่างและแสดงความน่าจะเป็น การงดตอบ และผลแบบมีโครงสร้าง อินเทอร์เฟซและเอกสารเป็นภาษาอังกฤษ นี่คือคำแนะนำติดตั้งจากรุ่นที่เผยแพร่ ไม่ใช่การอ้างว่าติดตั้งหรือจับเวลาโมเดลเพื่อบทความนี้ คู่มือ playground
คำขอข้อความเล็ก ๆ แสดงรูปแบบ native SDK:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
เริ่มด้วยตัวเลือกสองหรือสามตัวที่ต่างกันชัด จากนั้นลองกรณีกำกวมและกรณีที่ไม่อยู่ในตัวเลือกใด ตรวจว่าการงดตอบกับนโยบายแอปให้ผลที่มีประโยชน์หรือไม่ สำหรับทดสอบภาพ ใช้ภาพที่คุณมีสิทธิ์ประมวลผล และเขียนเกณฑ์จากหลักฐานที่มองเห็น แทนข้อเท็จจริงที่ภาพยืนยันไม่ได้
วางงบให้ backbone ด้วย ไม่ใช่แค่ adapter
สำหรับวิธี SDK 0.2.1 รุ่นเก่าด้านบน เช็กพอยต์ส่วนปรับ QEV มีประมาณ 32.01 MB และต้องดาวน์โหลด Qwen backbone แยกอีกราว 4.55 GB รายละเอียดที่เผยแพร่ระบุ backbone ประมาณ 2.213 พันล้านพารามิเตอร์ และส่วนปรับ/อ่านผล 7.992 ล้านพารามิเตอร์ ส่วนเช็กพอยต์ QEV-0.8B กับ QEV-2B เดือนตุลาคมด้านล่างใช้วิธีโหลดรุ่นอีกแบบ รายละเอียดขนาดโมเดล SDK
การตั้งค่าครั้งแรกจึงเกี่ยวข้องกับข้อมูลระดับกิกะไบต์ การใช้ภายหลังพึ่งไฟล์แคชได้ แต่หน่วยความจำขณะรันยังรวม activations การประมวลผลภาพ และบัฟเฟอร์ เส้นทาง GPU และ CPU ในเอกสารใช้ความละเอียดตัวเลขต่างกัน จำนวนไบต์ของเช็กพอยต์มีประโยชน์ต่อวางแผนจัดเก็บ ไม่ใช่คำสัญญาเรื่องหน่วยความจำ throughput หรือแบตเตอรี่บนเครื่องหนึ่ง
ถ้า 2B หนักเกินเครื่อง ลอง QEV-0.8B
รุ่นเดือนตุลาคมมี QEV-0.8B ที่สร้างบน Qwen3.5-0.8B และกลั่นจากโมเดลครูเดียวกับ QEV-2B รุ่นใหม่ เป็นจุดเริ่มต้นที่ใช้ได้จริงเมื่อหน่วยความจำ GPU หรือเวลาตอบสนองทำให้ใช้ 2B ไม่คล่อง โมเดลเล็กยังรักษาการตัดสินใจที่กำหนดตามคำขอ โดยแลกคุณภาพตัดสินใจจากภาพบางส่วนกับทรัพยากรที่น้อยลง โมเดลการ์ด 0.8B, โมเดลการ์ด 2B
| ค่าที่เผยแพร่ | QEV-0.8B | QEV-2B เดือนตุลาคม | ความต่าง |
|---|---|---|---|
| Decision Index ด้านภาพสาธารณะ โหมด accurate | 53.02 | 61.99 | 2B นำ 8.97 จุดดัชนี |
| หน่วยความจำ GPU ที่จัดสรรสูงสุด โหมด accurate | 1.86 GiB | 4.44 GiB | 0.8B ใช้น้อยกว่าประมาณ 58% |
| มัธยฐานของ latency p50 ของโปรไฟล์คำขอ | 66.0 ms | 135.3 ms | 0.8B ต่ำกว่าประมาณ 51% |
| latency p95 สูงสุดในโปรไฟล์คำขอ | 377.3 ms | 738.6 ms | 0.8B ต่ำกว่าประมาณ 49% |
| หน่วยความจำ GPU ที่จัดสรรสูงสุด โหมด fast | 1.60 GiB | 4.13 GiB | 0.8B ประหยัด 2.53 GiB |
| คะแนน RealWorldQA | 39.2 | 56.2 | 2B นำ 17.0 จุด |
| คะแนน Winoground | 47.5 | 65.5 | 2B นำ 18.0 จุด |
| คะแนน InfographicVQA | 75.4 | 83.1 | 2B นำ 7.7 จุด |
ทั้งหมดเป็นการวัดของนักพัฒนา ตรวจวันที่ 20 ตุลาคม 2026 ดัชนีให้คะแนนด้วยตนเองบน public vision kit รุ่น 0.3.2 และรอการรันอย่างเป็นทางการ ไม่ใช่ร้อยละความแม่นยำโดยรวม ช่วง paired bootstrap สำหรับช่องว่าง 8.97 จุดคือ 7.39–10.48 จุด เบนช์มาร์กแต่ละตัวแสดงว่าช่องว่างเปลี่ยนตามงานอย่างไร
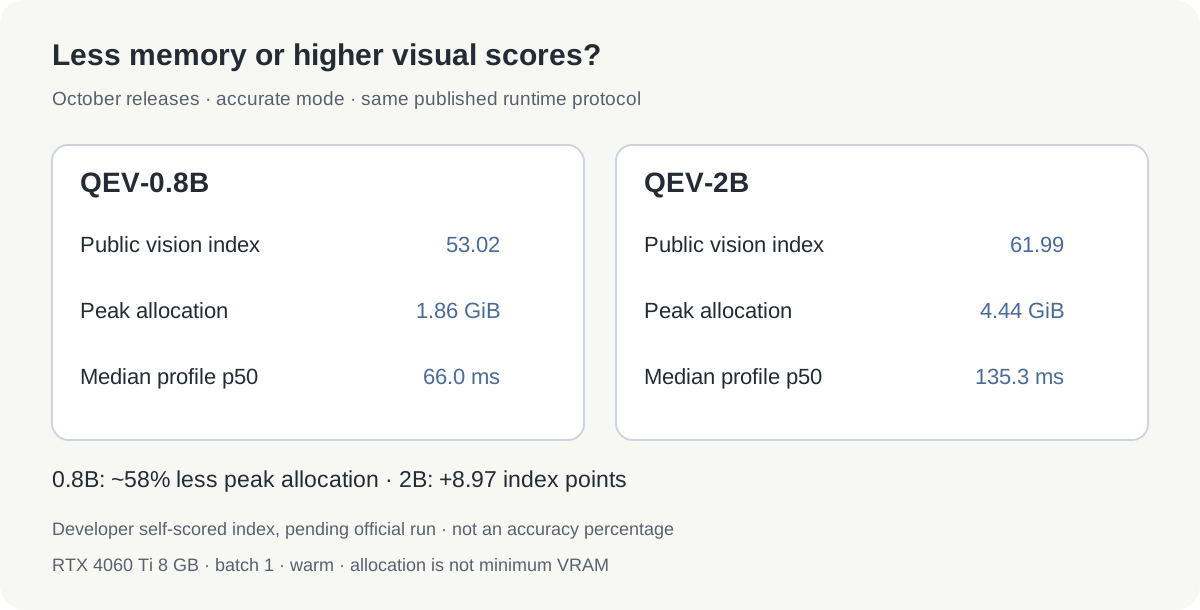 อินโฟกราฟิกเปรียบเทียบที่จัดทำขึ้นใหม่จากโมเดลการ์ดสองฉบับที่ตรึง revision ค่าดัชนีให้คะแนนด้วยตนเอง ส่วนหน่วยความจำและเวลาเป็นโหมด accurate บน GPU ที่ใช้วัด
การวัดรันไทม์ใช้ RTX 4060 Ti 8 GB batch 1 โมเดลอุ่นแล้ว และโปรไฟล์คำขอ 47 แบบ โดยอุ่นสามครั้งและจับเวลา 30 ครั้งต่อโปรไฟล์ โหมด accurate อนุญาตสูงสุด 1.6 MP ต่อภาพ หน่วยความจำคือ peak allocation ของ PyTorch ไม่ใช่ความจุการ์ดขั้นต่ำ: ไดรเวอร์ แอปอื่น และข้อมูลนำเข้าที่ต่างกันยังต้องมีพื้นที่ เวลาไม่รวมดาวน์โหลดและโหลดโมเดล และทำนายประสิทธิภาพ CPU ไม่ได้
โหมด fast จำกัดภาพที่ 0.26 MP และออกที่เลเยอร์ 16 จาก 24 สำหรับ 0.8B มัธยฐาน p50 ลดเหลือ 44.6 ms และ p95 ของโปรไฟล์ที่แย่ที่สุดเหลือ 123.2 ms ความแม่นยำ DEV ภายในลดจาก 86.0% ใน accurate เป็น 82.0% โดยกระทบข้อมูลเอกสาร แผนภูมิ และหน้าจอเป็นพิเศษ ไม่มี Decision Index สาธารณะของโหมด fast คะแนน 53.02 เป็นของโหมด accurate
ใช้สภาพแวดล้อม Python 3.12 แยกสำหรับเช็กพอยต์เหล่านี้ แพ็กเกจเก่า qev==0.2.1 โหลดรุ่น 0.8B ไม่ได้:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
ส่ง DecisionRequest ผ่าน model.predict(request) ตามตัวอย่างก่อนหน้า เริ่มจากโหมด accurate ของ 0.8B แล้วลอง fast หากทรัพยากรยังตึง ค่อยย้ายไป 2B เมื่อข้อผิดพลาดบนข้อมูลตัวแทนคุ้มกับหน่วยความจำและเวลาที่เพิ่ม โดยคงข้อมูลและคำอธิบายตัวเลือกเดิมเพื่อเปรียบเทียบ
ควรลองที่ไหน และหลักฐานสิ้นสุดตรงไหน
การทดลองแรกที่ดีมีหลักฐานมองเห็นได้และผลกระทบจำกัด เช่น ส่งภาพเอกสารเข้าคิวตรวจ จัดหมวดภาพสิ่งของ หรือเลือกคำอธิบายวิธีจัดการที่กำหนดว่าตัวใดเข้ากับข้อมูลที่สุด เก็บเส้นทางให้มนุษย์ตรวจไว้ขณะวัดว่าโมเดลช่วยได้หรือไม่
เลือกชุดตัวแทนเล็กก่อนปรับพรอมป์ต์ บันทึกความแม่นยำของคำตอบที่รับ อัตรางดตอบ และข้อผิดพลาดที่ยังหลุดผ่าน ทำซ้ำในแสง คุณภาพภาพ และภาษาต่างกัน QEV รับความสามารถข้อมูลหลายภาษาจาก backbone แต่หลักฐานความแม่นยำและการสอบเทียบที่เผยแพร่เน้นอังกฤษ ความเท่าเทียมในเกาหลีหรือภาษาอื่นควรทดสอบแทนสมมติ โมเดลการ์ดสาธารณะ
การประเมินโมเดล SDK เก่ายังวางขีดจำกัดรอบความหวังด้วย ในการเปรียบเทียบ typed decision 2,000 ข้อ QEV ได้ 77.00% และ LAYA ผู้เชี่ยวชาญข้อความได้ 76.95% ต่างเพียงหนึ่งคำถาม โดยช่วงความเชื่อมั่นแบบจับคู่คร่อมศูนย์ นี่ไม่ใช่หลักฐานความได้เปรียบความแม่นยำทั่วไป และไม่ใช่การเทียบตรงกับ Jev แบบโฮสต์ ผลเก่านี้แยกจากการเปรียบเทียบเช็กพอยต์เดือนตุลาคมด้านบน ความเชี่ยวชาญข้อความล้วนยังอาจเร็วกว่าในเงื่อนไขของมันเอง วิธีและผลเปรียบเทียบ
การให้เหตุผลจากภาพยังไม่สม่ำเสมอ การประเมิน 2048 เชิงสำรวจของโครงการรายงานว่าไม่มีเกมสำเร็จจาก 72 ครั้ง โมเดลกะทัดรัดที่ระบุวัสดุในภาพได้ไม่ได้เป็นผู้วางแผนเชิงพื้นที่ที่เชื่อถือได้โดยอัตโนมัติ บันทึกการประเมิน
QEV น่าสำรวจเมื่อการทำงานในเครื่อง backbone ระดับเล็ก และผลตัดสินใจที่ชัดเจนสำคัญพร้อมกัน เส้นทางภาพทดลองของ Jev และโครงการอื่นบน Qwen ทำให้เห็นทิศทางกว้างขึ้น: แอปจำนวนมากขึ้นขอคำตัดสินเกี่ยวกับภาพในขอบเขตที่กำหนดจากโมเดล แล้วใช้ซอฟต์แวร์ปกติตัดสินว่าจะทำอะไรกับคำตัดสินนั้น
แหล่งข้อมูล
ตรวจแหล่งข้อมูลวันที่ 20 ตุลาคม 2026 สถาปัตยกรรม ตัวอย่าง และขอบเขตรุ่นด้านบนอ้างจาก ซอร์สสาธารณะ QEV ที่ตรึง revision และ SDK 0.2.1 บริบทกว้างมาจาก ประกาศ Jev ของ TypeSafe, งานวิจัย PixelJev และ โมเดลการ์ด AutoTrust ภาพหลักเป็นภาพจับหน้าจอเพื่อประกอบบทความจาก README สาธารณะ QEV โดยบันทึก ที่มาและสิทธิ์สื่อ แยกไว้
เก็บหลักฐานต้นฉบับไว้ควบคู่การตัดสินใจ เพื่อย้อนทบทวนการจัดประเภทที่ผิดหรือนโยบายที่เปลี่ยนได้ สร้างบัญชี Telli.sh เพื่อรวบรวมแหล่งข้อมูล บันทึก และการค้นคว้าต่อในพื้นที่เดียวที่ค้นหาได้