[Buku Nota Idea AI 04] Daripada keputusan gaya Jev kepada imej: kenali QEV, model kecil berasaskan Qwen
Mengapa model keputusan visual berasaskan Qwen mula muncul, perubahan melalui sokongan imej eksperimen Jev, dan peranan projek QEV kelas 2B yang berjalan secara setempat.
Buku Nota Idea AI meneroka idea dan kemungkinan penggunaan praktikal di sebalik model serta alat AI yang baru muncul.
Sekeping foto tiba dalam aliran kerja pengasingan. Aplikasi perlu memilih antara plastik, kaca dan logam, memeriksa sama ada objek itu termasuk dalam kategori yang diberikan, lalu memulangkan nilai yang boleh digunakan oleh perisian. Perenggan yang lancar menerangkan botol itu mungkin menarik, tetapi masih meninggalkan satu langkah lagi antara model dengan keputusan.
Jev menarik perhatian kepada antara muka yang berbeza: berikan situasi, soalan dan jawapan yang dibenarkan kepada model, kemudian terima keputusan berstruktur bersama kebarangkalian. Soalan seterusnya timbul dengan sendirinya: bolehkah antara muka ini digunakan pada apa yang dilihat model, selain apa yang dibacanya?
Kini hal itu boleh dilakukan dalam beberapa bentuk. TypeSafe memperkenalkan sokongan imej eksperimen untuk Jev pada 14 Oktober 2026. Projek bebas turut menyesuaikan model asas bahasa-penglihatan Qwen kepada keputusan gaya Jev. Antaranya ialah QEV, model setempat berasaskan Qwen3.5-2B yang menyediakan pilihan, skor bertertib, keputusan Boolean dan penangguhan keputusan. Pengumuman Jev, repositori QEV
Pendedahan penulis: QEV ialah projek yang diselenggarakan secara bebas oleh penulis artikel ini. Pengenalan ini membezakan keluaran yang diterbitkan daripada ciri yang tersedia hanya dalam kod sumber, serta menggunakan dokumentasi awam dan contoh yang direkodkan; artikel ini tidak mengemukakan penilaian model bebas yang baharu.
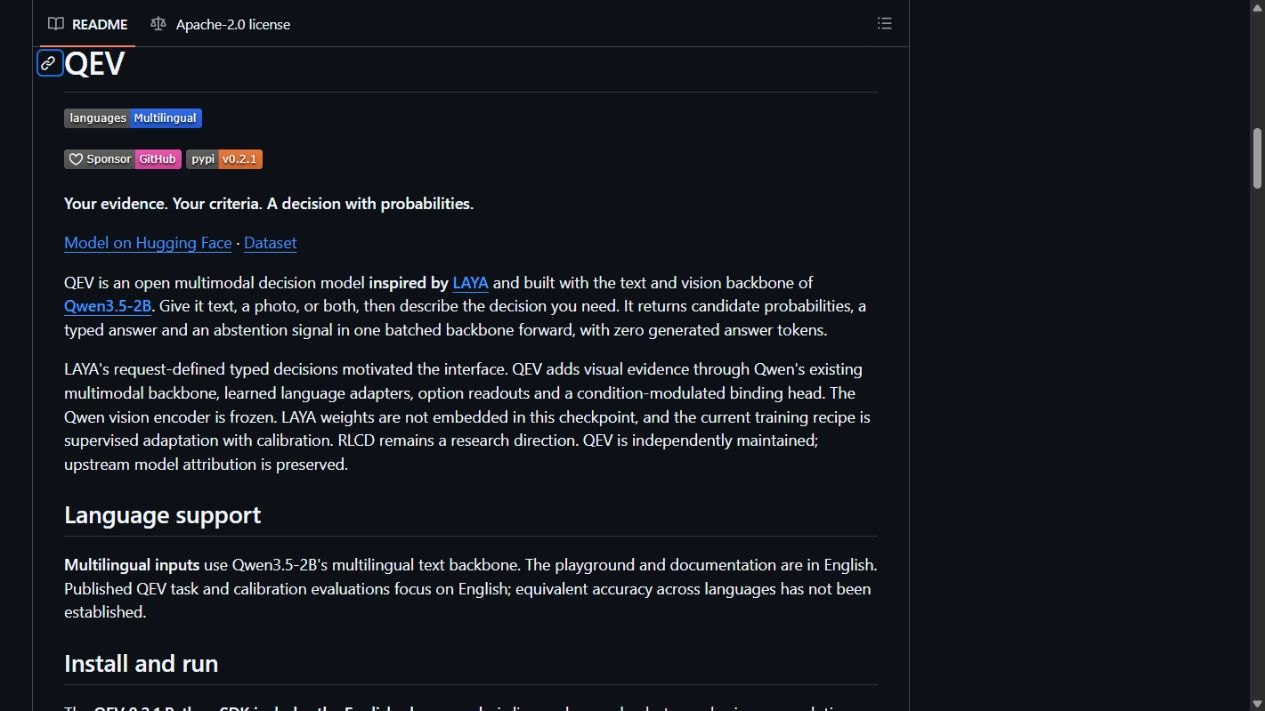 Repositori awam QEV, dirakam pada 20 Oktober 2026. Ini ialah paparan dokumentasi, bukan demonstrasi inferens setempat.
Mengapa model keputusan terasa berbeza daripada chatbot
Chatbot biasanya menulis jawapan token demi token. Model keputusan berguna apabila aplikasi sudah mengetahui bentuk jawapan yang diperlukan: memilih destinasi, menilai keadaan pada skala bertertib atau menentukan sama ada sesuatu pernyataan benar.
Pilihan jawapan boleh berubah pada setiap permintaan. Sistem sokongan mungkin menawarkan urusan bil dan sokongan teknikal hari ini, kemudian menambah pemulihan akaun esok. Aliran pengasingan visual mungkin memberikan enam penerangan bahan untuk satu soalan dan set peraturan pengendalian yang lain untuk soalan berikutnya. Model perlu menghubungkan bukti semasa dengan penerangan tersebut, bukan memilih daripada satu senarai label kekal yang dilatih terlebih dahulu.
Jenis asas Jev yang biasa digunakan ialah choice, score dan noul. Dalam QEV, choice memulangkan taburan kebarangkalian bagi calon yang diberikan. Score menggunakan tahap bertertib yang dibekalkan dan memulangkan kebarangkaliannya berserta tahap jangkaan. Soalan noul menggunakan kriteria benar dan palsu. Ketiga-tiganya merupakan kontrak output yang berbeza walaupun berkongsi model asas yang sama. Rujukan API QEV
Kebarangkalian menampakkan sempadan keputusan: kelebihan tipis antara dua calon boleh mencetuskan semakan dan bukannya tindakan automatik. Namun, kebarangkalian tidak menjadikan keputusan itu semestinya betul. Aplikasi masih memerlukan dasar untuk ketidakpastian, input yang tidak sesuai dan kos kesilapan.
Jev sudah mempunyai laluan imej eksperimen
Latar motivasi asal perlu dikemas kini. Memperkenalkan QEV dengan mengatakan bahawa Jev kini tidak boleh menerima imej akan mengelirukan. Pengumuman TypeSafe pada Oktober membolehkan input imej eksperimen untuk Jev 1.13 dan 1.14 melalui pengepala TypeSafe-Danger-Zone-Images. Jev 1.14 turut menambah jenis spatial Box. Pengumuman itu menerangkan ciri imej ini sebagai eksperimen. Pengumuman Jev 1.14
Hal ini mengubah asas perbandingan. Soalan yang berguna ialah kaedah pelaksanaan, kontrak input dan tingkah laku keputusan yang sesuai untuk aliran kerja tertentu. Eksperimen Jev yang dihoskan, model penyelidikan dan penyesuaian Qwen setempat boleh berkongsi idea keputusan terbatas sambil mempunyai pembungkusan dan operasi yang sangat berbeza.
QEV tidak mendokumentasikan padanan bagi jenis Box Jev. Ia merupakan pelaksanaan bebas, bukannya wajaran TypeSafe atau keluaran rasmi Jev. Berkongsi nama jenis asas atau titik akhir bergaya SystemOne hanyalah titik permulaan integrasi, bukan bukti bahawa setiap permintaan boleh dipindahkan tanpa perubahan antara produk.
Mengapa Qwen muncul dalam projek ini
Model asas bahasa-penglihatan sudah menyatukan maklumat teks dan imej dalam model yang sama. Ini memberikan titik permulaan praktikal kepada projek keputusan: kekalkan pemahaman visual, kemudian sesuaikan cara model menghubungkan bukti dengan jawapan yang diberikan oleh aplikasi.
Dua contoh awam menunjukkan bahawa arah ini melangkaui satu repositori:
| Projek | Pendekatan yang diterangkan secara awam | Cara memahami statusnya |
|---|---|---|
| PixelJev | Mengkaji pilihan visual gaya Jev dengan model asas kecil Qwen3.5, termasuk varian 2B dan 4B | Makalah penyelidikan tentang pilihan visual; bukan bukti pengganti Jev dihoskan yang lengkap |
| AutoTrust JEV-27B-VL | Menggunakan Qwen3.8-27B bersama kepala keputusan dan penyesuai | Model bebas yang lebih besar; kad model membezakan keputusan yang dilatih dengan teks daripada penggunaan imej secara zero-shot |
| QEV | Menyesuaikan Qwen3.5-2B kepada keputusan choice, score dan noul | Projek setempat kelas 2B dengan SDK yang diterbitkan dan peluasan sumber yang didokumentasikan berasingan |
Makalah PixelJev berguna untuk memahami idea seni binanya: hubungkan imej dan calon pada masa permintaan kepada lapisan output keputusan. Kad model AutoTrust pula menunjukkan skala pelaksanaan yang lain, sambil menyatakan bahawa penentukuran visual secara sistematik belum dipastikan. Ini ialah contoh corak reka bentuk yang sedang muncul, bukan kedudukan penanda aras atau senarai produk yang serasi pada tahap yang sama. Makalah PixelJev, kad model AutoTrust
Peranan QEV dalam gambaran ini ialah pelaksanaan setempat yang padat. “Kecil” merujuk kepada kelas model asasnya berbanding model bahasa-penglihatan yang jauh lebih besar; ia tidak bermaksud keseluruhan pemasangan hanya beberapa megabait atau akan berjalan serta-merta pada apa-apa peranti.
Bagaimana QEV menukar imej menjadi keputusan
QEV menggunakan satu model asas teks dan penglihatan Qwen3.5-2B. Seni bina yang diterbitkan menambah penyesuaian pada bahagian bahasa dan lapisan output yang mengikat situasi serta soalan kepada penerangan calon yang diberikan. Model menilai calon tersebut secara langsung, bukannya menjana ayat jawapan dan meminta penghurai lain mengekstrak label. Kad model awam
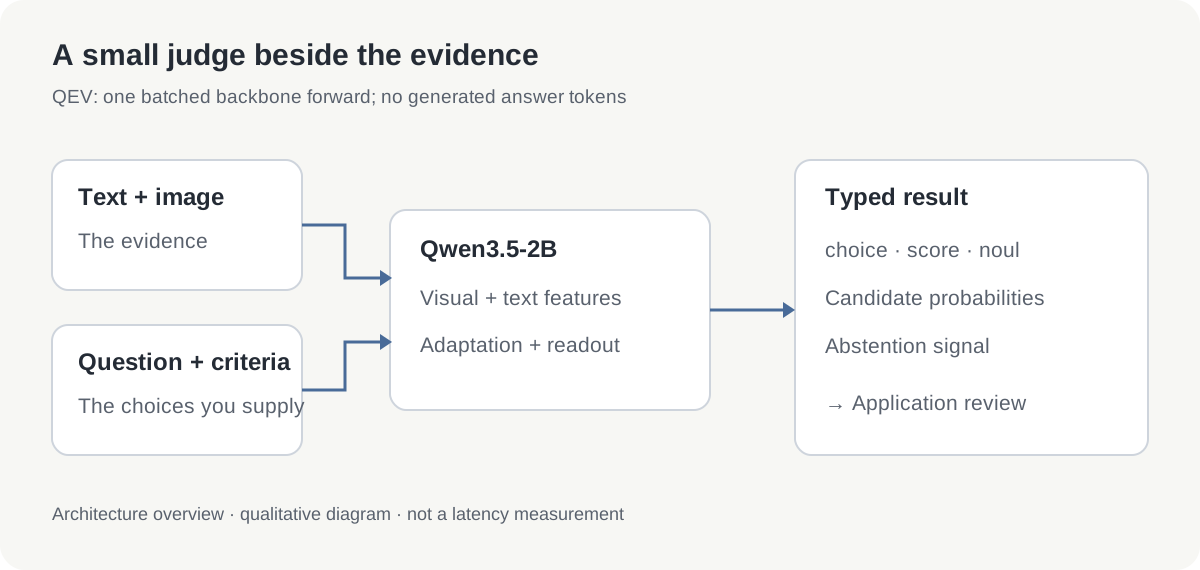 Rajah penerangan asal. Anak panah menerangkan laluan keputusan yang didokumentasikan, bukan perbandingan kelajuan yang diukur.
Dalam SDK yang diterbitkan, satu permintaan boleh mengandungi teks, satu imej atau kedua-duanya. Ia menyokong satu hingga empat soalan, dengan dua hingga enam belas calon untuk choice dan dua hingga enam belas tahap bertertib untuk score. Ini membolehkan sekumpulan kecil keputusan berkaitan diproses tanpa menjadikan setiap soalan perbualan chatbot yang berasingan. Rujukan API
Bayangkan foto dengan arahan ringkas: “Pilih bahan mengikut penerangan ini.” Soalan kedua boleh meminta jalur dasar yang berkenaan, dan soalan ketiga sama ada objek memenuhi syarat Boolean yang diberikan. Foto ialah bukti yang dikongsi; kriteria menentukan makna setiap keputusan.
Laluan inferens yang didokumentasikan menjana sifar token jawapan. Hal ini menghapuskan satu punca perubahan format, tetapi tidak menghapuskan pengekod penglihatan, pengiraan model asas, prapemprosesan imej atau kos tambahan aplikasi. “Tiada jawapan dijana” dan “tiada kos pengiraan” merupakan dakwaan yang sangat berbeza.
Baca contoh botol sebagai contoh
Repositori QEV menyertakan foto berlesen dan output direkodkan untuk sebuah botol plastik. Ini cara yang berguna untuk melihat struktur respons sebelum memasang apa-apa.
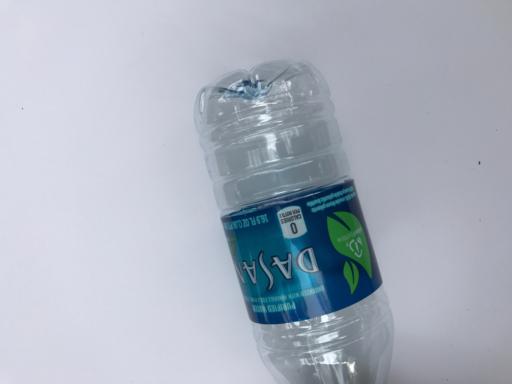 Input contoh yang diterbitkan daripada fixtur foto QEV, berasal daripada TrashNet. Hak cipta 2017 Gary Thung, lesen MIT; notis lesen dikekalkan.
| Soalan dalam fixtur yang diterbitkan | Hasil direkodkan | Maksudnya |
|---|---|---|
| Pilih antara enam bahan | Plastik, kebarangkalian kira-kira 0.9361 | Plastik menerima bahagian terbesar antara calon yang diberikan |
| Pilih jalur dasar bertertib | Tahap jangkaan kira-kira 0.4254 pada skala 0–2 | Purata berwajaran bagi indeks tiga jalur yang diberikan |
| Adakah ia termasuk dalam kaca, kertas atau plastik? | Benar, kebarangkalian kira-kira 0.7903 | Kriteria Boolean lebih disokong berbanding alternatif palsunya |
Skor ini perlu dibaca dengan teliti. Dalam fixtur ini, jalur 0 mengumpulkan kaca dan plastik, jalur 1 mengumpulkan logam dan sampah, manakala jalur 2 mengumpulkan kadbod dan kertas. Susunannya ialah dasar contoh. Nombor 0.4254 bukan penarafan keselamatan, piawaian kitar semula atau keyakinan terhadap pilihan bahan.
Begitu juga, kebarangkalian plastik menerangkan permintaan ini dan calonnya. Ia bukan bukti bahawa 93.61% daripada semua foto botol akan dikelaskan dengan betul. Ini fixtur keluaran yang pernah diperiksa, bukannya ujian baharu pada set data yang diasingkan, dan output di atas direkodkan oleh projek, bukan dihasilkan semula untuk artikel ini.
Apakah maksud “serasi Jev” di sini
Keserasian paling mudah difahami secara berlapis. Terdapat idea bersama tentang keputusan dengan calon yang ditentukan dalam permintaan, skema JSON yang tepat, input yang disokong dan tingkah laku setiap jenis output. Persamaan pada satu lapisan tidak secara automatik menyamakan lapisan yang lain.
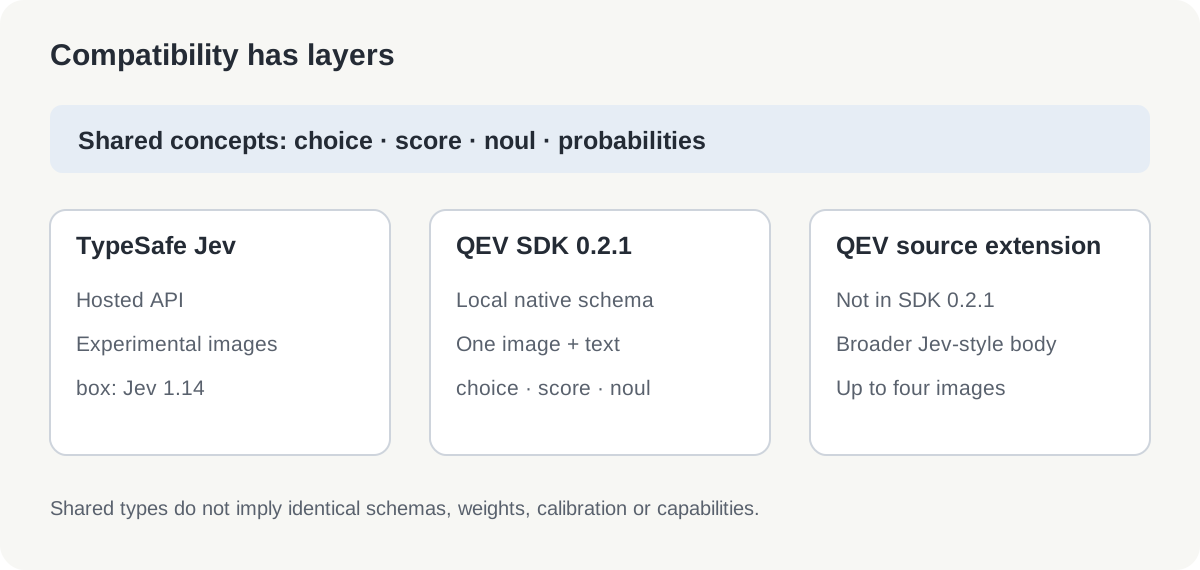 Peta keserasian asal, diperiksa pada 20 Oktober 2026. Peluasan sumber berasingan daripada kontrak SDK berbungkus.
SDK QEV 0.2.1 yang dibungkus menggunakan skema permintaan asli QEV dan satu imej pilihan. Salinan kod sumber awam turut mendokumentasikan pengendalian permintaan gaya Jev/SystemOne yang lebih luas dan sehingga empat imej bertertib. Jangan menganggap peluasan sumber tersebut sudah tersedia dalam pakej 0.2.1 yang diterbitkan. API dan nota keluaran, keluaran 0.2.1
Untuk integrasi, mulakan dengan satu permintaan yang diketahui dan bandingkan pengesahan, medan jawapan, susunan calon serta tingkah laku ketidakpastian. Laluan /v1/systemone yang biasa dilihat sahaja tidak membuktikan bahawa ia pengganti terus sejagat bagi perkhidmatan atau SDK TypeSafe.
Langkah awal yang praktikal
Untuk penerokaan pertama, playground setempat lebih mudah diperiksa berbanding integrasi aplikasi.
- Sediakan persekitaran Python 3.12 dan aktifkannya.
- Pasang versi keluaran yang ditetapkan dan mulakan playground dengan arahan di bawah.
- Buka
http://127.0.0.1:7860, pilih contoh dan periksa kebarangkalian calon serta penangguhan keputusan.
python -m pip install qev==0.2.1
qev playground
Playground yang didokumentasikan berjalan secara setempat di http://127.0.0.1:7860. Ia menyertakan contoh foto dan memaparkan kebarangkalian, penangguhan serta output berstruktur. Antara muka dan dokumentasinya dalam bahasa Inggeris. Ini arahan pemasangan daripada keluaran tersebut, bukan dakwaan bahawa model dipasang atau diukur masanya untuk artikel ini. Panduan playground
Permintaan teks yang ringkas menunjukkan bentuk SDK asli:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
Mulakan dengan dua atau tiga calon yang jelas berbeza. Kemudian cuba kes yang kabur dan kes yang tidak tergolong dalam mana-mana calon. Periksa sama ada penangguhan keputusan dan dasar aplikasi anda memberikan hasil yang berguna. Untuk ujian imej, gunakan foto yang anda berhak proses dan tulis kriteria berasaskan bukti yang kelihatan, bukan fakta yang tidak boleh ditentukan melalui imej.
Ambil kira model asas, bukan penyesuai sahaja
Untuk laluan SDK 0.2.1 yang lebih lama di atas, titik semak penyesuaian QEV bersaiz kira-kira 32.01 MB, bersama muat turun model asas Qwen berasingan kira-kira 4.55 GB. Pecahan yang diterbitkan menyenaraikan sekitar 2.213 bilion parameter model asas dan 7.992 juta parameter penyesuaian/lapisan output. Titik semak QEV-0.8B dan QEV-2B keluaran Oktober di bawah menggunakan laluan pemuatan keluaran yang berasingan. Pecahan saiz model SDK
Oleh itu, persediaan awal melibatkan beberapa gigabait. Penggunaan seterusnya boleh bergantung pada fail model dalam cache, tetapi memori masa jalan turut meliputi pengaktifan, pemprosesan imej dan penimbal. Laluan GPU dan CPU yang didokumentasikan menggunakan ketepatan angka yang berbeza. Kiraan bait titik semak berguna untuk merancang storan, bukan janji tentang memori, daya pemprosesan atau penggunaan bateri pada mesin tertentu.
Jika 2B membebankan komputer, cuba QEV-0.8B
Keluaran Oktober merangkumi QEV-0.8B, berasaskan Qwen3.5-0.8B dan disuling daripada model guru yang sama dengan QEV-2B yang lebih baharu. Ia titik permulaan praktikal apabila memori GPU atau masa respons menjadikan 2B sukar digunakan. Model yang lebih kecil mengekalkan keputusan yang ditakrifkan dalam permintaan sambil menukar sebahagian mutu keputusan visual dengan penggunaan sumber yang lebih rendah. Kad model 0.8B, kad model 2B
| Ukuran yang diterbitkan | QEV-0.8B | QEV-2B keluaran Oktober | Perbezaan |
|---|---|---|---|
| Decision Index visual awam, mod accurate | 53.02 | 61.99 | 2B mendahului sebanyak 8.97 mata indeks |
| Peruntukan GPU puncak, mod accurate | 1.86 GiB | 4.44 GiB | 0.8B menggunakan kira-kira 58% lebih sedikit |
| Median latensi p50 mengikut profil permintaan | 66.0 ms | 135.3 ms | Kira-kira 51% lebih rendah untuk 0.8B |
| Latensi p95 tertinggi antara profil permintaan | 377.3 ms | 738.6 ms | Kira-kira 49% lebih rendah untuk 0.8B |
| Peruntukan GPU puncak, mod fast | 1.60 GiB | 4.13 GiB | 0.8B menjimatkan 2.53 GiB |
| Skor RealWorldQA | 39.2 | 56.2 | 2B mendahului sebanyak 17.0 mata |
| Skor Winoground | 47.5 | 65.5 | 2B mendahului sebanyak 18.0 mata |
| Skor InfographicVQA | 75.4 | 83.1 | 2B mendahului sebanyak 7.7 mata |
Ini ukuran pembangun yang diperiksa pada 20 Oktober 2026. Indeks dinilai sendiri menggunakan kit visual awam edisi 0.3.2, sementara menunggu pelaksanaan rasmi; ia bukan peratus ketepatan keseluruhan. Julat bootstrap berpasangan bagi perbezaan 8.97 mata ialah 7.39–10.48 mata. Penanda aras individu menunjukkan bahawa perbezaan berubah mengikut tugas.
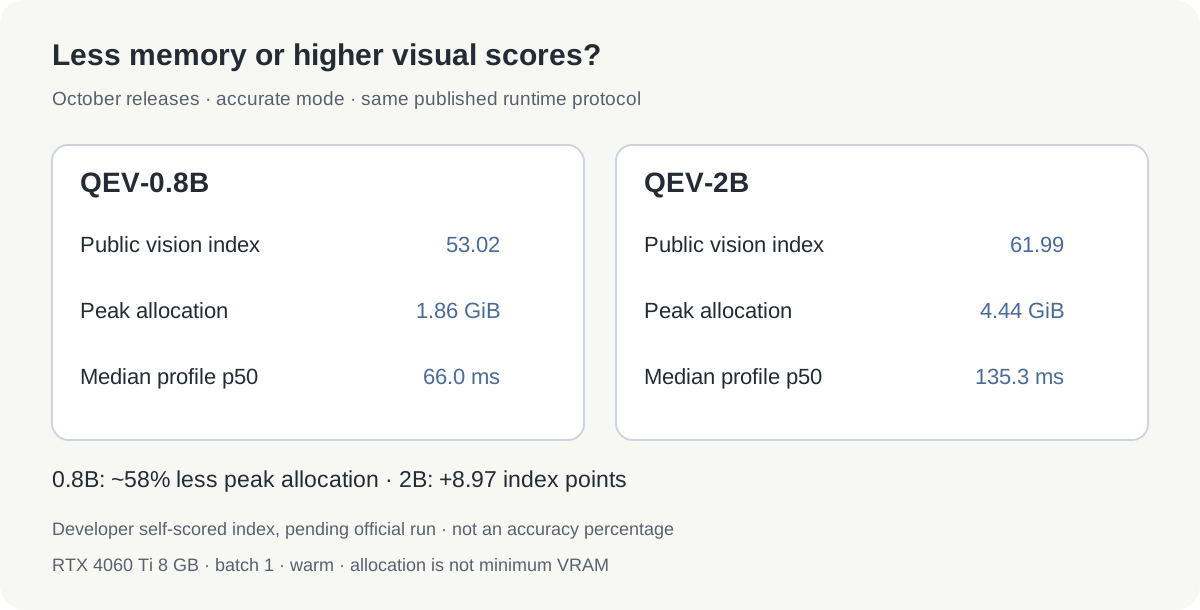 Infografik perbandingan asal berdasarkan dua kad model yang ditetapkan versinya. Nilai indeks dinilai sendiri; memori dan masa merujuk kepada mod accurate pada GPU yang diukur.
Ukuran masa jalan menggunakan RTX 4060 Ti 8 GB, kelompok 1, model yang sudah dipanaskan dan 47 profil permintaan, dengan tiga pusingan pemanasan serta 30 pusingan bermasa bagi setiap profil. Mod accurate membenarkan sehingga 1.6 MP setiap imej. Memori ialah peruntukan puncak PyTorch, bukan kapasiti minimum kad grafik: pemacu, aplikasi lain dan input berbeza masih memerlukan ruang. Masa tersebut tidak termasuk muat turun serta pemuatan model dan tidak meramalkan prestasi CPU.
Mod fast mengehadkan imej kepada 0.26 MP dan keluar pada lapisan 16 daripada 24. Bagi 0.8B, median p50 turun kepada 44.6 ms dan p95 profil paling perlahan kepada 123.2 ms. Ketepatan DEV dalaman turun daripada 86.0% dalam mod accurate kepada 82.0%, khususnya menjejaskan input dokumen, carta dan skrin. Tiada Decision Index awam dilaporkan untuk mod fast; skor 53.02 merujuk kepada mod accurate.
Gunakan persekitaran Python 3.12 berasingan untuk titik semak ini. Pakej lama qev==0.2.1 tidak boleh memuatkan keluaran 0.8B:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
Hantar DecisionRequest melalui model.predict(request), seperti contoh terdahulu. Mulakan dengan mod accurate 0.8B, kemudian cuba mod fast jika sumber masih terhad. Beralih kepada 2B apabila pengurangan kesilapan pada input yang mewakili tugas anda mewajarkan tambahan memori dan masa, sambil mengekalkan input serta penerangan calon yang sama untuk perbandingan.
Di mana hendak mencubanya, dan batas bukti yang ada
Eksperimen pertama yang baik mempunyai bukti yang kelihatan dan akibat yang terbatas: halakan imej dokumen ke barisan semakan, kategorikan foto objek atau pilih penerangan pengendalian yang paling sesuai daripada beberapa pilihan. Kekalkan laluan semakan manusia sambil mengukur sama ada model membantu.
Pilih set kecil yang mewakili penggunaan sebenar sebelum melaraskan prompt. Rekod ketepatan keputusan yang diterima, kadar penangguhan dan kesilapan yang masih terlepas. Ulangi merentasi pencahayaan, mutu imej dan bahasa. QEV mewarisi keupayaan input berbilang bahasa daripada model asasnya, tetapi bukti ketepatan serta penentukuran yang diterbitkan berfokus pada bahasa Inggeris; kesetaraan bahasa Korea atau bahasa lain perlu diuji dan bukannya diandaikan. Kad model awam
Penilaian model SDK yang lebih lama turut menetapkan batas jangkaan. Dalam perbandingan keputusan berjenis sebanyak 2,000 soalan, QEV mendapat 77.00% dan model pakar teks LAYA 76.95%—perbezaan satu soalan, dengan selang keyakinan berpasangan yang merangkumi sifar. Ini bukan bukti kelebihan ketepatan secara umum, dan bukan perbandingan langsung dengan Jev yang dihoskan. Hasil lama ini berasingan daripada perbandingan titik semak Oktober di atas. Pengkhususan teks sahaja juga boleh lebih pantas dalam persekitarannya sendiri. Kaedah dan hasil perbandingan
Penaakulan visual masih tidak sekata. Penilaian penerokaan 2048 projek ini melaporkan tiada permainan berjaya dalam 72 percubaan. Model padat yang boleh mengenal pasti bahan dalam foto tidak secara automatik menjadi perancang spatial yang boleh diharapkan. Nota penilaian
QEV wajar diteroka apabila operasi setempat, kelas model asas yang kecil dan output keputusan yang jelas diperlukan serentak. Laluan imej eksperimen Jev dan projek Qwen lain memperlihatkan arah yang lebih luas: lebih banyak aplikasi boleh meminta pertimbangan terbatas tentang imej daripada model, kemudian menentukan tindakan susulan dalam perisian biasa.
Sumber
Sumber diperiksa pada 20 Oktober 2026. Seni bina, contoh dan sempadan keluaran di atas merujuk kepada kod sumber awam QEV yang ditetapkan komitnya serta SDK 0.2.1. Konteks yang lebih luas bersumberkan pengumuman Jev TypeSafe, makalah PixelJev dan kad model AutoTrust. Imej utama ialah tangkapan editorial README awam QEV; sumber media dan hak penggunaan direkodkan berasingan.
Simpan bukti asal bersama keputusan supaya pengelasan yang tersilap atau dasar yang berubah boleh disemak semula. Cipta akaun Telli.sh untuk mengumpulkan bahan sumber, nota dan penyelidikan susulan dalam satu ruang kerja yang boleh dicari.