[Buku Catatan Ide AI 04] Dari keputusan ala Jev ke gambar: kenali QEV, model kecil berbasis Qwen
Mengapa model keputusan visual bermunculan di sekitar Qwen, perubahan dari dukungan gambar eksperimental Jev, dan posisi proyek QEV lokal kelas 2B.
Buku Catatan Ide AI menelusuri gagasan dan kemungkinan penggunaan praktis di balik model serta alat AI yang baru mulai bermunculan.
Sebuah foto masuk ke alur penyortiran. Aplikasi perlu memilih antara plastik, kaca, dan logam, memeriksa apakah benda termasuk kategori yang diberikan, lalu mengembalikan nilai yang dapat dipakai perangkat lunak. Paragraf lancar yang menggambarkan botol mungkin menarik, tetapi masih menyisakan satu tahap antara model dan keputusan.
Jev menarik perhatian pada antarmuka berbeda: berikan situasi, pertanyaan, dan jawaban yang diizinkan, lalu terima keputusan terstruktur dengan probabilitas. Pertanyaan selanjutnya wajar: dapatkah antarmuka itu bekerja dengan apa yang dilihat model, selain yang dibacanya?
Sekarang bisa dalam beberapa bentuk. TypeSafe memperkenalkan dukungan gambar eksperimental untuk Jev pada 14 Oktober 2026. Proyek independen juga mengadaptasi backbone visi-bahasa Qwen untuk keputusan ala Jev. Salah satunya QEV, model lokal berbasis Qwen3.5-2B yang menyediakan pilihan, skor berurutan, keputusan Boolean, dan abstensi. Pengumuman Jev, repositori QEV
Pengungkapan penulis: QEV adalah proyek yang dikelola secara independen oleh penulis artikel ini. Pengantar ini memisahkan rilis terbitan dari fitur yang hanya tersedia di sumber serta menggunakan dokumentasi publik dan contoh tercatat; bukan evaluasi model independen baru.
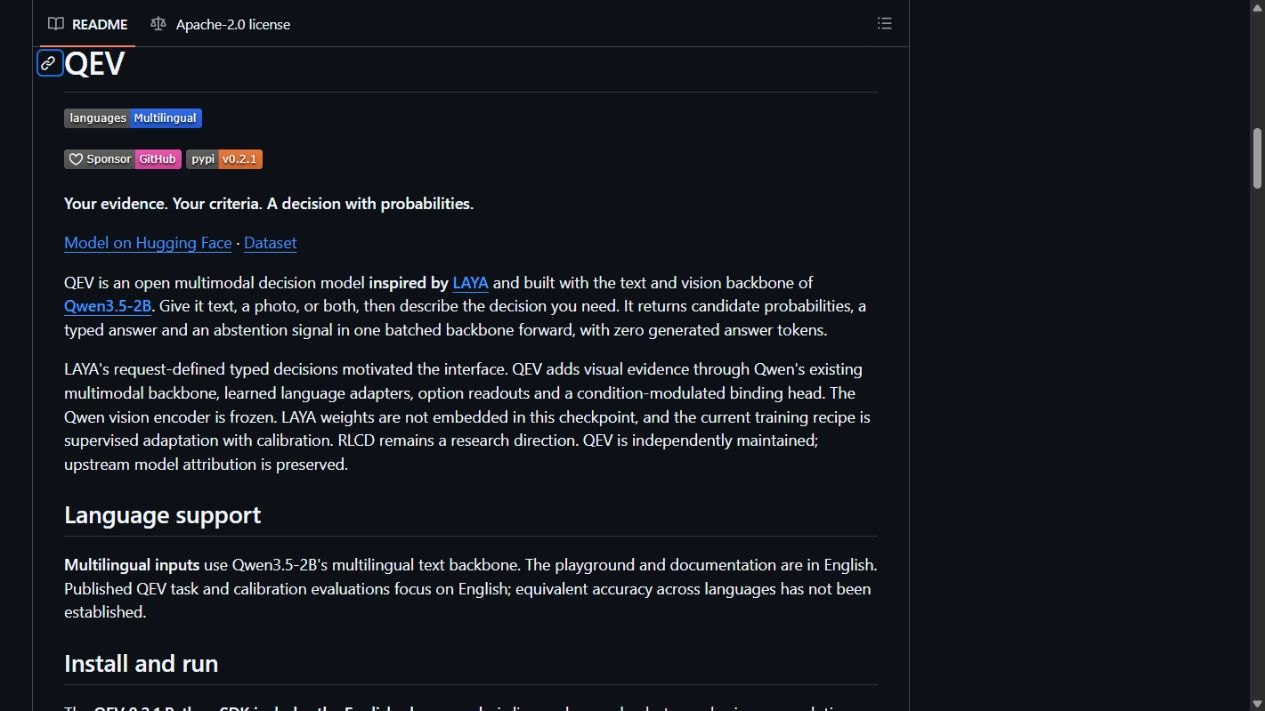 Repositori publik QEV, diambil pada 20 Oktober 2026. Ini layar dokumentasi, bukan demonstrasi inferensi lokal.
Mengapa model keputusan terasa berbeda dari chatbot
Chatbot biasanya menulis jawaban token demi token. Model keputusan berguna ketika aplikasi sudah mengetahui bentuk jawabannya: memilih tujuan, menilai kondisi pada skala berurutan, atau menentukan apakah suatu pernyataan berlaku.
Pilihan jawaban dapat berubah setiap permintaan. Sistem dukungan mungkin menawarkan penagihan dan dukungan teknis hari ini, lalu menambahkan pemulihan akun besok. Alur penyortiran visual mungkin memberikan enam deskripsi bahan untuk satu pertanyaan dan aturan penanganan berbeda untuk pertanyaan lain. Model perlu menghubungkan bukti saat ini dengan deskripsi itu, bukan memilih dari satu daftar label terlatih permanen.
Primitif Jev yang dikenal adalah choice, score, dan noul. Dalam QEV, choice mengembalikan distribusi atas kandidat yang diberikan. Score memakai tingkat berurutan yang disediakan dan mengembalikan probabilitas beserta tingkat harapannya. Pertanyaan noul menggunakan kriteria true dan false. Ini kontrak keluaran berbeda meskipun berbagi model dasar sama. Referensi API QEV
Probabilitas memperlihatkan batas: selisih tipis antara dua kandidat dapat memicu peninjauan, bukan tindakan otomatis. Probabilitas tidak menjamin keputusan benar. Aplikasi masih memerlukan kebijakan ketidakpastian, masukan tidak sesuai, dan biaya kesalahan.
Jev sudah memiliki jalur gambar eksperimental
Motivasi historisnya perlu diperbarui. Memperkenalkan QEV dengan mengatakan Jev sekarang tidak dapat menerima gambar akan menyesatkan. Pengumuman Oktober TypeSafe mengaktifkan masukan gambar eksperimental untuk Jev 1.13 dan 1.14 di balik header TypeSafe-Danger-Zone-Images. Jev 1.14 juga menambahkan primitif spasial Box. Pengumuman menyebut fitur gambar ini eksperimental. Pengumuman Jev 1.14
Itu mengubah perbandingannya. Pertanyaan berguna adalah penerapan, kontrak masukan, dan perilaku keputusan mana yang sesuai alur tertentu. Eksperimen Jev terkelola, model riset, dan adaptasi Qwen lokal dapat berbagi gagasan keputusan terbatas tetapi sangat berbeda dalam pengemasan dan operasi yang didukung.
QEV tidak memiliki padanan primitif Box Jev yang didokumentasikan. Ini implementasi independen, bukan bobot TypeSafe atau rilis resmi Jev. Kesamaan nama primitif atau endpoint ala SystemOne adalah titik awal integrasi, bukan bukti setiap permintaan dapat berpindah tanpa perubahan antarproduk.
Mengapa Qwen muncul dalam proyek-proyek ini
Backbone visi-bahasa sudah membawa informasi teks dan gambar ke model bersama. Ini memberi proyek keputusan titik awal praktis: pertahankan pemahaman visual, lalu adaptasi cara model menghubungkan bukti dengan jawaban yang disediakan aplikasi.
Dua contoh publik memperlihatkan arah yang lebih luas daripada satu repositori:
| Proyek | Pendekatan yang dijelaskan secara publik | Cara membaca statusnya |
|---|---|---|
| PixelJev | Mempelajari pilihan visual ala Jev dengan backbone Qwen3.5 kecil, termasuk varian 2B dan 4B | Makalah riset pilihan visual; bukan bukti pengganti Jev terkelola yang lengkap |
| AutoTrust JEV-27B-VL | Menggunakan Qwen3.8-27B dengan kepala keputusan dan adapter | Model independen lebih besar; kartunya membedakan perilaku keputusan terlatih teks dari penggunaan gambar zero-shot |
| QEV | Mengadaptasi Qwen3.5-2B untuk keputusan choice, score, dan noul | Proyek lokal kelas 2B dengan SDK terbitan dan ekstensi sumber yang didokumentasikan terpisah |
Makalah PixelJev berguna untuk memahami ide arsitekturnya: menghubungkan gambar dan kandidat saat runtime dengan pembaca keputusan. Kartu model AutoTrust menggambarkan skala implementasi lain, sembari mencatat kalibrasi visual sistematis belum ditetapkan. Ini contoh pola desain yang baru muncul, bukan peringkat benchmark atau daftar produk dengan kompatibilitas setara. Makalah PixelJev, kartu model AutoTrust
Posisi QEV dalam gambaran tersebut adalah penerapan lokal ringkas. “Kecil” menggambarkan kelas backbone relatif terhadap model visi-bahasa jauh lebih besar; bukan berarti seluruh instalasi hanya beberapa megabyte atau langsung berjalan di semua perangkat.
Cara QEV mengubah gambar menjadi keputusan
QEV memakai satu backbone teks dan visi Qwen3.5-2B. Arsitektur terbitannya menambahkan adaptasi sisi bahasa dan pembaca yang mengikat situasi serta pertanyaan dengan deskripsi kandidat. Model langsung menilai kandidat, bukan menghasilkan kalimat jawaban lalu meminta parser lain mengekstrak label. Kartu model publik
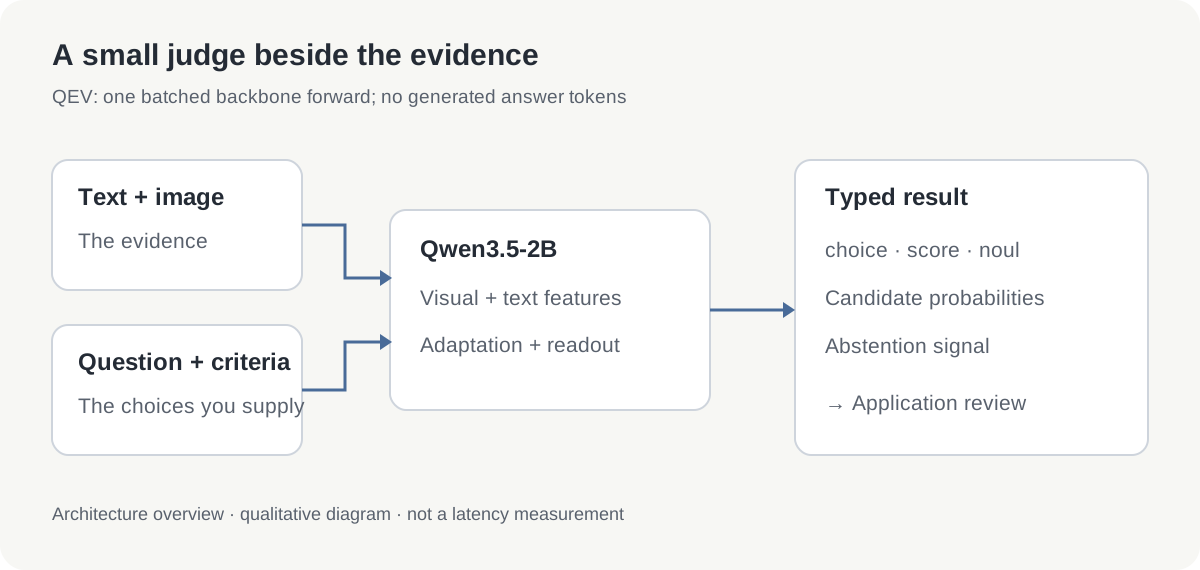 Diagram penjelasan orisinal. Panah menggambarkan jalur keputusan terdokumentasi, bukan perbandingan kecepatan terukur.
Dalam SDK terbitan, satu permintaan dapat berisi teks, satu gambar, atau keduanya. SDK mendukung satu sampai empat pertanyaan, dengan dua sampai enam belas kandidat untuk choice serta dua sampai enam belas tingkat berurutan untuk score. Ini memungkinkan sekumpulan kecil keputusan terkait tanpa mengubah setiap pertanyaan menjadi percakapan terpisah. Referensi API
Bayangkan foto dengan instruksi pendek: “Pilih bahan berdasarkan deskripsi berikut.” Pertanyaan kedua dapat menanyakan kelompok kebijakan yang berlaku, dan ketiga apakah benda sesuai kondisi Boolean yang diberikan. Foto adalah bukti bersama; kriteria menentukan arti setiap keputusan.
Jalur inferensi terdokumentasi menghasilkan nol token jawaban. Ini menghilangkan satu sumber variasi format, tetapi tidak menghapus encoder visi, komputasi backbone, prapemrosesan gambar, atau beban aplikasi. “Tidak ada jawaban yang dihasilkan” dan “tidak ada biaya komputasi” adalah klaim yang sangat berbeda.
Baca contoh botol sebagai contoh
Repositori QEV menyertakan foto berlisensi dan keluaran tercatat untuk botol plastik. Ini cara berguna melihat struktur respons sebelum memasang apa pun.
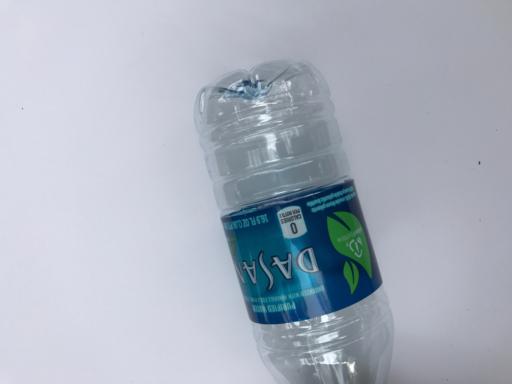 Masukan contoh terbitan dari fixture foto QEV, berasal dari TrashNet. Hak cipta 2017 Gary Thung, lisensi MIT; pemberitahuan lisensi dipertahankan.
| Pertanyaan dalam fixture terbitan | Hasil tercatat | Artinya |
|---|---|---|
| Pilih di antara enam bahan | Plastik, probabilitas sekitar 0.9361 | Plastik memperoleh bagian terbesar di antara kandidat yang diberikan |
| Pilih kelompok kebijakan berurutan | Tingkat harapan sekitar 0.4254 pada skala 0–2 | Rata-rata tertimbang dari tiga indeks kelompok yang diberikan |
| Apakah termasuk kaca, kertas, atau plastik? | True, probabilitas sekitar 0.7903 | Kriteria Boolean lebih diunggulkan daripada alternatif false |
Skor perlu diperhatikan khusus. Dalam fixture ini, kelompok 0 menggabungkan kaca dan plastik, kelompok 1 logam dan sampah, serta kelompok 2 karton dan kertas. Urutan itu kebijakan contoh. Angka 0.4254 bukan peringkat keselamatan, standar daur ulang, atau keyakinan pilihan bahan.
Demikian pula, probabilitas plastik menggambarkan permintaan ini dan kandidatnya. Itu bukan bukti bahwa 93.61% dari seluruh foto botol akan diklasifikasikan dengan benar. Ini fixture rilis yang sebelumnya diperiksa, bukan pengujian baru pada data yang disisihkan, dan keluaran di atas dicatat proyek, bukan direproduksi untuk artikel ini.
Apa arti “kompatibel dengan Jev” di sini
Kompatibilitas paling mudah dipahami dalam beberapa lapisan. Ada gagasan bersama mengenai keputusan yang didefinisikan permintaan, skema JSON persis, masukan yang didukung, dan perilaku setiap jenis keluaran. Kecocokan satu lapisan tidak otomatis mencocokkan yang lain.
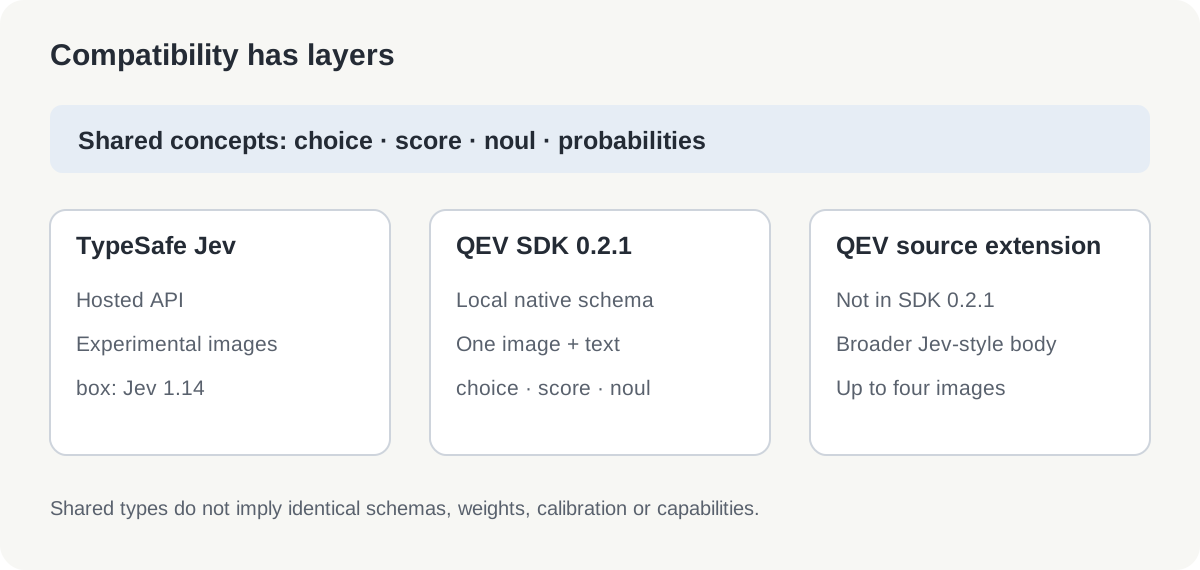 Peta kompatibilitas orisinal, diperiksa pada 20 Oktober 2026. Ekstensi sumber terpisah dari kontrak SDK dalam paket.
SDK paket QEV 0.2.1 menggunakan skema permintaan native QEV dan satu gambar opsional. Checkout sumber publik juga mendokumentasikan penanganan permintaan ala Jev/SystemOne yang lebih luas dan hingga empat gambar berurutan. Jangan menganggap ekstensi sumber itu tersedia dalam paket 0.2.1 terbitan. API dan catatan rilis, rilis 0.2.1
Untuk integrasi, mulailah dengan satu permintaan yang diketahui dan bandingkan validasi, kolom jawaban, urutan kandidat, serta perilaku ketidakpastian. Rute /v1/systemone yang familier saja tidak membuktikan pengganti langsung universal bagi layanan atau SDK TypeSafe.
Pandangan awal yang praktis
Untuk eksplorasi pertama, playground lokal lebih mudah diperiksa daripada integrasi aplikasi.
- Siapkan lingkungan Python 3.12 dan aktifkan.
- Pasang rilis yang dipatok dan mulai playground dengan perintah di bawah.
- Buka
http://127.0.0.1:7860, pilih contoh, lalu periksa probabilitas kandidat dan abstensinya.
python -m pip install qev==0.2.1
qev playground
Playground terdokumentasi berjalan lokal di http://127.0.0.1:7860. Tersedia foto contoh dan tampilan probabilitas, abstensi, serta keluaran terstruktur. Antarmuka dan dokumentasinya berbahasa Inggris. Ini petunjuk instalasi rilis, bukan klaim model dipasang atau diukur waktunya untuk artikel ini. Panduan playground
Permintaan teks kecil menunjukkan bentuk SDK native:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
Mulai dengan dua atau tiga kandidat yang jelas berbeda. Lalu coba kasus ambigu dan kasus yang tidak termasuk satu pun. Periksa apakah abstensi serta kebijakan aplikasi memberikan hasil berguna. Untuk pengujian gambar, gunakan foto yang berhak Anda proses dan tulis kriteria berdasarkan bukti terlihat, bukan fakta yang tidak dapat dipastikan gambar.
Anggarkan backbone, bukan hanya adapter
Untuk jalur SDK 0.2.1 lama di atas, checkpoint adaptasi QEV sekitar 32.01 MB, dengan unduhan backbone Qwen terpisah sekitar 4.55 GB. Rincian terbitan mencantumkan sekitar 2.213 miliar parameter backbone dan 7.992 juta parameter adaptasi/pembaca. Checkpoint QEV-0.8B dan QEV-2B Oktober di bawah menggunakan jalur pemuatan rilis terpisah. Rincian ukuran model SDK
Karena itu, penyiapan awal melibatkan gigabyte. Pemakaian berikutnya dapat mengandalkan berkas cache, tetapi memori runtime juga mencakup aktivasi, pemrosesan gambar, dan buffer. Jalur GPU dan CPU terdokumentasi memakai presisi numerik berbeda. Jumlah byte checkpoint berguna untuk perencanaan penyimpanan, bukan janji tentang memori, throughput, atau baterai pada mesin tertentu.
Jika 2B memberatkan komputer Anda, coba QEV-0.8B
Rilis Oktober mencakup QEV-0.8B, dibangun pada Qwen3.5-0.8B dan didistilasi dari guru yang sama dengan QEV-2B terbaru. Ini titik awal praktis ketika memori GPU atau waktu respons membuat 2B kurang nyaman. Model lebih kecil mempertahankan keputusan yang didefinisikan permintaan sambil menukar sebagian kualitas keputusan visual dengan penggunaan sumber daya lebih rendah. Kartu model 0.8B, kartu model 2B
| Ukuran yang dipublikasikan | QEV-0.8B | QEV-2B Oktober | Selisih |
|---|---|---|---|
| Decision Index visi publik, mode accurate | 53.02 | 61.99 | 2B unggul 8.97 poin indeks |
| Alokasi GPU puncak, mode accurate | 1.86 GiB | 4.44 GiB | 0.8B memakai sekitar 58% lebih sedikit |
| Median latensi p50 profil permintaan | 66.0 ms | 135.3 ms | Sekitar 51% lebih rendah untuk 0.8B |
| Latensi p95 tertinggi profil permintaan | 377.3 ms | 738.6 ms | Sekitar 49% lebih rendah untuk 0.8B |
| Alokasi GPU puncak, mode fast | 1.60 GiB | 4.13 GiB | 0.8B menghemat 2.53 GiB |
| Skor RealWorldQA | 39.2 | 56.2 | 2B unggul 17.0 poin |
| Skor Winoground | 47.5 | 65.5 | 2B unggul 18.0 poin |
| Skor InfographicVQA | 75.4 | 83.1 | 2B unggul 7.7 poin |
Ini pengukuran pengembang yang diperiksa pada 20 Oktober 2026. Indeks dinilai sendiri memakai public vision kit edisi 0.3.2, sambil menunggu eksekusi resmi; bukan persentase akurasi keseluruhan. Interval bootstrap berpasangan untuk selisih 8.97 poin adalah 7.39–10.48 poin. Benchmark individual menunjukkan variasi selisih menurut tugas.
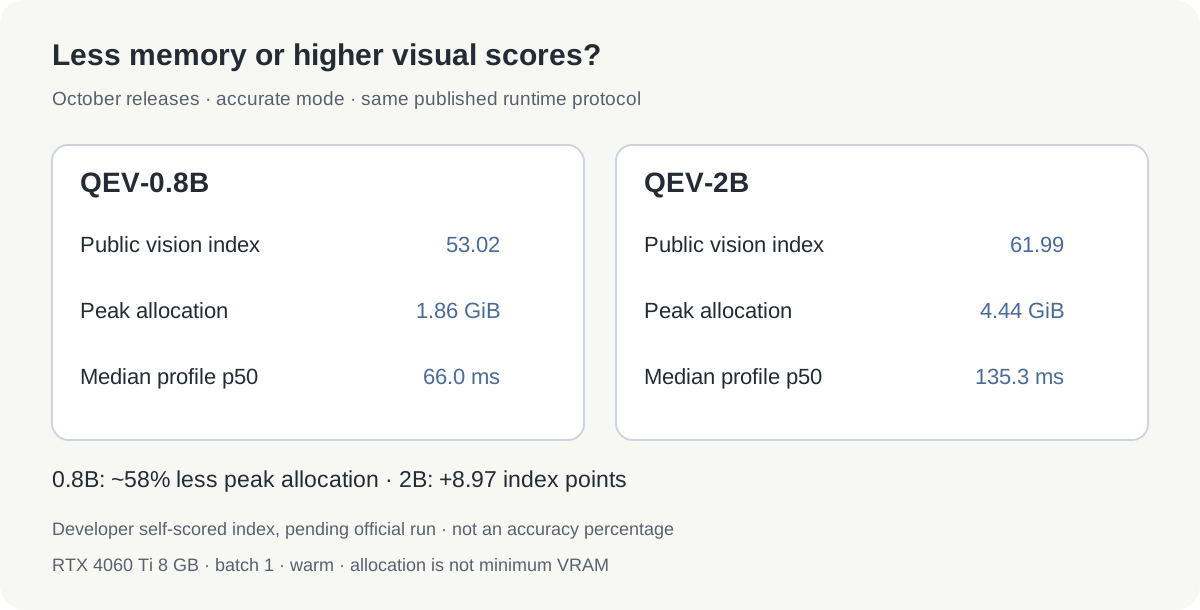 Infografik perbandingan orisinal berdasarkan dua kartu model dengan revisi dipatok. Nilai indeks dinilai sendiri; memori dan waktu merujuk mode accurate pada GPU pengukuran.
Pengukuran runtime menggunakan RTX 4060 Ti 8 GB, batch 1, model yang sudah dipanaskan, dan 47 profil permintaan, dengan tiga pemanasan serta 30 eksekusi terukur per profil. Mode accurate mengizinkan hingga 1.6 MP per gambar. Memori adalah alokasi puncak PyTorch, bukan kapasitas minimum kartu grafis: driver, aplikasi lain, dan masukan berbeda masih memerlukan ruang. Waktu tidak mencakup unduhan dan pemuatan model, serta tidak memprediksi kinerja CPU.
Mode fast membatasi gambar pada 0.26 MP dan keluar pada lapisan 16 dari 24. Untuk 0.8B, median p50 turun menjadi 44.6 ms dan p95 profil terburuk menjadi 123.2 ms. Akurasi DEV internal turun dari 86.0% pada mode accurate menjadi 82.0%, terutama memengaruhi masukan dokumen, bagan, dan layar. Tidak ada Decision Index publik untuk mode fast; skor 53.02 milik mode accurate.
Gunakan lingkungan Python 3.12 terpisah untuk checkpoint ini. Paket lama qev==0.2.1 tidak memuat rilis 0.8B:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
Kirim DecisionRequest melalui model.predict(request), seperti contoh sebelumnya. Mulailah dengan mode accurate 0.8B, lalu coba fast jika sumber daya masih terbatas. Beralih ke 2B ketika kesalahan pada masukan representatif membenarkan tambahan memori dan waktu, dengan masukan serta deskripsi kandidat sama untuk perbandingan.
Tempat mencobanya dan batas bukti yang tersedia
Eksperimen pertama yang baik memiliki bukti terlihat dan konsekuensi terbatas: arahkan gambar dokumen ke antrean peninjauan, kategorikan foto benda, atau pilih deskripsi penanganan yang paling cocok di antara pilihan yang diberikan. Pertahankan jalur tinjauan manusia sambil mengukur apakah model membantu.
Pilih set representatif kecil sebelum menyesuaikan prompt. Catat akurasi jawaban yang diterima, tingkat abstensi, dan kesalahan yang tetap lolos. Ulangi pada pencahayaan, kualitas gambar, dan bahasa berbeda. QEV mewarisi kemampuan masukan multibahasa dari backbone, tetapi bukti akurasi serta kalibrasi terbitannya berfokus pada bahasa Inggris; kesetaraan bahasa Korea atau lainnya perlu diuji, bukan diasumsikan. Kartu model publik
Evaluasi model SDK lama juga membatasi harapan. Dalam perbandingan typed decision 2,000 pertanyaan, QEV meraih 77.00% dan spesialis teks LAYA 76.95%—selisih satu pertanyaan, dengan interval keyakinan berpasangan melintasi nol. Itu bukan bukti keunggulan akurasi umum, dan bukan perbandingan langsung dengan Jev terkelola. Hasil lama ini terpisah dari perbandingan checkpoint Oktober di atas. Spesialisasi teks saja juga dapat lebih cepat dalam pengaturannya sendiri. Metodologi dan hasil perbandingan
Penalaran visual masih belum merata. Evaluasi eksploratif 2048 proyek ini melaporkan tidak ada permainan berhasil dalam 72 percobaan. Model ringkas yang mengidentifikasi bahan dalam foto tidak otomatis menjadi perencana spasial andal. Catatan evaluasi
QEV layak dijelajahi ketika operasi lokal, kelas backbone kecil, dan keluaran keputusan eksplisit sama-sama penting. Jalur gambar eksperimental Jev dan proyek berbasis Qwen lain memperjelas arah lebih luas: semakin banyak aplikasi dapat meminta penilaian terbatas atas gambar kepada model, lalu menentukan tindakan atas penilaian itu dalam perangkat lunak biasa.
Sumber
Sumber diperiksa pada 20 Oktober 2026. Arsitektur, contoh, dan batas rilis di atas merujuk sumber publik QEV yang dipatok serta SDK 0.2.1. Konteks lebih luas berasal dari pengumuman Jev TypeSafe, makalah PixelJev, dan kartu model AutoTrust. Gambar utama adalah tangkapan editorial README publik QEV; sumber dan hak media dicatat terpisah.
Simpan bukti asli bersama keputusan agar klasifikasi keliru atau kebijakan berubah dapat ditinjau kembali. Buat akun Telli.sh untuk mengumpulkan bahan sumber, catatan, dan riset lanjutan dalam satu ruang kerja yang dapat dicari.