Mengapa PFN Ingin Menumpuk Memori pada Chip AI Berikutnya
Kolaborasi PFN dan SEMIFIVE untuk MN-Core L2000 menyasar hambatan memori dalam inferensi AI. Arti peta pengembangannya bagi agen, AI privat, dan pembelian perangkat keras mendatang.
Asisten AI bisa memiliki cukup memori untuk memuat model, tetapi tetap terasa lambat setiap kali menjawab. Unit aritmetikanya siap, namun komputasi yang berguna bergantung pada tersedianya data yang tepat pada saat yang tepat. Bagi perusahaan yang melayani beberapa asisten privat, perbedaan ini dapat mengubah spesifikasi chip yang mengesankan menjadi jeda antarkata yang mengganggu.
Preferred Networks dan SEMIFIVE mempertaruhkan pengembangan mereka pada masalah itu. Pengumuman tanggal 16 November 2026 menjelaskan seri MN-Core L2000, prosesor berfokus pada inferensi yang menumpuk logika dan DRAM secara vertikal. Target yang dinyatakan adalah bandwidth memori lebih dari dua kali lipat seri L1000 sebelumnya. PFN memublikasikan pengumuman tersebut di situsnya pada 17 November. Pengumuman PFN
Pertanyaan menariknya adalah apa yang dapat diubah desain ini bagi orang yang kelak mengoperasikan layanan AI. Pemindahan data yang lebih cepat bisa sama pentingnya dengan penambahan kemampuan aritmetika, sementara pengemasan, dukungan perangkat lunak, dan server akhir menentukan apakah manfaatnya sampai ke layar pengguna. Pengumuman L2000 menyediakan cara berguna untuk memikirkan keputusan tersebut sebelum waktunya membeli.
Perusahaan di balik PLaMo juga merancang mesin yang menopangnya
Preferred Networks adalah perusahaan AI di Tokyo yang mengembangkan prosesor, infrastruktur komputasi, dan keluarga model PLaMo. Dalam kolaborasi ini, PFN bertanggung jawab atas arsitektur prosesor dan desain logika; SEMIFIVE menyediakan implementasi serta layanan rantai pasok menggunakan platform Samsung Foundry dan infrastruktur desain 3D-IC-nya. PFN dan pembagian peran pengembangan
Pembagian tugas ini penting karena akselerator yang berguna bukan sekadar set instruksi atau gambar chip. Desain logika harus menjadi silikon yang dapat diproduksi, memori harus terhubung dengannya, dan perangkat yang sudah dikemas harus bekerja secara konsisten. Pelanggan pada akhirnya membutuhkan konfigurasi server yang dapat direplikasi dan jalur perangkat lunak yang mengubah model menjadi aplikasi. Setiap perpindahan tanggung jawab dapat memengaruhi biaya dan jadwal pengiriman produk akhir.
Hubungan dengan PLaMo memberi pembaca titik masuk yang familier, tetapi tidak membuktikan bahwa seluruh penerapan PLaMo akan beralih ke perangkat keras ini. Pengembang model dan pembeli infrastruktur juga memiliki pertanyaan berbeda. Pengembang menanyakan apakah beban kerja dapat diekspresikan secara efisien; pembeli menanyakan apakah implementasi yang didukung mampu memenuhi target layanan sepanjang masa pakai instalasi.
Bagi pembaca Korea, keterlibatan SEMIFIVE adalah contoh konkret keahlian desain semikonduktor lokal yang berpartisipasi dalam infrastruktur inferensi. Pertanyaan berguna berikutnya adalah bagaimana keahlian itu diwujudkan menjadi perangkat produksi dan sistem yang mendapat dukungan. Pengumuman kolaborasi memperlihatkan peserta dan arah pengembangan; produk setelahnya akan menentukan pilihan pelanggan.
Kapasitas dan bandwidth memori menjawab pertanyaan berbeda
Kapasitas menunjukkan seberapa banyak data yang dapat disimpan sistem memori. Bandwidth menunjukkan seberapa banyak data yang dapat dipindahkan dalam interval tertentu. Model bisa muat dalam batas pertama sementara batas kedua menghambat kecepatan prosesor. Menambah kapasitas saja tidak menjamin aplikasi menjadi lebih responsif.
Perhitungan perencanaan sederhana membantu memperjelas perbedaan pertama. Model padat hipotetis dengan 30 miliar parameter yang disimpan menggunakan dua byte per parameter memerlukan sekitar 60 miliar byte hanya untuk parameternya. Perhitungan ini belum mencakup ruang kerja runtime, data perhatian dalam cache, dan overhead lain. Ini merupakan ilustrasi anggaran penyimpanan, bukan pernyataan tentang kapasitas L2000 atau model yang didukungnya.
Pertanyaan berikutnya adalah bagaimana beban kerja memakai data yang disimpannya. Memproses prompt masuk dan menghasilkan token keluaran secara berurutan memberikan tuntutan berbeda pada sistem. Penjelasan optimasi inferensi NVIDIA membedakan pekerjaan paralel saat memproses prompt dari decoding autoregresif, ketika perpindahan memori dapat menjadi pembatas. Penjelasan itu juga membahas mengapa batching dan pengelolaan cache perhatian mengubah keseimbangannya. Panduan optimasi inferensi NVIDIA, 17 November 2023
Bayangkan memori sebagai gudang bahan makanan yang terhubung ke dapur. Gudang lebih besar membantu menyimpan lebih banyak bahan di lokasi; jalur lebih lebar membantu dapur menerimanya. Keduanya tidak langsung memberi tahu berapa lama makanan tertentu selesai, karena persiapan dan tahap lainnya tetap penting. Perbandingan perangkat keras menjadi lebih berguna ketika fungsi-fungsi tersebut tetap dibedakan.
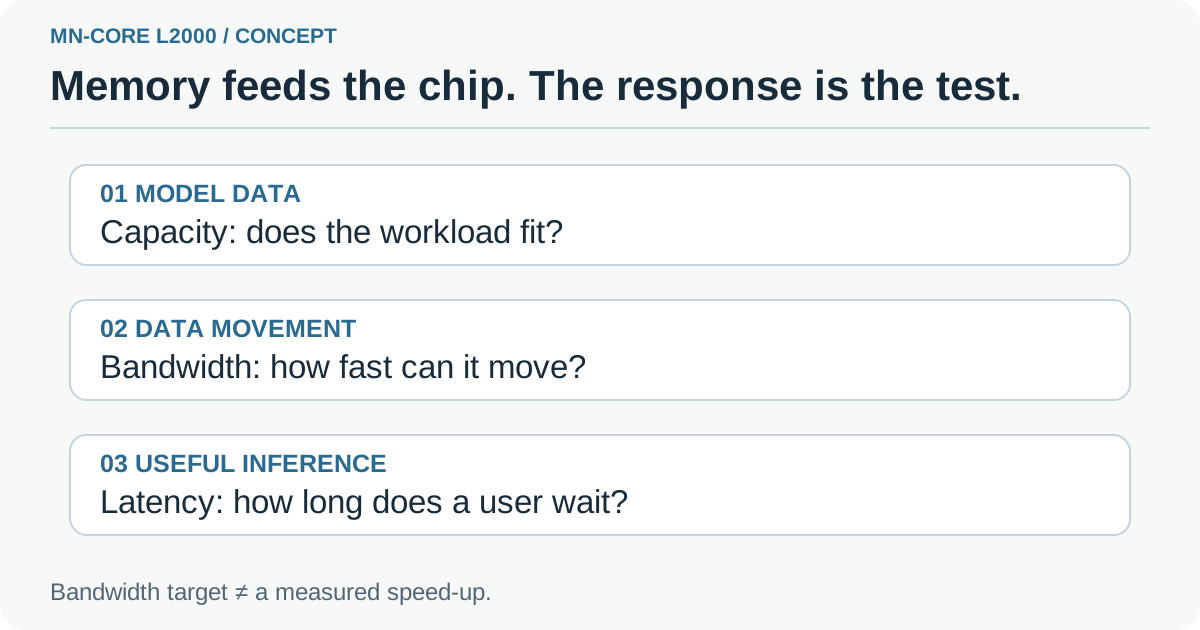
Diagram penjelasan asli yang memisahkan penyimpanan, perpindahan data, dan respons aplikasi. Gambar ini menjelaskan keputusan, bukan menggambarkan tata letak paket L2000 yang belum dipublikasikan.
Penumpukan mengubah persoalan rekayasa sekaligus jalur data
Pengumuman resmi PFN menyertakan diagram penumpukan vertikal logika dan DRAM seri MN-Core L. Diagram tersebut membantu memahami arah yang diusulkan. Namun, diagram itu tidak menunjukkan server lengkap yang akan dipasang pelanggan atau membuktikan kinerja aplikasi akhir.
Menyusun komponen dalam satu tumpukan berarti desain harus berfungsi sebagai sistem fisik. Penyaluran daya, pembuangan panas, dan konsistensi produksi perlu dibahas bersama perpindahan data. Ketiganya bukan persoalan tambahan yang diselesaikan setelah arsitektur terlihat menarik di slide. Faktor-faktor ini memengaruhi apakah perangkat dapat diproduksi, dikemas, didinginkan, dan didukung dengan biaya yang masuk akal.
Bagi operator, desain paket merupakan awal penyelidikan, bukan akhirnya. Rak memiliki batas daya, fasilitas memiliki desain pendinginan, dan layanan mempunyai harapan ketersediaan. Akselerator yang diusulkan akhirnya harus sesuai dengan ketiganya. Manfaat ekonomi bergantung pada keseluruhan instalasi, termasuk peralatan dan tenaga kerja untuk mempertahankan operasinya.
Itulah mengapa pembahasan efisiensi harus disertai kondisi pengukuran. Hasil yang baik untuk satu model, presisi, dan tingkat konkurensi tidak menjelaskan semua beban kerja. Pelanggan perlu melihat di mana sistem bekerja dengan baik, di mana ruang longgarnya habis, serta berapa banyak energi yang dipakai seluruh layanan untuk memberikan jawaban berguna.
Tiga beban kerja akan mengajukan tiga pertanyaan berbeda
Pertimbangkan asisten dokumen privat untuk tim hukum atau rekayasa. Dalam layanan ilustratif ini, permintaan datang tidak teratur dan pengguna menyadari jeda sebelum jawaban dimulai. Evaluasinya harus mencakup dokumen representatif, waktu pencarian, dan respons pertama model. Akselerator dapat memperbaiki sebagian jalur sementara pencarian dokumen atau pemeriksaan akses masih menyebabkan penundaan terbesar.
Contoh kedua adalah agen internal yang memanggil model berulang kali untuk menyelesaikan tugas. Satu proses generasi yang lambat dapat memengaruhi beberapa tahap yang bergantung padanya. Hasil yang berguna adalah waktu untuk menyelesaikan tugas dengan otorisasi yang benar, termasuk hasil alat dan persetujuan manusia yang diperlukan. Menaikkan laju token hanya membantu bagian alur yang benar-benar menunggu generasi.
Contoh ketiga adalah antrean malam yang mengklasifikasikan atau merangkum banyak catatan. Antrean ini dapat menerima batch lebih besar dan lebih mementingkan total pekerjaan selesai sebelum tenggat. Konfigurasi pilihannya mungkin berbeda dari asisten interaktif meskipun keduanya memakai model sama. Peninjauan pengadaan harus mempertahankan perbedaan ini, bukan memilih demonstrasi dengan angka judul terbesar.
Skenario tersebut adalah rencana evaluasi, bukan uji coba L2000. Skenario itu menunjukkan mengapa arsitektur berfokus memori layak diikuti tanpa mengasumsikan satu hasil kinerja. Pilot terbaik dimulai dari beban kerja yang sudah dipahami tim dan hasil yang dapat dibandingkan dengan sistem saat ini.
| Keputusan | Yang perlu disiapkan tim | Yang harus dibuktikan hasilnya |
|---|---|---|
| Asisten dokumen privat | Pertanyaan, dokumen, dan aturan akses yang representatif | Jawaban berguna tiba dalam target respons yang disepakati |
| Agen internal bertahap | Tugas lengkap, panggilan alat, dan titik persetujuan | Penyelesaian dari awal hingga akhir membaik tanpa kehilangan ketepatan |
| Antrean pemrosesan malam | Kumpulan catatan tetap dan tenggat penyelesaian | Pekerjaan yang dibutuhkan selesai andal dalam anggaran operasional |
Target bandwidth hanyalah satu masukan untuk memperkirakan layanan
Menurut kami, perbandingan paling berguna dimulai dari pekerjaan yang dibeli. Tim tidak membeli bandwidth secara terpisah; tim membeli kemampuan menyelesaikan tugas di bawah batasan. Hal itu membutuhkan rangkaian bukti dari model dan runtime hingga server dan aplikasi.
Mulailah dengan dukungan model. Arsitektur yang tepat, presisi, dan operator yang dibutuhkan harus bekerja dalam tumpukan perangkat lunak yang didukung. Kompiler atau runtime yang mampu menjalankan demonstrasi mungkin masih menyisakan pekerjaan integrasi untuk produksi. Tanyakan versi yang didukung, operasi yang harus dikonversi, dan siapa yang memelihara jalur tersebut saat model berubah.
Lalu pisahkan ukuran respons. Waktu hingga jawaban berguna pertama, kecepatan selama generasi, dan jumlah permintaan selesai menggambarkan pengalaman berbeda. Catat semuanya dengan ukuran masukan dan konkurensi sama, termasuk respons gagal atau tidak selesai. Eksekusi lebih cepat yang mengubah kualitas keluaran atau diam-diam membuang permintaan bukan hasil yang sama dengan perbaikan layanan.
Terakhir, tempatkan kembali aplikasi di sekitar model. Pencarian, moderasi, akses alat, antrean, dan lalu lintas jaringan juga memakai waktu. Pilot perangkat keras harus menunjukkan berapa banyak waktu tugas lengkap dihabiskan menunggu inferensi. Dengan begitu, tim dapat memperkirakan secara masuk akal manfaat nyata dari jalur inferensi yang lebih cepat.
Tonggak berikutnya yang terlihat adalah penyerahan desain ke manufaktur
Target tape-out yang diumumkan adalah kuartal pertama 2027: saat data desain final diserahkan untuk manufaktur. Ini merupakan tonggak pengembangan, bukan tanggal pengiriman server jadi. Peta pengembangan PFN
Manufaktur, pengemasan, pengaktifan awal, dan validasi masih harus menghubungkan desain dengan produk yang dapat digunakan. Kualifikasi perangkat lunak dan integrasi sistem selanjutnya menentukan apa yang dapat diterapkan pelanggan. Kemajuan tahap-tahap itu bisa menghasilkan berita penting sebelum penjualan umum, tetapi setiap tahap menjawab pertanyaan berbeda.
Disiplin yang sama berlaku untuk dasar perbandingan. L1000 sendiri dijadwalkan dirilis pada 2027, sehingga pengumuman ini membandingkan generasi pengembangan, bukan dua sistem yang tersedia untuk dibeli sekarang. Pengumuman tidak menerbitkan harga ritel L2000, jadwal pengiriman Korea, atau benchmark sistem final. Jadwal pembelian harus berdasarkan konfigurasi yang didukung dan ketentuan pengiriman yang kelak ditawarkan pemasok.
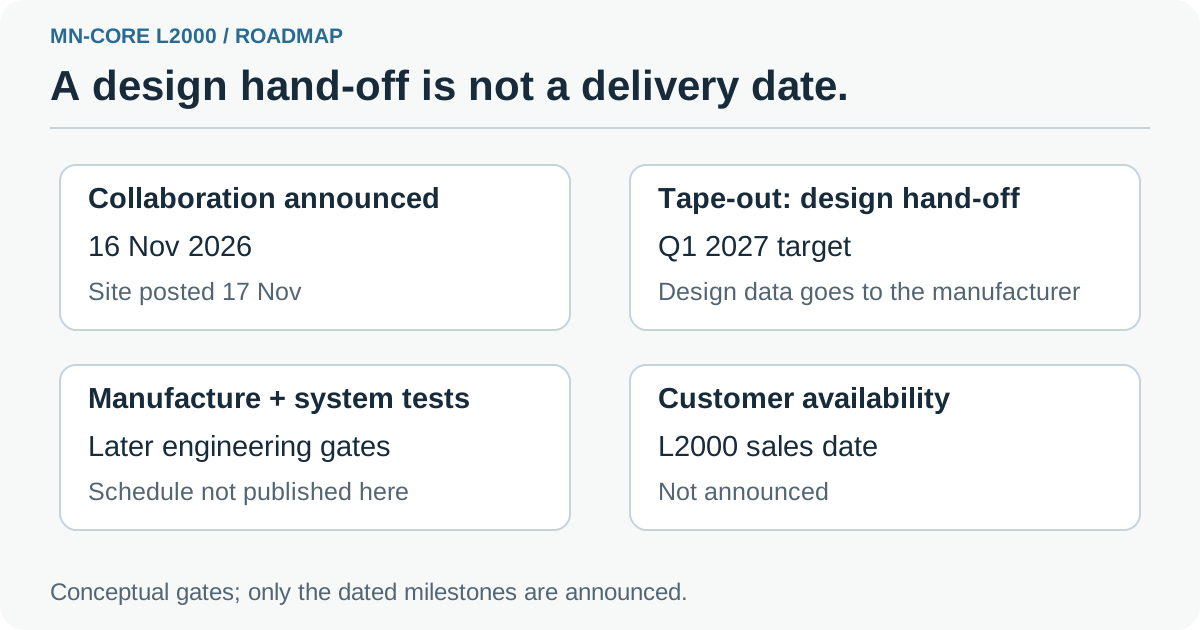
Panduan tahap pengembangan asli. Target tape-out yang diumumkan dibedakan dari manufaktur, kualifikasi, dan pengiriman pelanggan setelahnya; tanggal tahap lanjutan tersebut masih terbuka.
Apa yang perlu dimuat berkas evaluasi praktis
Tim dapat melakukan pekerjaan berguna sambil mengikuti peta pengembangan. Tim sebaiknya membuat dasar pembanding ringkas yang tetap bernilai, baik pembelian akhirnya berupa sistem MN-Core, server GPU, maupun layanan hosting. Tujuannya adalah membuat perbandingan perangkat keras berikutnya lebih murah dan bermakna.
- Pilih pekerjaan lengkap. Tentukan satu tugas interaktif dan, bila relevan, satu pekerjaan batch. Catat kriteria penyelesaian yang benar serta tenggat respons atau penyelesaian.
- Tetapkan bahan uji dan versi perangkat lunak. Simpan prompt, dokumen masukan, revisi model, presisi, dan pengaturan runtime bersama-sama. Gunakan bahan yang boleh diproses oleh tim.
- Ukur jalur saat ini. Catat waktu respons model, durasi tugas lengkap, kegagalan, dan penggunaan sumber daya di bawah beban yang diharapkan. Tandai waktu menunggu pencarian atau alat alih-alih generasi.
- Minta konfigurasi yang didukung dengan kondisi setara. Uji pemasok mendatang harus mengidentifikasi akselerator, konfigurasi memori, host, runtime, dan dukungan model. Pastikan perubahan kualitas atau presisi tetap terlihat.
- Bandingkan keputusan operasional. Sertakan pembelian, integrasi perangkat lunak, listrik, pendinginan, dukungan, dan pemulihan. Nilai apakah perbaikan menyelesaikan tugas awal dengan biaya yang dapat diterima.
Berkas ini lebih berguna daripada kumpulan tangkapan layar throughput yang tidak saling terkait. Berkas tersebut mencegah tim mengganti beban kerja setiap kali sistem baru muncul. Keuntungan nyata juga lebih mudah dikenali: pekerjaan sama, selesai dengan baik, dengan lebih sedikit penundaan atau beban operasional.
Bagi tim kecil, keputusan langsungnya mungkin tetap memakai perangkat keras saat ini sambil memperbaiki aplikasi. Jika pencarian mendominasi waktu respons, mempercepat inferensi saja berdampak terbatas. Jika layanan terus menunggu generasi di bawah beban yang diperlukan, akselerator baru menjadi kandidat uji yang lebih relevan. Kedua temuan membantu mengarahkan pengeluaran pada hambatan yang memengaruhi pengguna.
Cerita perangkat keras bergerak mendekati memori
Kolaborasi L2000 layak diikuti karena menghubungkan persoalan inferensi dengan desain fisik dan pekerjaan produksi untuk mengatasinya. Bukti berguna berikutnya adalah kemajuan manufaktur dan kualifikasi perangkat lunak, lalu pengukuran pada sistem yang didukung. Hasil itu akan menunjukkan beban kerja yang memperoleh manfaat dan investasi yang diperlukan operator untuk mendapatkannya.
Untuk sekarang, pelajaran praktisnya sudah tersedia. Pisahkan kapasitas model, perpindahan data, dan hasil aplikasi saat membandingkan perangkat keras AI. Model yang muat dalam memori adalah awal percakapan; layanan andal adalah hasil yang dibutuhkan pembeli.
Sumber
- Preferred Networks, PFN dan SEMIFIVE Berkolaborasi Mengembangkan Seri MN-Core L2000, pengumuman bertanggal 16 November 2026, dipublikasikan di situs pada 17 November 2026. Memuat diagram struktur resmi dan jadwal pengembangan.
- Preferred Networks, pengumuman berbahasa Jepang, rilis perusahaan yang bersesuaian.
- Shashank Verma dan Neal Vaidya, NVIDIA Technical Blog, Mastering LLM Techniques: Inference Optimization, 17 November 2023. Latar belakang tahap inferensi, batching, dan penggunaan memori, bukan benchmark perangkat keras MN-Core.
Simpan beban kerja, pengaturan model, dan jawaban pemasok bersama-sama agar evaluasi berikutnya dimulai dari dasar yang dapat dibandingkan. Buat catatan pertama Anda dengan Telli.sh.