AI lokal Anda kini bisa bicara: peluang nyata pembaruan Phonon di Ollama
Ollama menambahkan generasi suara lokal dengan model Phonon dari Gradium. Alur mendengarkan yang berguna, batas macOS saat ini, dan pentingnya lisensi model paling kecil.
Jawaban model bahasa lokal biasanya masih berakhir sebagai teks pada terminal atau jendela percakapan. Anda dapat terus bertanya, tetapi harus terus melihat layar. Membacakan jawaban menambahkan aplikasi lain, API lain, atau tahap tambahan.
Pengumuman Ollama pada 24 Oktober 2026 membawa generasi suara ke alur lokal tersebut. Keluarga suara pertama yang didukung adalah Phonon, buatan Gradium. Teks dapat menjadi audio melalui baris perintah atau endpoint suara kompatibel OpenAI, dan jawaban model bahasa dapat langsung diteruskan kepada model suara. Pengumuman resmi.
Bagi yang belum memakainya, Ollama adalah alat untuk mengunduh dan menjalankan model pada komputer sendiri, lalu menyediakannya melalui API lokal. Pembaruan penting karena suara menjadi kemampuan model tambahan di lingkungan itu. AI lokal mendapat cara menjawab secara lisan, dengan batas penting: dukungan suara yang diumumkan saat ini untuk macOS, dan lisensi dalam keluarga Phonon berbeda-beda.
 Identitas resmi Ollama dari repositori Ollama, lisensi MIT. Dirasterisasi secara proporsional pada latar putih. Ini gambar identitas produk, bukan tangkapan layar atau suara yang dihasilkan.

Suara yang berguna dimulai dari janji sederhana
Kemampuan langsungnya adalah teks ke suara. Anda memberikan kata dan menerima audio sintetis. Ini dapat memudahkan mendengarkan jawaban, mengubah dokumen menjadi draf dengar pribadi, atau membantu pengembang membuat prototipe antarmuka bersuara tanpa memulai dengan layanan suara terpusat.
Kemampuan ini tidak dengan sendirinya menciptakan asisten suara lengkap. Mendengarkan mikrofon, menentukan akhir ucapan, mengenali suara, menghentikan pemutaran, dan memutuskan tindakan berizin adalah bagian aplikasi yang berbeda. Suara lancar dapat membuat sistem belum selesai terasa lebih lengkap daripada kenyataannya.
Perbedaan ini berguna saat memilih hal pertama yang dibangun. Membacakan paragraf yang disetujui adalah tugas terbatas. Sistem yang mendengar permintaan, mencari materi pribadi, memilih alat, lalu membacakan hasil memiliki tanggung jawab jauh lebih besar. Phonon dapat menyediakan suara keluaran; Phonon tidak menetapkan ketepatan atau kewenangan tahap sebelumnya.
Karena itu, penggunaan awal terkuat memiliki batas teks yang jelas. Anda dapat memeriksa yang akan diucapkan, menentukan kesesuaian redaksi, lalu membuat audio. Susunan sederhana ini memudahkan penilaian apakah suara memperbaiki tugas nyata.
Peluncuran memiliki batas platform dan bahasa
Petunjuk peluncuran mensyaratkan Mac Apple Silicon dengan Ollama 0.40.11 atau lebih baru, sedangkan dukungan Windows dan Linux menyusul. Pengguna Ollama pada sistem lain tidak boleh menganggap pemasangan lamanya sudah mendukung alur suara yang diumumkan. Terlihatnya pustaka model di web berbeda dari tersedianya fitur pada setiap platform.
Entri pustaka Phonon juga membedakan pilihan model. Phonon dasar ditawarkan untuk bahasa Inggris. Keluarga 40M memiliki varian khusus Inggris, Prancis, Jerman, Spanyol, dan Portugis, beserta varian multibahasa yang mencakup kelima bahasa tersebut.
Daftar itu bukan klaim suara multibahasa universal. Bahasa Korea tidak termasuk kelima bahasa tersebut, sehingga peluncuran ini tidak menetapkan pilihan suara Korea.
Alur mendengarkan bahasa Inggris dan produk multibahasa memerlukan evaluasi berbeda. Yang pertama mungkin hanya membutuhkan suara yang membacakan catatan Inggris dengan jelas. Yang kedua harus memeriksa bahasa, nama, pelafalan, dan perilaku model tertentu saat kalimat berpindah bahasa. Label bahasa saja tidak membuktikan seluruh kasus itu berjalan baik.
Model kecil, izin berbeda
Keluarga model memiliki perbedaan lisensi yang mudah terlewat saat memilih berdasarkan ukuran. Model Phonon dasar dicantumkan dengan Apache 2.0. Varian 40M dicantumkan dengan CC BY-NC 4.0, yang membatasi penggunaan komersial. Informasi model dan lisensi.
Artinya unduhan terkecil tidak otomatis menjadi pilihan termudah bagi produk komersial. Model ringkas menarik untuk percobaan pada mesin sederhana, tetapi izin model tersebut mungkin tidak sesuai dengan layanan berbayar atau aplikasi produksi pelanggan.
| Pilihan yang diperiksa | Perbedaannya | Yang perlu dicek sebelum adopsi |
|---|---|---|
| Phonon dasar | Pilihan suara Inggris dengan pencantuman Apache 2.0 | Model persis yang diunduh, pemberitahuan, dan aset suara tambahan |
| Varian 40M khusus bahasa | Model ringkas untuk satu bahasa dalam daftar | Batas nonkomersial dan pelafalan materi Anda |
| Varian 40M multibahasa | Satu pilihan ringkas untuk lima bahasa dalam daftar | Batas lisensi yang sama serta perilaku pergantian dan campuran bahasa |
Ini keputusan produk praktis, bukan argumen bahwa satu lisensi membuat suara model lebih bagus. Bandingkan kualitas, biaya eksekusi, dan izin penggunaan secara terpisah. Catat varian tepat yang diuji alih-alih hanya menulis “Phonon” pada catatan penerapan.
Baris perintah memperjelas jalur baru
Pada pemasangan macOS yang didukung, pengumuman resmi menunjukkan perintah langsung:
ollama run phonon "Hello from Ollama."
Pengumuman juga mendemonstrasikan penerusan keluaran model teks menjadi suara:
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
Ini contoh alur yang diumumkan, bukan hasil pengujian perangkat kami. Bagian menariknya adalah penghubung pipe: satu model membuat kata, model lain membuat suara. Jawaban singkat dan pengecualian penalaran tersembunyi dari masukan suara membuat serah terima lebih mudah dipahami.
Pengumuman juga memperlihatkan penyimpanan suara sebagai berkas WAV:
ollama run phonon "Save this to a file." > speech.wav
Gunakan perintah terdokumentasi dalam lingkungan didukung, lalu periksa berkasnya sebelum membangun proses massal. Adanya berkas audio tidak menjelaskan apakah semua kalimat diucapkan, awal terpotong, atau angka penting dilafalkan dengan benar.
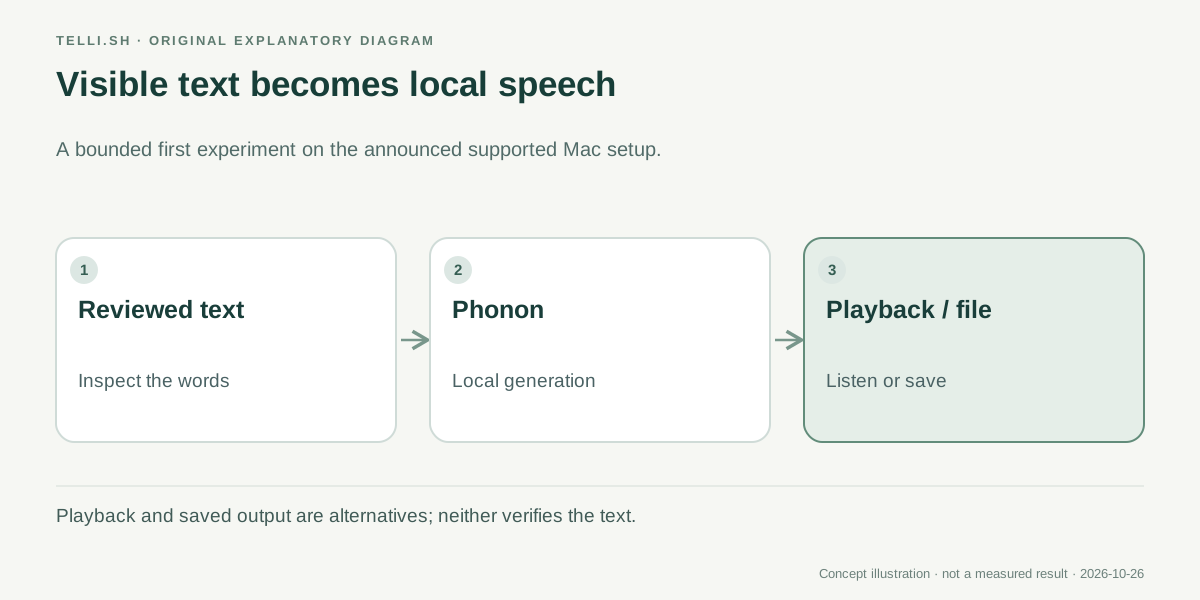 Batas berguna pertama adalah teks terlihat. Suara mengubah cara menyampaikan jawaban; suara tidak memverifikasi jawaban secara independen.
Contoh pertama: dengarkan dokumen sebelum mengirimnya
Bayangkan konsultan meninjau pembaruan proyek dalam bahasa Inggris. Dokumen menjelaskan secara padat perubahan, ketidakpastian, dan hal yang perlu disetujui pelanggan. Di layar cukup mudah dibaca, tetapi mendengarkannya bisa mengungkap kalimat terlalu panjang atau transisi sulit diikuti.
Model suara lokal dapat mengubah teks yang disetujui menjadi draf dengar. Konsultan mendengar redaksi sebenarnya sambil menyunting dokumen asli. Model suara tidak perlu menciptakan rangkuman atau menentukan pernyataan penting.
Manfaatnya spesifik: cara tambahan untuk meninjau tulisan. Ini juga dapat membantu orang yang lebih suka mendengar atau ingin bergantian antara pekerjaan visual dan audio. Ini bukan bukti solusi aksesibilitas lengkap, dan suara generatif tidak boleh menggantikan pemeriksaan yang diperlukan oleh kebutuhan khusus audiens.
Contoh ini memudahkan penilaian privasi. Jika generasi suara benar-benar tetap dalam proses lokal, tahap tersebut tidak perlu mengirim dokumen ke penyedia suara terpusat. Alur lengkapnya masih mungkin mencakup editor cloud, model bahasa jarak jauh, telemetri, atau folder berbagi. “Suara lokal” menjelaskan satu batas pemrosesan, bukan semua aplikasi di sekelilingnya.
Contoh kedua: prototipe jawaban lisan dengan transkrip terlihat
Bayangkan pengembang membuat prototipe kecil pembelajaran bahasa atau kios informasi. Aplikasi menghasilkan jawaban singkat, menampilkan kata, dan menyediakan tombol mendengar. Pengguna dapat membandingkan yang dilihat dengan yang didengar, sedangkan pengembang dapat memeriksa kegagalan tanpa menebak teks masukan model suara.
Endpoint /v1/audio/speech Ollama yang kompatibel dengan OpenAI dan dilayani lingkungan lokal relevan di sini. Pengumuman resmi menjelaskan endpoint sebagai cara mengintegrasikan generasi suara ke aplikasi. Kompatibilitas dapat mengurangi pekerjaan integrasi perangkat lunak yang sudah memakai API suara, tetapi tidak membuktikan setiap opsi penyedia jarak jauh punya implementasi lokal identik.
Mulailah dengan model, suara, dan perilaku respons terdokumentasi. Jika aplikasi mengharapkan format streaming, pembatalan, atau pengodean audio tertentu, uji kontrak itu secara persis. Keberhasilan satu permintaan singkat tidak membuktikan sesi interaktif panjang akan berjalan benar.
Untuk contoh pembelajaran bahasa, mulailah dengan satu bahasa didukung dan sedikit kalimat yang ditinjau. Uji nama dan kata tidak familier secara terpisah. Jika pengguna dapat memasukkan teks bebas, putuskan cara menangani aksara tidak didukung, masukan sangat panjang, dan materi yang tidak seharusnya diucapkan di ruang bersama.
Cara membuat percobaan pertama informatif
Percobaan paling berguna ketika menjawab pertanyaan yang dapat ditindaklanjuti. “Bisakah alat membuat suara?” cocok sebagai pemeriksaan pemasangan, tetapi lemah sebagai kriteria adopsi. Alat tulis membutuhkan paragraf yang dapat dipahami; prototipe interaktif juga memerlukan waktu tunggu wajar dan penghentian andal.
- Pastikan platform dan lingkungan. Periksa dokumentasi suara Ollama terbaru. Petunjuk peluncuran menyebut Mac Apple Silicon dan Ollama 0.40.11 atau lebih baru. Perlakukan platform mendatang sebagai ketersediaan masa depan.
- Pilih model tepat dan periksa lisensinya. Catat tag, bahasa, dan tujuan penggunaan sebelum membandingkan ukuran atau kecepatan.
- Siapkan teks representatif. Sertakan kalimat pendek, paragraf, angka, nama, dan kasus sulit dalam alur nyata. Simpan setiap masukan.
- Dengarkan keluaran lengkap. Periksa bagian hilang, pelafalan, jeda tidak alami, pengulangan, dan keberadaan akhir. Uji berkas tersimpan selain pemutaran langsung.
- Ukur pengalaman pada komputer Anda. Catat mesin, model, panjang masukan, dan waktu hingga audio berguna. Bandingkan materi sama pada pilihan berbeda.
- Pisahkan peninjauan dari pemutaran. Biarkan manusia memeriksa redaksi sensitif atau berdampak sebelum aplikasi mengucapkan atau menyebarkan berkas audio.
Proses ini tidak membutuhkan tolok ukur besar. Tim kecil memperoleh cara berulang untuk menentukan apakah suara lokal memadai bagi tugas terbatas dan batas mana yang perlu diteliti berikutnya.
Klaim kecepatan memerlukan kondisi pengujian
Pengumuman Ollama memuat perbandingan performa dan kualitas suara. Itu hasil laporan vendor dalam kondisi model, perangkat, dan evaluasi yang disebutkan. Hasil tersebut memberi petunjuk untuk diteliti, bukan janji latensi sama pada komputer berbeda atau suara dan bahasa lain.
Pisahkan laju produksi audio dari waktu hingga keluaran pertama terdengar. Model dapat membuat bagian panjang dengan cepat secara keseluruhan, tetapi masih membuat interaksi singkat terasa lambat di awal. Draf buku audio massal dan balasan percakapan memiliki kepentingan berbeda terhadap kedua ukuran itu.
Pengukuran kualitas juga memerlukan konteks. Pengenalan kata terhadap suara generatif membantu mendeteksi masalah kejelasan, tetapi tingkat kesalahan rendah tidak sepenuhnya menilai tempo, ekspresi, atau kesesuaian pelafalan nama bagi audiens. Mendengarkan langsung tetap berguna untuk materi yang benar-benar akan diucapkan produk.
Kami belum melakukan perbandingan independen lintas mesin untuk artikel ini. Harapan praktisnya adalah pilihan lokal baru untuk dievaluasi, bukan pemenang yang dinyatakan mengungguli seluruh sistem suara lokal atau terpusat.
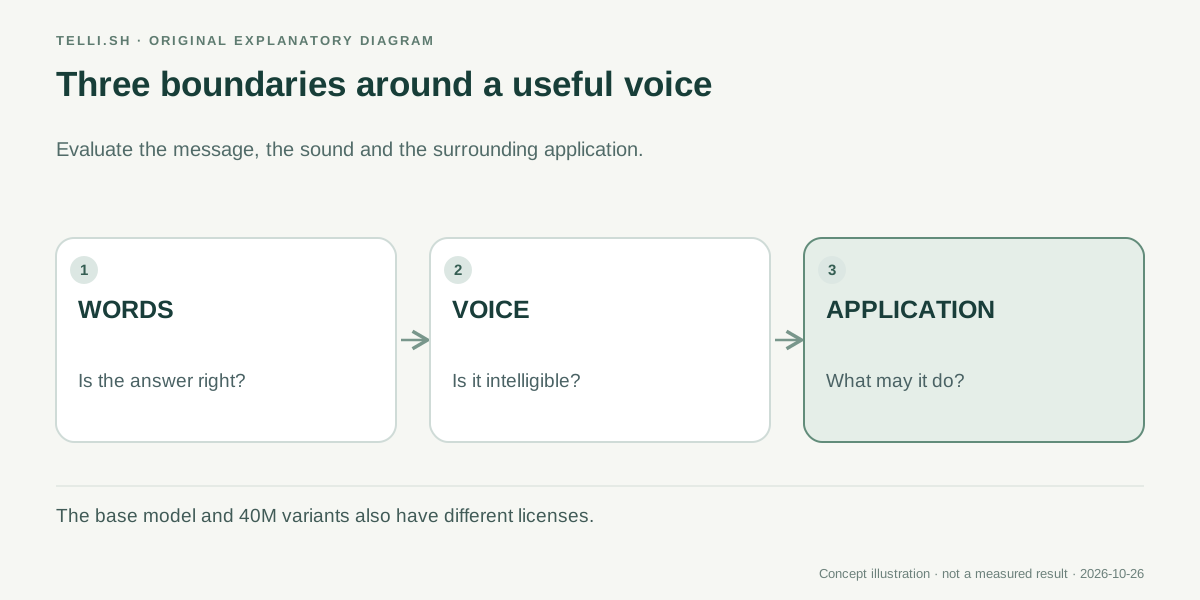 Periksa kata, suara, dan aplikasi secara terpisah. Suara jelas dapat menyampaikan jawaban salah sejelas jawaban benar.
Perubahan berikutnya yang mungkin dibawa suara lokal
Bagian menjanjikan pembaruan ini adalah hubungan yang bisa menjadi begitu biasa. Model lokal menulis penjelasan singkat, model lain membacakannya, dan aplikasi mempertahankan transkrip terlihat. Suara mulai menjadi kemampuan keluaran yang dapat dirangkai, bukan tujuan terpisah untuk teks salinan.
Ini dapat memudahkan eksplorasi peninjauan tulisan lokal, draf dengar pribadi, dan antarmuka lisan kecil. Ini juga dapat mendorong aplikasi yang menggabungkan beberapa model khusus: satu memahami masukan, satu mengambil keputusan terbatas, dan satu membacakan hasil yang ditinjau.
Uji berikutnya konkret. Dukungan sistem operasi lebih luas akan menambah pengguna yang dapat mencoba. Cakupan bahasa lebih besar mengubah audiens yang dilayani. Pembatalan, pengelolaan suara, dan integrasi lebih baik membuat aplikasi interaktif terasa alami. Masing-masing merupakan kemajuan berbeda yang perlu dinilai ketika benar-benar tersedia.
Untuk sekarang, dukungan Phonon di Ollama menawarkan langkah pertama berguna: biarkan AI lokal membacakan teks singkat yang dapat diperiksa, lalu tentukan apakah mendengarkan memperbaiki tugas tersebut. Jaga lisensi model dan batas platform sama terlihatnya dengan suaranya.
Sumber
- Ollama: Speech models, 24 Oktober 2026.
- Ollama: pustaka model Phonon dan lisensi, diperiksa pada 26 Oktober 2026.
Ingin menyimpan rekaman teks, catatan dengar, dan pilihan model yang mudah dicari dari percobaan? Kumpulkan materi di Telli.sh dan buat catatan yang dapat Anda kunjungi kembali.