NVIDIA Speech Skills: สอนกระบวนการ ASR ให้รู้ว่าศัพท์เฉพาะผิดตรงไหน
รู้จักสกิลปรับระบบรู้จำเสียงของ NVIDIA เอเจนต์เขียนโค้ดช่วยตรวจศัพท์เฉพาะ เตรียมข้อมูล เลือกฝึกเฉพาะที่จำเป็น และประเมินสิ่งที่ดีขึ้นได้อย่างไร
บทถอดเสียงได้โครงสร้างประโยคถูก แต่ชื่อสำคัญกลับผิด ผู้เชี่ยวชาญรู้ทันทีว่าผู้พูดตั้งใจใช้วลีใด แต่โมเดลเสียงแทนด้วยคำธรรมดา การปรับผลลัพธ์นี้เริ่มด้วยคำถามที่เฉพาะเจาะจงกว่า “โมเดลไหนดีที่สุด?”
บทสอน Speech Agent Skills ของ NVIDIA วันที่ 13 ตุลาคม 2026 เสนอกระบวนการปรับระบบรู้จำเสียงอัตโนมัติ หรือ ASR ให้เข้ากับสาขาเฉพาะ สกิลระดับสูงช่วยกำหนดปัญหาและประสานงาน ส่วนผู้เชี่ยวชาญ NeMo จัดการฝึกและประเมินที่เข้ากันได้ บทสอนใช้เสียงควบคุมการจราจรทางอากาศเป็นตัวอย่างลงมือทำ บทสอน NVIDIA
บทความนี้อธิบายว่าสกิลเพิ่มอะไร เมื่อใดควรพิจารณาฝึก และจะวางแผนทดลองแรกอย่างไร คุณไม่จำเป็นต้องเริ่มด้วยการฝึกครั้งใหญ่ ผลแรกที่มีประโยชน์อาจเป็นคำอธิบายชัดเจนว่าคำใดผิด เหตุใดจึงสำคัญ และวิธีแก้ใดควรนำมาทดสอบ
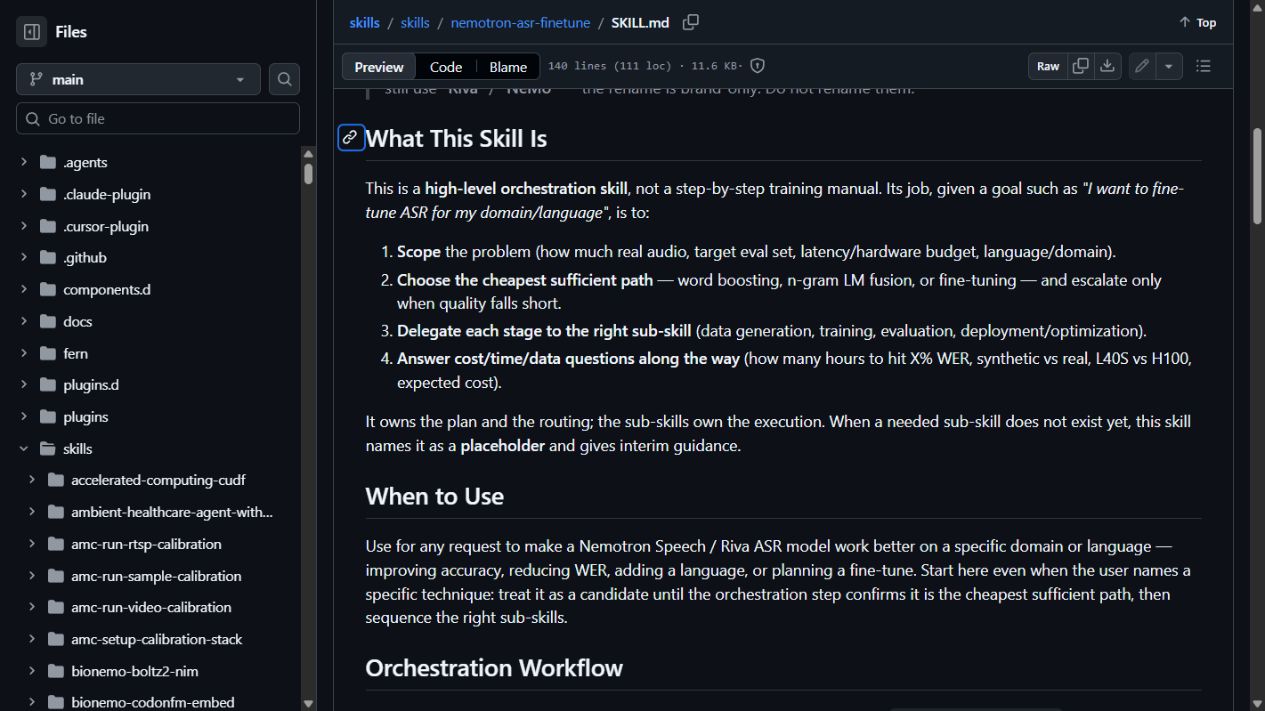 เอกสารสกิลสาธารณะ ของ NVIDIA ถ่ายวันที่ 20 ตุลาคม 2026 เอกสาร © NVIDIA อ้างที่มาตาม CC BY 4.0 ภาพนี้แสดงคำแนะนำสกิล ไม่ใช่การฝึกที่กำลังรัน
สกิลจัดระเบียบงานรอบโมเดล
โมเดลมีพารามิเตอร์ที่เรียนรู้แล้ว เฟรมเวิร์กฝึกมีเครื่องมือสำหรับปรับพารามิเตอร์ ส่วนสกิลเอเจนต์มีคำแนะนำช่วยให้ผู้ช่วยเขียนโค้ดเลือกและทำตามกระบวนการ การติดตั้งคำแนะนำไม่ได้ติดตั้งทุกเฟรมเวิร์ก ดาวน์โหลดทุกเช็กพอยต์ หรือยืนยันว่า GPU รันการทดลองได้
ในบทสอน NVIDIA แยกสกิลประสานงาน nemotron-asr-finetune ออกจากผู้เชี่ยวชาญ nemo-speech-asr-finetune ตัวแรกวางกรอบเป้าหมายและส่งงานต่อ ตัวที่สองจัดการการทำงานเฉพาะ NeMo เมื่อต้องฝึกหรือประเมินแบบออฟไลน์ คำอธิบายกระบวนการ
การแบ่งนี้มีประโยชน์เพราะ “ปรับการรู้จำให้ดีขึ้น” ครอบคลุมงานหลายชนิด ปัญหาคำศัพท์อาจต้องเสริมการถอดรหัส ความต่างของลีลาพูดหรือสภาพเสียงอาจสมควรปรับโมเดล ส่วนการเตรียมข้อมูลที่ตั้งค่าผิดอาจต้องแก้ก่อนสองแนวทางนั้นจะมีความหมาย
มองสกิลเป็นผู้ประสานการทดลอง มันช่วยให้เป้าหมาย ข้อมูลนำเข้า และการเปรียบเทียบสอดคล้องกันได้ แต่การทดลองยังต้องมีคนกำหนดว่าความสำเร็จคืออะไร สิ่งที่ส่งมอบสุดท้ายควรเป็นหลักฐานที่ตรวจสอบได้ ไม่ใช่เพียงผู้ช่วยบอกว่าฝึกจบแล้ว
เริ่มจากข้อผิดพลาดที่เปลี่ยนความหมาย
สมมติบริษัทฝึกพนักงานให้พูดรหัสสินค้าชุดเล็กระหว่างตรวจงาน ตัวรู้จำถอดบทสนทนาทั่วไปได้ดี แต่สับสนรหัสคล้ายกันสองรหัสซ้ำ ๆ ชุดข้อมูลแรกที่มีประโยชน์คือกลุ่มความสับสนเหล่านั้น พร้อมเสียงต้นฉบับและบทถอดเสียงอ้างอิงที่ตรวจแล้ว
กรณีที่สองคือคลังสัมภาษณ์ซึ่งมีชื่อคนและศัพท์เฉพาะ ความยากอาจเปลี่ยนตามผู้พูด ไมโครโฟน และหัวข้อ แยกข้อตกลงการสะกดจากความผิดพลาดทางเสียง: รูปเขียนสองแบบของตัวย่อเดียวกันไม่ควรถูกนับเป็นความผิดพลาดรู้จำคนละชนิดโดยอัตโนมัติ
กรณีที่สามคือเสียงสนับสนุนอุปกรณ์ผ่านช่องสัญญาณมีเสียงรบกวน การเพิ่มรายการคำศัพท์อาจช่วยบางคำแต่ยังแก้พยางค์ที่หายไม่ได้ โครงการปรับสาขาเฉพาะจะมีประโยชน์ขึ้นเมื่อแยกความคาดหวังด้านภาษาออกจากเสียงที่โมเดลได้รับจริง
นี่คือการประยุกต์กระบวนการที่เสนอ ไม่ใช่รายงานการใช้จริง แสดงว่าทำไมข้อมูลนำเข้าควรมีตัวอย่างมากกว่าประโยคเป้าหมายอย่างเดียว ความผิดพลาดสิบกว่ารายการที่เข้าใจดีอาจบอกได้ว่าขั้นต่อไปควรทำความสะอาดข้อมูล เสริมคำศัพท์ หรือศึกษาการปรับโมเดลที่จริงจังขึ้น
ใช้วิธีที่เบาที่สุดซึ่งแก้ความล้มเหลวนั้นได้
สกิลประสานงานสาธารณะอธิบายลำดับจาก word boosting ไปสู่การเสริมโมเดลภาษาและ fine-tuning โดยเลือกวิธีที่เพียงพอก่อนยกระดับ นี่คือหลักวางแผน ไม่ใช่การรับประกันว่าทุกโมเดลหรือรันไทม์มีตัวควบคุมเหมือนกัน เอกสารสกิล
| ปัญหาที่พบ | วิธีที่อาจใช้ | สิ่งที่ต้องเปรียบเทียบ |
|---|---|---|
| คำที่รู้จักแพ้คำธรรมดา | กลไกคำศัพท์หรือ word boosting ที่รองรับ | ความถูกต้องของคำเป้าหมายและคำที่แทรกโดยไม่ต้องการ |
| รูปแบบวลีเฉพาะทางมีโอกาสต่ำอย่างสม่ำเสมอ | การเสริมโมเดลภาษาหรือการถอดรหัสที่เข้ากันได้ | ความแม่นยำในสาขาควบคู่เสียงทั่วไป |
| โมเดลมีปัญหากับเสียงพูดหรือช่องสัญญาณของสาขา | การปรับโมเดลเสียง | เสียงเฉพาะทางที่กันไว้และชุดเสียงทั่วไป |
| ความแม่นยำตกทันทีหลังเปลี่ยนการตั้งค่า | คืนค่าและตรวจความเข้ากันได้ของการเตรียมข้อมูล | เช็กพอยต์และเสียงเดียวกันภายใต้การตั้งค่าทั้งสอง |
ตารางเป็นตัวช่วยตัดสินใจ ไม่ใช่การวินิจฉัย การเพิ่มคำศัพท์อาจสร้างข้อผิดพลาดใหม่เมื่อคำธรรมดาที่คล้ายกันพบบ่อย Fine-tuning อาจช่วยงานเฉพาะทางแต่ทำเสียงอีกแบบแย่ลง วัดทั้งผลที่ต้องการและผลข้างเคียงที่ต้องหลีกเลี่ยง
ควรแยกการถอดเสียงจากการเกลาข้อความปลายทางด้วย โมเดลภาษาอาจเขียนวลีที่ไม่น่าเป็นไปได้ให้ดูสมเหตุสมผล แต่ไม่ได้พิสูจน์ว่ากู้คำที่พูดจริงกลับมาได้ เก็บผลรู้จำต้นฉบับไว้เพื่อตัดสินงานเสียงอย่างเป็นอิสระ
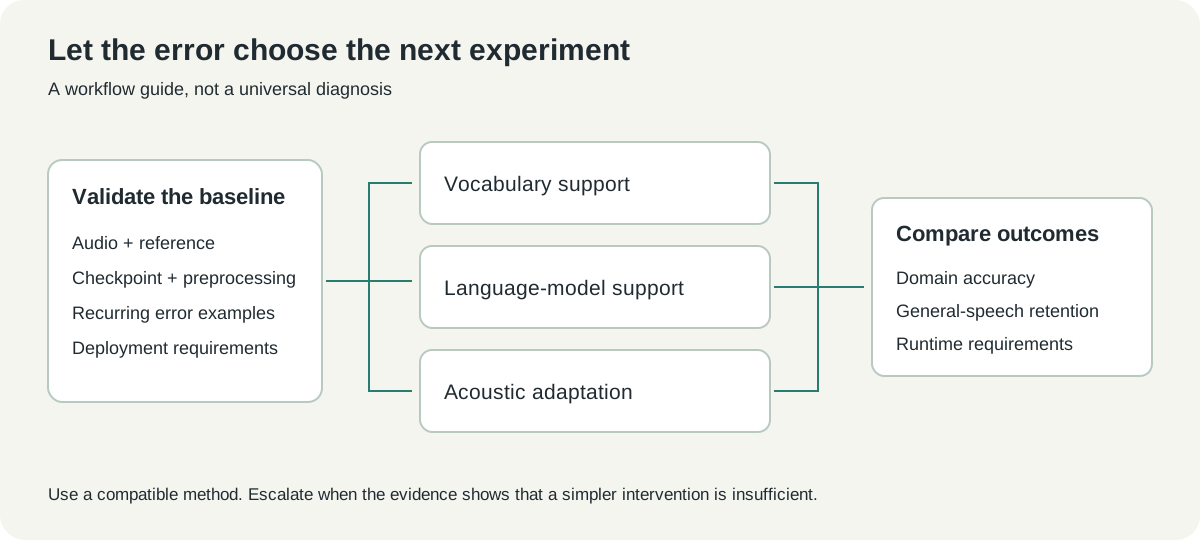 แผนภาพตัดสินใจที่จัดทำขึ้นใหม่จากกระบวนการในเอกสาร แนะนำเส้นทางที่เป็นไปได้ ไม่ได้กล่าวว่าเส้นทางเดียวเหมาะกับตัวรู้จำทุกตัว
ผลที่ดีขึ้นซึ่งรายงานมีฐานคำนวณชัดเจน
ในการศึกษาตัวอย่าง NVIDIA รายงานว่าอัตราคำผิดของ Nemotron ลดจาก 77.00% เป็น 22.46% บน ชุดทดสอบ ATCO2 ยาวสองชั่วโมงที่มนุษย์ทำคำกำกับ คิดเป็น การลดเชิงสัมพัทธ์ 70.8% และรายงาน WER ภาษาอังกฤษทั่วไปจาก 3.50% เป็น 3.63% ทั้งหมดเป็นผลของผู้เผยแพร่ภายใต้เงื่อนไขการศึกษานั้น บทสอนวันที่ 13 ตุลาคม
อัตราคำผิดนับการแทนคำ การลบคำ และการแทรกคำ เทียบกับจำนวนคำอ้างอิง ไม่ใช่ร้อยละของประโยคที่มีข้อผิดพลาดอย่างน้อยหนึ่งจุด และการลดเชิงสัมพัทธ์ที่รายงานก็ไม่ใช่การเปลี่ยนแบบจุดร้อยละ การแยกปริมาณเหล่านี้ช่วยให้เปรียบเทียบผลอย่างตรงไปตรงมา
ตัวอย่างมีประโยชน์เพราะแสดงทั้งสาขาเป้าหมายและอีกสาขา ผลเฉพาะทางอย่างเดียวบอกไม่ได้ว่าตัวรู้จำยังรักษาความสามารถเสียงทั่วไปที่ต้องใช้หรือไม่ แม้การเปลี่ยนในสาขาทั่วไปจะเล็ก ก็ควรอ่านคู่กับการปรับปรุง แทนตัดออกจากเรื่อง
ไมโครโฟน ภาษา หรือข้อตกลงการถอดเสียงที่ต่างกันอาจให้ผลต่างมาก ตัวเลขเด่นจึงควรชวนให้นำวิธีไปใช้: วัดค่าฐาน ปรับภายใต้เงื่อนไขควบคุม แล้วให้คะแนนชุดที่กันไว้ ไม่ควรกลายเป็นคำสัญญาว่าบริษัทจะลดข้อผิดพลาดจากสายของตนได้ในสัดส่วนเดียวกัน
แยกสิ่งที่ใช้สอนออกจากสิ่งที่ใช้ตัดสิน
ชุดข้อมูลปรับโมเดลต้องมีบทบาทแยกกัน ตัวอย่างฝึกเปลี่ยนโมเดล ตัวอย่างพัฒนาช่วยเลือกเช็กพอยต์และค่าถอดรหัส ตัวอย่างทดสอบตัดสินระบบที่เลือกหลังตัดสินใจเหล่านั้นแล้ว
การสุ่มแบ่งช่วงสั้นอาจทำให้ดูเป็นอิสระอย่างชวนเข้าใจผิด คลิปสองคลิปจากการบันทึกเดียวอาจมีผู้พูด ช่องสัญญาณ วลี และเสียงพื้นหลังร่วมกัน หากทำได้ ออกแบบการแบ่งตามหน่วยที่สำคัญต่อการใช้จริง เช่น การบันทึก ผู้พูด หรือรอบเก็บข้อมูล
ระบุข้อตกลงข้อความอ้างอิงให้ชัด ตัดสินก่อนให้คะแนนว่าตัวเลข ตัวย่อ วรรคตอน และเสียงลังเลเขียนอย่างไร หากผลลัพธ์เขียน “twenty one” แต่ข้อความอ้างอิงเขียน “21” การทำ normalization ที่เลือกอาจเปลี่ยนคะแนนโดยไม่เปลี่ยนสิ่งที่ผู้ฟังเข้าใจ
สำหรับโครงการเริ่มต้น เตรียมบัญชีรายการขนาดเล็กแทนเร่งเก็บคลังใหญ่ บันทึกว่าเสียงมาจากไหน ใช้ทำอะไรได้ ใครตรวจบทถอด และแต่ละรายการมีบทบาทใด บัญชีที่ชัดเจนตรวจง่ายกว่าโฟลเดอร์ที่มีเพียงชื่อไฟล์บอกที่มาอย่างมาก
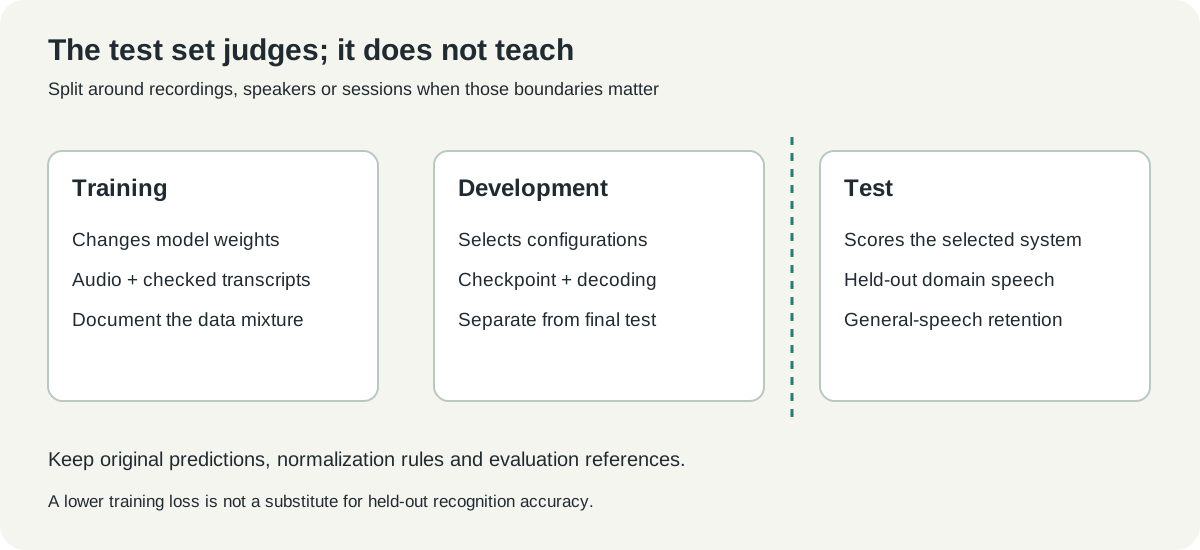 แผนภาพอธิบายที่จัดทำขึ้นใหม่ ช่องทดสอบอยู่นอกการฝึกและการเลือกเช็กพอยต์ พร้อมประเมินการรักษาเสียงทั่วไปควบคู่กับงานเฉพาะทาง
คำขอแรกควรขอแผนและค่าฐาน
สกิลทำงานมีประโยชน์ขึ้นเมื่อคำขอมีเป้าหมายที่สังเกตได้ “ช่วยบทถอดงานตรวจของเรา” เป็นจุดเริ่มต้น แต่ยังไม่ชัดว่าตัวรู้จำ ภาษา โหมดใช้งาน และต้นทุนข้อผิดพลาดคืออะไร เพิ่มรายละเอียดและขอขั้นแรกที่จำกัดขอบเขต
ตัวอย่างคำขอที่เสนออาจเขียนว่า:
ตรวจชุดเสียงงานตรวจและบทถอดอ้างอิงขนาดเล็กที่มีสิทธิ์ใช้ ระบุความสับสนของคำที่เกิดซ้ำ ตรวจตัวรู้จำและการเตรียมข้อมูลปัจจุบัน แล้ววัดค่าฐาน เปรียบเทียบการเสริมคำศัพท์กับข้อเสนอฝึก รักษาชุดทดสอบที่กันไว้ และรายงานความแม่นยำเฉพาะทาง การรักษาเสียงทั่วไป และทรัพยากรที่ต้องใช้ก่อนรันยาว
ตัวอย่างนี้กำหนดหลักฐานที่เอเจนต์ควรส่งกลับ และเปิดวิธีไว้จนข้อมูลสนับสนุนทางเลือก ปกติมีประสิทธิผลกว่าการเริ่มสั่ง fine-tune เช็กพอยต์หนึ่งตามจำนวนสเต็ปที่กำหนดขึ้นเอง
รายงานแรกที่มีประโยชน์ควรระบุเช็กพอยต์แน่นอน การตั้งค่ารันไทม์ ชุดประเมิน และข้อผิดพลาดซ้ำ รวมถึงอธิบายว่าส่วนใดกำลังจำกัดความก้าวหน้า บทถอดที่แย่เพราะตั้งค่าการสุ่มตัวอย่างผิดต้องแก้ต่างจากกรณีเสียงที่โมเดลไม่คุ้นจริง
ติดตั้งทั้งคำแนะนำและส่วนที่ใช้รันอย่างตั้งใจ
บทสอน NVIDIA มีคำสั่งติดตั้งสกิลประสานงานและสกิลผู้เชี่ยวชาญแยกกัน ตัวที่สองไม่ได้ถูกติดตั้งอัตโนมัติเพียงเพราะตัวแรกอ้างถึง คำสั่งต่อไปนี้ทำตามเส้นทางเลือกสกิลในบทสอน ตรวจรีโพซิทอรีและเลือกขอบเขตติดตั้งที่ต้องการเมื่อถูกถาม
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
เริ่มเซสชันเอเจนต์เขียนโค้ดใหม่หลังติดตั้ง และยืนยันว่าสกิลที่คาดไว้พร้อมใช้ สิ่งนี้ยืนยันว่าเอเจนต์ค้นพบคำแนะนำได้ ยังไม่ได้บอกว่าเครื่องโหลดเช็กพอยต์หรือฝึกได้หรือไม่
บทสอนใช้โฮสต์ Linux ที่มี GPU และคอนเทนเนอร์ NeMo Speech ที่ตรึงไว้เป็น 26.07.00 สำหรับการตั้งค่าในเอกสาร ตรวจข้อกำหนดไดรเวอร์ GPU และเฟรมเวิร์กของอิมเมจปัจจุบันก่อนเตรียมโฮสต์ สกิลที่ติดตั้งบนแล็ปท็อปแทนสภาพแวดล้อมรันดังกล่าวไม่ได้ การเตรียมสภาพแวดล้อม
จำกัดการตรวจสภาพแวดล้อมแรกให้แคบ ตรวจ import การมองเห็น GPU การโหลดเช็กพอยต์ และการอนุมานสั้น ๆ ก่อนจัดงบฝึก บันทึกเวอร์ชันและตัวตนคอนเทนเนอร์เพื่อเชื่อมผลภายหลังกับซอฟต์แวร์ที่สร้างมัน
การรู้จำแบบสตรีมและออฟไลน์ต้องเปรียบเทียบแยกกัน
ตัวรู้จำสตรีมต้องส่งผลขณะเสียงเข้ามา ส่วนตัวรู้จำออฟไลน์ใช้รูปแบบทำงานอีกแบบหลังมีการบันทึกครบได้ ทั้งสองถอดเสียงได้ แต่ latency บริบท และการถอดรหัสอาจต่างจนคะแนนเดียวไม่พอเปรียบเทียบ
สำหรับแอปสด บันทึกว่าผลบางส่วนปรากฏเมื่อใด นิ่งเมื่อใด และส่งข้อความสุดท้ายอย่างไร บทถอดที่แม่นกว่าแต่มาช้าอาจไม่เหมาะกับคำบรรยายสด สำหรับคลังบันทึก กระบวนการออฟไลน์ที่ช้ากว่าอาจยอมรับได้หากให้บันทึกสุดท้ายดีกว่า
ใช้โหมดเดียวก่อนและหลังปรับในการเปรียบเทียบหลัก หากเปลี่ยนทั้งการแบ่งช่วง การถอดรหัส เช็กพอยต์ และ normalization คะแนนที่ดีขึ้นจะไม่บอกว่าการเปลี่ยนใดสำคัญ เพิ่มอีกการทดลองเมื่อต้องการเทียบกระบวนการทางเลือกครบชุด
วินัยเดียวกันช่วยการประเมินปลายทางด้วย ป้ายผู้พูด เวลา และคำรู้จำเป็นผลลัพธ์แยกกัน บทถอดอาจมี WER ดีแต่ระบุคำพูดสำคัญเป็นของผิดคน จึงควรตัดสินแต่ละความสามารถแยกเมื่อแอปต้องใช้
เช็กพอยต์ที่ประเมินแล้วมีมากกว่าบันทึกว่าฝึกสำเร็จ
ค่า training loss ที่ลดลงบอกว่าการหาค่าที่เหมาะสมกำลังเข้ากับวัตถุประสงค์ ไม่ได้ยืนยันว่าจะรู้จำผู้พูดใหม่แม่นขึ้น สิ่งส่งมอบที่มีประโยชน์คือเช็กพอยต์ที่เลือก พร้อมการตั้งค่า คำทำนาย และผลประเมิน
เก็บโมเดลต้นฉบับไว้และให้คะแนนด้วยระเบียบวิธีเดียวกัน รวมตัวอย่างความล้มเหลวที่เป็นตัวแทนไว้หลายรายการ เพื่อให้ผู้เชี่ยวชาญสาขาเข้าใจช่องว่างที่เหลือ ตารางค่าเฉลี่ยควรนำไปสู่ตัวอย่าง แทนซ่อนตัวอย่างไว้
การนำไปใช้งานเพิ่มคำถามอีกชุด เครื่องปลายทางโหลดสิ่งส่งมอบได้หรือไม่ รันไทม์ให้บริการรองรับสถาปัตยกรรมและ tokenizer หรือไม่ ผลลัพธ์ยังรักษาข้อตกลงที่ซอฟต์แวร์ปลายทางคาดไว้หรือไม่ สภาพแวดล้อมฝึกกับรันไทม์แอปอาจไม่ตรงกัน แม้ทั้งคู่รองรับ “การรู้จำเสียง”
บทสอน NVIDIA แยกเครื่องมือที่เผยแพร่แล้วออกจากเช็กพอยต์ Gold-refined ที่ระบุว่าจะตามมา ควรมองการมีโค้ด ผลตัวอย่าง และน้ำหนักปรับแล้วที่ดาวน์โหลดได้เป็นสถานะเปิดตัวต่างกัน บทสอนสาธารณะพอเริ่มวางแผนได้ แต่ไม่ได้หมายความว่าทุกสิ่งที่สาธิตบรรจุพร้อมใช้งานแล้ว
การปรับที่ดีเริ่มจากคำถามเล็กและชัดกว่า
เรามองว่า Speech Skills มีประโยชน์ที่สุดในฐานะวิธีทำให้งาน ASR เฉพาะทางตรวจสอบได้ มันเปลี่ยนคำขอปลายเปิดเรื่องเพิ่มความแม่นยำเป็นลำดับการตัดสินใจเรื่องข้อผิดพลาด ข้อมูล วิธีที่เข้ากันได้ และการประเมิน ช่วยไม่ให้การทดลองกลายเป็นการฝึกยาวที่ไม่มีเส้นชัยตกลงร่วมกัน
เริ่มจากคำที่สำคัญและเสียงที่พิสูจน์ปัญหา ถามว่าวิธีง่ายกว่าช่วยได้หรือไม่ แล้วค่อยยกระดับด้วยหลักฐาน เช็กพอยต์มีคุณค่าเมื่อทำบทถอดดีขึ้นในสภาพที่ผู้อ่านหรือผู้ฟังของคุณพบจริง
แหล่งข้อมูลและสื่อ
ตรวจสอบเมื่อวันที่ 20 ตุลาคม 2026 ตัวเลขผลลัพธ์อ้างจากการศึกษาของ NVIDIA บทความนี้ไม่ได้ทำซ้ำการฝึก การอนุมาน หรือผลเดโม ภาพหน้าจอแสดงเอกสาร NVIDIA สาธารณะที่ผู้เขียนถ่าย พร้อมอ้างสิทธิ์ CC BY 4.0 แผนภาพจัดทำขึ้นใหม่ ดู บันทึกสื่อ
- บทสอน NVIDIA วันที่ 13 ตุลาคม 2026
- สกิลประสานงาน
- สกิลผู้เชี่ยวชาญ NeMo
- เฟรมเวิร์ก NeMo Speech
- ใบอนุญาตเอกสารและซอร์ส NVIDIA
เก็บหลักฐานเสียงไว้ข้างการทบทวน
เก็บแหล่งอ้างอิง การตัดสินใจด้านคำศัพท์ และบันทึกประเมินไว้ด้วยกัน เพื่อให้การทดลองถัดไปเริ่มจากบันทึกที่ชัดเจน Telli.sh ช่วยจัดระเบียบงานค้นคว้านี้ได้ สร้างบัญชี Telli.sh