NVIDIA Speech Skills: ajar aliran kerja ASR mengenal pasti kesilapan istilah khusus
Pengenalan kepada kemahiran penyesuaian pertuturan NVIDIA: bagaimana ejen pengekodan boleh membantu menyiasat istilah khusus, menyediakan data, melatih secara terpilih dan menilai penambahbaikan.
Transkrip menangkap struktur ayat dengan betul tetapi tersalah nama yang penting. Pakar segera mengenali frasa yang dimaksudkan, namun model pertuturan menggantikannya dengan perkataan biasa. Memperbaiki hasil ini bermula dengan soalan yang lebih khusus daripada “model manakah yang terbaik?”
Tutorial Speech Agent Skills NVIDIA pada 13 Oktober 2026 membentangkan aliran kerja untuk menyesuaikan pengecaman pertuturan automatik, atau ASR, kepada sesuatu domain. Kemahiran aras tinggi membantu menentukan skop masalah dan menyelaras kerja; pakar NeMo mengendalikan latihan dan penilaian yang serasi. Tutorial itu menggunakan pertuturan kawalan trafik udara sebagai contoh kajiannya. Tutorial NVIDIA
Pengenalan ini menerangkan sumbangan kemahiran tersebut, bila latihan wajar dipertimbangkan dan cara merancang eksperimen pertama. Anda tidak perlu bermula dengan latihan berskala besar. Hasil awal yang berguna boleh berupa penjelasan jelas tentang perkataan yang gagal dikenal pasti, kepentingannya dan intervensi yang patut diuji.
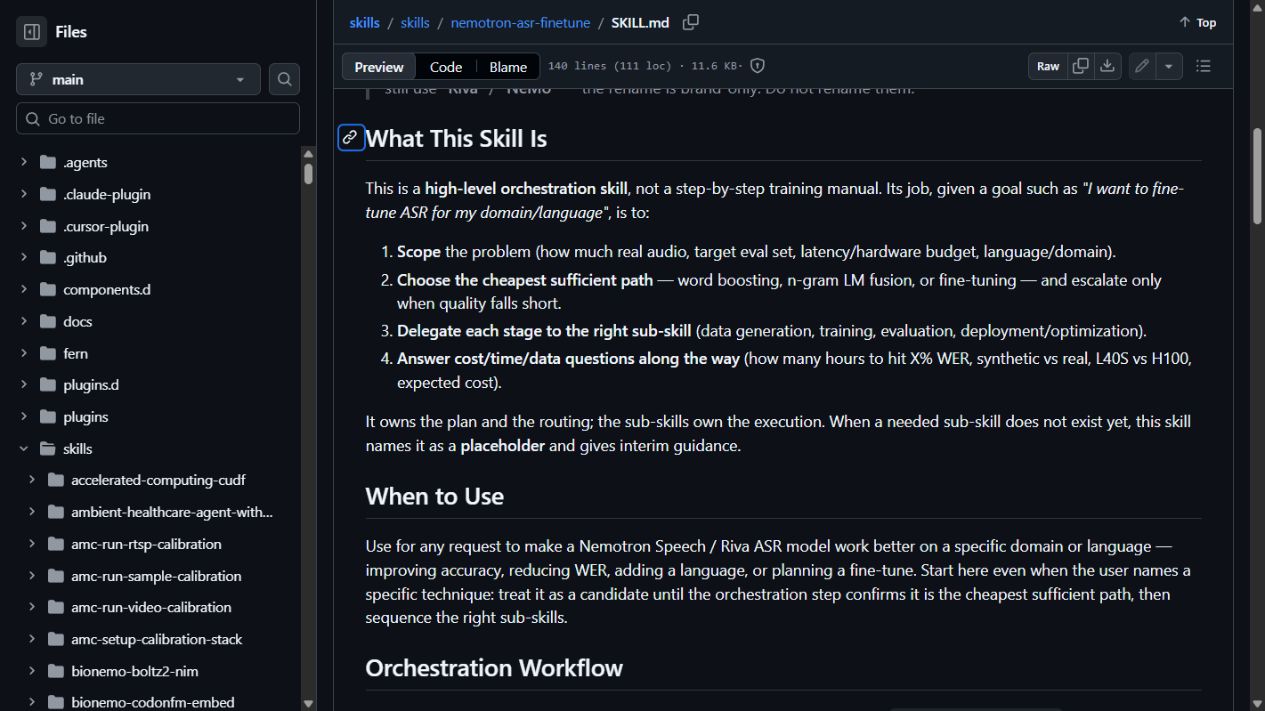 Dokumentasi kemahiran awam NVIDIA, dirakam pada 20 Oktober 2026. Dokumentasi © NVIDIA, dengan atribusi di bawah CC BY 4.0. Ini menunjukkan arahan kemahiran, bukan pelaksanaan latihan.
Kemahiran menyusun kerja di sekitar model
Model mengandungi parameter yang dipelajari. Rangka kerja latihan menyediakan mekanisme untuk mengemas kini parameter tersebut. Kemahiran ejen menyediakan arahan yang membantu pembantu pengekodan memilih dan melaksanakan aliran kerja. Memasang arahan tidak memasang setiap rangka kerja, memuat turun setiap titik semak atau membuktikan bahawa GPU boleh menjalankan eksperimen.
Dalam tutorial itu, NVIDIA memisahkan kemahiran penyelarasan nemotron-asr-finetune daripada kemahiran pakar nemo-speech-asr-finetune. Yang pertama merumuskan matlamat dan menghalakan kerja. Yang kedua mengendalikan pelaksanaan khusus NeMo apabila latihan atau penilaian luar talian sesuai dilakukan. Penerangan aliran kerja
Pembahagian itu berguna kerana “memperbaiki pengecaman” meliputi beberapa tugas berbeza. Masalah kosa kata mungkin memerlukan sokongan penyahkodan. Ketidakpadanan gaya pertuturan atau keadaan audio mungkin mewajarkan penyesuaian. Tetapan prapemprosesan yang rosak mungkin perlu dibetulkan sebelum kedua-dua laluan itu bermakna.
Anggap kemahiran sebagai penyelaras eksperimen. Ia boleh membantu menyelaraskan matlamat, input dan perbandingan, tetapi eksperimen masih memerlukan seseorang untuk menentukan makna kejayaan. Artifak akhir sepatutnya bukti yang boleh diperiksa, bukan sekadar pembantu mengatakan bahawa latihan sudah selesai.
Mulakan dengan kesilapan yang mengubah makna
Bayangkan sebuah syarikat melatih kakitangan menyebut sekumpulan kecil kod produk semasa pemeriksaan. Pengecam menyalin perbualan biasa dengan baik tetapi berulang kali mengelirukan dua kod yang serupa. Set data pertama yang berguna ialah koleksi kekeliruan tersebut bersama audio asal dan transkrip rujukan yang disemak.
Contoh kedua ialah arkib temu bual yang mengandungi nama dan istilah khusus. Di sini kesukaran mungkin berubah mengikut penutur, mikrofon dan topik. Pisahkan konvensyen ejaan daripada kesilapan akustik: dua bentuk tulisan bagi singkatan yang sama tidak sepatutnya secara automatik dianggap kegagalan pengecaman yang berbeza.
Contoh ketiga ialah audio sokongan peralatan yang dirakam melalui saluran bising. Menambah senarai kosa kata mungkin membantu sesetengah istilah tetapi tidak menyelesaikan suku kata yang hilang. Projek penyesuaian domain menjadi lebih berguna apabila ia membezakan jangkaan bahasa daripada bunyi yang sebenarnya tersedia kepada model.
Ini cadangan penggunaan aliran kerja, bukan pelaksanaan sebenar yang dilaporkan. Contoh-contoh ini menunjukkan mengapa input perlu menyertakan contoh dan bukan ayat matlamat sahaja. Sedozen kesilapan yang difahami dengan baik boleh menunjukkan sama ada langkah seterusnya ialah pembersihan data, sokongan kosa kata atau kajian penyesuaian yang lebih besar.
Gunakan intervensi paling ringan yang menangani kegagalan
Kemahiran penyelarasan awam menerangkan perkembangan daripada pengutamaan perkataan kepada sokongan model bahasa dan penalaan halus, dengan memilih laluan yang mencukupi sebelum meningkatkannya. Ini prinsip perancangan, bukan jaminan bahawa setiap model atau persekitaran masa jalan menawarkan kawalan yang sama. Dokumentasi kemahiran
| Masalah yang diperhatikan | Intervensi calon | Perkara yang dibandingkan |
|---|---|---|
| Istilah diketahui kalah kepada perkataan biasa | Mekanisme kosa kata atau pengutamaan perkataan yang disokong | Ketepatan istilah sasaran dan sisipan tidak diingini |
| Pola frasa domain sentiasa diberi kebarangkalian rendah | Sokongan model bahasa atau penyahkodan yang serasi | Ketepatan domain bersama pertuturan biasa |
| Model sukar memahami pertuturan atau saluran domain | Penyesuaian model akustik | Audio domain yang diasingkan dan set pertuturan umum |
| Ketepatan tiba-tiba merosot selepas perubahan konfigurasi | Pulihkan dan sahkan keserasian prapemprosesan | Titik semak dan audio yang sama di bawah kedua-dua konfigurasi |
Jadual ini membantu membuat keputusan, bukan diagnosis. Penambahan kosa kata boleh mencipta kesilapan baharu apabila perkataan biasa yang serupa kerap digunakan. Penalaan halus boleh memperbaiki tugas khusus sambil merosakkan jenis pertuturan lain. Ukur kesan yang diingini serta kesan sampingan yang perlu dielakkan.
Memisahkan transkripsi daripada pembersihan hiliran juga membantu. Model bahasa boleh menulis semula frasa yang tidak munasabah menjadi sesuatu yang kedengaran masuk akal, tetapi itu bukan bukti bahawa ia memulihkan perkataan yang dituturkan. Simpan output pengecaman asal supaya tugas akustik boleh dinilai secara berasingan.
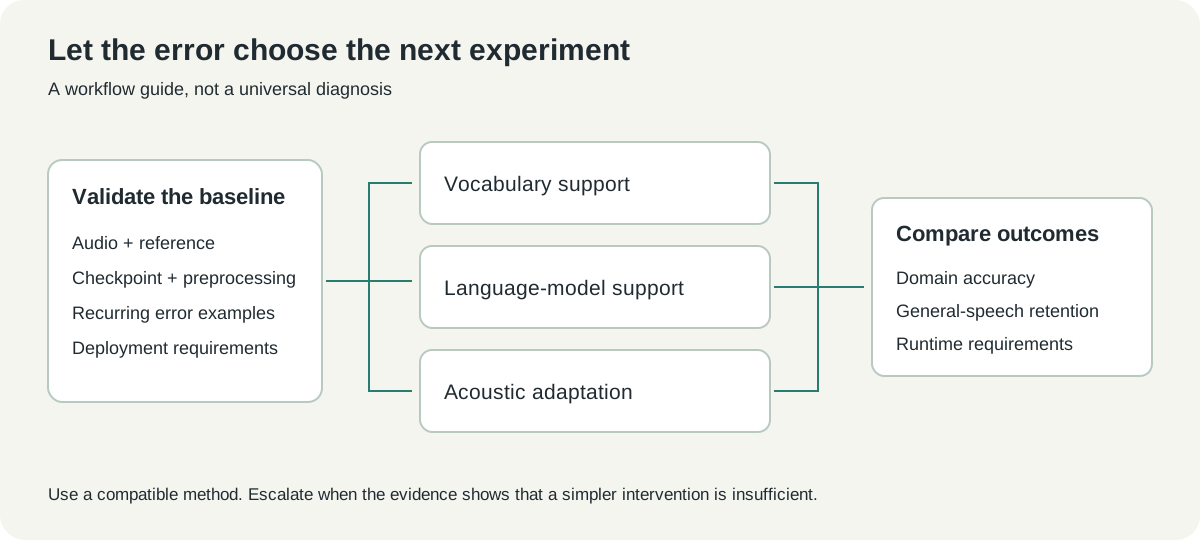 Rajah keputusan asal berdasarkan aliran kerja yang didokumentasikan. Ia memperkenalkan laluan yang mungkin, bukan mendakwa satu laluan sesuai untuk setiap pengecam.
Penambahbaikan yang dilaporkan mempunyai asas kiraan tertentu
Dalam kajian contoh NVIDIA, tutorial melaporkan kadar ralat perkataan Nemotron turun daripada 77.00% kepada 22.46% pada set ujian ATCO2 dua jam yang dianotasi manusia, iaitu pengurangan relatif 70.8%. Ia turut melaporkan WER bahasa Inggeris umum berubah daripada 3.50% kepada 3.63%. Ini hasil penerbit di bawah syarat kajian tersebut. Tutorial 13 Oktober
Kadar ralat perkataan mengira penggantian, pengguguran dan sisipan berbanding perkataan rujukan. Ia bukan peratus ayat yang mengandungi sekurang-kurangnya satu kesilapan, dan pengurangan relatif yang dilaporkan bukan perubahan mata peratusan. Memisahkan kuantiti ini memudahkan perbandingan hasil secara jujur.
Contoh ini berguna kerana ia menunjukkan domain sasaran dan domain lain. Hasil khusus sahaja tidak dapat menjelaskan sama ada pengecam mengekalkan kebolehan pertuturan biasa yang masih diperlukan. Perubahan kecil pada domain umum pun wajar dibaca bersama penambahbaikan, bukan digugurkan daripada penerangan.
Mikrofon, bahasa atau konvensyen transkripsi yang berbeza boleh memberikan hasil yang sangat berbeza. Oleh itu, tajuk utama sepatutnya mendorong kaedah: ukur garis dasar, sesuaikan dalam keadaan terkawal dan nilai set yang diasingkan. Ia tidak patut menjadi janji bahawa sesebuah syarikat boleh menghapuskan bahagian kesilapan yang sama daripada panggilannya sendiri.
Pisahkan bahan yang mengajar daripada bahan yang menilai
Set data penyesuaian memerlukan peranan yang berbeza. Contoh latihan mengubah model. Contoh pembangunan membimbing pilihan seperti titik semak dan tetapan penyahkodan. Contoh ujian menilai sistem yang dipilih selepas pilihan tersebut dibuat.
Pembahagian mengikut segmen pendek secara rawak boleh memberikan gambaran kebebasan yang mengelirukan. Dua klip daripada rakaman yang sama mungkin berkongsi penutur, saluran, frasa dan bunyi latar. Jika boleh, reka pembahagian berdasarkan unit yang penting untuk penggunaan sebenar, seperti rakaman, penutur atau sesi pengumpulan.
Nyatakan konvensyen rujukan dengan jelas. Tentukan cara nombor, singkatan, tanda baca dan bunyi teragak-agak diwakili sebelum menilai. Jika satu output menulis “twenty one” dan rujukan menulis “21,” normalisasi yang dipilih boleh mengubah skor tanpa mengubah apa yang difahami pendengar.
Untuk projek permulaan, sediakan inventori kecil dan bukannya berlumba mengumpul korpus besar. Rekod asal audio, penggunaan yang dibenarkan, penyemak transkrip dan peranan item. Inventori yang jelas jauh lebih mudah disemak berbanding folder yang hanya bergantung pada nama fail sebagai bukti asal usul.
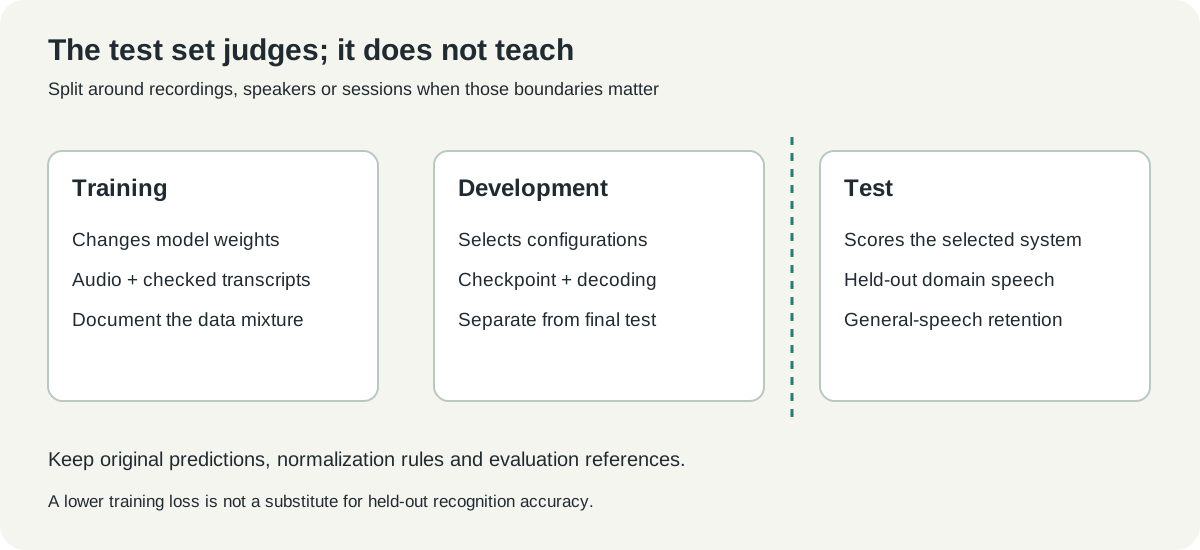 Rajah penerangan asal. Laluan ujian kekal di luar latihan dan pemilihan titik semak; pengekalan pertuturan biasa dinilai bersama tugas domain.
Permintaan pertama patut meminta rancangan dan garis dasar
Kemahiran boleh melakukan kerja yang lebih berguna apabila permintaan mempunyai sasaran yang boleh diperhatikan. “Bantu transkrip pemeriksaan kami” ialah permulaan, tetapi masih membiarkan pengecam, bahasa, mod penggunaan dan kos kesilapan tidak jelas. Tambah butiran itu dan minta peringkat pertama yang terbatas.
Sebagai contoh, cadangan permintaan boleh berbunyi:
Periksa set kecil rakaman pemeriksaan dan transkrip rujukan kami yang berlesen. Kenal pasti kekeliruan istilah berulang, sahkan pengecam serta prapemprosesan semasa dan ukur garis dasar. Bandingkan sokongan kosa kata dengan cadangan latihan. Kekalkan set ujian yang diasingkan dan laporkan ketepatan domain, pengekalan pertuturan biasa serta keperluan sumber sebelum latihan yang lebih panjang.
Contoh ini menentukan bukti yang patut dipulangkan ejen. Ia turut membiarkan kaedah terbuka sehingga data menyokong sesuatu pilihan. Ini biasanya lebih produktif daripada bermula dengan arahan menala halus titik semak tertentu untuk bilangan langkah yang dipilih sewenang-wenangnya.
Laporan awal yang berguna patut mengenal pasti titik semak tepat, konfigurasi masa jalan, set penilaian dan kesilapan berulang. Ia juga patut menjelaskan bahagian proses yang sedang mengehadkan kemajuan. Transkrip lemah akibat konfigurasi pensampelan yang salah memerlukan pembaikan berbeza daripada transkrip lemah akibat pertuturan yang benar-benar tidak biasa.
Pasang arahan dan kebergantungan pelaksanaan dengan teliti
Tutorial NVIDIA mendokumentasikan arahan pemasangan berasingan bagi kemahiran penyelarasan dan pakar. Kemahiran kedua tidak dipasang secara automatik hanya kerana yang pertama merujuk kepadanya. Arahan berikut mengulangi laluan pemilihan kemahiran dalam tutorial; periksa repositori dan pilih skop pemasangan yang dimaksudkan apabila diminta.
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
Mulakan sesi ejen pengekodan yang baharu selepas pemasangan dan sahkan bahawa kemahiran yang dijangka tersedia. Ini membuktikan ejen boleh menemui arahan tersebut. Ia belum menjelaskan sama ada mesin boleh memuatkan titik semak atau melakukan latihan.
Tutorial menggunakan hos GPU Linux dan kontena NeMo Speech yang ditetapkan versinya, 26.07.00, untuk persediaan yang didokumentasikan. Periksa keperluan pemacu, GPU dan rangka kerja imej semasa sebelum menyediakan hos. Kemahiran yang dipasang pada komputer riba tidak menggantikan persekitaran pelaksanaan itu. Persediaan persekitaran
Pastikan pemeriksaan persekitaran pertama berskop kecil. Sahkan import, pengesanan GPU, pemuatan titik semak dan inferens ringkas sebelum memperuntukkan belanjawan latihan. Rekod versi dan identiti kontena supaya hasil kemudian dapat dihubungkan kepada perisian yang menghasilkannya.
Pengecaman penstriman dan luar talian memerlukan perbandingan berasingan
Pengecam penstriman mesti menghasilkan output semasa audio tiba. Pengecam luar talian boleh menggunakan corak pelaksanaan berbeza selepas rakaman tersedia. Kedua-duanya mungkin menyalin pertuturan, tetapi latensi, konteks dan pilihan penyahkodan boleh cukup berbeza sehingga satu skor tidak memberikan perbandingan yang lengkap.
Untuk aplikasi langsung, rekod bila hasil separa muncul, bila hasil itu stabil dan bagaimana teks akhir dihantar. Transkrip yang lebih tepat tetapi tiba terlalu lewat mungkin tidak sesuai untuk sari kata langsung. Untuk arkib, proses luar talian yang lebih perlahan boleh diterima jika menghasilkan rekod akhir yang lebih baik.
Gunakan mod yang sama sebelum dan selepas penyesuaian untuk perbandingan utama. Jika anda turut menukar pembahagian ketulan, penyahkodan, titik semak dan normalisasi teks, skor yang bertambah baik tidak akan menjelaskan perubahan yang paling berpengaruh. Tambah eksperimen berasingan apabila mahu membandingkan keseluruhan aliran kerja alternatif.
Disiplin yang sama membantu penilaian hiliran. Label penutur, cap masa dan perkataan yang dikenal pasti ialah output berasingan. Transkrip boleh mempunyai WER yang baik sambil mengaitkan pernyataan penting kepada orang yang salah, jadi nilai keupayaan tersebut secara berasingan apabila diperlukan aplikasi.
Titik semak yang dinilai lebih bermakna daripada log latihan berjaya
Nilai fungsi kerugian latihan yang menurun menunjukkan proses pengoptimuman sedang memadankan objektifnya. Ia tidak membuktikan bahawa pertuturan penutur baharu akan ditranskripsikan dengan lebih tepat. Artifak yang berguna ialah titik semak terpilih bersama konfigurasi, ramalan dan hasil penilaiannya.
Pastikan model asal masih tersedia dan nilai di bawah protokol yang sama. Sertakan beberapa kegagalan yang mewakili penggunaan dalam laporan supaya penyemak domain memahami jurang yang tinggal. Jadual purata patut membawa pembaca kepada contoh, bukan menyembunyikannya.
Pelaksanaan menambah kumpulan soalan lain. Bolehkah mesin sasaran memuatkan artifak? Adakah persekitaran penyajian menyokong seni bina dan tokenizer-nya? Adakah output mengekalkan konvensyen yang dijangka perisian hiliran? Persekitaran latihan dan masa jalan aplikasi boleh tidak sepadan walaupun kedua-duanya menyokong “pengecaman pertuturan.”
Tutorial NVIDIA membezakan alat yang telah diterbitkan daripada titik semak Gold-refined yang diterangkan sebagai akan datang. Anggap ketersediaan kod, hasil contoh dan wajaran teradaptasi yang boleh dimuat turun sebagai status keluaran yang berasingan. Tutorial awam mencukupi untuk memulakan perancangan; ia tidak bermaksud setiap artifak demonstrasi sudah dibungkus untuk penggunaan anda.
Penyesuaian lebih baik bermula dengan soalan lebih kecil dan jelas
Pada pandangan kami, Speech Skills paling berguna sebagai cara menjadikan kerja ASR khusus boleh diperiksa. Ia menukar permintaan terbuka untuk ketepatan lebih baik kepada turutan keputusan tentang kesilapan, data, kaedah yang serasi dan penilaian. Ini boleh mengelakkan eksperimen menjadi latihan panjang tanpa garis penamat yang dipersetujui.
Mulakan dengan perkataan yang penting dan rakaman yang membuktikan masalah. Tanya sama ada intervensi lebih mudah berkesan, kemudian tingkatkan berdasarkan bukti. Titik semak bernilai apabila ia memperbaiki transkrip di bawah keadaan yang benar-benar dihadapi pembaca atau pendengar anda.
Sumber dan media
Diperiksa pada 20 Oktober 2026. Hasil berangka dikaitkan kepada kajian NVIDIA; tiada latihan, inferens atau hasil demo dihasilkan semula untuk artikel ini. Tangkapan skrin menunjukkan dokumentasi NVIDIA awam yang dirakam penulis, dengan atribusi CC BY 4.0. Rajah ialah karya asal. Lihat rekod media.
- Tutorial NVIDIA, 13 Oktober 2026
- Kemahiran penyelarasan
- Kemahiran pakar NeMo
- Rangka kerja NeMo Speech
- Pelesenan dokumentasi dan kod sumber NVIDIA
Simpan bukti audio bersama semakan
Simpan rujukan sumber, keputusan istilah dan nota penilaian bersama-sama supaya eksperimen seterusnya bermula dengan rekod yang jelas. Telli.sh boleh membantu menyusun penyelidikan itu. Cipta akaun Telli.sh