NVIDIA Speech Skills: ajari alur ASR menemukan kekeliruan jargon
Pengantar skill adaptasi ucapan NVIDIA: bagaimana agen pemrograman membantu menyelidiki kosakata khusus, menyiapkan data, melatih secara selektif, dan mengevaluasi perbaikannya.
Transkrip menangkap struktur kalimat dengan benar, tetapi nama pentingnya salah. Spesialis langsung mengenali frasa yang dimaksud, sementara model ucapan menggantinya dengan kata biasa. Memperbaiki hasil itu dimulai dengan pertanyaan lebih spesifik daripada “model mana yang terbaik?”
Tutorial Speech Agent Skills NVIDIA pada 13 Oktober 2026 menyajikan alur adaptasi pengenalan ucapan otomatis, atau ASR, untuk suatu domain. Skill tingkat tinggi membantu menentukan masalah dan mengoordinasikan pekerjaan; spesialis NeMo menangani pelatihan serta evaluasi yang kompatibel. Tutorial menggunakan ucapan pengendalian lalu lintas udara sebagai contoh kerja. Tutorial NVIDIA
Pengantar ini menjelaskan tambahan yang diberikan skill, kapan pelatihan layak dipertimbangkan, dan cara merencanakan eksperimen pertama. Anda tidak harus memulai pelatihan besar. Hasil awal yang berguna bisa berupa uraian jelas tentang kata yang gagal, mengapa penting, dan intervensi yang patut diuji.
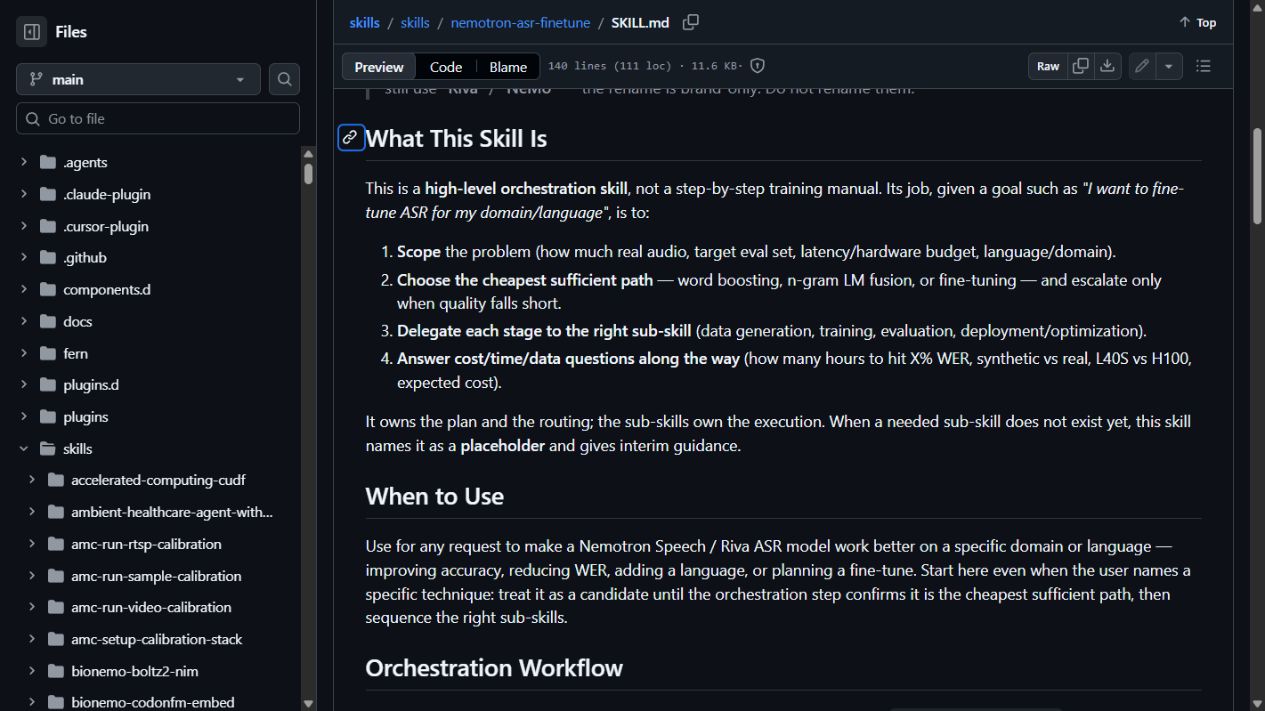 Dokumentasi skill publik NVIDIA, diambil pada 20 Oktober 2026. Dokumentasi © NVIDIA, diatribusikan berdasarkan CC BY 4.0. Layar ini menunjukkan instruksi skill, bukan eksekusi pelatihan.
Skill mengatur pekerjaan di sekitar model
Model memuat parameter terpelajari. Kerangka pelatihan menyediakan mesin untuk memperbaruinya. Skill agen menyediakan instruksi yang membantu asisten pemrograman memilih dan menjalankan alur kerja. Memasang instruksi tidak memasang setiap kerangka, mengunduh semua checkpoint, atau memastikan GPU mampu menjalankan eksperimen.
Dalam tutorial, NVIDIA memisahkan skill orkestrasi nemotron-asr-finetune dari spesialis nemo-speech-asr-finetune. Yang pertama merumuskan tujuan dan mengarahkan pekerjaan. Yang kedua menangani eksekusi khusus NeMo ketika pelatihan atau evaluasi offline sesuai. Deskripsi alur kerja
Pembagian itu berguna karena “meningkatkan pengenalan” mencakup beberapa pekerjaan berbeda. Masalah kosakata mungkin membutuhkan dukungan decoding. Ketidakcocokan gaya bicara atau kondisi audio dapat membenarkan adaptasi. Pengaturan prapemrosesan yang rusak mungkin perlu diperbaiki sebelum kedua jalur itu bermakna.
Anggap skill sebagai koordinator eksperimen. Ia dapat menjaga keselarasan tujuan, masukan, dan perbandingan, tetapi eksperimen tetap memerlukan manusia untuk mendefinisikan keberhasilan. Artefak akhirnya harus berupa bukti yang dapat diperiksa, bukan sekadar asisten mengatakan pelatihan selesai.
Mulai dengan kesalahan yang mengubah makna
Misalkan perusahaan melatih staf menyebut sejumlah kecil kode produk saat inspeksi. Pengenal mentranskripsikan percakapan biasa dengan baik, tetapi berulang kali mencampur dua kode mirip. Dataset pertama yang berguna adalah kumpulan kekeliruan itu bersama audio asli dan transkrip referensi yang diperiksa.
Kasus kedua adalah arsip wawancara berisi nama dan istilah khusus. Kesulitannya dapat bervariasi menurut pembicara, mikrofon, dan topik. Pisahkan konvensi ejaan dari kesalahan akustik: dua bentuk tertulis singkatan yang sama tidak otomatis menjadi kegagalan pengenalan berbeda.
Kasus ketiga adalah audio dukungan peralatan yang direkam melalui saluran bising. Penambahan daftar kosakata mungkin membantu sebagian istilah, tetapi tidak memulihkan suku kata hilang. Proyek adaptasi domain lebih berguna ketika membedakan harapan bahasa dari suara yang benar-benar tersedia bagi model.
Ini penerapan alur kerja yang diusulkan, bukan penerapan yang dilaporkan. Contoh tersebut menunjukkan mengapa masukan harus mencakup contoh, bukan hanya kalimat tujuan. Belasan kesalahan yang dipahami baik dapat menunjukkan apakah langkah berikutnya pembersihan data, dukungan kosakata, atau studi adaptasi lebih mendalam.
Gunakan intervensi paling ringan yang mengatasi kegagalan
Skill orkestrasi publik menjelaskan perkembangan melalui word boosting, dukungan model bahasa, dan fine-tuning, dengan memilih jalur memadai sebelum menaikkan tingkat intervensi. Ini prinsip perencanaan, bukan jaminan setiap model atau runtime menyediakan kendali identik. Dokumentasi skill
| Masalah teramati | Kandidat intervensi | Yang dibandingkan |
|---|---|---|
| Istilah yang diketahui kalah dari kata umum | Mekanisme kosakata atau word boosting yang didukung | Akurasi istilah target dan penyisipan tak diinginkan |
| Pola frasa domain selalu berprobabilitas rendah | Dukungan model bahasa atau decoding yang kompatibel | Akurasi domain bersama ucapan biasa |
| Model kesulitan dengan ucapan atau saluran domain | Adaptasi model akustik | Audio domain yang disisihkan dan kumpulan ucapan umum |
| Akurasi mendadak anjlok setelah perubahan konfigurasi | Pulihkan dan validasi kompatibilitas prapemrosesan | Checkpoint dan audio sama di kedua konfigurasi |
Tabel ini alat bantu keputusan, bukan diagnosis. Penambahan kosakata dapat menimbulkan kesalahan baru jika kata biasa yang mirip sering muncul. Fine-tuning dapat meningkatkan tugas khusus tetapi menurunkan pengenalan jenis ucapan lain. Ukur efek yang diinginkan serta efek samping yang perlu dihindari.
Pisahkan pula transkripsi dari pembersihan tahap hilir. Model bahasa dapat menulis ulang frasa tidak masuk akal menjadi sesuatu yang terdengar wajar, tetapi itu bukan bukti bahwa kata yang diucapkan telah dipulihkan. Simpan keluaran pengenalan asli agar tugas akustik dapat dinilai secara mandiri.
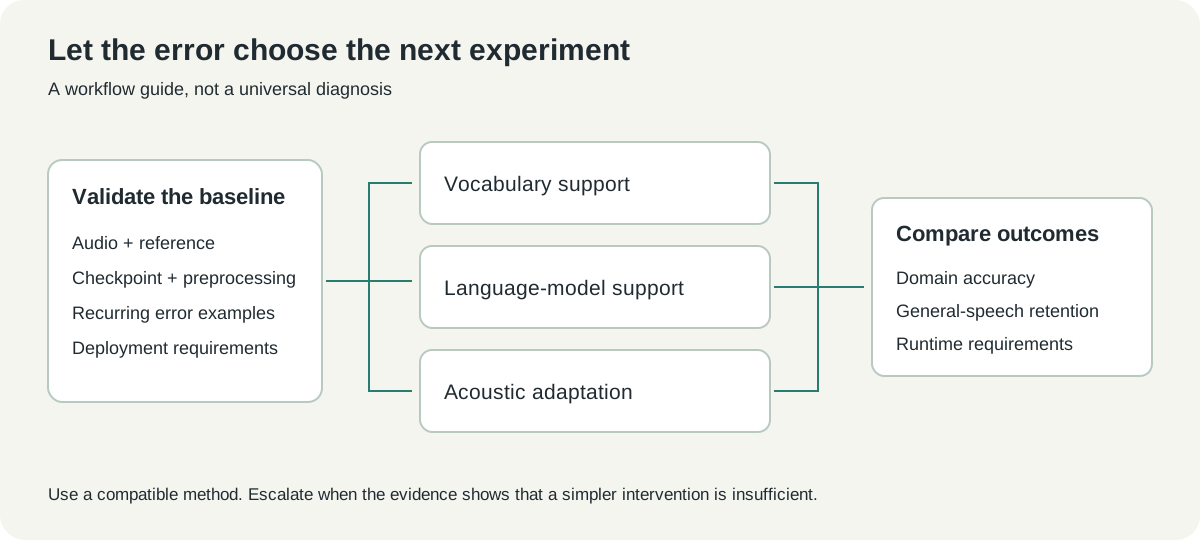 Diagram keputusan orisinal berdasarkan alur terdokumentasi. Ini pengantar jalur yang mungkin, bukan klaim satu jalur sesuai untuk semua pengenal.
Peningkatan yang dilaporkan memiliki penyebut yang tepat
Dalam studi contoh NVIDIA, tutorial melaporkan word error rate Nemotron turun dari 77.00% menjadi 22.46% pada set uji ATCO2 dua jam dengan anotasi manusia, sebuah penurunan relatif 70.8%. WER bahasa Inggris umum juga dilaporkan bergerak dari 3.50% ke 3.63%. Ini hasil penerbit di bawah kondisi studi tersebut. Tutorial 13 Oktober
Word error rate menghitung substitusi, penghapusan, dan penyisipan relatif terhadap kata referensi. Ini bukan persentase kalimat dengan setidaknya satu kesalahan, dan penurunan relatif tersebut bukan perubahan poin persentase. Memisahkan besaran itu memudahkan perbandingan yang jujur.
Contohnya berguna karena menunjukkan domain target dan domain lain. Hasil khusus saja tidak dapat memastikan pengenal mempertahankan kemampuan ucapan biasa yang masih dibutuhkan. Perubahan domain umum sekecil apa pun patut dibaca berdampingan dengan perbaikannya, bukan dihilangkan dari cerita.
Mikrofon, bahasa, atau konvensi transkripsi berbeda dapat menghasilkan hasil sangat berbeda. Karena itu, angka utama seharusnya memotivasi metode: ukur baseline, lakukan adaptasi terkendali, dan nilai set yang disisihkan. Jangan menjadikannya janji perusahaan dapat menghapus proporsi kesalahan sama dari panggilannya sendiri.
Pisahkan bahan untuk belajar dari bahan untuk menilai
Dataset adaptasi memerlukan peran terpisah. Contoh pelatihan mengubah model. Contoh pengembangan memandu pilihan seperti checkpoint dan pengaturan decoding. Contoh pengujian menilai sistem terpilih setelah pilihan tersebut ditetapkan.
Pemisahan segmen pendek secara acak dapat memberi kesan independensi yang menyesatkan. Dua klip dari rekaman sama mungkin berbagi pembicara, saluran, frasa, dan suara latar. Jika memungkinkan, susun pemisahan berdasarkan unit yang penting bagi penerapan, misalnya rekaman, pembicara, atau sesi pengumpulan.
Tegaskan konvensi referensi. Putuskan bagaimana angka, singkatan, tanda baca, dan bunyi keraguan direpresentasikan sebelum penilaian. Jika keluaran menulis “twenty one” dan referensi menulis “21”, normalisasi pilihan dapat mengubah skor tanpa mengubah pemahaman pendengar.
Untuk proyek awal, siapkan inventaris kecil alih-alih berlomba mengumpulkan korpus besar. Catat sumber audio, penggunaan yang diizinkan, pemeriksa transkrip, dan peran item. Inventaris jelas jauh lebih mudah ditinjau daripada folder yang nama berkasnya menjadi satu-satunya penanda asal.
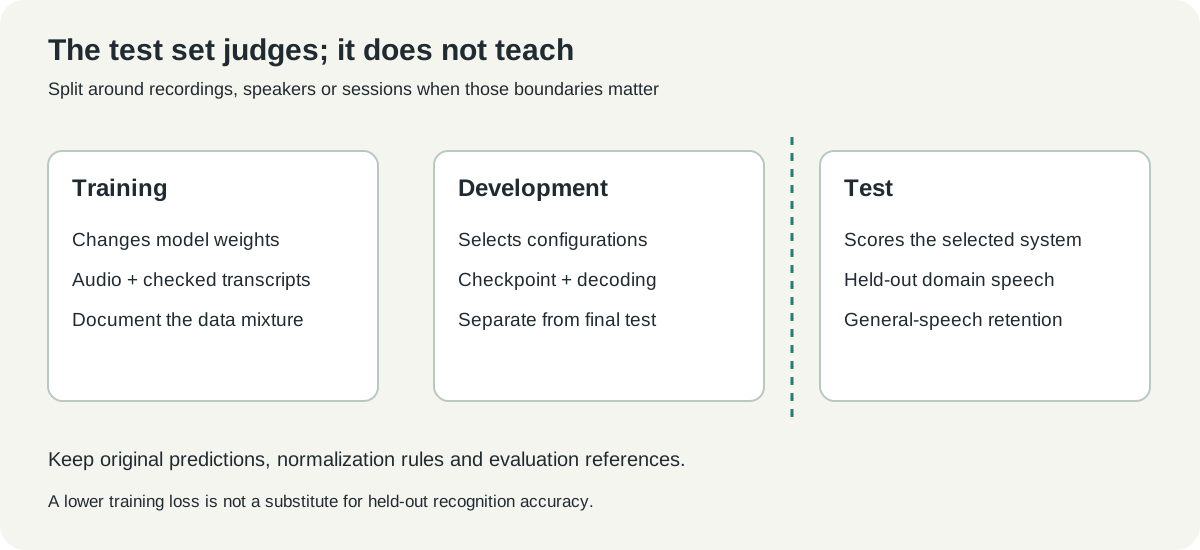 Diagram penjelasan orisinal. Jalur pengujian tetap di luar pelatihan dan pemilihan checkpoint; retensi ucapan biasa dievaluasi bersama tugas domain.
Permintaan pertama sebaiknya meminta rencana dan baseline
Skill dapat melakukan pekerjaan lebih berguna jika permintaan memuat target yang dapat diamati. “Bantu transkrip inspeksi kami” adalah awal, tetapi pengenal, bahasa, mode penerapan, dan biaya kesalahannya masih ambigu. Tambahkan rincian itu dan minta tahap pertama yang terbatas.
Misalnya, permintaan usulan dapat berbunyi:
Periksa kumpulan kecil berlisensi dari rekaman inspeksi dan transkrip referensi kami. Identifikasi kekeliruan istilah berulang, validasi pengenal serta prapemrosesan saat ini, dan ukur baseline. Bandingkan dukungan kosakata dengan usulan pelatihan. Pertahankan set uji yang disisihkan dan laporkan akurasi domain, retensi ucapan biasa, serta kebutuhan sumber daya sebelum eksekusi lebih panjang.
Contoh ini menentukan bukti yang perlu dikembalikan agen. Metodenya tetap terbuka sampai data mendukung pilihan. Itu biasanya lebih produktif daripada langsung memerintahkan fine-tuning checkpoint tertentu selama jumlah langkah sewenang-wenang.
Laporan awal yang berguna perlu menyebut checkpoint persis, konfigurasi runtime, set evaluasi, dan kesalahan berulang. Laporan juga perlu menjelaskan bagian proses yang membatasi kemajuan. Transkrip buruk karena konfigurasi sampling salah memerlukan perbaikan berbeda dari ucapan yang benar-benar asing.
Pasang instruksi dan dependensi eksekusi dengan sengaja
Tutorial NVIDIA mendokumentasikan perintah pemasangan terpisah untuk skill orkestrasi dan spesialis. Skill kedua tidak otomatis terpasang hanya karena disebut skill pertama. Perintah berikut mengikuti jalur pemilihan skill dalam tutorial; periksa repositori dan pilih cakupan instalasi yang dimaksud saat diminta.
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
Mulai sesi agen pemrograman baru setelah pemasangan dan pastikan skill yang diharapkan tersedia. Ini memastikan agen dapat menemukan instruksi. Belum ada kesimpulan tentang kemampuan mesin memuat checkpoint atau melakukan pelatihan.
Tutorial menggunakan host GPU Linux dan kontainer NeMo Speech yang dipatok, 26.07.00, untuk penyiapan terdokumentasi. Periksa persyaratan driver, GPU, dan kerangka pada image saat ini sebelum menyiapkan host. Skill di laptop bukan pengganti lingkungan eksekusi tersebut. Persiapan lingkungan
Batasi pemeriksaan lingkungan pertama. Verifikasi impor, GPU terlihat, pemuatan checkpoint, dan inferensi singkat sebelum mengalokasikan anggaran pelatihan. Catat versi dan identitas kontainer agar hasil berikutnya dapat dikaitkan dengan perangkat lunak penghasilnya.
Pengenalan streaming dan offline perlu perbandingan terpisah
Pengenal streaming harus menghasilkan keluaran saat audio masuk. Pengenal offline dapat memakai pola eksekusi berbeda setelah rekaman tersedia. Keduanya mentranskripsikan ucapan, tetapi latensi, konteks, dan pilihan decoding dapat berbeda cukup jauh sehingga satu skor tidak menjadi perbandingan lengkap.
Untuk aplikasi langsung, catat kapan hasil parsial muncul, kapan stabil, dan bagaimana teks akhir dikirim. Transkrip lebih akurat yang datang terlambat mungkin tidak cocok untuk takarir langsung. Untuk arsip, proses offline lebih lambat dapat diterima jika memberikan catatan akhir lebih baik.
Gunakan mode sama sebelum dan sesudah adaptasi untuk perbandingan inti. Jika sekaligus mengubah pemenggalan, decoding, checkpoint, dan normalisasi teks, skor lebih baik tidak menjelaskan perubahan yang berpengaruh. Buat eksperimen terpisah jika ingin membandingkan seluruh alur alternatif.
Disiplin yang sama membantu evaluasi hilir. Label pembicara, cap waktu, dan kata pengenalan adalah keluaran berbeda. Transkrip dapat memiliki WER baik tetapi mengaitkan pernyataan penting ke orang salah; nilai kemampuan tersebut terpisah jika dibutuhkan aplikasi.
Checkpoint yang dievaluasi lebih dari log pelatihan sukses
Training loss yang menurun menunjukkan proses optimisasi menyesuaikan objektifnya. Itu tidak membuktikan pembicara baru akan dikenali lebih akurat. Artefak berguna adalah checkpoint terpilih bersama konfigurasi, prediksi, dan hasil evaluasinya.
Pertahankan model asli dan beri skor dengan protokol sama. Sertakan beberapa kegagalan representatif agar peninjau domain memahami celah tersisa. Tabel rata-rata seharusnya mengarahkan pada contoh, bukan menyembunyikannya.
Penerapan menambahkan pertanyaan lain. Bisakah mesin target memuat artefak? Apakah runtime layanan mendukung arsitektur dan tokenizer? Apakah keluarannya mempertahankan konvensi yang diharapkan perangkat lunak hilir? Lingkungan pelatihan dan runtime aplikasi dapat tidak cocok meskipun keduanya mendukung “pengenalan ucapan”.
Tutorial NVIDIA membedakan alat yang sudah dirilis dari checkpoint Gold-refined yang disebut akan datang. Perlakukan ketersediaan kode, hasil contoh, dan bobot adaptasi yang dapat diunduh sebagai status rilis terpisah. Tutorial publik cukup untuk memulai perencanaan; tidak berarti semua artefak demonstrasi telah dikemas untuk penerapan Anda.
Adaptasi lebih baik dimulai dari pertanyaan lebih kecil dan jelas
Menurut kami, Speech Skills paling berguna sebagai cara membuat pekerjaan ASR khusus dapat diperiksa. Ia mengubah permintaan terbuka untuk akurasi lebih baik menjadi rangkaian keputusan tentang kesalahan, data, metode kompatibel, dan evaluasi. Itu dapat mencegah eksperimen berubah menjadi pelatihan panjang tanpa garis akhir yang disepakati.
Mulailah dengan kata yang penting dan rekaman yang membuktikan masalah. Tanyakan apakah intervensi lebih sederhana berhasil, lalu tingkatkan dengan bukti. Checkpoint bernilai ketika memperbaiki transkrip dalam kondisi yang benar-benar dihadapi pembaca atau pendengar Anda.
Sumber dan media
Diperiksa pada 20 Oktober 2026. Hasil numerik diatribusikan pada studi NVIDIA; tidak ada pelatihan, inferensi, atau hasil demo yang direproduksi untuk artikel ini. Tangkapan layar menampilkan dokumentasi publik NVIDIA, diambil penulis, dengan atribusi CC BY 4.0. Diagram merupakan karya orisinal. Lihat catatan media.
- Tutorial NVIDIA, 13 Oktober 2026
- Skill orkestrasi
- Skill spesialis NeMo
- Kerangka NeMo Speech
- Lisensi dokumentasi dan sumber NVIDIA
Simpan bukti audio berdampingan dengan peninjauan
Simpan referensi sumber, keputusan istilah, dan catatan evaluasi bersama agar eksperimen selanjutnya dimulai dari catatan jelas. Telli.sh dapat membantu menata riset itu. Buat akun Telli.sh